Mantener afilado el juicio humano: la paradoja de la pérdida de habilidades con la IA en el trabajo
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
La paradoja de la pérdida de habilidades (de-skilling) es esta: cuanto más delega un equipo el pensamiento en la IA, más se debilita su juicio justo en la habilidad que ahora más necesita, detectar a la IA cuando se equivoca. La verificación, la capacidad de reconocer un error que suena plausible, depende del mismo músculo mental que antes construía el hecho de generar el trabajo desde cero. Si se delega la generación y se omite la práctica, el músculo se atrofia mientras el trabajo que lo requiere (revisar la máquina) sigue firmemente del lado humano del escritorio.
Esto no es una predicción. Es un patrón con décadas de evidencia detrás en la aviación, en la navegación y ahora en las primeras investigaciones sobre el propio trabajo del conocimiento. Nada de esa evidencia dice que la IA convierta a las personas en peores pensadoras de forma permanente. Dice que un mecanismo específico y bien documentado se activa siempre que una tarea pasa de "yo hago esto" a "un sistema hace esto y yo lo reviso", y que ese mecanismo es manejable una vez que se sabe que existe.
Datos clave
- El sesgo de automatización tiene dos modos de fallo, y la capacitación solo corrige uno de ellos. Los estudios originales de Skitka, Mosier y Burdick encontraron que las personas cometen errores de omisión (pasar por alto algo que la automatización no señaló) y errores de comisión (seguir el consejo de la automatización aun cuando otra evidencia lo contradice), y que la capacitación de concientización redujo los errores de comisión pero no los de omisión. Does Automation Bias Decision-Making? (Skitka, Mosier & Burdick)
- "Your Brain on ChatGPT", del MIT Media Lab, encontró una conectividad cerebral más débil en el grupo que escribía con ayuda de un LLM, pero es un preprint pequeño y sin revisión por pares. Con 54 participantes, el compromiso cognitivo medido por EEG fue más bajo en el grupo que usó un LLM para escribir ensayos y más alto en el grupo que usó solo su cerebro. Los propios autores señalan el tamaño de la muestra y la falta de revisión por pares como límites reales. MIT Media Lab, "Your Brain on ChatGPT"
- Una mayor confianza en la IA predice menos pensamiento crítico reportado, en una encuesta de Microsoft Research y Carnegie Mellon a 319 trabajadores del conocimiento. Cuanto más confiaban las personas en que la IA manejaría bien una tarea, menos escrutinio crítico dijeron aplicar a su resultado, mientras que la confianza en su propia capacidad se movía en sentido contrario. Microsoft Research, "The Impact of Generative AI on Critical Thinking"
- Un mayor uso del GPS a lo largo de la vida predice una peor memoria espacial al navegar sin él. Un estudio de la McGill University con 50 conductores habituales encontró esta relación, y un seguimiento a tres años en un subconjunto mostró que el mayor uso del GPS desde la primera prueba coincidía con un deterioro más pronunciado de la memoria espacial dependiente del hipocampo, y no al revés. Dahmani & Bohbot, Scientific Reports (Nature)
- Los reguladores de la aviación llevan más de una década construyendo políticas en torno a la pérdida de habilidad de vuelo manual. El Flight Deck Automation Working Group de la FAA y organismos internacionales (ICAO, EASA) identificaron el deterioro de las habilidades de vuelo manual y de la conciencia de respuesta a la automatización como factores contribuyentes en incidentes de pérdida de control, lo que impulsó una capacitación obligatoria en vuelo manual y en fallos de automatización. FAA Air Carrier Training ARC report
La paradoja de la pérdida de habilidades, definida
Toda profesión tiene una versión de la misma regla: se aprende a detectar una mala respuesta habiendo producido uno mismo suficientes respuestas buenas y malas. Un radiólogo lee imágenes durante años antes de que una mirada le diga que algo anda mal. Un editor desarrolla el olfato para un argumento débil escribiendo cientos de primeros borradores débiles propios. Ese sentido de reconocimiento de patrones es el juicio, y se construye con repetición, no con instrucción. Para mucha gente es también la parte del trabajo que se sentía como oficio y no como labor, razón por la cual perder la repetición cuesta más que una habilidad; sentido, identidad y oficio en la era de la IA aborda esa segunda pérdida, menos medida.
La IA cambia la economía de esa repetición. ¿Para qué escribir el primer borrador, hacer las cuentas a mano o leer el contrato completo cuando un modelo lo hace en diez segundos? Para cualquier tarea individual, saltarse la repetición manual es la opción obviamente eficiente. Pero el juicio es un activo que se capitaliza, construido con miles de repeticiones pequeñas, y saltarse la repetición es también saltarse el depósito. Si se hace esto de forma constante en un equipo, un rol o una etapa de carrera, el juicio acumulado que antes hacía valiosas a las personas experimentadas deja de acumularse.
La paradoja es el doble vínculo que esto crea. La IA es más útil justo en las tareas tediosas o lentas de hacer a mano, que son también las que construyen el juicio necesario para revisar el trabajo de la IA. El equipo que más se apoya en la IA mejora hoy su velocidad de producción mientras degrada en silencio su capacidad de detectar el error de mañana. Ninguno de los dos efectos es visible en el momento. La velocidad se ve de inmediato; la brecha de juicio aparece meses después, normalmente la primera vez que la IA se equivoca con seguridad en algo que importa.
Sesgo de automatización y complacencia: por qué dejamos de verificar
Qué le hace realmente el sesgo de automatización a una decisión
El sesgo de automatización es la tendencia bien documentada a tratar una recomendación automatizada como un sustituto de comprobar activamente la evidencia por uno mismo, en lugar de como un dato más que sopesar. Linda Skitka, Kathleen Mosier y Susan Burdick realizaron una serie de estudios en los que los participantes hacían una tarea simulada de monitoreo de vuelo, algunos con una ayuda automatizada muy (pero no perfectamente) fiable y otros sin ella. Las personas sin la ayuda detectaron más errores en total. Las personas con la ayuda pasaron por alto eventos que esta no señaló (errores de omisión) y, de forma más llamativa, a veces siguieron su consejo aun teniendo delante información que lo contradecía (errores de comisión).
Lo inquietante de sus hallazgos es que estos errores persistieron incluso después de decirles explícitamente a los participantes que la ayuda no era perfectamente fiable. Saber intelectualmente que un sistema puede equivocarse no cambia de forma fiable el comportamiento hacia él. Solo la capacitación dirigida que recorría específicamente los modos de fallo del sesgo de automatización redujo los errores de comisión, y aun así esa capacitación dejó los errores de omisión en gran medida intactos. Decirle a un equipo "recuerden, puede equivocarse" no es, por sí solo, una solución.
La complacencia es lo predeterminado, no la excepción
La complacencia es la prima más silenciosa del sesgo de automatización: no confiar activamente en una respuesta equivocada, simplemente no mirar con suficiente atención como para notarla. Es el estado por defecto, no un lapso en un proceso por lo demás vigilante, porque la vigilancia es costosa y una respuesta fluida y de apariencia segura de la IA le da al cerebro todas las señales que usa para decidir que algo no necesita una segunda mirada. Este es el mecanismo detrás de la seguridad psicológica en equipos de IA: ese artículo trata de si las personas se sienten lo bastante seguras como para expresar en voz alta sus dudas sobre el resultado de una IA. Este trata de algo anterior: si conservan el juicio afilado para notar que hay algo que dudar en primer lugar. Un equipo puede sentirse al máximo seguro para hablar y aun así pasar por alto el error, si nadie en él ha mantenido la habilidad de reconocimiento de patrones que lo habría señalado.
La descarga cognitiva y lo que cuesta
La descarga cognitiva (cognitive offloading), entregar una tarea mental a una herramienta externa en lugar de hacerla de cabeza, no es nueva ni es mala por naturaleza. Anotar cosas, usar una calculadora y buscar un dato son formas de descarga, y ninguna destruyó la alfabetización ni la aritmética. Lo que cambia con la IA generativa es el alcance: descarga no solo la memoria o el cálculo, sino la construcción misma de un argumento, un análisis o una decisión, que es una parte mucho mayor del pensamiento que construye el juicio.
Los hallazgos del MIT Media Lab y sus límites reales
El estudio "Your Brain on ChatGPT" del MIT Media Lab, ampliamente compartido, midió con EEG la conectividad cerebral de personas que escribían ensayos con un LLM, con un buscador o sin ninguna herramienta. El grupo que solo usó su cerebro mostró el compromiso neuronal más fuerte y más distribuido; el grupo del LLM, el más débil. Es una señal temprana genuinamente interesante, y merece reportarse con honestidad en lugar de exagerarse: 54 participantes, una sola tarea de redacción de ensayos, sin revisión por pares en la versión comentada aquí, y los propios autores advierten contra tratar el resultado como ciencia asentada. Léalo como una hipótesis que vale la pena tomar en serio, no como prueba de que el uso de la IA recablea el cerebro. La dirección del hallazgo importa más que su certeza estadística en esta etapa: coincide con un mecanismo (menos construcción activa, menos compromiso activo) que aparece de forma independiente en la investigación sobre aviación y navegación que sigue.
El efecto de confianza de Microsoft y Carnegie Mellon
Más sólido, porque encuestó trabajo real y no una tarea de laboratorio, es el estudio de Microsoft Research y Carnegie Mellon con 319 trabajadores del conocimiento que describieron 936 casos reales de uso de IA generativa en su trabajo. Su hallazgo central: cuanta más confianza tenía alguien en la capacidad de la IA para manejar una tarea, menos pensamiento crítico reportaba aplicar al resultado, mientras que la confianza en su propia capacidad se movía en sentido contrario. Los investigadores también encontraron que la IA generativa cambia cómo se ve el pensamiento crítico, de generar una respuesta a verificarla, integrarla y custodiarla, y que las personas se saltan ese nuevo paso de verificación con más frecuencia cuando carecen de la habilidad para inspeccionar y mejorar de verdad lo que la IA produjo. Ese último punto es la paradoja en una sola frase: las personas menos preparadas para detectar un error de la IA suelen ser las que más trabajo han descargado, el mismo que habría construido la habilidad para detectarlo.
Dos precedentes de los que ya tenemos evidencia
El trabajo del conocimiento es nuevo en este problema. Otros dos ámbitos no lo son, y ambos tienen décadas de datos medidos sobre lo que pasa cuando una habilidad se entrega a la automatización y deja de practicarse.
Aviación: qué pasa cuando los pilotos dejan de volar a mano
Los aviones comerciales modernos pueden volar casi toda la ruta con piloto automático, y los pilotos a menudo hacen exactamente eso para reducir la carga de trabajo y el consumo de combustible. El costo que los reguladores acabaron teniendo que afrontar: las habilidades de vuelo manual y de reconocimiento de fallos se degradan cuando no se ejercitan, y varios incidentes graves se remontaron en parte a una tripulación que no había practicado recientemente el escenario exacto que la automatización les devolvió en el peor momento posible. El Flight Deck Automation Working Group de la FAA documentó este patrón con la claridad suficiente como para remodelar los estándares de capacitación en toda la industria, añadiendo segmentos obligatorios de vuelo manual y simulacros de fallo de automatización específicamente para evitar que la habilidad de base se erosione. La solución nunca fue "usar menos automatización". Fue "practicar la habilidad a propósito, de forma programada, haga o no falta en el trabajo actual".
El GPS y la erosión silenciosa de la memoria espacial
La navegación ofrece un experimento natural más limpio y de más larga duración, porque millones de personas lo llevan corriendo durante dos décadas. Un estudio de la McGill University midió la memoria espacial en conductores habituales y encontró que las personas con más experiencia de GPS a lo largo de su vida rindieron peor en tareas de navegación autoguiada, las que exigen un mapa mental interno en lugar de instrucciones paso a paso. Un seguimiento tres años después con un grupo más pequeño encontró la dirección de la causalidad: quienes aumentaron su uso del GPS en el intervalo mostraron un deterioro más pronunciado de la memoria espacial dependiente del hipocampo, y eso no se explicaba por que ya tuvieran un mal sentido de la orientación que los empujara hacia la herramienta. El mecanismo es casi idéntico a lo que aparece en el trabajo del conocimiento: el GPS convierte la navegación en seguir una instrucción de estímulo-respuesta ("gire a la derecha en 200 metros") en lugar de construir y actualizar un modelo interno de la ruta, así que la habilidad que construye el modelo interno simplemente deja de ejercitarse.
Por qué esto golpea más a la verificación
Cada contramedida que sigue existe por un problema estructural: la verificación es justo la habilidad que este patrón erosiona más rápido, y es también la única habilidad que nadie puede subcontratar a la propia IA. No se le puede pedir a un modelo que le diga de forma fiable cuándo se equivoca; la investigación sobre la alucinación de la IA es clara en que una respuesta segura, fluida y errónea se ve idéntica desde fuera a una respuesta segura, fluida y correcta. Lo único que se interpone entre un error plausible de la IA y una decisión costosa es un humano que todavía tenga la agudeza de reconocimiento de patrones para notar que algo anda mal, y esa agudeza se construye con el tipo exacto de repetición manual que la adopción de la IA elimina. Decidir conservar esa agudeza dentro de la casa, a propósito, en lugar de suponer que un modelo acabará detectando sus propios errores, es el mismo cálculo que la prima humana plantea para decidir qué puntos de contacto siguen siendo humanos.
Aquí es también donde la paradoja se agrava en un equipo en lugar de quedarse como un problema individual. Cuando el juicio de una persona se embota, es un riesgo personal. Cuando el juicio colectivo de todo un equipo se embota a la vez, en las mismas tareas, porque todos adoptaron juntos el mismo workflow de IA, no queda nadie en la sala con el instinto afilado para detectar lo que se coló. Ese es un riesgo estructural, y es la razón por la que los equipos humano-agente necesitan pensar el mantenimiento de las habilidades como una cuestión de diseño a nivel de equipo y no como un hábito individual.
| Capacidad en riesgo | Cómo se erosiona | Contramedida |
|---|---|---|
| Construcción del primer borrador (escritura, análisis, código) | Saltarse el intento manual elimina la repetición que construye el reconocimiento de patrones de cómo se ve una respuesta errónea | Práctica manual deliberada con una cadencia fija, incluso cuando la IA podría hacer la tarea más rápido |
| Detección de errores en el resultado de otra persona (o de la IA) | El sesgo de automatización y la complacencia hacen que una respuesta fluida parezca revisada cuando solo se ha hojeado | Revisión a ciegas primero, en la que el humano llega a una respuesta independiente antes de ver lo que produjo la IA |
| Confianza calibrada (saber cuándo cuestionar) | La confianza en la IA sustituye a la confianza en el propio juicio, según el hallazgo del efecto de confianza de Microsoft y CMU | Rotar al revisor, para que la confianza de ninguna persona en un workflow de IA concreto quede sin cuestionar por mucho tiempo |
| Intuición de dominio sobre el sistema o la cuenta específicos | La complacencia se agrava cuando la misma persona siempre cede ante la misma tarea recurrente | Hacer red-teaming del resultado de la IA de forma programada, tratando las comprobaciones adversarias como mantenimiento rutinario y no como respuesta a incidentes |
| Juicio ante la ambigüedad (casos para los que la IA no fue entrenada) | Pérdida de habilidad al estilo del vuelo manual: el juicio que se practica poco se degrada más rápido y falla justo cuando el caso rutinario se convierte en un caso límite | Puertas de human-in-the-loop colocadas en puntos genuinos de juicio, no estampadas en cada resultado sin importar lo que esté en juego |
Cómo construir contramedidas que funcionen de verdad
Práctica manual deliberada
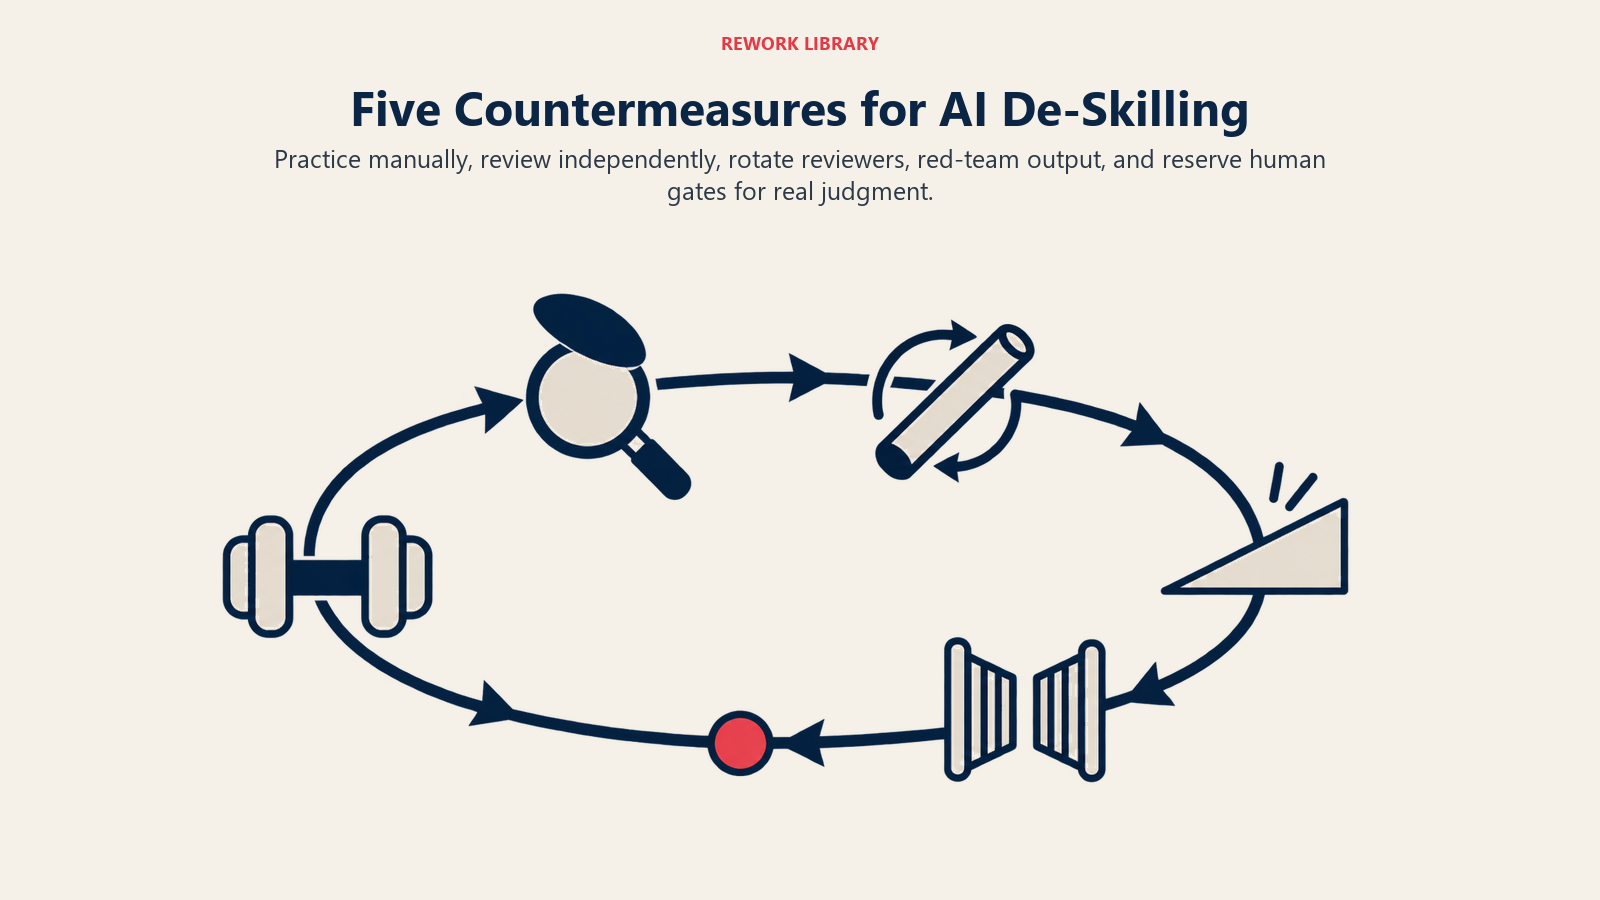
La solución de la aviación se generaliza con limpieza: programe repeticiones manuales a propósito, con independencia de que el trabajo las necesite hoy. Un equipo de finanzas que deja que la IA construya todos los modelos debería aun así hacer que sus analistas construyan algunos desde cero cada trimestre. Un equipo de soporte que deja que la IA redacte todas las respuestas debería aun así hacer que algunas personas escriban algunas sin ayuda, específicamente para evitar que la habilidad de base se apague. El objetivo no es la nostalgia de hacer las cosas por el camino lento. Es mantener la maquinaria de reconocimiento de patrones lo bastante caliente como para notar cuándo el camino rápido produce algo equivocado.
Revisión a ciegas primero
El hábito de mayor impacto contra el sesgo de automatización es la secuencia: forme su propia opinión antes de ver la de la IA. Lea la cláusula del contrato, estime la cifra o esboce el argumento primero, y luego compare notas con lo que produjo el modelo. Invertir ese orden, ver la respuesta de la IA y después intentar evaluarla, es exactamente la configuración en la que la investigación de Skitka y Mosier muestra que las personas son peores, porque una respuesta fluida ancla el juicio antes de que este tenga la oportunidad de formarse de manera independiente.
Rotar al revisor
La complacencia se profundiza cuanto más tiempo revisa la misma persona el mismo workflow de IA. Rote quién hace la comprobación final en un proceso recurrente asistido por IA, incluso cuando el revisor "experto" esté técnicamente más cualificado. Un revisor nuevo aún no ha construido la confianza (ni los puntos ciegos) que vienen de meses en que la IA acierta lo suficiente como para dejar de ser cuestionada de cerca. Esta es una solución estructural, no de capacitación, y funciona precisamente porque no depende de la fuerza de voluntad de ninguna persona.
El red-teaming del resultado de la IA como rutina, no como respuesta a incidentes
Trate las pruebas adversarias del trabajo generado por IA igual que los equipos de seguridad tratan las pruebas de penetración: programadas, no activadas solo después de que algo se rompe. Elija una muestra del resultado de la IA en cada ciclo e intente romperla a propósito: encuentre el supuesto equivocado, la afirmación sin sustento, el caso límite que se le escapó. El material de Rework sobre red-teaming para agentes de IA cubre la mecánica para sistemas agénticos en particular, pero la disciplina se aplica igual de bien a un solo memorando o una sola hoja de cálculo redactados por IA. El objetivo no es detectar todos los errores; es mantener en uso activo el músculo del escrutinio escéptico para que esté ahí cuando aparezca un error real sin avisar.
Human-in-the-loop para el juicio, no para el sello de goma
Las puertas de human-in-the-loop solo valen la fricción que añaden si el humano en la puerta realmente ejerce juicio en lugar de hacer clic en aprobar. Una puerta colocada en cada resultado, sin importar lo que esté en juego, entrena a las personas a aprobar por reflejo, lo opuesto al efecto buscado. Reserve los puntos de aprobación humana para decisiones con consecuencias reales, y empareje cada uno con el contexto suficiente para que el revisor tenga algo que evaluar de verdad. Buenos guardrails para agentes de IA y la observabilidad sobre lo que un agente realmente hizo ayudan en esto, porque un revisor con visibilidad del razonamiento tiene más que comprobar que uno que mira una respuesta final sin ningún rastro detrás. Hacer mal esta puerta es también un problema de cultura: un equipo que castiga a quien señala un error de la IA entrenará a todos los demás a dejar de señalarlo, lo que vacía en silencio todo el sentido de tener a un humano en el circuito.
Qué deberían hacer los líderes con esto
Nada de esto aboga por usar menos IA. Los equipos con el juicio más afilado dentro de cinco años serán los que usaron la IA intensamente y trataron el mantenimiento de las habilidades como una práctica deliberada y presupuestada, y no como un accidente de lo que la herramienta dejó. Incorpore la práctica manual al calendario como los pilotos incorporan la capacitación recurrente. Estructure la revisión para que un humano forme una opinión antes de ver la de la máquina. Rote a las personas que hacen esa revisión. Programe el red-teaming en lugar de esperar a que un fallo lo imponga. Y construya una confianza en la propia IA calibrada a lo que realmente se ha ganado, no a lo segura y fluida que suene. Ninguna de estas es una inversión grande por separado. Omitidas en conjunto, suman un equipo que ya no puede distinguir cuándo la máquina se equivoca, el día que más importa.

Co-Founder, Rework.com
On this page
- Datos clave
- La paradoja de la pérdida de habilidades, definida
- Sesgo de automatización y complacencia: por qué dejamos de verificar
- Qué le hace realmente el sesgo de automatización a una decisión
- La complacencia es lo predeterminado, no la excepción
- La descarga cognitiva y lo que cuesta
- Los hallazgos del MIT Media Lab y sus límites reales
- El efecto de confianza de Microsoft y Carnegie Mellon
- Dos precedentes de los que ya tenemos evidencia
- Aviación: qué pasa cuando los pilotos dejan de volar a mano
- El GPS y la erosión silenciosa de la memoria espacial
- Por qué esto golpea más a la verificación
- Cómo construir contramedidas que funcionen de verdad
- Práctica manual deliberada
- Revisión a ciegas primero
- Rotar al revisor
- El red-teaming del resultado de la IA como rutina, no como respuesta a incidentes
- Human-in-the-loop para el juicio, no para el sello de goma
- Qué deberían hacer los líderes con esto