Bahasa Indonesia
Menjaga Ketajaman Penilaian Manusia: Paradoks De-Skilling dari AI di Tempat Kerja
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
Paradoks de-skilling adalah ini: makin banyak sebuah tim mengalihkan pemikiran ke AI, makin lemah penilaiannya justru pada keterampilan yang kini paling dibutuhkan, yaitu menangkap AI ketika ia keliru. Verifikasi, kemampuan melihat kesalahan yang terdengar masuk akal, bergantung pada otot mental yang sama yang dulu dibangun oleh mengerjakan sesuatu dari nol. Delegasikan pembuatannya dan lewati latihannya, maka otot itu mengalami atrofi sementara pekerjaan yang membutuhkannya (memeriksa mesin) tetap berada tegas di sisi meja manusia.
Ini bukan prediksi. Ini pola dengan bukti selama puluhan tahun di penerbangan, navigasi, dan kini riset awal tentang pekerjaan pengetahuan itu sendiri. Tidak ada bukti itu yang mengatakan AI membuat orang menjadi pemikir yang lebih buruk secara permanen. Yang dikatakannya adalah bahwa mekanisme tertentu yang terdokumentasi dengan baik bekerja setiap kali tugas berpindah dari "saya mengerjakan ini" ke "sistem mengerjakan ini dan saya memeriksanya", dan mekanisme itu dapat dikelola begitu Anda tahu ia ada.
Fakta Utama
- Automation bias punya dua mode kegagalan, dan pelatihan hanya memperbaiki salah satunya. Studi-studi awal Skitka, Mosier, dan Burdick menemukan orang melakukan kesalahan omisi (melewatkan sesuatu yang tidak ditandai otomatisasi) dan kesalahan komisi (mengikuti saran otomatisasi meski bukti lain bertentangan), dan bahwa pelatihan kesadaran mengurangi kesalahan komisi tetapi tidak kesalahan omisi. Does Automation Bias Decision-Making? (Skitka, Mosier & Burdick)
- "Your Brain on ChatGPT" dari MIT Media Lab menemukan konektivitas otak yang lebih lemah pada kelompok menulis berbantuan LLM, tetapi ini preprint kecil yang belum ditinjau sejawat. 54 peserta, keterlibatan kognitif yang diukur EEG paling rendah pada kelompok yang memakai LLM untuk menulis esai dan paling tinggi pada kelompok tanpa alat bantu. Para penulis sendiri menandai ukuran sampel dan ketiadaan tinjauan sejawat sebagai batasan nyata. MIT Media Lab, "Your Brain on ChatGPT"
- Kepercayaan yang lebih tinggi pada AI memprediksi berpikir kritis yang dilaporkan lebih sedikit, dalam survei Microsoft Research dan Carnegie Mellon terhadap 319 pekerja pengetahuan. Makin orang memercayai AI menangani suatu tugas dengan baik, makin sedikit pemeriksaan kritis yang mereka katakan diterapkan pada outputnya, sementara kepercayaan pada kemampuan sendiri bergerak ke arah sebaliknya. Microsoft Research, "The Impact of Generative AI on Critical Thinking"
- Pemakaian GPS seumur hidup yang lebih berat memprediksi memori spasial yang lebih buruk saat bernavigasi tanpanya. Studi McGill University terhadap 50 pengemudi reguler menemukan hubungan ini, dan tindak lanjut tiga tahun pada sebagian peserta menunjukkan bahwa peningkatan pemakaian GPS sejak tes pertama sejalan dengan penurunan memori spasial yang bergantung pada hipokampus yang lebih curam, bukan sebaliknya. Dahmani & Bohbot, Scientific Reports (Nature)
- Regulator penerbangan telah menghabiskan lebih dari satu dekade menyusun kebijakan seputar hilangnya keterampilan menerbangkan secara manual. Flight Deck Automation Working Group milik FAA dan badan internasional (ICAO, EASA) mengidentifikasi menurunnya keterampilan terbang manual dan kesadaran respons otomatisasi sebagai faktor penyumbang insiden hilangnya kendali, yang mendorong pelatihan terbang manual dan kegagalan otomatisasi yang wajib. FAA Air Carrier Training ARC report
Paradoks De-Skilling, Didefinisikan
Setiap profesi punya versi aturan yang sama: Anda belajar menangkap jawaban yang buruk dengan sendiri pernah menghasilkan cukup banyak jawaban yang baik dan buruk. Seorang radiolog membaca film selama bertahun-tahun sebelum sekilas pandang memberi tahu ada yang janggal. Seorang editor mengembangkan kepekaan terhadap argumen yang lemah dengan menulis ratusan draf pertama yang lemah miliknya sendiri. Kepekaan pencocokan pola itu adalah penilaian, dan ia dibangun lewat pengulangan, bukan instruksi. Bagi banyak orang, itu juga bagian pekerjaan yang terasa seperti keahlian, bukan tenaga, itulah sebabnya kehilangan pengulangan itu lebih mahal daripada sekadar sebuah keterampilan; makna, identitas, dan keahlian di era AI membahas kehilangan kedua yang kurang terukur itu.
AI mengubah ekonomi dari pengulangan tersebut. Mengapa menulis draf pertama, menghitung angka dengan tangan, atau membaca kontrak lengkap ketika model dapat melakukannya dalam sepuluh detik? Untuk satu tugas mana pun, melewatkan repetisi manual jelas pilihan yang efisien. Tetapi penilaian adalah aset majemuk yang dibangun dari ribuan repetisi yang masing-masing kecil, dan melewatkan repetisi juga berarti melewatkan setoran. Lakukan itu secara konsisten di sebuah tim, peran, atau tahap karier, dan penilaian terakumulasi yang dulu membuat orang berpengalaman berharga berhenti menumpuk.
Paradoksnya adalah dilema ganda yang tercipta. AI paling berguna justru pada tugas yang membosankan atau lambat dikerjakan secara manual, yang juga tugas yang membangun penilaian untuk memeriksa pekerjaan AI. Tim yang paling bersandar pada AI meningkatkan kecepatan outputnya hari ini sambil diam-diam menurunkan kapasitasnya menangkap kesalahan esok hari. Tidak ada dari kedua efek itu yang terlihat saat itu juga. Kecepatan langsung tampak; kesenjangan penilaian baru tampak berbulan-bulan kemudian, biasanya pertama kali ketika AI keliru dengan penuh percaya diri tentang sesuatu yang penting.
Automation Bias dan Kepuasan Diri: Mengapa Kita Berhenti Memeriksa
Apa yang Sebenarnya Dilakukan Automation Bias pada Sebuah Keputusan
Automation bias adalah kecenderungan yang terdokumentasi dengan baik untuk memperlakukan rekomendasi otomatis sebagai pengganti memeriksa bukti secara aktif sendiri, bukan sebagai satu masukan lagi untuk ditimbang. Linda Skitka, Kathleen Mosier, dan Susan Burdick menjalankan serangkaian studi yang menempatkan peserta dalam tugas pemantauan penerbangan simulasi, sebagian dipasangkan dengan alat bantu otomatis yang sangat (tetapi tidak sempurna) andal dan sebagian tanpa alat itu. Orang tanpa alat bantu menangkap lebih banyak kesalahan secara keseluruhan. Orang dengan alat bantu melewatkan peristiwa yang gagal ditandainya (kesalahan omisi) dan, yang lebih mencolok, kadang mengikuti sarannya meski informasi yang bertentangan ada tepat di depan mereka (kesalahan komisi).
Bagian yang mengusik dari temuan mereka adalah bahwa kesalahan ini bertahan bahkan setelah peserta diberi tahu secara eksplisit bahwa alat itu tidak sepenuhnya andal. Mengetahui secara intelektual bahwa sebuah sistem bisa salah tidak secara andal mengubah perilaku terhadapnya. Hanya pelatihan terarah yang secara spesifik menelusuri mode kegagalan automation bias yang mengurangi kesalahan komisi, dan bahkan pelatihan itu nyaris tidak menyentuh kesalahan omisi. Mengatakan kepada tim "ingat, ia bisa salah" bukanlah, dengan sendirinya, solusi.
Kepuasan Diri Adalah Default, Bukan Pengecualian
Kepuasan diri adalah sepupu automation bias yang lebih senyap: bukan secara aktif memercayai jawaban yang salah, hanya tidak melihat cukup dekat untuk menyadarinya. Ini keadaan default, bukan kelalaian dalam proses yang sebenarnya waspada, karena kewaspadaan itu mahal dan jawaban AI yang fasih dan terdengar percaya diri memberi otak setiap sinyal yang dipakainya untuk memutuskan bahwa sesuatu tidak perlu dilihat dua kali. Inilah mekanisme di balik rasa aman psikologis di tim AI: artikel itu membahas apakah orang merasa cukup aman untuk menyuarakan keraguan atas output AI secara terbuka. Artikel ini membahas sesuatu yang berada di hulunya: apakah mereka masih memiliki penilaian yang tajam untuk menyadari bahwa ada sesuatu yang patut diragukan sejak awal. Sebuah tim bisa sepenuhnya aman untuk bersuara dan tetap melewatkan kesalahan, jika tidak ada seorang pun di dalamnya yang menjaga keterampilan pencocokan pola yang akan menandainya.
Cognitive Offloading dan Biayanya
Cognitive offloading, menyerahkan tugas mental kepada alat eksternal alih-alih mengerjakannya di kepala, bukan hal baru dan tidak buruk dengan sendirinya. Mencatat, memakai kalkulator, dan mencari fakta semuanya adalah offloading, dan tidak satu pun merusak literasi atau aritmetika. Yang berbeda dengan AI generatif adalah cakupannya: ia mengalihkan bukan hanya memori atau komputasi, tetapi penyusunan argumen, analisis, atau keputusan itu sendiri, yang merupakan porsi jauh lebih besar dari pemikiran yang membangun penilaian.
Temuan MIT Media Lab, dan Batas Nyatanya
Studi "Your Brain on ChatGPT" dari MIT Media Lab yang banyak dibagikan mengukur konektivitas otak lewat EEG pada orang yang menulis esai dengan LLM, dengan mesin pencari, atau tanpa alat sama sekali. Kelompok tanpa alat menunjukkan keterlibatan saraf yang paling kuat dan paling tersebar; kelompok LLM yang paling lemah. Ini sinyal awal yang benar-benar menarik, dan layak dilaporkan dengan jujur, bukan dilebih-lebihkan: 54 peserta, satu tugas menulis esai, belum ditinjau sejawat pada versi yang dibahas di sini, dan para penulis sendiri mengingatkan agar hasilnya tidak diperlakukan sebagai ilmu yang sudah mapan. Bacalah sebagai hipotesis yang layak ditanggapi serius, bukan bukti bahwa pemakaian AI merombak otak. Arah temuannya lebih penting daripada kepastian statistiknya pada tahap ini: ia sejalan dengan mekanisme (konstruksi yang kurang aktif, keterlibatan yang kurang aktif) yang muncul secara independen dalam riset penerbangan dan navigasi di bawah.
Efek Kepercayaan dari Microsoft dan Carnegie Mellon
Lebih kokoh, karena mensurvei pekerjaan nyata, bukan tugas laboratorium, adalah studi Microsoft Research dan Carnegie Mellon terhadap 319 pekerja pengetahuan yang menggambarkan 936 contoh nyata pemakaian AI generatif di tempat kerja. Temuan utamanya: makin besar kepercayaan seseorang pada kemampuan AI menangani suatu tugas, makin sedikit berpikir kritis yang dilaporkan diterapkan pada hasilnya, sementara kepercayaan pada kemampuan sendiri bergerak ke arah sebaliknya. Para peneliti juga menemukan bahwa AI generatif menggeser wujud berpikir kritis, dari menghasilkan jawaban menjadi memverifikasi, mengintegrasikan, dan mengelola satu jawaban, dan bahwa orang paling sering melewatkan langkah verifikasi baru itu ketika mereka tidak punya keterampilan untuk benar-benar memeriksa dan memperbaiki apa yang dihasilkan AI. Poin terakhir itu adalah paradoksnya dalam satu kalimat: orang yang paling tidak siap menangkap kesalahan AI sering kali adalah mereka yang paling banyak menyerahkan pekerjaan yang seharusnya membangun keterampilan untuk menangkapnya.
Dua Preseden yang Sudah Kita Punya Buktinya
Pekerjaan pengetahuan baru menghadapi masalah ini. Dua bidang lain tidak, dan keduanya memiliki data terukur selama puluhan tahun tentang apa yang terjadi ketika sebuah keterampilan diserahkan kepada otomatisasi dan berhenti dilatih.
Penerbangan: Apa yang Terjadi Ketika Pilot Berhenti Menerbangkan Secara Manual
Pesawat penumpang modern dapat terbang hampir seluruh rute dengan autopilot, dan pilot sering melakukan persis itu untuk mengurangi beban kerja dan konsumsi bahan bakar. Pertukaran yang akhirnya harus dihadapi regulator: keterampilan terbang manual dan pengenalan kegagalan menurun ketika tidak dilatih, dan beberapa insiden serius sebagian ditelusuri ke awak pesawat yang belum lama berlatih skenario persis yang dikembalikan otomatisasi kepada mereka pada saat terburuk. Flight Deck Automation Working Group milik FAA mendokumentasikan pola ini cukup jelas sehingga membentuk ulang standar pelatihan di seluruh industri, menambahkan segmen terbang manual yang wajib dan latihan kegagalan otomatisasi secara khusus agar keterampilan dasarnya tidak terkikis. Solusinya tidak pernah "kurangi otomatisasi." Solusinya "latih keterampilan itu dengan sengaja, sesuai jadwal, entah pekerjaan saat ini menuntutnya atau tidak."
GPS dan Erosi Diam-Diam Memori Spasial
Navigasi menawarkan eksperimen alami yang lebih bersih dan berjalan lebih lama karena jutaan orang menjalaninya selama dua dekade. Studi McGill University mengukur memori spasial pada pengemudi reguler dan menemukan bahwa orang dengan pengalaman GPS seumur hidup lebih banyak berkinerja lebih buruk pada tugas navigasi mandiri, yaitu yang membutuhkan peta mental internal, bukan petunjuk belokan demi belokan. Tindak lanjut tiga tahun kemudian pada kelompok lebih kecil menemukan arah kausalitasnya: orang yang meningkatkan pemakaian GPS pada masa itu menunjukkan penurunan memori spasial yang bergantung pada hipokampus yang lebih curam, dan ini tidak dijelaskan oleh mereka yang sejak awal memiliki rasa arah yang buruk yang mendorong mereka ke alat itu. Mekanismenya hampir identik dengan yang muncul di pekerjaan pengetahuan: GPS mengubah navigasi menjadi mengikuti instruksi stimulus-respons ("belok kanan 200 meter lagi") alih-alih membangun dan memperbarui model internal tentang rute, sehingga keterampilan yang membangun model internal itu sekadar berhenti dilatih.
Mengapa Ini Paling Menghantam Verifikasi
Setiap langkah penangkal di bawah ada karena satu masalah struktural: verifikasi adalah keterampilan persis yang paling cepat dikikis pola ini, dan juga satu-satunya keterampilan yang tidak bisa dialihdayakan kepada AI itu sendiri. Anda tidak bisa meminta model memberi tahu secara andal kapan ia salah; riset halusinasi AI jelas bahwa jawaban yang percaya diri, fasih, dan salah tampak identik dari luar dengan yang percaya diri, fasih, dan benar. Satu-satunya hal yang berdiri di antara kesalahan AI yang masuk akal dan keputusan yang mahal adalah manusia yang masih memiliki ketajaman pencocokan pola untuk menyadari ada yang janggal, dan ketajaman itu dibangun oleh jenis repetisi manual persis yang dihapus oleh adopsi AI. Memutuskan untuk menjaga ketajaman itu tetap di dalam, dengan sengaja, alih-alih berasumsi model pada akhirnya akan menangkap kesalahannya sendiri, adalah perhitungan yang sama dengan yang dibahas premi manusia untuk memutuskan titik sentuh mana yang tetap dipegang manusia.
Di sinilah paradoks ini juga bertumpuk di seluruh tim, bukan tetap menjadi masalah individu. Ketika penilaian satu orang menumpul, itu risiko pribadi. Ketika penilaian kolektif seluruh tim menumpul bersamaan, pada tugas yang sama, karena semua orang mengadopsi alur kerja AI yang sama bersama-sama, tidak ada lagi orang di ruangan dengan naluri tajam untuk menangkap apa yang lolos. Itu risiko struktural, dan itulah mengapa tim manusia-agent perlu memikirkan pemeliharaan keterampilan sebagai pertanyaan desain tingkat tim, bukan kebiasaan individu.
| Kapabilitas yang berisiko | Bagaimana terkikis | Langkah penangkal |
|---|---|---|
| Penyusunan draf pertama (penulisan, analisis, kode) | Melewatkan percobaan manual menghilangkan repetisi yang membangun pengenalan pola tentang seperti apa jawaban yang salah | Latihan manual yang disengaja dengan irama tetap, dilakukan bahkan ketika AI bisa mengerjakan tugas lebih cepat |
| Deteksi kesalahan pada output orang lain (atau AI) | Automation bias dan kepuasan diri membuat jawaban yang fasih terasa sudah diperiksa padahal hanya dibaca sekilas | Tinjauan blind-first, di mana manusia mencapai jawaban independen sebelum melihat apa yang dihasilkan AI |
| Kepercayaan yang terkalibrasi (tahu kapan harus menolak) | Kepercayaan pada AI menggantikan kepercayaan pada penilaian sendiri, menurut temuan efek kepercayaan Microsoft dan CMU | Merotasi peninjau, agar kepercayaan satu orang pada alur kerja AI tertentu tidak lolos tanpa dipertanyakan terlalu lama |
| Intuisi domain pada sistem atau akun tertentu | Kepuasan diri menumpuk ketika orang yang sama selalu menurut pada tugas berulang yang sama | Red-teaming output AI sesuai jadwal, memperlakukan pemeriksaan adversarial sebagai pemeliharaan rutin, bukan respons insiden |
| Penilaian dalam ambiguitas (kasus yang tidak dilatihkan pada AI) | Hilangnya keterampilan ala terbang manual: penilaian yang jarang dilatih menurun paling cepat dan gagal persis ketika kasus rutin berubah menjadi kasus tepi | Gerbang human-in-the-loop yang dipasang pada titik penilaian yang sesungguhnya, bukan dicap pada setiap output tanpa memandang taruhannya |
Membangun Langkah Penangkal yang Benar-Benar Berhasil
Latihan Manual yang Disengaja
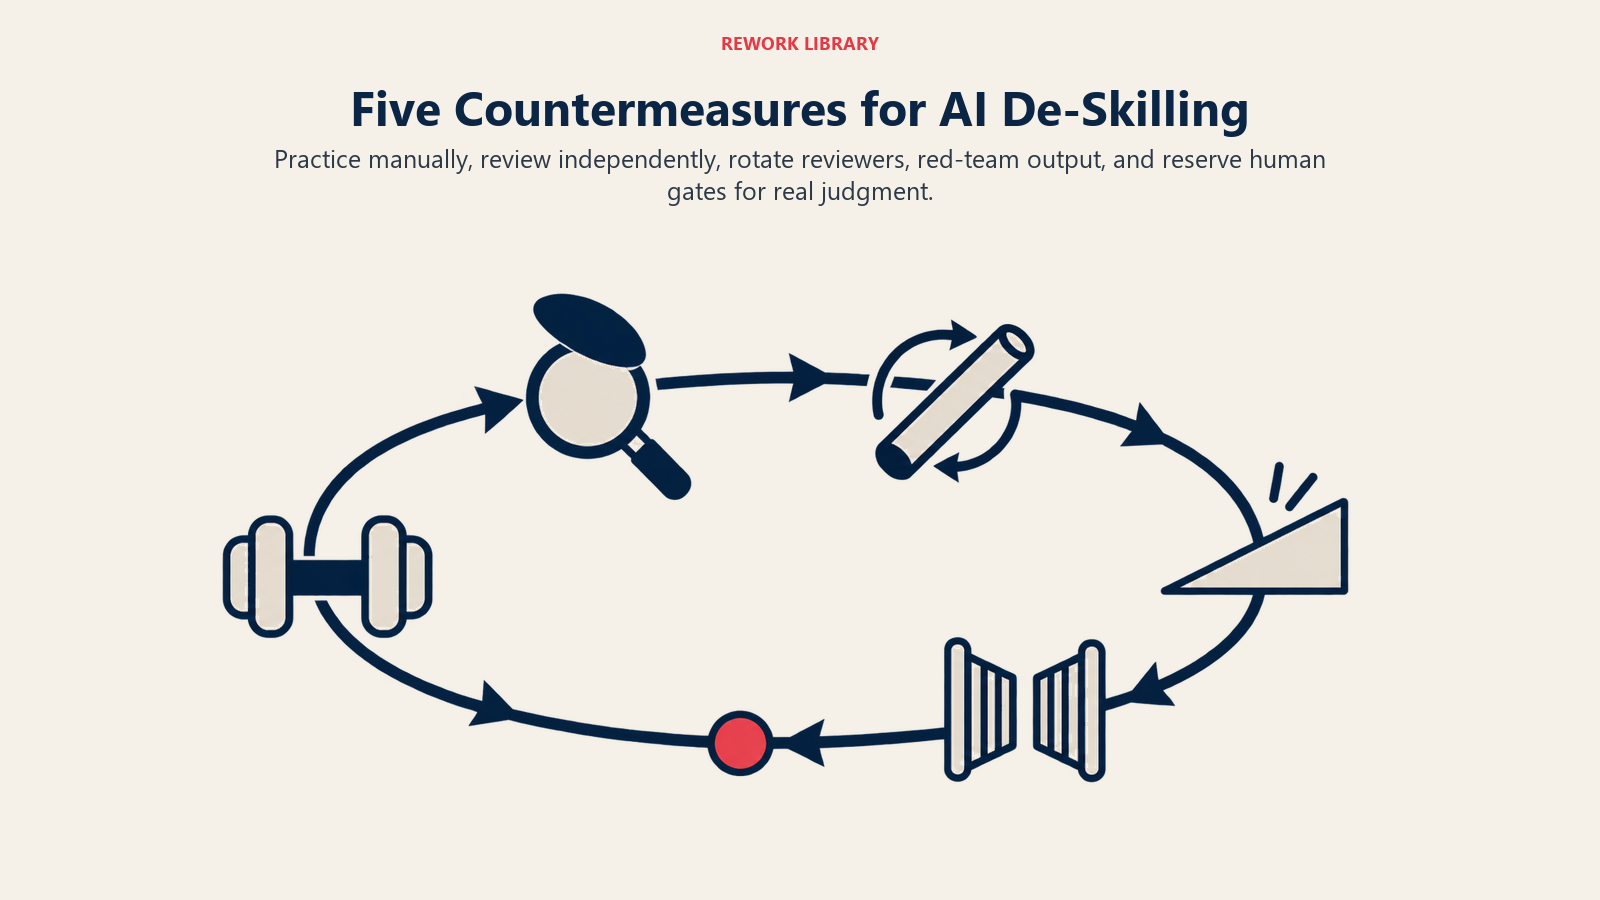
Solusi penerbangan dapat digeneralisasi dengan mulus: jadwalkan repetisi manual dengan sengaja, terpisah dari apakah pekerjaan membutuhkannya hari ini. Tim keuangan yang membiarkan AI membangun setiap model tetap perlu meminta analis membangun beberapa dari nol setiap kuartal. Tim dukungan yang membiarkan AI menyusun setiap balasan tetap perlu meminta orang menulis sebagian tanpa bantuan, khusus untuk menjaga keterampilan dasarnya tidak menjadi sepi. Tujuannya bukan nostalgia mengerjakan hal dengan cara lambat. Tujuannya menjaga mesin pengenalan pola tetap hangat agar bisa menyadari ketika cara cepat menghasilkan sesuatu yang salah.
Tinjauan Blind-First
Kebiasaan paling berdaya ungkit tinggi melawan automation bias adalah pengurutan: bentuk pandangan Anda sendiri sebelum melihat pandangan AI. Baca klausul kontrak, perkirakan angkanya, atau buat sketsa argumennya dulu, lalu bandingkan catatan dengan apa yang dihasilkan model. Membalik urutan itu, melihat jawaban AI lalu mencoba menilainya, adalah susunan persis yang menurut riset Skitka dan Mosier paling buruk dihadapi orang, karena jawaban yang fasih menjangkarkan penilaian sebelum penilaian sempat terbentuk secara independen.
Merotasi Peninjau
Kepuasan diri makin dalam semakin lama orang yang sama meninjau alur kerja AI yang sama. Rotasikan siapa yang melakukan pemeriksaan akhir pada proses berbantuan AI yang berulang, bahkan ketika peninjau "ahli" secara teknis lebih berkualifikasi. Peninjau baru belum membangun kepercayaan (atau titik buta) yang datang dari berbulan-bulan AI cukup sering benar sehingga berhenti dipertanyakan dengan ketat. Ini perbaikan struktural, bukan pelatihan, dan berhasil justru karena tidak bergantung pada tekad satu orang mana pun.
Red-Teaming Output AI sebagai Rutinitas, Bukan Respons Insiden
Perlakukan pengujian adversarial atas pekerjaan buatan AI seperti tim keamanan memperlakukan penetration testing: terjadwal, bukan dipicu hanya setelah ada yang rusak. Ambil sampel output AI setiap siklus dan coba patahkan dengan sengaja, temukan asumsi yang salah, klaim yang tidak didukung, kasus tepi yang terlewat. Red-teaming untuk AI agent dari Rework membahas mekanismenya khusus untuk sistem agentik, tetapi disiplinnya berlaku sama baiknya untuk satu memo atau spreadsheet yang disusun AI. Intinya bukan menangkap setiap kesalahan; melainkan menjaga otot pemeriksaan skeptis tetap aktif dipakai agar ada ketika kesalahan nyata muncul tanpa jadwal.
Human-in-the-Loop untuk Penilaian, Bukan Sekadar Stempel
Gerbang human-in-the-loop hanya sepadan dengan hambatan yang ditambahkannya jika manusia di gerbang itu benar-benar menjalankan penilaian, bukan sekadar mengeklik setuju. Gerbang yang dipasang pada setiap output, tanpa memandang taruhannya, melatih orang menyetujui secara refleks, kebalikan dari efek yang dimaksud. Sediakan titik persetujuan manusia untuk keputusan dengan konsekuensi nyata, dan padukan masing-masing dengan konteks yang cukup agar peninjau punya sesuatu untuk benar-benar dievaluasi. Guardrail AI agent dan observabilitas atas apa yang sebenarnya dilakukan agent yang baik sama-sama membantu di sini, karena peninjau yang bisa melihat penalarannya punya lebih banyak untuk diperiksa daripada yang menatap jawaban akhir tanpa jejak di belakangnya. Keliru dalam merancang gerbang ini juga masalah budaya: tim yang menghukum orang yang menandai kesalahan AI akan melatih semua orang lain berhenti menandai, yang diam-diam menghancurkan seluruh tujuan memiliki manusia dalam lingkaran.
Apa yang Sebaiknya Dilakukan Pemimpin dengan Ini
Tidak ada dari ini yang berargumen untuk memakai AI lebih sedikit. Tim dengan penilaian paling tajam lima tahun dari sekarang adalah yang memakai AI secara intensif dan memperlakukan pemeliharaan keterampilan sebagai praktik yang disengaja dan dianggarkan, bukan kebetulan dari apa pun yang ditinggalkan alat itu. Masukkan latihan manual ke kalender seperti pilot memasukkan pelatihan berulang. Susun tinjauan agar manusia membentuk pandangan sebelum melihat pandangan mesin. Rotasikan orang yang melakukan tinjauan itu. Jadwalkan red-teaming alih-alih menunggu kegagalan memaksanya. Dan bangun kepercayaan pada AI itu sendiri yang dikalibrasi dengan apa yang benar-benar telah diraihnya, bukan dengan seberapa percaya diri dan fasih ia terdengar. Tidak satu pun dari ini investasi besar secara individual. Jika semuanya dilewatkan, hasilnya adalah tim yang tidak lagi bisa membedakan kapan mesin salah, pada hari yang paling penting.

Co-Founder, Rework.com
On this page
- Fakta Utama
- Paradoks De-Skilling, Didefinisikan
- Automation Bias dan Kepuasan Diri: Mengapa Kita Berhenti Memeriksa
- Apa yang Sebenarnya Dilakukan Automation Bias pada Sebuah Keputusan
- Kepuasan Diri Adalah Default, Bukan Pengecualian
- Cognitive Offloading dan Biayanya
- Temuan MIT Media Lab, dan Batas Nyatanya
- Efek Kepercayaan dari Microsoft dan Carnegie Mellon
- Dua Preseden yang Sudah Kita Punya Buktinya
- Penerbangan: Apa yang Terjadi Ketika Pilot Berhenti Menerbangkan Secara Manual
- GPS dan Erosi Diam-Diam Memori Spasial
- Mengapa Ini Paling Menghantam Verifikasi
- Membangun Langkah Penangkal yang Benar-Benar Berhasil
- Latihan Manual yang Disengaja
- Tinjauan Blind-First
- Merotasi Peninjau
- Red-Teaming Output AI sebagai Rutinitas, Bukan Respons Insiden
- Human-in-the-Loop untuk Penilaian, Bukan Sekadar Stempel
- Apa yang Sebaiknya Dilakukan Pemimpin dengan Ini