Confianza cuando su compañero de equipo es una IA
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
Confiar en un compañero de IA significa calibrar cuánto depende usted de lo que produce según la evidencia de lo fiable que es realmente en una tarea concreta, y no según lo seguro que suene. Es una habilidad distinta de confiar en un colega, porque una IA no tiene intención de engañar ni una carrera en juego si se equivoca, lo que elimina las dos señales que las personas usan normalmente para decidir a quién creer.
La mayoría de los consejos sobre «confiar en la IA» saltan directo a las políticas: redactar una guía de uso, añadir una regla de divulgación y listo. Eso es necesario, pero no es la parte difícil. La confianza con un compañero humano y la confianza con un compañero de IA funcionan con mecánicas casi totalmente distintas, y los equipos que pasan por alto la diferencia acaban atrapados en uno de dos modos de fallo costosos: rehacer en silencio todo lo que toca la IA, o dar el visto bueno sin mirar a resultados que resultan estar equivocados con total seguridad. Este artículo explica por qué difieren las mecánicas, ambos modos de fallo con la investigación que los respalda, cómo se ve la confianza calibrada en la práctica, qué la construye realmente y las normas de equipo que la hacen duradera.
Por qué confiar en una IA es un problema distinto de confiar en una persona
La confianza humana se apoya en un fundamento simple y bien estudiado: uno observa la capacidad de alguien, su integridad y si parece preocuparse por sus intereses (benevolencia), a lo largo de suficientes situaciones como para que surja un patrón. Tratamos ese modelo en profundidad en cómo generar confianza en el lugar de trabajo. El mecanismo funciona porque una persona tiene intención: puede decidir engañarle, y la posibilidad de que la descubran, de un costo para su reputación, es parte de lo que mantiene honestas a la mayoría de las personas.
Un sistema de IA no tiene ninguna de las dos partes de ese mecanismo. No pretende engañarle cuando se equivoca y no tiene una reputación que proteger ni una carrera en juego. Eso no es un defecto moral, es simplemente otro tipo de sistema, pero significa que los atajos que la gente usa normalmente para decidir en quién confiar (¿esta persona tiene buenas intenciones?, ¿tiene algo que perder si no cumple?) sencillamente no se aplican. Lo que le queda es evaluar algo más cercano a un instrumento de medición que a un colega: cuán preciso es, en qué condiciones y cómo se sabe cuándo se ha desviado.
Seguro y equivocado se ve idéntico a seguro y acertado
El problema más agudo es la presentación. Una persona que no está segura de una respuesta suele indicarlo con rodeos, con el tono o con el lenguaje corporal. Un modelo de lenguaje grande produce una cita inventada, una cifra errónea o una frase fabricada exactamente con el mismo registro fluido y seguro que una correcta. Esta es la mecánica central de la alucinación de la IA: el sistema no está mintiendo, está generando texto verosímil, y verosímil y verdadero no son la misma propiedad. Nada en lo seguro que suene el resultado le dice cuál de los dos tiene delante.
Ese único hecho es la razón por la que la confianza en la IA no puede limitarse a extender la confianza en las personas. Hacen falta señales externas, evidencia de pruebas, un historial en una tarea concreta, fuentes que se puedan comprobar, porque la señal interna que los humanos leen por instinto como seguridad se ha desacoplado de la fiabilidad real.
Los dos modos de fallo: desconfianza excesiva y confianza excesiva
Los equipos sin un enfoque deliberado no aterrizan en el punto medio. Se van a uno de dos extremos, y ambos son caros de maneras distintas.
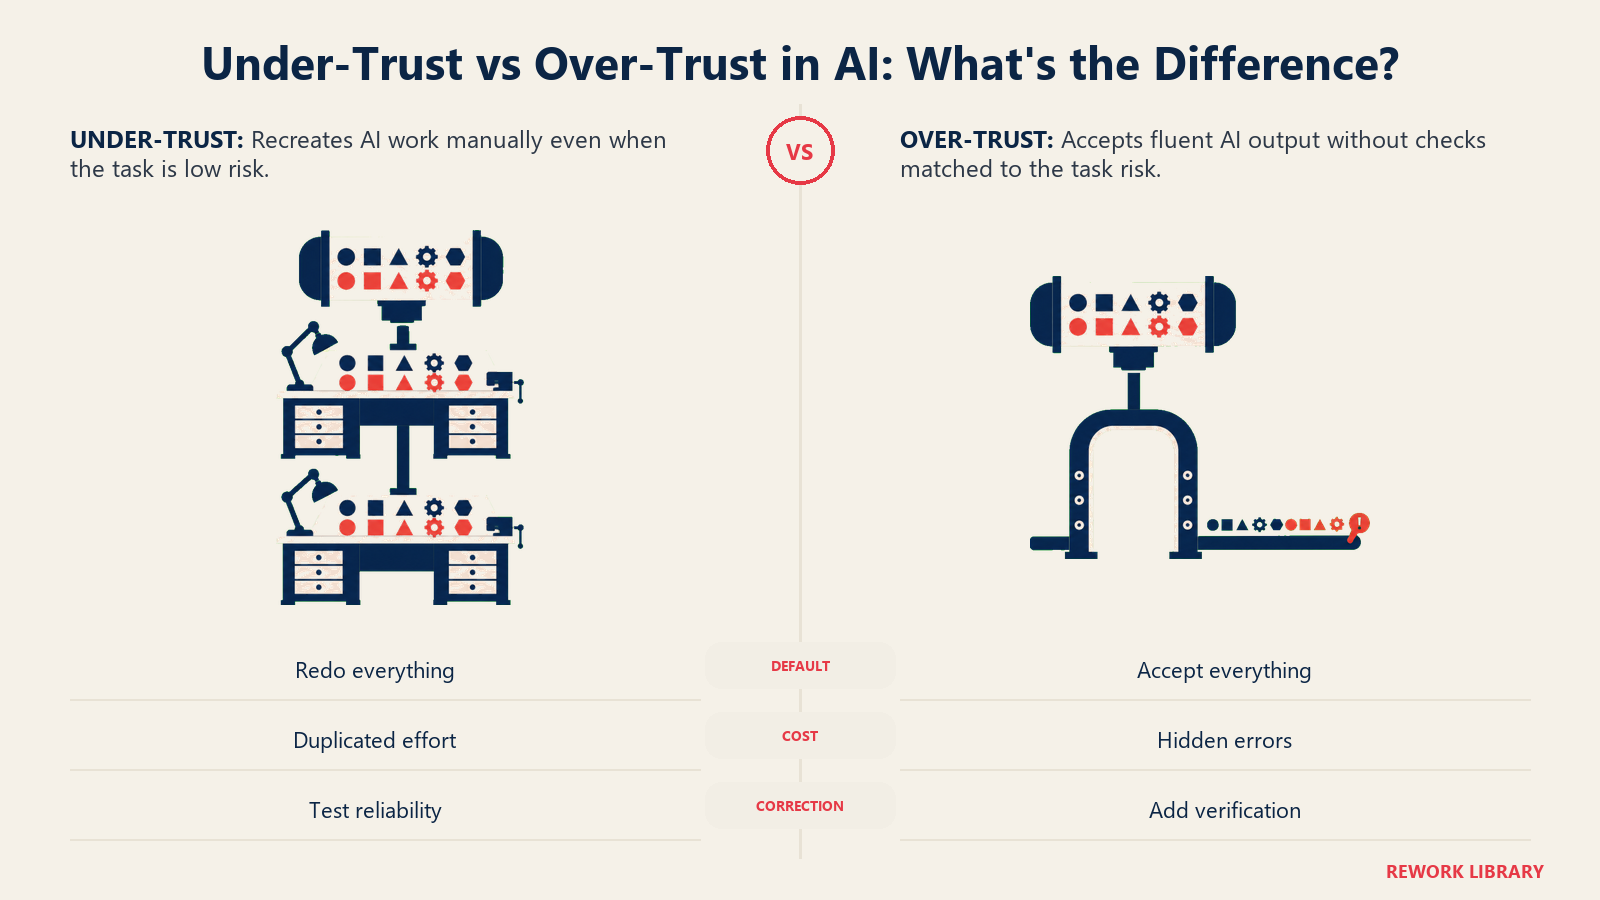
Desconfianza excesiva: rehacer a mano el trabajo del agente
La desconfianza excesiva parece responsable a primera vista. Un gerente revisa cada línea que produce un agente con el mismo escrutinio que aplicaría si no confiara en absoluto en el sistema, haciendo en la práctica el trabajo dos veces. Eso borra la ganancia de productividad que la IA debía aportar. Si revisar un borrador lleva tanto como escribirlo desde cero, la organización ha añadido una herramienta sin cambiar su producción, y quien hace la doble verificación acaba agotado o deja de hacerlo en silencio, lo que solo retrasa el problema de la confianza excesiva en lugar de resolverlo.
La desconfianza excesiva se ve con más fuerza en los equipos que tuvieron una mala experiencia temprana con una herramienta de IA y nunca la revisaron. Un solo dato alucinado y bochornoso en una presentación para un cliente puede congelar durante un año la disposición de un equipo a apoyarse en lo que produce la IA, incluso después de que la herramienta mejore.
Confianza excesiva: el sesgo de automatización y el costo de saltarse la verificación
La confianza excesiva, o sesgo de automatización, es la tendencia a dar a lo que produce un sistema automatizado más peso del que respalda la evidencia, y a dejar de verificar una vez que el sistema ha acertado unas cuantas veces. Es uno de los modos de fallo mejor documentados en la investigación sobre interacción entre humanos y automatización, con décadas de estudios de aviación y seguridad, y empeora, no mejora, a medida que los sistemas de IA progresan, porque un sistema que acierta el 95% de las veces inspira la confianza suficiente para que la gente deje de comprobar el otro 5%.
Un estudio de 2023 en la revista Radiology puso cifras a cuán grave puede llegar a ser esto. Los investigadores hicieron que 27 radiólogos leyeran 50 mamografías, algunas acompañadas de la sugerencia de clasificación BI-RADS de un sistema de IA. Cuando la sugerencia de la IA era errónea, la precisión de los radiólogos con menos experiencia se desplomó de alrededor del 80% a menos del 20%. Los radiólogos con más de 15 años de experiencia tampoco fueron inmunes: su precisión bajó del 82% al 45.5%. La experiencia redujo el daño. No se acercó a eliminarlo.
Ese es un entorno clínico, pero el mecanismo aparece también en el trabajo de conocimiento corriente, con un nombre de menor gravedad: workslop. Una encuesta de septiembre de 2025 a 1,150 trabajadores estadounidenses a tiempo completo, realizada por BetterUp Labs y el Social Media Lab de Stanford, encontró que el 40% había recibido «workslop», contenido generado por IA que parece pulido pero carece de la sustancia para hacer avanzar una tarea, en el mes anterior. Cada incidente llevó en promedio dos horas de resolver, con un costo estimado de $186 por empleado al mes, o aproximadamente $9 millones al año para una empresa de 10,000 personas. El workslop es la confianza excesiva en la práctica: alguien aceptó el borrador de un agente tal cual, lo pasó y dejó la verificación real para quien lo recibiera después.
Datos clave
- La precisión de los radiólogos en la lectura de mamografías cayó de alrededor del 80% a menos del 20% para los lectores con menos experiencia, y del 82% al 45.5% para los lectores con más de 15 años de experiencia, cuando la sugerencia de un sistema de IA era incorrecta, en un estudio de 27 radiólogos que leyeron 50 mamografías. Fuente: Automation Bias in Mammography, Radiology (RSNA), vía EurekAlert
- El 40% de 1,150 trabajadores estadounidenses a tiempo completo encuestados recibió «workslop» generado por IA en el mes anterior; cada incidente costó en promedio dos horas de corrección, un estimado de $186 por empleado al mes, o unos $9 millones al año para una empresa de 10,000 personas. Fuente: BetterUp Labs, "Workslop"
- El 60% de los ejecutivos ya usa IA en la toma de decisiones, pero solo el 5% dice que la gestiona bien, una brecha que Deloitte señala como impulsora de la «deuda cultural» organizacional. Fuente: Deloitte 2026 Global Human Capital Trends
- El 56% de los líderes diseña la IA únicamente para resultados de negocio; solo el 40% la diseña tanto para resultados de negocio como humanos, y el 42% de los trabajadores dice que su organización no está evaluando en absoluto el impacto de la IA en las personas. Fuente: Deloitte 2026 Global Human Capital Trends
- Cuando los gerentes mostraron de forma visible su propio uso de la IA, los empleados reportaron un aumento de 30 puntos en la confianza hacia la IA agéntica y tuvieron 1.4 veces más probabilidades de convertirse en usuarios frecuentes de ella, respaldados por una red de seguridad. Fuente: Microsoft Work Trend Index 2026
Confianza calibrada: confiar, pero verificar, con detalles concretos
Los investigadores que estudian la interacción entre humanos y automatización usan el término confianza calibrada (también llamada dependencia adecuada) para el estado objetivo entre los dos modos de fallo: aceptar lo que produce un sistema cuando la evidencia dice que es fiable y cuestionarlo cuando la evidencia dice que no lo es, tarea por tarea y no como una política general. La distinción que importa aquí es entre confianza y dependencia. La confianza es lo que alguien dice creer sobre un sistema; la dependencia es lo que realmente hace con lo que este produce. La investigación encuentra de forma constante que ambas se separan: alguien puede decir que no confía del todo en una herramienta de IA y aun así actuar sobre lo que produce sin comprobarlo, porque verificar exige esfuerzo y el camino de menor resistencia es aceptar.
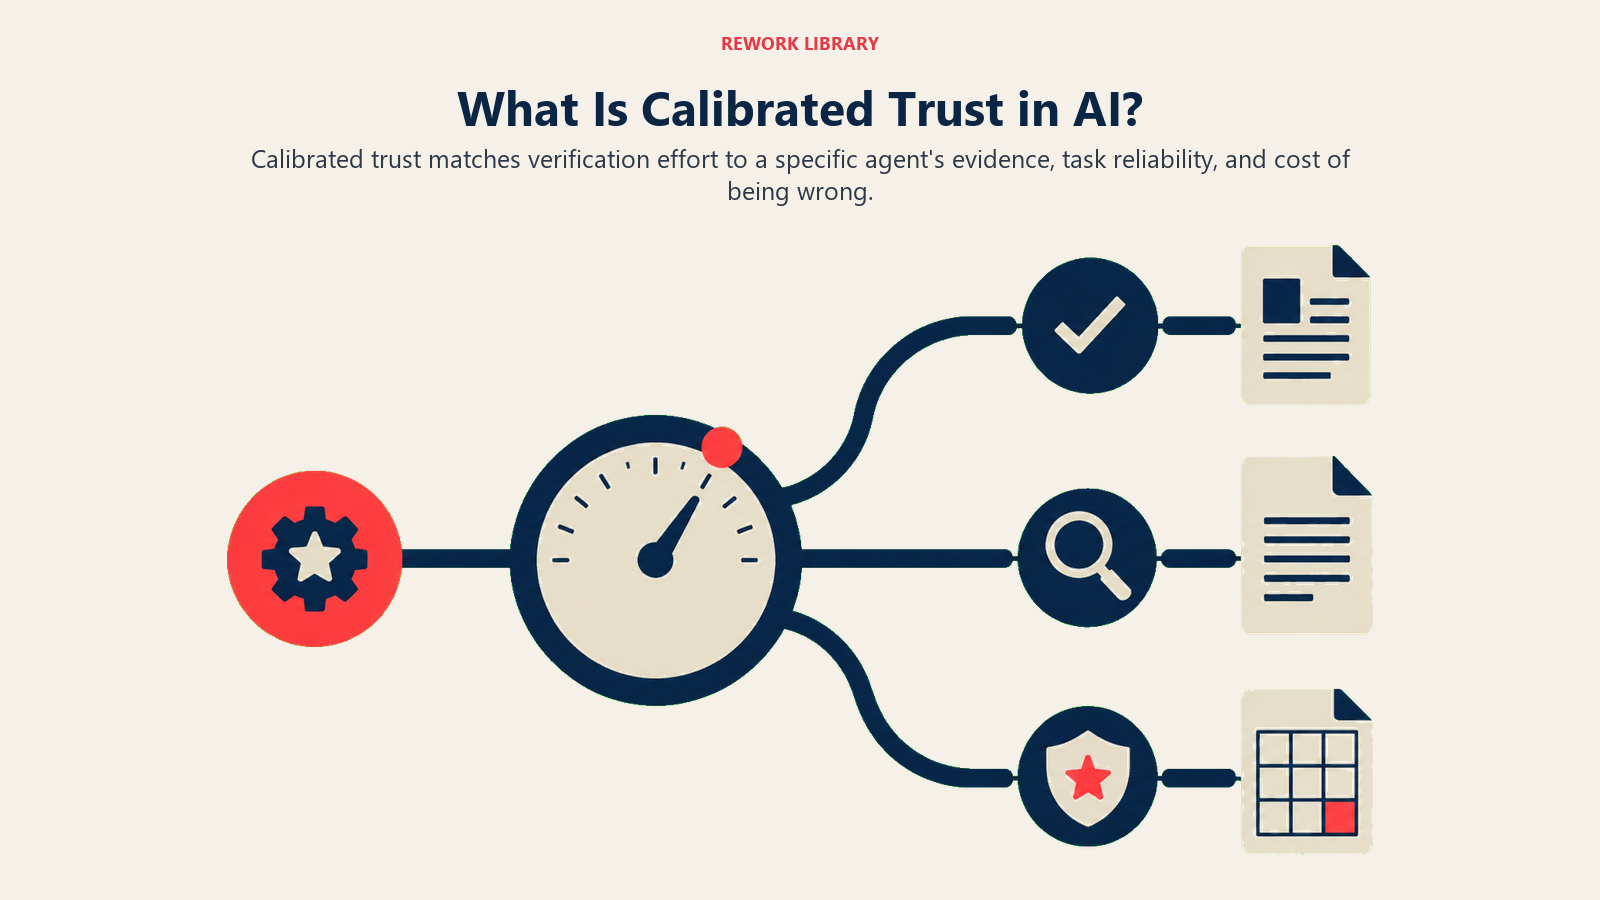
La calibración solo funciona cuando es específica de la tarea, no de la herramienta en su conjunto. Un agente que redacta de forma fiable un primer resumen de reunión tiene un perfil de fiabilidad completamente distinto al del mismo modelo al que se le pide calcular una proyección financiera o citar un precedente legal. «¿Confiamos en la IA?» es la pregunta equivocada. «¿Confiamos en este agente, en esta tarea, según lo que hemos visto que acierta y que falla?» es la útil.
Sepa dónde es fiable el agente y dónde no
Construir esa imagen a nivel de tarea exige un seguimiento deliberado, no intuición. Un equipo que ha notado en silencio que un agente acierta los primeros borradores de correos rutinarios pero inventa con frecuencia estadísticas en los resúmenes de investigación ha hecho un trabajo real de calibración, aunque nadie lo haya escrito. La brecha que tienen la mayoría de los equipos no está en notarlo, sino en hacer ese conocimiento explícito y compartido en lugar de que viva en la cabeza de una sola persona, para que un recién llegado no repita el error de confianza excesiva que el resto del equipo ya aprendió a evitar.
Cómo es la verificación en el día a día
En concreto, esto significa comprobar por muestreo las afirmaciones con fuente antes de que un documento salga al exterior, contrastar cualquier cifra que produzca un agente con una referencia conocida y tratar un primer borrador como un borrador por editar, no como algo que se reenvía tal cual. Nada de eso exige rehacer el trabajo desde cero, que es lo que separa la confianza calibrada de la desconfianza excesiva: verificación dirigida donde se sabe que el agente es débil y aceptación segura donde se sabe que es fuerte.
Qué construye una confianza adecuada en la IA
Cuatro cosas llevan de forma fiable a un equipo de adivinar a calibrar, y ninguna es una sesión de formación única.
Transparencia. Un agente que muestra sus fuentes, señala su nivel de confianza o explica los pasos que siguió le da a la persona algo real que evaluar, en lugar de una respuesta final pulida que aceptar o rechazar por fe. Los equipos que trabajan con herramientas que muestran su razonamiento o sus citas tienden a calibrar más rápido que los equipos atrapados con una caja negra que solo devuelve un resultado de aspecto limpio.
Historial. La confianza en un recién contratado se construye observando cómo maneja situaciones reales a lo largo de semanas. La confianza en un agente debería construirse igual, llevando un registro honesto de lo que acertó y falló en tipos de tarea concretos, y no suponiendo que el desempeño de la primera semana predice el de la semana doce.
Salvaguardas. Es más fácil extender la confianza cuando el costo de un error está acotado. Un agente limitado a redactar, no a enviar; a recomendar, no a ejecutar un pago; a señalar, no a cerrar automáticamente un ticket, da a las personas margen para verificar antes de que ocurra algo irreversible. Profundizamos en cómo delimitar esa autoridad en las salvaguardas para agentes de IA.
Human-in-the-loop por diseño, no por defecto. Hay una diferencia real entre un flujo de trabajo con un punto de control colocado deliberadamente donde los errores más importan y uno en el que una persona simplemente echa un vistazo al resultado porque siempre se ha hecho así. El human-in-the-loop bien hecho coloca el punto de control en el lugar de mayor palanca, no en todas partes, que es justo lo que causa en primer lugar el modo de fallo de la desconfianza excesiva.
El ángulo del equipo y la cultura: normas compartidas sobre cuándo verificar
Nada de lo anterior funciona si vive en la cabeza de una sola persona cuidadosa. El punto de fallo real en la mayoría de los equipos no es que nadie sepa que hay que verificar lo que produce un agente, sino que no existe una respuesta compartida y explícita a «quién comprueba qué, y cuándo», así que cada uno recurre a su propio instinto, y los instintos varían enormemente. Una persona comprueba todo por muestreo; otra reenvía los borradores del agente sin mirarlos dos veces; ninguna sigue una norma escrita, porque no existe.
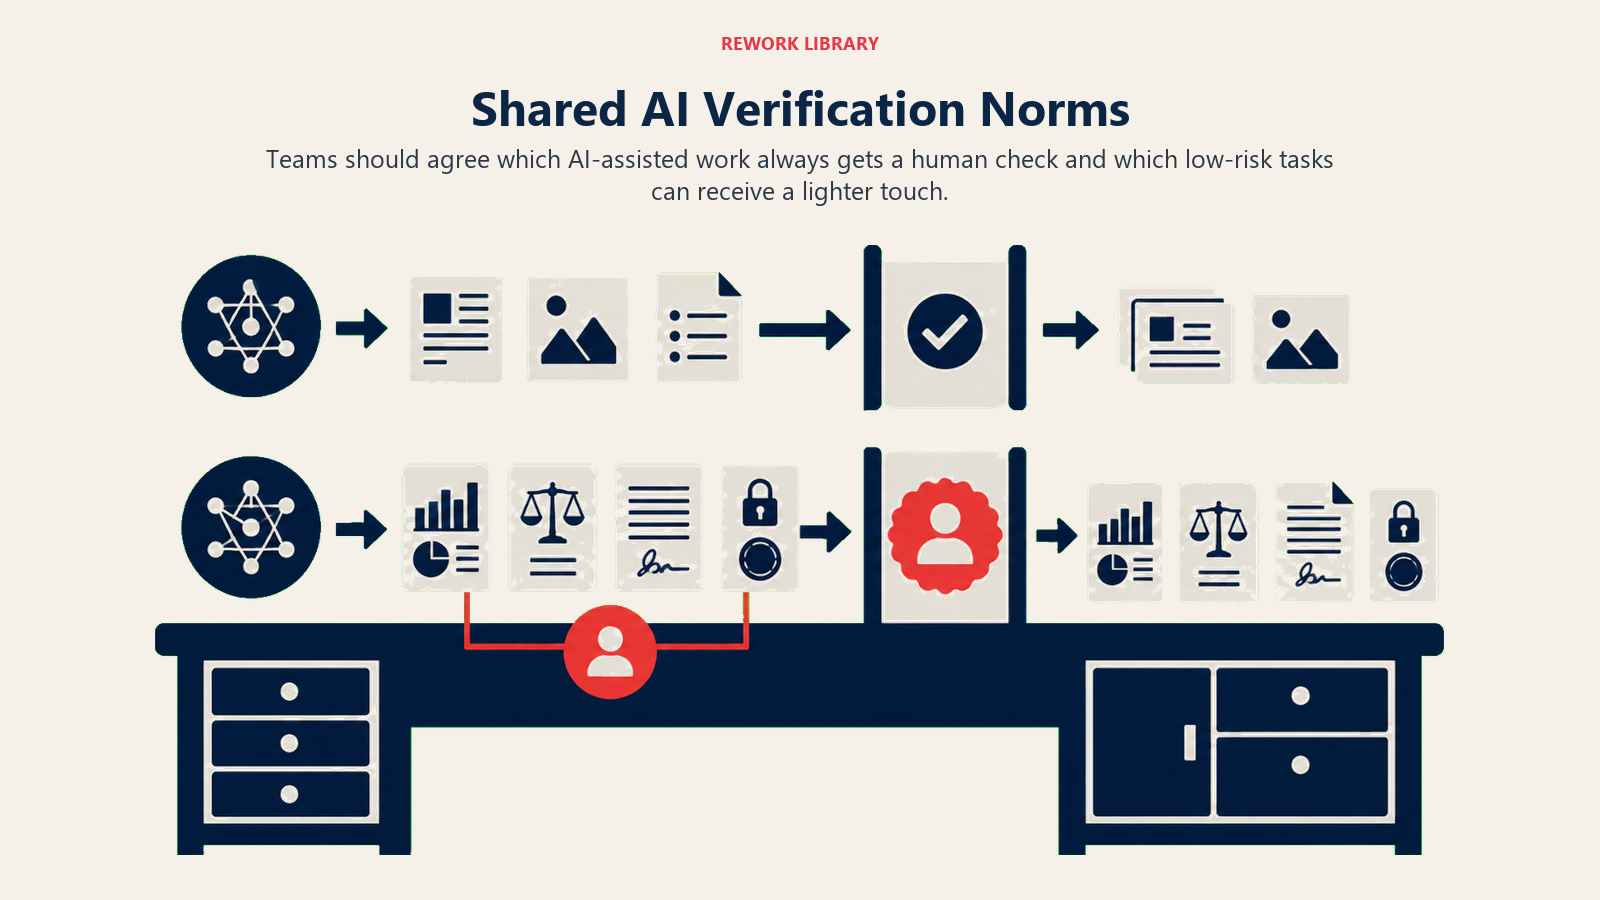
Esto es de lleno un problema de cultura, no de herramientas. La etiqueta de la IA y las normas del lugar de trabajo trata el conjunto más amplio de reglas no escritas que los equipos están negociando en torno a la divulgación y el uso adecuado; la versión específica de la confianza consiste en acordar, en voz alta, qué categorías de trabajo siempre reciben una revisión humana antes de que ocurra algo externo (cifras para clientes, lenguaje legal, cualquier cosa irreversible) y cuáles son de bajo riesgo como para un toque ligero. Equivocarse en esa división en cualquier dirección reproduce uno de los dos modos de fallo anteriores a nivel de equipo y no de individuo.
Las mismas normas importan más, no menos, a medida que los agentes dejan de ser herramientas que opera una persona y pasan a formar parte de la producción real del equipo, el cambio que se trata en equipos de humanos y agentes. Un equipo sin normas de confianza compartidas no falla de forma estruendosa. Acumula el tipo de brecha que Deloitte llama deuda cultural de la IA: dependencia excesiva silenciosa en algunos rincones, doble verificación redundante silenciosa en otros, y nadie con una imagen clara de qué ocurre dónde hasta que un error visible obliga a tener la conversación. Acertar con esto es una pieza del cambio más amplio que se trata en cómo es realmente la cultura nativa de IA, donde la confianza, la responsabilidad y la rendición de cuentas hay que reconstruirlas a propósito.
Nada de esto es exclusivo de las empresas con equipos dedicados de IA. Un negocio de cinco personas que usa un agente para redactar correos de prospección necesita la misma respuesta explícita a «quién revisa esto antes de que salga» que una empresa de mil personas. Lo que está en juego crece con el tamaño de la empresa; el problema de la calibración, no.
Próximos pasos
- Cómo generar confianza en el lugar de trabajo, los modelos de confianza entre personas con los que este artículo contrasta
- Equipos de humanos y agentes, qué cambia cuando un agente pasa a formar parte de la producción real y no solo es una herramienta
- Deuda cultural de la IA, qué ocurre cuando nunca se construyen normas de confianza y la brecha se acumula
- Etiqueta de la IA y normas del lugar de trabajo, el conjunto más amplio de reglas no escritas que los equipos negocian en torno al uso de la IA
- ¿Qué es la cultura nativa de IA?, el panorama completo de cómo cambian la confianza y la rendición de cuentas cuando los agentes son compañeros de equipo
- ¿Qué es la IA agéntica?, cómo planifican y actúan estos sistemas, parte de por qué sus errores se ven distintos de los de una simple herramienta
- Alucinación de la IA, el mecanismo específico detrás de los resultados seguros, fluidos y erróneos
- Human-in-the-loop, cómo diseñar el punto de control en lugar de dejarlo a la costumbre
Preguntas frecuentes sobre confiar en la IA en el trabajo
¿En qué se diferencia confiar en una IA de confiar en un compañero de trabajo?
La confianza en una persona se construye observando con el tiempo su capacidad, su integridad y si parece preocuparse por sus intereses, en parte porque una persona tiene algo que perder si le engaña. Un sistema de IA no tiene ni intención de engañar ni una reputación en juego, así que esos atajos no se aplican, y un resultado seguro y fluido puede estar tan equivocado como acertado.
¿Qué es el sesgo de automatización?
El sesgo de automatización es la tendencia a dar a lo que produce un sistema automatizado más peso del que respalda la evidencia, y a dejar de verificarlo de forma independiente una vez que el sistema ha acertado unas cuantas veces. Es uno de los modos de fallo más estudiados en la investigación sobre humanos y automatización, y tiende a empeorar a medida que mejora la precisión del sistema, porque un sistema que suele acertar hace que las personas detecten menos las veces que se equivoca.
¿Cuál es la diferencia entre desconfiar en exceso y confiar en exceso en la IA?
La desconfianza excesiva significa rehacer a mano el trabajo de una IA por costumbre, lo que borra la ganancia de productividad que la herramienta debía aportar. La confianza excesiva significa aceptar lo que produce la IA sin verificarlo porque suena seguro, que es como el «workslop» y los errores de hecho generados por IA llegan al trabajo terminado. La confianza calibrada está entre ambas: verificar donde la evidencia dice que la IA es débil y aceptar donde dice que es fuerte.
¿Qué significa «confianza calibrada» en la práctica?
La confianza calibrada significa ajustar cuánto se depende de lo que produce un sistema de IA según la evidencia real y específica de la tarea sobre su fiabilidad, y no según lo seguro que suene. Exige hacer seguimiento de lo que un agente concreto acierta y falla en tipos de tarea concretos, y ajustar en consecuencia el esfuerzo de verificación en lugar de aplicar una regla general de «confiar siempre» o «verificar siempre».
¿Qué es el «workslop» y cómo se relaciona con la confianza en la IA?
El workslop es contenido generado por IA que parece pulido pero carece de la sustancia para hacer avanzar una tarea, un término acuñado por investigadores de BetterUp Labs y del Social Media Lab de Stanford. Es un síntoma directo de la confianza excesiva: alguien aceptó un borrador de IA sin el escrutinio suficiente y lo pasó, dejando la verificación para quien lo recibiera después, lo que según una encuesta de 2025 cuesta un estimado de $9 millones al año a una empresa de 10,000 personas.
¿Tener más experiencia hace inmune al sesgo de automatización?
No, reduce el daño pero no lo elimina. Un estudio de 27 radiólogos encontró que, cuando la sugerencia diagnóstica de una IA era errónea, la precisión de los lectores con menos experiencia bajó de alrededor del 80% a menos del 20%, mientras que la de los lectores con más de 15 años de experiencia cayó del 82% al 45.5%. La experiencia ayuda a las personas a detectar más errores, pero no vuelve inmune a nadie a una recomendación equivocada dada con seguridad.
¿Cómo ayuda el diseño human-in-the-loop a construir una confianza adecuada?
El human-in-the-loop funciona cuando el punto de control se coloca deliberadamente donde un error importaría más, por lo general antes de que ocurra algo externo o irreversible, y no como un vistazo reflejo a todo lo que toca un agente. Bien hecho, permite a un equipo extender una confianza real a las partes de un flujo de trabajo que no necesitan revisión y aun así detectar los errores que realmente costarían algo.
¿Cuál es el primer paso para un equipo que aún no ha fijado normas de confianza en la IA?
Ser explícito, como equipo, sobre qué categorías de trabajo asistido por IA siempre reciben una revisión humana antes de que ocurra algo externo (cifras para clientes, lenguaje legal, cualquier cosa irreversible) y cuáles son de bajo riesgo como para un toque más ligero. La mayoría de los equipos ya tiene una respuesta informal que vive en los hábitos de una persona cuidadosa; el trabajo consiste en volverla compartida y coherente en lugar de un instinto individual.
La confianza en un compañero de IA no debería ser un sentimiento privado que lleva quien más de cerca la observa. Conviértala en una medición: haga seguimiento de dónde el agente es fiable y dónde no, y comparta esa lectura con todo el equipo para que la confianza esté calibrada y no supuesta. Los equipos que lo hacen dejan de oscilar entre la fe ciega y la sospecha generalizada, y empiezan a usar el agente exactamente para lo que se ha ganado, ni más ni menos.

Co-Founder, Rework.com
On this page
- Por qué confiar en una IA es un problema distinto de confiar en una persona
- Seguro y equivocado se ve idéntico a seguro y acertado
- Los dos modos de fallo: desconfianza excesiva y confianza excesiva
- Desconfianza excesiva: rehacer a mano el trabajo del agente
- Confianza excesiva: el sesgo de automatización y el costo de saltarse la verificación
- Datos clave
- Confianza calibrada: confiar, pero verificar, con detalles concretos
- Sepa dónde es fiable el agente y dónde no
- Cómo es la verificación en el día a día
- Qué construye una confianza adecuada en la IA
- El ángulo del equipo y la cultura: normas compartidas sobre cuándo verificar
- Próximos pasos