人間の判断力を鋭く保つ:職場のAIがもたらす「スキル喪失のパラドックス」
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
スキル喪失のパラドックスとは、次のようなものです。チームが思考をAIに任せれば任せるほど、いま最も必要なスキル、つまりAIが間違ったときにそれを見抜く力において、判断力が弱まっていきます。検証、すなわちもっともらしく聞こえる誤りに気づく力は、かつて一から作業を生み出すことで鍛えられていたのと同じ「頭の筋肉」に依存しています。生成を任せて練習を省けば、その筋肉は衰えます。それでいて、その筋肉を必要とする仕事(機械のチェック)は、依然として人間の机の側にしっかり残ったままです。
これは予測ではありません。航空、ナビゲーション、そしてナレッジワークそのものに関する初期の研究にまたがる、数十年分のエビデンスに裏づけられたパターンです。それらのエビデンスのどれも、AIが人を恒久的に思考の苦手な人にするとは言っていません。示されているのは、タスクが「自分がやる」から「システムがやって、自分がチェックする」へ移るたびに、特定の、よく記録されたメカニズムが働き出すということであり、そのメカニズムは、存在を知っていれば管理できるということです。
重要なポイント
- 自動化バイアスには2つの失敗モードがあり、トレーニングで直せるのはそのうち1つだけです。 Skitka、Mosier、Burdickの最初の研究では、人は見落としエラー(自動化が示さなかったものを見逃す)と実行エラー(他の証拠が矛盾していても自動化の助言に従う)の両方を犯すことがわかり、意識向上のトレーニングは実行エラーを減らしたものの、見落としエラーは減らしませんでした。Does Automation Bias Decision-Making? (Skitka, Mosier & Burdick)
- MIT Media Labの「Your Brain on ChatGPT」は、LLMを使って文章を書いたグループで脳の結合性が弱いことを見出しましたが、小規模で査読を経ていないプレプリントです。 参加者は54人で、EEGで測定された認知的関与は、LLMでエッセイを書いたグループで最も低く、脳だけで書いたグループで最も高くなりました。著者自身が、サンプルサイズと査読がないことを実際の限界として挙げています。MIT Media Lab, "Your Brain on ChatGPT"
- Microsoft ResearchとCarnegie Mellonによる、319人のナレッジワーカーを対象とした調査では、AIへの信頼が高いほど、報告された批判的思考が少なくなりました。 AIがタスクをうまくこなすと信頼するほど、その出力に適用する批判的な精査は少なくなったと答え、一方で自分自身の能力への自信は逆の方向に動きました。Microsoft Research, "The Impact of Generative AI on Critical Thinking"
- 生涯のGPS利用が多いほど、GPSなしで移動するときの空間記憶が悪くなることが予測されます。 マギル大学による50人の日常的なドライバーを対象とした研究でこの関係が見出され、一部の人を対象とした3年後の追跡調査では、最初のテスト以降にGPSの利用が増えたことが、海馬に依存する空間記憶のより急な低下と結びついており、その逆ではありませんでした。Dahmani & Bohbot, Scientific Reports (Nature)
- 航空当局は、手動操縦スキルの喪失を軸に、10年以上にわたって政策を構築してきました。 FAAのFlight Deck Automation Working Groupと国際機関(ICAO、EASA)は、手動操縦スキルの低下と自動化への対応意識の低下を、操縦不能に至るインシデントの一因として特定し、手動飛行と自動化故障のトレーニングを義務づけるに至りました。FAA Air Carrier Training ARC report
スキル喪失のパラドックスとは
あらゆる職業に、同じルールの何らかの形があります。悪い答えを見抜く力は、自分自身で十分な数の良い答えと悪い答えを生み出すことで身につく、というものです。放射線科医は何年もフィルムを読み続けて初めて、ひと目で何かがおかしいとわかるようになります。編集者は、自分で何百本もの出来の悪い初稿を書くことで、弱い論証への感覚を養います。このパターンを見分ける感覚が判断力であり、それは指導ではなく反復によって築かれます。多くの人にとっては、それは仕事のなかでも労働ではなく職人技のように感じられる部分でもあります。だからこそ、反復を失うことはスキル以上のものを失うことになります。AI時代における意味、アイデンティティ、職人技は、その2つ目の、測定されにくい損失を扱っています。
AIは、その反復の経済性を変えます。モデルが10秒でやってくれるのに、なぜ初稿を書き、手で計算し、契約書を全文読む必要があるのか。単一のタスクだけを見れば、手作業の反復を省くのは明らかに効率的な選択です。しかし判断力は、数千の小さな反復から築かれる複利で増える資産であり、反復を省くことは積立を省くことでもあります。それをチーム、職種、キャリアの段階にわたって一貫して行えば、経験豊富な人を価値ある存在にしていた蓄積された判断力が、蓄積されなくなります。
パラドックスとは、これが生み出す二重の拘束のことです。AIが最も役立つのは、手作業では退屈で時間のかかるタスクであり、それらはまた、AIの仕事をチェックするために必要な判断力を築くタスクでもあります。AIに最も深く頼るチームは、今日の出力スピードを高める一方で、明日の誤りを見抜く能力を静かに損なっています。どちらの影響も、その瞬間には目に見えません。スピードはすぐに現れますが、判断力のギャップは数か月後に、たいていはAIが重要なことについて自信満々に間違えた最初のときに現れます。
自動化バイアスと慢心:なぜ私たちは確認をやめるのか
自動化バイアスは意思決定に実際に何をもたらすのか
自動化バイアスとは、自動化された提案を、天秤にかけるべきもう1つの情報としてではなく、自分で根拠を確認する作業の代替として扱ってしまう、よく知られた傾向です。Linda Skitka、Kathleen Mosier、Susan Burdickは、参加者を模擬的な飛行監視タスクに置く一連の研究を行いました。高い(ただし完全ではない)信頼性を持つ自動化支援を併用する参加者と、使わない参加者がいました。支援なしの人のほうが、全体としてより多くの誤りを見つけました。支援ありの人は、支援が示さなかった事象を見逃し(見落としエラー)、さらに印象的なことに、矛盾する情報が目の前にあるにもかかわらず、支援の助言に従うことがありました(実行エラー)。
彼らの発見で心をざわつかせるのは、これらの誤りが、支援が完全には信頼できないと参加者に明示的に告げられた後でも続いたことです。システムが間違いうると頭で理解していても、それに対する行動が確実に変わるわけではありません。自動化バイアスの失敗モードを具体的に取り上げたトレーニングだけが実行エラーを減らしましたが、そのトレーニングでさえ、見落としエラーはほとんど手つかずのままでした。チームに「覚えておいて、間違うことがありますよ」と伝えるだけでは、それ自体では解決策になりません。
慢心は例外ではなく、既定の状態である
慢心は、自動化バイアスのもっと静かな親戚です。間違った答えを積極的に信じるのではなく、気づけるほど注意深く見ていない状態です。これは、そうでなければ警戒を怠らないプロセスの中での気の緩みではなく、既定の状態です。警戒にはコストがかかり、流暢で自信に満ちたAIの答えは、脳が「もう一度見る必要はない」と判断するのに使うあらゆるシグナルを与えるからです。これが、AIチームにおける心理的安全性の背後にあるメカニズムです。その記事は、AIの出力への疑念を声に出して言えるほど安全だと感じているかを扱っています。本稿が扱うのは、その上流にあるもの、つまり、そもそも疑うべき何かがあると気づけるだけの研ぎ澄まされた判断力を、まだ持っているかどうかです。チームが声を上げるのに最大限安全であっても、誤りを見抜くパターン認識のスキルを誰も保っていなければ、見逃してしまうことがあります。
認知的オフロードとそのコスト
認知的オフロード、つまり頭の中で行う代わりに、精神的なタスクを外部のツールに任せることは、新しいものではなく、本質的に悪いものでもありません。メモを取る、電卓を使う、事実を調べるといったことはすべてオフロードですが、そのどれも読み書きや算数の力を損なうことはありませんでした。生成AIで異なるのはその範囲です。記憶や計算だけでなく、論証、分析、意思決定の実際の組み立てまでオフロードするもので、それは判断力を築く思考の、はるかに大きな割合を占めます。
MIT Media Labの発見と、その本当の限界
MIT Media Labの広く共有された「Your Brain on ChatGPT」研究は、LLMを使う、検索エンジンを使う、あるいはツールをまったく使わずにエッセイを書く人々のEEGによる脳の結合性を測定しました。脳だけのグループは、最も強く、最も広く分布した神経活動を示し、LLMグループは最も弱い活動を示しました。これは本当に興味深い初期のシグナルであり、誇張せず誠実に報じられるべきものです。参加者は54人、エッセイを書くタスクは1つだけ、ここで論じているバージョンの時点では査読を経ておらず、著者自身も結果を確定した科学として扱うことに注意を促しています。AIの利用が脳を配線し直す証拠としてではなく、真剣に受け止める価値のある仮説として読んでください。この段階では、統計的な確実性よりも、発見の方向性のほうが重要です。それは、後述する航空やナビゲーションの研究にも独立して現れるメカニズム(能動的な構築が少なく、能動的な関与が少ない)と一致しています。
MicrosoftとCarnegie Mellonによる信頼の効果
より頑健なのは、実験室のタスクではなく実際の仕事を調べているため、Microsoft ResearchとCarnegie Mellonによる、319人のナレッジワーカーを対象とし、仕事で生成AIを使った実際の936件の事例を記述した研究です。その中心的な発見は、AIがタスクをこなす能力への信頼が高い人ほど、その結果に適用した批判的思考が少なかったと報告し、一方で自分自身の能力への自信は逆の方向に動いた、というものです。研究者たちは、生成AIによって批判的思考の姿が、答えを生み出すことから、答えを検証し、統合し、管理することへ移ること、そしてAIが生成したものを実際に検査し改善するスキルを持たない人ほど、この新たな検証のステップを最も飛ばしやすいことも見出しました。この最後の点が、パラドックスを一文にしたものです。AIの誤りを見抜くための装備が最も乏しい人は、それを見抜くスキルを築いたはずの作業を、最も多くオフロードしてしまった人であることが多いのです。
すでにエビデンスのある2つの先例
ナレッジワークにとって、この問題は新しいものです。他の2つの領域はそうではなく、どちらも、スキルが自動化に委ねられ、実践されなくなったときに何が起きるかについて、数十年分の測定データがあります。
航空:パイロットが手動操縦をやめたとき何が起こるか
現代の旅客機は、ほぼ全行程を自動操縦で飛ぶことができ、パイロットは作業負荷と燃料消費を減らすために、まさにそうすることがよくあります。当局が最終的に向き合わなければならなかったトレードオフはこうです。手動操縦と故障認識のスキルは、使わなければ低下します。そして、いくつかの深刻なインシデントは、自動化が最悪のタイミングで操縦を人間に返した、まさにそのシナリオを乗務員が最近練習していなかったことに、一部起因していました。FAAのFlight Deck Automation Working Groupはこのパターンを十分に明確に記録し、業界全体の訓練基準を作り変えました。基礎となるスキルが衰えないよう、義務としての手動飛行セグメントと自動化故障の訓練を追加したのです。解決策は「自動化を減らす」ではありませんでした。「その仕事が今は必要としていなくても、スケジュールに沿って、意図的にスキルを練習する」ことでした。
GPSと、空間記憶の静かな衰え
ナビゲーションは、より明快で、より長期にわたる自然実験を提供します。何百万人もの人が、20年にわたってそれを行ってきたからです。マギル大学の研究は、日常的に運転する人々の空間記憶を測定し、生涯のGPS経験が多い人ほど、自力でのナビゲーションタスク、つまり曲がり角ごとの指示ではなく頭の中の地図を必要とするタスクの成績が悪いことを見出しました。3年後に、より小さなグループで行われた追跡調査では、因果の方向が見出されました。その間にGPSの利用を増やした人は、海馬に依存する空間記憶がより急に低下しており、これは、もともと方向感覚が悪くてツールに頼りがちだったからでは説明できませんでした。そのメカニズムは、ナレッジワークで見られるものとほぼ同じです。GPSはナビゲーションを、経路の内的モデルを築き更新することから、刺激と反応の指示に従うこと(「200メートル先を右折」)へと変えてしまいます。そのため、内的モデルを築くスキルは、単に使われなくなるのです。
なぜこれは検証に最も強く響くのか
以下のあらゆる対策は、1つの構造的な問題から存在しています。検証は、このパターンが最も速く蝕むスキルであり、同時に、AI自身には誰も任せられない唯一のスキルでもあるということです。間違っているときを確実に教えてくれるようモデルに頼むことはできません。AIハルシネーションの研究は、自信に満ちた、流暢で、間違った答えは、外から見れば、自信に満ちた、流暢で、正しい答えとまったく同じに見えることを明確にしています。もっともらしいAIの誤りと、高くつく意思決定の間に立っているのは、何かがおかしいと気づくだけのパターン認識の鋭さをまだ持っている人間だけであり、その鋭さは、AIの導入が取り除く、まさにその種の手作業の反復によって築かれます。モデルがいずれ自分の誤りを見つけるだろうと考えるのではなく、その鋭さを意図的に社内に保つと決めることは、どの接点を人間のままにするかを決める人間ならではの付加価値が扱うのと同じ計算です。
ここは、パラドックスが個人の問題にとどまらず、チーム全体で積み重なる場所でもあります。1人の判断力が鈍れば、それは個人のリスクです。チーム全体の集合的な判断力が、全員が同じAIワークフローを一緒に導入したために、同じタスクで同時に鈍れば、すり抜けたものを見抜く研ぎ澄まされた直感を持つ人が、部屋に誰もいなくなります。それは構造的なリスクであり、人とエージェントのチームがスキルの維持を、個人の習慣ではなくチームレベルの設計課題として考える必要がある理由です。
| リスクにさらされる能力 | どのように衰えるか | 対策 |
|---|---|---|
| 初稿の組み立て(執筆、分析、コード) | 手作業の試みを省くと、誤った答えがどう見えるかというパターン認識を築く反復がなくなる | AIのほうが速くできる場合でも、決まった頻度で意図的に手作業の練習を行う |
| 他者(あるいはAI)の出力におけるエラー検出 | 自動化バイアスと慢心により、流暢な答えが、流し読みしただけなのに確認済みのように感じられる | ブラインドファーストのレビュー:AIが何を出したかを見る前に、人間が独立した答えにたどり着く |
| 較正された信頼(いつ押し返すべきかを知ること) | MicrosoftとCMUの信頼の効果の発見のとおり、AIへの信頼が自分自身の判断力への自信に取って代わる | レビュアーをローテーションし、特定のAIワークフローへの誰か1人の信頼が、長く疑われないままにならないようにする |
| 特定のシステムやアカウントに関する領域の直感 | 同じ人が同じ繰り返しのタスクで常に従うと、慢心が積み重なる | AIの出力を定期的にレッドチーミングし、敵対的なチェックをインシデント対応ではなく日常的なメンテナンスとして扱う |
| 曖昧さの中での判断(AIが学習していないケース) | 手動操縦型のスキル喪失:めったに練習されない判断力が最も速く衰え、定型のケースが例外に変わるまさにそのときに機能しなくなる | ヒューマンインザループのゲートは、リスクの大きさにかかわらずすべての出力に押すのではなく、本当に判断が必要な地点に置く |
実際に機能する対策を築く
意図的な手作業の練習
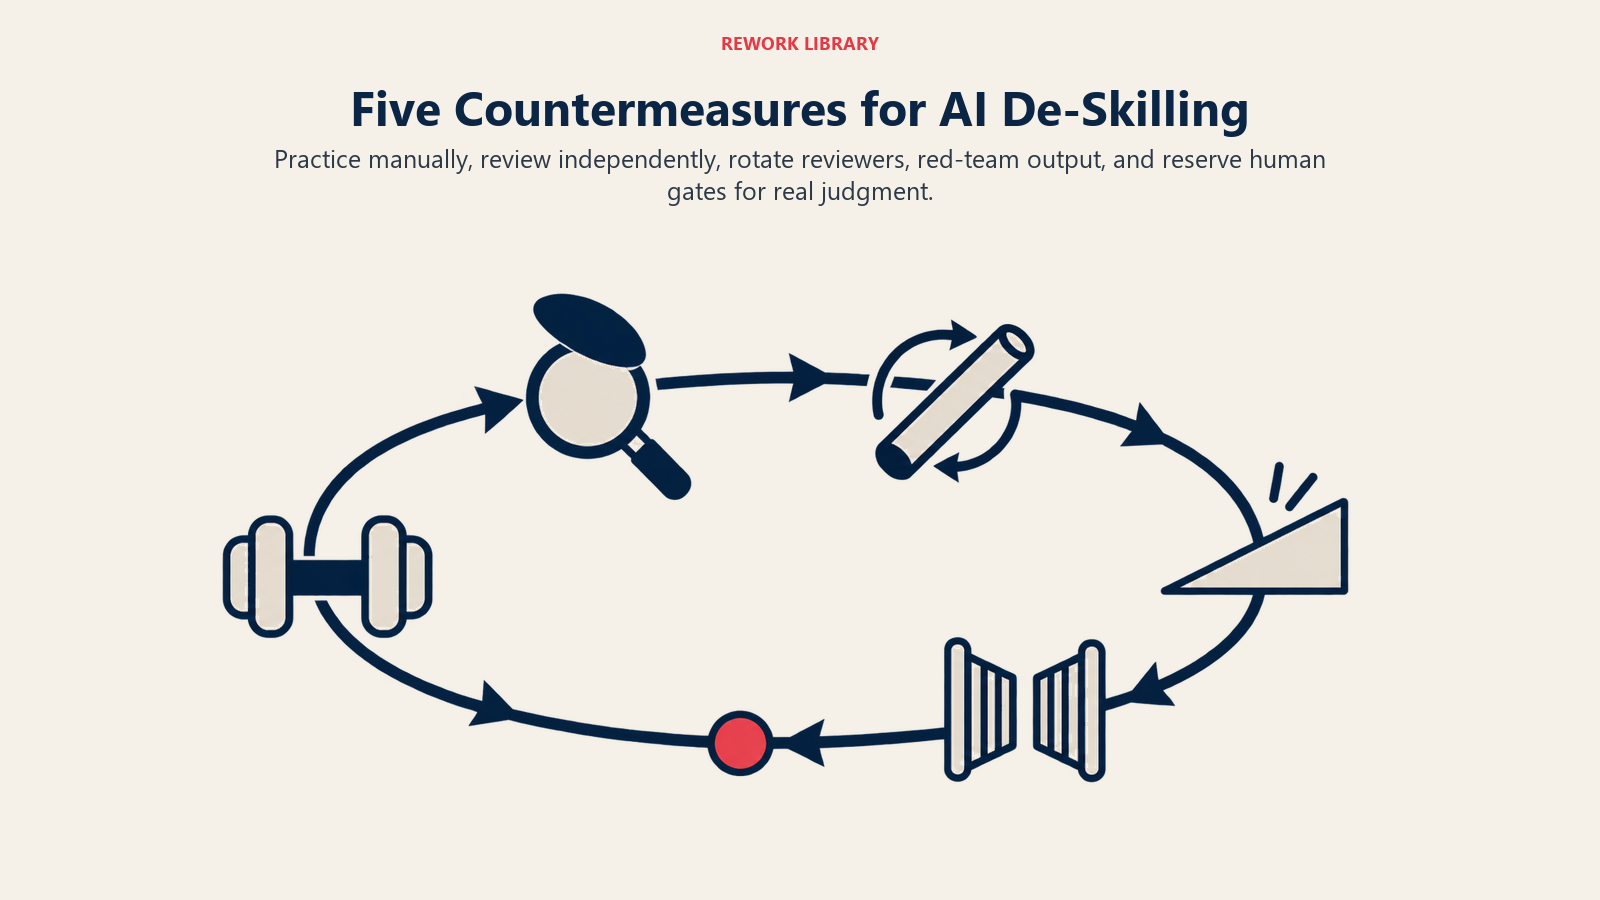
航空の解決策は、きれいに一般化できます。その仕事が今日それを必要とするかどうかとは切り離して、手作業の反復を意図的にスケジュールすることです。AIにすべてのモデルを作らせる財務チームでも、四半期ごとにアナリストが一から数本のモデルを構築するべきです。AIにすべての返信を起草させるサポートチームでも、基礎となるスキルが鈍らないよう、あえて何人かが支援なしで書くべきです。目的は、ゆっくりとしたやり方への郷愁ではありません。速いやり方が間違ったものを生んだときに気づけるよう、パターン認識の仕組みを十分に温めておくことです。
ブラインドファーストのレビュー
自動化バイアスに対する最もレバレッジの高い習慣は、順序です。AIの見解を見る前に、自分の見解を形づくることです。契約書の条項を読み、数字を見積もり、論点を描き出してから、モデルが出したものと見比べます。この順序を逆にして、AIの答えを見てからそれを評価しようとするのは、SkitkaとMosierの研究が、人が最も苦手とすることを示しているまさにその状況です。流暢な答えが、判断が独立して形づくられる機会を得る前に、判断を引きずってしまうからです。
レビュアーのローテーション
慢心は、同じ人が同じAIワークフローをレビューし続けるほど深まります。たとえ「専門家」のレビュアーのほうが技術的により適任であっても、繰り返し行われるAI支援プロセスの最終チェックを担当する人を交代させてください。新しいレビュアーは、AIが何か月も十分な頻度で正しかったために、もはや厳しく疑われなくなることで生じる信頼(や盲点)を、まだ築いていません。これは研修ではなく構造による対策であり、誰か1人の意志力に依存しないからこそ機能します。
AI出力のレッドチーミングを、インシデント対応ではなく日常業務に
AIが生成した成果物の敵対的テストを、セキュリティチームがペネトレーションテストを扱うのと同じように扱ってください。何かが壊れた後にだけ発動するのではなく、スケジュールに沿って行います。サイクルごとにAIの出力のサンプルを選び、意図的に壊そうとし、誤った前提、裏づけのない主張、見落としたエッジケースを見つけます。ReworkのAIエージェントのレッドチーミングは、特にエージェント型システムのための手法を扱っていますが、その規律は、AIが起草した1通のメモや1枚のスプレッドシートにも同じように当てはまります。目的はすべての誤りを見つけることではありません。懐疑的な精査という筋肉を使い続け、予定外に本当の誤りが現れたときに、それが働くようにしておくことです。
判断のためのヒューマンインザループであり、ただの承認印ではない
ヒューマンインザループのゲートは、そこにいる人間が承認ボタンを押すだけでなく、実際に判断を働かせている場合にのみ、それが加える手間に見合います。リスクの大きさにかかわらずすべての出力にゲートを置くと、人は反射的に承認するよう訓練されてしまい、意図とは逆の効果になります。人間による承認ポイントは、実際に影響の大きい意思決定のために確保し、それぞれに、レビュアーが実際に評価できるだけの文脈を添えてください。優れたAIエージェントのガードレールと、エージェントが実際に何を行ったかへの可観測性は、どちらもここで役立ちます。推論の過程が見えるレビュアーは、背後に履歴のない最終的な答えを見つめているレビュアーよりも、確認できることが多いからです。このゲートを誤ることは、文化の問題でもあります。AIの誤りを指摘した人を罰するチームは、他の全員に指摘をやめるよう訓練してしまい、人間をループに置くことの意味そのものを、静かに骨抜きにします。
リーダーはこれを実際にどう活かすべきか
これは、AIの利用を減らすべきだという主張ではありません。5年後に最も鋭い判断力を持つチームは、AIを大いに使いつつ、スキルの維持を、ツールがたまたま残したものの偶然の産物ではなく、意図的で予算を伴う実践として扱ったチームです。パイロットが定期訓練を組み込むのと同じように、手作業の練習をカレンダーに組み込んでください。人間が機械の見解を見る前に自分の見解を形づくるように、レビューを構成してください。そのレビューを行う人を交代させてください。失敗に迫られるのを待つのではなく、レッドチーミングをスケジュールに入れてください。そして、AIがどれほど自信に満ちて流暢に聞こえるかではなく、実際に得た信頼の度合いに較正された、AI自体への信頼を築いてください。これらのどれも、個別には大きな投資ではありません。まとめて省けば、最も重要な日に、機械が間違っているかどうかをもはや見分けられないチームになります。
スキル喪失とAIに関するよくある質問
AI導入におけるスキル喪失のパラドックスとは何ですか。
AIにタスクを任せることで、同じAIの誤りを見抜くために必要な判断力が蝕まれるというパターンです。誤った答えを見つけるスキルは、手作業で仕事をこなすことで築かれますが、AIの利用はそれを減らすからです。
自動化バイアスとは何ですか。また、慢心と同じですか。
自動化バイアスとは、自動化された提案を、根拠を独立して確認する作業の代替として扱うことで、Skitka、Mosier、Burdickの研究では、見落としエラーと、反対の証拠があるにもかかわらず悪い助言に従うことの両方が生じることがわかっています。慢心は密接に関連していますが、より微妙です。システムを積極的に過信するのではなく、何かがおかしいと気づけるほど注意深く見ていない状態です。
MITの「Your Brain on ChatGPT」研究は、AIが人を愚かにすることを証明していますか。
いいえ。これは、1つのエッセイ作成タスクの間のEEGによる脳の結合性を測定した、小規模(参加者54人)で査読を経ていないプレプリントであり、著者自身がその限界を指摘しています。他のエビデンスと一致する有益な初期のシグナルですが、全般的な認知機能の低下を証明するものではありません。
これは、AIチームの心理的安全性という視点とどう違うのですか。
AIチームにおける心理的安全性は、AIの出力に疑問を声に出して問える安全さを感じているかどうかに関するものです。これは、そもそも疑問を持つに値するものに気づく力を保っているかどうかに関するものです。チームが声を上げるのにまったく安全だと感じていても、基礎となる判断力を誰も鋭く保っていなければ、誤りを見逃すことがあります。
ブラインドファーストのレビューとは何ですか。なぜ効果があるのですか。
AIが出したものを見る前に、タスクについて自分の独立した判断を形づくり、そのうえで比較することです。先にAIの答えを見ると、評価がそれに引きずられ、自動化バイアスが起こりやすくなります。順序を逆にすることで、判断が実際に働くプロセスの部分を守ることができます。
なぜ、毎回最も経験豊富な人を使うのではなく、レビュアーをローテーションするのですか。
同じ人が同じAIワークフローをレビューし続けるほど慢心が深まるからです。AIが何か月も正しいと、その人がどれほど注意深く確認するかが損なわれます。新しいレビュアーは、その信頼やそれに伴う盲点をまだ築いていないため、ローテーションは個人の規律に依存しない構造的な対策になります。
スキルを守るために、チームはAIの利用を減らすべきだということですか。
必ずしもそうではありません。エビデンスは、AIを大いに使いながら、手作業の練習、ブラインドファーストのレビュー、ローテーション、レッドチーミングを意図的にスケジュールすることを示しています。航空業界が、自動操縦をなくすのではなく、自動化を維持したまま手動飛行の訓練義務を加えたのと同じです。
「判断のためのヒューマンインザループであり、ただの承認印ではない」とは、実際にどういう意味ですか。
承認のゲートを、影響の大きい意思決定のために確保し、レビュアーが実際に評価できるだけの文脈と推論の過程を与えるということです。リスクの大きさにかかわらずすべての出力にゲートを加えると、人は考えるのではなく反射的に承認するよう訓練されてしまいます。

Co-Founder, Rework.com
On this page
- 重要なポイント
- スキル喪失のパラドックスとは
- 自動化バイアスと慢心:なぜ私たちは確認をやめるのか
- 自動化バイアスは意思決定に実際に何をもたらすのか
- 慢心は例外ではなく、既定の状態である
- 認知的オフロードとそのコスト
- MIT Media Labの発見と、その本当の限界
- MicrosoftとCarnegie Mellonによる信頼の効果
- すでにエビデンスのある2つの先例
- 航空:パイロットが手動操縦をやめたとき何が起こるか
- GPSと、空間記憶の静かな衰え
- なぜこれは検証に最も強く響くのか
- 実際に機能する対策を築く
- 意図的な手作業の練習
- ブラインドファーストのレビュー
- レビュアーのローテーション
- AI出力のレッドチーミングを、インシデント対応ではなく日常業務に
- 判断のためのヒューマンインザループであり、ただの承認印ではない
- リーダーはこれを実際にどう活かすべきか