Seguridad psicológica en equipos con IA: seguro para cuestionar, seguro para decir que no
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
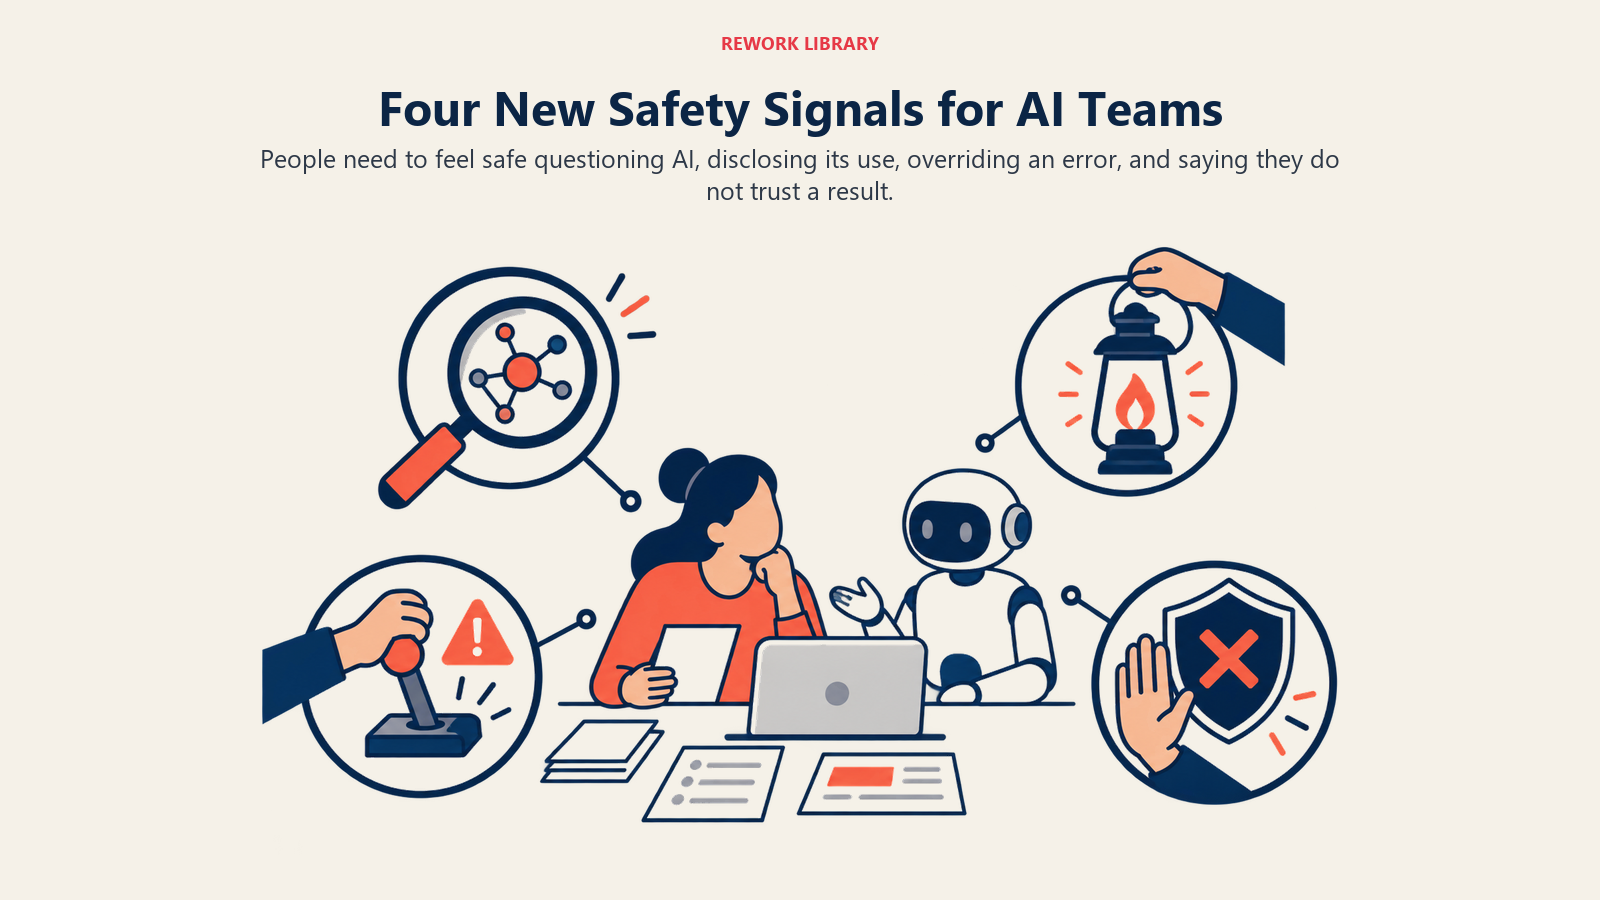
La seguridad psicológica en equipos con IA es el concepto original de Amy Edmondson, la convicción compartida de que un equipo es un lugar seguro para asumir riesgos interpersonales, extendido a un nuevo conjunto de riesgos que solo existen cuando la IA hace parte del trabajo. Significa que las personas se sienten seguras de cuestionar el resultado de un agente, de admitir que usaron IA en una tarea, de señalar un error de la IA o anular su recomendación, y de decir con claridad "no confío en este resultado", sin que nada de eso les cueste estatus, credibilidad o una mala anotación en su historial.
Edmondson construyó su carrera estudiando por qué las personas callan en hospitales, cabinas de avión y salas de directorio, incluso cuando hablar salvaría una vida o un proyecto. El mecanismo que encontró, que el silencio es una respuesta racional ante una sala que castiga el riesgo, se traslada casi intacto a la IA. Antes nadie necesitaba permiso para desconfiar de una hoja de cálculo. Hoy una parte creciente de la fuerza laboral necesita justamente ese permiso, y la mayoría de los equipos nunca lo ha concedido en voz alta. Este artículo cubre lo genuinamente nuevo de la seguridad en equipos humano-IA, por qué el sesgo de automatización y la deferencia excesiva son el modo de fallo que aparece cuando falta, investigación real sobre por qué las personas dejan de preguntar "por qué", y qué hacen los líderes para reconstruirla.
Ampliar el modelo de Edmondson: cuatro cosas nuevas que las personas necesitan sentirse seguras de decir
El modelo original de cuatro etapas de Edmondson, seguridad de inclusión, del aprendiz, del colaborador y del retador, se construyó en torno a interacciones entre personas. Ese modelo completo se trata en seguridad psicológica en el trabajo. Cuando un agente de IA pasa a ser una parte activa del equipo, en lugar de una herramienta que alguien usa en silencio por su cuenta, las mismas cuatro etapas deben ampliarse para abarcar un nuevo conjunto de momentos que Edmondson no tuvo que modelar en 1999, porque aquello que se cuestionaba era siempre un colega.
Seguro para cuestionar el resultado de la IA
Alguien mira lo que produjo un agente y tiene la molesta sensación de que algo no cuadra: una cifra que no coincide con su intuición, una cita que suena demasiado limpia, un paso que esperaría que una persona señalara. La seguridad del retador, en el modelo de Edmondson, es la etapa en la que las personas se sienten libres de cuestionar el plan o a la persona a cargo. La versión de esa etapa en un equipo con IA es cuestionar a la máquina, y tiene un costo social distinto: nadie queda mal por dudar de la idea de un colega de la misma forma en que puede parecer lento o paranoico por poner en duda un sistema que "todos los demás" parecen aceptar sin comentarios.
Seguro para admitir que usó IA
Este riesgo está más cerca de la seguridad de inclusión y del aprendiz. Usar IA en un borrador, un resumen o un análisis no es una confesión, pero en muchos equipos se trata como tal, porque nadie ha dicho en voz alta que no lo sea. Una persona que oculta su uso de la IA no miente por malicia; está leyendo bien la sala si esa sala nunca ha hecho que divulgarlo se sienta seguro. Ese silencio tiene un costo directo: el gerente pierde visibilidad sobre cómo se produjo realmente el trabajo, y por lo tanto no puede detectar justo el modo de fallo del que trata este artículo.
Seguro para señalar un error de la IA o anular su recomendación
Un agente se equivoca, o una persona anula lo que recomendó y hace algo distinto. Ambos son momentos de seguridad del colaborador, usar su criterio y lograr que cuente, pero ahora implican anular un sistema que fue adquirido, configurado y probablemente promovido por alguien de mayor rango. Señalar el error de una persona arriesga una conversación incómoda. Señalar o anular el error de un sistema arriesga parecer que no confía en la inversión que la empresa acaba de hacer en él, un riesgo distinto y a menudo más pesado de cargar a solas.
Seguro para decir "no confío en este resultado"
Esta es la frase que más importa, y la que la mayoría de los equipos tiene menos práctica en decir. No es una afirmación técnica sobre la precisión; es una declaración de incertidumbre de una persona que se supone que debe verse competente y decidida. Decirla sobre el trabajo de un colega es incómodo, pero es un terreno conocido. Decirla sobre un sistema que produjo una respuesta rápida, fluida y de aspecto profesional, sin que nadie más en la sala objete nada, es el riesgo interpersonal genuinamente nuevo que da nombre a este artículo.
Sesgo de automatización y deferencia excesiva: el nuevo modo de fallo
Esta es la parte que la mayoría de los consejos sobre seguridad psicológica pasa por alto por completo. Cuando un equipo no se siente seguro con la IA, el fallo no se ve como un conflicto. Se ve como acuerdo. Todos asienten, el resultado sale, y el equipo parece perfectamente alineado hasta que el error aflora en algún lugar costoso.
Qué es realmente el sesgo de automatización
Los investigadores Linda Skitka, Kathleen Mosier y Malcolm Burdick dieron nombre a este patrón en un estudio de 1999 que sigue siendo la cita de referencia del campo: el sesgo de automatización, la tendencia a aceptar el resultado de un sistema automatizado como sustituto de la verificación vigilante que una persona haría por su cuenta. Su investigación, realizada en una tarea simulada de monitoreo de vuelo, encontró algo lo bastante específico como para importar aquí: las personas cometían dos tipos distintos de errores. Errores de omisión, no notar un problema porque el sistema automatizado no lo señalaba. Y errores de comisión, seguir activamente una recomendación automatizada aunque otra información a su alcance sugiriera que era errónea. Fuente: Skitka, Mosier & Burdick, "Does Automation Bias Decision-Making?"
Esa segunda categoría es la importante para una conversación sobre cultura. Un error de comisión no es un accidente. Es una persona que elige la respuesta automatizada por encima de su propio criterio, en el momento, a menudo mientras otras señales estaban justo frente a ella. Eso no es una brecha de capacitación. Es una decisión moldeada por lo que la sala a su alrededor hace cómodo decir y hacer.
Por qué la seguridad psicológica es la variable que falta
La mayor parte de lo escrito sobre el sesgo de automatización lo trata como un defecto cognitivo individual, algo que se corrige con una mejor interfaz o un módulo de capacitación. Ese planteamiento pasa por alto por completo el mecanismo a nivel de equipo. Un error de comisión es más fácil de cometer precisamente cuando cuestionar el sistema resulta socialmente costoso y callar parece gratis. Invierta el incentivo y la misma persona, con el mismo cableado cognitivo, se comporta de otra manera. El hallazgo del laboratorio de Skitka y la investigación de campo de Edmondson describen la misma forma desde dos direcciones: el sesgo de automatización muestra que las personas tienden por defecto a aceptar bajo incertidumbre, y la seguridad psicológica muestra qué hace que hablar bajo incertidumbre resulte costoso o gratuito. La deferencia excesiva hacia la IA no es un nuevo tipo de fallo humano. Es el más antiguo de Edmondson, un equipo que castiga la voz y premia el silencio, con una interfaz nueva.
El estudio de los oficiales de crédito: cuando no preguntar "por qué" es el punto
Un estudio de 2026 dirigido por Alex Chan, de Harvard Business School, pone cifras reales a cuán deliberado puede ser ese silencio. Los investigadores pidieron a 2,512 participantes en línea que actuaran como oficiales de crédito y revisaran pares de solicitudes reales de préstamos de $10,000, con un sistema de IA que entregaba un puntaje de riesgo para cada una. Ochenta por ciento de los participantes quiso ver el puntaje de riesgo de la IA, pero solo 46% fue más allá y pidió ver la explicación detrás de este, aunque estuviera a un clic de distancia. Cuando los investigadores asignaron al azar a algunos participantes un bono económico ligado al desempeño real del préstamo en lugar de una tarifa fija, la evitación de la explicación subió 20 puntos porcentuales, y volvió a subir más de 10 puntos adicionales cuando los participantes tenían motivos para creer que la explicación podría revelar que la raza o el género habían influido en el puntaje de la IA. Fuente: HBS Working Knowledge, "When AI Gives Advice, Employees Rarely Ask Why"
La propia formulación de Chan sobre el resultado es la frase en la que vale la pena detenerse: "El mayor riesgo de la IA no son solo las respuestas erróneas o la falta de adopción. Es entrenar a las personas para que dejen de preguntar por qué". Sus participantes no estaban confundidos sobre cómo ver el razonamiento de la IA. Una parte significativa de ellos eligió no mirar, porque mirar arriesgaba sacar a la luz algo inconveniente. Eso no es el sesgo de automatización como un atajo cognitivo pasivo. Es el sesgo de automatización como una elección activa y motivada, facilitada al máximo por un entorno donde los incentivos de nadie premiaban hacer la pregunta más difícil.
Datos clave
- El sesgo de automatización, la tendencia a aceptar el resultado de un sistema automatizado por encima de la verificación vigilante de la propia persona, fue definido por el estudio de 1999 de Skitka, Mosier y Burdick, que halló que las personas cometen tanto errores de omisión (no ver un problema que el sistema no señaló) como errores de comisión (seguir activamente una mala recomendación automatizada pese a evidencia en contra). Fuente: International Journal of Human-Computer Studies, vía ACM
- En un estudio de 2026 con 2,512 participantes que actuaban como oficiales de crédito, 80% quiso ver el puntaje de riesgo de un sistema de IA pero solo 46% pidió ver la explicación detrás de este; la evitación de la explicación subió 20 puntos porcentuales cuando se ligó un bono económico al desempeño del préstamo, y subió más de 10 puntos adicionales cuando la explicación arriesgaba revelar un sesgo racial o de género. Fuente: HBS Working Knowledge
- La investigación de 2026 de Amy Edmondson y Jayshree Seth en Harvard Business Review halló que, pese a las mejoras de productividad que las empresas esperan de la IA, el desempeño de los equipos a menudo empeora: las personas empiezan a dudar de sí mismas y la confianza se erosiona de maneras difíciles de precisar, una dinámica que describen como "ambigüedad de confianza". Fuente: Harvard Business Review
- El Work Trend Index 2026 de Microsoft halló que, cuando los gerentes crearon deliberadamente seguridad psicológica en torno a la experimentación con IA, los empleados reportaron hasta 20 puntos más de preparación para la IA y de valor percibido, y tuvieron 1.4 veces más probabilidades de convertirse en usuarios frecuentes de IA agéntica. Fuente: Microsoft Work Trend Index 2026
- La investigación Global Human Capital Trends 2026 de Deloitte halló que 60% de los ejecutivos ya usa IA en la toma de decisiones, pero solo 5% dice gestionarlo bien, una brecha que se acumula en lo que Deloitte llama deuda cultural de la IA cuando nadie se siente lo bastante seguro para nombrar el problema en voz alta. Fuente: Deloitte 2026 Global Human Capital Trends
Por qué este tipo de silencio es fácil de pasar por alto
El silencio de siempre en las reuniones tiene una forma conocida: alguien tiene una preocupación, la sala se queda callada y todos perciben la tensión aunque nadie la nombre. El silencio en torno a la IA a menudo no se siente como tensión en absoluto. Se siente como un acuerdo fluido, porque deferir a un sistema no tiene el mismo peso social visible que deferir a una persona. Nadie ve a un colega aceptar en silencio la cifra de una IA y lo interpreta como echarse atrás, como interpretaría a alguien que cede ante una voz fuerte en la sala. Eso es lo que lo hace peligroso: un equipo puede parecer perfectamente seguro, con mucho debate abierto sobre todo aquello en lo que sus miembros discrepan, mientras mantiene un punto ciego sin examinar en todo lo que la IA toca.
La investigación de 2026 de Edmondson y Seth nombra el mecanismo directamente: el uso sostenido de la IA puede erosionar en silencio la confianza de una persona en su propia capacidad de cuestionar el resultado de una IA, incluso cuando tiene la pericia exacta para detectar lo que está mal. Es lo contrario de cómo suele funcionar la confianza, ya que un experto en su campo normalmente se vuelve más asertivo con la experiencia, no menos. Ver producirse una y otra vez una respuesta fluida y de aspecto profesional enseña otra lección: que lo que necesita justificación es dudar en aceptarla, no la aceptación misma. Confianza cuando su compañero de equipo es una IA explica por qué el resultado de la IA es mucho más difícil de leer en términos de confianza que el de una persona; esta es la consecuencia para la seguridad de esa misma mecánica, que se manifiesta como una duda silenciosa sobre uno mismo en lugar de un desacuerdo abierto que cualquiera podría señalar y corregir.
El costo se acumula porque es invisible mientras ocurre. Alguien que se traga una duda sobre el plan de un colega al menos sabe que lo hizo. Alguien que acepta el resultado de una IA sin expresar una duda a menudo no lo vive como ceder en absoluto; simplemente siente que sigue adelante. Multiplique eso por un equipo durante meses y obtiene un grupo que ha dejado de ejercer en silencio el mismo criterio para el que fue contratado, sin que exista un solo momento que alguien pueda señalar como el punto donde las cosas fallaron.
Qué hacen los líderes para construir seguridad psicológica en equipos con IA
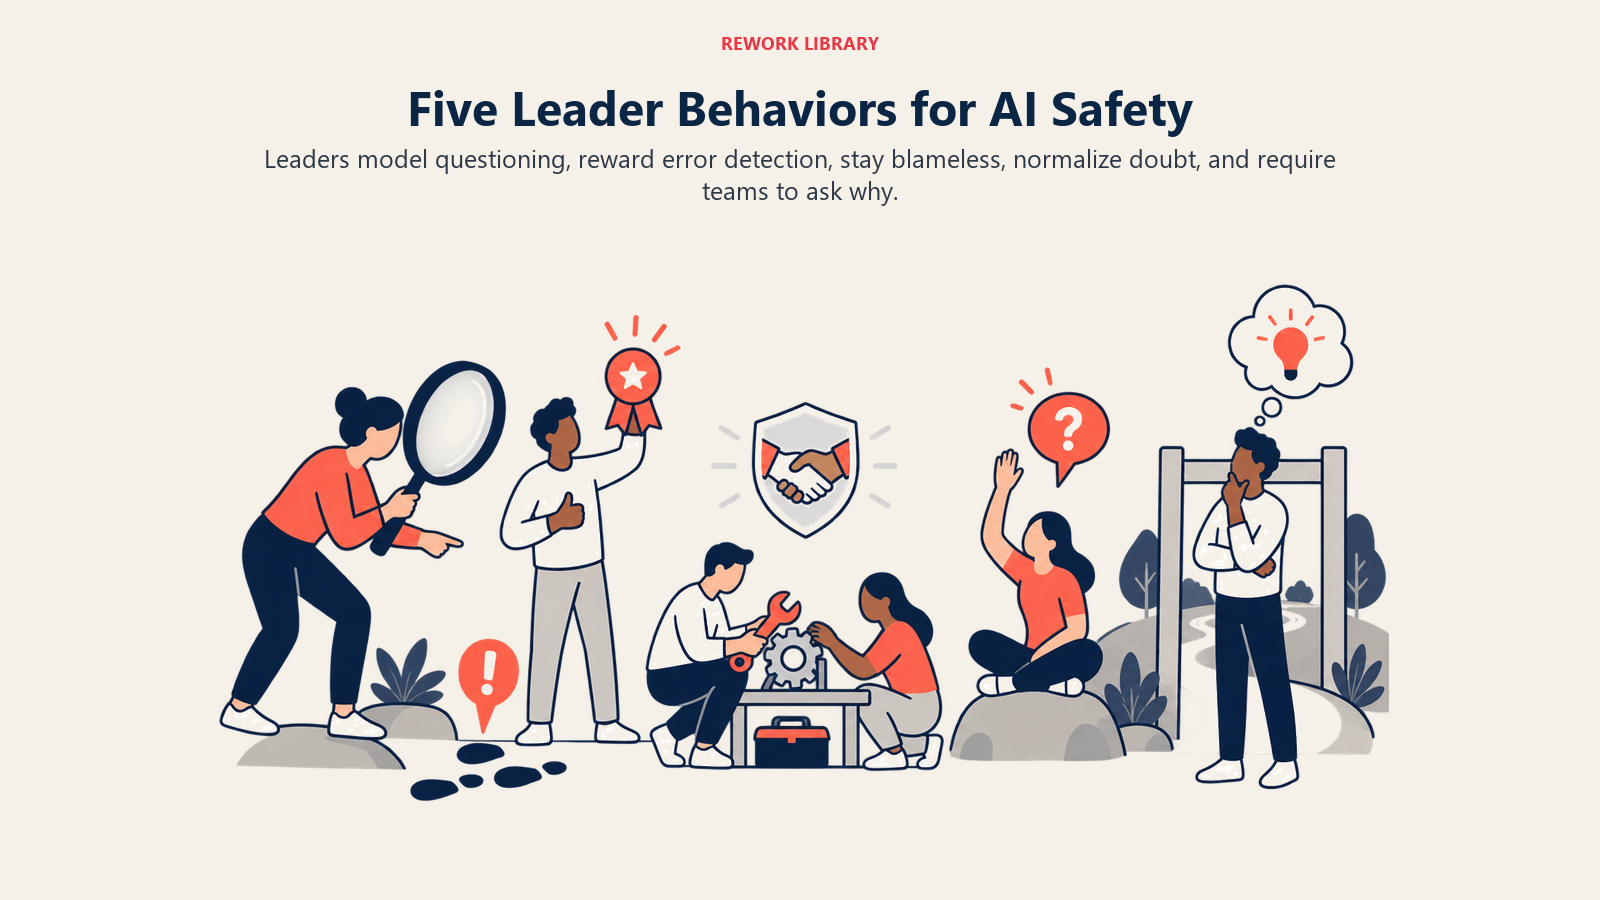
Los equipos que evitan este modo de fallo no son los que tienen la política de IA más cautelosa. Son aquellos donde un puñado de comportamientos específicos de los líderes hace que cuestionar, admitir y dudar sean una parte normal de cómo se trabaja, no una excepción que alguien deba justificar.
Modele usted mismo el cuestionamiento de la IA, a la vista de todos
La acción de mayor impacto es que un líder ponga en duda públicamente un resultado de la IA frente al equipo, incluso las veces en que resulta que tenía razón. "Quiero verificar esta cifra antes de usarla", dicho por la persona de mayor rango en la sala, hace más por autorizar el mismo comportamiento en todos los demás que cualquier política escrita. La investigación de Microsoft sobre gerentes que modelan visiblemente su propio uso de la IA halló efectos reales y medibles en la disposición de todo el equipo a interactuar de forma crítica con la IA, no solo en su adopción bruta. El comportamiento que se propaga es el acto visible de verificar, no un memorando que dice que verificar está bien visto.
Premie a quien detecta el error, no solo a quien entrega rápido
Si el único resultado reconocido en un equipo es la velocidad, quien detecta un resultado defectuoso de la IA y frena las cosas para corregirlo parece la persona que incumplió el plazo, no la que salvó el proyecto. Los sistemas de reconocimiento construidos por completo en torno al volumen de entrega entrenan en silencio a las personas para que dejen de mirar con demasiado detalle. Nombrar y reconocer a quien detectó un error de la IA antes de que saliera, como un buen equipo reconoce a quien vio un bug antes del lanzamiento, convierte detectar errores en un movimiento que gana estatus en lugar de arriesgarlo.
Trate los errores de la IA como errores sin culpables, siempre
Cómo responde un equipo ante un error entrena a todos los que observan, ya sea que el error venga de una persona o de una máquina. Cultura de la culpa frente a cultura del aprendizaje es tan relevante para el error de un agente como para el de una persona. Un equipo que culpa en silencio a quien "debió haber detectado" el error de la IA enseña a todos que la jugada más segura la próxima vez es el silencio, no el escrutinio. Un equipo que trata el error como información, qué pasó por alto el agente y qué cambia para que no se repita, mantiene abierta la puerta para que la siguiente persona hable con honestidad en lugar de cubrirse.
Haga de "no confío en esto" una frase normal
Los líderes pueden nombrar esto directamente en lugar de esperar a que surja solo. Decir, en una reunión de equipo, "si alguna vez mira lo que produjo un agente y siente que algo no cuadra, esa es exactamente la frase que quiero oír, aunque todavía no pueda explicar bien por qué" hace más de lo que parece. Convierte una sensación vaga y difícil de justificar en una contribución explícitamente bienvenida, justo la brecha en la que la investigación de Chan encontró que caen las personas: evitar una pregunta no por carecer de las herramientas para hacerla, sino porque nada en la sala les dijo que valía la pena la fricción de hacerla.
Cree el hábito de preguntar "por qué", no solo "qué"
Los equipos que preguntan "qué recomendó la IA" y se detienen ahí están estructuralmente preparados para la deferencia excesiva que describe este artículo. Los equipos que incorporan al flujo de trabajo mismo el "por qué lo recomendó, y ¿se sostiene el razonamiento?", como paso estándar a partir de un umbral de riesgo definido y no como una verificación ocasional por intuición, hacen lo contrario de lo que hicieron los participantes de Chan cuando un bono volvió inconveniente mirar la explicación. Es la misma disciplina que necesitan los equipos humano-agente para la rendición de cuentas en general, aplicada al momento previo a que el resultado salga y no después de que algo ya haya salido mal.
Una auditoría rápida: ¿su equipo realmente la tiene?
La mayoría de los equipos no puede saber si tiene seguridad psicológica en torno a la IA hasta que busca señales específicas, no una sensación general. La tabla siguiente separa cómo se ve la presencia de la seguridad de cómo se ve su ausencia, ya que ambas pueden parecer tranquilas en la superficie.
| Señal | Presente | Ausente |
|---|---|---|
| Cuestionar el resultado de la IA | La gente dice "quiero verificar esto" sin titubear ni disculparse primero | Las dudas se plantean solo en privado, después de que el resultado ya salió |
| Admitir el uso de IA | La divulgación es rutinaria, se menciona igual que se mencionaría una fuente | El uso de IA se menciona solo si se pregunta directamente, o no se menciona |
| Señalar o anular errores de la IA | A la persona que detectó el error se la nombra y se la reconoce | El error aflora más tarde sin un registro claro de quién estuvo a punto de detectarlo |
| Decir "no confío en esto" | Se dice con claridad en espacios de equipo y se trata como información útil | Se dice solo en privado, si es que se dice, y se trata como una confesión |
| Comportamiento del líder | Los líderes cuestionan visiblemente el resultado de la IA, incluido el propio | Los líderes dan por zanjado el resultado de la IA una vez que lo aprobó una persona de mayor rango |
Un equipo que se reconoce sobre todo en la columna de la derecha no está roto; simplemente opera con la configuración exacta que tanto la investigación de Chan como el marco original de sesgo de automatización de Skitka predicen que acumulará errores de comisión sin hacer ruido. La solución no es una nueva herramienta. Es lograr que la columna de la izquierda sea la forma normal y poco llamativa en que el equipo ya conversa.
Próximos pasos
Este artículo extiende la investigación fundacional sobre seguridad psicológica a un nuevo contexto específico. A partir de aquí:
- Seguridad psicológica en el trabajo, para el modelo original de cuatro etapas de Edmondson y la investigación del Project Aristotle de Google en que se apoya este artículo
- Confianza cuando su compañero de equipo es una IA, para la mecánica de la confianza calibrada y por qué el tono seguro de la IA no se puede leer como el de una persona
- Equipos humano-agente, para las preguntas de propiedad y rendición de cuentas que surgen cuando un agente es una parte activa del equipo
- Cultura de la culpa frente a cultura del aprendizaje, para ver cómo la respuesta de un equipo ante cualquier error, humano o de la IA, determina si la siguiente persona hablará
- Deuda cultural de la IA, para lo que se acumula cuando las brechas de confianza y seguridad en torno a la IA quedan sin atender
- Etiqueta de la IA y normas de trabajo, para el conjunto más amplio de reglas no escritas sobre divulgación dentro del cual se ubica la segunda categoría de riesgo de este artículo
- La Frontier Firm y el ascenso del agent boss, para ver cómo el rol de orquestador cambia lo que los líderes necesitan modelar
- Cómo construir una cultura preparada para la IA, para el conjunto más amplio de prácticas en el que esto encaja
- ¿Qué es la cultura nativa de IA?, para el concepto fundacional dentro del cual se ubican las preguntas de este artículo
- Liderar la cultura en la era de la IA, para el panorama completo de liderazgo en toda la Sección 7
El estado de salud de un equipo con IA se ve en un solo momento: cuando alguien dice "no confío en este resultado", ¿la sala lo trata como parte de hacer el trabajo, o como algo que frena a todos? Las normas de divulgación, el reporte de errores, la disposición a anular a una máquina que suena segura, todo se deriva de la respuesta. Construya para ese momento y lo demás se vuelve más fácil. Castíguelo una vez y las personas dejarán de decirlo en silencio, que es justo cuando el sesgo de automatización empieza a costarle caro.

Co-Founder, Rework.com
On this page
- Ampliar el modelo de Edmondson: cuatro cosas nuevas que las personas necesitan sentirse seguras de decir
- Seguro para cuestionar el resultado de la IA
- Seguro para admitir que usó IA
- Seguro para señalar un error de la IA o anular su recomendación
- Seguro para decir "no confío en este resultado"
- Sesgo de automatización y deferencia excesiva: el nuevo modo de fallo
- Qué es realmente el sesgo de automatización
- Por qué la seguridad psicológica es la variable que falta
- El estudio de los oficiales de crédito: cuando no preguntar "por qué" es el punto
- Datos clave
- Por qué este tipo de silencio es fácil de pasar por alto
- Qué hacen los líderes para construir seguridad psicológica en equipos con IA
- Modele usted mismo el cuestionamiento de la IA, a la vista de todos
- Premie a quien detecta el error, no solo a quien entrega rápido
- Trate los errores de la IA como errores sin culpables, siempre
- Haga de "no confío en esto" una frase normal
- Cree el hábito de preguntar "por qué", no solo "qué"
- Una auditoría rápida: ¿su equipo realmente la tiene?
- Próximos pasos