Das menschliche Urteilsvermögen scharf halten: Das De-Skilling-Paradox der KI bei der Arbeit
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
Das De-Skilling-Paradox lautet: Je mehr ein Team das Denken an KI abgibt, desto schwächer wird sein Urteilsvermögen ausgerechnet bei der Fähigkeit, die es jetzt am dringendsten braucht, nämlich KI bei Fehlern zu ertappen. Verifikation, die Fähigkeit, einen plausibel klingenden Fehler zu erkennen, beruht auf demselben mentalen Muskel, den früher das Erarbeiten der Ergebnisse von Grund auf trainierte. Wer die Erstellung delegiert und die Übung auslässt, dessen Muskel verkümmert, während die Aufgabe, die ihn verlangt (die Maschine zu kontrollieren), fest auf der menschlichen Seite des Schreibtischs bleibt.
Das ist keine Prognose. Es ist ein Muster mit jahrzehntelanger Evidenz in der Luftfahrt, in der Navigation und nun in früher Forschung zur Wissensarbeit selbst. Nichts davon besagt, dass KI Menschen dauerhaft zu schlechteren Denkern macht. Es besagt, dass ein konkreter, gut dokumentierter Mechanismus greift, sobald eine Aufgabe von „Ich mache das“ zu „Ein System macht das und ich kontrolliere es“ wechselt, und dass dieser Mechanismus beherrschbar ist, sobald man weiß, dass es ihn gibt.
Wichtige Fakten
- Automation Bias hat zwei Fehlformen, und Training behebt nur eine davon. Die ursprünglichen Studien von Skitka, Mosier und Burdick fanden, dass Menschen Unterlassungsfehler begehen (etwas übersehen, das die Automatisierung nicht gemeldet hat) und Handlungsfehler (dem Rat der Automatisierung folgen, obwohl andere Belege widersprechen), und dass Aufklärungstraining Handlungsfehler verringerte, Unterlassungsfehler aber nicht. Does Automation Bias Decision-Making? (Skitka, Mosier & Burdick)
- „Your Brain on ChatGPT“ des MIT Media Lab fand eine schwächere Gehirnkonnektivität in der LLM-gestützten Schreibgruppe, aber es ist ein kleiner, nicht begutachteter Preprint. Bei 54 Teilnehmenden war das per EEG gemessene kognitive Engagement in der Gruppe am niedrigsten, die ein LLM zum Verfassen von Essays nutzte, und in der Gruppe ohne Hilfsmittel am höchsten. Die Autoren selbst nennen Stichprobengröße und fehlende Begutachtung als echte Grenzen. MIT Media Lab, „Your Brain on ChatGPT“
- Höheres Vertrauen in KI sagt weniger berichtetes kritisches Denken voraus, in einer Umfrage von Microsoft Research und Carnegie Mellon unter 319 Wissensarbeitenden. Je mehr Menschen darauf vertrauten, dass die KI eine Aufgabe gut erledigt, desto weniger kritische Prüfung wendeten sie nach eigener Aussage auf deren Ergebnis an, während das Vertrauen in die eigene Fähigkeit in die entgegengesetzte Richtung ging. Microsoft Research, „The Impact of Generative AI on Critical Thinking“
- Intensivere lebenslange GPS-Nutzung sagt ein schlechteres räumliches Gedächtnis bei der Navigation ohne GPS voraus. Eine Studie der McGill University mit 50 regelmäßigen Autofahrern fand diesen Zusammenhang, und eine dreijährige Nachverfolgung bei einer Teilgruppe zeigte, dass eine seit dem ersten Test gestiegene GPS-Nutzung mit einem stärkeren Rückgang des hippocampusabhängigen räumlichen Gedächtnisses einherging, nicht umgekehrt. Dahmani & Bohbot, Scientific Reports (Nature)
- Luftfahrtbehörden haben über ein Jahrzehnt lang Regelwerke rund um den Verlust manueller Flugfertigkeiten aufgebaut. Die Flight Deck Automation Working Group der FAA und internationale Gremien (ICAO, EASA) identifizierten nachlassende manuelle Flugfertigkeiten und mangelndes Bewusstsein für die Reaktion auf Automatisierung als beitragende Faktoren bei Kontrollverlust-Vorfällen, was verpflichtendes Training für manuelles Fliegen und Automatisierungsausfälle auslöste. FAA Air Carrier Training ARC report
Das De-Skilling-Paradox, definiert
Jeder Beruf kennt eine Version derselben Regel: Man lernt, eine schlechte Antwort zu erkennen, indem man selbst genug gute und schlechte Antworten hervorgebracht hat. Eine Radiologin liest jahrelang Aufnahmen, bevor ihr ein Blick sagt, dass etwas nicht stimmt. Ein Lektor entwickelt ein Gespür für ein schwaches Argument, indem er selbst Hunderte schwacher erster Entwürfe schreibt. Dieses Mustererkennungsgespür ist Urteilsvermögen, und es entsteht durch Wiederholung, nicht durch Unterweisung. Für viele ist es zudem der Teil der Arbeit, der sich nach Handwerk anfühlte statt nach Mühe, weshalb der Verlust der Wiederholung mehr kostet als eine Fertigkeit; Sinn, Identität und Handwerk im KI-Zeitalter behandelt diesen zweiten, weniger gemessenen Verlust.
KI verändert die Ökonomie dieser Wiederholung. Warum den ersten Entwurf schreiben, die Zahlen von Hand durchrechnen oder den ganzen Vertrag lesen, wenn ein Modell es in zehn Sekunden erledigt? Für jede einzelne Aufgabe ist das Auslassen der manuellen Wiederholung die offensichtlich effiziente Wahl. Aber Urteilsvermögen ist ein Vermögenswert, der sich aus Tausenden einzeln kleinen Wiederholungen aufbaut, und die Wiederholung auszulassen heißt auch, die Einzahlung auszulassen. Wer das konsequent in einem Team, einer Rolle oder einer Karrierephase tut, dem hört das angesammelte Urteilsvermögen auf, sich anzusammeln, das erfahrene Menschen früher wertvoll machte.
Das Paradox ist die Zwickmühle, die dadurch entsteht. KI ist genau bei den Aufgaben am nützlichsten, die mühsam oder langsam von Hand zu erledigen sind, und das sind auch die Aufgaben, die das Urteilsvermögen aufbauen, das nötig ist, um die Arbeit der KI zu prüfen. Das Team, das sich am stärksten auf KI stützt, verbessert heute sein Arbeitstempo und untergräbt dabei leise seine Fähigkeit, den Fehler von morgen zu erkennen. Keiner der beiden Effekte ist im Moment sichtbar. Das Tempo zeigt sich sofort; die Lücke im Urteilsvermögen zeigt sich Monate später, meist, wenn die KI zum ersten Mal selbstsicher bei etwas Wichtigem falschliegt.
Automation Bias und Selbstzufriedenheit: Warum wir aufhören zu prüfen
Was Automation Bias mit einer Entscheidung tatsächlich macht
Automation Bias ist die gut dokumentierte Neigung, eine automatisierte Empfehlung als Ersatz für die aktive eigene Prüfung der Belege zu behandeln, statt als einen weiteren Faktor, den man abwägt. Linda Skitka, Kathleen Mosier und Susan Burdick führten eine Reihe von Studien durch, in denen Teilnehmende eine simulierte Flugüberwachungsaufgabe bearbeiteten, teils mit einer hochgradig (aber nicht perfekt) zuverlässigen automatisierten Hilfe, teils ohne. Menschen ohne Hilfe entdeckten insgesamt mehr Fehler. Menschen mit Hilfe übersahen Ereignisse, die sie nicht meldete (Unterlassungsfehler), und folgten, besonders auffällig, manchmal ihrem Rat, obwohl ihnen widersprechende Informationen direkt vor Augen lagen (Handlungsfehler).
Der beunruhigende Teil ihrer Befunde: Diese Fehler blieben bestehen, selbst nachdem den Teilnehmenden ausdrücklich gesagt worden war, dass die Hilfe nicht perfekt zuverlässig ist. Intellektuell zu wissen, dass ein System falschliegen kann, ändert das Verhalten ihm gegenüber nicht verlässlich. Nur gezieltes Training, das die Fehlformen des Automation Bias konkret durchging, verringerte Handlungsfehler, und selbst dieses Training ließ Unterlassungsfehler weitgehend unberührt. Einem Team zu sagen „denken Sie daran, dass sie falschliegen kann“, ist für sich genommen keine Lösung.
Selbstzufriedenheit ist der Normalzustand, nicht die Ausnahme
Selbstzufriedenheit ist der leisere Verwandte des Automation Bias: nicht aktiv einer falschen Antwort vertrauen, sondern nur nicht genau genug hinsehen, um es zu bemerken. Sie ist der Normalzustand, kein Aussetzer in einem sonst wachsamen Prozess, denn Wachsamkeit ist teuer, und eine flüssige, selbstsicher klingende KI-Antwort gibt dem Gehirn jedes Signal, mit dem es entscheidet, dass etwas keinen zweiten Blick braucht. Das ist der Mechanismus hinter psychologischer Sicherheit in KI-Teams: Dieser Artikel behandelt, ob sich Menschen sicher genug fühlen, Zweifel am KI-Output laut zu äußern. Hier geht es um etwas, das davor liegt: ob sie überhaupt noch das geschärfte Urteilsvermögen haben, zu bemerken, dass es etwas zu bezweifeln gibt. Ein Team kann sich maximal sicher fühlen, offen zu sprechen, und den Fehler trotzdem übersehen, wenn niemand darin die Mustererkennung bewahrt hat, die ihn erkannt hätte.
Cognitive Offloading und was es kostet
Cognitive Offloading, also das Abgeben einer mentalen Aufgabe an ein externes Werkzeug, statt sie im Kopf zu erledigen, ist nicht neu und nicht grundsätzlich schlecht. Aufschreiben, ein Taschenrechner und das Nachschlagen eines Fakts sind alle Offloading, und nichts davon hat Lesefähigkeit oder Rechnen zerstört. Bei generativer KI unterscheidet sich der Umfang: Sie nimmt nicht nur Gedächtnis oder Rechnen ab, sondern das eigentliche Konstruieren eines Arguments, einer Analyse oder einer Entscheidung, und das ist ein viel größerer Teil des Denkens, das Urteilsvermögen aufbaut.
Die Befunde des MIT Media Lab und ihre tatsächlichen Grenzen
Die vielfach geteilte Studie „Your Brain on ChatGPT“ des MIT Media Lab maß die EEG-Gehirnkonnektivität bei Menschen, die Essays mit einem LLM, mit einer Suchmaschine oder ganz ohne Hilfsmittel schrieben. Die Gruppe ohne Hilfsmittel zeigte das stärkste, am weitesten verteilte neuronale Engagement; die LLM-Gruppe das schwächste. Es ist ein wirklich interessantes frühes Signal, das ehrlich berichtet und nicht übertrieben werden sollte: 54 Teilnehmende, eine einzelne Schreibaufgabe, keine Begutachtung in der hier besprochenen Fassung, und die Autoren warnen selbst davor, das Ergebnis als gesicherte Wissenschaft zu behandeln. Lesen Sie es als Hypothese, die ernst zu nehmen ist, nicht als Beweis dafür, dass KI-Nutzung das Gehirn umverdrahtet. Die Richtung des Befunds zählt in diesem Stadium mehr als seine statistische Sicherheit: Sie passt zu einem Mechanismus (weniger aktives Konstruieren, weniger aktives Engagement), der unabhängig davon in der unten behandelten Luftfahrt- und Navigationsforschung auftaucht.
Der Vertrauenseffekt von Microsoft und Carnegie Mellon
Belastbarer, weil sie reale Arbeit statt einer Laboraufgabe untersuchte, ist die Studie von Microsoft Research und Carnegie Mellon unter 319 Wissensarbeitenden, die 936 tatsächliche Fälle des Einsatzes generativer KI im Job beschrieben. Der zentrale Befund: Je mehr Vertrauen jemand in die Fähigkeit der KI hatte, eine Aufgabe zu erledigen, desto weniger kritisches Denken wendete er nach eigener Angabe auf das Ergebnis an, während das Vertrauen in die eigene Fähigkeit in die entgegengesetzte Richtung ging. Die Forschenden fanden außerdem, dass generative KI verändert, wie kritisches Denken aussieht: vom Erzeugen einer Antwort hin zum Überprüfen, Integrieren und Betreuen einer Antwort, und dass Menschen diesen neuen Prüfschritt am häufigsten auslassen, wenn ihnen die Fähigkeit fehlt, das Ergebnis der KI tatsächlich zu untersuchen und zu verbessern. Dieser letzte Punkt ist das Paradox in einem Satz: Die Menschen, die am schlechtesten gerüstet sind, einen KI-Fehler zu erkennen, haben oft am meisten Arbeit abgegeben, die ihnen die Fähigkeit dazu verschafft hätte.
Zwei Präzedenzfälle, für die wir bereits Evidenz haben
Die Wissensarbeit ist neu bei diesem Problem. Zwei andere Bereiche sind es nicht, und beide haben jahrzehntelange Messdaten dazu, was passiert, wenn eine Fertigkeit an Automatisierung abgegeben und nicht mehr geübt wird.
Luftfahrt: Was passiert, wenn Piloten nicht mehr von Hand fliegen
Moderne Verkehrsflugzeuge können nahezu die gesamte Strecke im Autopilot fliegen, und Piloten tun genau das oft, um Arbeitsbelastung und Treibstoffverbrauch zu senken. Der Zielkonflikt, dem sich die Behörden schließlich stellen mussten: Manuelles Fliegen und das Erkennen von Ausfällen verkümmern, wenn sie nicht geübt werden, und mehrere schwere Vorfälle ließen sich teilweise auf eine Crew zurückführen, die genau das Szenario, das die Automatisierung im schlechtmöglichsten Moment zurückgab, zuletzt nicht geübt hatte. Die Flight Deck Automation Working Group der FAA dokumentierte dieses Muster so deutlich, dass es die Trainingsstandards branchenweit veränderte, mit verpflichtenden manuellen Flugabschnitten und Übungen zu Automatisierungsausfällen, gezielt, damit die zugrunde liegende Fertigkeit nicht verkümmert. Die Lösung lautete nie „weniger Automatisierung nutzen“. Sie lautete „die Fertigkeit gezielt, nach Plan üben, ob der Job sie gerade verlangt oder nicht“.
GPS und der leise Abbau des räumlichen Gedächtnisses
Die Navigation bietet ein saubereres, länger laufendes natürliches Experiment, weil Millionen Menschen es seit zwei Jahrzehnten durchführen. Eine Studie der McGill University maß das räumliche Gedächtnis regelmäßiger Autofahrer und fand, dass Menschen mit mehr lebenslanger GPS-Erfahrung bei selbstgeführten Navigationsaufgaben schlechter abschnitten, bei denen man eine innere mentale Karte braucht statt Abbiegehinweisen. Eine Nachuntersuchung drei Jahre später an einer kleineren Gruppe zeigte die Richtung der Kausalität: Menschen, die ihre GPS-Nutzung in der Zwischenzeit steigerten, zeigten einen stärkeren Rückgang des hippocampusabhängigen räumlichen Gedächtnisses, und das ließ sich nicht damit erklären, dass sie von Haus aus einen schlechten Orientierungssinn hatten, der sie zum Tool getrieben hätte. Der Mechanismus ist fast identisch mit dem in der Wissensarbeit: GPS macht aus Navigation das Befolgen einer Reiz-Reaktions-Anweisung („in 200 Metern rechts abbiegen“), statt ein inneres Modell der Strecke aufzubauen und zu aktualisieren, sodass die Fertigkeit, die das innere Modell aufbaut, schlicht nicht mehr trainiert wird.
Warum es die Verifikation am härtesten trifft
Jede Gegenmaßnahme unten gibt es wegen eines strukturellen Problems: Verifikation ist genau die Fertigkeit, die dieses Muster am schnellsten aushöhlt, und es ist auch die eine Fertigkeit, die niemand an die KI selbst auslagern kann. Man kann ein Modell nicht verlässlich bitten, zu sagen, wann es falschliegt; die Forschung zu KI-Halluzinationen ist eindeutig, dass eine selbstsichere, flüssige, falsche Antwort von außen genauso aussieht wie eine selbstsichere, flüssige, richtige. Das Einzige zwischen einem plausiblen KI-Fehler und einer teuren Entscheidung ist ein Mensch, der noch die Schärfe der Mustererkennung hat, um zu bemerken, dass etwas nicht stimmt, und diese Schärfe entsteht durch genau die Art manueller Wiederholung, die die KI-Einführung beseitigt. Diese Schärfe bewusst im Haus zu halten, statt anzunehmen, dass ein Modell seine Fehler irgendwann selbst fängt, ist dieselbe Überlegung, die die Humanprämie für die Entscheidung anstellt, welche Kontaktpunkte überhaupt menschlich bleiben.
Hier verstärkt sich das Paradox auch über ein Team hinweg, statt ein individuelles Problem zu bleiben. Wenn das Urteilsvermögen einer einzelnen Person stumpf wird, ist das ein persönliches Risiko. Wenn das kollektive Urteilsvermögen eines ganzen Teams gleichzeitig stumpf wird, bei denselben Aufgaben, weil alle gemeinsam denselben KI-Workflow übernommen haben, ist im Raum niemand mehr mit dem geschärften Instinkt, das Durchgerutschte zu erkennen. Das ist ein strukturelles Risiko, und deshalb müssen Mensch-Agent-Teams den Erhalt von Fertigkeiten als Gestaltungsfrage auf Teamebene behandeln, nicht als individuelle Gewohnheit.
| Gefährdete Fähigkeit | Wie sie verkümmert | Gegenmaßnahme |
|---|---|---|
| Erstellen des ersten Entwurfs (Schreiben, Analyse, Code) | Das Auslassen des manuellen Versuchs beseitigt die Wiederholung, die die Mustererkennung dafür aufbaut, wie eine falsche Antwort aussieht | Gezielte manuelle Übung im festen Takt, auch wenn die KI die Aufgabe schneller erledigen könnte |
| Fehlererkennung im Output anderer (oder der KI) | Automation Bias und Selbstzufriedenheit lassen eine flüssige Antwort geprüft wirken, obwohl sie nur überflogen wurde | Blind-First-Review, bei der der Mensch zu einer unabhängigen Antwort kommt, bevor er sieht, was die KI erzeugt hat |
| Kalibriertes Vertrauen (wissen, wann man widersprechen sollte) | Vertrauen in die KI ersetzt Vertrauen in das eigene Urteilsvermögen, so der Befund zum Vertrauenseffekt von Microsoft und CMU | Rotation der Prüfenden, damit das Vertrauen einer einzelnen Person in einen KI-Workflow nicht lange unhinterfragt bleibt |
| Domänenintuition für das konkrete System oder den konkreten Account | Selbstzufriedenheit verstärkt sich, wenn dieselbe Person bei derselben wiederkehrenden Aufgabe immer nachgibt | Red-Teaming von KI-Output nach Plan, wobei gegnerische Prüfungen als reguläre Wartung gelten, nicht als Störfallreaktion |
| Urteilsvermögen bei Mehrdeutigkeit (Fälle, auf die die KI nicht trainiert wurde) | Verlust nach Art des manuellen Fliegens: selten geübtes Urteilsvermögen verkümmert am schnellsten und versagt genau dann, wenn der Routinefall zum Randfall wird | Human-in-the-Loop-Gates an echten Urteilspunkten, nicht auf jeden Output gestempelt, egal wie viel auf dem Spiel steht |
Gegenmaßnahmen aufbauen, die wirklich wirken
Gezielte manuelle Übung
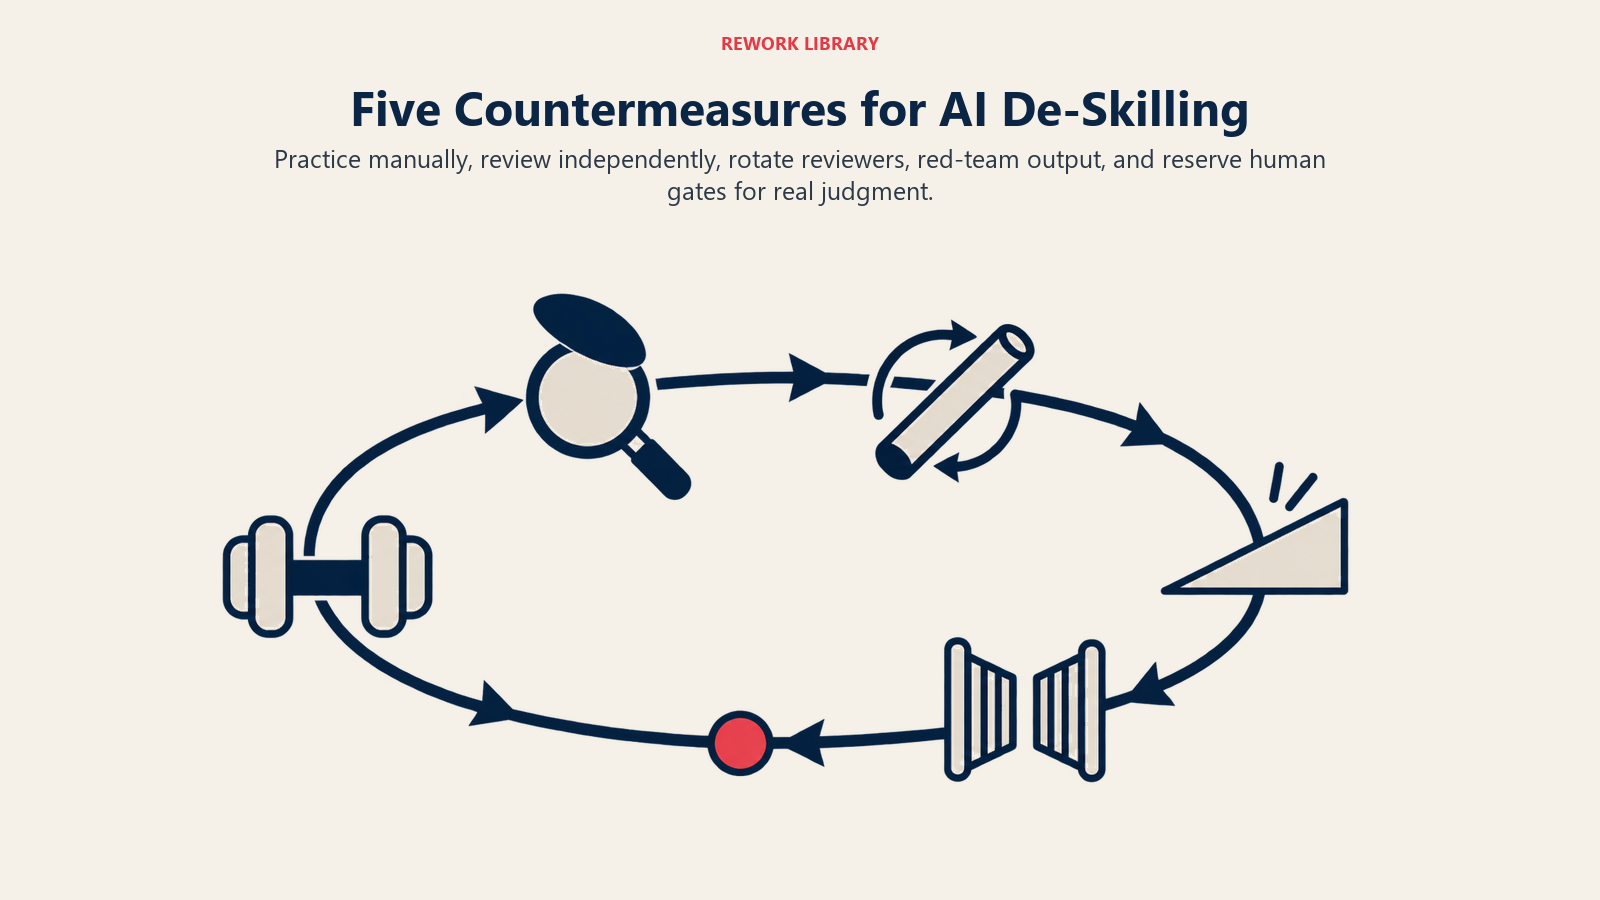
Die Lösung der Luftfahrt lässt sich sauber verallgemeinern: Planen Sie manuelle Wiederholungen bewusst ein, unabhängig davon, ob der Job sie heute braucht. Ein Finanzteam, das KI jedes Modell bauen lässt, sollte trotzdem jedes Quartal einige Modelle von Analysten von Grund auf bauen lassen. Ein Support-Team, das KI jede Antwort entwerfen lässt, sollte trotzdem einige ohne Hilfe schreiben lassen, gezielt, damit die zugrunde liegende Fertigkeit nicht verstummt. Es geht nicht um Nostalgie für den langsamen Weg. Es geht darum, die Mustererkennung warm genug zu halten, um zu bemerken, wenn der schnelle Weg etwas Falsches hervorbringt.
Blind-First-Review
Die wirksamste einzelne Gewohnheit gegen Automation Bias ist die Reihenfolge: Bilden Sie sich Ihre eigene Meinung, bevor Sie die der KI sehen. Lesen Sie die Vertragsklausel, schätzen Sie die Zahl oder skizzieren Sie das Argument zuerst, und vergleichen Sie dann mit dem, was das Modell erzeugt hat. Die Reihenfolge umzukehren, also erst die Antwort der KI zu sehen und dann zu versuchen, sie zu bewerten, ist genau das Setup, bei dem Menschen laut der Forschung von Skitka und Mosier am schlechtesten abschneiden, weil eine flüssige Antwort das Urteil verankert, bevor es sich unabhängig bilden kann.
Die Prüfenden rotieren
Selbstzufriedenheit vertieft sich, je länger dieselbe Person denselben KI-Workflow prüft. Rotieren Sie, wer die Endkontrolle eines wiederkehrenden KI-gestützten Prozesses übernimmt, auch wenn der „Experte“ formal qualifizierter ist. Ein frischer Prüfer hat noch nicht das Vertrauen (oder die blinden Flecken) aufgebaut, die entstehen, wenn die KI monatelang oft genug richtiglag, um nicht mehr genau hinterfragt zu werden. Das ist eine strukturelle Lösung, keine Trainingsmaßnahme, und sie wirkt gerade deshalb, weil sie nicht von der Willenskraft einer einzelnen Person abhängt.
Red-Teaming von KI-Output als Routine, nicht als Störfallreaktion
Behandeln Sie gegnerische Tests von KI-generierter Arbeit so wie Sicherheitsteams Penetrationstests: geplant, nicht erst ausgelöst, nachdem etwas kaputtgegangen ist. Ziehen Sie pro Zyklus eine Stichprobe des KI-Outputs und versuchen Sie gezielt, ihn zu knacken, die falsche Annahme, die unbelegte Behauptung, den übersehenen Randfall zu finden. Reworks Red-Teaming für KI-Agents behandelt die Mechanik speziell für agentenbasierte Systeme, aber die Disziplin gilt genauso für ein einzelnes KI-entworfenes Memo oder eine Tabelle. Es geht nicht darum, jeden Fehler zu fangen; es geht darum, den Muskel der skeptischen Prüfung aktiv zu halten, damit er da ist, wenn ein echter Fehler ungeplant auftaucht.
Human-in-the-Loop für Urteilsvermögen, nicht für Abnicken
Human-in-the-Loop-Gates sind nur die Reibung wert, die sie erzeugen, wenn der Mensch am Gate tatsächlich Urteilsvermögen ausübt, statt auf „Genehmigen“ zu klicken. Ein Gate auf jedem einzelnen Output, egal wie viel auf dem Spiel steht, trainiert Menschen zum reflexhaften Genehmigen, das Gegenteil der beabsichtigten Wirkung. Reservieren Sie menschliche Freigabepunkte für Entscheidungen mit echten Folgen und geben Sie jedem genug Kontext mit, dass der Prüfende etwas Konkretes zu bewerten hat. Gute Guardrails für KI-Agents und Observability darüber, was ein Agent tatsächlich getan hat helfen hier beide, denn ein Prüfender mit Einblick in die Argumentation hat mehr zu prüfen als jemand, der auf eine Endantwort ohne Spur dahinter starrt. Dieses Gate falsch zu gestalten ist auch ein Kulturproblem: Ein Team, das die Person bestraft, die einen KI-Fehler meldet, bringt allen anderen bei, nicht mehr zu melden, und das höhlt den gesamten Sinn eines Menschen in der Schleife leise aus.
Was Führungskräfte damit konkret tun sollten
Nichts davon spricht dafür, weniger KI zu nutzen. Die Teams mit dem schärfsten Urteilsvermögen in fünf Jahren werden diejenigen sein, die KI intensiv nutzten und den Erhalt von Fertigkeiten als bewusste, budgetierte Praxis behandelten statt als Zufall dessen, was das Tool übrig ließ. Bauen Sie manuelle Übung in den Kalender ein, so wie Piloten wiederkehrendes Training einplanen. Gestalten Sie Prüfungen so, dass ein Mensch sich eine Meinung bildet, bevor er die der Maschine sieht. Rotieren Sie die Personen, die prüfen. Planen Sie Red-Teaming ein, statt zu warten, bis ein Ausfall es erzwingt. Und bauen Sie Vertrauen in die KI selbst auf, das daran kalibriert ist, was sie sich tatsächlich verdient hat, nicht daran, wie selbstsicher und flüssig sie klingt. Keine dieser Maßnahmen ist einzeln eine große Investition. Zusammen ausgelassen ergeben sie ein Team, das nicht mehr erkennen kann, wann die Maschine falschliegt, an dem Tag, auf den es am meisten ankommt.
Häufig gestellte Fragen zu De-Skilling und KI
Was ist das De-Skilling-Paradox bei der KI-Einführung?
Es ist das Muster, dass das Verlassen auf KI bei einer Aufgabe das Urteilsvermögen aushöhlt, das man bräuchte, um genau die Fehler dieser KI zu erkennen, weil die Fähigkeit, eine falsche Antwort zu erkennen, durch manuelles Arbeiten entsteht, das KI-Nutzung verringert.
Was ist Automation Bias, und ist es dasselbe wie Selbstzufriedenheit?
Automation Bias bedeutet, eine automatisierte Empfehlung als Ersatz für die unabhängige Prüfung der Belege zu behandeln, was laut der Forschung von Skitka, Mosier und Burdick sowohl übersehene Fehler als auch das Befolgen schlechter Ratschläge trotz gegenteiliger Belege hervorbringt. Selbstzufriedenheit ist eng verwandt, aber subtiler: nicht aktiv dem System zu sehr zu vertrauen, sondern nur nicht genau genug hinzusehen, um zu bemerken, dass etwas nicht stimmt.
Beweist die MIT-Studie „Your Brain on ChatGPT“, dass KI Menschen dümmer macht?
Nein. Es ist ein kleiner (54 Teilnehmende), nicht begutachteter Preprint, der die EEG-Gehirnkonnektivität bei einer einzelnen Schreibaufgabe misst, und die Autoren nennen selbst die Grenzen. Es ist ein nützliches frühes Signal, das zu anderer Evidenz passt, kein Beleg für einen allgemeinen kognitiven Abbau.
Wie unterscheidet sich das vom Blickwinkel der psychologischen Sicherheit in KI-Teams?
Bei psychologischer Sicherheit in KI-Teams geht es darum, ob sich Menschen sicher fühlen, KI-Output laut zu hinterfragen. Hier geht es darum, ob sie überhaupt noch in der Lage sind, etwas zu erkennen, das es zu hinterfragen lohnt. Ein Team kann sich völlig sicher fühlen, offen zu sprechen, und den Fehler trotzdem übersehen, wenn niemand das zugrunde liegende Urteilsvermögen scharf gehalten hat.
Was ist Blind-First-Review, und warum hilft sie?
Sie bedeutet, sich bei einer Aufgabe ein eigenes, unabhängiges Urteil zu bilden, bevor man ansieht, was die KI erzeugt hat, und dann zu vergleichen. Wer zuerst die Antwort der KI sieht, verankert seine Bewertung daran und fördert Automation Bias; die umgekehrte Reihenfolge schützt den Teil des Prozesses, in dem Urteilsvermögen tatsächlich ausgeübt wird.
Warum die Prüfenden rotieren, statt jedes Mal die erfahrenste Person einzusetzen?
Selbstzufriedenheit vertieft sich, je länger eine Person denselben KI-Workflow prüft, weil Monate, in denen die KI richtiglag, die Genauigkeit der Kontrolle aushöhlen. Ein frischer Prüfer hat dieses Vertrauen und die damit verbundenen blinden Flecken noch nicht aufgebaut, weshalb Rotation eine strukturelle Lösung ist, die nicht von individueller Disziplin abhängt.
Heißt das, Teams sollten weniger KI nutzen, um ihre Fertigkeiten zu schützen?
Nicht unbedingt. Die Evidenz spricht dafür, KI intensiv zu nutzen und dabei bewusst manuelle Übung, Blind-First-Review, Rotation und Red-Teaming einzuplanen, so wie die Luftfahrt die Automatisierung behielt und verpflichtendes Training für manuelles Fliegen ergänzte, statt Autopiloten abzuschaffen.
Was bedeutet „Human-in-the-Loop für Urteilsvermögen, nicht für Abnicken“ konkret?
Es bedeutet, Freigabe-Gates für Entscheidungen mit echten Folgen zu reservieren und den Prüfenden genug Kontext und Argumentation zur Bewertung zu geben, statt jedem Output ein Gate vorzuschalten, egal wie viel auf dem Spiel steht, was Menschen zum reflexhaften Genehmigen statt zum Denken erzieht.

Co-Founder, Rework.com
On this page
- Wichtige Fakten
- Das De-Skilling-Paradox, definiert
- Automation Bias und Selbstzufriedenheit: Warum wir aufhören zu prüfen
- Was Automation Bias mit einer Entscheidung tatsächlich macht
- Selbstzufriedenheit ist der Normalzustand, nicht die Ausnahme
- Cognitive Offloading und was es kostet
- Die Befunde des MIT Media Lab und ihre tatsächlichen Grenzen
- Der Vertrauenseffekt von Microsoft und Carnegie Mellon
- Zwei Präzedenzfälle, für die wir bereits Evidenz haben
- Luftfahrt: Was passiert, wenn Piloten nicht mehr von Hand fliegen
- GPS und der leise Abbau des räumlichen Gedächtnisses
- Warum es die Verifikation am härtesten trifft
- Gegenmaßnahmen aufbauen, die wirklich wirken
- Gezielte manuelle Übung
- Blind-First-Review
- Die Prüfenden rotieren
- Red-Teaming von KI-Output als Routine, nicht als Störfallreaktion
- Human-in-the-Loop für Urteilsvermögen, nicht für Abnicken
- Was Führungskräfte damit konkret tun sollten