Support-Signale, die Churn vorhersagen: Gefährdete Kunden mit AI erkennen
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
Ein Churn-Signal aus dem Support ist ein Muster in den Tickets, Chats und Anrufen eines Kunden (wiederholte Kontakte, sich verschlechternder Ton, offen bleibende Bugs, Eskalationen, wachsender Aufwand), das häufig auftaucht, bevor der Kunde kündigt oder nicht verlängert. AI verdichtet diese verstreuten Muster zu einem Flag auf Account-Ebene, und das Flag geht an den Customer Success Manager (CSM), der die Beziehung verantwortet.
Der Support sieht Dinge, die der Rest des Unternehmens nicht sieht. Ein Kunde, der sich nicht mehr einloggt, ist still. Ein Kunde, der im Monat viermal schreibt, jedes Mal etwas kürzer und etwas schärfer, ist laut. Das Problem: Niemand wird dafür bezahlt, diese Nachrichten zusammenzuzählen. Der Support schließt das Ticket, Customer Success schaut auf ein Nutzungs-Dashboard, und der Account geht, während die Warnung in einem Helpdesk liegt, den auf der CS-Seite niemand geöffnet hat.
Dieser Leitfaden behandelt, welche Support-Signale sich zu verfolgen lohnen, wie AI sie kombiniert, wie Sie das Flag an jemanden übergeben, der handeln kann, und wie Sie prüfen, ob das Modell funktioniert. Das größere Bild, wie man handelt, bevor sich ein Kunde beschwert, beginnt mit proaktivem Kundenservice mit AI.
Wichtige Fakten
- IBM-Forschende trainierten ein Eskalationsmodell für Tickets mit über 2,5 Millionen Support-Tickets und rund 10.000 Eskalationen und berichten 87,36% Recall bei einer um 88,23% geringeren Arbeitslast für Analysten (Montgomery et al., arXiv). Es sagt Eskalationen voraus, nicht Churn, zeigt aber, dass die Ticket-Historie ein starkes Rohmaterial für Risikomodelle ist.
- Zu den Merkmalen dieser IBM-Arbeit gehören Anstiege des Schweregrads, Tage seit dem letzten Kontakt und die aktuelle Antwortzeit eines Kunden im Vergleich zu dem, was er bisher erhalten hat (Montgomery et al., Volltext). Den Kunden mit seiner eigenen Baseline (Ausgangswert) zu vergleichen, ist die Kernidee.
- Die Zendesk-Integration von Gainsight erlaubt es Admins, Ticket-Daten in Gainsight zu ziehen und „Health Scores auf Basis von Support-Daten auszulösen“ (Gainsight Marketplace). Das ist eine vom Anbieter beschriebene Fähigkeit, kein gemessenes Ergebnis.
- Dieselbe Beschreibung nennt das Anlegen und Verknüpfen von Calls to Action (CTAs) mit Zendesk-Tickets direkt aus dem Helpdesk. Das ist der Handoff-Mechanismus, der unten behandelt wird.
- Precision ist der Anteil der markierten Accounts, die tatsächlich gefährdet waren, und Recall der Anteil der gefährdeten Accounts, die das Modell erfasst hat (scikit-learn-Dokumentation). Um ein Churn-Flag zu beurteilen, brauchen Sie beide Zahlen.
- Gewöhnliche gemischte Kreuzvalidierung liefert bei zeitlich geordneten Daten überhöhte Werte, daher sollten Churn-Modelle auf späteren Zeiträumen getestet werden als denen, mit denen sie trainiert wurden (scikit-learn-Dokumentation).
Warum Support-Daten Churn vorhersagen
Die Produktnutzung zeigt, was Kunden tun. Der Support zeigt, wie sie es empfinden, in ihren eigenen Worten, in dem Moment, in dem etwas schiefging. Das macht ihn zu einem ungewöhnlich direkten Signal, und es steht schon am ersten Tag zur Verfügung, bevor Sie Monate an Nutzungshistorie haben.
Drei Dinge unterscheiden Support-Daten von einem Nutzungs-Score:
- Es ist Text. Der Großteil der Information steckt in dem, was der Kunde geschrieben hat, nicht in einem Feld. Das in großem Umfang zu lesen, können Sprachmodelle besonders gut.
- Es ist ereignisgetrieben. Ein monatlich aktualisierter Health Score verpasst die Woche, in der dreimal etwas kaputtging. Tickets kommen, wenn es passiert.
- Es zeigt die Erfahrung des ganzen Accounts. Ein verärgerter Nutzer ist ein Vorfall. Fünf Nutzer eines Unternehmens, die innerhalb von vierzehn Tagen Probleme melden, sind ein Muster.
Nichts davon heißt, dass ein Ticket ein Urteil ist. Viele Kunden mit vielen Tickets sind intensive, engagierte Nutzer, die gern verlängern. Das Ziel ist nicht, Kontakt als schlecht zu behandeln. Es geht darum, die Veränderung im Muster eines Accounts zu finden. Deshalb vergleicht der folgende Ansatz jeden Kunden immer wieder mit seiner eigenen Historie.
Die fünf Signalfamilien
Die meisten nützlichen Churn-Signale aus dem Support gehören zu fünf Familien. Jede ist günstig zu berechnen, sobald Ihre Support-Daten für AI vorbereitet sind.
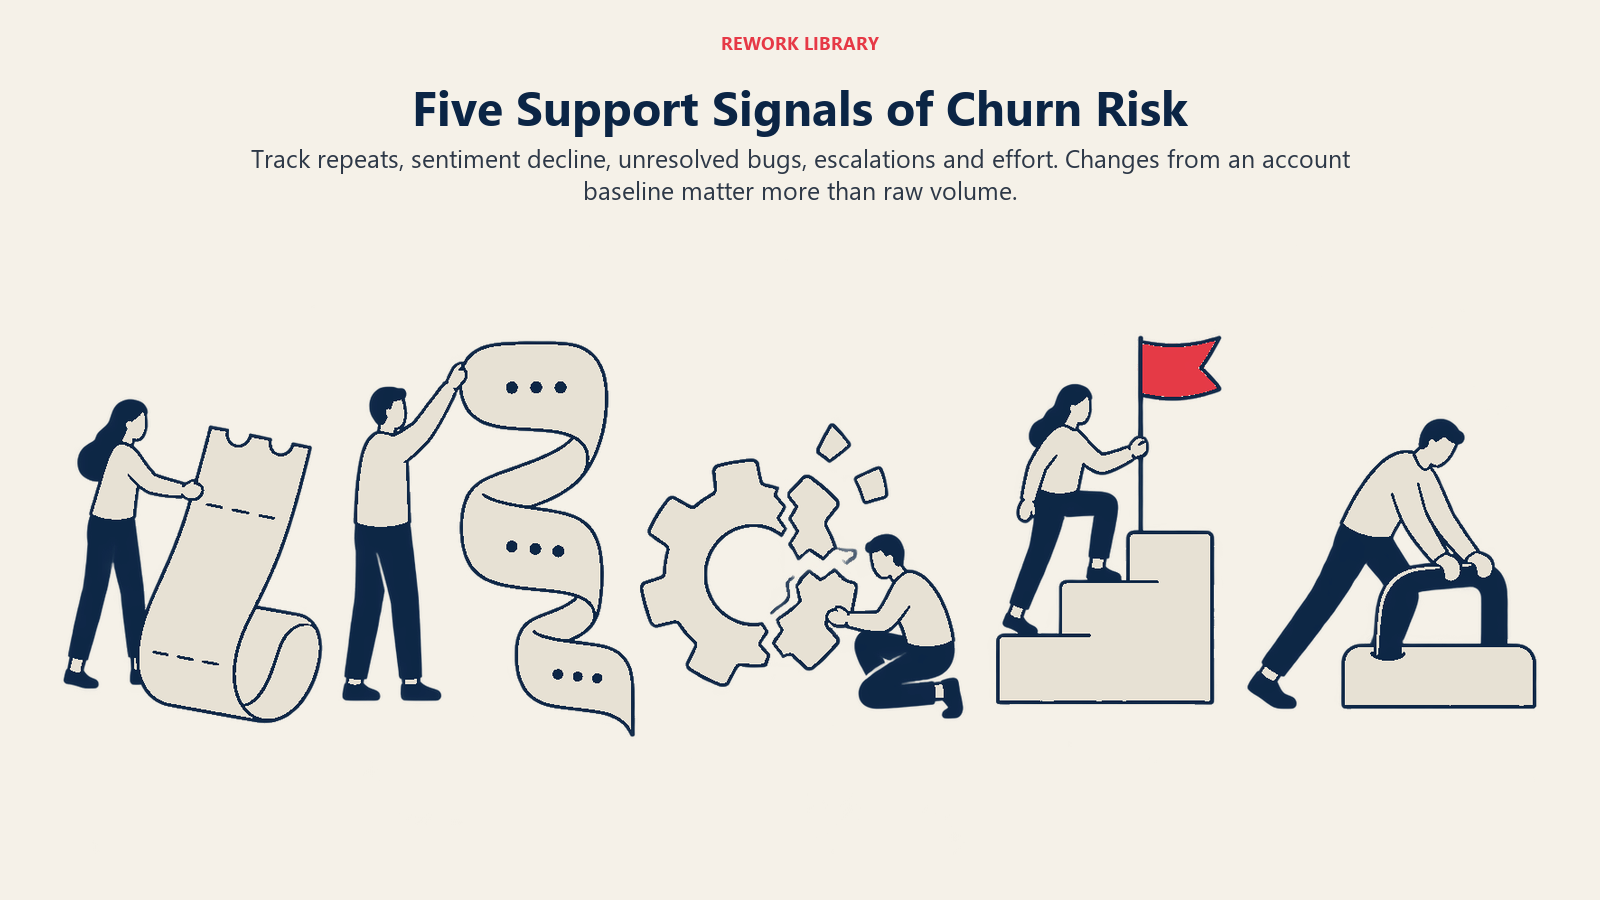
| Signalfamilie | So sieht es aus | Warum es zählt | Typische Falle |
|---|---|---|---|
| Wiederholte Kontakte | Dasselbe Problem wird innerhalb weniger Tage erneut gemeldet, oder der Kunde öffnet ein geschlossenes Ticket wieder | Die erste Lösung hat nicht funktioniert, und der Kunde steckt doppelt Aufwand hinein | Das gesamte Volumen zählen statt Wiederholungen zum selben Problem |
| Negative Stimmung | Der Ton verschlechtert sich innerhalb einer Konversation oder über Wochen hinweg zwischen Tickets | Frust baut sich meist vor der Kündigung auf | Eine scharfe Nachricht als Trend behandeln |
| Ungelöste Bugs | Ein Defekt, der den Account betrifft, bleibt länger offen, als der Kunde erwartet | Der Kunde zahlt für etwas, das nicht funktioniert | Bugs ignorieren, die beim Engineering liegen und nicht beim Support |
| Eskalationen | Schweregrad erhöht, Vorgesetzter verlangt, Executive Sponsor in Kopie | Der Kunde übt maximalen Druck aus | Stille Eskalationen übersehen, die per E-Mail außerhalb des Helpdesks laufen |
| Aufwand | Viele Nachrichten hin und her, viele Handoffs, lange Wartezeiten bis zur ersten Antwort | Mühsames Hilfesuchen zehrt am Wohlwollen | Nur die Lösungszeit messen und nicht die Zahl der Schritte |
Wiederholte Kontakte
Ein wiederholter Kontakt ist das stärkste einfache Signal, denn er bedeutet, dass der Support-Prozess bereits einmal gescheitert ist. Definieren Sie ihn sorgfältig: derselbe Kunde, dasselbe zugrunde liegende Problem, innerhalb eines Zeitfensters Ihrer Wahl (sieben Tage sind ein üblicher Startpunkt). Dafür müssen Tickets nach Thema gruppiert werden, und die Intent-Erkennung bei Kundenanliegen ist dafür das richtige Werkzeug, denn Kunden beschreiben ein Problem mit vielen verschiedenen Worten.
Negative Stimmung
Stimmung ist nur als Verlauf nützlich. Ein Kunde, der immer unverblümt ist, sollte nicht dafür markiert werden. Ein Kunde, der im Januar herzlich war und im März knapp, schon. Wenn Sie bereits einen prognostizierten CSAT nutzen, sind dessen Werte pro Konversation ein fertiger Input. Speichern Sie für die Risikoarbeit den Wert pro Nachricht und verfolgen Sie dann die Veränderung über ein gleitendes Fenster für jeden Account.
Ungelöste Bugs
Das ist das Signal, das die meisten Teams übersehen, weil das Ticket in der Warteschlange des Supports nicht „offen“ ist: Es wurde an das Engineering übergeben und steht auf „ausstehend“. Aus Sicht des Kunden hat sich nichts geändert. Verknüpfen Sie Tickets mit Bug-Datensätzen und messen Sie, wie lange jeder betroffene Account wartet. Dieselbe Verknüpfung zeigt Produktteams, welche Defekte am meisten kosten, wie in Support-Tickets in Produkt-Backlog-Einträge verwandeln beschrieben.
Eskalationen
Eine Eskalation ist der Kunde, der Ihnen sagt, wie ernst es ist. Die IBM-Forschung zu Eskalationen ist hier eine nützliche Referenz: Zu ihren Merkmalen gehören Anstiege des Schweregrads und kundenspezifische Vergleiche der Antwortzeit (Montgomery et al.). Sie können den Gedanken übernehmen, ohne das Modell zu kopieren. Verfolgen Sie Änderungen des Schweregrads, Bitten um einen Vorgesetzten und das Auftauchen eines neuen hochrangigen Namens im Thread.
Aufwand
Aufwand ist am schwersten zu erkennen und oft am aufschlussreichsten. Zählen Sie die Nachrichten bis zur Lösung, die Zahl der beteiligten Mitarbeitenden, die Zahl der Kanalwechsel (Chat zu E-Mail zu Telefon) und die Zeit zwischen der Nachricht des Kunden und der ersten nützlichen Antwort. Ein gelöstes Ticket mit neun Nachrichten und drei Mitarbeitenden ist ein anderes Erlebnis als eines mit zwei.
Wie AI die Signale kombiniert
Ein einzelnes Signal ist verrauscht. Der Wert entsteht durch die Kombination und dadurch, dass jeder Account mit seinem eigenen Normalzustand verglichen wird.
Die Pipeline hat vier Schritte, passend zu den Fähigkeiten Ingest, Analyze, Predict und Execute im ACE Framework:
- Ingest. Ziehen Sie Tickets, Chat-Verläufe, Anruftranskripte, Bug-Verknüpfungen und CSAT-Antworten in eine Ansicht auf Account-Ebene, bezogen auf den Kunden-Account, nicht auf den einzelnen Nutzer.
- Analyze. Ein Sprachmodell labelt jede Konversation: Thema, Stimmung, ob das Problem gelöst wurde, ob der Kunde Abwanderung, Wettbewerber oder Vertragsbedingungen erwähnt. Eine Ticket-Zusammenfassung für jeden Account über die letzten 30 Tage hält die Ausgabe für Menschen lesbar.
- Predict. Ein Scoring-Modell nimmt die Labels plus strukturierte Fakten (Tarif, Vertragsdauer, Renewal-Datum, Nutzungstrend) und erzeugt einen Risiko-Score pro Account. Das kann eine einfache logistische Regression oder ein Gradient-Boosting-Modell sein. Ein komplexeres Modell schlägt ein gut gebautes einfaches selten, wenn Sie nur einige hundert Churn-Beispiele haben.
- Execute. Accounts, die eine Schwelle überschreiten, erzeugen eine Aufgabe für den Verantwortlichen. Das ist der Handoff, der im nächsten Abschnitt behandelt wird.
Zwei Designentscheidungen bestimmen, ob das funktioniert.
Vergleichen Sie mit der Baseline (Ausgangswert) des Accounts. Das Antwortzeit-Merkmal des IBM-Teams ist so gebaut: Es vergleicht, was der Kunde jetzt erhält, mit dem, was er bisher erhielt (Montgomery et al.). Wenden Sie dieselbe Idee auf Volumen, Stimmung und Aufwand an. „Die Ticketzahl ist das Dreifache des Medians dieses Accounts“ ist ein weit besseres Merkmal als „Die Ticketzahl ist 12“.
Trennen Sie den Grund vom Score. Eine nackte Zahl wie „Risiko 0,82“ wird ignoriert. Lassen Sie das Modell die zwei oder drei wichtigsten Einflussgrößen in einfachen Worten zurückgeben. Diese Gründe liest der CSM.
Zur Modellierung über Support-Daten hinaus geht Churn-Prognosemodelle tiefer auf Algorithmen und Trainingsdaten ein. Support-Signale nutzen Sie am besten als einen Input in einem breiteren Health Score, nicht als Ersatz für Nutzungs- und Vertragsdaten.
Ein durchgerechnetes Beispiel (hypothetisch)
Dieses Beispiel dient der Veranschaulichung. Die Zahlen sind erfunden, um die Logik zu zeigen.
Ein Mid-Market-Software-Account eröffnet normalerweise ein Ticket pro Monat. In den letzten drei Wochen waren es fünf. Zwei betrafen denselben Exportfehler, eines wurde wieder geöffnet, und ein verknüpfter Bug ist seit 19 Tagen offen. Der Ton der Nachrichten ist über die letzten drei Tickets von neutral auf knapp gesunken. Das jüngste erwähnt, man „prüfe andere Optionen“.
Kein einzelner Punkt ist alarmierend. Zusammen sind sie es, bei einem Account, der sonst ruhig ist. Das Modell markiert den Account und schreibt: „Support-Volumen das Fünffache des Normalen. Derselbe Exportfehler zweimal gemeldet, Bug seit 19 Tagen offen. Stimmung sinkt. Kunde erwähnte, Alternativen zu prüfen.“ Ein CSM kann darauf in einer Minute reagieren.
Das Flag an den CSM übergeben
Hier scheitern die meisten Programme. Ein Flag, auf das niemand reagiert, ist ein Dashboard. Der Handoff muss so sorgfältig gestaltet werden wie das Modell.
Legen Sie das Flag dorthin, wo der CSM ohnehin arbeitet. Arbeiten CSMs im CRM oder in der Customer-Success-Plattform, erstellen Sie die Aufgabe dort, nicht in einem Bericht, den sie erst öffnen müssen. Dafür gibt es Integrationen: Die Zendesk-Beschreibung von Gainsight nennt zum Beispiel das Verknüpfen von CTAs mit Zendesk-Tickets direkt aus dem Helpdesk (Gainsight Marketplace).
Senden Sie ein Paket, keinen Alarm. Jedes Flag sollte fünf Fragen beantworten, ohne dass der CSM etwas anderes öffnen muss:
| Frage | Was das Flag enthalten sollte |
|---|---|
| Wer ist es? | Account, Verantwortlicher, Tarif, Renewal-Datum |
| Was ist passiert? | Eine Zusammenfassung der letzten 30 Tage Support in zwei Zeilen |
| Warum markiert? | Die wichtigsten Einflussgrößen in einfachen Worten |
| Was ist offen? | Ungelöste Tickets und verknüpfte Bugs, mit Alter |
| Was soll ich tun? | Ein Vorschlag für den ersten Schritt, etwa ein Anruf, eine Nachricht der Geschäftsführung oder ein Statusupdate zum Bug |
Legen Sie Verantwortung und Reaktionszeit fest. Entscheiden Sie, wer jedes Flag verantwortet und wie schnell er reagiert. Ohne das geht der Support davon aus, dass CS sich kümmert, und CS geht davon aus, dass der Support es tut.
Schließen Sie die Schleife. Wenn der CSM handelt, hält er das Ergebnis fest (gerettet, Fehlalarm, bereits am Gehen, Kunde zurückgewonnen). Dieses Feedback sind die Trainingsdaten für die nächste Modellversion, und nur so erfahren Sie, was das Flag wert ist.
Überschwemmen Sie sie nicht. Bekommt ein CSM 40 Flags pro Woche, liest er sie ab Woche drei nicht mehr. Stellen Sie die Schwelle so ein, dass die Zahl der Flags für das Team bearbeitbar ist, und prüfen Sie sie monatlich. Besser 60% der gefährdeten Accounts mit Flags, denen Menschen vertrauen, als 90% mit Flags, die sie ignorieren.
Nicht jedes Flag gehört dem CSM. Ein Flag, das durch einen wiederkehrenden Defekt entsteht, ist ein Produktproblem. Leiten Sie es mit den Belegen ans Produktteam weiter und verfolgen Sie, welche Ursachen immer wiederkehren.
So validieren Sie das Modell
Ein Churn-Flag, das in einer Demo vernünftig aussieht, kann in der Praxis trotzdem falsch sein. Die Validierung beantwortet eine Frage: Kündigen die Accounts, die das Modell markiert, tatsächlich häufiger als die, die es nicht markiert?
Schritt 1: Churn und Prognosefenster definieren
Entscheiden Sie, was zählt: Kündigung, Nichtverlängerung oder ein deutliches Downgrade. Legen Sie dann das Fenster fest, zum Beispiel „Wird dieser Account innerhalb von 90 Tagen nach dem Flag kündigen?“. Ein Modell ohne festgelegtes Fenster lässt sich nicht testen.
Schritt 2: Den Datensatz aus der Vergangenheit aufbauen
Halten Sie für jeden Account zu jedem vergangenen Zeitpunkt die Support-Signale fest, wie sie damals waren, und ob der Account danach innerhalb des Fensters gekündigt hat. Gehen Sie dabei strikt vor: Enthält ein Merkmal Informationen aus der Zeit nach dem Flag-Datum, schummelt das Modell. Ein klassisches Leck ist ein Feld, das erst bei der Kündigung gesetzt wird, etwa ein Tag „Kündigungsgrund“ im letzten Ticket.
Schritt 3: Nach Zeit trennen, nicht zufällig
Trainieren Sie auf früheren Zeiträumen und testen Sie auf späteren. Die übliche gemischte Kreuzvalidierung nimmt unabhängige Stichproben an und liefert bei zeitlich geordneten Daten überhöhte Werte, weil Teststichproben zeitlich nah an Trainingsstichproben liegen (scikit-learn-Dokumentation). Eine zeitbasierte Trennung bildet den echten Einsatz nach: Das Modell lernt aus der Vergangenheit und wird an einer Zukunft gemessen, die es nicht gesehen hat.
Schritt 4: Das Richtige messen
| Kennzahl | Einfach gesagt | Worauf Sie achten sollten |
|---|---|---|
| Precision | Von den markierten Accounts: Wie viele waren wirklich gefährdet? | Niedrige Precision heißt, CSMs verschwenden Zeit und trauen den Flags nicht mehr |
| Recall | Von den Accounts, die gekündigt haben: Wie viele haben wir markiert? | Niedriger Recall heißt, das Modell verpasst den Großteil des Problems |
| Lift | Um wie viel wahrscheinlicher kündigen markierte Accounts als der Durchschnitt? | Ein Lift nahe 1 heißt, das Flag bringt nichts |
| Vorlaufzeit | Wie viele Tage vor der Kündigung wurde das Flag ausgelöst? | Ein Flag eine Woche vor der Kündigung kommt zu spät, um zu helfen |
Precision ist der Anteil der markierten Accounts, die tatsächlich positiv waren, und Recall der Anteil aller Positiven, die das Modell gefunden hat (scikit-learn-Dokumentation). Sie stehen im Konflikt zueinander. Eine höhere Schwelle liefert weniger, verlässlichere Flags und verpasst mehr Kündiger. Wählen Sie die Balance danach, wie viele Flags Ihre CSMs bearbeiten können.
Schritt 5: Mit einer einfachen Baseline vergleichen
Prüfen Sie das Modell gegen etwas Schlichtes: „Markiere jeden Account mit drei oder mehr Tickets in 30 Tagen“ oder Ihren bestehenden Health Score. Schlägt ein AI-Modell die einfache Regel kaum, nehmen Sie die Regel. Verbessert das Modell, wenn es Support-Signale zu einem bestehenden Health Score hinzufügt, den Lift, haben Sie den Beleg, den Sie zum Behalten brauchen.
Schritt 6: Im Feld testen, dann weiter prüfen
Betreiben Sie es einen Renewal-Zyklus lang im Schattenmodus: Accounts markieren, ohne die Arbeit der CSMs zu ändern, und die markierten Accounts dann mit dem Rest vergleichen. Beobachten Sie nach dem Start den Drift (die schleichende Abweichung). Ein neues Produkt-Release, eine Preisänderung oder ein neues Support-Team können verändern, was „normal“ bedeutet. Prüfen Sie Precision und Recall jedes Quartal und nutzen Sie die Ergebnisnotizen der CSMs, um die Fehlalarme zu finden.
Seien Sie bei Kausalaussagen vorsichtig. Ein Flag zeigt, wer wahrscheinlich geht. Es zeigt nicht, dass Ihre Intervention ihn gerettet hat. Um die Wirkung der Ansprache zu messen, halten Sie, wenn Ihr Geschäft das verkraftet, eine zufällige Teilmenge markierter Accounts eine Weile zurück und vergleichen die Ergebnisse.
Checkliste für die Umsetzung
- Wählen Sie eine Churn-Definition und ein Fenster. Beginnen Sie nicht mit dreien.
- Verbinden Sie den Support mit Account-Datensätzen. Tickets müssen auf den Account hochlaufen, nicht nur auf den Nutzer.
- Beginnen Sie mit den fünf Signalfamilien. Ergänzen Sie weitere nur, wenn sie sich bewähren.
- Berechnen Sie Signale gegen die eigene Baseline jedes Accounts.
- Bauen Sie zuerst eine Baseline-Regel, probieren Sie dann ein Modell.
- Geben Sie mit jedem Score Gründe zurück.
- Erstellen Sie Aufgaben im Tool des CSM, mit Verantwortlichem und Reaktionszeit.
- Halten Sie Ergebnisse zu jedem Flag fest.
- Validieren Sie per Zeittrennung und berichten Sie Precision, Recall, Lift und Vorlaufzeit.
- Prüfen Sie quartalsweise und streichen Sie Signale, die nicht mehr helfen.
Häufige Fallstricke
Jeden Kontakt als schlecht behandeln. Intensive Nutzer reichen mehr Tickets ein. Suchen Sie nach Abweichungen von der Baseline des Accounts, nicht nach Rohzahlen.
Nutzer statt Accounts bewerten. Churn ist meist eine Entscheidung auf Account-Ebene. Die schlechte Woche einer Person ist nicht das Risiko des Accounts.
Die Antwort durchsickern lassen. Merkmale, die nach der Kündigungsentscheidung entstehen, lassen das Modell im Test brillant und in der Produktion nutzlos wirken.
Zu viele Alarme. Bei zu vielen Flags hört das Team auf zu lesen. Stellen Sie die Schwelle auf die Kapazität ein.
Ein Flag ohne Playbook. Weiß niemand, was bei einem Flag zu tun ist, hat das Modell keinen Wert. Schreiben Sie zuerst das Playbook.
Bugs ignorieren, die beim Engineering liegen. Bei Tickets im Status „ausstehend beim Engineering“ warten Kunden am längsten. Beziehen Sie sie ein.
Den Kunden bestrafen. Ein Risiko-Flag dient dazu, zu helfen, nicht Service zurückzuhalten. Leiten Sie markierte Kunden nicht in langsamere Warteschlangen und nutzen Sie den Score nicht, um vernünftige Anfragen abzulehnen.
Datenschutz vergessen. Ticket-Texte enthalten personenbezogene Daten. Prüfen Sie, was Ihre Auftragsverarbeitungsbedingungen erlauben, bevor Sie Transkripte an ein Modell senden, und begrenzen Sie, was das Flag dem CSM offenlegt.
Häufig gestellte Fragen zu Support-Signalen und Churn
Welche Support-Signale sagen Churn am besten voraus?
Fünf Familien eignen sich als Start: wiederholte Kontakte zum selben Problem, sich verschlechternde Stimmung im Zeitverlauf, ungelöst bleibende Bugs, Eskalationen und hoher Kundenaufwand. Jede ist nützlicher, wenn sie am üblichen Muster des Accounts gemessen wird statt als Rohzahl.
Kann AI Churn wirklich allein aus Support-Tickets vorhersagen?
Support-Daten sind ein starkes Rohmaterial, wirken aber am besten in Kombination mit Nutzungs-, Vertrags- und Renewal-Daten. Veröffentlichte IBM-Forschung zu Ticket-Eskalationen zeigt, wie viel die Ticket-Historie verraten kann, wobei diese Studie Eskalationen vorhersagte und nicht Churn.
Wie übergeben wir ein Risiko-Flag an einen CSM?
Erstellen Sie eine Aufgabe in dem Tool, das der CSM ohnehin nutzt, mit Account, kurzer Zusammenfassung, den wichtigsten Gründen für das Flag, offenen Tickets und Bugs sowie einem Vorschlag für den ersten Schritt. Legen Sie Verantwortlichen und Reaktionszeit fest und bitten Sie den CSM, das Ergebnis festzuhalten, damit das Modell lernen kann.
Woher wissen wir, ob das Churn-Modell genau ist?
Trainieren Sie auf früheren Zeiträumen und testen Sie auf späteren. Berichten Sie dann Precision, Recall, Lift und Vorlaufzeit gegenüber einer einfachen Baseline-Regel. Zufällig gemischte Aufteilungen liefern bei zeitlich geordneten Daten überhöhte Ergebnisse, vermeiden Sie sie also. Prüfen Sie quartalsweise erneut, denn Produkte und Richtlinien verändern, was normal ist.
Wie viele Tickets sollten ein Churn-Flag auslösen?
Es gibt keine allgemeingültige Zahl. Ein besserer Auslöser ist ein Sprung gegenüber dem üblichen Volumen des Accounts, kombiniert mit weiteren Signalen wie Wiederholungen, Ton und offenen Bugs. Stellen Sie die Schwelle so ein, dass Ihre CSMs pro Woche eine Zahl von Flags bekommen, die sie realistisch bearbeiten können.
Ist es fair, Kunden nach ihrem Support-Verhalten zu bewerten?
Es ist in Ordnung, wenn der Score dazu dient, früher Hilfe anzubieten, und nicht, den Service einzuschränken. Schützen Sie die Daten, erklären Sie in Ihrer Datenschutzerklärung, wie Support-Daten genutzt werden, und verwenden Sie einen Risiko-Score nie, um berechtigte Anfragen abzulehnen oder zu verzögern.

Customer Success Operations Manager
On this page
- Wichtige Fakten
- Warum Support-Daten Churn vorhersagen
- Die fünf Signalfamilien
- Wiederholte Kontakte
- Negative Stimmung
- Ungelöste Bugs
- Eskalationen
- Aufwand
- Wie AI die Signale kombiniert
- Ein durchgerechnetes Beispiel (hypothetisch)
- Das Flag an den CSM übergeben
- So validieren Sie das Modell
- Schritt 1: Churn und Prognosefenster definieren
- Schritt 2: Den Datensatz aus der Vergangenheit aufbauen
- Schritt 3: Nach Zeit trennen, nicht zufällig
- Schritt 4: Das Richtige messen
- Schritt 5: Mit einer einfachen Baseline vergleichen
- Schritt 6: Im Feld testen, dann weiter prüfen
- Checkliste für die Umsetzung
- Häufige Fallstricke