Empati dan Nada dalam Perkhidmatan Pelanggan AI: Di Mana Bot Masih Kurang
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
Empati dalam perkhidmatan pelanggan AI ialah sejauh mana pelanggan berasa dijaga, difahami dan dihormati dalam perbualan dengan bot, dan kajian menunjukkan ia mempunyai dua bahagian: perkataan yang ditulis oleh model, dan apa yang pelanggan percaya tentang siapa penulisnya. Perkataannya selalunya baik. Beberapa kajian mendapati balasan tulisan AI dinilai mesra, malah lebih mesra daripada balasan manusia. Kepercayaan itulah masalahnya. Sebaik sahaja pelanggan tahu mesin yang menunjukkan keprihatinan, ramai yang memandangnya kurang bernilai, dan dalam sesetengah situasi perkhidmatan, bahasa emosi itu memakan diri.
Artikel ini ditujukan kepada pemimpin sokongan dan pengurus CX yang menentukan bagaimana bunyi sesebuah bot dan bila ia perlu berhenti bercakap. Ia sebahagian daripada koleksi AI dalam perkhidmatan pelanggan. Kita akan meneliti apa yang sebenarnya diukur oleh kajian (dan ke atas siapa), di mana pelanggan mahukan seorang manusia, serta satu set garis panduan nada yang boleh anda masukkan ke dalam arahan bot minggu ini.
Fakta Utama
- Dalam tiga kajian vinyet dengan 714 peserta, pelanggan melaporkan kepuasan yang lebih rendah dan kurang kesediaan untuk kembali selepas interaksi dengan chatbot berbanding dengan manusia, dan jurang itu dijelaskan sepenuhnya oleh empati yang dirasakan (Markovitch, Stough dan Huang, Journal of Retailing and Consumer Services, 2024).
- Apabila peserta diberitahu sesuatu balasan datang daripada AI dan bukannya manusia, mereka berasa kurang didengari: 5.13 berbanding 5.81 pada skala 7 mata (Yin, Jia dan Wakslak, PNAS, 2024).
- Merentasi sembilan kajian dengan 6,282 peserta, teks empati tulisan LLM yang serupa dinilai lebih empati dan menyokong apabila dilabelkan manusia berbanding dilabelkan AI (Rubin et al., Nature Human Behaviour, 2025).
- Dalam kajian forum perubatan, penilai menilai 45.1% jawapan chatbot sebagai empati atau sangat empati berbanding 4.6% jawapan doktor (Ayers et al., JAMA Internal Medicine, 2023). Itu soal jawab kesihatan, bukan perkhidmatan pelanggan.
- Separuh daripada pengguna bimbang AI akan menghalang mereka daripada menghubungi seorang manusia (Qualtrics XM Institute, 2026).
- Hampir 75% pengguna mahu tahu sama ada mereka bercakap dengan ejen AI, dan 45% lebih cenderung menggunakannya apabila ada laluan yang jelas kepada seorang manusia (Salesforce, 2024).
Maksud "Empati" bagi Sebuah Bot
Penyelidik membahagikan empati kepada beberapa bahagian, dan pembahagian itu berguna untuk pasukan sokongan. Empati kognitif ialah memahami apa yang dirasakan seseorang dan sebabnya. Empati afektif ialah berkongsi perasaan itu. Empati bermotivasi ialah cukup prihatin untuk bertindak. Sebuah model boleh melakukan yang pertama dengan baik, kerana ia membaca corak, dan ia boleh menulis ayat yang kedengaran seperti dua yang lain. Apa yang tidak mampu dilakukannya ialah merasai apa-apa, dan pelanggan tahu hal itu.
Bagi operasi sokongan, adalah membantu untuk menterjemahkannya kepada tiga perkara praktikal yang sama ada dilakukan atau tidak oleh sesuatu balasan:
- Menamakan masalah sebenar. "Anda dicaj dua kali dan bayaran balik belum muncul" lebih baik daripada "Saya faham kekecewaan anda."
- Mengakui kos kepada pelanggan. Masa yang hilang, tarikh akhir yang terlepas, perbualan yang janggal dengan bos mereka sendiri.
- Melakukan sesuatu tentangnya. Bayaran balik, eskalasi, langkah seterusnya yang konkrit dengan pemilik dan masa.
Perkara ketiga ialah tempat bot dihadkan oleh kebenaran akses, bukan oleh bahasa. Bot yang kedengaran prihatin tetapi tidak dapat mengeluarkan bayaran balik ialah bot yang kedengaran prihatin dan kemudian gagal.
Apa yang Ditunjukkan oleh Kajian
Kebanyakan kajian ini menggunakan pertukaran bertulis yang pendek, peserta dalam talian dan interaksi tunggal, bukan barisan gilir sokongan sebenar. Berikut ialah apa yang dilakukan oleh setiap kajian, supaya anda dapat menilai sejauh mana ia boleh diterapkan.
Teks AI boleh dibaca sebagai lebih empati daripada teks manusia
Hasil yang paling terkenal datang daripada kajian JAMA Internal Medicine. Penulisnya mengambil 195 soalan awam daripada forum kesihatan Reddit, dengan jawapan daripada doktor bertauliah, dan menjana balasan ChatGPT (GPT-3.5) bagi setiap satu. Tiga profesional kesihatan berlesen, yang juga merupakan penulis bersama, menilai pasangan jawapan itu tanpa mengetahui yang mana satu. Mereka memilih chatbot dalam 78.6% penilaian, dan menilai jawapannya lebih tinggi dari segi empati (min 3.65 berbanding 2.15 pada skala 5 mata). Satu perincian sangat penting: jawapan chatbot jauh lebih panjang, dengan median 211 perkataan berbanding 52 bagi doktor (Ayers et al., 2023).
Jadi apa yang boleh diambil oleh pemimpin sokongan daripadanya? Bukan bahawa bot lebih empati daripada ejen terbaik anda. Doktor menjawab orang yang tidak dikenali dalam forum awam percuma, mungkin dalam beberapa baris, dan penilainya ialah profesional kesihatan yang membaca teks. Bacaan yang selamat lebih sempit: apabila model diminta menulis balasan yang teliti dan mengakui perasaan, sementara seseorang menulis balasan yang pantas, versi model itu boleh dibaca sebagai lebih mesra. Itu soal usaha dan panjang, dan ia alasan untuk menggunakan AI bagi membantu ejen menulis balasan yang lebih baik (lihat AI agent assist).
Kajian USC menunjuk ke arah yang sama. Peserta menceritakan situasi yang menekan dan kemudian membaca satu respons. Dalam eksperimen utama, 540 peserta AS direkrut di Prolific, dan 455 menamatkan peringkat akhir. Respons yang ditulis oleh Bing Chat (GPT-4) membuatkan orang berasa lebih didengari berbanding respons yang ditulis oleh peserta lain (5.74 berbanding 5.17 pada skala 7 mata). Penulis mengaitkannya dengan sokongan emosi: AI memberikan lebih banyak sokongan itu (5.76 berbanding 4.64) dan lebih sedikit cadangan praktikal (3.28 berbanding 4.31), dan sokongan emosi, bukan nasihat, dikaitkan dengan rasa didengari (Yin, Jia dan Wakslak, 2024). Penjawab manusia ialah orang asing yang tidak dikenali dan balasannya sekitar 50 hingga 60 perkataan, jadi ini tidak menunjukkan bagaimana ejen berpengalaman yang mengenali pelanggan akan dibandingkan.
Label AI menarik balik sebahagian daripadanya
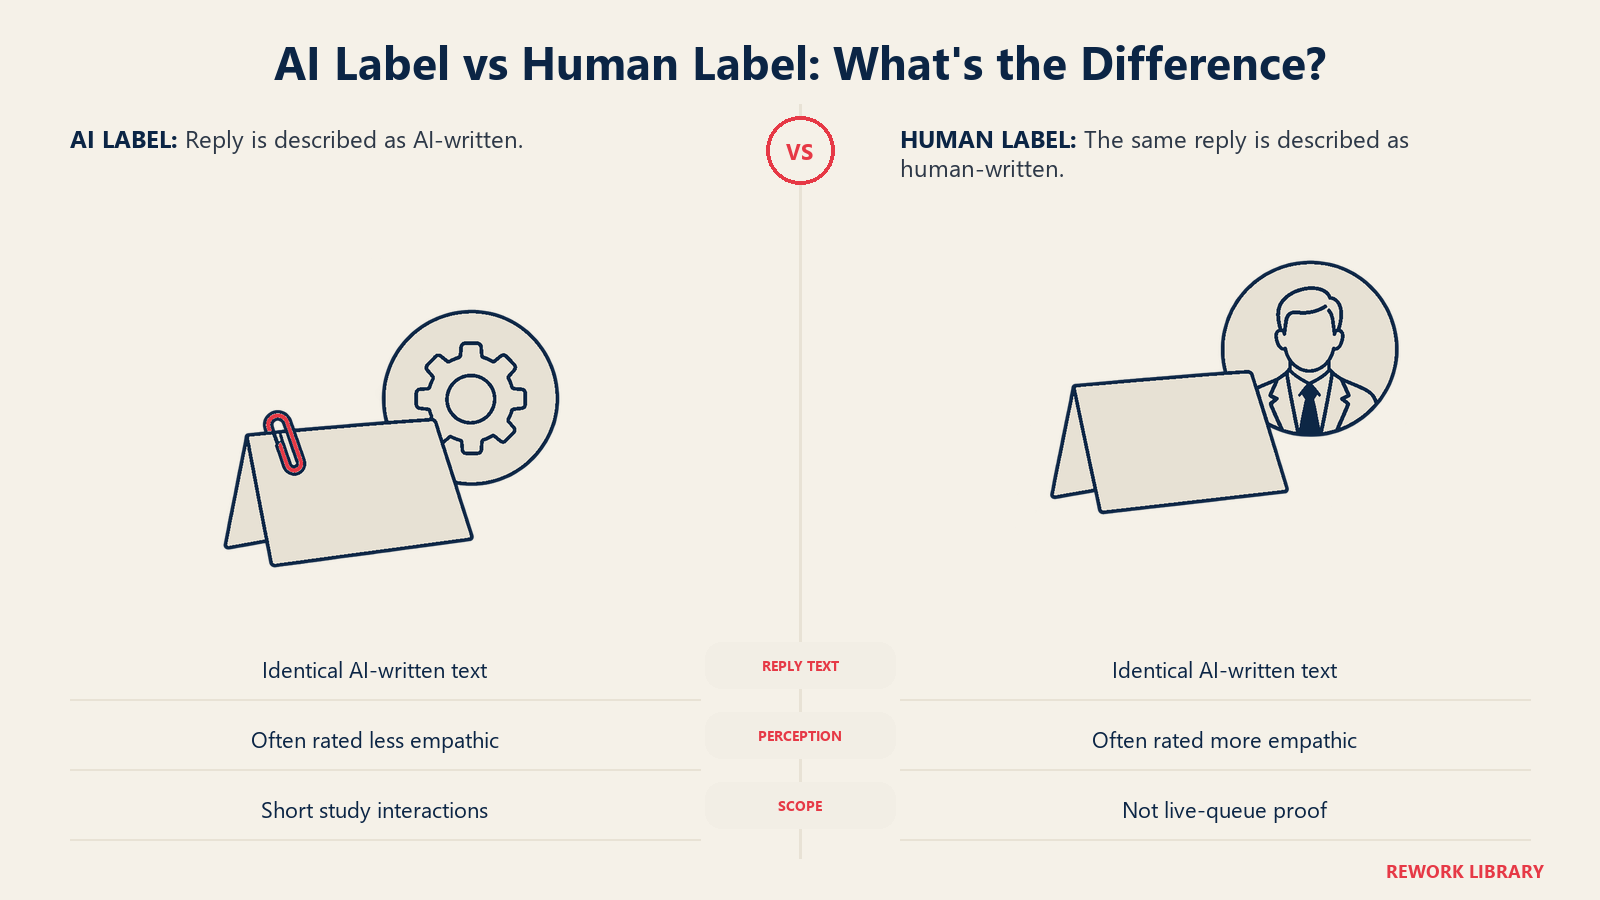
Eksperimen USC yang sama menyilangkan sumber sebenar dengan label. Kesan label hampir sebesar kesan penulisan, dan ke arah yang bertentangan. Balasan yang dipercayai daripada AI membuatkan orang berasa kurang didengari berbanding balasan yang dipercayai daripada manusia, siapa pun penulis sebenarnya. Kedua-dua kesan itu hampir mengimbangi: teks AI di bawah label AI (5.41) mendarat hampir sama dengan teks manusia di bawah label manusia (5.51), manakala teks AI yang dipercayai sebagai manusia mendapat skor tertinggi (6.12). Penulis menyatakan tiada keadaan tanpa label, jadi mereka tidak dapat memastikan sama ada label AI menurunkan perasaan atau label manusia menaikkannya (Yin, Jia dan Wakslak, 2024).
Makalah Nature Human Behaviour menolak dapatan yang sama dengan lebih kuat. Dalam setiap kajian, penyelidik meminta LLM menulis respons empati kepada situasi emosi orang ramai dan memberitahu peserta sama ada manusia atau AI yang menulisnya. Teksnya sama. Versi "manusia" dinilai lebih empati, lebih menyokong, dan menghasilkan lebih banyak emosi positif serta lebih sedikit emosi negatif. Jurang itu bertahan merentasi panjang respons, kelewatan dan model yang berbeza. Ia paling kuat bagi respons yang menekankan perkongsian perasaan dan keprihatinan, dan lebih lemah bagi jenis yang semata-mata memahami. Orang yang mengesyaki, tanpa digesa, bahawa AI membantu menulis balasan berlabel manusia turut menilainya lebih rendah. Apabila mereka mahukan penglibatan emosi, mereka memilih seorang manusia (Rubin et al., 2025).
Ini mempunyai implikasi yang jelas untuk sokongan. Sebahagian daripada nilai "Saya amat kesal perkara ini berlaku" bagi pelanggan ialah ada seseorang yang memilih untuk mengatakannya. Singkirkan seseorang itu dan ayat yang sama bernilai kurang. Ini juga bermakna anda tidak patut menyembunyikan bot untuk mendapatkan semula skor empati: kajian yang sama mencadangkan bahawa penemuan kemudian itu mahal, dan kebanyakan pengguna berkata mereka mahu tahu juga (data tinjauan ada dalam jadual di bawah).
Kajian perkhidmatan pelanggan: empati menjelaskan jurang kepuasan
Dua makalah meneliti suasana perkhidmatan secara langsung. Dalam yang pertama, Markovitch dan rakan sekerja menjalankan tiga kajian vinyet. Pelanggan menilai perkhidmatan chatbot lebih rendah daripada perkhidmatan manusia dari segi kepuasan, patronaj semula, penerimaan cadangan dan kesediaan mengesyorkan, sama ada hasilnya baik atau buruk. Empati yang dirasakan menjelaskan kesan itu sepenuhnya. Dan ada tuas reka bentuk: apabila chatbot ditulis supaya berkomunikasi dengan lebih empati, penilaian meningkat ke tahap ejen manusia, sementara menjadikannya kelihatan lebih seperti manusia tidak membantu. Kajian keempat, dengan 100 orang yang menggunakan ChatGPT untuk nasihat perubatan, menyokong corak yang sama (Markovitch, Stough dan Huang, 2024). Perhatikan bahawa ini ialah vinyet dan interaksi pendek, bukan pelanggan berulang yang hidup bersama bot selama setahun.
Makalah kedua menambah amaran. Han, Yin dan Zhang menjalankan tiga eksperimen dalam MIS Quarterly, satu dengan chatbot LLM langsung. Balasan chatbot yang mengakui dan mencerminkan perasaan negatif pelanggan sering mencetuskan reaktans psikologi, iaitu rasa bahawa sempadan atau kawalan diri sedang ditolak. Itu menjadikan bot kelihatan kurang cekap dan menurunkan kualiti perkhidmatan yang dirasakan serta kepuasan. Empati daripada ejen manusia kekal berkesan (University of South Florida, meringkaskan kajian itu). Liputan itu tidak memberikan saiz sampel, jadi anggaplah saiz kesannya tidak diketahui dan arahnya sebagai peringatan.
Gabungkan kedua-duanya dan anda mendapat peraturan yang lebih berguna daripada "tambah empati." Perkataan empati mengangkat sebuah bot apabila ia tentang situasi pelanggan. Pencerminan emosi ("Saya dapat merasakan betapa menyedihkannya ini") boleh memakan diri, terutamanya selepas sesuatu berlaku dengan salah.
Di Mana Pelanggan Mahukan Manusia
Kajian empati menjelaskan mengapa data tinjauan tentang akses kepada manusia kelihatan seperti itu. Pelanggan tidak menentang AI melakukan kerja. Mereka berwaspada terhadap AI yang berdiri di antara mereka dan seorang manusia apabila masalahnya penting.
| Isyarat | Sumber | Maksudnya untuk reka bentuk anda |
|---|---|---|
| Bimbang AI akan menyekat akses kepada seorang manusia | Qualtrics XM Institute, 20,000+ pengguna di 14 negara | Letakkan pilihan manusia pada setiap skrin, bukan di sebalik gelung yang gagal |
| Hampir satu daripada lima yang menggunakan AI untuk perkhidmatan tidak nampak apa-apa manfaat | Qualtrics | Hadkan bot kepada tugas yang dapat diselesaikannya; jangan jadikannya penjaga pintu |
| Mahu tahu ia ejen AI | Salesforce, 15,015 pengguna di 18 negara | Dedahkan dalam mesej pertama |
| Kesediaan lebih tinggi menggunakan ejen AI apabila laluan kepada seorang manusia jelas | Salesforce | Jalan keluar yang kelihatan meningkatkan kesediaan mencuba bot |
| 30% akan memilih AI untuk perkhidmatan lebih pantas | Salesforce | Kelajuan ialah tarikan, jadi dahulukan jawapan, bukan perbualan kosong |
Cadangan Qualtrics sendiri ialah AI mengendalikan permintaan mudah dan transaksional, kemudian membekalkan latar belakang dan penyelesaian yang dicadangkan kepada ejen manusia bagi permintaan yang rumit. Tinjauan tidak mengukur secara langsung "keperluan empati," jadi jangan mendakwa sedemikian. Tetapi gabungkannya dengan hasil makmal dan satu peraturan penghalaan yang munasabah terhasil:
- Biarkan bot mengendalikan permintaan di mana pelanggan mahukan jawapan, bukan hubungan: status pesanan, set semula kata laluan, soalan dasar, pertukaran alamat.
- Serahkan kepada seorang manusia apabila pelanggan kecewa tentang sesuatu kegagalan, apabila wang atau pembatalan dipertaruhkan, apabila mereka memintanya, atau apabila bot tersilap dua kali.
- Bantu orang itu dalam kes tersebut dengan ringkasan dan cadangan perkataan. Halaman automasikan atau bantu membincangkan cara membuat keputusan, dan apa yang pelanggan jangkakan daripada perkhidmatan AI menyelami sisi tinjauan dengan lebih mendalam.
Garis Panduan Nada untuk Bot Anda
Berikut ialah satu set peraturan untuk ditulis ke dalam arahan bot dan disemak. Ia diambil daripada dapatan di atas, ditambah akal sehat tentang balasan bertulis yang pendek.
| Situasi | Balasan lemah | Balasan lebih kukuh |
|---|---|---|
| Pesanan lewat | "Saya faham kekecewaan anda. Biar saya bantu." | "Pesanan anda dijadualkan tiba pada hari Selasa dan masih dalam perjalanan. Saya telah menyemak status pembawa dan kini ia dijadualkan pada hari Jumaat." |
| Caj berganda | "Saya sangat kesal anda berasa marah tentang caj ini." | "Anda dicaj dua kali pada 3 Mac. Saya sedang menghantar semula caj pendua itu ke kad anda sekarang; biasanya ia muncul dalam 5 hingga 7 hari bekerja." |
| Bot tidak dapat membantu | "Malangnya saya tidak dapat membantu dalam hal itu." | "Saya tidak dapat menukar terma pelan. Saya menyerahkan perkara ini kepada pakar pengebilan bersama perbualan penuh supaya anda tidak perlu mengulang." |
| Permintaan pembatalan | "Kami sedih melihat anda pergi!" | "Difahami. Inilah cara membatalkan, dan seorang manusia tersedia jika anda mahu membincangkannya." |
Apa yang dikongsi oleh contoh-contoh itu:
- Nyatakan apa yang berlaku, dalam istilah pelanggan. Perincian dibaca sebagai kefahaman. Simpati generik dibaca sebagai skrip.
- Langkau emosi yang dicerminkan. Jangan beritahu pelanggan bagaimana perasaan mereka. Memandangkan dapatan reaktans, "Saya nampak anda marah" lebih berisiko daripada bot berbanding "Perkara itu tidak sepatutnya berlaku."
- Pasangkan setiap pengakuan dengan tindakan atau langkah seterusnya. Empati tanpa apa-apa di belakangnya ialah perkara yang dirungutkan pelanggan.
- Ringkaskan. Hasil forum perubatan sebahagian besarnya tentang jawapan panjang mengalahkan jawapan tergesa-gesa. Panjang bukan matlamat dalam sembang. Lengkap itulah matlamatnya. Liputi masalah, penyelesaian dan langkah seterusnya, kemudian berhenti.
- Dedahkan, dengan jelas dan awal. "Saya pembantu AI. Saya boleh membantu dengan pesanan dan pengebilan, atau menghubungkan anda dengan seorang manusia." Jangan beri bot nama manusia dan kelewatan menaip. Penyelidikan label menunjukkan penemuan kemudian merugikan anda.
- Minta maaf untuk kejadian itu, bukan untuk perasaan. "Maaf bayaran balik mengambil masa selama ini" adalah tepat. "Maaf anda rasa begitu" ialah cara klasik untuk memburukkan keadaan.
- Padankan gaya dengan saluran dan pelanggan. Balasan ringkas sesuai untuk pembangun yang menampal ralat. Balasan yang lebih mesra sesuai untuk aduan pengebilan, dan konteks akaun dan sejarah memberitahu bot pelanggan mana yang sedang dilayannya. Baca niat dahulu dengan pengesanan niat pelanggan.
- Jangan berjanji perkara yang hanya boleh diputuskan oleh manusia. Bayaran balik di luar dasar, pengecualian dan kredit muhibah adalah milik manusia yang menerima serahan daripada bot.
- Tawarkan jalan keluar sekali, dengan jelas. Satu baris, di tempat yang sama setiap kali.
Langkah demi Langkah: Menetapkan Nada untuk Bot Sokongan Anda
- Susun sebab hubungan teratas anda mengikut beban emosi. Tandakan setiap satu sebagai bermaklumat, mengecewakan atau berisiko tinggi. Yang pertama boleh diautomasikan sepenuhnya. Yang terakhir harus dihalakan kepada manusia.
- Tulis ringkasan nada sebagai contoh, bukan kata sifat. "Mesra tetapi profesional" tidak memberi model apa-apa untuk ditiru. Lima balasan yang baik dan lima yang buruk memberinya sesuatu.
- Larang frasa berskrip. Senaraikan baris yang anda tidak mahu langsung ("Saya faham kekecewaan anda," "maaf anda rasa begitu," "Saya memohon maaf atas sebarang kesulitan") dan uji bahawa ia sudah tiada.
- Tetapkan pencetus eskalasi. Penanda kemarahan, perkataan pembatalan, jawapan kedua yang gagal, permintaan terus untuk seorang manusia, dan sebarang pertikaian wang melebihi ambang. Isyarat sentimen boleh membantu; lihat entri glosari analisis sentimen untuk apa yang boleh dan tidak boleh dikatakannya kepada anda.
- Jadikan serahan membawa konteks. Orang itu harus melihat transkrip penuh dan butiran akaun. Tiada yang menenggelamkan empati bot lebih pantas daripada pelanggan terpaksa bermula semula.
- Uji dengan transkrip sebenar. Ambil 50 perbualan terkini, jalankan melalui bot, dan minta dua ejen menilai nada secara buta. Perselisihan menunjukkan di mana ringkasan itu kabur.
- Skor nada dengan rubrik, bukan perasaan. Semakan yang boleh diperhatikan paling berkesan ("menamakan masalah khusus," "memberi langkah seterusnya"). Panduan jaminan kualiti (QA) AI menunjukkan cara menentukur pemarkahan itu dengan penyemak manusia.
- Ukur hasil di sisi pelanggan. Hubungan semula dalam seminggu, kadar serahan, masa untuk menghubungi seorang manusia, dan semakan kepuasan satu soalan selepas sembang bot sahaja.
Kesilapan Lazim
- Menganggap satu kajian sebagai universal. Kajian forum soalan kesihatan tidak banyak membantu tentang pertikaian bayaran balik. Setiap kali anda membaca statistik empati, tanya siapa pesertanya, apa yang mereka nilai dan sama ada ia interaksi sebenar.
- Menyembunyikan bahawa ia bot untuk memperoleh mata empati. Penyelidikan label menunjukkan jurang itu nyata, dan pelanggan berkata mereka mahu tahu. Pendedahan ialah jalan yang jujur dan lebih murah apabila ia ditemui.
- Menggunakan pencerminan emosi selepas kegagalan. Di sinilah dapatan reaktans memberi kesan paling teruk.
- Mengelirukan panjang dengan keprihatinan. Balasan panjang mendapat skor baik dalam satu kajian. Dalam tetingkap sembang, ia hanya melambatkan orang.
- Memberi bot empati tetapi bukan kuasa. Balasan yang baik hati tetapi berakhir dengan "Saya tidak boleh berbuat demikian" lebih teruk daripada balasan biasa yang dihalakan dengan pantas.
- Melatih ejen untuk berbunyi seperti bot. Jika AI menulis pengakuan yang lebih baik daripada pasukan anda, gunakannya sebagai bantuan penulisan, bukan templat untuk disalin perkataan demi perkataan.
- Tidak pernah menguji semula. Model, dasar dan mood pelanggan berubah. Jalankan semula ujian transkrip setiap suku tahun.

Customer Success Operations Manager
On this page
- Fakta Utama
- Maksud "Empati" bagi Sebuah Bot
- Apa yang Ditunjukkan oleh Kajian
- Teks AI boleh dibaca sebagai lebih empati daripada teks manusia
- Label AI menarik balik sebahagian daripadanya
- Kajian perkhidmatan pelanggan: empati menjelaskan jurang kepuasan
- Di Mana Pelanggan Mahukan Manusia
- Garis Panduan Nada untuk Bot Anda
- Langkah demi Langkah: Menetapkan Nada untuk Bot Sokongan Anda
- Kesilapan Lazim