AI拡張型の仕事における個人の貢献をどう測るか
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
AI拡張型の仕事における個人の貢献を測るとは、モデルとワークフローも生成に関わった成果物に対して、一人の判断と意思決定が何を付け加えたかを切り分けることです。 これは報酬、昇進、説明責任に関わる問題ですが、素朴なアクティビティ指標(クローズしたチケット数、下書きした語数、ツールの利用状況)はAIによって水増しされ、誰の実際の貢献も反映しなくなります。この問題を完全に解決した組織はありません。最も擁護しやすいアプローチは、単一の数字ではなく、先行指標、チームレベルの説明責任、そして誠実な人間の判断を組み合わせることです。
重要なポイント
- 経済学者チャールズ・グッドハートが1975年に提唱し、人類学者マリリン・ストラザーンが1997年に「指標が目標になると、それは良い指標ではなくなる」という形で広めたグッドハートの法則は、貢献の指標が報酬と結びついたときに何が起きるかを説明しています(Wikipedia, "Goodhart's law")。
- DORAの2024年版State of DevOpsレポートは、個人の成果(満足度、フロー、自己申告の生産性)を、チームやシステムレベルのデリバリー指標と切り分けています。そしてAIの導入が個人の生産性とフローを高めた一方で、チームレベルではデリバリーの安定性とスループットを測定可能なほど損なったことを明らかにしました(DORA, Accelerate State of DevOps Report 2024)。
- SPACEフレームワークは、開発者の生産性をコード行数やコミット数のような単一のアクティビティ指標に還元することを戒めています。こうした指標は目に見える活動と実際の成果を混同し、個人評価と結びつけるとゲーム化されるからです(Forsgren et al., "The SPACE of Developer Productivity," ACM Queue, 2021)。
- 94の独立したサンプル、23,461人の労働者を対象としたメタ分析では、電子的なパフォーマンス監視が個人の成果を高めるという証拠は見つからず、導入方法にかかわらず労働者のストレスを確実に高めることがわかりました(Ravid et al., "A meta-analysis of the effects of electronic performance monitoring on work outcomes," Personnel Psychology, 2023)。
- MIT NANDAによる300件以上の企業のAI導入のレビューでは、生成AIのパイロットの95%で測定可能なP&Lへの影響が見られませんでした。研究者はこのギャップの原因を、個人の努力ではなく、測定されていないワークフロー要因に求めています(MIT NANDA, "The GenAI Divide: State of AI in Business 2025", via Fortune)。
帰属の問題が再び重要になった理由
帰属の問題は、AI以前にも完全には解決されていませんでした。同僚が見つけてきた案件を成約させる営業担当者や、デザイナーが仕様を決めた機能をリリースするエンジニア。仕事は常に協働的であり、功績の配分は常にある程度が判断の問題でした。AIがこの問題を生み出したわけではありません。AIは、昔からある問題を、より多くの場面で同時に重要な問題にしました。今やほぼすべての成果物に、インタビューも昇進も説明責任の追及もできない3人目の貢献者がいるからです。
報酬と昇進は今も個人の成果を前提としている
報酬と昇進の判断は、成果を一人の判断に、合理的な確信をもって遡れることを前提としています。この前提は四半期ごとに不安定になっています。ある担当者がAIアシスタントを使って15通のアウトバウンドメールを書き、3件を成約させ、アシスタントを使わない同僚が手作業で5通を書いて2件を成約させたとします。どちらの四半期が、より優れた判断を反映しているでしょうか。報酬制度が頼りにする仕組みは、こうした曖昧さを想定して作られていませんが、まだ明らかな代替手段がないため、ほとんどの企業はそれでも運用を続けています。AI時代の報酬と公平性では、一人の成果が、その背後にある判断ではなくツールのおかげで5人分に見えるとき、報酬のロジックの何が実際に崩れるのかをさらに掘り下げています。
モデルが手伝ったからといって説明責任は消えない
AIが支援した意思決定がうまくいかなかったとき(見落とした契約条項、約束しすぎた顧客へのメール、モデルに組み込まれた誤った前提)、誰かがその責任を負わなければなりません。言語モデルをパフォーマンス改善計画の対象にすることはできません。これは報酬のための貢献の測定と関連はしていても別の問題です。うまくいったときに誰がボーナスを受け取るかではなく、何かが壊れたときに誰が答えるかという問題であり、「人が決めた」と「ツールが出した」の境界が曖昧になったことで、どちらも難しくなっています。
功績の扱いはリーダーが過小評価する形で士気を左右する
功績の配分が間違っていれば、人はすぐに気づきます。問題を定義し、モデルのもっともらしく聞こえる誤答を見つけたチームメンバーが、AIの下書きをそのまま受け入れただけの同僚が同じ功績を得るのを目にすれば、職場の信頼はあっという間に損なわれます。帰属を目に見える形で何度か誤れば、最も優秀な人たちは、測りにくい難しい仕事を静かに減らしていきます。その仕事は評価されないと、制度から伝えられたばかりだからです。
素朴なアクティビティ指標が以前より深刻に機能しなくなる理由
どの組織にも、すでに何らかのアクティビティ指標があります。クローズしたチケット数、コード行数、下書きした語数、発信した通話数などです。これらはもともと価値の不完全な代理指標でした。AIは、その代理指標を特定の形で壊します。アクティビティを大量に生み出すことは極めて簡単になる一方で、実際の判断(これは正しい答えだったか、検証に耐えたか)は、以前とまったく同じ難しさのまま、あるいはむしろ難しくなります。今は、成果物を作るだけでなく、誰かがその出力を検証しなければならないからです。
グッドハートの法則は、すでにこの事態を待ち構えていた
グッドハートの法則は、目標になった指標は良い指標ではなくなると述べています。人は本来の目的ではなく、指標が報いるものを中心に努力を組み替えるからです。これはAIに限った話ではありません。教師が標準テストに合わせて授業を絞り込むのも、コールセンターの担当者が問題を解決するのではなく処理時間の目標を達成するために通話を短くするのも、同じ仕組みです。AIが変えるのは、ゲーム化の速さです。以前は水増しに実際の労力が必要だった指標(コードをより多く書く、メールをより多く下書きする)が、今ではいくつかのプロンプトとほとんど判断なしで水増しできます。そのため、「数字が上がった」と「価値が上がった」の間のギャップは、ほとんどの評価制度が調整できるよりも速く広がります。
指標がかつて測っていたものと、今報いているもの
| 指標 | 測っているように見えたもの | 今、実際に報いているもの |
|---|---|---|
| コード行数・コミット数 | エンジニアリングの成果と労力 | 動くソフトウェアとは無関係な、冗長なAI生成コードとコミットの水増し |
| 週あたりのクローズしたチケット数 | サポートのスループット | 難しいチケットを解決せず、AI支援で簡単なチケットをより多くのチケットに分割すること |
| 下書きした語数・文書数 | 執筆の成果 | AIが下書きしたテキストの量であり、その背後にある思考、編集、判断ではない |
| 応答時間・対応の速さ | 即応性と勤勉さ | 検証していないAIの下書きを素早く出すことで、それが間違っていた場合に気づくことではない |
| AIツールの利用頻度(「シート導入率」) | AIの習熟度と熱意 | 「承認」を繰り返しクリックすることであり、出力の検証、修正、改善ではない |
| 送信した会議・メッセージ数 | 協働とエンゲージメント | AI支援によるメッセージの量で、意思決定の数が変わらなくても急増しうる |
ソフトウェアエンジニアリングがすでに痛い思いをして学んだ教訓
ソフトウェアチームは、この問題に最初に直面しました。コードの出力は、AIが最も早い段階で水増しを容易にしたものの一つだったからです。業界の答えはSPACEフレームワークとして体系化され、個人に対する単一のアクティビティ指標を退け、生産性を5つの次元(満足度、パフォーマンス、アクティビティ、コミュニケーション、効率)で測るというものでした。そのほとんどは、チームやシステムのレベルでしか意味を持ちません。DORAの2024年の調査はこれを、やっかいな発見で裏づけています。AIの導入は個々の開発者が感じる生産性を高めた一方で、ソフトウェアが確実にリリースされるかを予測するチームレベルの指標を、測定可能なほど損ないました。個人の数字だけを読めば、AIは疑いようのない勝利に見えます。チームレベルの数字を並べて読むと、より正直な姿が現れます。本コレクションがAIの生産性パラドックスで記録しているのと同じパターンで、個人のシグナルと組織の成果が、同時に逆方向に動くことがあるのです。
チームレベルと個人レベルのトレードオフ
これは、名指ししているかどうかにかかわらず、すべてのリーダーが最終的に折り合いをつけるトレードオフです。
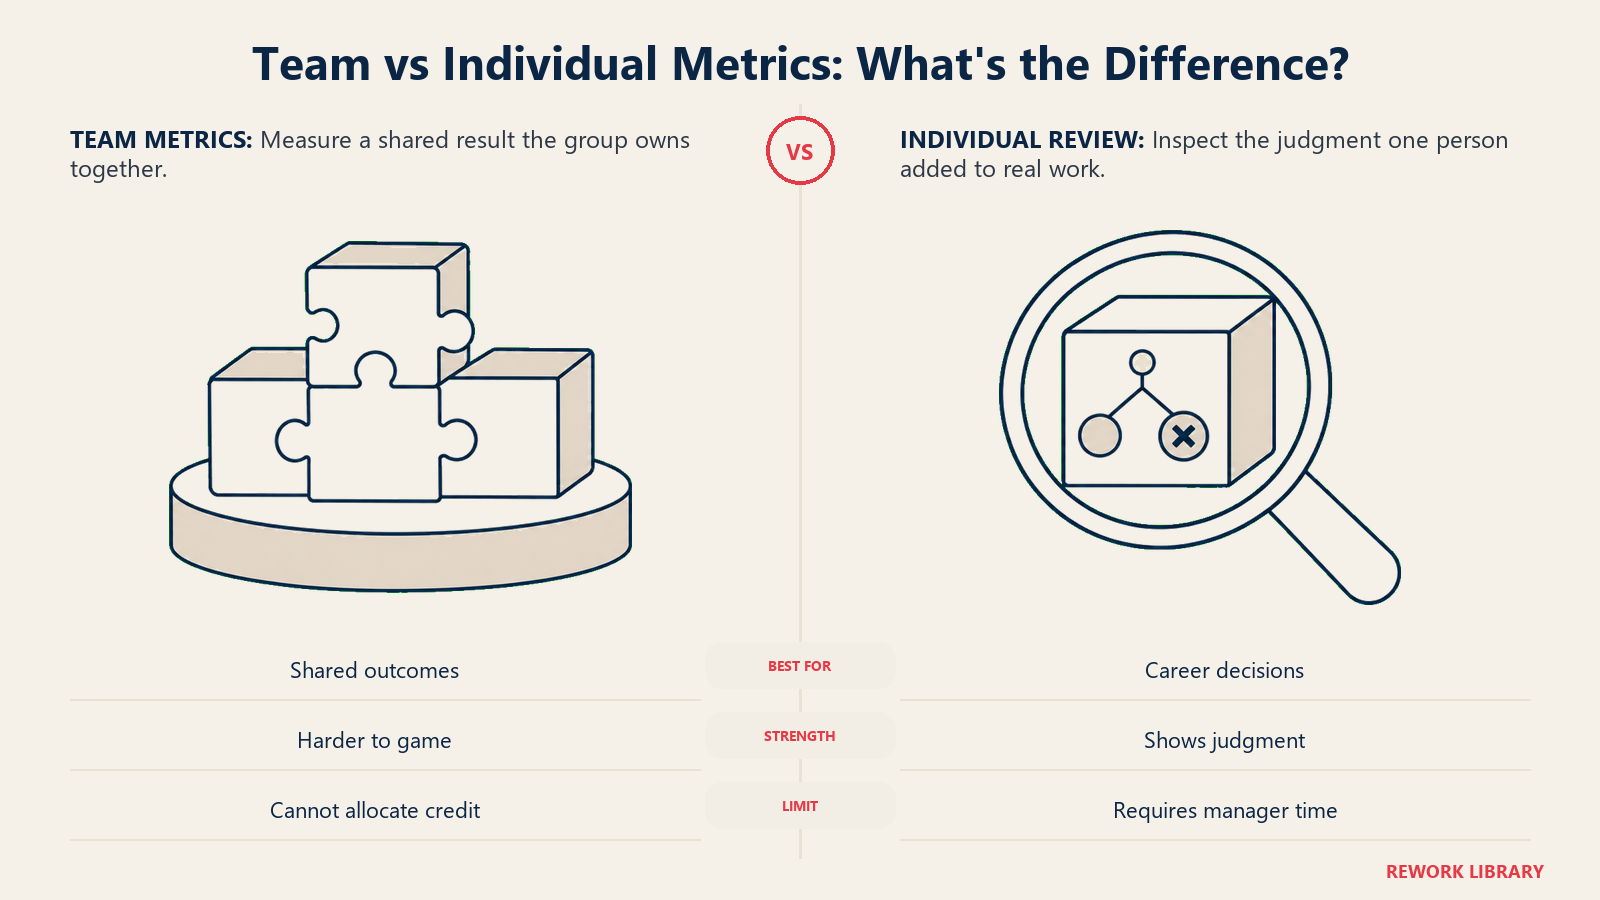
チームレベルの測定はより誠実だが、報酬の問いには答えない
チームやワークフローのレベルで成果を測ること(このポッドは機能をリリースしたか、顧客の解約は減ったか)は、ゲーム化に強くなります。共有の数字を一人が水増しすれば、残りのチームが気づきやすいからです。これは、現在のオーケストレーター型の役割の働き方にも合っています。仕事のほとんどが判断と調整であり、どのアクティビティ指標にも見えないのに、それがチームの成果が良い理由であることもあります。その代わり、チームレベルの測定だけでは、誰を昇進させ、誰により多く支払うべきかはわかりません。
個人レベルの測定はリーダーが求めるものであり、より難しい問題でもある
報酬や昇進の制度は、最終的にはどれも個人のシグナルを必要とします。報酬の判断は、ポッドではなく人についてなされるからです。しかし、一人の限界的な貢献を精密に切り分けようとするほど、誰も解けていない問題にぶつかります。プロンプトを上手に書き、モデルのミスを見つけ、20分で優れた成果を出した人は、どのアクティビティ指標で見ても、最初の下書きをそのまま受け入れ、運よく平凡なものを出した人と同じに見えることがあります。2つの成果は同じではありませんが、ほとんどの制度は、人間が実際の仕事をレビューしなければ、両者を区別できません。
きれいな解決策はなく、あるふりをするほうが悪い
誠実な立場は、両方のレンズを必要とします。グループ全体に影響する意思決定にはチームレベルの指標を、誰を昇進させるかのように、どうしても一人についての意思決定には個人の判断に基づくレビューを使うのです。この個人の層をダッシュボードで自動化しようとするところで、ほとんどの害が生じます。
それでもシグナルを持つ先行指標
以下のどれも、アクティビティ数のように速く安価にゲーム化することはできません。いずれも、観察者が仕事を数えるのではなく、実際に見る必要があるからです。
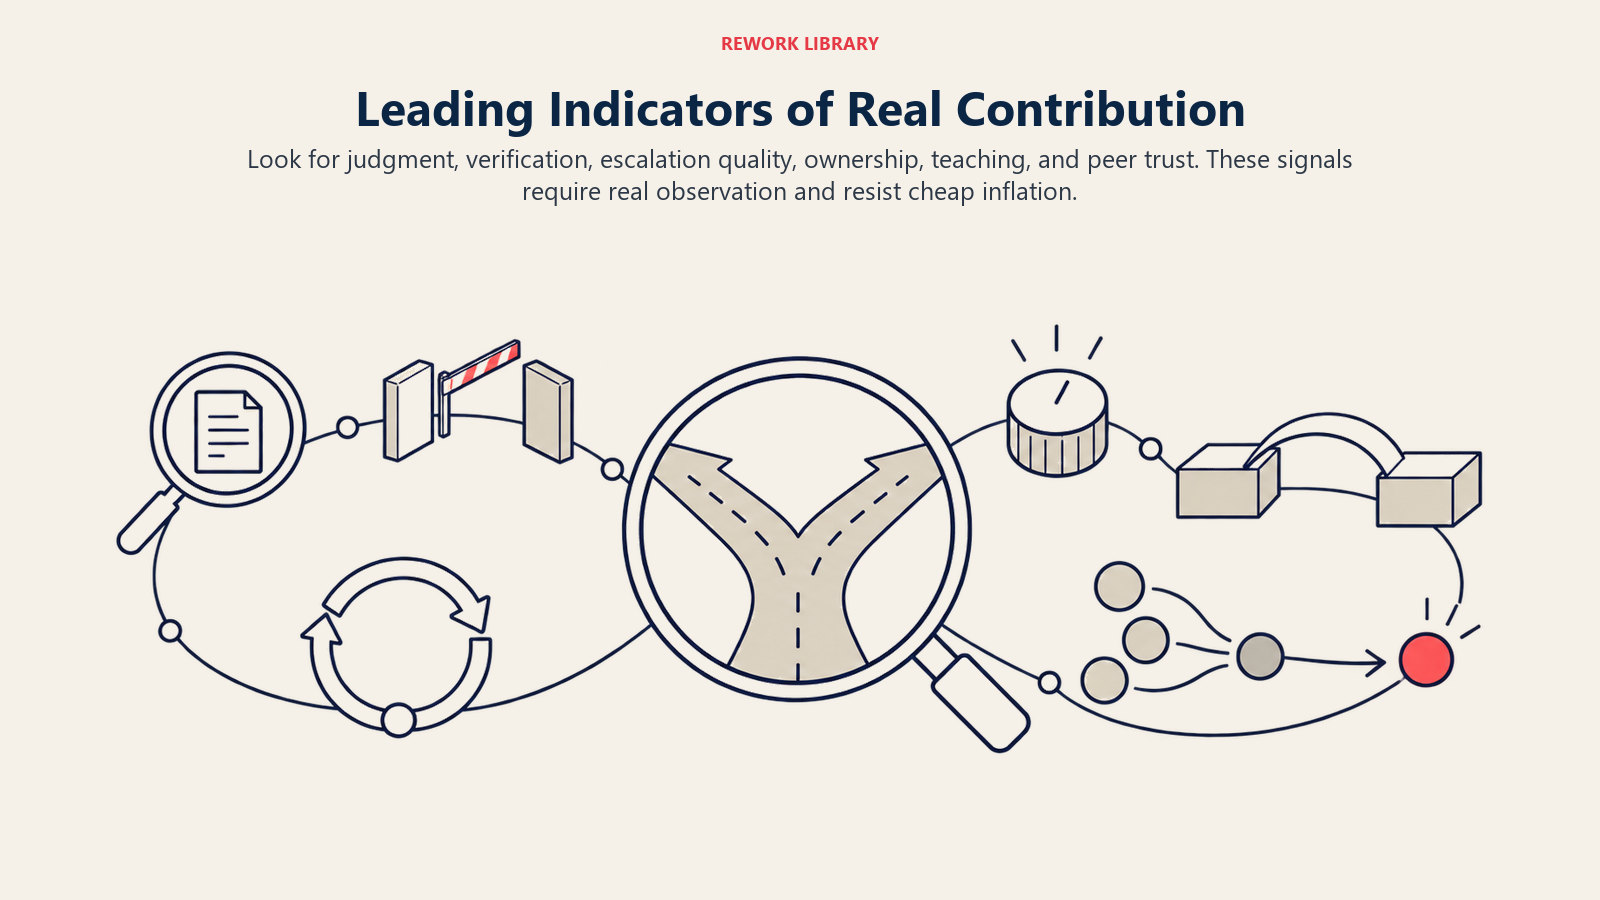
- 曖昧さの中での判断。 AIツール、プレイブック、ポリシーが明確にカバーしていなかった状況で、この人は筋の通った判断を下したでしょうか。最も偽装しにくく、実際の貢献を示す最も明確なシグナルです。
- 検証の行動。 この人は、AIの出力を送る前に、情報源や顧客の実際の状況と照らし合わせて確認するでしょうか。それとも素通りさせるでしょうか。実際の仕事のサンプルをレビューするのに30分かけるマネージャーなら、これはすぐにわかります。自動化された指標では、これをうまく捉えられません。この確認の時間は、AI時代のペースとバーンアウトが検証税と呼ぶ負荷でもあり、AIのスピードが取り除くのではなく生み出した仕事です。
- エスカレーションの質。 自分で決めるべき判断と、上げるべき判断の違いをわかっており、適切なものを適切なタイミングで上げているでしょうか。すべてをエスカレーションするのは、何もエスカレーションしないのと同じく、判断の失敗です。
- 一連の工程を通じたオーナーシップ。 顧客や下流のチームが、この人の成果物を実際に使った数週間後も、成果は持ちこたえたでしょうか。週次のダッシュボードより観察に時間がかかり、偽装ははるかに困難です。
- 教えることと目線合わせのシグナル。 この人と働くことで、周囲がAIのミスを見抜くのが上手になるでしょうか。単に成果物を作るのが速くなるだけではなく。AIが定型業務を吸収するほど価値が高まる補完的スキルの一つです。
- 同僚を介した信頼。 曖昧で重大な問題が起きたとき、同僚は誰に、頼まれなくても持ち込むでしょうか。ほとんどの評価制度が捉えようともしない本物のシグナルですが、答えは誰もがすでに知っています。
これらには、実際の人間が実際の仕事を見ることが必要です。だからこそ、アクティビティ指標が招く速いゲーム化に耐えます。これらは判断の材料であって、判断の代わりではありません。
監視の罠:モニタリングが逆効果になる理由
アクティビティ指標が機能しなくなったとき、本能的に出てくるのは、より強く監視することです。画面録画、キーストロークの記録、AI利用の追跡などです。研究は異例なほど一貫しており、この本能にとっては悪い知らせです。
証拠が実際に示していること
94のサンプル、23,000人を超える労働者を対象とした2023年のメタ分析では、電子的なパフォーマンス監視が成果を高めるという証拠は見つかりませんでした。一方で、監視されていることに伴う労働者のストレスの上昇は、実施方法にかかわらず確実に見られました。これは、監視ツールがよく掲げる触れ込み、つまり可視性の向上、説明責任の強化、より良い成果とは正反対です。データが示すのは、監視は測定可能な成果の向上なしに、主にストレスを買っているということです。
本当の仕組みは信頼であり、その再構築には高いコストがかかる
同じ研究は、透明性が害を和らげることも明らかにしています。開示され、正当な目的に明確に結びついた監視は、秘密裏の、あるいは懲罰的な監視より害が小さいのです。ただし「害が小さい」は「役に立つ」ではありません。自分を支えるためではなく捕まえるために見られていると信じた途端、人はその制度を迂回するようになります。MIT NANDAが、摩擦を生んだ途端に放棄されたAIパイロットで記録したのと同じ行動です。監視型の測定は、それが修正しようとした指標と同じ失敗パターンを生みます。人は監視されている対象の下で生産的に見えるよう最適化し、本来の目的だった判断を犠牲にするのです。また、チームが「このAIの出力が正しいか自信がありません」と言えるために必要な心理的安全性にも逆行します。これはまさに、促したい行動です。
擁護できる実践的なアプローチ
この問題をきれいに解く公式はありません。擁護できるアプローチは、そのことを受け入れたうえで、公式が提供できないチェックを組み込みます。
- 幅広い意思決定の財源となるものは、チームまたは成果レベルの指標を基本にします。 ボーナスプールやロードマップ上の功績は、AIが不均等に水増しできるアクティビティ数ではなく、グループが共同で責任を負う成果に連動させるべきです。
- 個人の評価は、ダッシュボードではなく、実際の仕事に対する人間の実際のレビューに限り、定期的に行います。 マネージャーが実際の成果物のサンプルを読み、誰がミスを見つけたか、あるいは見逃したかも確認すれば、どの利用指標よりもはるかに正確な全体像が得られます。
- AIの支援を、隠すものではなく申告するものにします。 「AIで下書きし、この3つのセクションを修正した」と言うことが普通で安全であれば、貢献をめぐる対話はすぐに誠実になります。有能に見せるために隠すのなら、制度全体が誤った情報の上で動くことになります。
- 先行指標は、自動化されたスコアではなく、対話の材料として扱います。 先行指標が報酬を決める数字として公式化された途端、それが置き換えた指標と同じグッドハートの法則の力学に悩まされ始めます。
- ゲーム化の監査を決まった頻度で行い、どんな指標も劣化すると想定します。 今日測っているものは、数四半期のうちにそれを回避する形で最適化されます。レビューのレビューを制度に組み込みましょう。
- 「仕事が完了したか」と「この人の判断が決め手だったか」を切り分けます。 この2つを混同することが、貢献の測定が静かに信頼を損なう最も一般的な理由です。
モデルが何を出力し、人が何を変更または上書きしたかを記録するAI監査証跡は、数か月後の記憶や自己申告ではなく、このプロセスに具体的な材料を与えます。ワークフローそのものに組み込まれたヒューマンインザループのレビューポイントと組み合わせ、さらにマネージャー自身が判断力を鋭く保ち、良い判断と運の良さの違いを見分けられるようにすると、最も効果的です。
これで解決しないこと
ここでは、整った結論よりも知的な誠実さが重要です。これは本当に、部分的に未解決の問題であり、ごまかさずに率直に述べておくべきことがいくつかあります。
ほとんどの組織が必要とする規模で、「上手にプロンプトを書き、何が良いものかを知っていた」と「運のよい最初の下書きをそのまま出した」を切り分ける、信頼できる自動化された方法は、現時点ではありません。上記の先行指標には人間の時間が必要ですが、ほとんどの組織はそのための予算を組んでおらず、多くは収集が安価で誤解を招くことが知られているアクティビティ指標に頼り続けるでしょう。全社レベルのAIのROI測定でさえ十分に難しいのに、同じ厳密さを個人の帰属にまで下ろせば、難しさは何倍にもなります。そしてこの分野はまだ収束していません。SPACEとDORAが10年分の先行事例を提供するソフトウェアチームで公正な帰属とされるものが、営業、法務、サポートにそのまま当てはまるわけではありません。そこでは失敗パターンが異なるため、枠組みを丸ごと借りると、高い確信をもって誤った答えが出てしまいます。
だからといって、貢献の測定をあきらめる理由にはなりません。どんな手法も緩やかに握り、キャリアにとって最も重要な意思決定には人間を関与させ続け、本コレクションがAIと仕事に関するあらゆる主張に対して取っているのと同じ姿勢でこの問題に臨む、という理由になります。確立された部分には確かな証拠があり、残りには本物の不確実性がある、開かれた進化中の問題として扱うのです。この取り組みと並行して優れたカルチャー指標を整えることも役立ちます。チームがどのように協働しているかをすでに測っていれば、先行して取り組めるからです。ただし、それだけで仕事が完結するわけではありません。
どの貢献指標を採用する前にも、これらの大半を一刀両断するテストが一つあります。この数字が、モデルの判断ではなく、測られる本人の判断を反映している理由を、本人に向かって声に出して説明できるでしょうか。正直な答えが「いいえ」なら、ダッシュボードがどれほどきれいに見えても、その指標は誰の報酬にも触れる準備ができていません。
AI拡張型の仕事における貢献の測定に関するよくある質問
AIが関わるようになって、個人の貢献を測るのが難しくなったのはなぜですか?
かつては水増しに実際の目に見える労力が必要だったアクティビティ指標(より多くのコード、文書、クローズしたチケット)が、今ではほとんど判断なしで大量に生み出せるからです。指標が急上昇しても、その人が実際に付け加えた価値は横ばいのままということがあり、ほとんどの報酬・昇進制度が前提としているものが崩れます。
グッドハートの法則とは何で、なぜここに当てはまるのですか?
「指標が目標になると、それは良い指標ではなくなる」という形で広まったグッドハートの法則は、報酬と結びついた指標が、本当に改善されるのではなく、回避する形で最適化されることを表しています。AIはこれを加速させます。指標を意味のあるものにしていた具体的な行動(実際の労力、実際の成果)を、評価制度が調整できるよりもはるかに速く、AI生成の量で置き換えられるからです。
企業は貢献をチームレベルで測るべきですか、それとも個人レベルで測るべきですか?
意思決定の種類に応じて、両方です。チームまたは成果レベルの指標はゲーム化しにくく、ボーナスプールやロードマップ上の功績といったグループ単位の意思決定に向いています。一人についての報酬・昇進の判断には、依然として個人レベルの評価が必要ですが、それにはアクティビティのダッシュボードではなく、実際の仕事に対する人間の実際のレビューが必要です。ダッシュボードでは、優れた判断と、AI支援の運のよい結果を確実に区別できないからです。
モニタリングや監視ソフトウェアは、帰属の問題を解決しますか?
証拠は、解決しないと示しています。94のサンプル、23,000人を超える労働者を対象としたメタ分析では、電子的なパフォーマンス監視が個人の成果を高めるという証拠は見つからず、労働者のストレスを確実に高めることがわかりました。監視はまた、人がAIの利用を隠したり、制度を丸ごと迂回したりする原因にもなり、貢献を誠実に評価することを容易にするどころか、難しくします。
AI拡張型の仕事における、実際の貢献の先行指標とは何ですか?
曖昧さの中での判断、検証の行動(AIの出力を出す前に確認すること)、エスカレーションの質、引き渡し後も含めた成果の一連の工程を通じたオーナーシップ、そして同僚が曖昧な仕事や重大な仕事を頼まれなくてもこの人に持ち込むかどうかです。これらには人間の観察者が必要であり、アクティビティ数よりも速いゲーム化に強いという特徴があります。
この測定の問題は、パフォーマンス管理と同じものですか?
関連はありますが、別のものです。ここで扱うのは、AI支援の成果に対して一人が実際に何を付け加えたかをどう測るかです。パフォーマンス管理は、時間をかけて人をレビューし、コーチングし、評価する、より広いプロセスであり、測定を活用しますが、目標設定、フィードバック、育成の対話も含み、単一の指標を超えるものです。
この問題に対する業界標準の解決策は、もうありますか?
ありません。ソフトウェアエンジニアリングは、SPACEのようなフレームワークやDORAの研究を通じて、最も成熟した考え方を持っていますが、その分野でさえ、AI支援の仕事における個人の帰属を完全には解決していません。現在のどの手法も、確立された答えではなく、妥当な出発点として扱ってください。

Co-Founder, Rework.com
On this page
- 重要なポイント
- 帰属の問題が再び重要になった理由
- 報酬と昇進は今も個人の成果を前提としている
- モデルが手伝ったからといって説明責任は消えない
- 功績の扱いはリーダーが過小評価する形で士気を左右する
- 素朴なアクティビティ指標が以前より深刻に機能しなくなる理由
- グッドハートの法則は、すでにこの事態を待ち構えていた
- 指標がかつて測っていたものと、今報いているもの
- ソフトウェアエンジニアリングがすでに痛い思いをして学んだ教訓
- チームレベルと個人レベルのトレードオフ
- チームレベルの測定はより誠実だが、報酬の問いには答えない
- 個人レベルの測定はリーダーが求めるものであり、より難しい問題でもある
- きれいな解決策はなく、あるふりをするほうが悪い
- それでもシグナルを持つ先行指標
- 監視の罠:モニタリングが逆効果になる理由
- 証拠が実際に示していること
- 本当の仕組みは信頼であり、その再構築には高いコストがかかる
- 擁護できる実践的なアプローチ
- これで解決しないこと