Como medir a contribuição individual no trabalho ampliado por IA
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
Medir a contribuição individual no trabalho ampliado por IA significa isolar o que o julgamento e as decisões de uma pessoa acrescentaram a um resultado que um modelo e um workflow também ajudaram a produzir. Isso importa para remuneração, promoção e accountability, mas métricas ingênuas de atividade (chamados encerrados, palavras redigidas, uso de ferramentas) são infladas pela IA e deixam de refletir a contribuição real de alguém. Nenhuma organização resolveu isso por completo. A abordagem mais defensável combina indicadores antecedentes, accountability em nível de equipe e julgamento humano honesto, em vez de um número único.
Fatos principais
- A Lei de Goodhart, formulada pelo economista Charles Goodhart em 1975 e popularizada como "quando uma medida se torna uma meta, ela deixa de ser uma boa medida" pela antropóloga Marilyn Strathern em 1997, descreve o que acontece quando uma métrica de contribuição passa a ser atrelada à remuneração (Wikipedia, "Goodhart's law").
- O relatório State of DevOps 2024 da DORA separa os resultados individuais (satisfação, estado de fluxo, produtividade autodeclarada) das métricas de entrega em nível de equipe e de sistema, e constatou que a adoção de IA elevou a produtividade e o fluxo individuais, mas prejudicou de maneira mensurável a estabilidade e o throughput de entrega no nível da equipe (DORA, Accelerate State of DevOps Report 2024).
- O framework SPACE alerta contra reduzir a produtividade de desenvolvedores a contagens isoladas de atividade, como linhas de código ou commits, pois elas confundem atividade visível com resultado real e são manipuladas assim que atreladas à avaliação individual (Forsgren et al., "The SPACE of Developer Productivity," ACM Queue, 2021).
- Uma metanálise de 94 amostras independentes e 23.461 trabalhadores não encontrou evidências de que o monitoramento eletrônico de desempenho melhore o desempenho individual e constatou que ele aumenta de maneira consistente o estresse dos trabalhadores, independentemente da implementação (Ravid et al., "A meta-analysis of the effects of electronic performance monitoring on work outcomes," Personnel Psychology, 2023).
- A revisão do MIT NANDA de mais de 300 implantações corporativas de IA constatou que 95 por cento dos pilotos de IA generativa não mostraram impacto mensurável no P&L, uma lacuna que os pesquisadores atribuem a fatores de workflow não medidos, e não ao esforço individual (MIT NANDA, "The GenAI Divide: State of AI in Business 2025", via Fortune).
Por que a atribuição voltou a importar de repente
A atribuição nunca foi totalmente resolvida antes da IA. Um vendedor que fecha um negócio prospectado por um colega, um engenheiro que entrega uma funcionalidade especificada por um designer: o trabalho sempre foi colaborativo, e o crédito sempre foi, em parte, uma questão de julgamento. A IA não criou o problema. Ela fez um problema antigo se tornar crítico em mais lugares ao mesmo tempo, porque quase toda entrega agora tem um terceiro colaborador que não pode ser entrevistado, promovido nem responsabilizado.
Remuneração e promoção ainda pressupõem a entrega individual
As decisões de remuneração e promoção pressupõem que é possível rastrear um resultado até o julgamento de uma pessoa com razoável confiança. Essa premissa fica mais frágil a cada trimestre. Se um representante escreve quinze e-mails de prospecção com um assistente de IA e fecha três negócios, e um colega sem o assistente escreve cinco à mão e fecha dois, o trimestre de quem reflete melhor julgamento? Os sistemas em que a remuneração se apoia não foram feitos para essa ambiguidade, e a maioria das empresas os mantém mesmo assim porque ainda não há substituto óbvio. Remuneração e equidade na era da IA aprofunda o que, na lógica de pagamento, de fato se quebra quando a entrega de uma pessoa parece a de cinco, graças inteiramente à ferramenta e não ao julgamento por trás dela.
A accountability não desaparece só porque um modelo ajudou
Quando uma decisão assistida por IA dá errado (uma cláusula contratual perdida, um e-mail ao cliente que promete demais, uma premissa ruim embutida em um modelo), alguém ainda precisa assumir a responsabilidade. Não dá para colocar um modelo de linguagem em um plano de melhoria de desempenho. Isso é relacionado, mas distinto de medir a contribuição para fins de recompensa: trata de quem responde quando algo quebra, não de quem recebe o bônus quando funciona, e ambos ficam mais difíceis porque a linha entre "a pessoa decidiu isto" e "a ferramenta produziu isto" ficou borrada.
O crédito molda o moral de maneiras que os líderes subestimam
As pessoas percebem rápido quando o crédito é mal distribuído. Um integrante da equipe que formulou o problema e pegou a resposta errada, mas convincente, do modelo, e que vê um colega receber o mesmo crédito por aceitar um rascunho de IA sem revisão, é uma forma rápida de corroer a confiança no ambiente de trabalho. Erre a atribuição de maneira visível algumas vezes e as suas melhores pessoas vão, em silêncio, fazer menos do trabalho difícil de medir, porque o sistema acabou de dizer que ele não conta.
Por que as métricas ingênuas de atividade falham ainda mais do que antes
Toda organização já tem alguma versão de uma métrica de atividade: chamados encerrados, linhas de código, palavras redigidas, ligações feitas. Elas sempre foram um indicador imperfeito de valor. A IA quebra esse indicador de um jeito específico: torna a atividade trivialmente fácil de produzir em volume, enquanto o julgamento de fato (essa era a resposta certa, ela se sustentou) continua tão difícil quanto sempre foi, ou mais, porque agora alguém precisa verificar o resultado em vez de apenas produzi-lo.
A Lei de Goodhart já estava à espera disso
A Lei de Goodhart diz que uma medida que vira meta deixa de ser boa, porque as pessoas reorganizam o esforço em torno do que a métrica premia, e não do objetivo de fundo. Isso não é novidade da IA: é o mesmo mecanismo por trás de professores que restringem o ensino a uma prova padronizada ou de atendentes de call center que encurtam as ligações para bater uma meta de tempo médio de atendimento em vez de resolver o problema. O que a IA muda é a velocidade da manipulação. Uma métrica que antes exigia esforço real para ser inflada (escrever mais código, redigir mais e-mails) agora pode ser inflada com alguns prompts e quase nenhum julgamento, de modo que a distância entre "o número subiu" e "o valor subiu" aumenta mais rápido do que a maioria dos sistemas de desempenho consegue se ajustar.
O que uma métrica media antes e o que ela premia agora
| Métrica | O que parecia medir | O que ela realmente premia agora |
|---|---|---|
| Linhas de código / commits | Entrega e esforço de engenharia | Código verboso gerado por IA e commits inflados, sem relação com software funcionando |
| Chamados encerrados por semana | Capacidade de atendimento do suporte | Dividir chamados fáceis, assistidos por IA, em mais chamados, em vez de resolver os difíceis |
| Palavras ou documentos redigidos | Produção de texto | Volume de texto redigido por IA, não o raciocínio, a edição ou o julgamento por trás dele |
| Tempo de resposta / velocidade de retorno | Agilidade e dedicação | Enviar rápido um rascunho de IA não verificado, sem pegar o caso em que estava errado |
| Frequência de uso de ferramentas de IA ("adoção de licenças") | Proficiência e entusiasmo com IA | Clicar em aceitar repetidamente, sem verificar, corrigir ou melhorar o resultado |
| Reuniões ou mensagens enviadas | Colaboração e engajamento | Volume de mensagens assistidas por IA, que pode subir muito sem nenhuma mudança nas decisões tomadas |
A lição que a engenharia de software já aprendeu da maneira difícil
As equipes de software foram as primeiras a enfrentar esse problema, porque a produção de código foi uma das primeiras coisas que a IA tornou trivialmente fácil de inflar. A resposta do setor, formalizada no framework SPACE, foi rejeitar métricas isoladas de atividade para indivíduos e medir a produtividade em cinco dimensões (satisfação, desempenho, atividade, comunicação, eficiência), a maioria das quais só faz sentido no nível da equipe ou do sistema. A pesquisa DORA de 2024 reforça isso com uma constatação incômoda: a adoção de IA elevou o quanto cada desenvolvedor se sentia produtivo, mas prejudicou de maneira mensurável as métricas de equipe que indicam se o software é entregue com confiabilidade. Olhando só os números individuais, a IA parece uma vitória inequívoca. Olhando os números de equipe ao lado deles, surge um quadro mais honesto, o mesmo padrão que esta coleção documenta em o paradoxo da produtividade da IA: sinais individuais e resultados organizacionais podem se mover em direções opostas ao mesmo tempo.
O trade-off entre nível de equipe e nível individual
É o trade-off que todo líder acaba negociando, dê ou não nome a ele.
A medição em nível de equipe é mais honesta, mas não responde à questão da remuneração
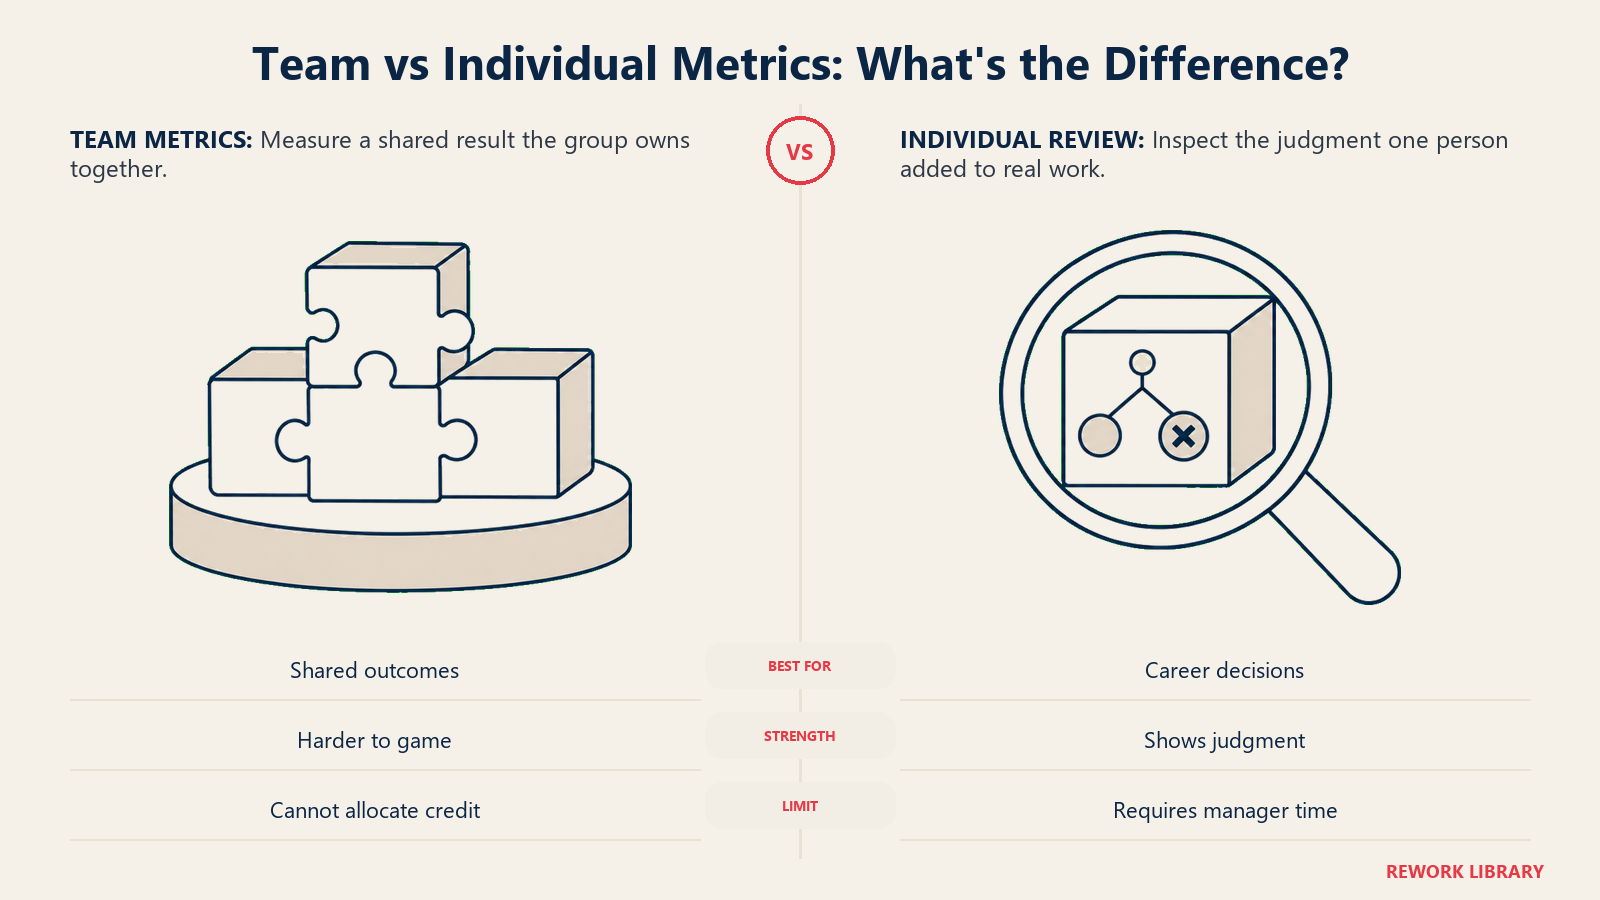
Medir resultados no nível da equipe ou do workflow (esse time entregou a funcionalidade, os clientes dele tiveram menos churn) resiste melhor à manipulação, porque é mais difícil uma pessoa inflar um número compartilhado sem que o restante da equipe perceba. Também combina com o modo como funcionam hoje os cargos de estilo orquestrador: um cargo pode ser quase todo julgamento e coordenação, invisível a qualquer contagem de atividade, e ainda assim ser a razão de a entrega da equipe ser boa. O custo é que a medição em nível de equipe, por si só, não diz quem promover ou pagar mais.
A medição em nível individual é o que os líderes querem, e o problema mais difícil
Todo sistema de remuneração e promoção acaba precisando de um sinal individual, porque as decisões de pagamento são sobre pessoas, não sobre pods. Mas quanto mais precisamente você tenta isolar a contribuição marginal de uma pessoa, mais esbarra num problema que ninguém resolveu: quem faz bons prompts, pega o erro do modelo e entrega um ótimo resultado em vinte minutos pode parecer, em qualquer métrica de atividade, idêntico a quem aceitou o primeiro rascunho, teve sorte e entregou algo medíocre. Os dois desempenhos não são iguais, e a maioria dos sistemas não consegue distingui-los sem um humano revisando o trabalho real.
Não há resolução limpa, e fingir o contrário é pior
A posição honesta exige as duas lentes: métricas em nível de equipe para decisões que afetam o grupo todo e revisão individual, baseada em julgamento, para decisões que inevitavelmente dizem respeito a uma só pessoa, como quem é promovido. Tentar automatizar essa camada individual com um dashboard é onde acontece a maior parte do dano.
Indicadores antecedentes que ainda carregam sinal
Nenhum dos itens a seguir pode ser manipulado de maneira tão rápida e barata quanto as contagens de atividade, porque cada um exige que o observador realmente olhe o trabalho em vez de contá-lo.
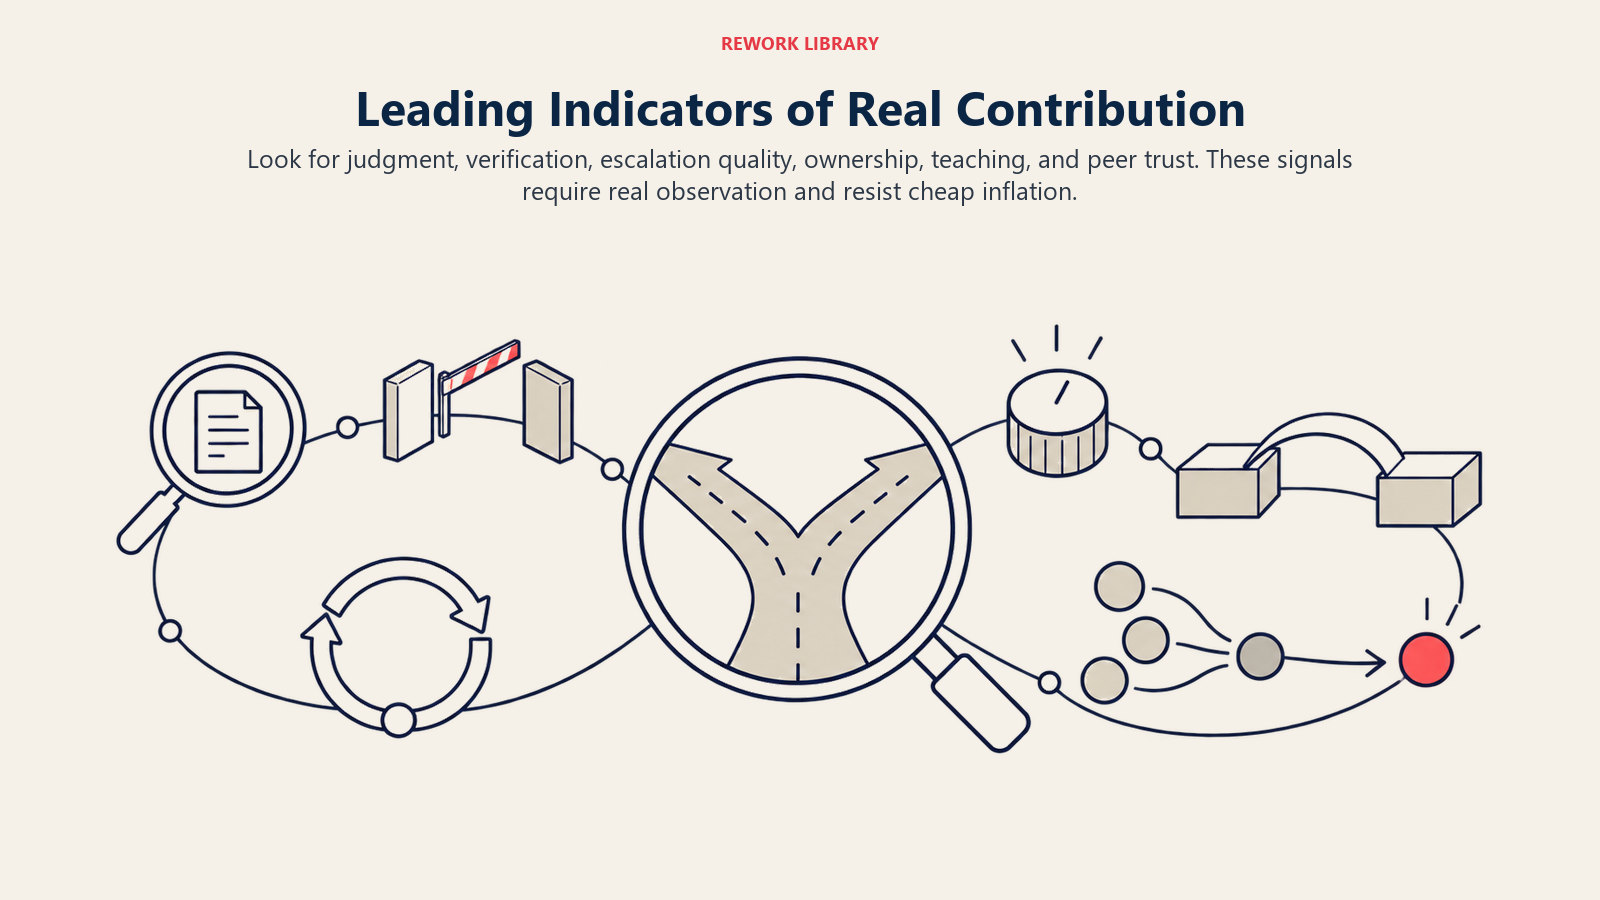
- Julgamento diante da ambiguidade. Essa pessoa tomou uma decisão defensável numa situação que a ferramenta de IA, o playbook e a política não cobriam com clareza? A coisa mais difícil de fingir e o sinal mais claro de contribuição real.
- Comportamento de verificação. Essa pessoa confere o resultado da IA com a fonte ou com a situação real do cliente antes de enviá-lo, ou o deixa passar? Um gestor que dedica trinta minutos a revisar amostras de trabalho real percebe isso de imediato; nenhuma métrica automatizada captura isso bem. Esse tempo de conferência é também a carga que ritmo e burnout na era da IA chama de imposto da verificação, trabalho que a velocidade da IA criou em vez de eliminar.
- Qualidade da escalação. A pessoa sabe a diferença entre uma decisão a tomar e uma a levar adiante, e leva as certas no momento certo? Escalar tudo é uma falha de julgamento tanto quanto não escalar nada.
- Propriedade do ciclo completo. O resultado se sustentou semanas depois, quando um cliente ou uma equipe a jusante de fato usou o que essa pessoa produziu? Mais lento de observar do que um dashboard semanal e muito mais difícil de fingir.
- Sinal de ensino e calibragem. Trabalhar com essa pessoa torna os outros melhores em identificar os erros da IA, e não apenas mais rápidos em produzir? Uma das habilidades complementares que ganham valor à medida que a IA absorve o trabalho rotineiro.
- Confiança encaminhada pelos pares. Quando surge algo ambíguo e de alto risco, para quem os colegas encaminham, sem que ninguém peça? Um sinal real que a maioria dos sistemas de desempenho nunca se dá ao trabalho de capturar, embora todo mundo já saiba a resposta.
Esses indicadores exigem que um humano de verdade olhe o trabalho de verdade, e é por isso que resistem à manipulação rápida que as métricas de atividade convidam. São insumos para um julgamento, não um substituto dele.
A armadilha da vigilância: por que o monitoramento sai pela culatra
O instinto, quando as métricas de atividade deixam de funcionar, costuma ser monitorar mais: gravação de tela, registro de teclas, rastreamento de uso de IA. A pesquisa é incomumente consistente, e traz más notícias para esse instinto.
O que as evidências realmente mostram
A metanálise de 2023, que abrange 94 amostras e mais de 23.000 trabalhadores, não encontrou evidências de que o monitoramento eletrônico de desempenho melhore o desempenho. Encontrou, sim, um aumento consistente do estresse dos trabalhadores associado ao fato de serem monitorados, independentemente de como o monitoramento foi implementado. É o oposto do argumento usual a favor das ferramentas de monitoramento: mais visibilidade, mais accountability, melhores resultados. Os dados dizem que, na maior parte, elas compram estresse sem ganho de desempenho mensurável.
A confiança é o mecanismo de fato, e é cara de reconstruir
A mesma pesquisa conclui que a transparência modera o dano: um monitoramento divulgado e claramente ligado a um objetivo legítimo faz menos mal do que um monitoramento velado ou punitivo. Mas "menos mal" não é "ajuda". Quando as pessoas acreditam que são vigiadas para serem flagradas e não para serem apoiadas, elas contornam o sistema, o mesmo comportamento que o MIT NANDA documentou em pilotos de IA abandonados no instante em que criaram atrito. A medição no estilo vigilância produz o mesmo modo de falha das métricas que ela pretendia corrigir: as pessoas otimizam para parecer produtivas diante daquilo que está sendo observado, em detrimento do julgamento, que era o ponto central. Ela também trabalha contra a segurança psicológica de que uma equipe precisa para admitir "não tenho certeza de que este resultado da IA está certo", exatamente o comportamento que vale incentivar.
Uma abordagem prática e defensável
Nenhuma fórmula resolve isso com limpeza. Uma abordagem defensável aceita esse fato e incorpora as verificações que a fórmula não consegue oferecer.
- Adote como padrão métricas de equipe ou de resultado para tudo que financie uma decisão ampla. Pools de bônus e crédito no roadmap devem acompanhar resultados pelos quais um grupo responde em conjunto, não contagens de atividade que a IA pode inflar de maneira desigual.
- Reserve a avaliação individual para a revisão humana de trabalho real, em uma cadência definida, e não para um dashboard. Um gestor que lê uma amostra de entregas reais, incluindo onde alguém pegou ou deixou passar um erro, obtém um retrato muito mais preciso do que qualquer métrica de uso.
- Faça da assistência de IA algo que as pessoas declaram, não escondem. Se dizer "usei IA para redigir isto e depois revisei estas três seções" é normal e seguro, as conversas sobre contribuição ficam honestas rapidamente. Se as pessoas escondem para parecerem capazes, o sistema inteiro funciona com informação ruim.
- Trate os indicadores antecedentes como insumos para uma conversa, não como uma pontuação automatizada. No instante em que um deles é formalizado em um número que define remuneração, passa a sofrer a mesma dinâmica da Lei de Goodhart que as métricas que ele substituiu.
- Faça auditorias de manipulação em cadência fixa e espere que qualquer métrica se degrade. O que você mede hoje será contornado em um par de trimestres. Incorpore ao sistema a revisão da própria revisão.
- Separe "o trabalho foi feito" de "o julgamento dessa pessoa foi o diferencial". Misturar os dois é o motivo mais comum de a medição de contribuição minar a confiança em silêncio.
Uma trilha de auditoria de IA que registra o que um modelo produziu e o que uma pessoa alterou ou rejeitou dá a esse processo algo concreto em que se apoiar, em vez de memória ou autorrelato meses depois. Ela funciona melhor combinada com pontos de revisão human-in-the-loop embutidos no próprio workflow e com gestores que mantêm o próprio julgamento afiado o bastante para perceber a diferença entre uma boa decisão e uma decisão de sorte.
O que isso não resolve
A honestidade intelectual importa mais aqui do que uma conclusão organizada. Isso é, de fato e em parte, um problema não resolvido, e algumas coisas merecem ser ditas com clareza em vez de maquiadas.
Hoje não existe uma forma confiável e automatizada de separar "fez bons prompts e sabia como era um bom resultado" de "teve sorte no primeiro rascunho e o enviou", na escala de que a maioria das organizações precisa. Os indicadores antecedentes acima exigem tempo humano, e a maioria das organizações não orçou isso, então muitas continuarão recorrendo a métricas de atividade, baratas de coletar e sabidamente enganosas. Medir o ROI da IA no nível da empresa já é difícil o bastante; levar o mesmo rigor até a atribuição individual multiplica a dificuldade. E o campo não convergiu: o que conta como atribuição justa em uma equipe de software, onde SPACE e DORA oferecem uma década de referências, não se transfere automaticamente para vendas, jurídico ou suporte, onde os modos de falha diferem o bastante para que emprestar o framework por inteiro leve à resposta errada com muita confiança.
Nada disso é motivo para desistir de medir a contribuição. É motivo para segurar qualquer método com leveza, manter um humano no circuito das decisões que mais pesam numa carreira e tratar o tema como o restante desta coleção trata toda afirmação sobre IA e trabalho: um problema aberto e em evolução, com evidências reais por trás das partes assentadas e incerteza real no restante. Construir boas métricas de cultura em paralelo ajuda, já que uma equipe que já mede como trabalha em conjunto sai na frente, mas isso sozinho não encerra o trabalho.
Um teste atravessa quase tudo isso antes de adotar qualquer métrica de contribuição: você se sentiria à vontade para explicar, em voz alta, à pessoa medida por que esse número reflete o julgamento dela e não o do modelo? Se a resposta honesta for não, a métrica não está pronta para tocar na remuneração de ninguém, por mais limpo que o dashboard pareça.
Perguntas frequentes sobre a medição da contribuição no trabalho ampliado por IA
Por que medir a contribuição individual ficou mais difícil com a IA?
As métricas de atividade que antes exigiam esforço real e visível para serem infladas (mais código, mais documentos, mais chamados encerrados) agora podem ser produzidas em volume com o mínimo de julgamento. A métrica pode subir muito enquanto o valor que a pessoa de fato acrescentou permanece estável, o que quebra a premissa em que se apoia a maioria dos sistemas de remuneração e promoção.
O que é a Lei de Goodhart e por que ela se aplica aqui?
A Lei de Goodhart, popularizada como "quando uma medida se torna uma meta, ela deixa de ser uma boa medida", descreve como qualquer métrica atrelada a uma recompensa acaba sendo contornada, em vez de genuinamente melhorada. A IA acelera isso porque os comportamentos que tornavam uma métrica significativa (esforço real, resultado real) podem ser substituídos por volume gerado por IA muito mais rápido do que os sistemas de desempenho conseguem se ajustar.
As empresas devem medir a contribuição no nível da equipe ou no nível individual?
Os dois, para decisões diferentes. Métricas de equipe ou de resultado são mais difíceis de manipular e funcionam bem para decisões de grupo, como pools de bônus ou crédito no roadmap. A avaliação individual continua necessária para decisões de remuneração e promoção sobre uma só pessoa, mas exige revisão humana de trabalho real, e não um dashboard de atividade, porque dashboards não conseguem separar com confiabilidade o bom julgamento de um resultado de sorte assistido por IA.
Um software de monitoramento ou vigilância resolve o problema da atribuição?
As evidências dizem que não. Uma metanálise de 94 amostras e mais de 23.000 trabalhadores não encontrou evidências de que o monitoramento eletrônico de desempenho melhore o desempenho individual e constatou que ele aumenta de maneira consistente o estresse dos trabalhadores. O monitoramento também pode levar as pessoas a esconder o uso de IA ou a contornar o sistema por completo, o que torna a contribuição mais difícil de avaliar com honestidade, não mais fácil.
Quais são os indicadores antecedentes da contribuição real no trabalho ampliado por IA?
Julgamento diante da ambiguidade, comportamento de verificação (conferir o resultado da IA antes de ele sair), qualidade da escalação, propriedade do ciclo completo de um resultado após a entrega e se os colegas encaminham trabalhos ambíguos ou de alto risco a essa pessoa sem que ninguém peça. Eles exigem um observador humano e resistem melhor à manipulação rápida do que as contagens de atividade.
Esse problema de medição é o mesmo que gestão de desempenho?
São relacionados, mas distintos. Este trata de como medir o que uma pessoa realmente acrescentou a um resultado assistido por IA. A gestão de desempenho é o processo mais amplo de avaliar, orientar e classificar pessoas ao longo do tempo, que se apoia na medição, mas também envolve definição de metas, feedback e conversas de desenvolvimento que vão além de qualquer métrica isolada.
Já existe uma solução padrão no setor para esse problema?
Não. A engenharia de software tem o pensamento mais maduro sobre o tema, por meio de frameworks como o SPACE e da pesquisa da DORA, mas nem essa área resolveu por completo a atribuição individual no trabalho assistido por IA. Trate qualquer método atual como um ponto de partida razoável, não como uma resposta definitiva.

Co-Founder, Rework.com
On this page
- Fatos principais
- Por que a atribuição voltou a importar de repente
- Remuneração e promoção ainda pressupõem a entrega individual
- A accountability não desaparece só porque um modelo ajudou
- O crédito molda o moral de maneiras que os líderes subestimam
- Por que as métricas ingênuas de atividade falham ainda mais do que antes
- A Lei de Goodhart já estava à espera disso
- O que uma métrica media antes e o que ela premia agora
- A lição que a engenharia de software já aprendeu da maneira difícil
- O trade-off entre nível de equipe e nível individual
- A medição em nível de equipe é mais honesta, mas não responde à questão da remuneração
- A medição em nível individual é o que os líderes querem, e o problema mais difícil
- Não há resolução limpa, e fingir o contrário é pior
- Indicadores antecedentes que ainda carregam sinal
- A armadilha da vigilância: por que o monitoramento sai pela culatra
- O que as evidências realmente mostram
- A confiança é o mecanismo de fato, e é cara de reconstruir
- Uma abordagem prática e defensável
- O que isso não resolve