Cómo medir la contribución individual en el trabajo aumentado por IA
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
Medir la contribución individual en el trabajo aumentado por IA significa aislar lo que el juicio y las decisiones de una persona aportaron a un resultado que también ayudaron a producir un modelo y un workflow. Importa para la remuneración, los ascensos y la rendición de cuentas, pero las métricas de actividad ingenuas (tickets cerrados, palabras redactadas, uso de herramientas) las infla la IA y dejan de reflejar la contribución real de nadie. Ninguna organización lo ha resuelto por completo. El enfoque más defendible combina indicadores adelantados, responsabilidad a nivel de equipo y juicio humano honesto en lugar de un único número.
Datos clave
- La ley de Goodhart, formulada por el economista Charles Goodhart en 1975 y popularizada como "cuando una medida se convierte en un objetivo, deja de ser una buena medida" por la antropóloga Marilyn Strathern en 1997, describe lo que ocurre cuando una métrica de contribución se vincula con el pago (Wikipedia, "Goodhart's law").
- El informe State of DevOps 2024 de DORA separa los resultados individuales (satisfacción, flujo, productividad autopercibida) de las métricas de entrega a nivel de equipo y de sistema, y halló que la adopción de IA elevó la productividad individual y el flujo, pero perjudicó de forma medible la estabilidad y el rendimiento de las entregas a nivel de equipo (DORA, Accelerate State of DevOps Report 2024).
- El marco SPACE advierte contra reducir la productividad de los desarrolladores a conteos de actividad aislados, como líneas de código o commits, porque confunden la actividad visible con el resultado real y se manipulan en cuanto se ligan a la evaluación individual (Forsgren et al., "The SPACE of Developer Productivity," ACM Queue, 2021).
- Un metaanálisis de 94 muestras independientes y 23,461 trabajadores no halló evidencia de que el monitoreo electrónico del desempeño mejore el rendimiento individual, y sí que eleva de manera constante el estrés de los trabajadores, sin importar cómo se implemente (Ravid et al., "A meta-analysis of the effects of electronic performance monitoring on work outcomes," Personnel Psychology, 2023).
- La revisión de MIT NANDA de más de 300 despliegues empresariales de IA halló que el 95 por ciento de los pilotos de IA generativa no mostró un impacto medible en el P&L, una brecha que los investigadores atribuyen a factores de workflow no medidos, no al esfuerzo individual (MIT NANDA, "The GenAI Divide: State of AI in Business 2025", vía Fortune).
Por qué la atribución vuelve a importar de repente
La atribución nunca se resolvió del todo antes de la IA. Un vendedor que cierra un trato que consiguió un compañero, un ingeniero que entrega una funcionalidad que especificó un diseñador: el trabajo siempre ha sido colaborativo y el crédito siempre ha tenido algo de juicio subjetivo. La IA no creó el problema. Hizo que un problema antiguo se vuelva crítico en más lugares a la vez, porque casi todo resultado cuenta ahora con un tercer colaborador al que no se puede entrevistar, ascender ni exigirle cuentas.
La remuneración y los ascensos siguen suponiendo un resultado individual
Las decisiones de compensación y ascenso suponen que se puede rastrear un resultado hasta el juicio de una persona con una confianza razonable. Ese supuesto se debilita cada trimestre. Si un representante escribe quince correos salientes con un asistente de IA y cierra tres tratos, y un colega sin asistente escribe cinco a mano y cierra dos, ¿el trimestre de quién refleja mejor juicio? Los sistemas en los que se apoya la compensación no se construyeron para esta ambigüedad, y la mayoría de las empresas los siguen usando porque todavía no hay un reemplazo evidente. Compensación y equidad en la era de la IA profundiza en qué lógica de pago se rompe cuando el resultado de una persona parece el de cinco, gracias por completo a la herramienta y no al juicio que hay detrás.
La rendición de cuentas no desaparece porque un modelo haya ayudado
Cuando una decisión asistida por IA sale mal (una cláusula contractual omitida, un correo a un cliente que promete de más, un supuesto erróneo incorporado a un modelo) alguien tiene que hacerse cargo. No se puede poner a un modelo de lenguaje en un plan de mejora del desempeño. Esto está relacionado con medir la contribución para recompensarla, pero es distinto: se trata de quién responde cuando algo falla, no de quién recibe el bono cuando funciona, y ambas cosas se vuelven más difíciles porque la línea entre "la persona decidió esto" y "la herramienta produjo esto" se ha difuminado.
El crédito moldea la moral de maneras que los líderes subestiman
Las personas notan rápido cuando el crédito se asigna mal. Que un miembro del equipo que planteó el problema y detectó la respuesta errónea y de apariencia segura del modelo vea a un compañero recibir el mismo crédito por aceptar un borrador de IA sin tocarlo es una forma rápida de erosionar la confianza en el lugar de trabajo. Si la atribución falla visiblemente unas cuantas veces, sus mejores personas harán en silencio menos del trabajo difícil de medir, porque el sistema les acaba de decir que no cuenta.
Por qué las métricas de actividad ingenuas fallan peor que antes
Toda organización ya tiene alguna versión de una métrica de actividad: tickets cerrados, líneas de código, palabras redactadas, llamadas realizadas. Siempre fueron un indicador imperfecto del valor. La IA rompe ese indicador de una manera concreta: hace trivialmente fácil producir actividad en volumen, mientras que el juicio real (si fue la respuesta correcta, si resistió) sigue siendo tan difícil como siempre, o más, porque ahora alguien tiene que verificar el resultado en lugar de solo producirlo.
La ley de Goodhart ya estaba esperando esto
La ley de Goodhart dice que una medida que se convierte en objetivo deja de ser buena, porque las personas reorganizan su esfuerzo en torno a lo que premia la métrica en lugar de la meta de fondo. Esto no es nuevo con la IA: es el mismo mecanismo por el que los docentes estrechan la enseñanza para un examen estandarizado, o por el que los agentes de un call center acortan las llamadas para cumplir un objetivo de tiempo de atención en lugar de resolver el problema. Lo que cambia la IA es la velocidad de la manipulación. Una métrica que antes exigía un esfuerzo real para inflarse (escribir más código, redactar más correos) ahora puede inflarse con unos pocos prompts y casi sin juicio, de modo que la distancia entre "el número subió" y "el valor subió" se ensancha más rápido de lo que la mayoría de los sistemas de desempeño puede ajustarse.
Qué medía antes una métrica frente a qué premia ahora
| Métrica | Qué parecía medir | Qué premia realmente ahora |
|---|---|---|
| Líneas de código / commits | Producción y esfuerzo de ingeniería | Código verboso generado por IA y relleno de commits, sin relación con un software que funcione |
| Tickets cerrados por semana | Rendimiento del soporte | Dividir tickets fáciles asistidos por IA en más tickets en lugar de resolver los difíciles |
| Palabras o documentos redactados | Producción escrita | Volumen de texto redactado por IA, no el pensamiento, la edición ni el juicio detrás |
| Tiempo de respuesta / velocidad de entrega | Capacidad de respuesta y diligencia | Enviar rápido un borrador de IA sin verificar, no detectar el caso en que estaba equivocado |
| Frecuencia de uso de herramientas de IA ("adopción de licencias") | Dominio y entusiasmo con la IA | Pulsar aceptar una y otra vez, sin verificar, corregir ni mejorar el resultado |
| Reuniones o mensajes enviados | Colaboración y participación | Volumen de mensajes asistidos por IA, que puede subir mucho sin que cambien las decisiones tomadas |
La lección que la ingeniería de software ya aprendió por las malas
Los equipos de software toparon con este problema primero, porque la producción de código fue una de las primeras cosas que la IA volvió trivialmente fáciles de inflar. La respuesta de la industria, formalizada en el marco SPACE, fue rechazar las métricas de actividad únicas para las personas y medir la productividad en cinco dimensiones (satisfacción, desempeño, actividad, comunicación, eficiencia), la mayoría de las cuales solo tienen sentido a nivel de equipo o de sistema. La investigación de DORA de 2024 lo respalda con un hallazgo incómodo: la adopción de IA elevó lo productivos que se sentían los desarrolladores individuales, mientras perjudicaba de forma medible las métricas de equipo que predicen si el software se entrega de manera fiable. Si se leen solo los números individuales, la IA parece una victoria sin matices. Si se leen junto a los números de equipo, aparece una imagen más honesta, el mismo patrón que esta colección documenta en la paradoja de la productividad de la IA: las señales individuales y los resultados organizacionales pueden moverse en sentidos opuestos a la vez.
El equilibrio entre el nivel de equipo y el nivel individual
Es el equilibrio que todo líder termina negociando, lo nombre o no.
La medición a nivel de equipo es más honesta, pero no responde la pregunta del pago
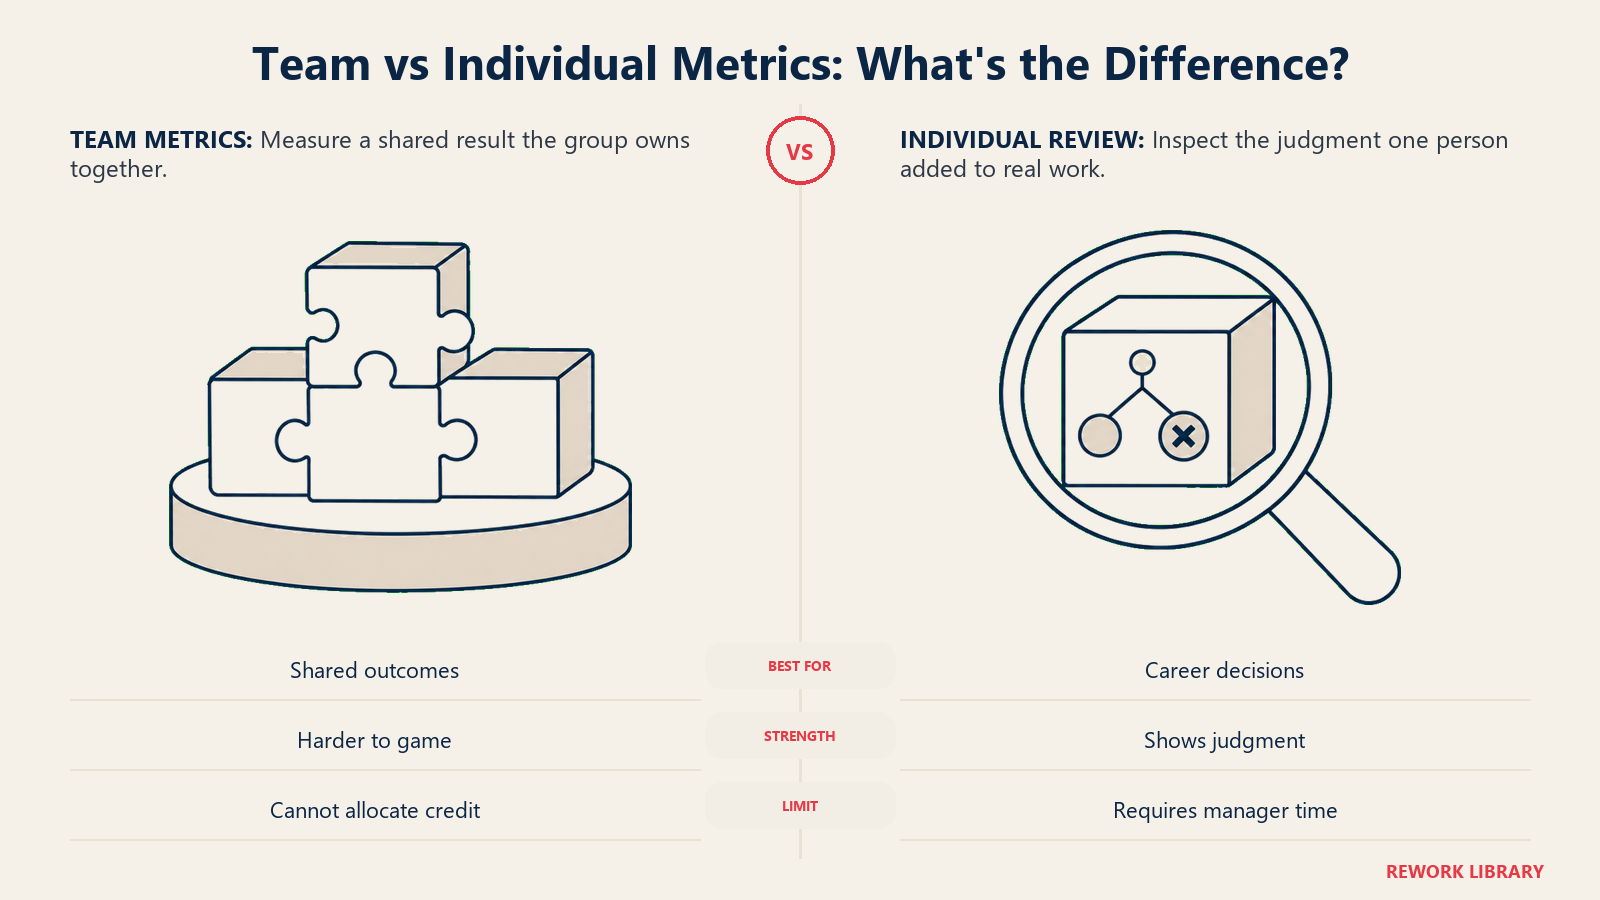
Medir los resultados a nivel de equipo o de workflow (si este grupo entregó la funcionalidad, si sus clientes abandonaron menos) resiste mejor la manipulación, porque es más difícil que una persona infle un número compartido sin que el resto del equipo lo note. También encaja con cómo funcionan hoy los roles de tipo orquestador: un puesto puede ser casi por completo juicio y coordinación, invisible para cualquier conteo de actividad, y aun así ser la razón por la que el resultado del equipo es bueno. El costo es que la medición a nivel de equipo, por sí sola, no le dice a quién ascender ni a quién pagar más.
La medición a nivel individual es lo que quieren los líderes, y el problema más difícil
Todo sistema de compensación y ascensos acaba necesitando una señal individual, porque las decisiones de pago se toman sobre personas, no sobre grupos. Pero cuanto más precisamente se intenta aislar la contribución marginal de una persona, más se choca con un problema que nadie ha resuelto: alguien que da buenos prompts, detecta el error del modelo y entrega un gran resultado en veinte minutos puede parecer, en cualquier métrica de actividad, idéntico a quien aceptó el primer borrador, tuvo suerte y entregó algo mediocre. Los dos desempeños no son iguales, y la mayoría de los sistemas no puede distinguirlos sin que una persona revise el trabajo real.
No hay una resolución limpia, y fingir lo contrario es peor
La postura honesta necesita ambas lentes: métricas a nivel de equipo para las decisiones que afectan a todo el grupo, y una revisión individual basada en el juicio para las decisiones que inevitablemente tratan de una sola persona, como quién asciende. Intentar automatizar esa capa individual con un dashboard es donde ocurre la mayor parte del daño.
Indicadores adelantados que siguen aportando señal
Ninguno de los siguientes se puede manipular de la misma manera rápida y barata que los conteos de actividad, porque cada uno exige que el observador mire el trabajo en lugar de contarlo.
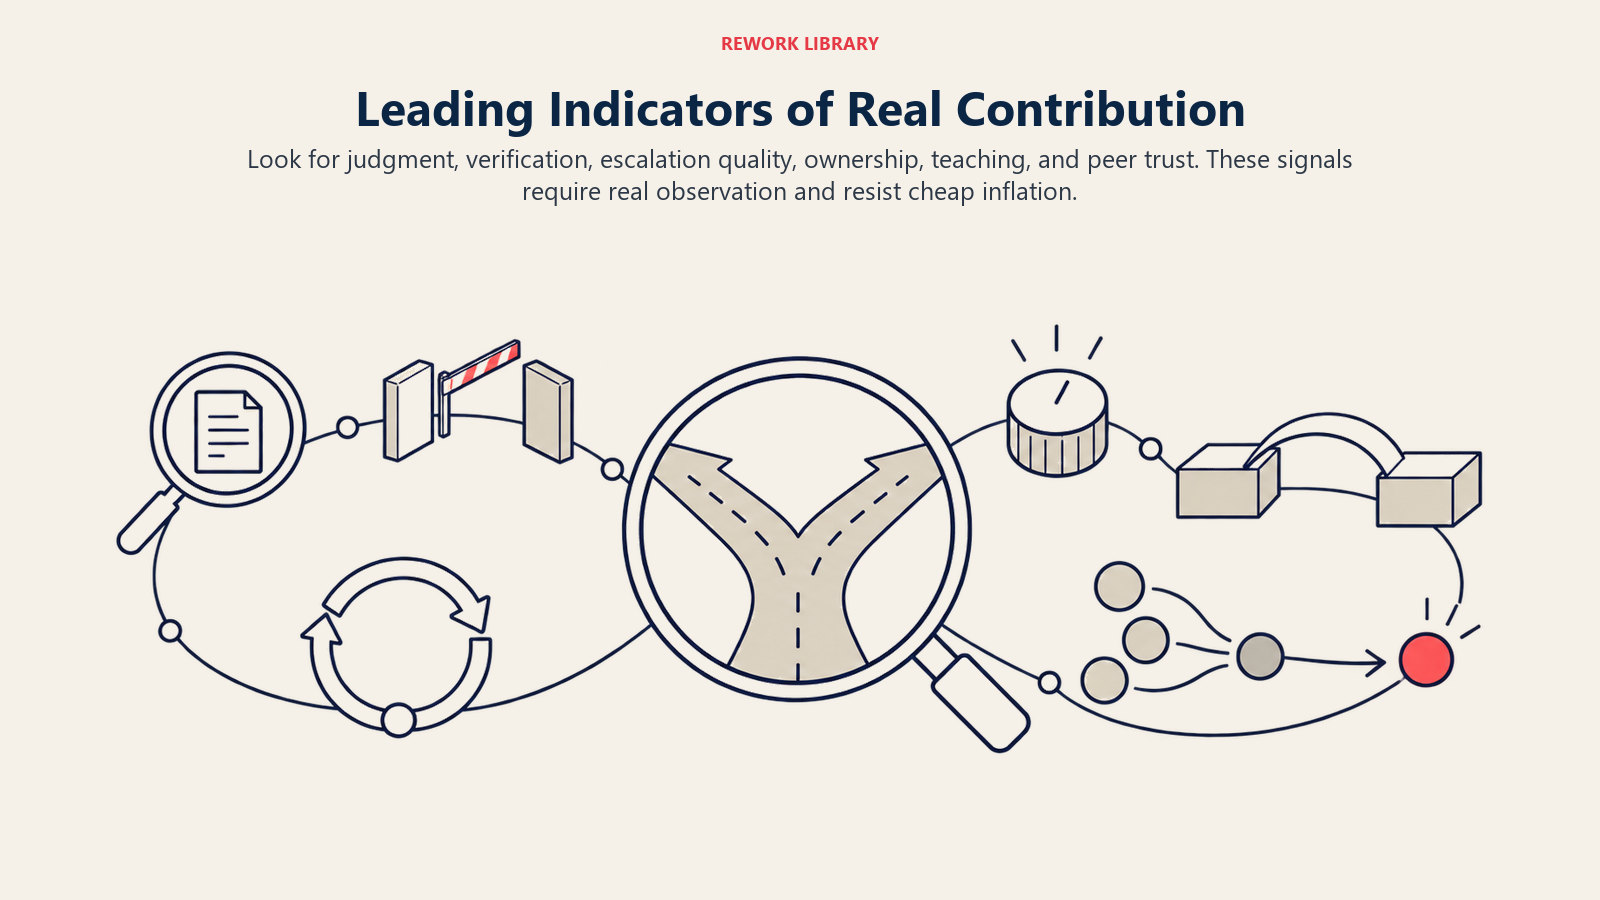
- Juicio ante la ambigüedad. ¿Esta persona tomó una decisión defendible en una situación que la herramienta de IA, el playbook y la política no cubrían con claridad? Es lo más difícil de falsificar y la señal más clara de contribución real.
- Comportamiento de verificación. ¿Esta persona contrasta el resultado de la IA con la fuente o con la situación real del cliente antes de enviarlo, o lo da por bueno sin mirar? Un gerente que dedica treinta minutos a revisar muestras de trabajo real lo ve de inmediato; ninguna métrica automatizada lo capta bien. Ese tiempo de verificación es también la carga que el ritmo y el burnout en la era de la IA llama el impuesto de la verificación, trabajo que la velocidad de la IA creó en lugar de eliminar.
- Calidad del escalamiento. ¿Distingue entre una decisión que debe tomar y una que debe elevar, y eleva las correctas en el momento correcto? Escalarlo todo es tan fallido como no escalar nada.
- Responsabilidad de ciclo completo. ¿El resultado se sostuvo semanas después, cuando un cliente o un equipo posterior usó de verdad lo que esta persona produjo? Es más lento de observar que un dashboard semanal y mucho más difícil de falsificar.
- Señal de enseñanza y calibración. ¿Trabajar con esta persona hace que los demás sean mejores para detectar los errores de la IA, y no solo más rápidos para producir? Es una de las habilidades complementarias que ganan valor a medida que la IA absorbe el trabajo rutinario.
- Confianza canalizada por los pares. Cuando surge algo ambiguo y de alto riesgo, ¿a quién se lo derivan los colegas sin que nadie se lo pida? Es una señal real que la mayoría de los sistemas de desempeño nunca se molesta en capturar, aunque todos ya conocen la respuesta.
Todo esto requiere que una persona real mire trabajo real, y por eso resisten la manipulación rápida que invitan las métricas de actividad. Son insumos para una decisión de juicio, no un reemplazo de ella.
La trampa de la vigilancia: por qué el monitoreo sale mal
Cuando las métricas de actividad dejan de funcionar, el instinto suele ser monitorear más: grabación de pantalla, registro de pulsaciones, seguimiento del uso de IA. La investigación es inusualmente coherente, y trae malas noticias para ese instinto.
Qué muestra realmente la evidencia
El metaanálisis de 2023, que abarca 94 muestras y más de 23,000 trabajadores, no halló evidencia de que el monitoreo electrónico del desempeño mejore el rendimiento. Sí halló un aumento constante del estrés de los trabajadores asociado con estar monitoreados, sin importar cómo se implementara. Es lo contrario del argumento habitual de las herramientas de monitoreo: más visibilidad, más rendición de cuentas, mejor resultado. Los datos dicen que en su mayoría compra estrés sin mejora medible del desempeño.
La confianza es el mecanismo real, y es costoso reconstruirla
La misma investigación halla que la transparencia modera el daño: un monitoreo divulgado y claramente ligado a un objetivo legítimo hace menos daño que uno encubierto o punitivo. Pero "menos daño" no es "ayuda". Cuando las personas creen que las vigilan para pillarlas y no para apoyarlas, esquivan el sistema, el mismo comportamiento que MIT NANDA documentó en los pilotos de IA abandonados en cuanto generaron fricción. La medición de estilo vigilancia produce el mismo modo de fallo que las métricas que pretendía corregir: las personas se optimizan para parecer productivas bajo lo que se observa, a costa del juicio que era el verdadero objetivo. También va en contra de la seguridad psicológica que un equipo necesita para admitir "no estoy seguro de que este resultado de la IA sea correcto", justamente la conducta que conviene fomentar.
Un enfoque práctico y defendible
Ninguna fórmula lo resuelve con limpieza. Un enfoque defendible lo acepta e incorpora los controles que la fórmula no puede dar.
- Use por defecto métricas a nivel de equipo o de resultado para cualquier cosa que financie una decisión amplia. Los fondos de bonos y el crédito de la hoja de ruta deben seguir resultados de los que un grupo responde en conjunto, no conteos de actividad que la IA puede inflar de manera despareja.
- Reserve la evaluación individual para la revisión humana real de trabajo real, con una cadencia, no para un dashboard. Un gerente que lee una muestra de resultados reales, incluido dónde alguien detectó o pasó por alto un error, obtiene una imagen mucho más exacta que cualquier métrica de uso.
- Haga que la ayuda de la IA sea algo que las personas declaran, no algo que ocultan. Si "usé IA para redactar esto y luego revisé estas tres secciones" es normal y seguro de decir, las conversaciones sobre contribución se vuelven honestas rápido. Si las personas lo ocultan para parecer competentes, todo el sistema funciona con información mala.
- Trate los indicadores adelantados como insumos de una conversación, no como una puntuación automatizada. En cuanto uno se formaliza en un número que fija el pago, empieza a sufrir la misma dinámica de la ley de Goodhart que las métricas que reemplazó.
- Audite la manipulación con una cadencia fija y espere que cualquier métrica se deteriore. Lo que mida hoy se optimizará en torno a sí mismo en un par de trimestres. Incorpore al sistema la revisión de la revisión.
- Separe "se hizo el trabajo" de "el juicio de esta persona fue lo que marcó la diferencia". Confundirlos es la razón más común por la que la medición de la contribución rompe la confianza en silencio.
Un rastro de auditoría de la IA que registre lo que produjo un modelo y lo que una persona cambió o anuló le da a este proceso algo concreto con lo que trabajar, en lugar de la memoria o el autorreporte meses después. Funciona mejor junto con puntos de revisión human-in-the-loop integrados en el propio workflow, y con gerentes que mantienen afilado su propio juicio lo suficiente como para distinguir una buena decisión de una afortunada.
Lo que esto no resuelve
La honestidad intelectual importa aquí más que una conclusión ordenada. Esto está, de verdad y en parte, sin resolver, y conviene decir algunas cosas con claridad en lugar de pasarlas por alto.
Hoy no existe una forma fiable y automatizada de separar "dio buenos prompts y sabía qué aspecto tiene lo bueno" de "tuvo un primer borrador afortunado y lo entregó", a la escala que necesitan la mayoría de las organizaciones. Los indicadores adelantados anteriores requieren tiempo humano, y la mayoría de las organizaciones no lo ha presupuestado, así que muchas seguirán recurriendo a métricas de actividad que son baratas de recoger y que se sabe que engañan. Medir el ROI de la IA a nivel de empresa ya es bastante difícil; llevar ese mismo rigor hasta la atribución individual multiplica la dificultad. Y el campo no ha convergido: lo que cuenta como atribución justa en un equipo de software, donde SPACE y DORA aportan una década de antecedentes, no se traslada automáticamente a ventas, legal o soporte, donde los modos de fallo difieren lo bastante como para que tomar el marco prestado sin cambios dé la respuesta equivocada con mucha seguridad.
Nada de esto es motivo para renunciar a medir la contribución. Es un motivo para sostener cualquier método con flexibilidad, mantener a una persona en el proceso en las decisiones que más pesan en una carrera y tratar esto como el resto de esta colección trata cada afirmación sobre IA y trabajo: un problema abierto y en evolución, con evidencia real detrás de las partes asentadas e incertidumbre real en el resto. Construir buenas métricas de cultura junto a este trabajo ayuda, ya que un equipo que ya mide cómo trabaja en conjunto parte con ventaja, pero por sí solo no termina el trabajo.
Una prueba despeja la mayor parte de esto antes de adoptar cualquier métrica de contribución: ¿se sentiría cómodo explicando en voz alta, a la persona medida, por qué este número refleja su juicio y no el del modelo? Si la respuesta honesta es no, la métrica no está lista para tocar el pago de nadie, por limpio que se vea el dashboard.
Preguntas frecuentes sobre la medición de la contribución en el trabajo aumentado por IA
¿Por qué es más difícil medir la contribución individual ahora que interviene la IA?
Las métricas de actividad que antes exigían un esfuerzo real y visible para inflarse (más código, más documentos, más tickets cerrados) ahora pueden producirse en volumen con un juicio mínimo. La métrica puede subir mucho mientras el valor que la persona aportó realmente se mantiene plano, lo que rompe el supuesto sobre el que descansan la mayoría de los sistemas de pago y ascenso.
¿Qué es la ley de Goodhart y por qué se aplica aquí?
La ley de Goodhart, popularizada como "cuando una medida se convierte en un objetivo, deja de ser una buena medida", describe cómo cualquier métrica ligada a una recompensa se optimiza en torno a sí misma en lugar de mejorar de verdad. La IA acelera esto porque los comportamientos concretos que antes daban sentido a una métrica (esfuerzo real, resultado real) pueden sustituirse por volumen generado por IA mucho más rápido de lo que los sistemas de desempeño pueden ajustarse.
¿Deben las empresas medir la contribución a nivel de equipo o a nivel individual?
Ambos, para decisiones distintas. Las métricas a nivel de equipo o de resultado son más difíciles de manipular y funcionan bien para decisiones grupales como los fondos de bonos o el crédito de la hoja de ruta. La evaluación individual sigue siendo necesaria para las decisiones de pago y ascenso sobre una sola persona, pero exige una revisión humana real de trabajo real, no un dashboard de actividad, porque los dashboards no pueden separar de forma fiable el buen juicio de un resultado afortunado asistido por IA.
¿El software de monitoreo o vigilancia resuelve el problema de la atribución?
La evidencia dice que no. Un metaanálisis de 94 muestras y más de 23,000 trabajadores no halló evidencia de que el monitoreo electrónico del desempeño mejore el rendimiento individual, y sí que aumenta de manera constante el estrés de los trabajadores. El monitoreo también puede empujar a las personas a ocultar su uso de IA o a esquivar el sistema por completo, lo que hace que la contribución sea más difícil de evaluar con honestidad, no más fácil.
¿Cuáles son los indicadores adelantados de contribución real en el trabajo aumentado por IA?
El juicio ante la ambigüedad, el comportamiento de verificación (contrastar un resultado de la IA antes de que salga), la calidad del escalamiento, la responsabilidad de ciclo completo sobre un resultado tras la entrega y si los colegas derivan a esta persona, sin que nadie se lo pida, el trabajo ambiguo o de alto riesgo. Requieren un observador humano y resisten mejor la manipulación rápida que los conteos de actividad.
¿Este problema de medición es lo mismo que la gestión del desempeño?
Están relacionados, pero son distintos. Esto trata de cómo medir lo que una persona aportó realmente a un resultado asistido por IA. La gestión del desempeño es el proceso más amplio de revisar, acompañar y evaluar a las personas a lo largo del tiempo, que se apoya en la medición pero también implica fijación de objetivos, retroalimentación y conversaciones de desarrollo que van más allá de cualquier métrica aislada.
¿Existe ya una solución estándar de la industria para este problema?
No. La ingeniería de software tiene el pensamiento más maduro al respecto, a través de marcos como SPACE y la investigación de DORA, pero incluso ese campo no ha resuelto por completo la atribución individual en el trabajo asistido por IA. Trate cualquier método actual como un punto de partida razonable, no como una respuesta cerrada.

Co-Founder, Rework.com
On this page
- Datos clave
- Por qué la atribución vuelve a importar de repente
- La remuneración y los ascensos siguen suponiendo un resultado individual
- La rendición de cuentas no desaparece porque un modelo haya ayudado
- El crédito moldea la moral de maneras que los líderes subestiman
- Por qué las métricas de actividad ingenuas fallan peor que antes
- La ley de Goodhart ya estaba esperando esto
- Qué medía antes una métrica frente a qué premia ahora
- La lección que la ingeniería de software ya aprendió por las malas
- El equilibrio entre el nivel de equipo y el nivel individual
- La medición a nivel de equipo es más honesta, pero no responde la pregunta del pago
- La medición a nivel individual es lo que quieren los líderes, y el problema más difícil
- No hay una resolución limpia, y fingir lo contrario es peor
- Indicadores adelantados que siguen aportando señal
- La trampa de la vigilancia: por qué el monitoreo sale mal
- Qué muestra realmente la evidencia
- La confianza es el mecanismo real, y es costoso reconstruirla
- Un enfoque práctico y defendible
- Lo que esto no resuelve