Individuelle Beiträge in KI-gestützter Arbeit messen
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
Den individuellen Beitrag in KI-gestützter Arbeit zu messen heißt, herauszulösen, was das Urteilsvermögen und die Entscheidungen einer Person zu einem Ergebnis beigetragen haben, an dem auch ein Modell und ein Workflow mitgewirkt haben. Das ist wichtig für Vergütung, Beförderung und Verantwortlichkeit, doch naive Aktivitätsmetriken (geschlossene Tickets, entworfene Wörter, Tool-Nutzung) werden durch KI aufgebläht und spiegeln keinen tatsächlichen Beitrag mehr wider. Keine Organisation hat dies vollständig gelöst. Der vertretbarste Ansatz kombiniert Frühindikatoren, Verantwortlichkeit auf Teamebene und ehrliches menschliches Urteil statt einer einzelnen Kennzahl.
Wichtige Fakten
- Das Goodhart'sche Gesetz, 1975 vom Ökonomen Charles Goodhart formuliert und 1997 von der Anthropologin Marilyn Strathern als „Wird ein Maß zum Ziel, hört es auf, ein gutes Maß zu sein" popularisiert, beschreibt, was geschieht, sobald eine Beitragsmetrik an die Vergütung gekoppelt wird (Wikipedia, „Goodhart's law").
- Der DORA-Bericht „State of DevOps" 2024 trennt individuelle Ergebnisse (Zufriedenheit, Flow, selbstberichtete Produktivität) von Delivery-Metriken auf Team- und Systemebene und stellte fest, dass die KI-Einführung die individuelle Produktivität und den Flow steigerte, auf Teamebene jedoch Lieferstabilität und Durchsatz messbar verschlechterte (DORA, Accelerate State of DevOps Report 2024).
- Das SPACE-Framework warnt davor, die Produktivität von Entwicklern auf einzelne Aktivitätszahlen wie Codezeilen oder Commits zu reduzieren, da diese sichtbare Aktivität mit tatsächlichem Output verwechseln und manipuliert werden, sobald sie an die individuelle Bewertung gekoppelt sind (Forsgren et al., „The SPACE of Developer Productivity", ACM Queue, 2021).
- Eine Metaanalyse von 94 unabhängigen Stichproben mit 23.461 Beschäftigten fand keinen Beleg dafür, dass elektronische Leistungsüberwachung die individuelle Leistung verbessert, und stellte fest, dass sie unabhängig von der Umsetzung zuverlässig den Stress der Beschäftigten erhöht (Ravid et al., „A meta-analysis of the effects of electronic performance monitoring on work outcomes", Personnel Psychology, 2023).
- Die Auswertung von MIT NANDA zu mehr als 300 KI-Einsätzen in Unternehmen ergab, dass 95 Prozent der Pilotprojekte mit generativer KI keine messbare Wirkung auf die Gewinn- und Verlustrechnung zeigten, eine Lücke, die die Forschenden auf nicht gemessene Workflow-Faktoren zurückführen, nicht auf individuellen Einsatz (MIT NANDA, „The GenAI Divide: State of AI in Business 2025", via Fortune).
Warum Zuordnung plötzlich wieder wichtig wird
Zuordnung war schon vor KI nie vollständig gelöst. Ein Vertriebsmitarbeiter schließt einen Deal ab, den ein Kollege angebahnt hat, eine Entwicklerin liefert ein Feature aus, das ein Designer spezifiziert hat: Arbeit war schon immer kollaborativ, und die Zuschreibung von Verdienst war schon immer teilweise eine Ermessensfrage. KI hat das Problem nicht geschaffen. Sie hat ein altes Problem an mehr Stellen gleichzeitig tragend gemacht, weil nahezu jedes Ergebnis nun einen dritten Beitragenden hat, den man nicht befragen, nicht befördern und nicht zur Verantwortung ziehen kann.
Vergütung und Beförderung setzen weiterhin individuellen Output voraus
Entscheidungen zu Vergütung und Beförderung gehen davon aus, dass sich ein Ergebnis mit vertretbarer Sicherheit auf das Urteilsvermögen einer Person zurückführen lässt. Diese Annahme wird jedes Quartal wackliger. Schreibt ein Vertriebsmitarbeiter mit einem KI-Assistenten fünfzehn Outbound-E-Mails und schließt drei Deals, und ein Kollege ohne Assistenten schreibt fünf von Hand und schließt zwei, wessen Quartal zeugt dann von besserem Urteilsvermögen? Die Systeme, auf die sich die Vergütung stützt, wurden für diese Mehrdeutigkeit nicht gebaut, und die meisten Unternehmen betreiben sie trotzdem weiter, weil es noch keinen offensichtlichen Ersatz gibt. Vergütung und Fairness im KI-Zeitalter geht weiter darauf ein, welche Vergütungslogik tatsächlich bricht, wenn der Output einer Person wie der von fünf Personen aussieht, allein dank des Tools und nicht dank des Urteilsvermögens dahinter.
Verantwortlichkeit verschwindet nicht, weil ein Modell geholfen hat
Geht eine KI-gestützte Entscheidung schief (eine übersehene Vertragsklausel, eine zu viel versprechende Kunden-E-Mail, eine falsche Annahme in einem Modell), muss weiterhin jemand dafür einstehen. Ein Sprachmodell lässt sich nicht auf einen Leistungsverbesserungsplan setzen. Das ist verwandt mit der Beitragsmessung für Belohnungen, aber davon zu unterscheiden: Es geht darum, wer Rede und Antwort steht, wenn etwas schiefgeht, nicht darum, wer den Bonus bekommt, wenn es klappt, und beides wird schwieriger, weil die Grenze zwischen „die Person hat das entschieden" und „das Tool hat das erzeugt" verschwommen ist.
Verdienst prägt die Stimmung stärker, als Führungskräfte annehmen
Menschen merken schnell, wenn Verdienst falsch zugeteilt wird. Ein Teammitglied, das das Problem gerahmt und die selbstsicher klingende falsche Antwort des Modells abgefangen hat und zusieht, wie ein Kollege für das unveränderte Übernehmen eines KI-Entwurfs gleich viel Anerkennung erhält, untergräbt schnell das Vertrauen am Arbeitsplatz. Liegen Sie bei der Zuordnung ein paar Mal sichtbar daneben, tun Ihre besten Leute still weniger von der schwer messbaren Arbeit, weil das System ihnen gerade gesagt hat, dass sie nicht zählt.
Warum naive Aktivitätsmetriken schlimmer scheitern als zuvor
Jede Organisation hat bereits irgendeine Form von Aktivitätsmetrik: geschlossene Tickets, Codezeilen, entworfene Wörter, geführte Anrufe. Sie waren schon immer ein unvollkommener Stellvertreter für Wert. KI bricht diesen Stellvertreter auf besondere Weise: Sie macht die Aktivität in großer Menge mühelos herstellbar, während das eigentliche Urteil (war das die richtige Antwort, hat sie gehalten) genauso schwer bleibt wie zuvor oder schwerer, weil nun jemand das Ergebnis verifizieren muss, statt es nur zu erzeugen.
Das Goodhart'sche Gesetz hat darauf schon gewartet
Das Goodhart'sche Gesetz besagt, dass ein Maß, das zum Ziel wird, aufhört, ein gutes Maß zu sein, weil Menschen ihren Einsatz an dem ausrichten, was die Metrik belohnt, statt am eigentlichen Ziel. Das ist nichts Neues bei KI: Es ist derselbe Mechanismus, der Lehrkräfte den Unterricht auf einen standardisierten Test verengen lässt oder Call-Center-Mitarbeitende Gespräche kurz halten lässt, um eine Bearbeitungszeit zu treffen, statt das Problem zu lösen. Was KI ändert, ist die Geschwindigkeit der Manipulation. Eine Metrik, die früher echten Aufwand zum Aufblähen erforderte (mehr Code schreiben, mehr E-Mails entwerfen), lässt sich nun mit ein paar Prompts und fast ohne Urteilsvermögen aufblähen, sodass die Kluft zwischen „die Zahl ist gestiegen" und „der Wert ist gestiegen" schneller wächst, als die meisten Performance-Systeme nachsteuern können.
Was eine Metrik früher maß und was sie heute belohnt
| Metrik | Was sie zu messen schien | Was sie heute tatsächlich belohnt |
|---|---|---|
| Codezeilen / Commits | Engineering-Output und Aufwand | Wortreichen KI-generierten Code und aufgeblähte Commits, unabhängig von funktionierender Software |
| Geschlossene Tickets pro Woche | Support-Durchsatz | Das Aufteilen einfacher, KI-gestützter Tickets in mehr Tickets statt das Lösen schwieriger |
| Entworfene Wörter oder Dokumente | Schreib-Output | Menge an KI-entworfenem Text, nicht das Denken, Redigieren oder Urteilen dahinter |
| Antwortzeit / Bearbeitungsgeschwindigkeit | Reaktionsfähigkeit und Sorgfalt | Das schnelle Ausliefern eines ungeprüften KI-Entwurfs, statt den Fall zu erkennen, in dem er falsch war |
| Häufigkeit der KI-Tool-Nutzung („Seat Adoption") | KI-Kompetenz und Begeisterung | Wiederholtes Klicken auf „Akzeptieren", ohne das Ergebnis zu verifizieren, zu korrigieren oder zu verbessern |
| Gesendete Meetings oder Nachrichten | Zusammenarbeit und Engagement | KI-gestütztes Nachrichtenvolumen, das stark steigen kann, ohne dass sich die getroffenen Entscheidungen ändern |
Die Lektion, die das Software-Engineering auf die harte Tour gelernt hat
Softwareteams stießen als Erste auf dieses Problem, weil Code-Output eines der ersten Dinge war, die KI mühelos aufblähbar machte. Die Antwort der Branche, im SPACE-Framework formalisiert, bestand darin, einzelne Aktivitätsmetriken für Individuen abzulehnen und Produktivität über fünf Dimensionen zu messen (Zufriedenheit, Leistung, Aktivität, Kommunikation, Effizienz), von denen die meisten nur auf Team- oder Systemebene sinnvoll sind. Die DORA-Forschung 2024 stützt das mit einem unbequemen Befund: Die KI-Einführung steigerte, wie produktiv sich einzelne Entwickler fühlten, und verschlechterte zugleich messbar die Metriken auf Teamebene, die vorhersagen, ob Software zuverlässig ausgeliefert wird. Wer nur die individuellen Zahlen liest, sieht in KI einen eindeutigen Gewinn. Wer die Zahlen der Teamebene danebenlegt, erkennt ein ehrlicheres Bild, dasselbe Muster, das diese Collection im Produktivitätsparadoxon der KI dokumentiert: Individuelle Signale und organisatorische Ergebnisse können sich gleichzeitig in entgegengesetzte Richtungen bewegen.
Der Zielkonflikt zwischen Team- und Individualebene
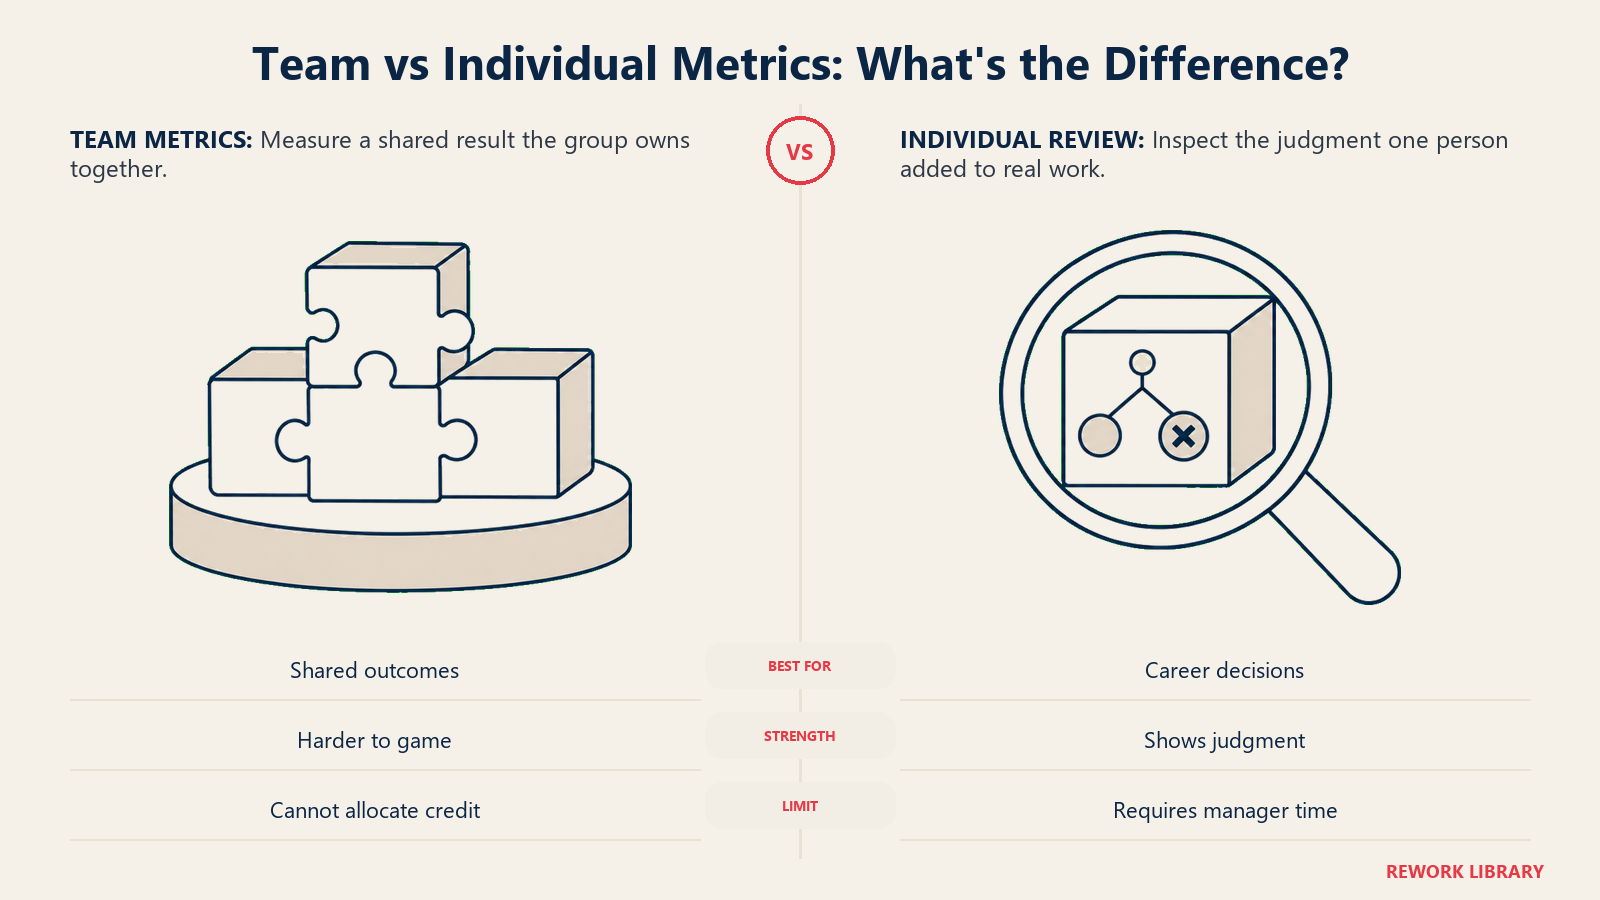
Das ist der Zielkonflikt, den jede Führungskraft am Ende austarieren muss, ob sie ihn benennt oder nicht.
Messung auf Teamebene ist ehrlicher, beantwortet aber nicht die Vergütungsfrage
Ergebnisse auf Team- oder Workflow-Ebene zu messen (hat dieser Pod das Feature ausgeliefert, sind seine Kunden seltener abgewandert), widersteht Manipulation besser, weil es für eine einzelne Person schwerer ist, eine gemeinsame Zahl aufzublähen, ohne dass das übrige Team es bemerkt. Es passt auch dazu, wie Rollen im Orchestrator-Stil heute funktionieren: Ein Job kann fast ganz aus Urteilen und Koordination bestehen, für jede Aktivitätszahl unsichtbar, und trotzdem der Grund sein, warum der Output des Teams gut ist. Der Preis ist, dass Messung auf Teamebene für sich allein nicht sagt, wen Sie befördern oder besser bezahlen sollten.
Messung auf Individualebene ist das, was Führungskräfte wollen, und das schwierigere Problem
Jedes Vergütungs- und Beförderungssystem braucht irgendwann ein individuelles Signal, denn Gehaltsentscheidungen betreffen Menschen, nicht Pods. Doch je genauer Sie versuchen, den Grenzbeitrag einer einzelnen Person herauszulösen, desto eher stoßen Sie auf ein Problem, das niemand geknackt hat: Eine Person, die gut promptet, den Fehler des Modells abfängt und in zwanzig Minuten ein großartiges Ergebnis ausliefert, kann bei jeder Aktivitätsmetrik identisch aussehen wie jemand, der den ersten Entwurf übernommen hat, Glück hatte und etwas Mittelmäßiges ausgeliefert hat. Die beiden Leistungen sind nicht gleich, und die meisten Systeme können sie ohne einen Menschen, der die tatsächliche Arbeit prüft, nicht unterscheiden.
Es gibt keine saubere Lösung, und so zu tun, als gäbe es sie, ist schlimmer
Die ehrliche Position braucht beide Perspektiven: Metriken auf Teamebene für Entscheidungen, die die ganze Gruppe betreffen, und individuelle, urteilsbasierte Prüfung für Entscheidungen, die unvermeidlich eine einzelne Person betreffen, etwa wer befördert wird. Diese individuelle Ebene mit einem Dashboard automatisieren zu wollen, ist der Punkt, an dem der meiste Schaden entsteht.
Frühindikatoren, die weiterhin Aussagekraft haben
Keiner der folgenden Punkte lässt sich so schnell und billig manipulieren wie Aktivitätszahlen, weil jeder erfordert, dass der Beobachter sich die Arbeit tatsächlich ansieht, statt sie zu zählen.
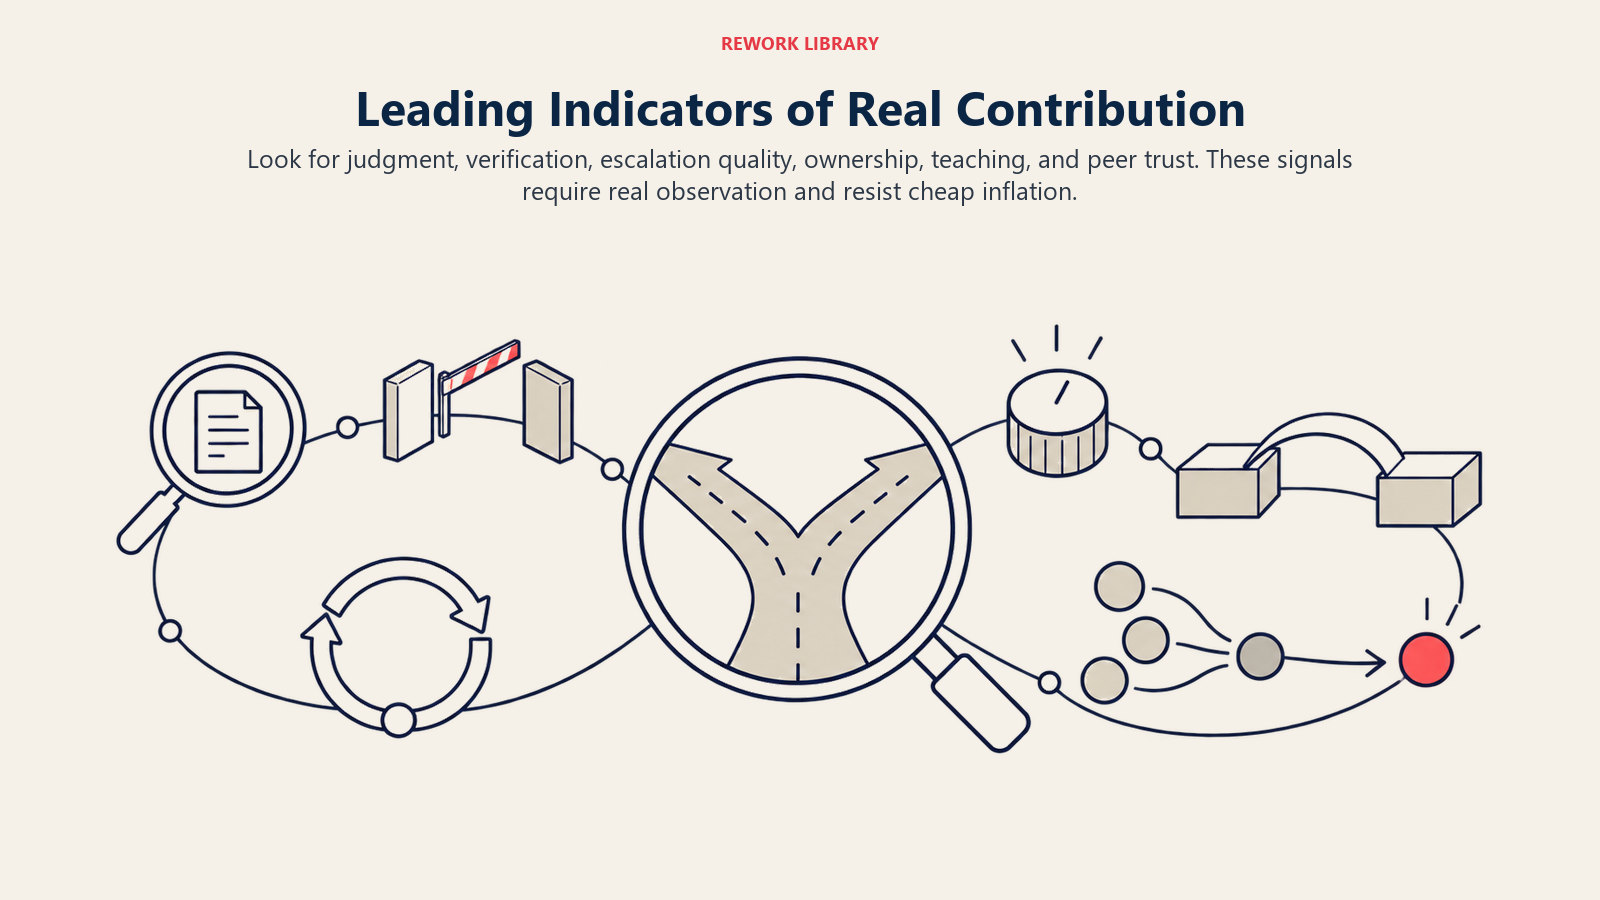
- Urteilsvermögen bei Mehrdeutigkeit. Hat diese Person in einer Situation, die das KI-Tool, das Playbook und die Richtlinie nicht klar abgedeckt haben, eine vertretbare Entscheidung getroffen? Das Schwierigste zu fälschende und das klarste Signal echten Beitrags.
- Verifikationsverhalten. Prüft diese Person ein KI-Ergebnis an der Quelle oder an der realen Situation des Kunden, bevor es hinausgeht, oder winkt sie es durch? Eine Führungskraft, die dreißig Minuten mit echten Arbeitsproben verbringt, sieht das sofort; keine automatisierte Metrik erfasst es gut. Diese Prüfzeit ist auch die Last, die Tempo und Burnout im KI-Zeitalter als Verifikationssteuer bezeichnet, Arbeit, die die Geschwindigkeit der KI erst geschaffen statt beseitigt hat.
- Eskalationsqualität. Kennt die Person den Unterschied zwischen einer Entscheidung, die sie selbst treffen, und einer, die sie weitergeben sollte, und gibt sie die richtigen zur richtigen Zeit weiter? Alles zu eskalieren ist ebenso ein Versagen des Urteilsvermögens wie nichts zu eskalieren.
- Ownership über den gesamten Zyklus. Hat das Ergebnis Wochen später noch Bestand, nachdem ein Kunde oder ein nachgelagertes Team das Erarbeitete tatsächlich genutzt hat? Langsamer zu beobachten als ein wöchentliches Dashboard und weit schwerer zu fälschen.
- Signal für Wissensvermittlung und Kalibrierung. Macht die Zusammenarbeit mit dieser Person andere besser darin, Fehler der KI zu erkennen, und nicht nur schneller darin, Output zu erzeugen? Eine der komplementären Fähigkeiten, die wertvoller werden, je mehr Routinearbeit KI übernimmt.
- Vertrauen, das Kollegen aussprechen. Wenn etwas Mehrdeutiges mit hohem Einsatz aufkommt, an wen geben Kollegen es unaufgefordert weiter? Ein echtes Signal, das die meisten Performance-Systeme nie erfassen, obwohl alle die Antwort längst kennen.
Dafür muss ein Mensch tatsächlich auf tatsächliche Arbeit schauen, weshalb sie der schnellen Manipulation widerstehen, zu der Aktivitätsmetriken einladen. Sie sind Eingaben für ein Urteil, kein Ersatz dafür.
Die Überwachungsfalle: Warum Monitoring nach hinten losgeht
Der Instinkt, sobald Aktivitätsmetriken nicht mehr funktionieren, lautet oft, schärfer zu überwachen: Bildschirmaufzeichnung, Tastaturprotokolle, Tracking der KI-Nutzung. Die Forschung ist ungewöhnlich einheitlich, und für diesen Instinkt eine schlechte Nachricht.
Was die Evidenz tatsächlich zeigt
Die Metaanalyse von 2023 mit 94 Stichproben und über 23.000 Beschäftigten fand keinen Beleg dafür, dass elektronische Leistungsüberwachung die Leistung verbessert. Sie fand einen zuverlässigen Anstieg des Stresses der Beschäftigten, der mit dem Überwachtwerden verbunden ist, unabhängig davon, wie sie umgesetzt wurde. Das ist das Gegenteil des üblichen Versprechens von Monitoring-Tools: mehr Transparenz, mehr Verantwortlichkeit, besserer Output. Die Daten sagen, dass es vor allem Stress einkauft, ohne messbaren Leistungsgewinn.
Vertrauen ist der eigentliche Mechanismus, und es ist teuer, es wiederaufzubauen
Dieselbe Forschung stellt fest, dass Transparenz den Schaden abmildert: Monitoring, das offengelegt und klar an ein legitimes Ziel geknüpft ist, schadet weniger als verdecktes oder strafendes. Aber „weniger Schaden" ist nicht „hilft". Sobald Menschen glauben, man beobachte sie, um sie zu ertappen statt zu unterstützen, umgehen sie das System, dasselbe Verhalten, das MIT NANDA bei KI-Piloten dokumentierte, die in dem Moment aufgegeben wurden, in dem sie Reibung erzeugten. Messung nach Art der Überwachung erzeugt dieselbe Fehlerform wie die Metriken, die sie reparieren sollte: Menschen optimieren darauf, unter dem Beobachteten produktiv zu wirken, auf Kosten des Urteilsvermögens, das der eigentliche Zweck war. Sie arbeitet auch gegen die psychologische Sicherheit, die ein Team braucht, um zuzugeben „ich bin nicht sicher, ob dieses KI-Ergebnis stimmt", genau das Verhalten, das gefördert werden sollte.
Ein vertretbarer praktischer Ansatz
Keine Formel löst das sauber. Ein vertretbarer Ansatz akzeptiert das und baut die Kontrollen ein, die die Formel nicht liefern kann.
- Verwenden Sie standardmäßig Metriken auf Team- oder Ergebnisebene für alles, was eine breite Entscheidung finanziert. Bonustöpfe und Roadmap-Anerkennung sollten Ergebnisse abbilden, für die eine Gruppe gemeinsam verantwortlich ist, nicht Aktivitätszahlen, die KI ungleichmäßig aufblähen kann.
- Reservieren Sie die individuelle Bewertung für die tatsächliche menschliche Prüfung tatsächlicher Arbeit, in einem festen Rhythmus, nicht per Dashboard. Eine Führungskraft, die eine Stichprobe echten Outputs liest, einschließlich der Stellen, an denen jemand einen Fehler abgefangen oder übersehen hat, erhält ein weit genaueres Bild als durch jede Nutzungsmetrik.
- Machen Sie KI-Unterstützung zu etwas, das Menschen angeben, nicht verbergen. Wenn „ich habe das mit KI entworfen und diese drei Abschnitte überarbeitet" normal und sicher auszusprechen ist, werden Gespräche über Beiträge schnell ehrlich. Wenn Menschen sie verbergen, um kompetent zu wirken, läuft das ganze System auf schlechten Informationen.
- Behandeln Sie Frühindikatoren als Eingaben für ein Gespräch, nicht als automatisierten Score. In dem Moment, in dem einer zu einer Zahl formalisiert wird, die die Vergütung bestimmt, leidet er unter denselben Goodhart-Dynamiken wie die Metriken, die er ersetzt hat.
- Prüfen Sie in festem Rhythmus auf Manipulation und rechnen Sie damit, dass jede Metrik verfällt. Was Sie heute messen, wird innerhalb weniger Quartale umgangen. Bauen Sie die Überprüfung der Überprüfung in das System ein.
- Trennen Sie „wurde die Arbeit erledigt" von „war das Urteilsvermögen dieser Person der Unterschied". Beides zu vermengen ist der häufigste Grund, warum Beitragsmessung still das Vertrauen zerstört.
Ein KI-Audit-Trail, der festhält, was ein Modell erzeugt hat und was ein Mensch geändert oder überstimmt hat, gibt diesem Prozess etwas Konkretes an die Hand, statt Erinnerung oder Selbstauskunft Monate später. Am besten wirkt er zusammen mit Human-in-the-Loop-Prüfpunkten, die in den Workflow selbst eingebaut sind, und mit Führungskräften, die ihr eigenes Urteilsvermögen aktiv scharf halten, sodass sie den Unterschied zwischen einer guten Entscheidung und einer glücklichen erkennen.
Was dies nicht löst
Intellektuelle Ehrlichkeit zählt hier mehr als ein ordentliches Fazit. Das ist tatsächlich teilweise ungelöst, und einiges sollte offen gesagt statt übergangen werden.
Heute gibt es keinen verlässlichen, automatisierten Weg, „hat gut geprompt und wusste, wie gut aussieht" von „hatte einen glücklichen ersten Entwurf und hat ihn ausgeliefert" zu trennen, und zwar in dem Umfang, den die meisten Organisationen brauchen. Die oben genannten Frühindikatoren erfordern die Zeit eines Menschen, und die meisten Organisationen haben dafür kein Budget eingeplant, sodass viele weiter auf Aktivitätsmetriken zurückfallen werden, die billig zu erheben und bekanntermaßen irreführend sind. KI-ROI-Messung auf Unternehmensebene ist schon schwer genug; dieselbe Strenge auf die individuelle Zuordnung herunterzubrechen, vervielfacht die Schwierigkeit. Und das Feld ist nicht zu einem Konsens gelangt: Was in einem Softwareteam, in dem SPACE und DORA ein Jahrzehnt Vorarbeit liefern, als faire Zuordnung gilt, lässt sich nicht automatisch auf Vertrieb, Recht oder Support übertragen, wo die Fehlerbilder sich so stark unterscheiden, dass das wortgetreue Übernehmen des Frameworks mit hoher Überzeugung zur falschen Antwort führt.
Nichts davon ist ein Grund, die Messung von Beiträgen aufzugeben. Es ist ein Grund, jede Methode mit lockerer Hand zu halten, bei den für eine Karriere wichtigsten Entscheidungen einen Menschen im Prozess zu behalten und das Thema so zu behandeln, wie der Rest dieser Collection jede Aussage zu KI und Arbeit behandelt: als offenes, sich entwickelndes Problem, mit echter Evidenz hinter den gesicherten Teilen und echter Unsicherheit im Rest. Parallel dazu gute Kulturmetriken aufzubauen, hilft, denn ein Team, das bereits misst, wie es zusammenarbeitet, hat einen Vorsprung, doch es schließt die Aufgabe nicht allein ab.
Ein Test schneidet durch das meiste hiervon, bevor Sie eine Beitragsmetrik einführen: Wären Sie bereit, der gemessenen Person laut zu erklären, warum diese Zahl ihr Urteilsvermögen widerspiegelt und nicht das des Modells? Lautet die ehrliche Antwort nein, ist die Metrik nicht reif, irgendjemandes Vergütung zu berühren, egal wie sauber das Dashboard aussieht.
Häufig gestellte Fragen zur Messung von Beiträgen in KI-gestützter Arbeit
Warum ist es schwieriger geworden, individuelle Beiträge zu messen, seit KI beteiligt ist?
Aktivitätsmetriken, die früher echten, sichtbaren Aufwand zum Aufblähen erforderten (mehr Code, mehr Dokumente, mehr geschlossene Tickets), lassen sich nun in großer Menge mit minimalem Urteilsvermögen erzeugen. Die Metrik kann stark steigen, während der Wert, den die Person tatsächlich hinzugefügt hat, gleich bleibt, was die Annahme untergräbt, auf der die meisten Vergütungs- und Beförderungssysteme beruhen.
Was ist das Goodhart'sche Gesetz und warum gilt es hier?
Das Goodhart'sche Gesetz, popularisiert als „Wird ein Maß zum Ziel, hört es auf, ein gutes Maß zu sein", beschreibt, wie jede an eine Belohnung gekoppelte Metrik umgangen statt wirklich verbessert wird. KI beschleunigt das, weil sich die Verhaltensweisen, die eine Metrik früher aussagekräftig machten (echter Aufwand, echter Output), nun durch KI-generierte Menge viel schneller ersetzen lassen, als Performance-Systeme nachsteuern können.
Sollten Unternehmen Beiträge auf Team- oder auf Individualebene messen?
Beides, für unterschiedliche Entscheidungen. Metriken auf Team- oder Ergebnisebene sind schwerer zu manipulieren und eignen sich gut für Entscheidungen auf Gruppenebene wie Bonustöpfe oder Roadmap-Anerkennung. Die individuelle Bewertung bleibt für Vergütungs- und Beförderungsentscheidungen über eine einzelne Person nötig, erfordert aber die tatsächliche menschliche Prüfung tatsächlicher Arbeit statt eines Aktivitäts-Dashboards, weil Dashboards gutes Urteilsvermögen nicht verlässlich von einem glücklichen KI-gestützten Ergebnis trennen können.
Löst Monitoring- oder Überwachungssoftware das Zuordnungsproblem?
Die Evidenz sagt nein. Eine Metaanalyse von 94 Stichproben und über 23.000 Beschäftigten fand keinen Beleg dafür, dass elektronische Leistungsüberwachung die individuelle Leistung verbessert, und stellte fest, dass sie den Stress der Beschäftigten zuverlässig erhöht. Monitoring kann Menschen auch dazu bringen, ihre KI-Nutzung zu verbergen oder das System ganz zu umgehen, was die ehrliche Bewertung von Beiträgen erschwert statt erleichtert.
Was sind Frühindikatoren echten Beitrags in KI-gestützter Arbeit?
Urteilsvermögen bei Mehrdeutigkeit, Verifikationsverhalten (ein KI-Ergebnis prüfen, bevor es hinausgeht), Eskalationsqualität, Ownership über den gesamten Zyklus eines Ergebnisses nach der Übergabe und die Frage, ob Kollegen mehrdeutige oder besonders wichtige Arbeit unaufgefordert an diese Person weitergeben. Dafür braucht es einen menschlichen Beobachter, und sie widerstehen schneller Manipulation besser als Aktivitätszahlen.
Ist dieses Messproblem dasselbe wie Performance Management?
Sie sind verwandt, aber verschieden. Hier geht es darum, wie man misst, was eine einzelne Person zu einem KI-gestützten Ergebnis tatsächlich beigetragen hat. Performance Management ist der breitere Prozess, Menschen über die Zeit zu beurteilen, zu coachen und zu bewerten; er stützt sich auf Messung, umfasst aber auch Zielsetzung, Feedback und Entwicklungsgespräche, die über jede einzelne Metrik hinausgehen.
Gibt es schon eine branchenübliche Lösung für dieses Problem?
Nein. Das Software-Engineering hat hier das ausgereifteste Denken, durch Frameworks wie SPACE und die Forschung von DORA, doch selbst dieses Feld hat die individuelle Zuordnung in KI-gestützter Arbeit nicht vollständig gelöst. Betrachten Sie jede aktuelle Methode als vernünftigen Ausgangspunkt, nicht als gesicherte Antwort.

Co-Founder, Rework.com
On this page
- Wichtige Fakten
- Warum Zuordnung plötzlich wieder wichtig wird
- Vergütung und Beförderung setzen weiterhin individuellen Output voraus
- Verantwortlichkeit verschwindet nicht, weil ein Modell geholfen hat
- Verdienst prägt die Stimmung stärker, als Führungskräfte annehmen
- Warum naive Aktivitätsmetriken schlimmer scheitern als zuvor
- Das Goodhart'sche Gesetz hat darauf schon gewartet
- Was eine Metrik früher maß und was sie heute belohnt
- Die Lektion, die das Software-Engineering auf die harte Tour gelernt hat
- Der Zielkonflikt zwischen Team- und Individualebene
- Messung auf Teamebene ist ehrlicher, beantwortet aber nicht die Vergütungsfrage
- Messung auf Individualebene ist das, was Führungskräfte wollen, und das schwierigere Problem
- Es gibt keine saubere Lösung, und so zu tun, als gäbe es sie, ist schlimmer
- Frühindikatoren, die weiterhin Aussagekraft haben
- Die Überwachungsfalle: Warum Monitoring nach hinten losgeht
- Was die Evidenz tatsächlich zeigt
- Vertrauen ist der eigentliche Mechanismus, und es ist teuer, es wiederaufzubauen
- Ein vertretbarer praktischer Ansatz
- Was dies nicht löst