Mengukur Sumbangan Individu dalam Kerja yang Dipertingkat oleh AI
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
Mengukur sumbangan individu dalam kerja yang dipertingkat oleh AI bermaksud mengasingkan apa yang ditambah oleh pertimbangan dan keputusan seseorang kepada output yang turut dihasilkan oleh model dan aliran kerja. Ia penting untuk gaji, kenaikan pangkat dan akauntabiliti, tetapi metrik aktiviti yang naif (tiket ditutup, perkataan yang didraf, penggunaan alat) menjadi kembung akibat AI dan tidak lagi mencerminkan sumbangan sebenar sesiapa pun. Tiada organisasi yang telah menyelesaikan perkara ini sepenuhnya. Pendekatan yang paling boleh dipertahankan menggabungkan penunjuk utama, akauntabiliti peringkat pasukan dan pertimbangan manusia yang jujur dan bukannya satu nombor tunggal.
Fakta Utama
- Goodhart's Law, yang dirumuskan oleh ahli ekonomi Charles Goodhart pada 1975 dan dipopularkan sebagai "when a measure becomes a target, it ceases to be a good measure" oleh ahli antropologi Marilyn Strathern pada 1997, menggambarkan apa yang berlaku sebaik sahaja metrik sumbangan dikaitkan dengan gaji (Wikipedia, "Goodhart's law").
- Laporan State of DevOps 2024 oleh DORA memisahkan hasil individu (kepuasan, aliran, produktiviti yang dilaporkan sendiri) daripada metrik penghantaran peringkat pasukan dan sistem, dan mendapati penerimaan AI meningkatkan produktiviti dan aliran individu sambil menjejaskan kestabilan serta daya pemprosesan penghantaran pada peringkat pasukan secara ketara (DORA, Accelerate State of DevOps Report 2024).
- Kerangka SPACE memberi amaran agar produktiviti pembangun tidak dikecilkan kepada bilangan aktiviti tunggal seperti baris kod atau commit, kerana ia mengelirukan aktiviti yang kelihatan dengan output sebenar dan mudah dimanipulasi sebaik sahaja dikaitkan dengan penilaian individu (Forsgren et al., "The SPACE of Developer Productivity," ACM Queue, 2021).
- Meta-analisis terhadap 94 sampel bebas dan 23,461 pekerja tidak menemui bukti bahawa pemantauan prestasi elektronik meningkatkan prestasi individu, dan mendapati ia secara konsisten meningkatkan tekanan pekerja tanpa mengira cara pelaksanaannya (Ravid et al., "A meta-analysis of the effects of electronic performance monitoring on work outcomes," Personnel Psychology, 2023).
- Kajian MIT NANDA terhadap 300+ pengerahan AI perusahaan mendapati 95 peratus projek perintis AI generatif tidak menunjukkan kesan P&L yang boleh diukur, jurang yang dikesan oleh para penyelidik kepada faktor aliran kerja yang tidak diukur dan bukannya usaha individu (MIT NANDA, "The GenAI Divide: State of AI in Business 2025", via Fortune).
Mengapa Atribusi Tiba-Tiba Penting Semula
Atribusi tidak pernah diselesaikan sepenuhnya sebelum AI. Jurujual yang menutup perjanjian yang dicari oleh rakan sepasukan, jurutera yang menghantar ciri yang ditentukan oleh pereka: kerja sentiasa bersifat kolaboratif, dan pujian sentiasa sebahagiannya keputusan pertimbangan. AI tidak mencipta masalah ini. Ia menjadikan masalah lama itu bersifat menanggung beban di lebih banyak tempat serentak, kerana hampir setiap output kini mempunyai penyumbang ketiga yang tidak boleh ditemu bual, dinaikkan pangkat atau dipertanggungjawabkan.
Gaji dan kenaikan pangkat masih menganggap output bersifat individu
Keputusan pampasan dan kenaikan pangkat menganggap anda boleh menjejak sesuatu hasil kembali kepada pertimbangan seseorang dengan keyakinan yang munasabah. Anggapan itu semakin goyah setiap suku tahun. Jika seorang wakil menulis 15 e-mel keluar dengan pembantu AI dan menutup tiga perjanjian, manakala rakan sekerja tanpa pembantu itu menulis lima secara manual dan menutup dua, suku tahun siapa yang mencerminkan pertimbangan yang lebih baik? Sistem yang menjadi pegangan pampasan tidak dibina untuk kekaburan ini, dan kebanyakan syarikat tetap menggunakannya kerana belum ada pengganti yang jelas. Pampasan dan keadilan dalam era AI mengupas lebih lanjut logik gaji apa yang sebenarnya rosak apabila output seorang kelihatan seperti output lima orang, semata-mata berkat alat dan bukan pertimbangan di sebaliknya.
Akauntabiliti tidak hilang hanya kerana model membantu
Apabila keputusan yang dibantu AI tersasar (klausa kontrak yang terlepas, e-mel pelanggan yang menjanjikan terlalu banyak, andaian buruk yang tertanam dalam model) seseorang masih perlu bertanggungjawab. Anda tidak boleh meletakkan model bahasa dalam pelan peningkatan prestasi. Ini berkaitan tetapi berbeza daripada mengukur sumbangan untuk ganjaran: ia tentang siapa yang menjawab apabila sesuatu rosak, bukan siapa yang mendapat bonus apabila ia berjaya, dan kedua-duanya menjadi lebih sukar kerana garis antara "orang itu memutuskan ini" dengan "alat itu menghasilkan ini" sudah kabur.
Pujian membentuk moral dengan cara yang diremehkan oleh pemimpin
Orang perasan dengan cepat apabila pujian tersalah agih. Ahli pasukan yang membingkai masalah dan menangkap jawapan salah model yang kedengaran yakin, sambil melihat rakan sepasukan mendapat pujian yang sama kerana menerima draf AI bulat-bulat, ialah cara pantas untuk menghakis kepercayaan di tempat kerja. Tersalah atribusi secara terang-terangan beberapa kali dan orang terbaik anda senyap-senyap mengurangkan kerja yang sukar diukur, kerana sistem baru sahaja memberitahu mereka ia tidak dikira.
Mengapa Metrik Aktiviti yang Naif Gagal Lebih Teruk Berbanding Dahulu
Setiap organisasi sudah mempunyai satu versi metrik aktiviti: tiket ditutup, baris kod, perkataan yang didraf, panggilan dibuat. Ini sentiasa proksi yang tidak sempurna untuk nilai. AI memecahkan proksi itu dengan cara tertentu: ia menjadikan aktiviti itu sangat mudah dihasilkan dalam jumlah besar, sedangkan pertimbangan sebenar (adakah ini jawapan yang betul, adakah ia bertahan) kekal sesukar dahulu, atau lebih sukar, kerana kini seseorang perlu mengesahkan output dan bukan sekadar menghasilkannya.
Goodhart's Law sudah lama menunggu perkara ini
Goodhart's Law menyatakan bahawa ukuran yang menjadi sasaran berhenti menjadi ukuran yang baik, kerana orang menyusun semula usaha mereka sekitar apa sahaja yang diganjari metrik dan bukannya matlamat asas. Ini bukan baharu kepada AI: ia mekanisme yang sama di sebalik guru yang menyempitkan pengajaran kepada ujian piawai, atau ejen pusat panggilan yang memendekkan panggilan untuk mencapai sasaran masa pengendalian dan bukannya menyelesaikan masalah. Apa yang AI ubah ialah kelajuan manipulasi itu. Metrik yang dahulu memerlukan usaha sebenar untuk digembungkan (menulis lebih banyak kod, mendraf lebih banyak e-mel) kini boleh digembungkan dengan beberapa gesaan dan hampir tanpa pertimbangan, jadi jurang antara "nombor naik" dengan "nilai naik" melebar lebih pantas daripada yang mampu diselaraskan oleh kebanyakan sistem prestasi.
Apa yang dahulu diukur oleh metrik berbanding apa yang diganjari sekarang
| Metrik | Apa yang kelihatan diukur | Apa yang sebenarnya diganjari sekarang |
|---|---|---|
| Baris kod / commit | Output dan usaha kejuruteraan | Kod janaan AI yang panjang lebar dan commit berlebihan, tiada kaitan dengan perisian yang berfungsi |
| Tiket ditutup seminggu | Daya pemprosesan sokongan | Memecahkan tiket mudah yang dibantu AI kepada lebih banyak tiket dan bukannya menyelesaikan yang sukar |
| Perkataan atau dokumen yang didraf | Output penulisan | Jumlah teks draf AI, bukan pemikiran, penyuntingan atau pertimbangan di sebaliknya |
| Masa respons / kelajuan pusingan | Responsif dan tekun | Menghantar draf AI yang tidak disahkan dengan pantas, tanpa menangkap kes di mana ia salah |
| Kekerapan penggunaan alat AI ("penerimaan lesen") | Kemahiran dan semangat terhadap AI | Menekan terima berulang kali, tanpa mengesahkan, membetulkan atau menambah baik output |
| Mesyuarat atau mesej dihantar | Kolaborasi dan penglibatan | Jumlah mesej dibantu AI, yang boleh melonjak tajam tanpa perubahan pada keputusan yang dibuat |
Pengajaran yang sudah dipelajari dengan pahit oleh kejuruteraan perisian
Pasukan perisian mengalami masalah ini dahulu, kerana output kod ialah antara perkara terawal yang AI jadikan sangat mudah digembungkan. Jawapan industri, yang dirumuskan dalam kerangka SPACE, ialah menolak metrik aktiviti tunggal untuk individu dan mengukur produktiviti merentas lima dimensi (kepuasan, prestasi, aktiviti, komunikasi, kecekapan), yang kebanyakannya hanya masuk akal pada peringkat pasukan atau sistem. Penyelidikan DORA 2024 menyokong ini dengan penemuan yang tidak menyenangkan: penerimaan AI meningkatkan perasaan produktif pembangun individu, sambil menjejaskan secara ketara metrik peringkat pasukan yang meramalkan sama ada perisian dihantar dengan boleh dipercayai. Baca hanya angka individu dan AI kelihatan kemenangan yang tidak dipertikaikan. Baca angka peringkat pasukan di sebelahnya dan gambaran yang lebih jujur muncul, corak yang sama yang didokumenkan koleksi ini dalam paradoks produktiviti AI: isyarat individu dan hasil organisasi boleh bergerak ke arah bertentangan pada masa yang sama.
Pertukaran antara Peringkat Pasukan dengan Peringkat Individu
Ini pertukaran yang akhirnya dirundingkan oleh setiap pemimpin, sama ada mereka menamakannya atau tidak.
Pengukuran peringkat pasukan lebih jujur, tetapi tidak menjawab soalan gaji
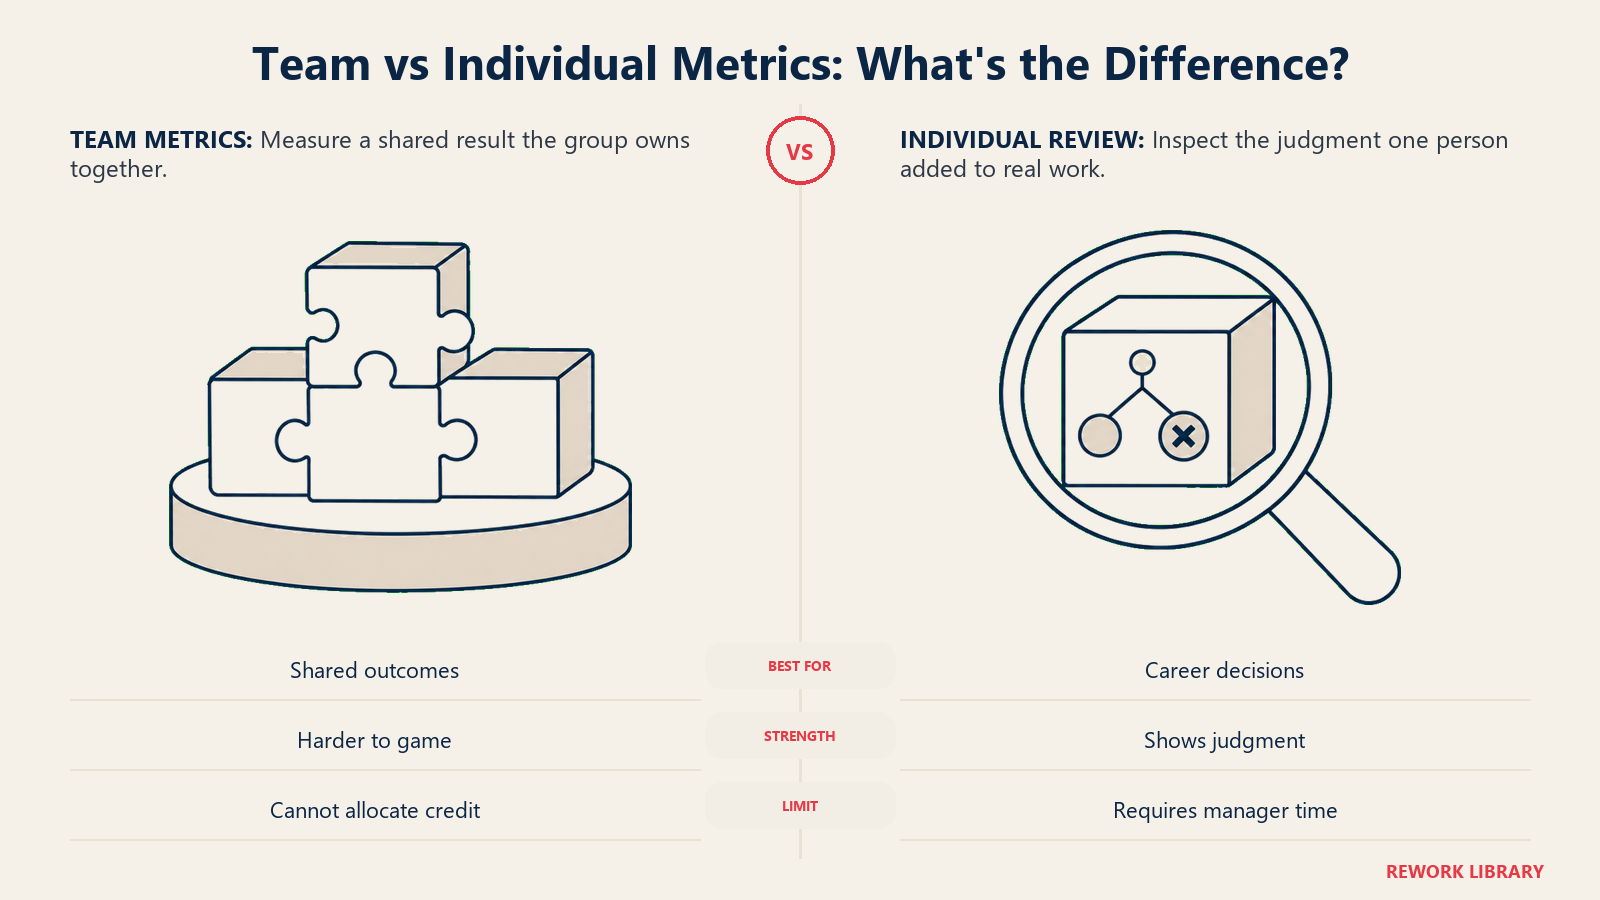
Mengukur hasil pada peringkat pasukan atau aliran kerja (adakah kumpulan ini menghantar ciri itu, adakah pelanggannya kurang berhenti) lebih tahan terhadap manipulasi, kerana lebih sukar bagi seseorang menggembungkan nombor yang dikongsi tanpa disedari seluruh pasukan. Ia juga sesuai dengan cara peranan gaya orkestrator berfungsi sekarang: sesuatu jawatan mungkin hampir keseluruhannya pertimbangan dan penyelarasan, tidak kelihatan kepada sebarang bilangan aktiviti, namun tetap menjadi sebab output pasukan baik. Kosnya ialah pengukuran peringkat pasukan, dengan sendirinya, tidak memberitahu anda siapa yang patut dinaikkan pangkat atau dibayar lebih.
Pengukuran peringkat individu ialah apa yang pemimpin mahukan, dan masalah yang lebih sukar
Setiap sistem pampasan dan kenaikan pangkat akhirnya memerlukan isyarat individu, kerana keputusan gaji dibuat tentang orang, bukan kumpulan. Tetapi semakin tepat anda cuba mengasingkan sumbangan marginal seseorang, semakin anda menemui masalah yang belum dirungkai sesiapa: orang yang membuat gesaan dengan baik, menangkap kesilapan model dan menghantar hasil hebat dalam dua puluh minit boleh kelihatan, pada sebarang metrik aktiviti, sama seperti orang yang menerima draf pertama, bernasib baik dan menghantar sesuatu yang sederhana. Kedua-dua prestasi itu tidak sama, dan kebanyakan sistem tidak dapat membezakannya tanpa manusia menyemak kerja sebenar.
Tiada penyelesaian yang bersih, dan berpura-pura sebaliknya lebih buruk
Pendirian yang jujur memerlukan kedua-dua lensa: metrik peringkat pasukan untuk keputusan yang menjejaskan seluruh kumpulan, dan semakan individu berasaskan pertimbangan untuk keputusan yang tidak dapat dielakkan tentang satu orang, seperti siapa yang dinaikkan pangkat. Cuba mengautomasikan lapisan individu itu dengan papan pemuka ialah tempat kebanyakan kerosakan berlaku.
Penunjuk Utama yang Masih Membawa Isyarat
Tiada satu pun yang berikut boleh dimanipulasi dengan cara pantas dan murah seperti bilangan aktiviti, kerana setiap satu memerlukan pemerhati benar-benar melihat kerja itu dan bukan mengiranya.
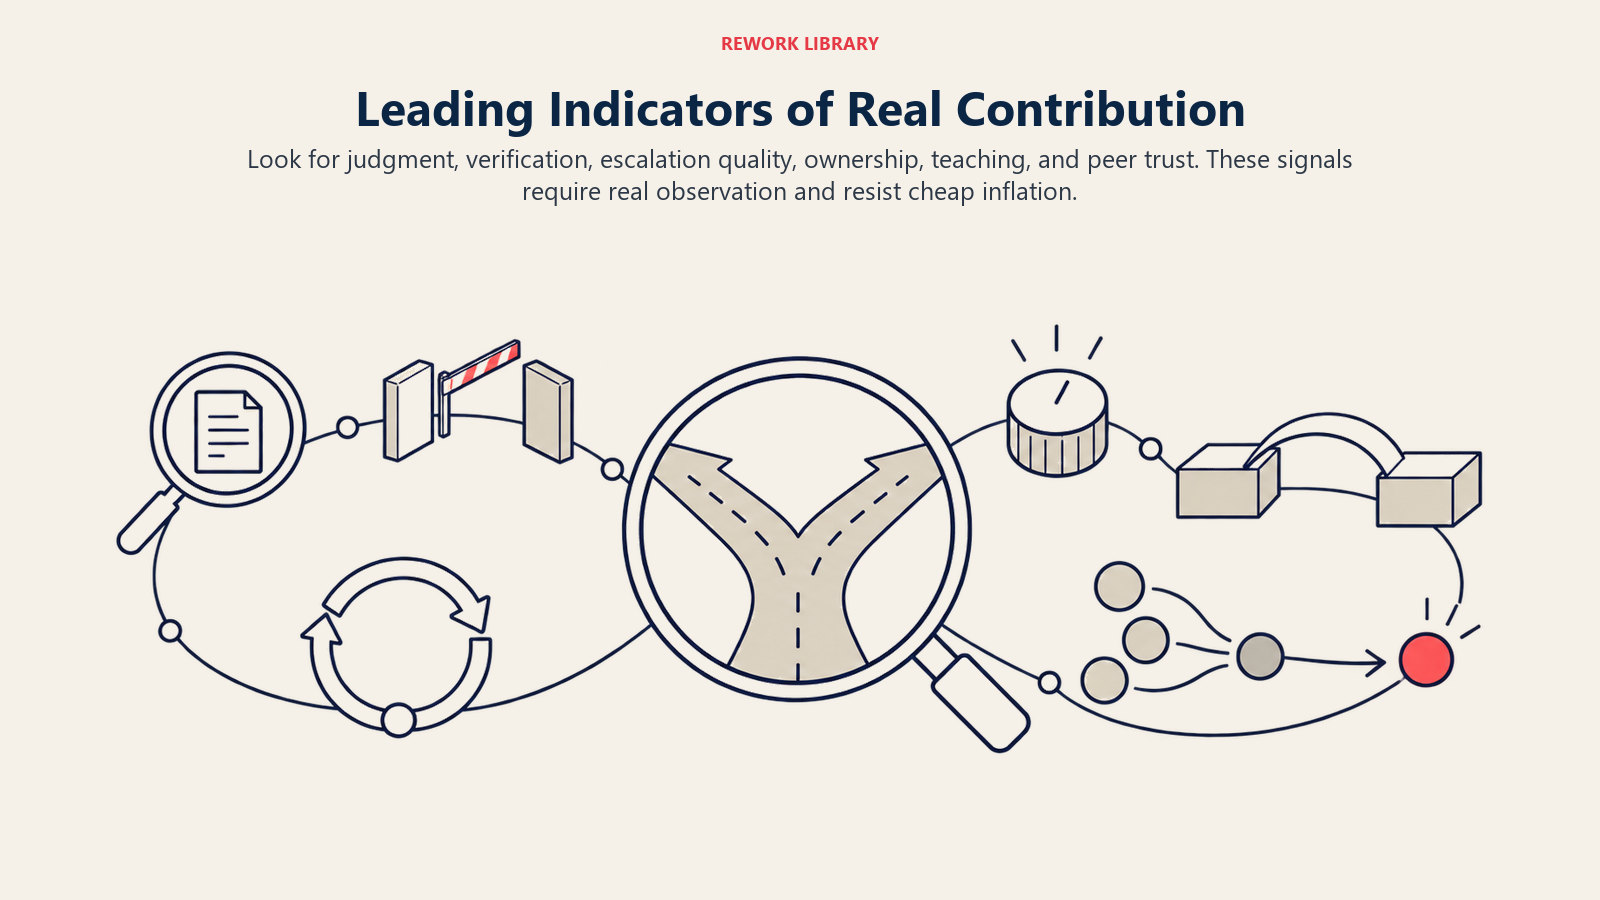
- Pertimbangan dalam kekaburan. Adakah orang ini membuat keputusan yang boleh dipertahankan dalam situasi yang tidak jelas diliputi oleh alat AI, playbook dan dasar? Perkara tunggal yang paling sukar dipalsukan, dan isyarat sumbangan sebenar yang paling jelas.
- Tingkah laku pengesahan. Adakah orang ini menyemak output AI berbanding sumber atau situasi sebenar pelanggan sebelum ia dihantar, atau meluluskannya begitu sahaja? Pengurus yang meluangkan tiga puluh minit menyemak sampel kerja sebenar nampak perkara ini serta-merta; tiada metrik automatik menangkapnya dengan baik. Masa menyemak itu juga ialah beban yang dinamakan kadar kerja dan burnout dalam era AI sebagai cukai pengesahan, kerja yang dicipta oleh kelajuan AI dan bukan dihapuskannya.
- Kualiti eskalasi. Adakah mereka tahu beza antara keputusan yang perlu dibuat dengan keputusan yang perlu dibangkitkan, dan membangkitkan yang betul pada masa yang betul? Mengeskalasi segala-galanya sama kegagalan pertimbangan seperti tidak mengeskalasi apa-apa.
- Pemilikan kitaran penuh. Adakah hasilnya bertahan beberapa minggu kemudian, setelah pelanggan atau pasukan hiliran benar-benar menggunakan apa yang dihasilkan orang ini? Lebih lambat diperhatikan daripada papan pemuka mingguan, dan jauh lebih sukar dipalsukan.
- Isyarat pengajaran dan penentukuran. Adakah bekerja dengan orang ini menjadikan orang lain lebih baik mengesan kesilapan AI, bukan sekadar lebih pantas menghasilkan output? Salah satu daripada kemahiran pelengkap yang semakin bernilai apabila AI menyerap kerja rutin.
- Kepercayaan melalui rakan sekerja. Apabila perkara yang kabur dan berisiko tinggi timbul, kepada siapa rakan sekerja menyalurkannya tanpa diminta? Isyarat sebenar yang kebanyakan sistem prestasi tidak pernah ambil peduli untuk direkodkan, walaupun semua orang sudah tahu jawapannya.
Semua ini memerlukan manusia sebenar melihat kerja sebenar, yang menjadikannya tahan terhadap manipulasi pantas yang dijemput oleh metrik aktiviti. Ia input kepada keputusan pertimbangan, bukan pengganti keputusan itu.
Perangkap Pengawasan: Mengapa Pemantauan Memakan Diri
Naluri, sebaik sahaja metrik aktiviti tidak lagi berkesan, selalunya ialah memantau dengan lebih ketat: rakaman skrin, pengelogan ketukan kekunci, penjejakan penggunaan AI. Penyelidikannya luar biasa konsisten, dan berita buruk untuk naluri itu.
Apa yang sebenarnya ditunjukkan oleh bukti
Meta-analisis 2023 yang meliputi 94 sampel dan lebih 23,000 pekerja tidak menemui bukti bahawa pemantauan prestasi elektronik meningkatkan prestasi. Ia mendapati peningkatan tekanan pekerja yang konsisten berkaitan dengan dipantau, tanpa mengira cara pelaksanaannya. Itu bertentangan dengan hujah jualan biasa untuk alat pemantauan: lebih banyak keterlihatan, lebih banyak akauntabiliti, output lebih baik. Data menunjukkan ia kebanyakannya hanya membeli tekanan tanpa peningkatan prestasi yang boleh diukur.
Kepercayaan ialah mekanisme sebenar, dan mahal untuk dibina semula
Penyelidikan yang sama mendapati ketelusan mengurangkan kerosakan: pemantauan yang didedahkan dan dikaitkan dengan jelas kepada matlamat yang sah kurang membawa mudarat berbanding pemantauan senyap atau bersifat hukuman. Tetapi "kurang mudarat" bukan "membantu". Sebaik sahaja orang percaya mereka diperhati untuk ditangkap dan bukan disokong, mereka mengelak sistem itu, tingkah laku yang sama yang didokumenkan MIT NANDA dalam projek perintis AI yang ditinggalkan sebaik sahaja ia menimbulkan geseran. Pengukuran gaya pengawasan menghasilkan mod kegagalan yang sama seperti metrik yang ingin dibaikinya: orang mengoptimumkan supaya kelihatan produktif di bawah apa yang diperhatikan, dengan mengorbankan pertimbangan yang menjadi tujuan sebenar. Ia juga menjejaskan keselamatan psikologi yang diperlukan pasukan untuk mengakui "saya tidak pasti output AI ini betul", iaitu tingkah laku yang wajar digalakkan.
Pendekatan Praktikal yang Boleh Dipertahankan
Tiada formula yang menyelesaikan ini dengan bersih. Pendekatan yang boleh dipertahankan menerima hakikat itu dan membina semakan yang tidak mampu disediakan oleh formula.
- Gunakan metrik peringkat pasukan atau hasil sebagai lalai untuk apa-apa yang membiayai keputusan yang luas. Kolam bonus dan pujian pelan hala tuju harus mengikut hasil yang menjadi tanggungjawab bersama kumpulan, bukan bilangan aktiviti yang boleh digembungkan AI secara tidak sekata.
- Simpan penilaian individu untuk semakan manusia sebenar terhadap kerja sebenar, mengikut kekerapan, bukan papan pemuka. Pengurus yang membaca sampel output sebenar, termasuk di mana seseorang menangkap atau terlepas kesilapan, mendapat gambaran yang jauh lebih tepat daripada sebarang metrik penggunaan.
- Jadikan bantuan AI sesuatu yang diisytiharkan orang, bukan disembunyikan. Jika "saya guna AI untuk mendraf ini, kemudian menyemak semula tiga bahagian ini" lazim dan selamat untuk dikatakan, perbualan tentang sumbangan menjadi jujur dengan cepat. Jika orang menyembunyikannya supaya kelihatan berkebolehan, seluruh sistem berjalan atas maklumat yang buruk.
- Anggap penunjuk utama sebagai input kepada perbualan, bukan skor automatik. Sebaik sahaja satu penunjuk diformalkan menjadi nombor yang menetapkan gaji, ia mula mengalami dinamik Goodhart's Law yang sama seperti metrik yang digantikannya.
- Audit manipulasi mengikut kekerapan tetap dan jangka sebarang metrik akan merosot. Apa sahaja yang anda ukur hari ini akan dioptimumkan dalam beberapa suku tahun. Bina semakan terhadap semakan itu ke dalam sistem.
- Asingkan "adakah kerja siap" daripada "adakah pertimbangan orang ini yang membezakan". Mencampuradukkan kedua-duanya ialah sebab tunggal paling lazim pengukuran sumbangan merosakkan kepercayaan secara senyap.
Jejak audit AI yang merekodkan apa yang dihasilkan model dan apa yang diubah atau diatasi seseorang memberi proses ini sesuatu yang konkrit untuk dirujuk, dan bukan ingatan atau laporan sendiri berbulan kemudian. Ia paling berkesan apabila dipasangkan dengan titik semakan human-in-the-loop yang dibina dalam aliran kerja itu sendiri, dan dengan pengurus yang aktif mengekalkan ketajaman pertimbangan mereka sendiri cukup untuk mengesan beza antara keputusan yang baik dengan keputusan yang bernasib baik.
Apa yang Tidak Diselesaikan Ini
Kejujuran intelektual lebih penting di sini daripada kesimpulan yang kemas. Ini benar-benar, sebahagiannya, belum selesai, dan beberapa perkara wajar dinyatakan dengan jelas dan bukan ditutup.
Tiada cara yang boleh dipercayai dan automatik hari ini untuk memisahkan "membuat gesaan dengan baik dan tahu rupa yang baik" daripada "mendapat draf pertama yang bernasib baik lalu menghantarnya", pada skala yang diperlukan kebanyakan organisasi. Penunjuk utama di atas memerlukan masa manusia, dan kebanyakan organisasi belum membelanjakan bajet untuknya, jadi ramai akan terus menggunakan metrik aktiviti yang murah dikumpul dan diketahui mengelirukan. Pengukuran ROI AI pada peringkat syarikat sudah cukup sukar; membawa ketegasan yang sama ke peringkat atribusi individu menggandakan kesukarannya. Dan bidang ini belum bertumpu: apa yang dikira atribusi adil dalam pasukan perisian, di mana SPACE dan DORA memberi sedekad contoh terdahulu, tidak serta-merta boleh dipindahkan ke jualan, undang-undang atau sokongan, di mana mod kegagalan cukup berbeza sehingga meminjam kerangka itu secara borong memberi jawapan salah dengan keyakinan tinggi.
Tiada satu pun daripada itu sebab untuk berhenti mengukur sumbangan. Ia sebab untuk memegang sebarang kaedah dengan longgar, mengekalkan manusia dalam gelung pada keputusan yang paling penting kepada sesuatu kerjaya, dan menganggap ini seperti cara koleksi ini menganggap setiap dakwaan AI-dan-kerja: masalah terbuka yang berkembang dengan bukti sebenar di sebalik bahagian yang telah mantap dan ketidakpastian sebenar pada selebihnya. Membina metrik budaya yang baik seiring kerja ini membantu, kerana pasukan yang sudah mengukur cara ia bekerja bersama mempunyai permulaan yang lebih baik, tetapi ia tidak menyiapkan kerja itu dengan sendirinya.
Satu ujian merungkai kebanyakan perkara ini sebelum menerima pakai sebarang metrik sumbangan: adakah anda selesa menerangkan, dengan lantang, kepada orang yang diukur, mengapa nombor ini mencerminkan pertimbangan mereka dan bukan pertimbangan model? Jika jawapan jujurnya tidak, metrik itu belum bersedia menyentuh gaji sesiapa, sebersih mana pun papan pemuka kelihatan.
Soalan Lazim tentang Mengukur Sumbangan dalam Kerja yang Dipertingkat oleh AI
Mengapakah mengukur sumbangan individu lebih sukar sekarang apabila AI terlibat?
Metrik aktiviti yang dahulu memerlukan usaha sebenar yang kelihatan untuk digembungkan (lebih banyak kod, lebih banyak dokumen, lebih banyak tiket ditutup) kini boleh dihasilkan dalam jumlah besar dengan pertimbangan yang minimum. Metrik boleh melonjak tajam sementara nilai yang benar-benar ditambah oleh orang itu kekal mendatar, yang memecahkan andaian yang menjadi pegangan kebanyakan sistem gaji dan kenaikan pangkat.
Apakah Goodhart's Law dan mengapa ia terpakai di sini?
Goodhart's Law, yang dipopularkan sebagai "when a measure becomes a target, it ceases to be a good measure," menggambarkan bagaimana mana-mana metrik yang dikaitkan dengan ganjaran dioptimumkan di sekitarnya dan bukan benar-benar diperbaiki. AI mempercepatkan ini kerana tingkah laku khusus yang dahulu menjadikan metrik bermakna (usaha sebenar, output sebenar) kini boleh digantikan dengan jumlah janaan AI jauh lebih pantas daripada yang mampu diselaraskan oleh sistem prestasi.
Haruskah syarikat mengukur sumbangan pada peringkat pasukan atau peringkat individu?
Kedua-duanya, untuk keputusan yang berbeza. Metrik peringkat pasukan atau hasil lebih sukar dimanipulasi dan sesuai untuk keputusan peringkat kumpulan seperti kolam bonus atau pujian pelan hala tuju. Penilaian peringkat individu masih perlu untuk keputusan gaji dan kenaikan pangkat tentang seseorang, tetapi ia memerlukan semakan manusia sebenar terhadap kerja sebenar, bukan papan pemuka aktiviti, kerana papan pemuka tidak dapat memisahkan pertimbangan yang baik daripada hasil bantuan AI yang bernasib baik.
Adakah perisian pemantauan atau pengawasan menyelesaikan masalah atribusi?
Bukti menunjukkan tidak. Meta-analisis terhadap 94 sampel dan lebih 23,000 pekerja tidak menemui bukti bahawa pemantauan prestasi elektronik meningkatkan prestasi individu, dan mendapati ia secara konsisten meningkatkan tekanan pekerja. Pemantauan juga boleh mendorong orang menyembunyikan penggunaan AI mereka atau mengelak sistem sepenuhnya, yang menjadikan sumbangan lebih sukar dinilai dengan jujur, bukan lebih mudah.
Apakah penunjuk utama sumbangan sebenar dalam kerja yang dipertingkat oleh AI?
Pertimbangan dalam kekaburan, tingkah laku pengesahan (menyemak output AI sebelum ia dihantar), kualiti eskalasi, pemilikan kitaran penuh terhadap sesuatu hasil selepas serah tugas, dan sama ada rakan sekerja menyalurkan kerja yang kabur atau berisiko tinggi kepada orang ini tanpa diminta. Ini memerlukan pemerhati manusia dan lebih tahan terhadap manipulasi pantas berbanding bilangan aktiviti.
Adakah masalah pengukuran ini sama seperti pengurusan prestasi?
Ia berkaitan tetapi berbeza. Ini tentang cara mengukur apa yang sebenarnya ditambah oleh seseorang kepada hasil yang dibantu AI. Pengurusan prestasi ialah proses lebih luas untuk menyemak, membimbing dan menilai orang dari semasa ke semasa, yang bergantung pada pengukuran tetapi turut melibatkan penetapan matlamat, maklum balas dan perbualan pembangunan yang melangkaui sebarang metrik tunggal.
Adakah sudah ada penyelesaian piawaian industri untuk masalah ini?
Belum. Kejuruteraan perisian mempunyai pemikiran paling matang di sini, melalui kerangka seperti SPACE dan penyelidikan DORA, tetapi malah bidang itu belum menyelesaikan atribusi individu dalam kerja dibantu AI sepenuhnya. Anggap sebarang kaedah semasa sebagai titik permulaan yang munasabah, bukan jawapan yang muktamad.

Co-Founder, Rework.com
On this page
- Fakta Utama
- Mengapa Atribusi Tiba-Tiba Penting Semula
- Gaji dan kenaikan pangkat masih menganggap output bersifat individu
- Akauntabiliti tidak hilang hanya kerana model membantu
- Pujian membentuk moral dengan cara yang diremehkan oleh pemimpin
- Mengapa Metrik Aktiviti yang Naif Gagal Lebih Teruk Berbanding Dahulu
- Goodhart's Law sudah lama menunggu perkara ini
- Apa yang dahulu diukur oleh metrik berbanding apa yang diganjari sekarang
- Pengajaran yang sudah dipelajari dengan pahit oleh kejuruteraan perisian
- Pertukaran antara Peringkat Pasukan dengan Peringkat Individu
- Pengukuran peringkat pasukan lebih jujur, tetapi tidak menjawab soalan gaji
- Pengukuran peringkat individu ialah apa yang pemimpin mahukan, dan masalah yang lebih sukar
- Tiada penyelesaian yang bersih, dan berpura-pura sebaliknya lebih buruk
- Penunjuk Utama yang Masih Membawa Isyarat
- Perangkap Pengawasan: Mengapa Pemantauan Memakan Diri
- Apa yang sebenarnya ditunjukkan oleh bukti
- Kepercayaan ialah mekanisme sebenar, dan mahal untuk dibina semula
- Pendekatan Praktikal yang Boleh Dipertahankan
- Apa yang Tidak Diselesaikan Ini