Bahasa Indonesia
Mengukur Kontribusi Individu dalam Pekerjaan yang Ditopang AI
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
Mengukur kontribusi individu dalam pekerjaan yang ditopang AI berarti memisahkan apa yang ditambahkan oleh penilaian dan keputusan satu orang pada output yang juga dibantu dihasilkan oleh sebuah model dan sebuah alur kerja. Hal ini penting untuk gaji, promosi, dan akuntabilitas, tetapi metrik aktivitas yang naif (tiket yang ditutup, kata yang disusun, penggunaan alat) ikut menggelembung karena AI dan tidak lagi mencerminkan kontribusi siapa pun. Belum ada organisasi yang menyelesaikan ini sepenuhnya. Pendekatan yang paling dapat dipertanggungjawabkan memadukan indikator awal, akuntabilitas tingkat tim, dan penilaian manusia yang jujur, bukan satu angka tunggal.
Fakta Utama
- Hukum Goodhart, dirumuskan oleh ekonom Charles Goodhart pada 1975 dan dipopulerkan sebagai "ketika sebuah ukuran menjadi target, ia berhenti menjadi ukuran yang baik" oleh antropolog Marilyn Strathern pada 1997, menggambarkan apa yang terjadi begitu metrik kontribusi dikaitkan dengan gaji (Wikipedia, "Goodhart's law").
- Laporan State of DevOps 2024 dari DORA memisahkan hasil individu (kepuasan, flow, produktivitas yang dilaporkan sendiri) dari metrik pengiriman tingkat tim dan sistem, dan menemukan bahwa adopsi AI meningkatkan produktivitas dan flow individu sambil secara terukur merugikan stabilitas dan throughput pengiriman di tingkat tim (DORA, Accelerate State of DevOps Report 2024).
- Kerangka SPACE memperingatkan agar produktivitas developer tidak direduksi menjadi hitungan aktivitas tunggal seperti baris kode atau commit, karena hitungan semacam itu mencampuradukkan aktivitas yang terlihat dengan output nyata dan mudah dipermainkan begitu dikaitkan dengan evaluasi individu (Forsgren et al., "The SPACE of Developer Productivity," ACM Queue, 2021).
- Sebuah meta-analisis terhadap 94 sampel independen dan 23.461 pekerja tidak menemukan bukti bahwa pemantauan kinerja elektronik meningkatkan kinerja individu, dan menemukan bahwa pemantauan itu secara konsisten meningkatkan stres pekerja apa pun cara penerapannya (Ravid et al., "A meta-analysis of the effects of electronic performance monitoring on work outcomes," Personnel Psychology, 2023).
- Tinjauan MIT NANDA terhadap lebih dari 300 penerapan AI di perusahaan menemukan bahwa 95 persen pilot AI generatif tidak menunjukkan dampak terukur pada laba rugi, kesenjangan yang oleh para peneliti ditelusuri ke faktor alur kerja yang tidak terukur, bukan upaya individu (MIT NANDA, "The GenAI Divide: State of AI in Business 2025", via Fortune).
Mengapa Atribusi Tiba-tiba Penting Lagi
Atribusi tidak pernah sepenuhnya terselesaikan sebelum AI. Seorang salesperson yang menutup deal yang dirintis rekannya, seorang engineer yang merilis fitur yang dispesifikasikan seorang desainer: pekerjaan selalu bersifat kolaboratif, dan pemberian kredit selalu sebagian merupakan keputusan subjektif. AI tidak menciptakan masalah ini. AI membuat masalah lama menjadi penopang beban di lebih banyak tempat sekaligus, karena hampir setiap output kini punya kontributor ketiga yang tidak bisa diwawancarai, dipromosikan, atau dimintai pertanggungjawaban.
Gaji dan promosi masih mengasumsikan output individu
Keputusan kompensasi dan promosi mengasumsikan bahwa hasil dapat ditelusuri kembali ke penilaian seseorang dengan keyakinan yang wajar. Asumsi itu makin goyah setiap kuartal. Jika seorang rep menulis lima belas email outbound dengan asisten AI dan menutup tiga deal, sementara rekannya tanpa asisten menulis lima secara manual dan menutup dua, kuartal siapa yang mencerminkan penilaian lebih baik? Sistem yang menjadi andalan kompensasi tidak dibangun untuk ambiguitas seperti ini, dan sebagian besar perusahaan tetap menjalankannya karena belum ada penggantinya yang jelas. Kompensasi dan keadilan di era AI membahas lebih jauh logika gaji apa yang sebenarnya rusak ketika output satu orang tampak seperti output lima orang, sepenuhnya berkat alatnya dan bukan penilaian di baliknya.
Akuntabilitas tidak hilang hanya karena sebuah model ikut membantu
Ketika keputusan berbantuan AI berujung salah (klausul kontrak yang terlewat, email pelanggan yang menjanjikan berlebihan, asumsi keliru yang tertanam dalam sebuah model), tetap harus ada yang bertanggung jawab. Anda tidak bisa menempatkan model bahasa dalam rencana perbaikan kinerja. Ini terkait tetapi berbeda dari mengukur kontribusi untuk imbalan: soalnya adalah siapa yang menjawab ketika sesuatu rusak, bukan siapa yang mendapat bonus ketika berhasil, dan keduanya makin sulit karena garis antara "orang itu yang memutuskan" dan "alat itu yang menghasilkan" sudah kabur.
Kredit membentuk moral dengan cara yang diremehkan pemimpin
Orang cepat menyadari ketika kredit dibagikan secara keliru. Anggota tim yang merumuskan masalah dan menangkap jawaban salah yang terdengar meyakinkan dari model, lalu melihat rekannya mendapat kredit setara karena menerima draf AI mentah-mentah, adalah cara cepat untuk mengikis kepercayaan di tempat kerja. Salah mengatribusikan secara terang-terangan beberapa kali, dan orang-orang terbaik Anda diam-diam mengurangi pekerjaan yang sulit diukur, karena sistem baru saja memberi tahu mereka bahwa itu tidak dihitung.
Mengapa Metrik Aktivitas yang Naif Gagal Lebih Parah dari Sebelumnya
Setiap organisasi sudah punya semacam metrik aktivitas: tiket yang ditutup, baris kode, kata yang disusun, panggilan yang dilakukan. Semua ini selalu merupakan proksi yang tidak sempurna untuk nilai. AI merusak proksi itu dengan cara tertentu: ia membuat aktivitas sangat mudah diproduksi dalam jumlah besar, sementara penilaian yang sebenarnya (apakah ini jawaban yang tepat, apakah bertahan diuji) tetap sesulit dulu, atau lebih sulit, karena kini seseorang harus memverifikasi output, bukan hanya memproduksinya.
Hukum Goodhart sudah lama menunggu momen ini
Hukum Goodhart menyatakan bahwa ukuran yang menjadi target berhenti menjadi ukuran yang baik, karena orang menata ulang upayanya di sekitar apa pun yang dihargai metrik itu, bukan tujuan yang mendasarinya. Ini bukan hal baru bagi AI: mekanismenya sama dengan guru yang menyempitkan pengajaran demi ujian standar, atau agen call center yang mempersingkat panggilan demi mencapai target handle time alih-alih menyelesaikan masalah. Yang diubah AI adalah kecepatan pemainannya. Metrik yang dulu memerlukan upaya nyata untuk digelembungkan (menulis lebih banyak kode, menyusun lebih banyak email) kini bisa digelembungkan dengan beberapa prompt dan nyaris tanpa penilaian, sehingga jarak antara "angkanya naik" dan "nilainya naik" melebar lebih cepat daripada kemampuan sebagian besar sistem kinerja untuk menyesuaikan diri.
Apa yang dulu diukur sebuah metrik vs. apa yang kini dihargainya
| Metrik | Apa yang tampak diukur | Apa yang sebenarnya dihargai sekarang |
|---|---|---|
| Baris kode / commit | Output dan upaya engineering | Kode buatan AI yang bertele-tele dan commit yang sengaja digemukkan, tidak terkait perangkat lunak yang berfungsi |
| Tiket yang ditutup per minggu | Throughput dukungan pelanggan | Memecah tiket mudah berbantuan AI menjadi lebih banyak tiket, bukan menyelesaikan yang sulit |
| Kata atau dokumen yang disusun | Output penulisan | Volume teks buatan AI, bukan pemikiran, penyuntingan, atau penilaian di baliknya |
| Waktu respons / kecepatan penyelesaian | Responsivitas dan ketekunan | Mengirim draf AI yang belum diverifikasi dengan cepat, bukan menangkap kasus ketika draf itu salah |
| Frekuensi penggunaan alat AI ("seat adoption") | Kecakapan dan antusiasme terhadap AI | Menekan terima berulang kali, bukan memverifikasi, mengoreksi, atau memperbaiki output |
| Rapat atau pesan terkirim | Kolaborasi dan keterlibatan | Volume pesan berbantuan AI, yang bisa melonjak tajam tanpa perubahan pada keputusan yang diambil |
Pelajaran yang sudah dipelajari rekayasa perangkat lunak dengan cara sulit
Tim perangkat lunak menghadapi masalah ini lebih dulu, karena output kode adalah salah satu hal pertama yang dibuat AI sangat mudah digelembungkan. Jawaban industri, yang dirumuskan dalam kerangka SPACE, adalah menolak metrik aktivitas tunggal untuk individu dan mengukur produktivitas di lima dimensi (kepuasan, kinerja, aktivitas, komunikasi, efisiensi), yang sebagian besar baru masuk akal di tingkat tim atau sistem. Riset DORA 2024 menguatkan ini dengan temuan yang tidak enak: adopsi AI meningkatkan seberapa produktif perasaan masing-masing developer, sambil secara terukur merugikan metrik tingkat tim yang memprediksi apakah perangkat lunak dirilis dengan andal. Baca hanya angka individunya dan AI tampak sebagai kemenangan yang tak diragukan. Baca angka tingkat tim di sampingnya dan gambaran yang lebih jujur muncul, pola yang sama yang didokumentasikan koleksi ini dalam paradoks produktivitas AI: sinyal individu dan hasil organisasi bisa bergerak berlawanan arah pada saat yang sama.
Pertukaran antara Tingkat Tim dan Tingkat Individu
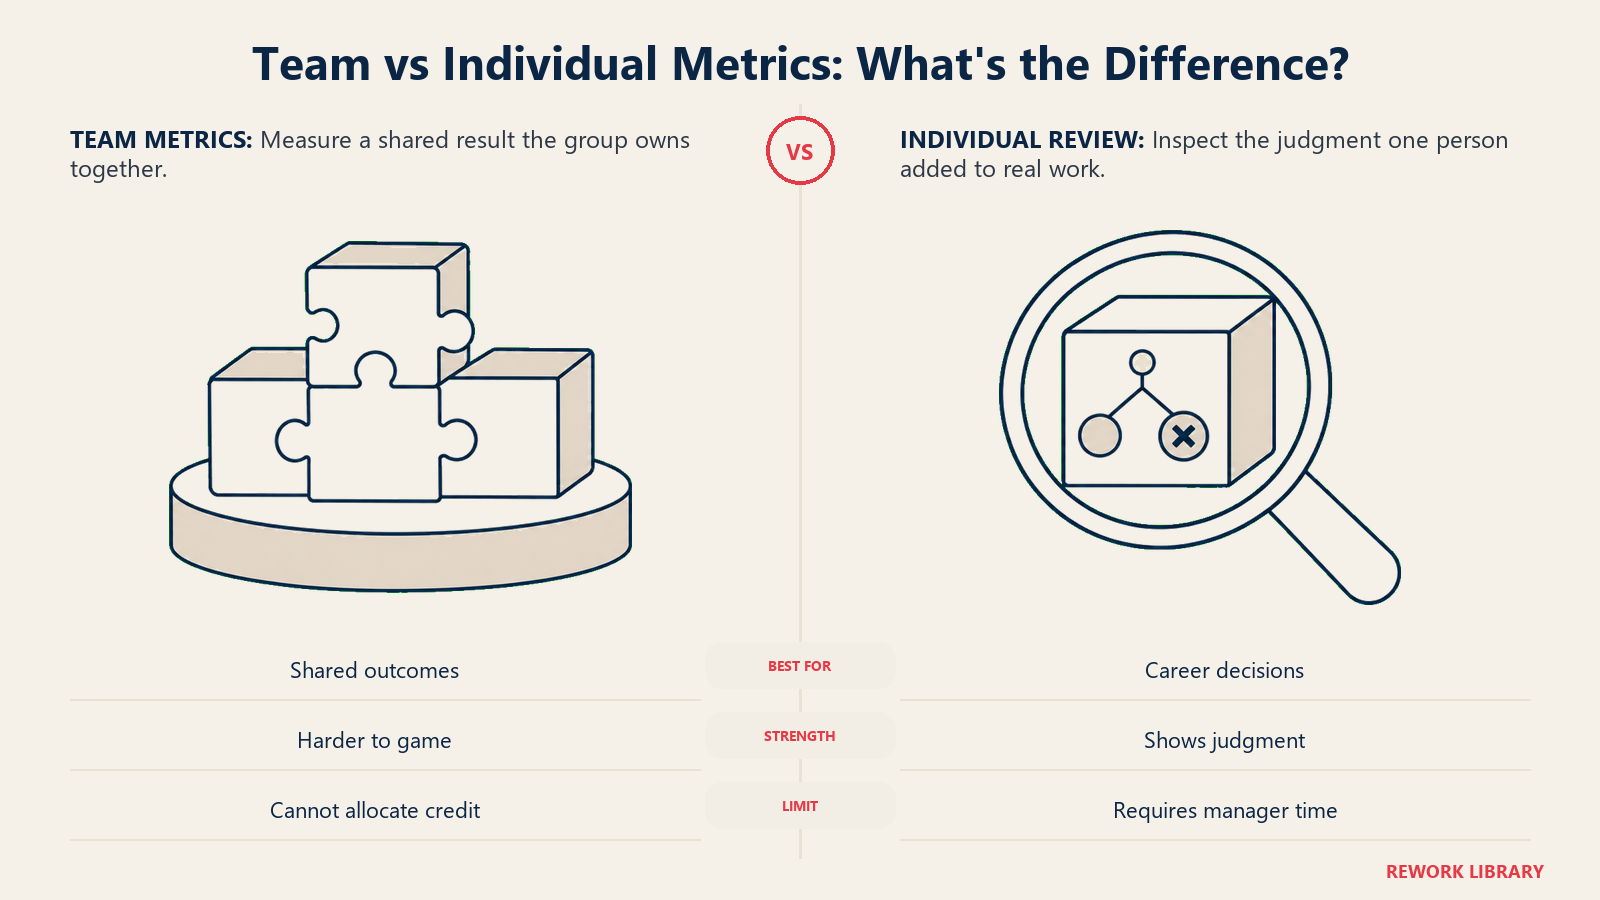
Inilah pertukaran yang akhirnya harus dinegosiasikan setiap pemimpin, disadari atau tidak.
Pengukuran tingkat tim lebih jujur, tetapi tidak menjawab pertanyaan gaji
Mengukur hasil di tingkat tim atau alur kerja (apakah pod ini merilis fiturnya, apakah pelanggannya lebih sedikit churn) lebih tahan terhadap permainan, karena sulit bagi satu orang menggelembungkan angka bersama tanpa disadari anggota tim lainnya. Ini juga sesuai dengan cara kerja peran bergaya orkestrator sekarang: sebuah pekerjaan bisa hampir seluruhnya berupa penilaian dan koordinasi, tak terlihat oleh hitungan aktivitas mana pun, namun tetap menjadi alasan output tim bagus. Kekurangannya, pengukuran tingkat tim tidak dengan sendirinya memberi tahu siapa yang harus dipromosikan atau dibayar lebih.
Pengukuran tingkat individu adalah yang diinginkan pemimpin, dan masalah yang lebih sulit
Setiap sistem kompensasi dan promosi pada akhirnya membutuhkan sinyal individu, karena keputusan gaji dibuat tentang orang, bukan pod. Namun semakin tepat Anda mencoba memisahkan kontribusi marginal satu orang, semakin Anda menabrak masalah yang belum dipecahkan siapa pun: orang yang menulis prompt dengan baik, menangkap kesalahan model, dan merilis hasil bagus dalam dua puluh menit bisa tampak, pada metrik aktivitas apa pun, identik dengan orang yang menerima draf pertama, beruntung, dan merilis sesuatu yang biasa saja. Kedua kinerja itu tidak sama, dan sebagian besar sistem tidak bisa membedakannya tanpa manusia yang meninjau pekerjaan sesungguhnya.
Tidak ada penyelesaian yang bersih, dan berpura-pura sebaliknya lebih buruk
Sikap yang jujur membutuhkan kedua lensa: metrik tingkat tim untuk keputusan yang memengaruhi seluruh kelompok, dan tinjauan individual berbasis penilaian untuk keputusan yang tak terelakkan menyangkut satu orang, seperti siapa yang dipromosikan. Mencoba mengotomatiskan lapisan individual itu dengan dashboard adalah tempat sebagian besar kerusakan terjadi.
Indikator Awal yang Masih Membawa Sinyal
Tidak satu pun dari yang berikut bisa dipermainkan secepat dan semurah hitungan aktivitas, karena masing-masing mengharuskan pengamat benar-benar melihat pekerjaannya, bukan sekadar menghitungnya.
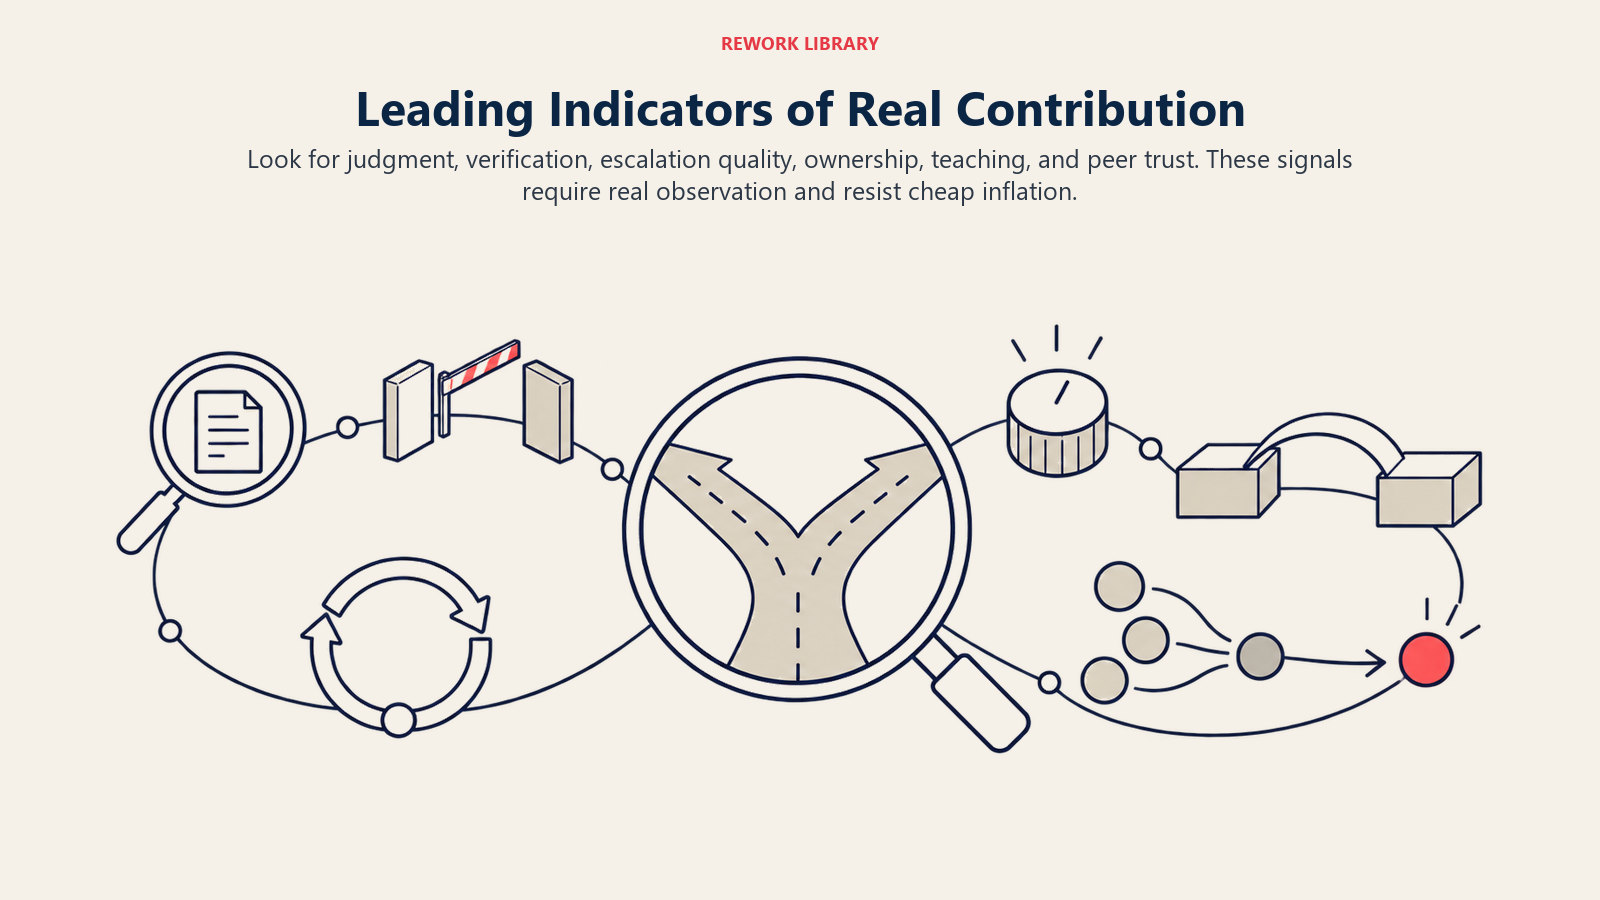
- Penilaian dalam situasi yang ambigu. Apakah orang ini mengambil keputusan yang dapat dipertanggungjawabkan dalam situasi yang tidak jelas dicakup oleh alat AI, playbook, dan kebijakan? Hal tersulit untuk dipalsukan, dan sinyal paling jelas dari kontribusi nyata.
- Perilaku verifikasi. Apakah orang ini memeriksa output AI terhadap sumbernya atau situasi nyata pelanggan sebelum dikirim, atau meloloskannya begitu saja? Manajer yang menghabiskan tiga puluh menit meninjau contoh pekerjaan nyata langsung melihat ini; tidak ada metrik otomatis yang menangkapnya dengan baik. Waktu pemeriksaan itu juga beban yang disebut tempo dan burnout di era AI sebagai pajak verifikasi, pekerjaan yang diciptakan oleh kecepatan AI, bukan dihilangkan olehnya.
- Kualitas eskalasi. Apakah mereka tahu bedanya antara keputusan yang harus diambil sendiri dan yang harus diangkat ke atas, dan mengangkat yang tepat pada waktu yang tepat? Mengeskalasi segalanya sama gagalnya dalam hal penilaian dengan tidak mengeskalasi apa pun.
- Kepemilikan sepanjang siklus penuh. Apakah hasilnya bertahan berminggu-minggu kemudian, setelah pelanggan atau tim hilir benar-benar menggunakan apa yang dihasilkan orang ini? Lebih lambat diamati daripada dashboard mingguan, dan jauh lebih sulit dipalsukan.
- Sinyal pengajaran dan kalibrasi. Apakah bekerja dengan orang ini membuat orang lain lebih jeli menemukan kesalahan AI, bukan hanya lebih cepat menghasilkan output? Salah satu dari keterampilan pelengkap yang makin bernilai seiring AI menyerap pekerjaan rutin.
- Kepercayaan yang diarahkan oleh rekan. Ketika muncul hal yang ambigu dan berisiko tinggi, kepada siapa rekan kerja menyerahkannya tanpa diminta? Sinyal nyata yang tidak pernah repot ditangkap oleh sebagian besar sistem kinerja, padahal semua orang sudah tahu jawabannya.
Semua ini memerlukan manusia sungguhan yang melihat pekerjaan sungguhan, itulah sebabnya semuanya tahan terhadap permainan cepat yang diundang oleh metrik aktivitas. Semua ini adalah masukan untuk sebuah keputusan penilaian, bukan penggantinya.
Jebakan Pengawasan: Mengapa Pemantauan Menjadi Bumerang
Naluri, begitu metrik aktivitas berhenti bekerja, sering kali adalah memantau lebih ketat: perekaman layar, pencatatan ketikan, pelacakan penggunaan AI. Risetnya luar biasa konsisten, dan kabar buruk bagi naluri itu.
Apa yang sebenarnya ditunjukkan bukti
Meta-analisis 2023 yang mencakup 94 sampel dan lebih dari 23.000 pekerja tidak menemukan bukti bahwa pemantauan kinerja elektronik meningkatkan kinerja. Ia memang menemukan peningkatan stres pekerja yang konsisten terkait dengan pemantauan, apa pun cara penerapannya. Itu kebalikan dari tawaran biasa alat pemantauan: lebih banyak visibilitas, lebih banyak akuntabilitas, output lebih baik. Data menunjukkan pemantauan sebagian besar hanya membeli stres tanpa peningkatan kinerja yang terukur.
Kepercayaan adalah mekanisme sebenarnya, dan mahal untuk dibangun kembali
Riset yang sama menemukan bahwa transparansi meredam kerusakan: pemantauan yang diungkapkan dan jelas terkait tujuan yang sah lebih sedikit merugikan daripada pemantauan yang diam-diam atau bersifat menghukum. Namun "lebih sedikit merugikan" bukan "membantu". Begitu orang percaya mereka diawasi untuk dijebak dan bukan didukung, mereka mencari jalan memutar, perilaku yang sama yang didokumentasikan MIT NANDA pada pilot AI yang ditinggalkan begitu menimbulkan gesekan. Pengukuran bergaya pengawasan menghasilkan mode kegagalan yang sama dengan metrik yang hendak diperbaikinya: orang mengoptimalkan tampilan produktif di bawah hal yang diawasi, dengan mengorbankan penilaian yang sebenarnya menjadi tujuan. Ia juga bertentangan dengan rasa aman psikologis yang dibutuhkan tim untuk mengakui "saya tidak yakin output AI ini benar", yang justru perilaku yang patut didorong.
Pendekatan Praktis yang Dapat Dipertanggungjawabkan
Tidak ada rumus yang menyelesaikan ini dengan bersih. Pendekatan yang dapat dipertanggungjawabkan menerima hal itu dan membangun pemeriksaan yang tidak bisa disediakan oleh rumus.
- Jadikan metrik tingkat tim atau hasil sebagai default untuk apa pun yang mendanai keputusan luas. Kolam bonus dan kredit roadmap harus mengikuti hasil yang menjadi tanggung jawab bersama kelompok, bukan hitungan aktivitas yang bisa digelembungkan AI secara tidak merata.
- Sediakan penilaian individual untuk tinjauan manusia atas pekerjaan nyata, dengan jadwal rutin, bukan lewat dashboard. Manajer yang membaca sampel output nyata, termasuk saat seseorang menangkap atau melewatkan kesalahan, mendapat gambaran jauh lebih akurat daripada metrik penggunaan mana pun.
- Jadikan bantuan AI sesuatu yang dinyatakan orang, bukan disembunyikan. Jika "saya memakai AI untuk menyusun ini, lalu merevisi tiga bagian ini" adalah hal normal dan aman diucapkan, percakapan tentang kontribusi cepat menjadi jujur. Jika orang menyembunyikannya agar terlihat cakap, seluruh sistem berjalan di atas informasi yang buruk.
- Perlakukan indikator awal sebagai masukan percakapan, bukan skor otomatis. Begitu salah satunya diformalkan menjadi angka yang menentukan gaji, ia mulai mengalami dinamika Hukum Goodhart yang sama dengan metrik yang digantikannya.
- Audit permainan metrik dengan jadwal tetap dan harapkan metrik apa pun akan meluruh. Apa pun yang Anda ukur hari ini akan dioptimalkan dalam beberapa kuartal. Bangun peninjauan atas peninjauan itu ke dalam sistem.
- Pisahkan "apakah pekerjaannya selesai" dari "apakah penilaian orang ini yang menjadi pembeda". Mencampurkan keduanya adalah alasan paling umum mengapa pengukuran kontribusi diam-diam merusak kepercayaan.
Jejak audit AI yang mencatat apa yang dihasilkan model dan apa yang diubah atau ditimpa seseorang memberi proses ini sesuatu yang konkret untuk dijadikan pegangan, alih-alih ingatan atau laporan diri berbulan-bulan kemudian. Hasilnya paling baik jika dipadukan dengan titik tinjauan human-in-the-loop yang dibangun ke dalam alur kerja itu sendiri, dan dengan manajer yang aktif menjaga ketajaman penilaian mereka sendiri agar mampu melihat beda antara keputusan yang bagus dan keputusan yang kebetulan beruntung.
Apa yang Tidak Diselesaikan Pendekatan Ini
Kejujuran intelektual lebih penting di sini daripada kesimpulan yang rapi. Ini sungguh-sungguh sebagian belum terpecahkan, dan beberapa hal lebih baik diucapkan terus terang daripada ditutup-tutupi.
Saat ini tidak ada cara otomatis yang andal untuk memisahkan "menulis prompt dengan baik dan tahu seperti apa yang bagus" dari "kebetulan dapat draf pertama yang bagus lalu mengirimkannya", dalam skala yang dibutuhkan sebagian besar organisasi. Indikator awal di atas membutuhkan waktu manusia, dan sebagian besar organisasi belum menganggarkannya, sehingga banyak yang akan terus mengandalkan metrik aktivitas yang murah dikumpulkan dan diketahui menyesatkan. Pengukuran ROI AI di tingkat perusahaan saja sudah cukup sulit; menurunkan ketelitian yang sama ke atribusi individu melipatgandakan kesulitannya. Dan bidang ini belum bersepakat: apa yang dianggap atribusi adil di tim perangkat lunak, tempat SPACE dan DORA memberi satu dekade praktik terdahulu, tidak otomatis berlaku untuk penjualan, hukum, atau dukungan pelanggan, yang mode kegagalannya cukup berbeda sehingga meminjam kerangka itu mentah-mentah menghasilkan jawaban yang salah dengan keyakinan tinggi.
Tidak satu pun dari itu merupakan alasan untuk berhenti mengukur kontribusi. Itu alasan untuk memegang metode apa pun dengan longgar, menjaga manusia tetap terlibat dalam keputusan yang paling berpengaruh pada karier seseorang, dan memperlakukan hal ini seperti koleksi ini memperlakukan setiap klaim tentang AI dan pekerjaan: masalah terbuka yang terus berkembang, dengan bukti nyata di balik bagian yang sudah mapan dan ketidakpastian nyata di sisanya. Membangun metrik budaya yang baik berdampingan dengan upaya ini membantu, karena tim yang sudah mengukur cara mereka bekerja sama punya awalan yang lebih baik, tetapi itu tidak menuntaskan pekerjaannya sendirian.
Satu ujian memangkas sebagian besar persoalan ini sebelum mengadopsi metrik kontribusi apa pun: apakah Anda nyaman menjelaskan, secara lisan, kepada orang yang diukur, mengapa angka ini mencerminkan penilaian mereka dan bukan penilaian model? Jika jawaban jujurnya tidak, metrik itu belum siap menyentuh gaji siapa pun, sebersih apa pun tampilan dashboardnya.
Pertanyaan yang Sering Diajukan tentang Mengukur Kontribusi dalam Pekerjaan yang Ditopang AI
Mengapa mengukur kontribusi individu lebih sulit sekarang setelah AI terlibat?
Metrik aktivitas yang dulu memerlukan upaya nyata dan terlihat untuk digelembungkan (lebih banyak kode, lebih banyak dokumen, lebih banyak tiket ditutup) kini bisa diproduksi dalam jumlah besar dengan penilaian minimal. Metrik bisa melonjak tajam sementara nilai yang sebenarnya ditambahkan orang itu tetap datar, yang meruntuhkan asumsi yang menjadi dasar sebagian besar sistem gaji dan promosi.
Apa itu Hukum Goodhart dan mengapa berlaku di sini?
Hukum Goodhart, yang dipopulerkan sebagai "ketika sebuah ukuran menjadi target, ia berhenti menjadi ukuran yang baik," menggambarkan bagaimana metrik apa pun yang dikaitkan dengan imbalan akan dioptimalkan secara akal-akalan alih-alih benar-benar diperbaiki. AI mempercepat hal ini karena perilaku spesifik yang dulu membuat sebuah metrik bermakna (upaya nyata, output nyata) kini dapat digantikan dengan volume buatan AI jauh lebih cepat daripada kemampuan sistem kinerja untuk menyesuaikan diri.
Haruskah perusahaan mengukur kontribusi di tingkat tim atau tingkat individu?
Keduanya, untuk keputusan yang berbeda. Metrik tingkat tim atau hasil lebih sulit dipermainkan dan cocok untuk keputusan tingkat kelompok seperti kolam bonus atau kredit roadmap. Penilaian tingkat individu tetap diperlukan untuk keputusan gaji dan promosi tentang satu orang, tetapi membutuhkan tinjauan manusia atas pekerjaan nyata, bukan dashboard aktivitas, karena dashboard tidak dapat memisahkan penilaian yang baik dari hasil berbantuan AI yang kebetulan beruntung.
Apakah perangkat lunak pemantauan atau pengawasan menyelesaikan masalah atribusi?
Bukti mengatakan tidak. Meta-analisis terhadap 94 sampel dan lebih dari 23.000 pekerja tidak menemukan bukti bahwa pemantauan kinerja elektronik meningkatkan kinerja individu, dan menemukan bahwa pemantauan itu secara konsisten meningkatkan stres pekerja. Pemantauan juga dapat mendorong orang menyembunyikan penggunaan AI mereka atau sepenuhnya mencari jalan memutar dari sistem, yang membuat kontribusi lebih sulit dinilai secara jujur, bukan lebih mudah.
Apa saja indikator awal kontribusi nyata dalam pekerjaan yang ditopang AI?
Penilaian dalam situasi ambigu, perilaku verifikasi (memeriksa output AI sebelum dikirim), kualitas eskalasi, kepemilikan sepanjang siklus penuh atas sebuah hasil setelah serah terima, dan apakah rekan kerja menyerahkan pekerjaan ambigu atau berisiko tinggi kepada orang ini tanpa diminta. Semua ini memerlukan pengamat manusia dan lebih tahan terhadap permainan cepat dibanding hitungan aktivitas.
Apakah masalah pengukuran ini sama dengan manajemen kinerja?
Terkait tetapi berbeda. Ini tentang cara mengukur apa yang sebenarnya ditambahkan satu orang pada hasil berbantuan AI. Manajemen kinerja adalah proses yang lebih luas untuk meninjau, membimbing, dan menilai orang dari waktu ke waktu, yang memanfaatkan pengukuran tetapi juga melibatkan penetapan sasaran, umpan balik, dan percakapan pengembangan yang melampaui metrik tunggal mana pun.
Apakah sudah ada solusi standar industri untuk masalah ini?
Belum. Rekayasa perangkat lunak memiliki pemikiran paling matang di sini, lewat kerangka seperti SPACE dan riset DORA, tetapi bahkan bidang itu belum sepenuhnya menyelesaikan atribusi individu dalam pekerjaan berbantuan AI. Perlakukan metode apa pun saat ini sebagai titik awal yang wajar, bukan jawaban yang sudah final.

Co-Founder, Rework.com
On this page
- Fakta Utama
- Mengapa Atribusi Tiba-tiba Penting Lagi
- Gaji dan promosi masih mengasumsikan output individu
- Akuntabilitas tidak hilang hanya karena sebuah model ikut membantu
- Kredit membentuk moral dengan cara yang diremehkan pemimpin
- Mengapa Metrik Aktivitas yang Naif Gagal Lebih Parah dari Sebelumnya
- Hukum Goodhart sudah lama menunggu momen ini
- Apa yang dulu diukur sebuah metrik vs. apa yang kini dihargainya
- Pelajaran yang sudah dipelajari rekayasa perangkat lunak dengan cara sulit
- Pertukaran antara Tingkat Tim dan Tingkat Individu
- Pengukuran tingkat tim lebih jujur, tetapi tidak menjawab pertanyaan gaji
- Pengukuran tingkat individu adalah yang diinginkan pemimpin, dan masalah yang lebih sulit
- Tidak ada penyelesaian yang bersih, dan berpura-pura sebaliknya lebih buruk
- Indikator Awal yang Masih Membawa Sinyal
- Jebakan Pengawasan: Mengapa Pemantauan Menjadi Bumerang
- Apa yang sebenarnya ditunjukkan bukti
- Kepercayaan adalah mekanisme sebenarnya, dan mahal untuk dibangun kembali
- Pendekatan Praktis yang Dapat Dipertanggungjawabkan
- Apa yang Tidak Diselesaikan Pendekatan Ini