コンバージョン率最適化のためのAI活用:テスト、パーソナライゼーション、インサイト
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
AIによるコンバージョン率最適化(CRO)とは、機械学習と生成AIを使って、訪問者がどこで離脱するかを見つけ、テストする変更を提案して優先順位をつけ、バリエーション間でトラフィックを配分し、訪問者ごとにページを調整することです。CROの前半、つまり問題を見つけて仮説を立てる部分を速めてくれます。後半は変えません。変更が実際にコンバージョンを高めたかどうかは、今も統計の問題であり、AIツールは、自分自身を欺きにくくするどころか、欺きやすくしてしまうことがあります。
これが本ガイド全体を貫く主題です。うまく使えば、AIは「何かおかしい」から「実施する価値のあるテストがある」までのサイクルを短縮します。不注意に使えば、自信満々の「勝者」の山を生み出しますが、それらは公開後に消えていきます。基礎が初めての方は、まずSaaS向けのコンバージョン率最適化やECのコンバージョン率最適化の基本から始め、そのうえでAIの層について本記事に戻ってきてください。
CROのサイクルにおけるAIの位置づけ
CROプログラムはループです。行動を観察し、仮説を立て、テストし、学び、繰り返します。AIはこのループの異なる時点で役立ち、その時点ごとにリスクの大きさが異なります。
| CROの段階 | AIが行うこと | 誤った場合のリスク |
|---|---|---|
| 観察 | セッションをクラスタ化し、録画を要約し、レイジクリックや行き止まりに印をつける | 低:結果は人がレビューします |
| 仮説立案 | アナリティクス、アンケート、レビューからテスト案を下書きし、順位付けする | 低:アイデアは安価です |
| バリエーション作成 | 見出し、コピー、レイアウトの案を下書きする | 中:弱い、またはブランドに合わないバリエーションはトラフィックを無駄にします |
| テストの実行 | トラフィックを配分し(バンディット)、多変量の組み合わせを実行する | 高:誤った統計は、偽の勝者を生みます |
| パーソナライズ | セグメントごと、または個人ごとにコンテンツを選ぶ | 中:気味悪い、または的外れな体験になり、測定も困難です |
| 学習 | 結果を要約し、次の施策を提案する | 中:要約が確実性を誇張することがあります |
注目すべきパターンがあります。AIが最も安全なのは、訪問者に何かが届く前に人がその出力をレビューする場面で、最もリスクが高いのは、ライブのトラフィックについてAIが判断を下す場面です。本ガイドの残りは、この傾斜に沿って進みます。
問題を見つける:セッション分析と行動インサイト
多くのCROプログラムは、ある問いから始まります。人はどこで離れ、それはなぜなのか。定量的なアナリティクスは「どこで」を教えてくれます。セッションの録画、ヒートマップ、アンケート、サポートチケットは「なぜ」を示唆します。問題は常にボリュームでした。1万本の録画を見る人はいません。
AIは3つの形で役立ちます。
- セッションのクラスタリング。 モデルは録画を行動パターンでグループ化します。たとえば、料金ページまでスクロールして離脱する訪問者や、リンクではない要素を何度もクリックする訪問者です。無作為のサンプルではなく、各クラスターから数本ずつ見れば済みます。
- 摩擦の検知。 ツールは、レイジクリック、フォーム項目の繰り返しエラー、行ったり来たりの遷移、放棄されたカートを、問題がありそうな箇所として示します。
- 定性情報の要約。 言語モデルは、アンケートの自由記述、チャットの書き起こし、レビュー、チケットの文章を読み、テーマごとにグループ化します。「送料が無料かどうか分からない」というコメントが300件出てくれば、探さなくても仮説が手に入ります。
これらはすべて、判決ではなく手がかりとして扱ってください。クラスターはデータ上のパターンにすぎず、パターンは偶然の一致や、セッションのサンプリング方法による人為的な産物であることがあります。チームの誠実さを保つルールがあります。AIが浮かび上がらせたインサイトは、そのままサイトに反映する変更ではなく、すべてテストされる仮説にすることです。良い行動データは、そもそも何を収集するかにも左右されます。これは、AIマーケティングのためのファーストパーティデータで扱っています。
仮説の生成と優先順位付け
有用な仮説には、問題、変更、期待される効果、指標が含まれます。「モバイルの訪問者は保証が目に入らないので、ボタンの上に移せば購入手続きの開始が増える」はテストできます。「ページを良くする」はテストできません。
ここでは、生成AIは量が得意です。アナリティクスの発見、アンケートのテーマ、ページの現在のコピーとオーディエンスを渡し、その構造で20個の仮説を頼みます。そのうえで、しっかり絞り込みます。モデルは、一般的なベストプラクティス(緊急性を加える、ソーシャルプルーフを加える)を提案しがちですが、それが自社のページに合うかは分かりません。また、自社の制約のうち、どれが本当のものかをモデルは知り得ません。
優先順位付けには、ICEやPIEなどのフレームワークを使い、インパクト、確信度、労力でアイデアをスコアリングするチームがよくあります。AIは第一次のスコアを埋められますが、「インパクト」の数字は慎重に見てください。実際のトラフィックと実際のベースラインに結びついていなければ、それは推測です。モデルのより良い使い方は、並べ替えの補助として使い、最終的な順序は人が決めることです。現実的にいくつのテストを実行できるかを考えてください。月に数千訪問のページでは、多くの並行実験は支えられないため、トラフィックの予算自体が優先順位付けの入力になります。そのバックログの組み立て方は、A/Bテストのフレームワークで扱っています。
テスト手法:A/B、多変量、バンディット
AIベンダーはこれらの手法の呼び名をあいまいにするため、区別しておくと役立ちます。
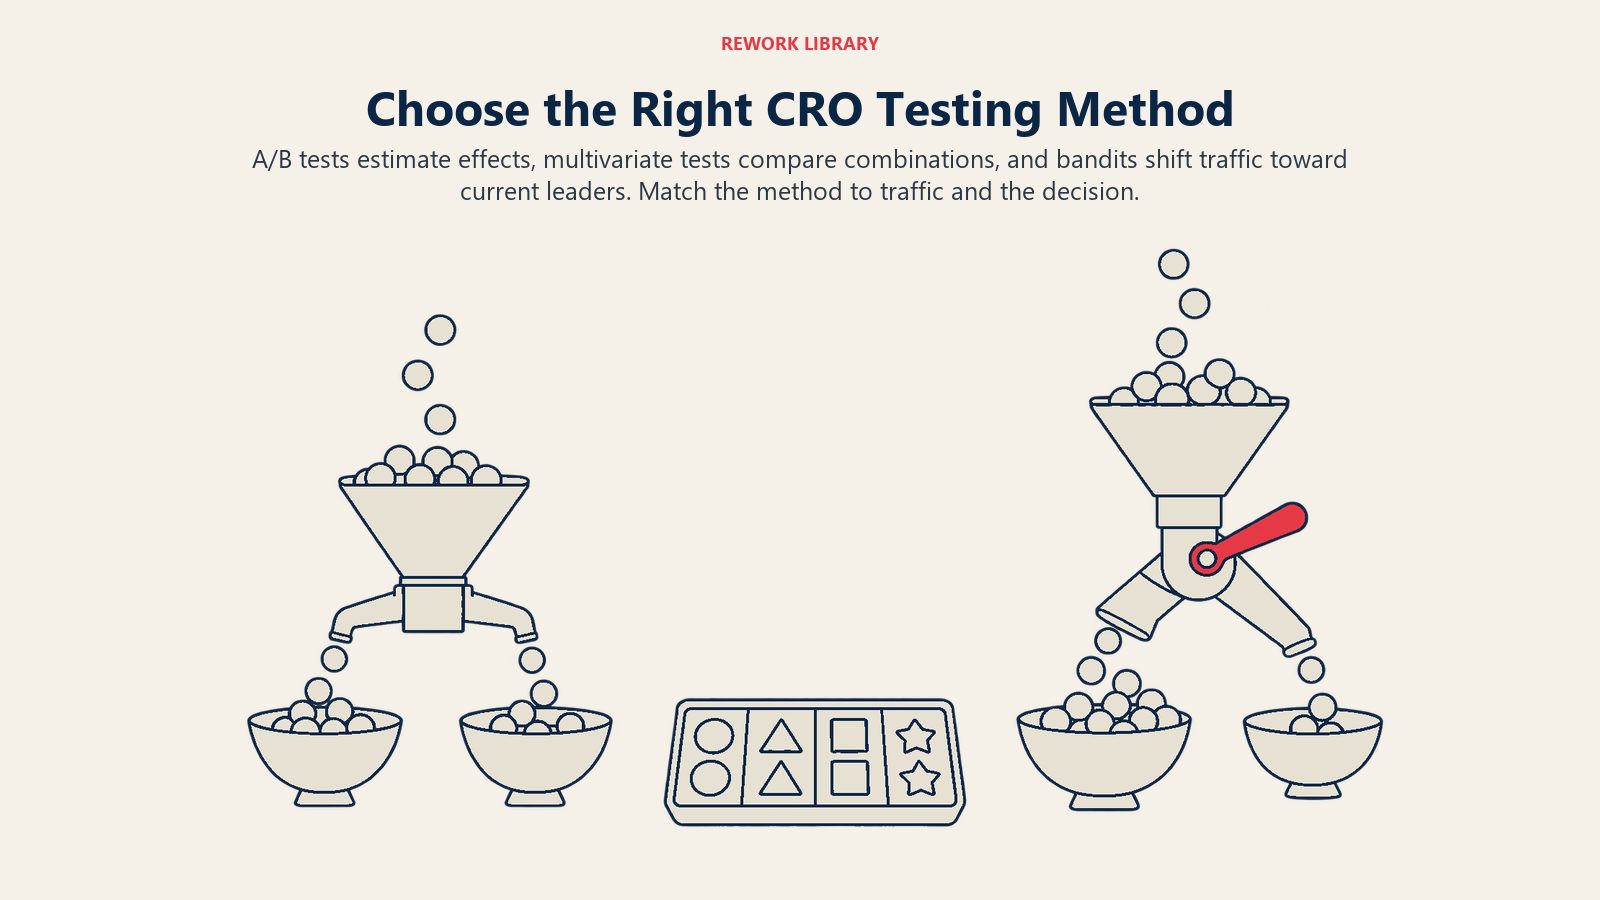
A/Bテストは、コントロールと1つ以上のバリエーションの間で、差を測定できるだけの期間、トラフィックを均等に分けます。目的は、効果についての信頼できる推定値を得ることです。
多変量テストは、複数の要素(見出し、画像、ボタン)を同時に変え、すべての組み合わせを測定します。どの要素が重要かを示せますが、トラフィックがすべての組み合わせに分割されるため、単純なA/Bテストよりはるかに多くのトラフィックが必要です。トラフィックの少ないページでは、たいてい何も有意に達しません。
バンディットテストは、データが入ってくるにつれて配分を調整し、勝っているように見えるバリエーションにより多くのトラフィックを送ります。ここでは、機械学習がテストそのものの中で実際に働きます。
テストソフトウェアを販売するWingifyは、このトレードオフを次のように説明しています。従来のA/Bテストは、コンバージョン率を正確に測ることが目的なので、実行期間中ずっと探索モードにとどまります。一方、多腕バンディットは探索と活用を並行して行い、現時点で最も良く見えるバリエーションにトラフィックの大半を寄せていきます(VWO / Wingifyによる多腕バンディットの解説)。同じ記事は、それぞれが向く場面も挙げています。A/Bテストは、事後のセグメント分析も含め、すべてのバリエーションの効果に確信が必要な意思決定に向いています。バンディットは、コンバージョンを1件失うごとの損失が大きい場合、期間が短い場合(期間限定のオファー、ニュースの見出し)、あるいは1つの指標だけが重要な場合に向いています。限界も挙げられています。統計的に頑健な勝者が必要な場合にバンディットは不向きで、1つの目標しか最適化せず、成績の悪いバリエーションにはトラフィックが少なすぎて、コンバージョン率を確実に推定できません。著者はベンダーなので、一人の実務者の見解として読むべきですが、そこで述べられているトレードオフは標準的なものです。
そこから、単純な判断ルールが導かれます。
| 状況 | より適した手法 |
|---|---|
| 数か月つきあうことになる一度きりの意思決定(新しい料金ページ、リデザイン) | 期間固定のA/Bテスト |
| なぜ勝ったのか、またはセグメント別にどうだったかを知る必要がある | A/Bテスト |
| まもなく期間が終わる、短命なキャンペーン、見出し、プロモーション | バンディット |
| リスクの低いコピーの多数のバリエーションで、指標は1つ | バンディット |
| 相互に影響する複数の要素があり、トラフィックが多い | 多変量 |
| トラフィックが少ない | バリエーションを増やすのではなく、少ないバリエーションでより大きな変更をテストする |
AIが解決しない統計の落とし穴
このセクションが最も重要です。自動化されたツールは、整ったダッシュボードの裏に統計上の問題を隠すことがあります。
覗き見(ピーキング)
覗き見とは、テストの実行中に結果を確認し、有意に見えた時点で止めることです。標準的な有意性検定は、あらかじめ決めたサンプルサイズで一度だけ見ることを前提としています。Evan Millerの古典的な解説は、はっきりと述べています。有意性検定を繰り返すと、偽陽性の率は必ず上がります。最悪のケースの例として、新しいバージョンが何の効果もないテストで、150件の観測のうちに最初に有意水準5%の兆候が出た時点で止めると、26.1%の確率で偽陽性になります(Evan Miller、「How Not To Run an A/B Test」、2010年4月18日)。彼の対策は、開始前にサンプルサイズを決めて早期に止めないこと、または逐次的な手法やベイズ的な手法など、繰り返しの確認のために設計された手法を使うことです。
Optimizelyも、Stats Engineを導入した際に同じ点を指摘しました。実際の差がないテストを同社自身がシミュレーションしたところ、訪問者ごとに確認すると、57%を超えるテストが少なくとも一度は勝者または敗者を宣言し、逐次的な手法により、継続的に確認した場合の誤り率は3%まで下がりました(Optimizely、2015年1月20日)。これらはベンダー自身のシミュレーションなので、正確な数字は参考値として扱ってください。確立しているのは、その方向性です。
では、どうすべきでしょうか。固定のサンプルサイズを決めて、それに達するまでテストに手を触れないか、継続的なモニタリング(逐次検定)のために統計が明示的に設計されたプラットフォームを使います。期間固定のツールを使いながら、毎日それを眺めるのはやめてください。
偽陽性と多重比較
確認する指標、バリエーション、セグメントが1つ増えるたびに、ノイズがシグナルに見える機会がまた1つ増えます。5つのバリエーション、10個の指標、6つのセグメントがあるテストには、数百の比較があります。その一部は、運よく有意水準を超えます。これが多重比較の問題で、「AIがバリエーションBの勝つセグメントを見つけた」という状況は、まさにそれが紛れ込む典型です。事後に見つかったセグメントは、結果ではなく、新しいテストのための仮説です。
対策は単純ですが、規律が要ります。テストの前に主要指標を1つ決め、バリエーションの数を制限し、副次的な指標とセグメントの切り分けは探索的なものとして扱い、意外な勝利は再実行して確認します。
サンプル比率の不一致
50対50の分割を意図したのに、実際の訪問者の分割が明らかに違っていれば、割り当てかトラッキングのどこかが壊れており、その結果は信頼できません。Microsoftなどの研究者は、これをサンプル比率の不一致(SRM)と呼び、熱がさまざまな病気の兆候であるのと同じように、さまざまなデータ品質の問題の症状だと説明しています(Fabijan他、KDD 2019)。検出は単純な統計的チェックですが、原因の特定は難しい部分です。多くのテストプラットフォームは、このチェックを自動で実行します。お使いのものが実行しないなら、結果を読む前に自分で実行してください。これはバンディットにも当てはまりますが、適応的な配分では期待される分割がもう固定されていないため、プラットフォーム自身の診断を使ってください。
新奇性効果とプライマシー効果
初期の結果は、人間的な理由でミスリードすることがあります。Microsoftの研究者は、新奇性を新しい技術に引きつけられる力で、時間とともに薄れるものと定義し、プライマシー効果を、ユーザーが変更に慣れるにつれて積み上がるエンゲージメントと定義しています。そして、実験は通常短すぎて、どちらもはっきりとは見えないと指摘しています(Sadeghi他、2021年)。実際上は、派手な新しいバナーは新しいというだけで1週目に勝つかもしれず、分かりにくいが優れたレイアウトは、常連が慣れるのに時間がかかるため、1週目には負けるかもしれません。テストは、ビジネスの周期をまるごとまたぐように(少なくとも丸1週間単位で)実行し、効果が安定しているのか、ずれていっているのかを観察し、リピーター向けの変更には特に慎重になってください。
バンディットと推定の問題
バンディットは、きれいな測定と引き換えに、より速い見返りを得ます。トラフィックが早い段階の先頭に寄っていくため、弱いバリエーションにはほとんどデータが集まらず、それらについて学べることが少なくなり、序盤の運のよい連勝が、誤った勝者を固定してしまうことがあります。上で取り上げたベンダーの記事が、説明し擁護する必要のある意思決定ではなく、短い期間と単一の指標にバンディットを勧めているのは、そのためです。
パーソナライゼーション:AIが加えるものと、その測定方法
サイト内のパーソナライゼーションは、訪問者ごとに異なるコンテンツを見せます。業界に合わせた見出し、閲覧履歴に基づく商品のレコメンド、リピーター向けの別の行動喚起などです。機械学習は、流入元、行動、所在地、過去の購入、予測された意図などのシグナルを使って、誰に何を見せるかを決めます。
AIは、ルールベースのパーソナライゼーションに3つのものを加えます。手作業では定義しなかったセグメントを見つけます。個人をスコアリングし(購入、解約、サポートが必要になる可能性)、そのスコアに基づいて動きます。そして、人がルールを改訂するのを待たずに、継続的に更新します。仕組みをより深く知るには、パーソナライゼーションエンジンのガイドを参照してください。
測定は、構築するよりも難しいものです。理由がいくつかあります。
- 必ずコントロールをホールドアウトします。 対象となる訪問者のうち、無作為に選んだ一定の割合を、デフォルトの体験にとどめておきます。そのグループがなければ、「パーソナライゼーションが効いた」ことと、「どのみち買うつもりだった人がパーソナライズされたページを見た」ことを切り分けられません。
- 交絡した結果に注意します。 モデルが、すでにコンバージョンすると予測している訪問者を狙っているなら、その人たちのコンバージョン率の上昇は、パーソナライゼーションについてほとんど何も語りません。
- 細分化による劣化に注意します。 小さなセグメントが多いほど、サンプルが小さくなり、多重比較の問題が戻ってきます。
- 同意とデータの制限を尊重します。 パーソナライゼーションは、使うことを許されたデータに依存します。ファーストパーティデータと、取得した同意の上に築いてください。
まずは、トラフィックの多い1つのページと、1文で説明できる2〜3個のセグメントから始めてください。説明できない複雑さは、デバッグできない複雑さです。
ステップごとに:CROプログラムにAIを加える
- まず測定を直します。 コンバージョンが、デバイスをまたいで正しく一貫して追跡されていることを確認します。壊れたアナリティクスの上にAIを載せても、誤りが速くなるだけです。
- 1つのページと、主要指標を1つ選びます。 料金ページ、サインアップフォーム、商品ページ、購入手続きのステップなどです。ベースラインのコンバージョン率を書き留めます。
- 観察にAIを使います。 そのページについて、セッションのクラスタリングと摩擦の検知を実行し、アンケートとサポートの文章を要約します。結果は人がレビューします。
- 仮説を生成して絞り込みます。 決まった形式(問題、変更、期待される効果、指標)で仮説を頼みます。一般的なものは削ります。懐疑的な同僚に説明できる5つを残します。
- 公開前にサンプルサイズを見積もります。 検出したい最小効果を決め、必要なトラフィックを計算し、ページが妥当な期間でそれを供給できるかを確認します。できなければ、より大胆な変更か、よりトラフィックの多いステップをテストします。設定についてはA/Bテストのフレームワークを参照してください。
- 手法を意図して選びます。 説明し擁護する必要のある意思決定には、期間固定のA/B。継続的に監視する必要があるなら、逐次的な手法。単一の指標で短い期間なら、バンディットです。
- 計画を事前登録します。 主要指標、実行期間または停止ルール、確認するセグメントを書き出します。テストの途中で変えたくなる気持ちに抗ってください。
- 結果の前に、データの品質を確認します。 トラフィックの分割が正しく見えること、すべてのバリエーションでトラッキングが発火したことを確認します。
- 結果は謙虚に読みます。 勝者のラベルだけでなく、信頼区間を見ます。区間が小さな効果から大きな効果までまたがる「勝ち」は、まだ予測の根拠にできる数字ではありません。
- 大きな勝利は確認します。 意外な結果や、重大な結果については、再実行するか、公開後にトラフィックの一部を旧バージョンに残して、上昇が持続することを検証します。
顧客ジャーニー全体にわたる他のAI活用事例の中での位置づけはファネルの段階別のAIマーケティング活用事例を、周辺のツールについてはAIマーケティングスタックを参照してください。
よくある間違い
- AIに勝者を宣言させること。 自動で昇格されたバリエーションは、その下にある統計の質以上のものではありません。使っているツールがどの手法を採っているかを把握してください。
- 期間固定のテストでの覗き見。 偽の勝利の最も一般的な原因です。
- 少ないトラフィックで多すぎるバリエーションをテストすること。 バリエーションが多いほど、1つあたりのデータが減り、偶然の結果が出る機会が増えます。
- 事後にセグメントを追いかけること。 「オハイオ州のモバイルユーザーには効いた」は、新しい仮説です。
- パーソナライゼーションでコントロールを省くこと。 ホールドアウトがなければ、証明はありません。
- 間違った指標を最適化すること。 クリックを増やしても、見込みの高いリードや訪問者あたりの収益を減らすバリエーションは、損失です。ビジネス価値に結びつく指標を選んでください。
重要なポイント
- 有意性検定を繰り返す(覗き見)と偽陽性の率が上がります。ある最悪のケースの例では、150件の観測のうちに最初に有意水準5%の読み取りが出た時点で止めると、26.1%の確率で偽陽性になりました(Evan Miller、2010年4月18日)。
- Optimizely自身の、実際の差がないテストのシミュレーションでは、従来の統計のもとで訪問者ごとに確認すると、57%を超えるテストが少なくとも一度は勝者または敗者を宣言しました(Optimizely、2015年1月20日)。
- A/Bテストは、効果を正確に測るために実行期間中ずっと探索します。バンディットは探索と活用を並行して行いますが、統計的に頑健な勝者が必要な場合には不向きです(VWO / Wingify)。
- サンプル比率の不一致、つまり観測されたトラフィックの分割が期待された分割と異なる状態は、データ品質の問題を示すシグナルで、単純な統計的チェックで検出できます(Fabijan他、KDD 2019)。
- 新奇性効果は時間とともに薄れ、プライマシー効果は積み上がりますが、実験はどちらも明らかにするには短すぎることがよくあります(Sadeghi他、arXiv、2021年2月18日)。
- CROでAIが最も安全なのは、訪問者の目に触れる前に人が出力をレビューする場面で、最もリスクが高いのは、事前に決めた統計計画なしにライブのトラフィックの判断を下す場面です。
コンバージョン率最適化のためのAI活用に関するよくある質問
AIによるコンバージョン率最適化とは何ですか。
機械学習と生成AIを使ってCROの業務を支援することです。セッション録画のクラスタリング、フィードバックの要約、テスト案の下書きと順位付け、バンディットアルゴリズムによるトラフィック配分、ページのパーソナライズが含まれます。問題を見つけて組み立てる作業は速くなります。変更が効くことの証明は、今も適切な実験設計に左右されます。
バンディットテストは、A/Bテストより優れていますか。
どちらも、あらゆる場面で優れているわけではありません。バンディットは、テストの実行中にトラフィックを先行するバリエーションへ寄せるので、短い期間や単一指標の目標に向いています。A/Bテストは一定の分割を保ち、より明確な推定値を与えるので、事後のセグメント分析を含め、理解し擁護する必要のある意思決定に向いています。
覗き見(ピーキング)とは何で、なぜ問題なのですか。
覗き見とは、実行中のテストを確認し、有意に見えた時点で止めることです。標準的な検定は、あらかじめ決めたサンプルサイズで一度だけ見ることを前提としているため、繰り返し確認すると、本物ではない勝者を宣言する可能性が高まります。サンプルサイズをあらかじめ固定するか、逐次検定のために作られたプラットフォームを使ってください。
AIによるパーソナライゼーションは、コンバージョンを悪化させることがありますか。
あります。ターゲティングが不適切なパーソナライゼーションは、無関係なコンテンツを表示することがあり、無作為に選んだホールドアウトのグループがなければ、それが役に立ったのかどうかも分かりません。コントロールを残し、デフォルトの体験と比較して測定してください。
CROのテストを行うには、どのくらいのトラフィックが必要ですか。
ベースラインのコンバージョン率と、検出したい最小の上昇幅によります。小さな上昇を検出するには、はるかに多くのトラフィックが必要です。公開前に必要なサンプルサイズを計算し、ページが妥当な期間でそれを供給できないなら、より大胆な変更か、よりトラフィックの多いステップをテストしてください。
AIにテストのバリエーションを書かせてもよいですか。
初稿や代案の良い供給源になります。バリエーションを公開する前に、すべての主張、トーン、コンプライアンス上の要件を人が確認し、自社のデータが示す内容に合わない一般的なアイデアは絞り込むべきです。

Principal Product Marketing Strategist