AIによるコンテンツの再活用:1つのアセットを多数に展開する
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
AIによるコンテンツの再活用とは、ウェビナーの録画、調査レポート、長い記事といった中身の濃い元のアセットを1つ取り上げ、AIを使って、チャネルごとの小さなアセットに変える取り組みです。要約記事、LinkedInの投稿シリーズ、メール、短い動画のスクリプト、スライドの構成案などがそれに当たります。うまくいく方法は、4つのステップのループです。元の素材を書き起こし、その主張と引用を抽出し、チャネルごとに調整し、公開前に人がレビューします。最初の3ステップの機械的な作業はAIが担当します。4つ目は人の仕事です。
コンテンツやキャンペーンのマネージャーにとって、魅力は明白です。1時間のウェビナーや30ページのレポートには、すでに専門知識、データ、ストーリーが詰まっています。足りないのは、フィードや受信トレイ、営業の商談の場に収まる形です。AIは、「優れたアセットがある」状態から「6つの場所で成果が出ている」状態までの時間を縮めてくれます。
ただし、再活用はAIコンテンツが最も静かに失敗しやすい場面でもあります。要約が事実からずれていくことがあります。投稿が自社のボイスからずれていくこともあります。ほとんど同じ内容の10ページは、検索エンジンから見ると量産された水増しに映りかねません。本ガイドでは、手順、そのままコピーして使える対応表、そして派生コンテンツを公開に値する品質に保つチェックポイントを紹介します。
再活用がAIに向いている理由(と、向いていない場面)
再活用は、すでに自社が所有し、承認済みの素材から始まります。そのため、何もないところからモデルに書かせるより安全です。モデルは記憶から事実を呼び出すのではなく、確認できるテキストを変換するからです。Googleの生成AIに関するガイダンスは、この違いをはっきり述べています。生成AIはトピックの調査やオリジナルのコンテンツへの構造づけに特に役立つ場合がある一方、ユーザーに価値を加えずに大量のページを生成すると、大量生成されたコンテンツの濫用に関するスパムポリシーに違反するおそれがあるとしています。
この一文は、あらゆる再活用プロジェクトを点検するのに役立つ基準です。オリジナルの素材に、構造、明快さ、新しい切り口を加えているでしょうか。それとも、量を作っているだけでしょうか。
重要なポイント: AIによるコンテンツの再活用
- Googleによると、生成AIはトピックの調査やオリジナルのコンテンツへの構造づけに役立つ一方、ユーザーに価値を加えずに多数のページを生成するために使うと、大量生成されたコンテンツの濫用に関するスパムポリシーに違反するおそれがあります(Google Search Central)。
- Googleのガイダンスは、生成モデルは事実を検索するのではなく、ありそうな単語の並びを予測するため、出力に不正確な内容が含まれる可能性があるとし、公開前の手作業による事実確認が極めて重要だとしています(Google Search Central)。
- このレビューは、検索結果に表示されうるメタデータにも当てはまります。タイトル要素、メタディスクリプション、構造化データ、画像の代替テキストです(Google Search Central)。
- Googleは、主要なコンテンツが同じか非常によく似た複数のページを見つけると、それらをクラスタ化して1つを正規ページに選びます。サイト側が示す正規ページの希望は、規則ではなくヒントです(Google Search Central)。
- リダイレクトとrel="canonical"のアノテーションは強い正規化シグナルであり、サイトマップへの記載は弱いシグナルです(Google Search Central)。
- Googleのスパムポリシーは、独自のコンテンツや価値を加えずに他のサイトのコンテンツを再公開することを、悪質なスクレイピングとして挙げています(Google Search Central)。
AIが向いていないのは、元の素材がそもそも薄い場合です。ウェビナーが印象に残らない内容だったなら、10本の派生記事を作っても救えません。再活用は、元にあるものを増やします。足りないものを補うことはありません。
4ステップの手法
ステップ1:取り込みと書き起こし
下流のすべての工程は、元の素材のきれいなテキスト版に依存します。音声や動画なら、話者ラベルとタイムスタンプ付きの書き起こしが必要です。PDFのレポートなら、抽出したテキストに加えて、図、表、グラフを別途リスト化します。人が引用したがる数字は、そこにあるからです。
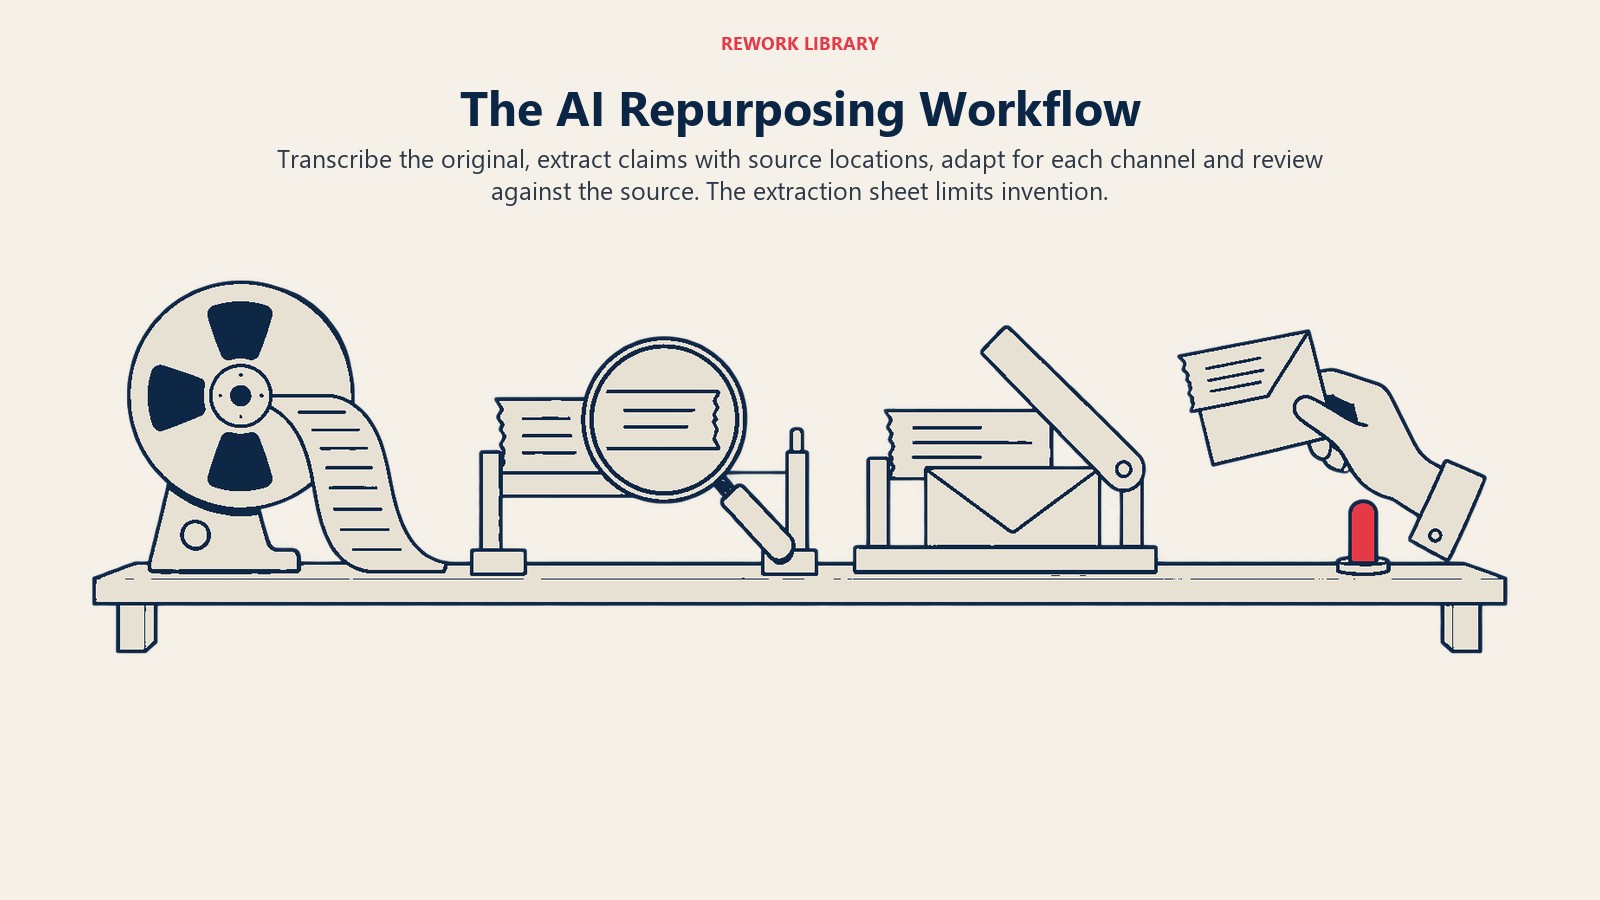
後で苦労しないための習慣が2つあります。
- 書き起こしを唯一の信頼できる情報源として保ちます。 すべての派生アセットは、そこにある箇所までさかのぼれるようにします。レビュー担当者から「この主張の出どころはどこですか」と聞かれたら、タイムスタンプかページ番号を示します。
- 先に書き起こしの中の名前、製品用語、数字を直します。 音声認識ツールは、固有名詞や数字を取り違えます。出どころで一度直した誤りは、8つのアセットにコピーされずに済みます。
これが実務における「取り込み」の機能です。構造化されていない音声、動画、文書を、ワークフローの残りが使える形にすることを指します。
ステップ2:抽出と分析
モデルに「このウェビナーからLinkedInの投稿を書いて」と一足飛びに頼まないでください。まず、元になる素材を、構造化したリストとして抜き出させます。
- 3〜5個の主な論点を、それぞれ1文で
- すべての統計や事実の主張と、それが出てくるタイムスタンプまたはページ
- 再利用する価値のある直接の引用と、話者の名前
- 参加者から出た質問と、それに対する回答
- 平易な言葉による定義が必要な用語
- 事実ではなく意見として話された内容すべて
この抽出シートは、手順全体の中で最も価値のある成果物です。人が10分でレビューできる短さで、次の調整ステップが使ってよい唯一の入力になります。トピックについての自らの記憶ではなくシートから書くモデルは、でっち上げる余地がはるかに小さくなります。なぜそれが重要なのかは、AIのハルシネーションを参照してください。
ステップ3:チャネルごとに調整する
次に、抽出シートと短いチャネル別ブリーフをもとに、チャネルごとに下書きを生成します。ブリーフには次の点を明記します。
- オーディエンスと役割。 誰が読み、その後に何をしてほしいのか。
- 形式の制約。 長さ、構成、行動喚起。
- ボイスのルール。 トーンのガイドラインと、承認済みの例を2〜3個。文書化したガイドラインがまだなければ、まずAIブランドボイスガイドラインから始めてください。
- 切り口。 派生物ごとに、シートの異なる論点から書き出します。同じ気づきで始まる10本の投稿は、1本の投稿の繰り返しです。
- 情報源のルール。 「抽出シートにある主張だけを使うこと。シートにない事実が必要な文には、[NEEDS SOURCE]と記すこと。」
この最後のルールは、安上がりで効果的です。気づかれない捏造を、目に見えるフラグに変えてくれます。
派生物に動画が含まれる場合、ショート動画のスクリプト作成と切り出しには固有の考慮点があります。AI動画マーケティングで解説しています。
ステップ4:公開前のレビュー
人のレビュー担当者が、すべての派生物を抽出シートと元の素材に照らして確認します。何を確認すべきかは次のセクションで扱います。原則は単純です。AIが下書きし、人が承認し、モデルの言うことだけを根拠に公開されるものは何もありません。
1つの元素材、多数のアセット:対応表
次の表は、1本のウェビナーがどう展開されうるかを示しています。元の素材をレポートや長い記事に置き換えても、全体の形は変わりません。ポイントは、各行にAIが行うことと、人が確認することの両方が書かれている点です。
| 派生アセット | チャネル | AIの工程 | 人によるチェック |
|---|---|---|---|
| 要約記事(800〜1,200語) | ブログ | 抽出シートから、主な論点ごとに構成して下書きする | すべての主張と数字を書き起こしと照合する。独自の視点を加える。タイトルとメタディスクリプションは自分で書く |
| 引用カード(3〜5枚) | LinkedIn、Instagram | タイムスタンプ付きで引用の候補を抜き出し、短いキャプションを提案する | 文言が一字一句そのままであることを確認する。名前を付けて引用する場合は話者の承認を得る |
| 投稿シリーズ(4〜6本) | LinkedIn、X | 主な論点ごとに1本ずつ、それぞれ異なる書き出しで下書きする | ガイドラインに照らしてボイスを確認する。繰り返される書き出しを削る。話者の発言を超える主張がないことを確認する |
| ナーチャリングメール | メール | 上位2つの論点を、行動喚起を1つに絞った短いメールに凝縮する | オファー、リンク、コンプライアンス上の文言を確認する。件名をテストする |
| ショート動画のスクリプト(2〜3本) | ソーシャル動画 | 単独で成立する30〜60秒の区間を最も多く特定し、キャプションを下書きする | 文脈から切り離しても各クリップが通じることを確認する。キャプションを音声と照合する |
| スライドの構成案 | 営業支援 | 論点とデータをスライドごとの構成案に変換する | 営業責任者が、実際の提案の仕方と合っていることを確認する。すべてのグラフの出典を確認する |
| FAQブロック | Webページ、営業資料 | 参加者の質問と回答を、整ったQ&Aのペアに変える | 専門家が、回答が今も最新であることを確認する |
| ポッドキャストや音声の抜粋メモ | ショーノート | タイムスタンプ付きで要約し、言及されたリンクの一覧を付ける | リンク先のリソースがすべて存在し、書いてある内容と一致することを確認する |
| 社内向けブリーフ | 営業とサポート | 主な主張と出された反論を要約する | プロダクトまたは法務が、過大な約束をしていないことを確認する |
「人によるチェック」の列が、「ざっと目を通す」になっていないことに注目してください。人が確認すべき具体的な内容が書かれています。これによって、レビューが速くなり、チーム内で一貫します。
最も重要な品質チェック
事実のずれ
事実のずれとは、書き直すたびに主張が少しずつ変わっていく現象です。「多くのチームが成果を報告した」が「大半のチームが大きな成果を得た」になり、「チームは3倍の成果を得られる」になります。どの段階も嘘には見えませんが、最終的な結果は元の素材が述べたことと違います。
防ぐには、各派生物を直前の下書きではなく、抽出シートと比較します。数字は一文字ずつ確認します。限定の言葉が残っているかも確認してください。「当社のサンプルでは」「エンタープライズのアカウントでは」「2026年に」といったものです。また、Googleのガイダンスが、公開前にAI生成コンテンツのすべてを手作業で事実確認しレビューするよう述べていることを思い出してください。対象にはタイトル、メタディスクリプション、構造化データ、画像の代替テキストといったメタデータも含まれます。再活用した投稿では、それらの項目が最後に入力され、最もレビューされにくいことがよくあります。
ボイスのずれ
モデルは、無難で洗練された文体に引き寄せられます。派生物を重ねるうちに、自社らしいボイスが少しずつ平板になり、読み手は理由を言えなくても気づきます。レビューは、1本ずつではなく、まとめて並べて行ってください。3本の投稿が、同じカテゴリのどの会社から出てもおかしくない内容なら、書き出しの数行は手で書き直します。プロンプトだけで直ることは少なく、自社のアーカイブから取った修正前後の例のほうが効果的です。より深い方法はAIブランドボイスガイドラインにあり、プロンプトの側面はプロンプトエンジニアリングで扱っています。
重複と正規化の考慮点
要約記事、その長いバージョン、書き起こしのページを公開すると、主要なコンテンツがほぼ同一のURLが複数できることがあります。Googleのドキュメントによると、主要なコンテンツが同じか非常によく似たページを見つけた場合、それらをクラスタ化し、1つを正規ページに選びます。サイト内にある程度の重複があるのは普通のことで、スパムポリシーの違反ではありませんが、読み手を混乱させ、成果の追跡を難しくすることがあります。
実践的なルールは次のとおりです。
- 各ページに、独自のURLを持つ理由を持たせます。 要約、詳細解説、書き起こしは、目的と深さが違うべきです。2つのページを何も失わずに統合できるなら、統合してください。
- 上位表示させたいページを決めて、シグナルで示します。 リダイレクトとrel="canonical"のアノテーションは強いシグナルで、サイトマップへの記載は弱いシグナルです。それでも指示ではなくヒントにすぎないため、コンテンツの違いも実質的なものにしてください。
- 一貫性を保ちます。 正規ページと考えるURLに内部リンクを張り、同じページに矛盾する正規化シグナルを出さないでください。
- シンジケーションされたコピーは慎重に扱います。 記事を別のサイトに再掲載する場合、元の記事を指していなければ、そのコピーは何も加えません。Googleのスパムポリシーは、独自のコンテンツや価値を加えずに他のサイトのコンテンツを再公開することを悪質なスクレイピングとして挙げているため、パートナーや自社の二次的なサイトは、元の記事へ明確にリンクを張る必要があります。
- ソーシャル投稿は問題ではありません。 ソーシャルプラットフォーム上の短い投稿は、異なる媒体にある別の形式です。重複コンテンツの問題は、主にオープンなWeb上のページに関するものです。
- 翻訳版は別物です。 Googleは、主要なコンテンツが同じ言語である場合にのみ、言語版を重複として扱います。したがって、本文を実際に翻訳したページは重複ではありませんが、ヘッダーだけを翻訳したページは重複です。Googleの正規化の概要を参照してください。
開示と文脈
Googleのガイダンスは、コンテンツがどのように作られたかを共有することで、たとえば自動化をどう使ったかの背景を示すなどして、読み手により多くの文脈を提供できると示唆しています。ブログの文章に必須とされる単一のラベルはないため、自社の方針を決め、一貫して適用してください。AIが下書きに大きく関与したページに控えめな注記を添えるのは妥当な選択肢で、引用した話者は、常に名前を挙げて出典を示すべきです。
より厳格なルールもあります。ECについて、Googleは、同じガイダンスのページによると、Merchant Centerには、画像のメタデータやAI生成の商品データへのラベル付けを含む、AI生成コンテンツに関する独自のポリシーがあると述べています。公開するプラットフォームのルールを確認し、規制対象の主張については法務のレビューを受けてください。
見落としやすい開示の論点がもう1つあります。話者と顧客の同意です。ウェビナーの録画があっても、顧客の発言を切り出してソーシャルのグラフィックにする許可を得たことにはなりません。誰かの言葉を新しいアセットにする前に、利用権を確認してください。
マーケティング機能別の事例
チームごとにこのループをどう適用しうるかの例を示します。これらは仮定のシナリオであり、事例研究ではありません。
- コンテンツマーケティング。 あるチームが年次のベンチマークレポートを公開します。5つの主要な発見を抽出し、それぞれに短い記事、グラフの投稿、ニュースレターの1コーナーを用意して、すべてを完全版のレポートにリンクさせます。より広い計画の視点については、コンテンツマーケターのワークフローにおけるAIを読んでください。
- デマンドジェネレーション。 B2Bソフトウェアのチームは、顧客パネルのウェビナーを3通のナーチャリングメールのシリーズに変えるかもしれません。各メールは、パネリストが取り上げた反論の1つを軸に構成します。
- プロダクトマーケティング。 ローンチのブリーフィングを、営業支援の1枚資料、FAQ、短い反論対応の資料に変えます。主張が一致するよう、すべて同じ抽出シートから作ります。
- イベント。 カンファレンスの基調講演から、要約記事、登壇者向けのクリップ集、セッションを聞き逃した参加者へのフォローアップメールが生まれます。
- カスタマーマーケティング。 長い顧客インタビューを、引用のライブラリに変えます。各引用は、どこかに出る前に顧客が承認します。
ステップごとに:ワークフローを整える
- 元のアセットを選びます。 オリジナルで、中身が濃く、最近承認されたものを選びます。法務や正確性に未解決の問題があるアセットは避けます。
- 権利を確認します。 録画に誰が登場し、何を再利用してよいかを確認します。名前付きの引用は、書面での承認を得ます。
- 書き起こして整えます。 名前、製品用語、数字を直します。タイムスタンプやページの参照を加えます。
- 抽出シートを作ります。 論点、場所付きの主張、引用、参加者の質問、意見として明示した意見をまとめます。元の素材の担当者にレビューしてもらいます。
- 派生物のセットを決めます。 上の対応表を使います。オーディエンスと自社の対応力に合う3〜6個を選びます。多ければよいわけではありません。
- チャネル別ブリーフを書きます。 チャネルごとに短いブリーフを1枚用意し、オーディエンス、形式、ボイスのルール、「シートだけを使う」ルールを入れます。
- 下書きを生成し、編集します。 派生物ごとに異なる切り口を与えます。ボイスは、最も重要な箇所、たいていは最初と最後の行を、手で編集します。
- レビューのチェックリストを実行します。 シートに照らした事実、ガイドラインに照らしたボイス、リンクの動作、メタデータの確認、権利の確認、重複に関する判断です。
- 正規ページと内部リンクを設定します。 どのページを主とするかを決め、派生物から主のページへリンクし、ほぼ同一のページを公開しないようにします。
- スケジュールを組み、測定します。 ストーリーが数週間かけて展開するよう、公開をずらします。各アセットの貢献を追跡し、注目を集める形式は残し、そうでないものは打ち切ります。
これらのアセットが属するより大きなコンテンツプログラムをまだ形にしている段階なら、AIコンテンツ戦略が自然な併読先です。また、ファネルの段階別のAIマーケティング活用事例は、各派生物がバイヤーの道筋のどこに収まるかを示しています。
よくある落とし穴
- 抽出シートを飛ばすこと。 書き起こしから直接プロンプトを書くと、モデルが隙間を記憶で埋めてしまいます。
- 量をゴールとみなすこと。 薄い派生物10本は、良い3本より劣ります。規模が大きくなると、Googleのスパムポリシーが述べるパターンに似てきます。
- 同じ書き出し。 すべてのアセットが同じ要点で始まると、オーディエンスはキャンペーンではなく繰り返しを見ます。
- 文脈を削ぎ落とすこと。 スライドから日付、サンプル、定義を外して取り出した統計は、単独の投稿としては誤解を招きます。
- メタデータを忘れること。 タイトル、ディスクリプション、代替テキストも公開されるコンテンツであり、同じレビューが必要です。
- レビューの担当者がいないこと。 「全員」が確認するなら、誰も確認していません。アセットごとに、責任を負うレビュー担当者を1人決めてください。
- 計画なしに重複を公開すること。 ほぼ同一のバージョンを公開する前に、トラフィックが分散した後ではなく、正規ページを決めておきます。
- 同意を無視すること。 録画に映ったゲストが同意したのはウェビナーであって、必ずしも自分の顔が載った引用グラフィックではありません。

Principal Product Marketing Strategist