Bahasa Indonesia
AI untuk Optimasi Tingkat Konversi: Pengujian, Personalisasi, dan Wawasan
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
AI untuk optimasi tingkat konversi (CRO) berarti memakai pembelajaran mesin dan AI generatif untuk menemukan titik pengunjung meninggalkan halaman, mengusulkan dan memprioritaskan perubahan untuk diuji, membagi trafik antarvarian, dan menyesuaikan halaman untuk pengunjung yang berbeda. AI mempercepat separuh awal CRO, yaitu menemukan masalah dan merumuskan hipotesis. AI tidak mengubah separuh akhirnya. Apakah suatu perubahan benar-benar menaikkan konversi tetap merupakan pertanyaan statistik, dan alat AI dapat membuat Anda lebih mudah menipu diri sendiri, bukan lebih sulit.
Itulah benang merah panduan ini. Dipakai dengan baik, AI memperpendek siklus dari "ada yang terasa janggal" ke "ini uji yang layak dijalankan." Dipakai sembarangan, AI menghasilkan tumpukan "pemenang" yang meyakinkan tetapi lenyap setelah peluncuran. Jika Anda baru mengenal dasarnya, mulailah dengan dasar-dasar optimasi tingkat konversi untuk SaaS atau untuk ecommerce, lalu kembali ke sini untuk lapisan AI-nya.
Di mana AI berperan dalam siklus CRO
Program CRO adalah sebuah siklus: amati perilaku, rumuskan hipotesis, uji, pelajari, ulangi. AI membantu pada titik berbeda dalam siklus itu, dan tingkat risikonya berbeda di tiap titik.
| Tahap CRO | Yang dilakukan AI | Risiko jika keliru |
|---|---|---|
| Amati | Mengelompokkan sesi, meringkas rekaman, menandai rage click dan jalan buntu | Rendah: Anda meninjau temuannya |
| Rumuskan hipotesis | Menyusun ide uji dari analitik, survei, dan ulasan; meranking-nya | Rendah: ide itu murah |
| Bangun varian | Menyusun draf judul utama, naskah, dan opsi tata letak | Sedang: varian yang lemah atau tidak sesuai merek membuang trafik |
| Jalankan uji | Membagi trafik (bandit), menjalankan kombinasi multivariat | Tinggi: statistik yang buruk menghasilkan pemenang palsu |
| Personalisasi | Memilih konten per segmen atau per individu pengunjung | Sedang: pengalaman yang mengganggu atau keliru, sulit diukur |
| Pelajari | Meringkas hasil dan mengusulkan tindak lanjut | Sedang: ringkasan dapat melebih-lebihkan kepastian |
Pola yang perlu diperhatikan: AI paling aman di tempat manusia meninjau keluarannya sebelum apa pun sampai ke pengunjung, dan paling berisiko di tempat ia membuat keputusan langsung atas trafik. Sisa panduan ini mengikuti gradasi tersebut.
Menemukan masalah: analisis sesi dan wawasan perilaku
Sebagian besar program CRO dimulai dengan pertanyaan: di mana orang pergi, dan mengapa? Analitik kuantitatif memberi tahu di mana. Rekaman sesi, peta panas, survei, dan tiket dukungan memberi petunjuk mengapa. Masalahnya selalu volume. Tidak ada yang menonton 10.000 rekaman.
AI membantu dengan tiga cara:
- Pengelompokan sesi. Model mengelompokkan rekaman menurut pola perilaku, seperti pengunjung yang menggulir ke harga lalu pergi, atau yang berulang kali mengeklik elemen yang bukan tautan. Anda menonton beberapa dari tiap klaster, bukan sampel acak.
- Deteksi hambatan. Alat menandai rage click, kesalahan berulang pada kolom formulir, navigasi bolak-balik, dan keranjang yang ditinggalkan sebagai titik masalah kandidat.
- Peringkasan kualitatif. Model bahasa membaca jawaban survei teks bebas, transkrip obrolan, ulasan, dan teks tiket, lalu mengelompokkannya ke dalam tema. "Tidak jelas apakah pengiriman gratis" yang muncul di 300 komentar adalah hipotesis yang tidak perlu Anda cari-cari.
Perlakukan semua ini sebagai petunjuk, bukan vonis. Klaster adalah pola dalam data, dan pola bisa berupa kebetulan atau artefak dari cara sesi disampel. Aturan yang menjaga tim tetap jujur: setiap wawasan yang diangkat AI menjadi hipotesis yang diuji, bukan perubahan yang langsung dirilis ke situs. Data perilaku yang baik juga bergantung pada apa yang Anda kumpulkan sejak awal, yang dibahas dalam data first-party untuk pemasaran AI.
Menghasilkan dan memprioritaskan hipotesis
Hipotesis yang berguna menyebut masalah, perubahan, efek yang diharapkan, dan metriknya. "Pengunjung di ponsel tidak melihat garansi, jadi memindahkannya ke atas tombol akan menaikkan jumlah checkout yang dimulai" itu dapat diuji. "Buat halamannya lebih baik" tidak.
AI generatif piawai dalam volume di sini. Berikan temuan analitik, tema survei, naskah halaman saat ini, dan audiensnya, lalu minta dua puluh hipotesis dalam struktur itu. Kemudian pangkas dengan tegas. Model cenderung menyarankan praktik terbaik yang generik (tambah urgensi, tambah bukti sosial) yang mungkin cocok atau tidak dengan halaman Anda, dan ia tidak bisa tahu batasan Anda mana yang nyata.
Untuk prioritas, tim umumnya menilai ide berdasarkan dampak, keyakinan, dan upaya, memakai kerangka seperti ICE atau PIE. AI dapat mengisi skor draf pertama, tetapi bersikaplah skeptis terhadap angka "dampak": itu tebakan kecuali terkait dengan trafik nyata dan baseline nyata. Penggunaan model yang lebih baik adalah sebagai alat bantu pengurutan, dengan manusia memegang urutan akhir. Pikirkan berapa banyak uji yang realistis dapat Anda jalankan. Halaman yang mendapat beberapa ribu kunjungan sebulan tidak dapat menopang banyak eksperimen paralel, jadi anggaran trafik itu sendiri adalah input prioritas. Kerangka uji A/B membahas cara menyusun backlog itu.
Metode pengujian: A/B, multivariat, dan bandit
Vendor AI mengaburkan nama metode-metode ini, jadi ada baiknya memisahkannya.
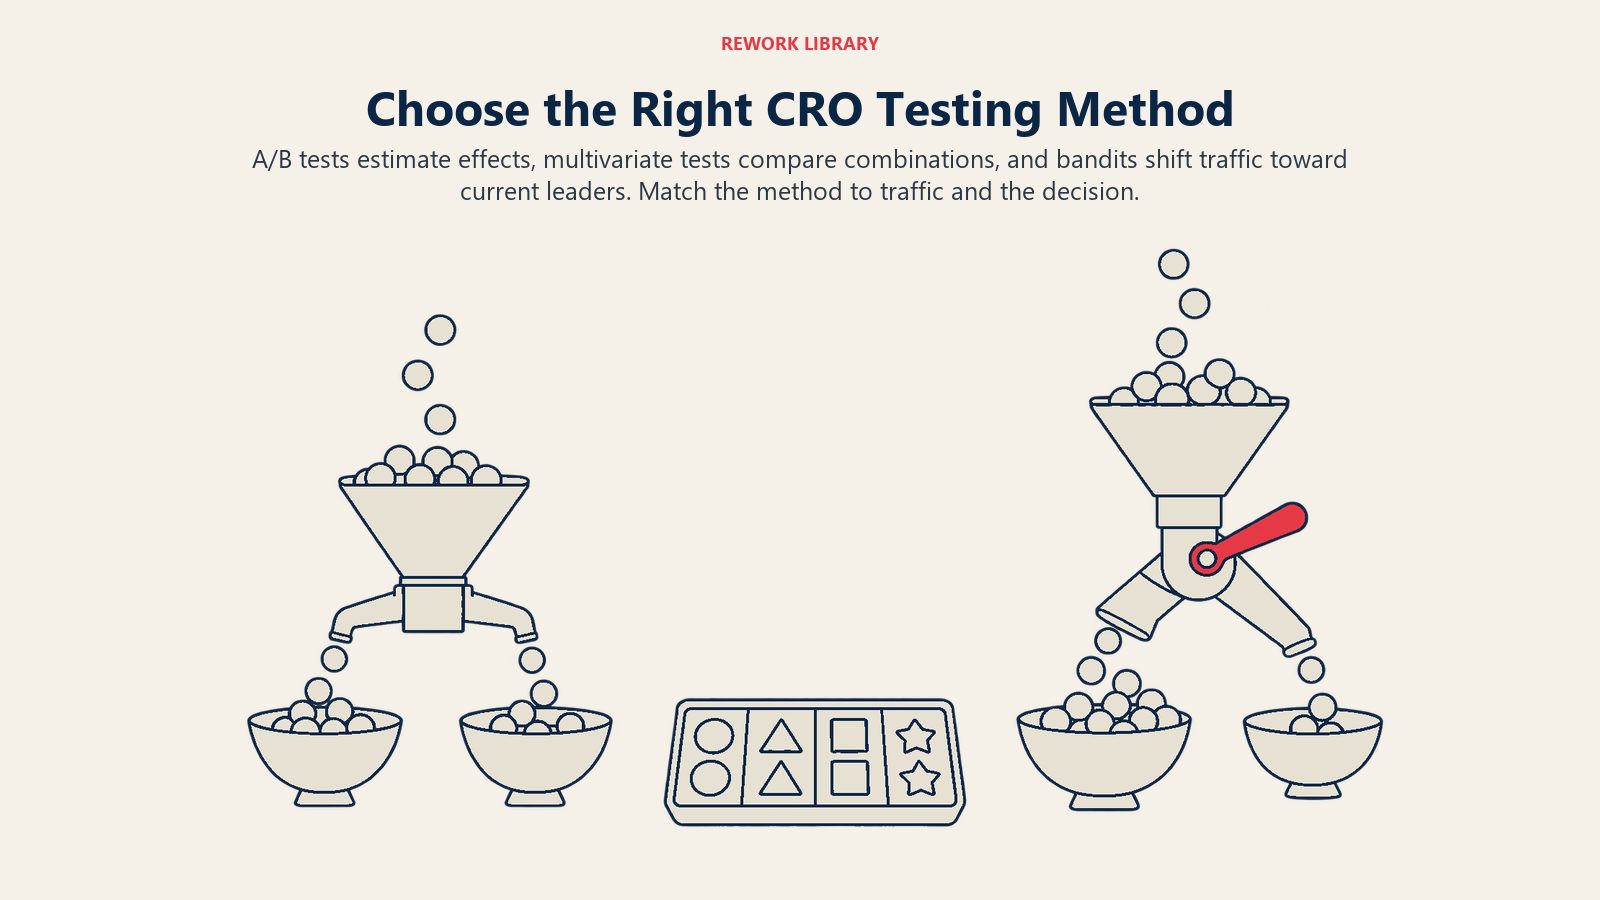
Uji A/B membagi trafik secara merata antara kontrol dan satu atau lebih varian cukup lama untuk mengukur perbedaan. Tujuannya adalah perkiraan efek yang dapat dipercaya.
Uji multivariat mengubah beberapa elemen sekaligus (judul utama, gambar, tombol) dan mengukur setiap kombinasi. Uji ini bisa menunjukkan elemen mana yang penting, tetapi membutuhkan trafik jauh lebih banyak daripada uji A/B sederhana karena trafik dibagi ke setiap kombinasi. Pada halaman bertrafik rendah, biasanya tidak ada yang mencapai signifikansi.
Uji bandit menyesuaikan pembagian saat data masuk, mengirim lebih banyak trafik ke varian yang tampak menang. Di sinilah pembelajaran mesin benar-benar bekerja di dalam uji itu sendiri.
Wingify, yang menjual perangkat lunak pengujian, menggambarkan pertukarannya begini. Uji A/B klasik tetap dalam mode eksplorasi sepanjang masa jalannya karena ia ada untuk mengukur tingkat konversi secara tepat, sedangkan multi-armed bandit mengeksplorasi dan mengeksploitasi secara paralel, memindahkan sebagian besar trafik ke variasi yang saat ini tampak terbaik (VWO / Wingify tentang multi-armed bandit). Artikel yang sama mendaftar di mana masing-masing cocok. Uji A/B cocok untuk keputusan yang membutuhkan keyakinan atas efek setiap varian, termasuk analisis segmen sesudahnya. Bandit cocok untuk kasus di mana setiap konversi yang hilang itu mahal, jendelanya singkat (penawaran terbatas waktu, judul berita), atau Anda hanya peduli pada satu metrik. Artikel itu juga mendaftar batasannya: bandit pilihan yang buruk bila Anda butuh pemenang yang kuat secara statistik, mereka mengoptimalkan satu tujuan, dan varian yang berkinerja rendah mendapat trafik terlalu sedikit untuk memperkirakan tingkat konversinya secara andal. Karena penulisnya adalah vendor, bacalah sebagai satu pandangan praktisi, tetapi pertukaran yang dijelaskannya adalah yang standar.
Aturan keputusan sederhana mengikutinya:
| Situasi | Pilihan yang lebih cocok |
|---|---|
| Keputusan satu kali (halaman harga baru, desain ulang) yang akan Anda jalani berbulan-bulan | Uji A/B dengan horizon tetap |
| Anda perlu tahu mengapa sesuatu menang, atau bagaimana hasilnya per segmen | Uji A/B |
| Kampanye, judul utama, atau promo berumur pendek yang jendelanya segera tutup | Bandit |
| Banyak varian naskah berisiko rendah, satu metrik | Bandit |
| Beberapa elemen yang saling berinteraksi, trafik banyak | Multivariat |
| Trafik rendah | Uji perubahan yang lebih besar dengan lebih sedikit varian, bukan lebih banyak varian |
Jebakan statistik yang tidak diperbaiki AI
Bagian ini paling penting. Perkakas otomatis dapat menyembunyikan masalah statistik di balik dasbor yang rapi.
Peeking
Peeking berarti memeriksa hasil saat uji masih berjalan dan menghentikannya ketika tampak signifikan. Uji signifikansi standar mengasumsikan Anda melihat sekali, pada ukuran sampel yang ditetapkan sebelumnya. Tulisan klasik Evan Miller menyatakannya terang-terangan: pengujian signifikansi berulang selalu meningkatkan tingkat false positive. Dalam contoh kasus terburuknya, uji di mana versi baru tidak berpengaruh apa pun, berhenti pada tanda pertama signifikansi 5% dalam 150 observasi menghasilkan false positive sebanyak 26,1% dari waktu (Evan Miller, "How Not To Run an A/B Test", 18 April 2010). Perbaikannya: tentukan ukuran sampel sebelum mulai dan jangan berhenti lebih awal, atau pakai desain yang dibuat untuk pemeriksaan berulang, seperti metode sekuensial atau Bayesian.
Optimizely menyampaikan hal yang sama saat memperkenalkan Stats Engine-nya. Dalam simulasinya sendiri atas uji tanpa perbedaan nyata, memeriksa setelah setiap pengunjung membuat lebih dari 57% uji menyatakan pemenang atau pecundang setidaknya sekali, dan pendekatan sekuensial menurunkan tingkat kesalahan untuk pemeriksaan terus-menerus menjadi 3% (Optimizely, 20 Januari 2015). Itu simulasi milik vendor sendiri, jadi perlakukan angka persisnya sebagai ilustrasi. Arahnya yang sudah mapan.
Jadi apa yang harus Anda lakukan? Entah berkomitmen pada ukuran sampel tetap dan membiarkan uji sampai tercapai, atau pakai platform yang statistiknya secara eksplisit dibuat untuk pemantauan terus-menerus (pengujian sekuensial). Jangan memakai alat horizon tetap lalu memantaunya setiap hari.
False positive dan perbandingan ganda
Setiap metrik, varian, dan segmen tambahan yang Anda periksa adalah satu peluang lagi bagi derau untuk tampak seperti sinyal. Uji dengan lima varian, sepuluh metrik, dan enam segmen punya ratusan perbandingan. Sebagian akan melewati garis signifikansi karena kebetulan. Inilah masalah perbandingan ganda, dan "AI menemukan segmen di mana varian B menang" persis cara masalah ini menyelinap masuk. Segmen yang ditemukan setelah kejadian adalah hipotesis untuk uji baru, bukan hasil.
Pertahanannya sederhana tetapi butuh disiplin: namai satu metrik utama sebelum uji, batasi jumlah varian, perlakukan metrik sekunder dan potongan segmen sebagai eksploratif, dan konfirmasi kemenangan yang mengejutkan dengan pengulangan.
Sample ratio mismatch
Jika Anda bermaksud membagi 50/50 dan pembagian pengunjung sebenarnya jelas berbeda, ada yang rusak dalam penugasan atau pelacakan, dan hasilnya tidak bisa dipercaya. Peneliti di Microsoft dan perusahaan lain menyebutnya sample ratio mismatch, dan menggambarkannya sebagai gejala dari berbagai masalah kualitas data, seperti demam yang menandakan banyak penyakit (Fabijan et al., KDD 2019). Mendeteksinya adalah pemeriksaan statistik sederhana; menemukan penyebabnya yang sulit. Banyak platform pengujian menjalankan pemeriksaan ini otomatis. Jika platform Anda tidak, jalankan sendiri sebelum membaca hasil apa pun. Ini berlaku juga untuk bandit, meski dengan alokasi adaptif pembagian yang diharapkan tidak lagi tetap, jadi gunakan diagnostik bawaan platform.
Efek kebaruan dan efek keutamaan
Hasil awal bisa menyesatkan karena alasan manusiawi. Peneliti Microsoft mendefinisikan kebaruan sebagai daya tarik teknologi baru, yang memudar seiring waktu, dan keutamaan sebagai keterlibatan yang tumbuh saat pengguna mengadopsi sebuah perubahan, dan mencatat bahwa eksperimen biasanya terlalu singkat untuk menunjukkan salah satunya dengan jelas (Sadeghi et al., 2021). Secara praktis: banner baru yang mencolok bisa menang di minggu pertama karena baru, dan tata letak yang membingungkan tetapi lebih baik bisa kalah di minggu pertama karena pengguna tetap butuh waktu menyesuaikan diri. Jalankan uji selama siklus bisnis penuh (setidaknya minggu utuh), perhatikan apakah efeknya stabil atau bergeser, dan ekstra hati-hati dengan perubahan yang menyasar pengunjung yang kembali.
Bandit dan masalah estimasi
Bandit menukar pengukuran yang bersih dengan hasil yang lebih cepat. Karena trafik bergeser ke pemimpin awal, varian yang lebih lemah mengumpulkan sedikit data, sehingga Anda belajar lebih sedikit tentangnya, dan rentetan keberuntungan awal dapat mengunci pemenang yang salah. Itulah sebabnya artikel vendor di atas merekomendasikannya untuk jendela singkat dan satu metrik, bukan untuk keputusan yang perlu Anda jelaskan dan pertahankan.
Personalisasi: yang ditambahkan AI dan cara mengukurnya
Personalisasi di situs menampilkan konten berbeda kepada pengunjung berbeda: judul utama yang disesuaikan dengan industri, rekomendasi produk berdasarkan penelusuran, ajakan bertindak berbeda untuk pelanggan yang kembali. Pembelajaran mesin memutuskan siapa melihat apa, memakai sinyal seperti sumber, perilaku, lokasi, pembelian sebelumnya, atau intent yang diprediksi.
AI menambahkan tiga hal dibanding personalisasi berbasis aturan. Ia menemukan segmen yang tidak akan Anda definisikan dengan tangan. Ia menilai individu (kemungkinan membeli, churn, membutuhkan bantuan) dan bertindak berdasarkan skor itu. Dan ia memperbarui secara terus-menerus alih-alih menunggu seseorang merevisi aturan. Untuk kajian mekanismenya yang lebih dalam, lihat panduan mesin personalisasi.
Mengukurnya lebih sulit daripada membangunnya, karena beberapa alasan:
- Selalu sisihkan kontrol. Biarkan sebagian pengunjung yang memenuhi syarat, yang dipilih secara acak, tetap pada pengalaman default. Tanpa kelompok itu, Anda tidak bisa memisahkan "personalisasi berhasil" dari "orang yang memang akan membeli mendapat halaman yang dipersonalisasi."
- Waspadai hasil yang terkonfundasi. Jika model menyasar pengunjung yang sudah diprediksinya akan berkonversi, kenaikan tingkat konversi mereka tidak banyak bercerita tentang personalisasinya.
- Awasi erosi. Banyak segmen kecil berarti sampel kecil, dan masalah perbandingan ganda kembali.
- Hormati persetujuan dan batas data. Personalisasi bergantung pada data yang boleh Anda pakai. Bangun di atas data first-party dan persetujuan yang telah Anda kumpulkan.
Mulailah dengan satu halaman bertrafik tinggi dan dua atau tiga segmen yang dapat Anda jelaskan dalam satu kalimat. Kompleksitas yang tidak bisa Anda jelaskan adalah kompleksitas yang tidak bisa Anda debug.
Langkah demi langkah: menambahkan AI ke program CRO
- Perbaiki pengukuran lebih dulu. Pastikan konversi dilacak dengan benar dan konsisten di semua perangkat. AI di atas analitik yang rusak hanya membuat kesalahan lebih cepat.
- Pilih satu halaman dan satu metrik utama. Halaman harga, formulir pendaftaran, halaman produk, atau satu langkah checkout. Tuliskan tingkat konversi baseline-nya.
- Gunakan AI untuk pengamatan. Jalankan pengelompokan sesi dan deteksi hambatan, serta ringkas teks survei dan dukungan untuk halaman itu. Minta seseorang meninjau temuannya.
- Hasilkan dan pangkas hipotesis. Minta hipotesis dalam format tetap (masalah, perubahan, efek yang diharapkan, metrik). Buang yang generik. Simpan lima yang bisa Anda jelaskan kepada rekan yang skeptis.
- Perkirakan ukuran sampel sebelum peluncuran. Tentukan efek minimum yang dapat dideteksi, hitung trafik yang dibutuhkan, dan periksa apakah halaman bisa menyediakannya dalam waktu wajar. Jika tidak, uji perubahan yang lebih berani atau langkah dengan trafik lebih tinggi. Lihat kerangka uji A/B untuk penyiapannya.
- Pilih metode dengan sengaja. A/B horizon tetap untuk keputusan yang perlu Anda pertahankan; metode sekuensial jika Anda harus memantau terus-menerus; bandit untuk jendela singkat dengan satu metrik.
- Daftarkan rencana lebih dulu. Tuliskan metrik utama, lama berjalan atau aturan berhenti, dan segmen yang akan Anda periksa. Tahan godaan mengubahnya di tengah uji.
- Periksa kualitas data sebelum hasil. Pastikan pembagian trafik tampak benar dan pelacakan aktif untuk setiap varian.
- Baca hasil dengan rendah hati. Lihat interval kepercayaan, bukan hanya label pemenang. "Kemenangan" yang intervalnya membentang dari efek kecil hingga besar belum menjadi angka yang bisa Anda jadikan dasar perkiraan.
- Konfirmasi kemenangan besar. Untuk hasil yang mengejutkan atau berisiko tinggi, ulangi atau sisihkan sebagian trafik pada versi lama setelah peluncuran untuk memverifikasi bahwa kenaikannya bertahan.
Untuk melihat posisinya di antara kasus penggunaan AI lain sepanjang perjalanan pelanggan, lihat kasus penggunaan pemasaran AI menurut tahap corong, dan untuk alat di sekitarnya, stack pemasaran AI.
Kesalahan Umum
- Membiarkan AI menyatakan pemenang. Varian yang dipromosikan otomatis hanya sebaik statistik di bawahnya. Ketahui metode yang dipakai alat Anda.
- Peeking pada uji horizon tetap. Sumber kemenangan palsu yang paling umum.
- Menguji terlalu banyak varian pada trafik yang terlalu sedikit. Lebih banyak varian berarti lebih sedikit data per varian dan lebih banyak peluang kebetulan.
- Mengejar segmen setelah kejadian. "Berhasil untuk pengguna ponsel di Ohio" adalah hipotesis baru.
- Melewatkan kontrol dalam personalisasi. Tanpa holdout, tanpa bukti.
- Mengoptimalkan metrik yang salah. Varian yang menaikkan klik tetapi menurunkan prospek berkualitas atau pendapatan per pengunjung adalah kerugian. Pilih metrik yang terkait dengan nilai bisnis.
Fakta Utama
- Pengujian signifikansi berulang (peeking) meningkatkan tingkat false positive; dalam satu contoh kasus terburuk, berhenti pada pembacaan signifikansi 5% pertama dalam 150 observasi menghasilkan false positive sebanyak 26,1% dari waktu (Evan Miller, 18 April 2010).
- Simulasi Optimizely sendiri atas uji tanpa perbedaan nyata menemukan lebih dari 57% menyatakan pemenang atau pecundang setidaknya sekali ketika diperiksa setelah setiap pengunjung di bawah statistik klasik (Optimizely, 20 Januari 2015).
- Uji A/B mengeksplorasi sepanjang masa jalannya untuk mengukur efek secara tepat; bandit mengeksplorasi dan mengeksploitasi secara paralel tetapi kurang cocok bila Anda butuh pemenang yang kuat secara statistik (VWO / Wingify).
- Sample ratio mismatch, di mana pembagian trafik yang teramati berbeda dari yang diharapkan, menandakan masalah kualitas data dan dideteksi dengan pemeriksaan statistik sederhana (Fabijan et al., KDD 2019).
- Efek kebaruan memudar dan efek keutamaan menguat seiring waktu, dan eksperimen sering terlalu singkat untuk menunjukkan salah satunya (Sadeghi et al., arXiv, 18 Februari 2021).
- AI paling aman dalam CRO di tempat manusia meninjau keluaran sebelum pengunjung melihatnya, dan paling berisiko di tempat ia membuat keputusan trafik langsung tanpa rencana statistik yang ditetapkan sebelumnya.
Pertanyaan yang Sering Diajukan tentang AI untuk Optimasi Tingkat Konversi
Apa itu optimasi tingkat konversi dengan AI?
Itu adalah penggunaan pembelajaran mesin dan AI generatif untuk mendukung pekerjaan CRO: mengelompokkan rekaman sesi, meringkas umpan balik, menyusun dan meranking ide uji, membagi trafik dengan algoritma bandit, dan mempersonalisasi halaman. AI mempercepat penemuan dan perumusan masalah. Membuktikan bahwa sebuah perubahan berhasil tetap bergantung pada desain eksperimen yang sehat.
Apakah uji bandit lebih baik daripada uji A/B?
Tidak ada yang lebih baik di semua kasus. Bandit menggeser trafik ke varian yang memimpin saat uji berjalan, yang cocok untuk jendela singkat dan tujuan satu metrik. Uji A/B menjaga pembagian yang stabil dan memberi perkiraan yang lebih bersih, yang cocok untuk keputusan yang perlu Anda pahami dan pertahankan, termasuk analisis segmen sesudahnya.
Apa itu peeking, dan mengapa itu masalah?
Peeking adalah memeriksa uji yang sedang berjalan dan menghentikannya ketika tampak signifikan. Uji standar mengasumsikan satu kali melihat pada ukuran sampel yang ditetapkan sebelumnya, sehingga pemeriksaan berulang menaikkan peluang menyatakan pemenang yang tidak nyata. Tetapkan ukuran sampel sebelumnya atau pakai platform yang dibuat untuk pengujian sekuensial.
Dapatkah personalisasi AI merugikan konversi?
Ya. Personalisasi yang sasarannya buruk dapat menampilkan konten yang tidak relevan, dan tanpa kelompok holdout yang dipilih secara acak Anda tidak bisa tahu apakah itu membantu. Pertahankan kontrol dan ukur terhadap pengalaman default.
Berapa banyak trafik yang saya butuhkan untuk menjalankan uji CRO?
Tergantung pada tingkat konversi baseline Anda dan kenaikan terkecil yang ingin Anda deteksi. Kenaikan yang lebih kecil membutuhkan trafik jauh lebih banyak. Hitung ukuran sampel yang dibutuhkan sebelum peluncuran, dan jika halaman tidak bisa menyediakannya dalam waktu wajar, uji perubahan yang lebih berani atau langkah dengan trafik lebih tinggi.
Haruskah AI menulis varian uji saya?
AI sumber yang baik untuk draf pertama dan alternatif. Seseorang harus memeriksa setiap klaim, nada, dan persyaratan kepatuhan sebelum varian ditayangkan, dan harus memangkas ide generik yang tidak cocok dengan apa yang ditunjukkan data Anda sendiri.

Principal Product Marketing Strategist
On this page
- Di mana AI berperan dalam siklus CRO
- Menemukan masalah: analisis sesi dan wawasan perilaku
- Menghasilkan dan memprioritaskan hipotesis
- Metode pengujian: A/B, multivariat, dan bandit
- Jebakan statistik yang tidak diperbaiki AI
- Peeking
- False positive dan perbandingan ganda
- Sample ratio mismatch
- Efek kebaruan dan efek keutamaan
- Bandit dan masalah estimasi
- Personalisasi: yang ditambahkan AI dan cara mengukurnya
- Langkah demi langkah: menambahkan AI ke program CRO
- Kesalahan Umum
- Fakta Utama