IA para la optimización de la tasa de conversión: pruebas, personalización y conocimiento
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
La IA para la optimización de la tasa de conversión (CRO) consiste en usar aprendizaje automático e IA generativa para encontrar dónde abandonan los visitantes, proponer y priorizar los cambios que se deben probar, repartir el tráfico entre variantes y adaptar las páginas a distintos visitantes. Acelera la primera mitad del CRO, que es encontrar problemas y formular hipótesis. No cambia la segunda mitad. Saber si un cambio realmente aumentó las conversiones sigue siendo una cuestión de estadística, y las herramientas de IA pueden hacer más fácil engañarse a uno mismo, no más difícil.
Ese es el hilo conductor de esta guía. Bien usada, la IA acorta el ciclo que va de "algo no cuadra" a "esta es una prueba que vale la pena ejecutar". Usada sin cuidado, produce una pila de "ganadores" seguros de sí mismos que se esfuman tras el lanzamiento. Si es nuevo en lo básico, empiece con los fundamentos de la optimización de la tasa de conversión para SaaS o para comercio electrónico, y luego vuelva aquí para la capa de IA.
Dónde encaja la IA en el ciclo de CRO
Un programa de CRO es un ciclo: observar el comportamiento, formular una hipótesis, probarla, aprender y repetir. La IA ayuda en distintos puntos de ese ciclo, y el nivel de riesgo difiere en cada uno.
| Etapa del CRO | Qué hace la IA | Riesgo si se equivoca |
|---|---|---|
| Observar | Agrupa sesiones, resume grabaciones, señala clics de frustración y callejones sin salida | Bajo: usted revisa los hallazgos |
| Formular hipótesis | Redacta ideas de prueba a partir de analítica, encuestas y reseñas; las clasifica | Bajo: las ideas son baratas |
| Construir variantes | Redacta titulares, textos y opciones de diseño | Medio: las variantes débiles o ajenas a la marca desperdician tráfico |
| Ejecutar la prueba | Reparte el tráfico (bandits), ejecuta combinaciones multivariantes | Alto: una mala estadística produce falsos ganadores |
| Personalizar | Elige el contenido por segmento de visitantes o por individuo | Medio: experiencias incómodas o erróneas, difíciles de medir |
| Aprender | Resume resultados y propone pasos siguientes | Medio: los resúmenes pueden exagerar la certeza |
El patrón que conviene notar: la IA es más segura donde una persona revisa su resultado antes de que llegue algo a un visitante, y más arriesgada donde toma decisiones en vivo sobre el tráfico. El resto de esta guía sigue ese gradiente.
Encontrar problemas: análisis de sesiones y conocimiento del comportamiento
La mayoría de los programas de CRO empiezan con una pregunta: ¿dónde se van las personas y por qué? La analítica cuantitativa le dice dónde. Las grabaciones de sesiones, los mapas de calor, las encuestas y los tickets de soporte sugieren por qué. El problema siempre ha sido el volumen. Nadie mira 10 000 grabaciones.
La IA ayuda de tres maneras:
- Agrupación de sesiones. Los modelos agrupan las grabaciones por patrón de comportamiento, como los visitantes que se desplazan hasta los precios y rebotan, o los que hacen clic repetidamente en un elemento que no es un enlace. Usted mira unas pocas de cada grupo en lugar de muestras al azar.
- Detección de fricción. Las herramientas señalan clics de frustración, errores repetidos en campos de formularios, navegación de ida y vuelta y carritos abandonados como puntos problemáticos candidatos.
- Resumen cualitativo. Los modelos de lenguaje leen respuestas de texto abierto de encuestas, transcripciones de chat, reseñas y texto de tickets, y luego las agrupan en temas. Que "No puedo saber si el envío es gratis" aparezca en 300 comentarios es una hipótesis que no tuvo que ir a buscar.
Trate todo esto como una pista, no como un veredicto. Un grupo es un patrón en los datos, y los patrones pueden ser coincidencias o artefactos de cómo se muestrearon las sesiones. La regla que mantiene honestos a los equipos: cada hallazgo que saca a la luz la IA se convierte en una hipótesis que se prueba, no en un cambio que llega directo al sitio. Los buenos datos de comportamiento también dependen de qué recopile desde el principio, lo cual se trata en datos propios para el marketing con IA.
Generar y priorizar hipótesis
Una hipótesis útil nombra el problema, el cambio, el efecto esperado y la métrica. "Los visitantes en móvil no ven la garantía, así que moverla encima del botón aumentará los inicios de compra" se puede probar. "Mejorar la página" no.
La IA generativa es buena en volumen aquí. Dele los hallazgos de su analítica, los temas de las encuestas, el texto actual de una página y la audiencia, y pida veinte hipótesis con esa estructura. Luego pode a fondo. Los modelos tienden a sugerir buenas prácticas genéricas (añadir urgencia, añadir prueba social) que pueden encajar o no con su página, y no pueden saber cuáles de sus restricciones son reales.
Para la priorización, los equipos suelen puntuar las ideas por impacto, confianza y esfuerzo, con marcos como ICE o PIE. La IA puede completar una puntuación de primer borrador, pero desconfíe del número de "impacto": es una conjetura a menos que esté vinculado con tráfico real y una línea base real. Un mejor uso del modelo es como ayuda para ordenar, con una persona a cargo del orden final. Piense en cuántas pruebas puede ejecutar de forma realista. Una página que recibe unos pocos miles de visitas al mes no puede sostener muchos experimentos en paralelo, así que el presupuesto de tráfico es en sí mismo un insumo de priorización. El marco de pruebas A/B explica cómo estructurar esa cartera de pendientes.
Métodos de prueba: A/B, multivariante y bandits
Los proveedores de IA desdibujan los nombres de estos métodos, así que conviene separarlos.
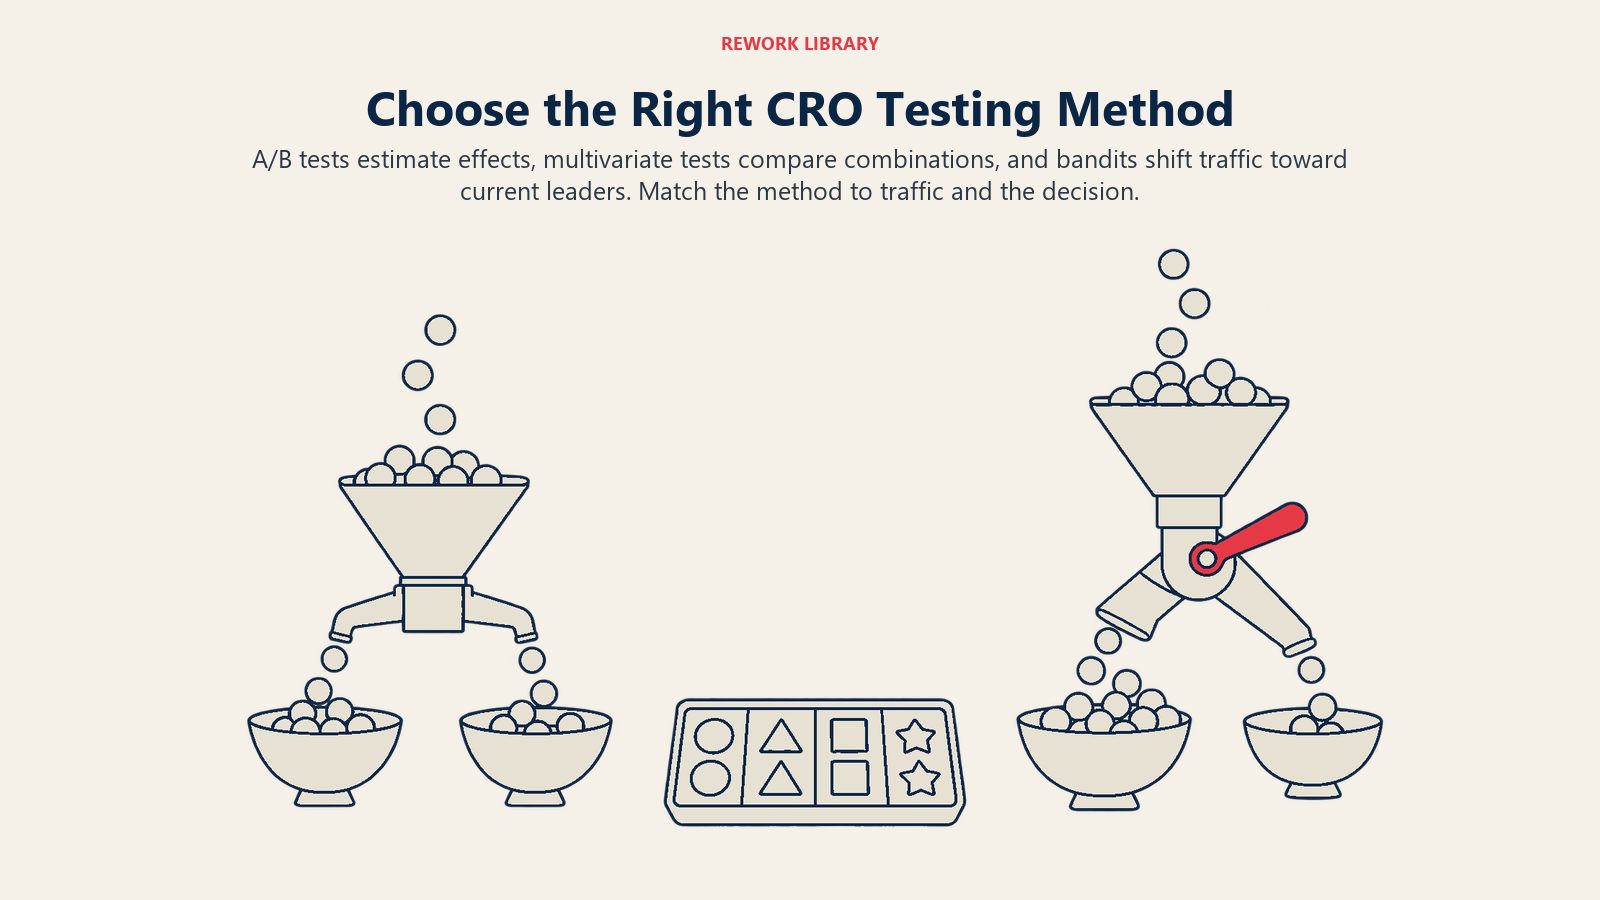
Las pruebas A/B reparten el tráfico de forma pareja entre un control y una o más variantes durante el tiempo suficiente para medir una diferencia. El objetivo es una estimación fiable del efecto.
Las pruebas multivariantes cambian varios elementos a la vez (titular, imagen, botón) y miden cada combinación. Pueden mostrar qué elemento importa, pero necesitan mucho más tráfico que una simple prueba A/B porque el tráfico se divide entre todas las combinaciones. En una página de poco tráfico, eso suele significar que nada alcanza significancia.
Las pruebas bandit ajustan el reparto a medida que llegan los datos, enviando más tráfico a las variantes que parecen ganar. Aquí es donde el aprendizaje automático hace un trabajo real en la propia prueba.
Wingify, que vende software de pruebas, describe el equilibrio así. Una prueba A/B clásica se mantiene en modo de exploración durante toda su ejecución porque existe para medir con precisión las tasas de conversión, mientras que un bandit de múltiples brazos explora y explota en paralelo, desplazando la mayor parte del tráfico hacia la variante que en ese momento parece mejor (VWO / Wingify sobre bandits de múltiples brazos). El mismo artículo enumera dónde encaja cada uno. Las pruebas A/B sirven para decisiones que requieren confianza en el efecto de cada variante, incluido el análisis posterior por segmentos. Los bandits sirven cuando cada conversión perdida es costosa, la ventana es corta (una oferta por tiempo limitado, un titular de noticias) o solo le importa una métrica. También enumera los límites: los bandits son una mala opción cuando necesita un ganador estadísticamente sólido, optimizan un solo objetivo y las variantes de bajo rendimiento reciben muy poco tráfico para estimar con fiabilidad sus tasas de conversión. Como el autor es un proveedor, léalo como un punto de vista de un profesional, pero el equilibrio que describe es el estándar.
De ahí se desprende una regla de decisión sencilla:
| Situación | Mejor opción |
|---|---|
| Decisión única (nueva página de precios, rediseño) con la que vivirá durante meses | Prueba A/B de horizonte fijo |
| Necesita saber por qué ganó algo o cómo le fue por segmento | Prueba A/B |
| Campaña, titular o promoción de corta vida donde la ventana se cierra pronto | Bandit |
| Muchas variantes de texto de bajo riesgo, una métrica | Bandit |
| Varios elementos que interactúan, mucho tráfico | Multivariante |
| Poco tráfico | Probar cambios más grandes con menos variantes, no más variantes |
Trampas estadísticas que la IA no resuelve
Esta sección es la que más importa. Las herramientas automatizadas pueden esconder problemas estadísticos detrás de un panel limpio.
Peeking
El peeking consiste en revisar los resultados mientras una prueba está en marcha y detenerla cuando parecen significativos. Las pruebas de significancia estándar asumen que usted mira una sola vez, con un tamaño de muestra fijado de antemano. El clásico texto de Evan Miller lo dice con claridad: las pruebas de significancia repetidas siempre aumentan la tasa de falsos positivos. En su ejemplo del peor caso, en una prueba donde la nueva versión no hace nada, detenerse a la primera señal de significancia del 5% dentro de 150 observaciones produce un falso positivo el 26,1% de las veces (Evan Miller, "How Not To Run an A/B Test", 18 de abril de 2010). Sus soluciones: decidir el tamaño de muestra antes de empezar y no detenerse antes, o usar un diseño pensado para miradas repetidas, como los métodos secuenciales o bayesianos.
Optimizely hizo el mismo planteamiento cuando presentó su Stats Engine. En sus propias simulaciones de pruebas sin diferencia real, revisar tras cada visitante llevó a más del 57% de las pruebas a declarar un ganador o un perdedor al menos una vez, y un enfoque secuencial redujo la tasa de error de la revisión continua al 3% (Optimizely, 20 de enero de 2015). Son simulaciones del propio proveedor, así que trate las cifras exactas como ilustrativas. La dirección es lo que está bien establecido.
Entonces, ¿qué debe hacer? O se compromete con un tamaño de muestra fijo y deja la prueba en paz hasta alcanzarlo, o usa una plataforma cuya estadística esté explícitamente diseñada para el monitoreo continuo (pruebas secuenciales). No use una herramienta de horizonte fijo y luego la mire a diario.
Falsos positivos y comparaciones múltiples
Cada métrica, variante y segmento adicional que usted inspecciona es una oportunidad más para que el ruido parezca señal. Una prueba con cinco variantes, diez métricas y seis segmentos tiene cientos de comparaciones. Algunas cruzarán una línea de significancia por pura suerte. Este es el problema de las comparaciones múltiples, y "la IA encontró un segmento donde gana la variante B" es exactamente la forma en que se cuela. Un segmento descubierto después de los hechos es una hipótesis para una nueva prueba, no un resultado.
Las defensas son simples pero exigen disciplina: nombrar una métrica principal antes de la prueba, limitar el número de variantes, tratar las métricas secundarias y los cortes por segmento como exploratorios y confirmar las victorias sorprendentes con una repetición.
Desajuste de la proporción de muestra
Si usted pretende una división 50/50 y la división real de visitantes es claramente distinta, algo está roto en la asignación o en el seguimiento, y no se puede confiar en el resultado. Investigadores de Microsoft y otras empresas lo llaman desajuste de la proporción de muestra (sample ratio mismatch) y lo describen como un síntoma de una variedad de problemas de calidad de datos, de forma parecida a como la fiebre señala muchas enfermedades (Fabijan et al., KDD 2019). Detectarlo es una verificación estadística sencilla; encontrar la causa es lo difícil. Muchas plataformas de pruebas ejecutan la verificación automáticamente. Si la suya no lo hace, hágala usted antes de leer cualquier resultado. Esto también se aplica a los bandits, aunque con asignación adaptativa la división esperada ya no es fija, así que use los diagnósticos de la propia plataforma.
Efectos de novedad y de primacía
Los primeros resultados pueden engañar por razones humanas. Investigadores de Microsoft definen la novedad como el atractivo de la nueva tecnología, que se desvanece con el tiempo, y la primacía como la interacción que se acumula a medida que los usuarios adoptan un cambio, y señalan que los experimentos suelen ser demasiado cortos para mostrar claramente cualquiera de los dos (Sadeghi et al., 2021). En la práctica: un banner llamativo puede ganar en la primera semana porque es nuevo, y un diseño confuso pero mejor puede perder en la primera semana porque los usuarios habituales necesitan tiempo para adaptarse. Ejecute las pruebas a lo largo de ciclos de negocio completos (al menos semanas enteras), observe si el efecto es estable o va a la deriva, y tenga especial cuidado con los cambios dirigidos a visitantes recurrentes.
Bandits y el problema de la estimación
Los bandits cambian medición limpia por una recompensa más rápida. Como el tráfico se desplaza hacia los primeros líderes, las variantes más débiles reúnen pocos datos, así que usted aprende menos sobre ellas, y una racha de suerte temprana puede fijar al ganador equivocado. Por eso el artículo del proveedor citado arriba los recomienda para ventanas cortas y métricas únicas, y no para decisiones que usted necesita explicar y defender.
Personalización: qué aporta la IA y cómo medirla
La personalización en el sitio muestra contenido distinto a visitantes distintos: un titular adaptado a una industria, recomendaciones de productos basadas en la navegación, una llamada a la acción diferente para clientes recurrentes. El aprendizaje automático decide quién ve qué, usando señales como el origen, el comportamiento, la ubicación, las compras anteriores o la intención prevista.
La IA aporta tres cosas frente a la personalización basada en reglas. Encuentra segmentos que usted no habría definido a mano. Puntúa a los individuos (probabilidad de comprar, de cancelar, de necesitar ayuda) y actúa según la puntuación. Y se actualiza de forma continua en lugar de esperar a que una persona revise las reglas. Para una mirada más profunda a la mecánica, consulte la guía del motor de personalización.
Medirla es más difícil que construirla, por varias razones:
- Mantenga siempre un grupo de control. Deje a una proporción elegida al azar de los visitantes elegibles en la experiencia predeterminada. Sin ese grupo, no puede separar "la personalización funcionó" de "las personas que de todos modos iban a comprar recibieron una página personalizada".
- Cuidado con los resultados confundidos. Si el modelo apunta a visitantes de los que ya predice que convertirán, un aumento en su tasa de conversión dice poco sobre la personalización.
- Vigile la erosión. Muchos segmentos pequeños significan muestras pequeñas, y vuelve el problema de las comparaciones múltiples.
- Respete el consentimiento y los límites de los datos. La personalización depende de datos que usted tiene permitido usar. Constrúyala sobre datos propios (first-party) y el consentimiento que ha recopilado.
Empiece con una página de mucho tráfico y dos o tres segmentos que pueda explicar en una frase. Una complejidad que no puede explicar es una complejidad que no puede depurar.
Paso a paso: añadir IA a un programa de CRO
- Arregle primero la medición. Confirme que las conversiones se registran de forma correcta y coherente en todos los dispositivos. La IA sobre una analítica rota solo hace los errores más rápido.
- Elija una sola página y una métrica principal. Una página de precios, un formulario de registro, una página de producto o un paso del pago. Anote la tasa de conversión de línea base.
- Use la IA para la observación. Ejecute la agrupación de sesiones y la detección de fricción, y resuma el texto de encuestas y soporte de esa página. Haga que una persona revise los hallazgos.
- Genere y pode hipótesis. Pida hipótesis en un formato fijo (problema, cambio, efecto esperado, métrica). Elimine todo lo genérico. Quédese con las cinco que podría explicar a un colega escéptico.
- Estime el tamaño de muestra antes de lanzar. Decida su efecto mínimo detectable, calcule el tráfico que necesita y compruebe si la página puede aportarlo en un tiempo razonable. Si no, pruebe un cambio más audaz o un paso con más tráfico. Consulte el marco de pruebas A/B para la configuración.
- Elija el método de forma deliberada. A/B de horizonte fijo para decisiones que debe defender; métodos secuenciales si debe monitorear de forma continua; bandits para ventanas cortas con una sola métrica.
- Registre el plan de antemano. Anote la métrica principal, la duración de la ejecución o la regla de detención y los segmentos que revisará. Resista la tentación de cambiarlos a mitad de la prueba.
- Revise la calidad de los datos antes de los resultados. Confirme que el reparto del tráfico se ve bien y que el seguimiento se activó para cada variante.
- Lea los resultados con humildad. Mire el intervalo de confianza, no solo la etiqueta de ganador. Una "victoria" cuyo intervalo abarca efectos pequeños y grandes todavía no es un número con el que pueda pronosticar.
- Confirme las grandes victorias. Para resultados sorprendentes o de alto riesgo, repita la prueba o reserve una parte del tráfico en la versión anterior tras el lanzamiento para verificar que el aumento persiste.
Para ver dónde encaja esto entre los demás casos de uso de la IA a lo largo del recorrido del cliente, consulte casos de uso de la IA en marketing por etapa del embudo, y para las herramientas que lo rodean, el stack de marketing con IA.
Errores comunes
- Dejar que la IA declare ganadores. Las variantes promovidas automáticamente son tan buenas como la estadística que las respalda. Sepa qué método usa su herramienta.
- Hacer peeking en una prueba de horizonte fijo. La fuente más común de falsas victorias.
- Probar demasiadas variantes con muy poco tráfico. Más variantes significa menos datos por variante y más posibilidades de una casualidad.
- Perseguir segmentos después de los hechos. "Funcionó para usuarios móviles en Ohio" es una nueva hipótesis.
- Omitir el control en la personalización. Sin grupo de control, no hay prueba.
- Optimizar la métrica equivocada. Una variante que aumenta los clics pero reduce los leads calificados o los ingresos por visitante es una pérdida. Elija una métrica que se vincule con el valor de negocio.
Datos clave
- Las pruebas de significancia repetidas (peeking) aumentan la tasa de falsos positivos; en un ejemplo del peor caso, detenerse en la primera lectura de significancia del 5% dentro de 150 observaciones produjo un falso positivo el 26,1% de las veces (Evan Miller, 18 de abril de 2010).
- Las propias simulaciones de Optimizely de pruebas sin diferencia real encontraron que más del 57% declaró un ganador o un perdedor al menos una vez cuando se revisaban tras cada visitante con estadística clásica (Optimizely, 20 de enero de 2015).
- Las pruebas A/B exploran durante toda su ejecución para medir los efectos con precisión; los bandits exploran y explotan en paralelo, pero encajan mal cuando se necesita un ganador estadísticamente sólido (VWO / Wingify).
- Un desajuste de la proporción de muestra, en el que la división de tráfico observada difiere de la esperada, señala problemas de calidad de datos y se detecta con una verificación estadística sencilla (Fabijan et al., KDD 2019).
- Los efectos de novedad se desvanecen y los de primacía se acumulan con el tiempo, y los experimentos suelen ser demasiado cortos para revelar cualquiera de los dos (Sadeghi et al., arXiv, 18 de febrero de 2021).
- La IA es más segura en el CRO donde una persona revisa el resultado antes de que lo vean los visitantes, y más arriesgada donde toma decisiones de tráfico en vivo sin un plan estadístico previo.
Preguntas frecuentes sobre IA para la optimización de la tasa de conversión
¿Qué es la optimización de la tasa de conversión con IA?
Es el uso de aprendizaje automático e IA generativa para apoyar el trabajo de CRO: agrupar grabaciones de sesiones, resumir comentarios, redactar y clasificar ideas de prueba, repartir el tráfico con algoritmos bandit y personalizar páginas. Acelera la tarea de encontrar y plantear problemas. Demostrar que un cambio funciona sigue dependiendo de un diseño de experimento sólido.
¿Son mejores las pruebas bandit que las pruebas A/B?
Ninguna es mejor en todos los casos. Los bandits desplazan el tráfico hacia la variante líder mientras corre la prueba, lo que sirve para ventanas cortas y objetivos de una sola métrica. Las pruebas A/B mantienen un reparto constante y dan estimaciones más limpias, lo que sirve para decisiones que necesita entender y defender, incluido el análisis posterior por segmentos.
¿Qué es el peeking y por qué es un problema?
El peeking es revisar una prueba en marcha y detenerla cuando parece significativa. Las pruebas estándar asumen una sola revisión con un tamaño de muestra preestablecido, por lo que las revisiones repetidas aumentan la probabilidad de declarar un ganador que no es real. Fije el tamaño de muestra de antemano o use una plataforma diseñada para pruebas secuenciales.
¿Puede la personalización con IA perjudicar la conversión?
Sí. Una personalización mal dirigida puede mostrar contenido irrelevante, y sin un grupo de control elegido al azar no puede saber si ayudó. Mantenga un control y mida frente a la experiencia predeterminada.
¿Cuánto tráfico necesito para ejecutar pruebas de CRO?
Depende de su tasa de conversión de línea base y del menor aumento que le interese detectar. Los aumentos menores necesitan mucho más tráfico. Calcule el tamaño de muestra requerido antes de lanzar y, si la página no puede aportarlo en un tiempo razonable, pruebe un cambio más audaz o un paso con más tráfico.
¿Debería la IA escribir mis variantes de prueba?
Es una buena fuente de primeros borradores y alternativas. Una persona debe revisar cada afirmación, el tono y cualquier requisito de cumplimiento normativo antes de que una variante salga en vivo, y debe podar las ideas genéricas que no coincidan con lo que muestran sus propios datos.

Principal Product Marketing Strategist
On this page
- Dónde encaja la IA en el ciclo de CRO
- Encontrar problemas: análisis de sesiones y conocimiento del comportamiento
- Generar y priorizar hipótesis
- Métodos de prueba: A/B, multivariante y bandits
- Trampas estadísticas que la IA no resuelve
- Peeking
- Falsos positivos y comparaciones múltiples
- Desajuste de la proporción de muestra
- Efectos de novedad y de primacía
- Bandits y el problema de la estimación
- Personalización: qué aporta la IA y cómo medirla
- Paso a paso: añadir IA a un programa de CRO
- Errores comunes
- Datos clave