KI für Conversion-Optimierung: Testen, Personalisierung und Erkenntnisse
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
KI für Conversion-Optimierung (CRO) bedeutet, maschinelles Lernen und generative KI einzusetzen, um zu finden, wo Besucher abspringen, um zu testende Änderungen vorzuschlagen und zu priorisieren, um Traffic auf Varianten zu verteilen und um Seiten auf verschiedene Besucher zuzuschneiden. Sie beschleunigt die erste Hälfte von CRO, nämlich Probleme zu finden und Hypothesen zu bilden. Die zweite Hälfte ändert sie nicht. Ob eine Änderung die Conversions tatsächlich erhöht hat, bleibt eine Frage der Statistik, und KI-Tools können es leichter machen, sich selbst zu täuschen, nicht schwerer.
Das ist der rote Faden dieses Leitfadens. Richtig eingesetzt verkürzt KI den Weg von „irgendetwas sieht falsch aus“ zu „hier ist ein Test, der sich lohnt“. Unvorsichtig eingesetzt erzeugt sie einen Haufen selbstsicherer „Gewinner“, die nach dem Launch verschwinden. Wenn Sie neu bei den Grundlagen sind, beginnen Sie mit den Grundlagen der Conversion-Optimierung für SaaS oder für E-Commerce und kehren Sie dann für die KI-Ebene hierher zurück.
Wo KI im CRO-Zyklus ansetzt
Ein CRO-Programm ist ein Kreislauf: Verhalten beobachten, eine Hypothese bilden, sie testen, lernen, wiederholen. KI hilft an verschiedenen Punkten dieses Kreislaufs, und das Risiko unterscheidet sich an jedem.
| CRO-Phase | Was KI tut | Risiko, wenn sie falsch liegt |
|---|---|---|
| Beobachten | Clustert Sessions, fasst Aufzeichnungen zusammen, markiert Rage Clicks und Sackgassen | Gering: Sie prüfen die Ergebnisse |
| Hypothesen bilden | Entwirft Testideen aus Analytics, Umfragen und Bewertungen; reiht sie | Gering: Ideen sind billig |
| Varianten bauen | Entwirft Überschriften, Texte und Layout-Optionen | Mittel: schwache oder markenfremde Varianten verschwenden Traffic |
| Test durchführen | Verteilt Traffic (Bandits), fährt multivariate Kombinationen | Hoch: schlechte Statistik erzeugt falsche Gewinner |
| Personalisieren | Wählt Inhalte pro Besuchersegment oder Einzelperson | Mittel: unheimliche oder falsche Erlebnisse, schwer messbar |
| Lernen | Fasst Ergebnisse zusammen und schlägt Folgetests vor | Mittel: Zusammenfassungen können Gewissheit überzeichnen |
Das Muster, das es zu beachten gilt: KI ist dort am sichersten, wo eine Person ihre Ausgabe prüft, bevor etwas einen Besucher erreicht, und dort am riskantesten, wo sie Live-Entscheidungen über Traffic trifft. Der Rest dieses Leitfadens folgt diesem Gefälle.
Probleme finden: Session-Analyse und Verhaltenserkenntnisse
Die meisten CRO-Programme beginnen mit einer Frage: Wo verlassen Menschen die Seite, und warum? Quantitative Analytik sagt Ihnen, wo. Session-Aufzeichnungen, Heatmaps, Umfragen und Support-Tickets deuten an, warum. Das Problem war schon immer die Menge. Niemand sieht sich 10.000 Aufzeichnungen an.
KI hilft auf drei Arten:
- Session-Clustering. Modelle gruppieren Aufzeichnungen nach Verhaltensmuster, etwa Besucher, die bis zur Preisseite scrollen und abspringen oder die wiederholt auf ein Element klicken, das kein Link ist. Sie sehen sich aus jedem Cluster eine Handvoll an statt zufälliger Stichproben.
- Erkennung von Reibung. Tools markieren Rage Clicks, wiederholte Fehler in Formularfeldern, Hin-und-her-Navigation und abgebrochene Warenkörbe als mögliche Problemstellen.
- Qualitative Zusammenfassung. Sprachmodelle lesen offene Umfrageantworten, Chat-Transkripte, Bewertungen und Ticket-Texte und gruppieren sie dann in Themen. „Ich sehe nicht, ob der Versand kostenlos ist“ in 300 Kommentaren ist eine Hypothese, die Sie nicht erst suchen mussten.
Behandeln Sie all das als Spur, nicht als Urteil. Ein Cluster ist ein Muster in Daten, und Muster können Zufälle sein oder Artefakte der Stichprobenziehung bei den Sessions. Die Regel, die Teams ehrlich hält: Jede von KI aufgedeckte Erkenntnis wird zu einer Hypothese, die getestet wird, nicht zu einer Änderung, die direkt auf die Website geht. Gute Verhaltensdaten hängen auch davon ab, was Sie überhaupt erheben, das behandelt First-Party-Daten für KI-Marketing.
Hypothesen erzeugen und priorisieren
Eine brauchbare Hypothese nennt das Problem, die Änderung, den erwarteten Effekt und die Kennzahl. „Besucher auf Mobilgeräten sehen die Garantie nicht, daher steigert ihr Verschieben über die Schaltfläche die Checkout-Starts“ ist testbar. „Mach die Seite besser“ ist es nicht.
Generative KI ist hier gut bei der Menge. Geben Sie ihr Ihre Analytics-Ergebnisse, Umfragethemen, den aktuellen Text einer Seite und die Zielgruppe und bitten Sie um zwanzig Hypothesen in dieser Struktur. Stutzen Sie dann kräftig. Modelle neigen dazu, generische Best Practices vorzuschlagen (Dringlichkeit erzeugen, sozialen Beweis ergänzen), die zu Ihrer Seite passen können oder nicht, und sie können nicht wissen, welche Ihrer Einschränkungen real sind.
Zur Priorisierung bewerten Teams Ideen üblicherweise nach Wirkung, Konfidenz und Aufwand, mit Frameworks wie ICE oder PIE. KI kann eine erste Punktzahl eintragen, aber seien Sie skeptisch gegenüber der Zahl für die „Wirkung“: Sie ist eine Schätzung, solange sie nicht an realen Traffic und eine reale Baseline (Ausgangswert) gebunden ist. Sinnvoller ist es, das Modell als Sortierhilfe zu nutzen, wobei ein Mensch die endgültige Reihenfolge verantwortet. Überlegen Sie, wie viele Tests Sie realistisch fahren können. Eine Seite mit einigen tausend Besuchen im Monat trägt nicht viele parallele Experimente, das Traffic-Budget ist also selbst eine Eingabe für die Priorisierung. Wie sich dieser Backlog strukturieren lässt, behandelt das A/B-Test-Framework.
Testmethoden: A/B, multivariat und Bandits
KI-Anbieter verwischen die Namen dieser Methoden, daher hilft es, sie zu trennen.
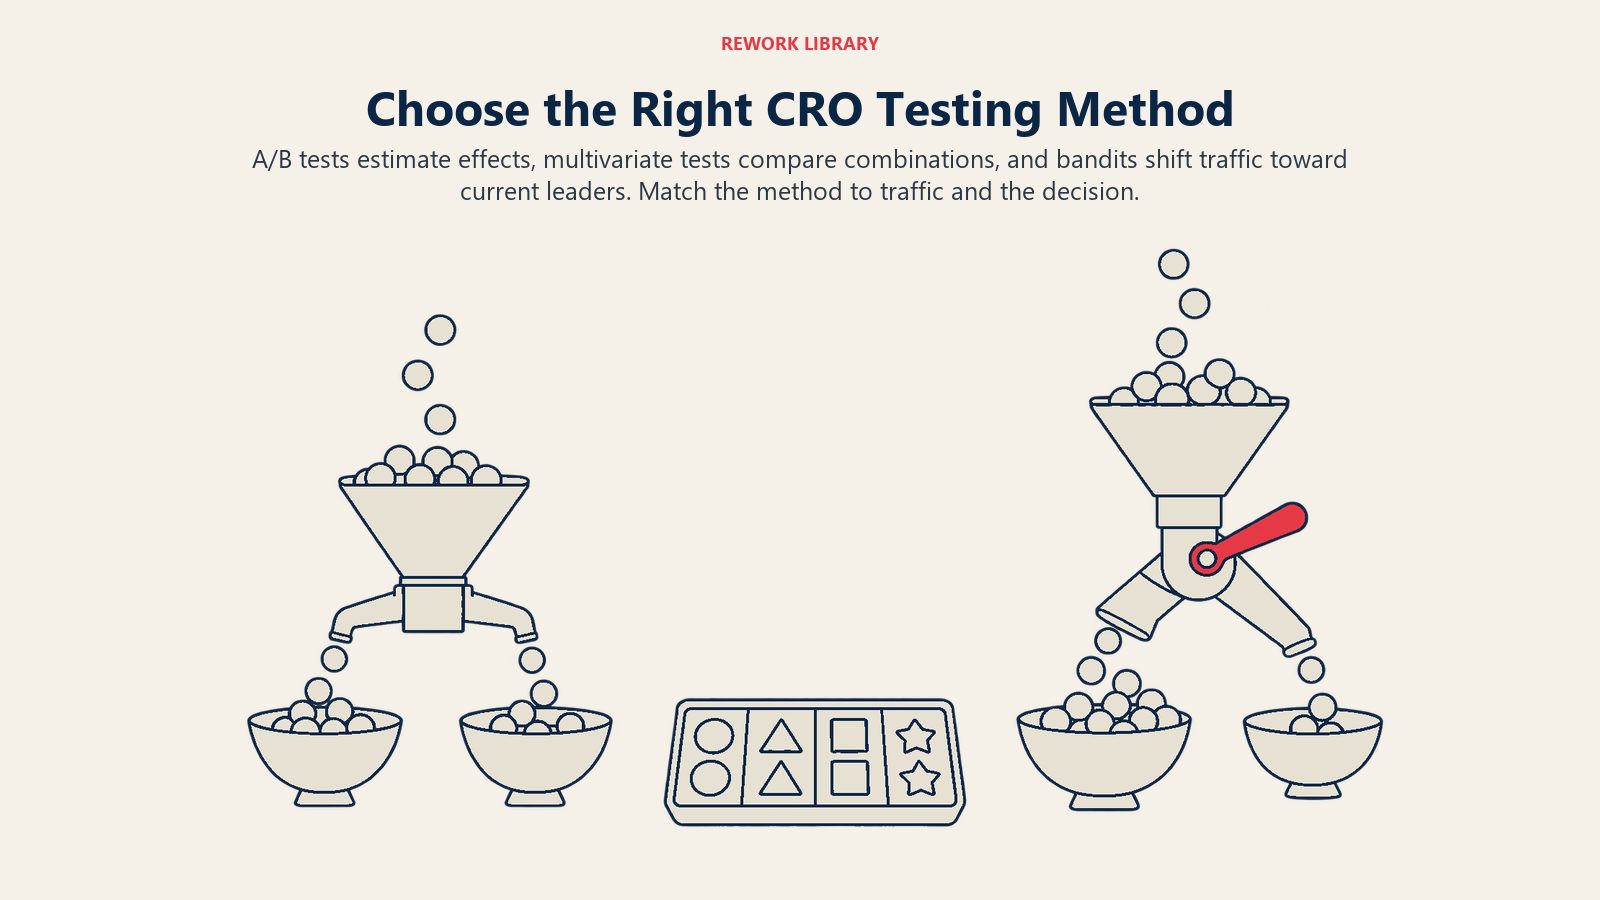
A/B-Tests teilen den Traffic gleichmäßig zwischen einer Kontrollversion und einer oder mehreren Varianten auf, und zwar lange genug, um einen Unterschied zu messen. Ziel ist eine vertrauenswürdige Schätzung des Effekts.
Multivariate Tests ändern mehrere Elemente gleichzeitig (Überschrift, Bild, Schaltfläche) und messen jede Kombination. Sie können zeigen, welches Element zählt, brauchen aber weit mehr Traffic als ein einfacher A/B-Test, weil sich der Traffic auf jede Kombination verteilt. Auf einer Seite mit wenig Traffic bedeutet das meist, dass nichts Signifikanz erreicht.
Bandit-Tests passen die Aufteilung an, sobald Daten eintreffen, und leiten mehr Traffic an Varianten, die zu gewinnen scheinen. Hier leistet maschinelles Lernen echte Arbeit im Test selbst.
Wingify, das Testsoftware verkauft, beschreibt den Zielkonflikt so: Ein klassischer A/B-Test bleibt während seiner gesamten Laufzeit im Explorationsmodus, weil er dazu da ist, Conversion-Raten präzise zu messen, während ein Multi-Armed-Bandit parallel erkundet und ausnutzt und den Großteil des Traffics auf die Variante verlagert, die derzeit am besten aussieht (VWO / Wingify zu Multi-Armed-Bandits). Derselbe Artikel nennt, wo welche Methode passt. A/B-Tests eignen sich für Entscheidungen, die Sicherheit über den Effekt jeder Variante brauchen, einschließlich einer anschließenden Segmentanalyse. Bandits eignen sich, wenn jede verlorene Conversion teuer ist, das Zeitfenster kurz ist (ein befristetes Angebot, eine Nachrichtenüberschrift) oder Sie sich nur für eine Kennzahl interessieren. Er nennt auch die Grenzen: Bandits sind eine schlechte Wahl, wenn Sie einen statistisch belastbaren Gewinner brauchen, sie optimieren ein einziges Ziel, und schwächere Varianten erhalten zu wenig Traffic, um ihre Conversion-Raten verlässlich zu schätzen. Da der Autor ein Anbieter ist, lesen Sie das als eine Praktikersicht, doch der beschriebene Zielkonflikt ist der übliche.
Daraus folgt eine einfache Entscheidungsregel:
| Situation | Besser geeignet |
|---|---|
| Einmalige Entscheidung (neue Preisseite, Redesign), mit der Sie monatelang leben | A/B-Test mit festem Horizont |
| Sie müssen wissen, warum etwas gewonnen hat oder wie es je Segment abschnitt | A/B-Test |
| Kurzlebige Kampagne, Überschrift oder Aktion, deren Zeitfenster bald schließt | Bandit |
| Viele Varianten eines Textes mit geringem Risiko, eine Kennzahl | Bandit |
| Mehrere zusammenwirkende Elemente, viel Traffic | Multivariat |
| Wenig Traffic | Größere Änderungen mit weniger Varianten testen, nicht mehr Varianten |
Statistische Fallstricke, die KI nicht behebt
Dieser Abschnitt ist der wichtigste. Automatisierte Tools können statistische Probleme hinter einem sauberen Dashboard verbergen.
Peeking
Peeking heißt, Ergebnisse während eines laufenden Tests zu prüfen und zu stoppen, wenn sie signifikant aussehen. Übliche Signifikanztests setzen voraus, dass Sie einmal hinsehen, bei einer vorab festgelegten Stichprobengröße. Evan Millers klassischer Beitrag sagt es deutlich: Wiederholte Signifikanztests erhöhen stets die Rate falsch positiver Ergebnisse. In seinem ungünstigsten Beispiel, einem Test, bei dem die neue Version nichts bewirkt, führt das Stoppen beim ersten Anzeichen von 5 % Signifikanz innerhalb von 150 Beobachtungen in 26,1 % der Fälle zu einem falsch positiven Ergebnis (Evan Miller, „How Not To Run an A/B Test“, 18. April 2010). Seine Lösungen: die Stichprobengröße vor dem Start festlegen und nicht vorzeitig stoppen oder ein Design nutzen, das für wiederholtes Hinsehen gebaut ist, etwa sequenzielle oder Bayes-Methoden.
Optimizely machte denselben Punkt bei der Einführung seiner Stats Engine. In eigenen Simulationen von Tests ohne echten Unterschied führte das Prüfen nach jedem Besucher dazu, dass mehr als 57 % der Tests mindestens einmal einen Gewinner oder Verlierer erklärten, und ein sequenzieller Ansatz senkte die Fehlerrate bei kontinuierlichem Prüfen auf 3 % (Optimizely, 20. Januar 2015). Das sind die eigenen Simulationen des Anbieters, verstehen Sie die genauen Zahlen also als Veranschaulichung. Die Richtung ist gut belegt.
Was also tun? Entweder legen Sie sich auf eine feste Stichprobengröße fest und lassen den Test in Ruhe, bis sie erreicht ist, oder Sie nutzen eine Plattform, deren Statistik ausdrücklich für kontinuierliches Monitoring gebaut ist (sequenzielles Testen). Nutzen Sie kein Tool mit festem Horizont und beobachten es dann täglich.
Falsch positive Ergebnisse und multiple Vergleiche
Jede zusätzliche Kennzahl, Variante und jedes Segment, das Sie betrachten, ist eine weitere Gelegenheit, dass Rauschen wie ein Signal aussieht. Ein Test mit fünf Varianten, zehn Kennzahlen und sechs Segmenten hat Hunderte Vergleiche. Einige überschreiten die Signifikanzgrenze durch Zufall. Das ist das Problem der multiplen Vergleiche, und „die KI hat ein Segment gefunden, in dem Variante B gewinnt“ ist genau die Art, wie es sich einschleicht. Ein nachträglich entdecktes Segment ist eine Hypothese für einen neuen Test, kein Ergebnis.
Die Abwehr ist einfach, braucht aber Disziplin: Benennen Sie vor dem Test eine primäre Kennzahl, begrenzen Sie die Zahl der Varianten, behandeln Sie sekundäre Kennzahlen und Segmentschnitte als explorativ und bestätigen Sie überraschende Gewinne mit einer Wiederholung.
Sample Ratio Mismatch
Wenn Sie eine Aufteilung von 50/50 beabsichtigen und die tatsächliche Aufteilung der Besucher deutlich abweicht, ist etwas bei Zuweisung oder Tracking kaputt, und dem Ergebnis ist nicht zu trauen. Forscher bei Microsoft und anderen Unternehmen nennen das Sample Ratio Mismatch und beschreiben es als Symptom einer Vielzahl von Datenqualitätsproblemen, ähnlich wie Fieber auf viele Krankheiten hindeutet (Fabijan et al., KDD 2019). Es zu erkennen ist ein einfacher statistischer Test; die Ursache zu finden ist der schwierige Teil. Viele Test-Plattformen führen die Prüfung automatisch durch. Tut Ihre es nicht, führen Sie sie selbst durch, bevor Sie Ergebnisse lesen. Das gilt auch für Bandits, wobei bei adaptiver Zuteilung die erwartete Aufteilung nicht mehr feststeht, nutzen Sie also die eigene Diagnose der Plattform.
Neuheits- und Primäreffekte
Frühe Ergebnisse können aus menschlichen Gründen in die Irre führen. Forscher bei Microsoft definieren Neuheit als den Reiz neuer Technik, der mit der Zeit nachlässt, und den Primäreffekt als das Engagement, das wächst, wenn Nutzer eine Änderung annehmen, und halten fest, dass Experimente meist zu kurz sind, um eines von beiden klar zu zeigen (Sadeghi et al., 2021). Praktisch heißt das: Ein auffälliges neues Banner kann in Woche eins gewinnen, weil es neu ist, und ein verwirrendes, aber besseres Layout kann in Woche eins verlieren, weil Stammnutzer Zeit zur Umgewöhnung brauchen. Führen Sie Tests über volle Geschäftszyklen aus (mindestens ganze Wochen), beobachten Sie, ob der Effekt stabil ist oder driftet, und seien Sie bei Änderungen für wiederkehrende Besucher besonders vorsichtig.
Bandits und das Schätzproblem
Bandits tauschen saubere Messung gegen schnelleren Ertrag. Weil sich der Traffic zu frühen Spitzenreitern verlagert, sammeln die schwächeren Varianten wenig Daten, Sie lernen über sie also weniger, und eine frühe Glückssträhne kann den falschen Gewinner festschreiben. Deshalb empfiehlt der oben genannte Anbieterartikel sie für kurze Zeitfenster und einzelne Kennzahlen statt für Entscheidungen, die Sie erklären und verteidigen müssen.
Personalisierung: was KI hinzufügt und wie Sie sie messen
Personalisierung auf der Website zeigt verschiedenen Besuchern unterschiedliche Inhalte: eine auf die Branche abgestimmte Überschrift, Produktempfehlungen anhand des Surfverhaltens, eine andere Handlungsaufforderung für wiederkehrende Kunden. Maschinelles Lernen entscheidet, wer was sieht, anhand von Signalen wie Herkunft, Verhalten, Standort, früheren Käufen oder vorhergesagter Absicht.
KI fügt gegenüber regelbasierter Personalisierung drei Dinge hinzu. Sie findet Segmente, die Sie von Hand nicht definiert hätten. Sie bewertet Einzelpersonen (Wahrscheinlichkeit zu kaufen, abzuwandern, Hilfe zu brauchen) und handelt nach der Bewertung. Und sie aktualisiert sich laufend, statt darauf zu warten, dass ein Mensch die Regeln überarbeitet. Einen tieferen Blick auf die Mechanik bietet der Leitfaden zur Personalisierungs-Engine.
Sie zu messen ist aus mehreren Gründen schwieriger, als sie zu bauen:
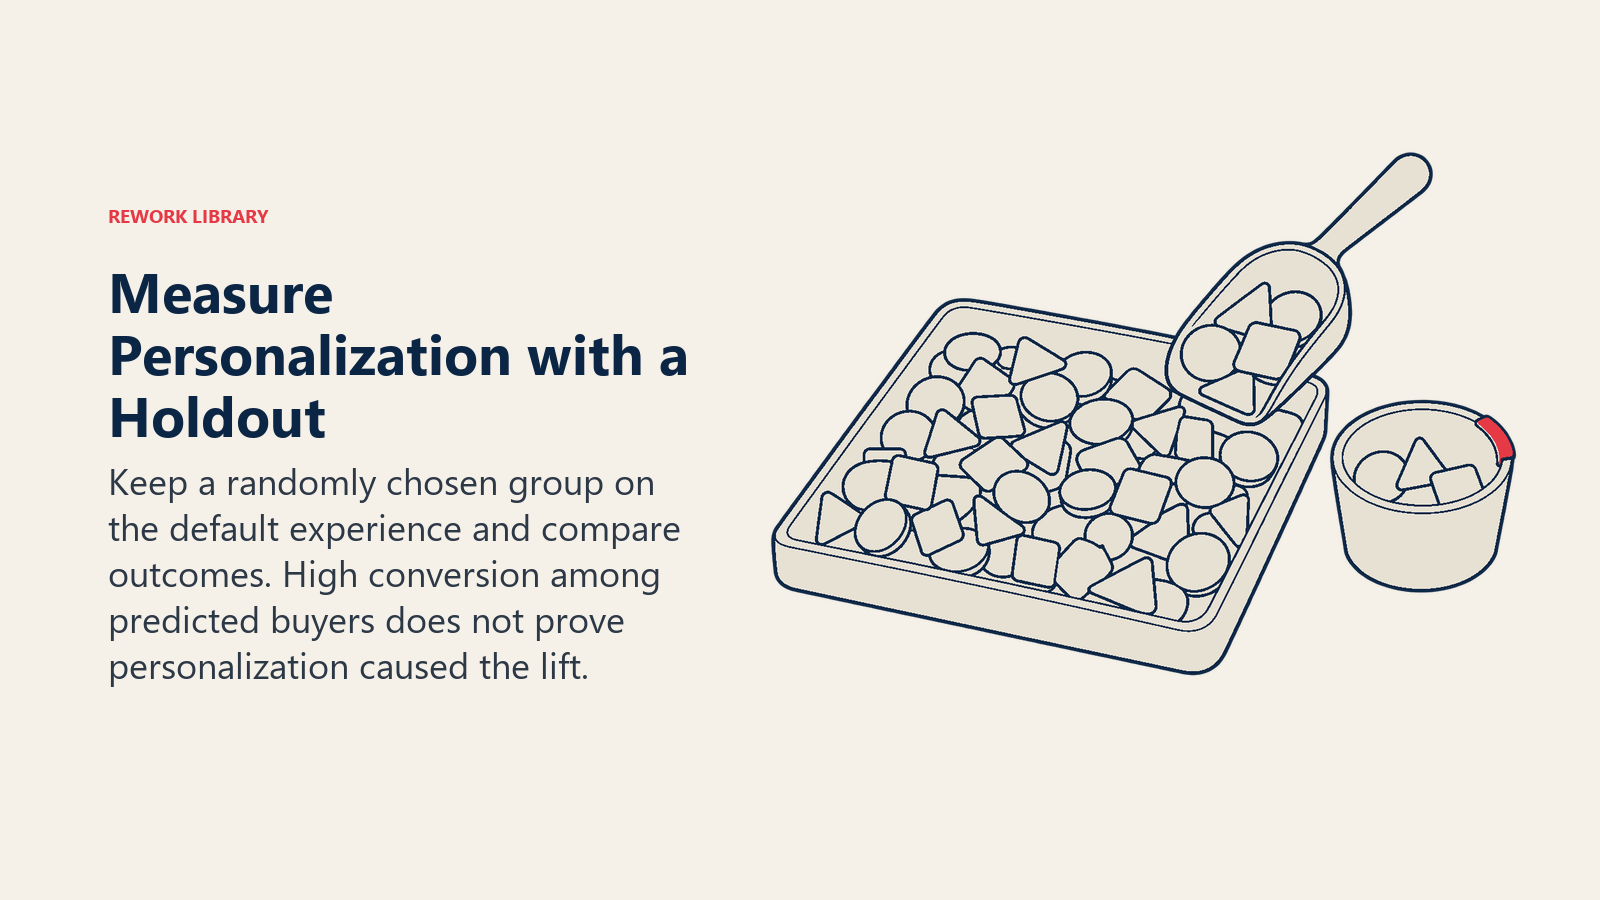
- Halten Sie immer eine Kontrollgruppe zurück. Lassen Sie einen zufällig gewählten Anteil berechtigter Besucher beim Standarderlebnis. Ohne diese Gruppe können Sie nicht trennen zwischen „die Personalisierung hat gewirkt“ und „Menschen, die ohnehin kaufen wollten, bekamen eine personalisierte Seite“.
- Achten Sie auf verzerrte Ergebnisse. Wenn das Modell Besucher anspricht, von denen es ohnehin vorhersagt, dass sie konvertieren, sagt ein Anstieg ihrer Conversion-Rate wenig über die Personalisierung.
- Beachten Sie die Erosion. Viele kleine Segmente bedeuten kleine Stichproben, und das Problem der multiplen Vergleiche kehrt zurück.
- Achten Sie auf Einwilligung und Datengrenzen. Personalisierung hängt von Daten ab, die Sie nutzen dürfen. Bauen Sie sie auf First-Party-Daten und der Einwilligung auf, die Sie eingeholt haben.
Beginnen Sie mit einer Seite mit viel Traffic und zwei oder drei Segmenten, die Sie in einem Satz erklären können. Komplexität, die Sie nicht erklären können, ist Komplexität, die Sie nicht debuggen können.
Schritt für Schritt: KI in ein CRO-Programm einführen
- Klären Sie zuerst die Messung. Stellen Sie sicher, dass Conversions korrekt und geräteübergreifend einheitlich erfasst werden. KI auf kaputter Analytik macht Fehler nur schneller.
- Wählen Sie eine einzelne Seite und eine primäre Kennzahl. Eine Preisseite, ein Anmeldeformular, eine Produktseite oder ein Checkout-Schritt. Notieren Sie die Baseline der Conversion-Rate.
- Nutzen Sie KI zur Beobachtung. Führen Sie Session-Clustering und Erkennung von Reibung durch und fassen Sie Umfrage- und Support-Texte für diese Seite zusammen. Lassen Sie eine Person die Ergebnisse prüfen.
- Erzeugen und stutzen Sie Hypothesen. Bitten Sie um Hypothesen in festem Format (Problem, Änderung, erwarteter Effekt, Kennzahl). Streichen Sie alles Generische. Behalten Sie die fünf, die Sie einem skeptischen Kollegen erklären könnten.
- Schätzen Sie die Stichprobengröße vor dem Start. Legen Sie Ihren minimal nachweisbaren Effekt fest, berechnen Sie den nötigen Traffic und prüfen Sie, ob die Seite ihn in angemessener Zeit liefern kann. Wenn nicht, testen Sie eine mutigere Änderung oder einen Schritt mit mehr Traffic. Zum Aufbau siehe das A/B-Test-Framework.
- Wählen Sie die Methode bewusst. A/B mit festem Horizont für Entscheidungen, die Sie verteidigen müssen; sequenzielle Methoden, wenn Sie kontinuierlich überwachen müssen; Bandits für kurze Zeitfenster mit einer einzigen Kennzahl.
- Legen Sie den Plan vorab fest. Halten Sie die primäre Kennzahl, die Laufzeit oder Stoppregel und die zu prüfenden Segmente schriftlich fest. Widerstehen Sie dem Ändern mitten im Test.
- Prüfen Sie die Datenqualität vor den Ergebnissen. Bestätigen Sie, dass die Traffic-Aufteilung stimmt und das Tracking für jede Variante ausgelöst hat.
- Lesen Sie Ergebnisse mit Demut. Schauen Sie auf das Konfidenzintervall, nicht nur auf das Etikett „Gewinner“. Ein „Gewinn“, dessen Intervall winzige und große Effekte umfasst, ist noch keine Zahl, mit der Sie planen können.
- Bestätigen Sie große Gewinne. Wiederholen Sie überraschende oder folgenreiche Ergebnisse oder halten Sie nach dem Launch einen Teil des Traffics auf der alten Version zurück, um zu prüfen, dass der Zuwachs bleibt.
Wo das im Verhältnis zu den anderen KI-Anwendungsfällen entlang der Customer Journey steht, zeigt KI-Marketing-Anwendungsfälle nach Funnel-Phase, und zu den Tools drumherum der KI-Marketing-Stack.
Häufige Fehler
- KI Gewinner erklären lassen. Automatisch hochgestufte Varianten sind nur so gut wie die Statistik darunter. Wissen Sie, welche Methode Ihr Tool nutzt.
- Peeking bei einem Test mit festem Horizont. Die häufigste Quelle falscher Gewinne.
- Zu viele Varianten bei zu wenig Traffic testen. Mehr Varianten bedeuten weniger Daten pro Variante und mehr Chancen auf einen Zufallstreffer.
- Segmenten im Nachhinein nachjagen. „Es hat bei Mobilnutzern in Ohio funktioniert“ ist eine neue Hypothese.
- Die Kontrollgruppe bei der Personalisierung auslassen. Keine Holdout-Gruppe, kein Beweis.
- Die falsche Kennzahl optimieren. Eine Variante, die Klicks steigert, aber qualifizierte Leads oder Umsatz pro Besucher senkt, ist ein Verlust. Wählen Sie eine Kennzahl, die an den Geschäftswert gekoppelt ist.
Wichtige Fakten
- Wiederholte Signifikanztests (Peeking) erhöhen die Rate falsch positiver Ergebnisse; in einem ungünstigsten Beispiel führte das Stoppen beim ersten Messwert mit 5 % Signifikanz innerhalb von 150 Beobachtungen in 26,1 % der Fälle zu einem falsch positiven Ergebnis (Evan Miller, 18. April 2010).
- In Optimizelys eigenen Simulationen von Tests ohne echten Unterschied erklärten mehr als 57 % mindestens einmal einen Gewinner oder Verlierer, wenn nach jedem Besucher unter klassischer Statistik geprüft wurde (Optimizely, 20. Januar 2015).
- A/B-Tests explorieren während ihrer gesamten Laufzeit, um Effekte präzise zu messen; Bandits erkunden und nutzen parallel, passen aber schlecht, wenn Sie einen statistisch belastbaren Gewinner brauchen (VWO / Wingify).
- Ein Sample Ratio Mismatch, bei dem die beobachtete Traffic-Aufteilung von der erwarteten abweicht, signalisiert Datenqualitätsprobleme und wird mit einem einfachen statistischen Test erkannt (Fabijan et al., KDD 2019).
- Neuheitseffekte klingen ab und Primäreffekte bauen sich mit der Zeit auf, und Experimente sind oft zu kurz, um eines von beiden zu zeigen (Sadeghi et al., arXiv, 18. Februar 2021).
- KI ist im CRO dort am sichersten, wo eine Person die Ausgabe prüft, bevor Besucher sie sehen, und dort am riskantesten, wo sie ohne vorab festgelegten statistischen Plan Live-Entscheidungen über Traffic trifft.
Häufig gestellte Fragen zu KI für Conversion-Optimierung
Was ist KI-Conversion-Optimierung?
Es ist der Einsatz von maschinellem Lernen und generativer KI zur Unterstützung der CRO-Arbeit: Session-Aufzeichnungen clustern, Feedback zusammenfassen, Testideen entwerfen und reihen, Traffic mit Bandit-Algorithmen verteilen und Seiten personalisieren. Sie beschleunigt das Finden und Einordnen von Problemen. Der Nachweis, dass eine Änderung wirkt, hängt weiterhin von sauberem Experimentdesign ab.
Sind Bandit-Tests besser als A/B-Tests?
Keines von beiden ist pauschal besser. Bandits verlagern den Traffic während des Tests zur führenden Variante, was zu kurzen Zeitfenstern und Zielen mit einer Kennzahl passt. A/B-Tests halten eine gleichmäßige Aufteilung und liefern sauberere Schätzungen, was zu Entscheidungen passt, die Sie verstehen und verteidigen müssen, einschließlich einer anschließenden Segmentanalyse.
Was ist Peeking, und warum ist es ein Problem?
Peeking heißt, einen laufenden Test zu prüfen und zu stoppen, wenn er signifikant aussieht. Übliche Tests setzen einen einzigen Blick bei vorab festgelegter Stichprobengröße voraus, wiederholte Prüfungen erhöhen daher die Chance, einen Gewinner auszurufen, der nicht echt ist. Legen Sie die Stichprobengröße vorab fest oder nutzen Sie eine Plattform, die für sequenzielles Testen gebaut ist.
Kann KI-Personalisierung die Conversion schädigen?
Ja. Schlecht ausgerichtete Personalisierung kann irrelevante Inhalte zeigen, und ohne eine zufällig gewählte Holdout-Gruppe können Sie nicht sagen, ob sie geholfen hat. Halten Sie eine Kontrollgruppe vor und messen Sie gegen das Standarderlebnis.
Wie viel Traffic brauche ich für CRO-Tests?
Das hängt von Ihrer Baseline der Conversion-Rate und dem kleinsten Zuwachs ab, den Sie nachweisen wollen. Kleinere Zuwächse brauchen deutlich mehr Traffic. Berechnen Sie die nötige Stichprobengröße vor dem Start, und wenn die Seite sie nicht in angemessener Zeit liefern kann, testen Sie eine mutigere Änderung oder einen Schritt mit mehr Traffic.
Sollte KI meine Testvarianten schreiben?
Sie ist eine gute Quelle für erste Entwürfe und Alternativen. Eine Person sollte jede Aussage, den Ton und eventuelle Compliance-Anforderungen prüfen, bevor eine Variante live geht, und generische Ideen streichen, die nicht zu dem passen, was Ihre eigenen Daten zeigen.

Principal Product Marketing Strategist
On this page
- Wo KI im CRO-Zyklus ansetzt
- Probleme finden: Session-Analyse und Verhaltenserkenntnisse
- Hypothesen erzeugen und priorisieren
- Testmethoden: A/B, multivariat und Bandits
- Statistische Fallstricke, die KI nicht behebt
- Peeking
- Falsch positive Ergebnisse und multiple Vergleiche
- Sample Ratio Mismatch
- Neuheits- und Primäreffekte
- Bandits und das Schätzproblem
- Personalisierung: was KI hinzufügt und wie Sie sie messen
- Schritt für Schritt: KI in ein CRO-Programm einführen
- Häufige Fehler
- Wichtige Fakten