AI顧客セグメンテーション:静的リストから行動ベースのセグメントへ
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
AI顧客セグメンテーションとは、機械学習を使い、年齢、役職、地域といった固定の属性ではなく、顧客が「何をしているか」と「次に何をしそうか」でグループ分けすることです。グループは行動(訪問、購入、商品の閲覧、メールへの反応)から作られ、新しいデータが届くたびに自動で更新されます。購入や解約といった将来の行動の確率でスコアリングされることも少なくありません。
人口統計のリストが教えてくれるのは、相手がどんな人かです。行動ベースのセグメントが教えてくれるのは、相手がいま何をしているかです。この違いは重要です。リスト上の35歳のマーケティングマネージャー2人が、まったく違う行動を取ることがあるからです。1人は1週間に料金ページを3回読み、もう1人は1年前にニュースレターを1通開いただけです。静的リストは2人を同じに扱います。行動ベースのセグメントはそうしません。
本記事は、基本をすでに理解していて、AIの層が何を加えるのかを知りたいマーケティングマネージャーやグロース責任者を対象としています。AIセグメントの3つの種類(行動、予測、類似)、各プラットフォームが実際に提供する機能、段階的な導入方法、つまずきやすい点を取り上げます。まず基礎を押さえたい場合は、Eコマースの顧客セグメンテーションから始めてください。背景にある統計手法については、ビジネスにおけるクラスタリングを参照してください。
静的リストとAIセグメントの違い
従来のセグメンテーションは、一度きりの分類です。誰かがルール(「地域がEMEAかつ従業員数が200人超」)を作り、リストを書き出し、誰かが更新を思い出すまでそのリストを使い続けます。透明性が高く、営業チームに説明しやすく、コストも低いという確かな強みがあります。一方で、3つの弱点もあります。
- 古くなります。 所属は、誰かがルールを再実行したときにしか変わりません。
- 属性は見えても、意図は見えません。 人口統計はプロフィールを表すだけで、購買のタイミングは表しません。
- 限界があります。 手作業で作ったルールは、数個のセグメントを超えると維持が難しくなります。
AIセグメンテーションは、その仕組みを変えます。セグメントは行動データのパターンで定義され、所属は継続的に再計算され、有用なセグメントの数もチームが管理できるルールの数に縛られません。パーソナライゼーションエンジンのパターンは、この方向の極端な形を示しています。1人ひとりにプロフィールを持たせ、やり取りのたびに更新するというものです。ほとんどのマーケティングチームはその中間のどこかにいますが、それで問題ありません。
| 静的リストによるセグメンテーション | AIによる行動セグメンテーション | |
|---|---|---|
| 定義の方法 | あらかじめ選んだ属性 | 行動データから見つけたパターン |
| 更新 | 手動 | 自動(多くは毎日) |
| 典型的な問い | 「ミッドマーケット層に含まれるのは誰か」 | 「今週購入しそうなのは誰か」 |
| 強み | 明快で監査しやすく、説明しやすい | 意図に反応し、想定していなかったグループを見つけられる |
| 弱点 | 古くなりやすく、浅く、拡張しにくい | クリーンなデータと人によるチェックが必要 |
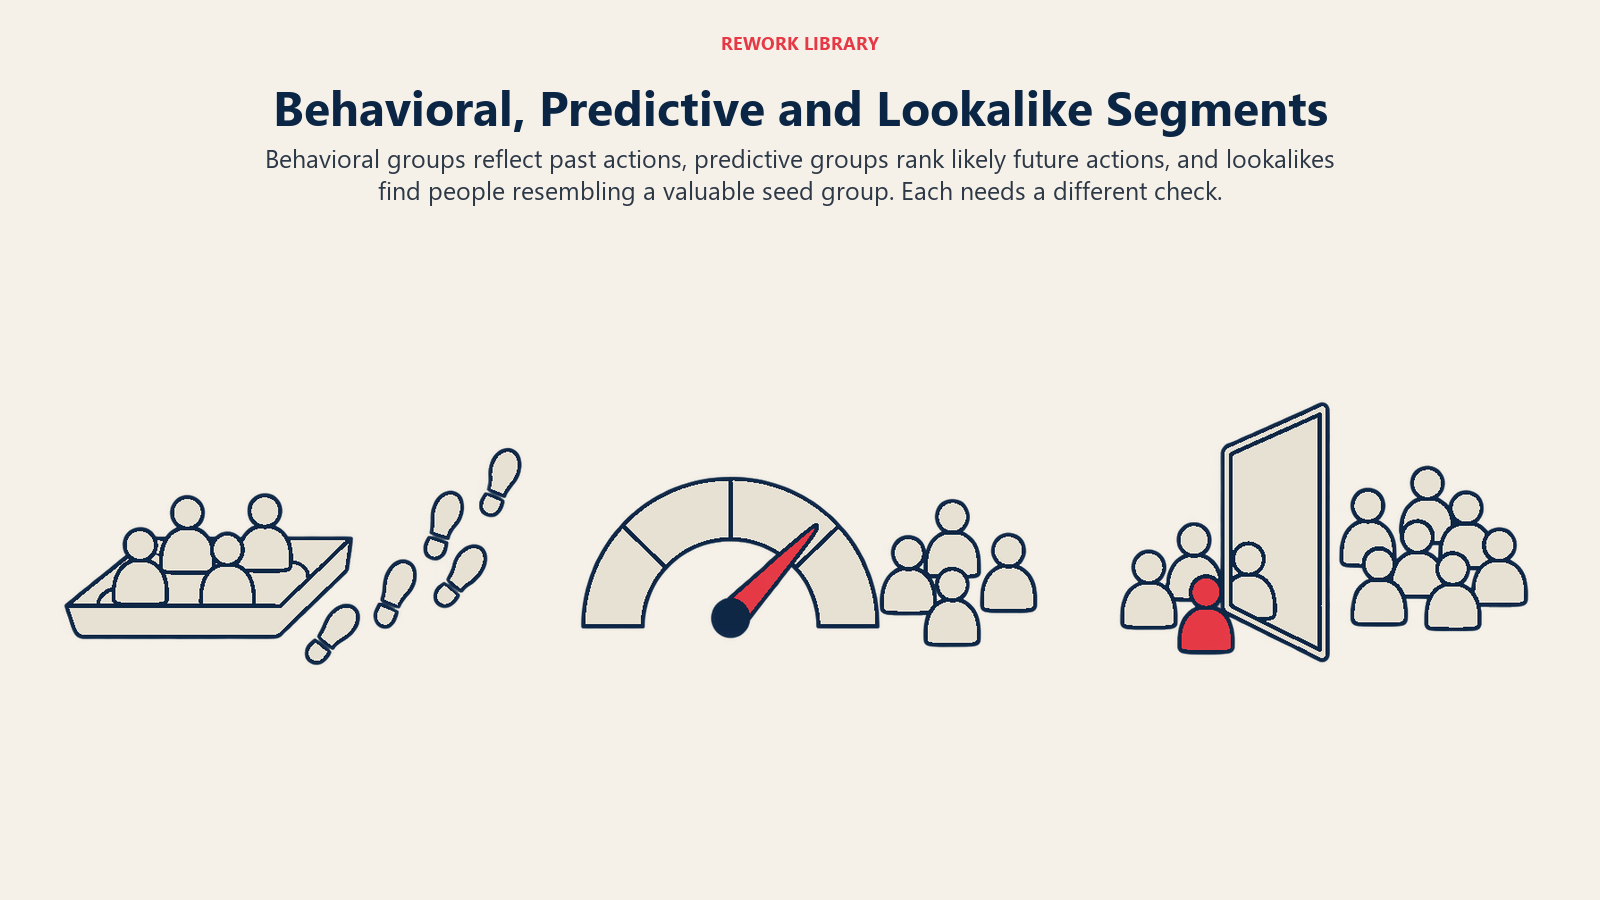
AIセグメントの3つの種類
多くのツールは、これらを組み合わせて提供しています。どれを使っているかが分かれば、必要なデータと評価の仕方も分かります。
行動セグメント
行動セグメントは、人々がしてきたこと(閲覧したページ、カートに入れた商品、使った機能、クリックしたメール、購入頻度)でグループ化します。自分で書くルール(「7日間に料金ページを2回閲覧した」)もあれば、クラスタリングから生まれるものもあります。クラスタリングでは、何を探すかを指示しなくても、アルゴリズムが似た顧客のグループを見つけます。クラスタリングの強みは、自分では定義しなかったパターン、たとえば販促期間にしか購入しないグループを見つけられることです。弱みは、アルゴリズムが出すのはグループであり、名前や意味ではないことです。各クラスタが何を表すのかは、人が読んで判断しなければなりません。グループがどう作られるかは、クラスタリングの記事で解説しています。
予測セグメント
予測セグメントは、将来の行動の可能性で人をランク付けします。多くのプラットフォームが製品化しているのはこのタイプなので、ドキュメントも具体的です。Google Analytics 4(GA4)には3つの予測指標があります。購入の可能性は、直近28日間にアクティブだったユーザーが、今後7日以内に特定のキーイベントを記録する確率です。解約の可能性は、直近7日間にアクティブだったユーザーが、今後7日間にアクティブにならない確率を推定します。予測収益は、ユーザーが今後28日間に使う金額を推定します。GA4はこれらのスコアから推奨オーディエンスを作り、推奨オーディエンスの定義にはパーセンタイルの基準が使われています。解約の可能性が80パーセンタイル超、購入の可能性が90パーセンタイル超、そして上位購入者のオーディエンスでは予測収益が95パーセンタイル超です。
Klaviyoも、Eコマース向けに同じことをしています。予測分析では、各プロフィールに、予測顧客生涯価値(今後1年間の想定支出額)、解約リスク、平均注文間隔、次回注文の予想日が表示されます。Klaviyoは、予測は個人よりも顧客のグループ全体でこそ信頼できると述べています。これは、あらゆる予測セグメントに当てはまる良い原則です。スコアはグループの優先順位付けに使うものであり、個人への判決ではありません。こうした価値スコアの作り方は、AIによる顧客生涯価値の予測を参照してください。
類似セグメント
類似(ルックアライク)セグメントは、最良の顧客など、すでに価値を認めているグループを出発点にして、そのグループに似た新しい人々を見つけます。マッチングはプラットフォームが、こちらからは見えないシグナルを使って行います。文書化された最も分かりやすい例が、Googleのカスタマーマッチです。顧客リストをアップロードすると、それらの顧客に加え、似た人々にも広告を届けられます。YouTubeでは、最も価値の高い顧客に似たセグメントを広告主がターゲットにできると、同ページは説明しています。また、スマート自動入札と最適化されたターゲティングには、オプトアウトしない限りカスタマーマッチのリストが自動的に含まれるとも書かれています。これは知っておく価値があります。意図していなくても、リストが配信に影響している可能性があるからです。こうした自動オーディエンスが入札とどう作用し、どこまで自分でコントロールできるかは、有料広告におけるAIで取り上げています。
類似セグメントの質は、元になるシード(種)のリストで決まります。これまでに登録した全員をシードにすれば、幅広い平均的なオーディエンスになります。2回更新した顧客をシードにすれば、狙いにずっと近いものになります。
プラットフォームが求める条件
文書化されている要件を見ると、小規模なデータや整っていないデータではAIセグメンテーションがなぜうまくいかないのかが分かります。プログラムを計画する前に、これらを確認してください。
| プラットフォームの機能 | 生成されるもの | 文書化されている要件 |
|---|---|---|
| GA4の予測オーディエンス | 購入、解約、収益に基づくオーディエンス | 28日以内の7日間に、予測条件を満たしたリピートユーザーが1,000人以上、満たさなかったユーザーが1,000人以上。モデルの品質が継続的に保たれていること。purchaseイベントにvalueとcurrencyが必要 |
| Klaviyoの予測分析 | 予測CLV、解約リスク、次回注文日 | 注文経験のある顧客が500人以上、180日分の注文履歴(直近30日以内の注文を含む)、そして3回以上注文した顧客がいること |
| Googleカスタマーマッチ | アップロードした顧客と類似する人々へのターゲティング | メンバーシップは540日で失効。リストを有効に保つには、その期間内に100人以上のメンバーを追加または更新する必要がある |
出典:GA4の予測指標、Klaviyo、Google広告のカスタマーマッチ。GA4のページには、予測は毎日生成されること、そしてモデルの品質が最低基準を下回ると更新が止まり、予測が利用できなくなる場合があることも書かれています。つまり、予測オーディエンスは気づかないうちに消えることがあります。チェックの仕組みを入れてください。
これらの基準は、「自社は準備ができているか」という問いへの実際的な答えです。顧客が300社のB2B企業は、数千件のイベントを前提とした予測購入モデルを使えません。それでも行動ルールは使えますし、CRMをもとにした類似セグメントも使えますが、データにないパターンをモデルが見つけてくれると期待してはいけません。
機能別の事例
セグメントは、誰かが行動に移して初めて意味を持ちます。チームごとに、どのような形になるかを見てみましょう。
メールとライフサイクルマーケティング。 ルールベースのライフサイクルセグメント(新規、アクティブ、離脱しかけ)を土台として残し、その上に予測スコアを重ねて、メッセージの強さを決めます。離脱しかけていて可能性の高い顧客には、個別のリマインダーを送ります。可能性の低い顧客には、軽めの接点にとどめます。具体的な手順はAIメールマーケティングにあります。
ペイドメディア。 データベース全体ではなく、最良の顧客をシードとしてアップロードし、拡張だけでなく除外にも使います。既存顧客を新規獲得キャンペーンから外せば、すでに購入した人に届けるために費用を払わずに済みます。
Eコマースのマーチャンダイジング。 割引日にしか購入しない顧客クラスタには、定価で補充用の商品を買うクラスタとは別のトップページとオファーを用意します。セグメントがメッセージを決めるのであって、その逆ではありません。
B2Bのデマンドジェネレーション。 料金ページへの繰り返しの訪問、ウェビナーへの参加、製品ドキュメントの閲覧といった行動シグナルから、「購買検討中」のセグメントを定義できます。営業はそのセグメントに1日以内にフォローアップします。これはリードスコアリングと密接に関わるもので、アカウントベースドマーケティングのためのAIと併せて機能します。
カスタマーサクセス。 解約の可能性は、ウォッチリストになります。スコアが上がったら、顧客が解約した後ではなく、解約する前に連絡を入れます。
ステップごとに:導入の進め方
- セグメントが変える意思決定を1つ選びます。 「誰にウィンバックのオファーを送るか」は意思決定です。「顧客をもっと理解する」は違います。意思決定がなければ、セグメントはただのレポートです。
- データを監査します。 取得しているイベント、Web、アプリ、メール、CRMをまたいで本人がどうつながっているか、購入記録がどれだけ整っているかを一覧にします。土台づくりについては、AIマーケティングのためのファーストパーティデータで解説しています。
- ルールから始めます。 行動セグメントを3〜4個、手作業で作ります。自社のデータで何が重要かが分かり、超えるべきベースラインもできます。
- 基準を満たす場合に、予測の層を加えます。 まずはプラットフォーム自身のモデルを使います。有効にする前に、上の表の最低条件を確認してください。
- すべてのセグメントに分かりやすい名前をつけます。 「クラスタ4」では、コピーライターには役に立ちません。「割引をきっかけにリピートする購入者」なら、チームが書き分けられます。
- 配信前にサンプルを確認します。 各セグメントから20人を取り出し、グループ分けがビジネス上意味を成しているかを確認します。共通点を説明できないなら、そのグループに合わせたメッセージは送らないでください。
- コントロールと比較してテストします。 各キャンペーンでランダムな一部を配信対象から外し、結果を比べます。ターゲティングなしのコントロールに勝てないセグメントは、存在する価値がありません。
- 更新とレビューのリズムを決めます。 セグメントは、製品、価格、顧客の変化とともにずれていきます。誰かが苦情を言ったときではなく、カレンダーに沿ってレビューします。
- 成果の出ないものは廃止します。 同じ行動につながる多数のセグメントより、異なる行動につながる少数のセグメントのほうが優れています。
プライバシーと同意
セグメンテーションはプロファイリングであり、多くの地域でプロファイリングには法的な重みがあります。GDPRの第21条は、ダイレクトマーケティング(それに関連するプロファイリングを含む)のための処理に対し、本人がいつでも異議を述べる権利を認めており、異議が述べられた後は、その目的でデータを使えなくなります。第22条は、法的効果または同様に重大な影響を及ぼす場合に、プロファイリングを含む自動処理のみに基づく決定の対象とされない権利を定めています。通常のマーケティングセグメントが後者の基準に達することはまれですが、価格設定、与信、適格性の判断では該当する可能性があります。
実務上は、オプトアウトをすべてのセグメントとアップロードするすべてのリストに反映し、各データがどこから来たかを記録し、センシティブな属性を推測しないようにします。アップロードする顧客リストについては、プラットフォームごとのルールが別途条件を定めているので、アップロード前に読んでください。通常のマーケティング利用の範囲を超えるセグメントは、法務またはプライバシー責任者にレビューを依頼してください。
重要なポイント: AI顧客セグメンテーション
- GA4の購入の可能性は、アクティブなユーザーが今後7日以内にキーイベントを記録するかどうかを推定します。解約の可能性と予測収益は、7日間と28日間の期間を対象としています(Google Analyticsヘルプ)。
- GA4の予測オーディエンスには、予測条件を満たしたリピートユーザーが1,000人以上、満たさなかったユーザーが1,000人以上必要です(Google Analyticsヘルプ)。
- GA4の推奨オーディエンスはパーセンタイルの基準を使っています。解約は80超、購入は90超、予測収益は95超です(Google Analyticsヘルプ)。
- Klaviyoの予測分析には、注文経験のある顧客500人以上と180日分の注文履歴が必要です。また、予測は個人ではなくグループ全体でこそ信頼できるとしています(Klaviyoヘルプセンター)。
- Googleカスタマーマッチを使うと、アップロードした顧客と、その顧客に似た人々に広告を届けられます。リストを有効に保つには、540日以内に100人以上のメンバーを追加または更新する必要があります(Google広告ヘルプ)。
- GDPR第21条により、本人はダイレクトマーケティングに関連するプロファイリングにいつでも異議を述べることができ、その後はそのデータをその目的に使えなくなります(GDPR条文)。
よくある落とし穴
- 意思決定のないセグメンテーション。 顧客グループの美しいマップも、グループごとに変わるキャンペーン、オファー、営業アクションがなければ、何も変えません。
- 間違ったリストでの類似セグメントのシード。 差別化されていないシードからは、差別化されていないオーディエンスが生まれます。最も価値の高い顧客を使ってください。
- 少ないデータでスコアを信用すること。 プラットフォームの最低基準を下回ると、予測は自信ありげなラベルのついたノイズです。
- 確率を事実として扱うこと。 90パーセンタイルのスコアは「ほとんどの人より可能性が高い」という意味であり、「購入する」という意味ではありません。
- 人によるチェックを省くこと。 クラスタは数学的なものであり、意味があるとは限りません。誰かが読み解く必要があります。
- セグメントが多すぎること。 それぞれに別のメッセージを書けないなら、統合してください。
- セグメントを放置して腐らせること。 モデルは再学習され、顧客の行動も変わります。1年前に作ったセグメントは、誰も表していないかもしれません。
- 同意シグナルを無視すること。 配信停止した、または異議を述べた連絡先がアップロードしたリストに残っていれば、コンプライアンス上の問題であり、ブランド上の問題でもあります。
- エンゲージメントだけで判断すること。 セグメントのクリック率が高くても、収益の証明にはなりません。コントロールと比べて、その後の成果を確認してください。

Principal Product Marketing Strategist