AI untuk Pengoptimuman Kadar Penukaran: Ujian, Pemperibadian dan Wawasan
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
AI untuk pengoptimuman kadar penukaran (CRO) bermaksud menggunakan pembelajaran mesin dan AI generatif untuk mencari di mana pelawat keluar, mencadangkan dan mengutamakan perubahan untuk diuji, memperuntukkan trafik antara varian, dan menyesuaikan halaman kepada pelawat yang berbeza. Ia mempercepatkan separuh pertama CRO, iaitu mencari masalah dan membentuk hipotesis. Ia tidak mengubah separuh kedua. Sama ada sesuatu perubahan benar-benar meningkatkan penukaran masih soalan statistik, dan alat AI boleh menjadikan anda lebih mudah menipu diri sendiri, bukan lebih sukar.
Itulah benang merah panduan ini. Jika digunakan dengan baik, AI memendekkan kitaran daripada "ada sesuatu yang tidak kena" kepada "ini ujian yang wajar dijalankan." Jika digunakan sambil lewa, ia menghasilkan longgokan "pemenang" yang yakin tetapi lenyap selepas pelancaran. Jika anda baharu dengan asasnya, mulakan dengan asas pengoptimuman kadar penukaran untuk SaaS atau untuk ecommerce, kemudian kembali ke sini untuk lapisan AI.
Di mana AI sesuai dalam kitaran CRO
Program CRO ialah satu gelung: perhatikan tingkah laku, bentuk hipotesis, uji, belajar, ulang. AI membantu pada titik berbeza dalam gelung itu, dan tahap risikonya berbeza pada setiap satu.
| Peringkat CRO | Apa yang AI lakukan | Risiko jika ia silap |
|---|---|---|
| Perhati | Mengelompokkan sesi, meringkaskan rakaman, menandakan rage click dan jalan buntu | Rendah: anda menyemak dapatannya |
| Hipotesis | Menyediakan draf idea ujian daripada analitik, tinjauan dan ulasan; menyusunnya | Rendah: idea murah |
| Bina varian | Menyediakan draf tajuk, salinan dan pilihan reka letak | Sederhana: varian yang lemah atau tidak selari jenama membazirkan trafik |
| Jalankan ujian | Memperuntukkan trafik (bandit), menjalankan kombinasi multivariat | Tinggi: statistik yang buruk menghasilkan pemenang palsu |
| Peribadikan | Memilih kandungan bagi setiap segmen pelawat atau individu | Sederhana: pengalaman yang menakutkan atau salah, sukar diukur |
| Belajar | Meringkaskan keputusan dan mencadangkan susulan | Sederhana: ringkasan boleh melebih-lebihkan kepastian |
Corak yang perlu diperhatikan: AI paling selamat di mana seseorang menyemak outputnya sebelum apa-apa sampai kepada pelawat, dan paling berisiko di mana ia membuat keputusan langsung ke atas trafik. Selebihnya panduan ini mengikut kecerunan itu.
Mencari masalah: analisis sesi dan wawasan tingkah laku
Kebanyakan program CRO bermula dengan satu soalan: di mana orang pergi, dan mengapa? Analitik kuantitatif memberitahu anda di mana. Rakaman sesi, peta haba, tinjauan dan tiket sokongan membayangkan mengapa. Masalahnya sejak dahulu ialah volum. Tiada sesiapa menonton 10,000 rakaman.
AI membantu dalam tiga cara:
- Pengelompokan sesi. Model mengelompokkan rakaman mengikut corak tingkah laku, seperti pelawat yang menatal ke harga dan keluar, atau yang berulang kali mengklik elemen yang bukan pautan. Anda menonton segelintir daripada setiap kelompok dan bukan sampel rawak.
- Pengesanan geseran. Alat menandakan rage click, ralat medan borang berulang, navigasi ulang-alik dan troli yang ditinggalkan sebagai tempat bermasalah calon.
- Ringkasan kualitatif. Model bahasa membaca jawapan tinjauan teks terbuka, transkrip sembang, ulasan dan teks tiket, kemudian mengelompokkannya kepada tema. "Tidak pasti sama ada penghantaran percuma" yang muncul dalam 300 komen ialah hipotesis yang tidak perlu anda cari.
Anggap semua ini sebagai petunjuk, bukan keputusan. Kelompok ialah corak dalam data, dan corak boleh jadi kebetulan atau artifak cara sesi disampel. Peraturan yang memastikan pasukan jujur: setiap wawasan yang dikesan AI menjadi hipotesis yang diuji, bukan perubahan yang terus dihantar ke laman. Data tingkah laku yang baik juga bergantung pada apa yang anda kumpulkan pada mulanya, yang dibincangkan dalam data pihak pertama untuk pemasaran AI.
Menjana dan mengutamakan hipotesis
Hipotesis yang berguna menamakan masalah, perubahan, kesan yang dijangka dan metrik. "Pelawat di mudah alih tidak nampak jaminan, jadi mengalihkannya ke atas butang akan meningkatkan permulaan pembayaran" boleh diuji. "Baikkan halaman" tidak.
AI generatif pandai dalam volum di sini. Beri ia dapatan analitik anda, tema tinjauan, salinan semasa halaman dan khalayak, dan minta dua puluh hipotesis dalam struktur itu. Kemudian pangkas dengan tegas. Model cenderung mencadangkan amalan terbaik yang generik (tambah kecemasan, tambah bukti sosial) yang mungkin atau mungkin tidak sesuai dengan halaman anda, dan ia tidak dapat tahu kekangan anda yang mana satu benar.
Untuk keutamaan, pasukan lazimnya memberi skor idea mengikut impak, keyakinan dan usaha, menggunakan rangka kerja seperti ICE atau PIE. AI boleh mengisi skor draf pertama, tetapi berwaspadalah terhadap nombor "impak": ia hanya tekaan melainkan dikaitkan dengan trafik sebenar dan garis dasar sebenar. Penggunaan model yang lebih baik ialah sebagai pembantu menyusun, dengan manusia memiliki susunan akhir. Fikirkan berapa banyak ujian yang boleh anda jalankan secara realistik. Halaman yang mendapat beberapa ribu lawatan sebulan tidak dapat menyokong banyak eksperimen selari, jadi bajet trafik itu sendiri ialah input keutamaan. Rangka kerja ujian A/B membincangkan cara menstrukturkan tunggakan itu.
Kaedah ujian: A/B, multivariat dan bandit
Vendor AI mengaburkan nama kaedah ini, jadi membantu untuk mengasingkannya.
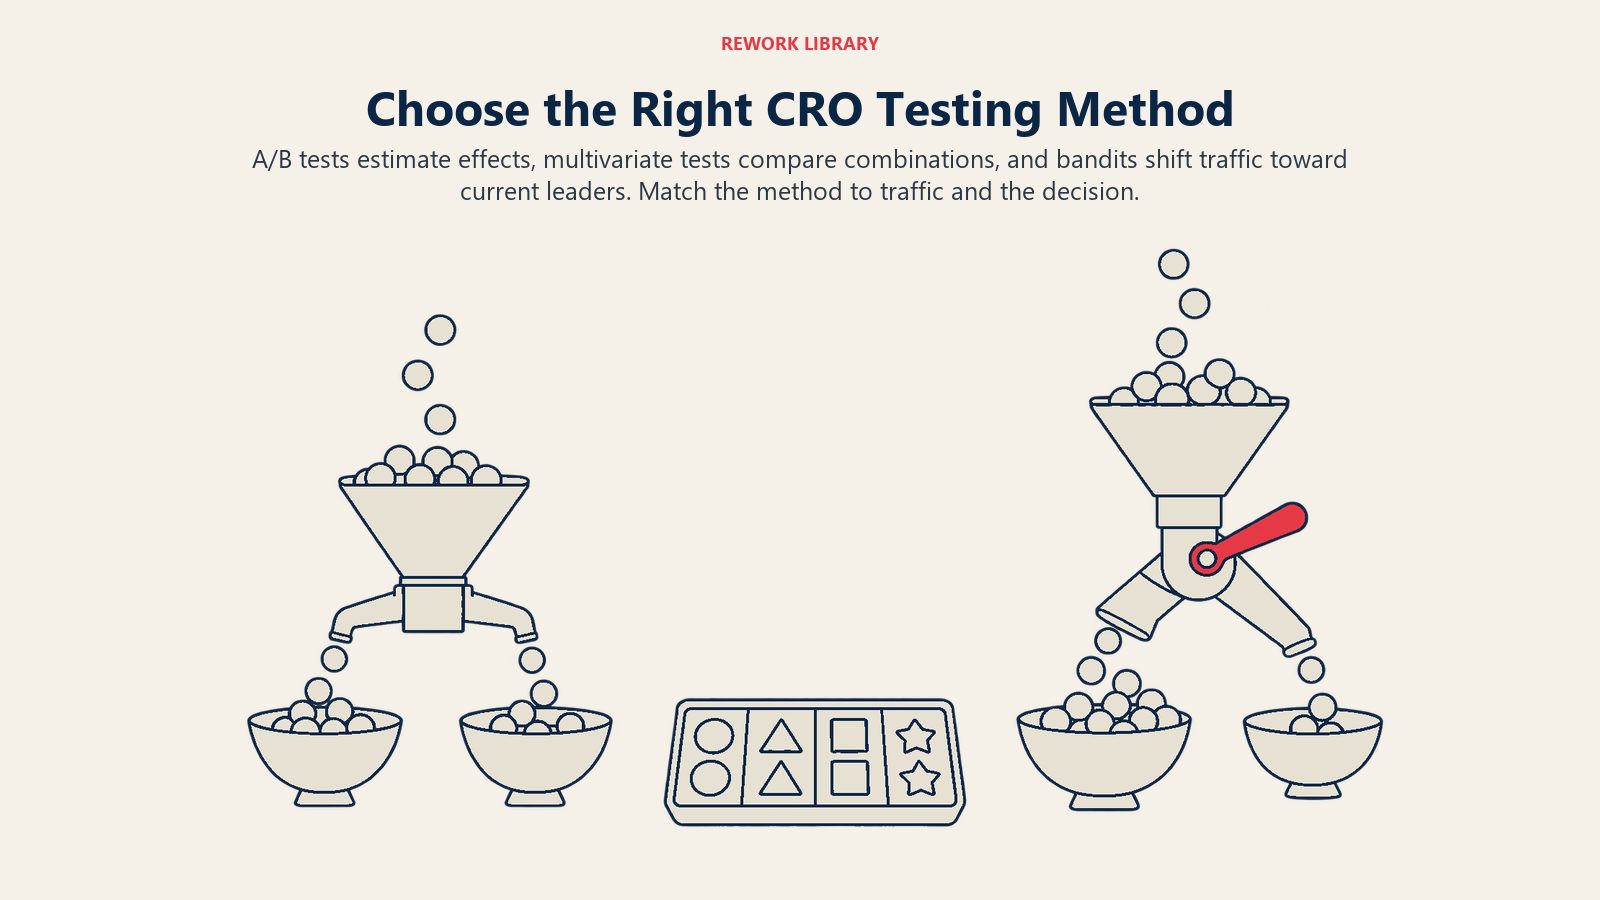
Ujian A/B membahagikan trafik secara sama rata antara kawalan dan satu atau lebih varian cukup lama untuk mengukur perbezaan. Matlamatnya ialah anggaran kesan yang boleh dipercayai.
Ujian multivariat mengubah beberapa elemen serentak (tajuk, imej, butang) dan mengukur setiap kombinasi. Ia boleh menunjukkan elemen mana yang penting, tetapi memerlukan trafik jauh lebih banyak daripada ujian A/B ringkas kerana trafik dibahagikan merentasi setiap kombinasi. Pada halaman trafik rendah, ia biasanya bermakna tiada apa mencapai signifikan.
Ujian bandit melaraskan pembahagian apabila data masuk, menghantar lebih banyak trafik kepada varian yang kelihatan menang. Di sinilah pembelajaran mesin melakukan kerja sebenar dalam ujian itu sendiri.
Wingify, yang menjual perisian ujian, menghuraikan pertukaran ini begini. Ujian A/B klasik kekal dalam mod penerokaan sepanjang larian kerana ia wujud untuk mengukur kadar penukaran dengan tepat, manakala bandit berbilang lengan meneroka dan mengeksploitasi secara selari, mengalihkan kebanyakan trafik kepada variasi yang kini kelihatan terbaik (VWO / Wingify tentang bandit berbilang lengan). Artikel yang sama menyenaraikan di mana setiap satu sesuai. Ujian A/B sesuai untuk keputusan yang memerlukan keyakinan terhadap kesan setiap varian, termasuk analisis segmen selepas itu. Bandit sesuai untuk kes di mana setiap penukaran yang hilang adalah mahal, tempohnya singkat (tawaran terhad masa, tajuk berita), atau anda hanya mengambil berat tentang satu metrik. Ia juga menyenaraikan had: bandit pilihan yang lemah apabila anda memerlukan pemenang yang teguh secara statistik, ia mengoptimumkan satu matlamat, dan varian yang berprestasi rendah mendapat terlalu sedikit trafik untuk menganggar kadar penukarannya dengan boleh dipercayai. Memandangkan penulisnya ialah vendor, bacalah ia sebagai satu pandangan pengamal, tetapi pertukaran yang dihuraikannya ialah yang piawai.
Peraturan keputusan yang mudah menyusul:
| Situasi | Padanan yang lebih baik |
|---|---|
| Keputusan sekali sahaja (halaman harga baharu, reka bentuk semula) yang akan anda hidup bersamanya selama berbulan-bulan | Ujian A/B ufuk tetap |
| Anda perlu tahu mengapa sesuatu menang, atau bagaimana prestasinya mengikut segmen | Ujian A/B |
| Kempen, tajuk atau promosi jangka pendek yang tempohnya akan tamat tidak lama lagi | Bandit |
| Banyak varian salinan berisiko rendah, satu metrik | Bandit |
| Beberapa elemen yang saling berinteraksi, trafik banyak | Multivariat |
| Trafik rendah | Uji perubahan yang lebih besar dengan lebih sedikit varian, bukan lebih banyak varian |
Perangkap statistik yang tidak dibaiki AI
Bahagian ini paling penting. Perkakasan automatik boleh menyembunyikan masalah statistik di sebalik papan pemuka yang kemas.
Peeking
Peeking bermaksud menyemak keputusan semasa ujian berjalan dan berhenti apabila ia kelihatan signifikan. Ujian signifikan piawai mengandaikan anda melihat sekali sahaja, pada saiz sampel yang ditetapkan lebih awal. Tulisan klasik Evan Miller menyatakannya dengan jelas: ujian signifikan berulang sentiasa meningkatkan kadar positif palsu. Dalam contoh kes terburuknya, ujian di mana versi baharu tidak berbuat apa-apa, berhenti pada tanda pertama signifikan 5% dalam 150 pemerhatian menghasilkan positif palsu sebanyak 26.1% daripada masa (Evan Miller, "How Not To Run an A/B Test", 18 April 2010). Pembaikannya: tentukan saiz sampel sebelum bermula dan jangan berhenti awal, atau gunakan reka bentuk yang dibina untuk pandangan berulang, seperti kaedah sekuensial atau Bayesian.
Optimizely membuat perkara yang sama apabila memperkenalkan Stats Engine. Dalam simulasinya sendiri bagi ujian tanpa perbezaan sebenar, menyemak selepas setiap pelawat menyebabkan lebih 57% ujian mengisytiharkan pemenang atau yang kalah sekurang-kurangnya sekali, dan pendekatan sekuensial menurunkan kadar ralat bagi semakan berterusan kepada 3% (Optimizely, 20 Januari 2015). Itu simulasi vendor sendiri, jadi anggap angka tepatnya sebagai ilustrasi. Arahnya yang mantap.
Jadi apa yang patut anda lakukan? Sama ada berkomitmen kepada saiz sampel tetap dan biarkan ujian sehingga ia dicapai, atau gunakan platform yang statistiknya secara jelas dibina untuk pemantauan berterusan (ujian sekuensial). Jangan gunakan alat ufuk tetap kemudian menontonnya setiap hari.
Positif palsu dan perbandingan berganda
Setiap metrik, varian dan segmen tambahan yang anda periksa ialah satu lagi peluang untuk bunyi bising kelihatan seperti isyarat. Ujian dengan lima varian, sepuluh metrik dan enam segmen mempunyai ratusan perbandingan. Sebahagiannya akan melepasi garis signifikan secara kebetulan. Ini masalah perbandingan berganda, dan "AI menemui segmen di mana varian B menang" ialah cara tepat ia menyelinap masuk. Segmen yang ditemui selepas kejadian ialah hipotesis untuk ujian baharu, bukan keputusan.
Pertahanannya mudah tetapi memerlukan disiplin: namakan satu metrik utama sebelum ujian, hadkan bilangan varian, anggap metrik sekunder dan potongan segmen sebagai penerokaan, dan sahkan kemenangan yang mengejutkan dengan larian semula.
Ketidakpadanan nisbah sampel
Jika anda bermaksud pembahagian 50/50 dan pembahagian sebenar pelawat jelas berbeza, sesuatu rosak dalam penugasan atau penjejakan, dan keputusan tidak boleh dipercayai. Penyelidik di Microsoft dan syarikat lain menyebutnya ketidakpadanan nisbah sampel (sample ratio mismatch), dan menghuraikannya sebagai gejala pelbagai masalah kualiti data, seperti demam menandakan banyak penyakit (Fabijan et al., KDD 2019). Mengesannya ialah semakan statistik yang mudah; mencari puncanya yang sukar. Banyak platform ujian menjalankan semakan itu secara automatik. Jika platform anda tidak, jalankan sendiri sebelum membaca sebarang keputusan. Ini terpakai kepada bandit juga, walaupun dengan peruntukan adaptif pembahagian yang dijangka tidak lagi tetap, jadi gunakan diagnostik platform itu sendiri.
Kesan kebaharuan dan keutamaan
Keputusan awal boleh mengelirukan atas sebab manusiawi. Penyelidik Microsoft mentakrifkan kebaharuan sebagai tarikan teknologi baharu, yang pudar dari semasa ke semasa, dan keutamaan sebagai penglibatan yang terbina apabila pengguna menerima pakai perubahan, dan menyatakan bahawa eksperimen biasanya terlalu singkat untuk menunjukkan salah satunya dengan jelas (Sadeghi et al., 2021). Secara praktikal: sepanduk baharu yang menarik mungkin menang pada minggu pertama kerana ia baharu, dan reka letak yang mengelirukan tetapi lebih baik mungkin kalah pada minggu pertama kerana pelanggan tetap memerlukan masa untuk menyesuaikan diri. Jalankan ujian merentasi kitaran perniagaan penuh (sekurang-kurangnya minggu penuh), perhatikan sama ada kesannya stabil atau hanyut, dan lebih berhati-hati dengan perubahan yang disasarkan kepada pelawat yang kembali.
Bandit dan masalah anggaran
Bandit menukar pengukuran yang bersih dengan pulangan yang lebih cepat. Kerana trafik beralih ke arah pendahulu awal, varian yang lebih lemah mengumpul sedikit data, jadi anda belajar kurang tentangnya, dan rentetan bertuah awal boleh mengunci pemenang yang salah. Itulah sebabnya artikel vendor di atas mengesyorkannya untuk tempoh singkat dan metrik tunggal dan bukan untuk keputusan yang perlu anda jelaskan dan pertahankan.
Pemperibadian: apa yang AI tambah dan cara mengukurnya
Pemperibadian di laman menunjukkan kandungan berbeza kepada pelawat berbeza: tajuk yang dipadankan dengan industri, cadangan produk berdasarkan semakan imbas, seruan tindakan berbeza untuk pelanggan yang kembali. Pembelajaran mesin menentukan siapa melihat apa, menggunakan isyarat seperti sumber, tingkah laku, lokasi, pembelian lalu atau niat yang diramalkan.
AI menambah tiga perkara berbanding pemperibadian berasaskan peraturan. Ia menemui segmen yang anda tidak akan takrifkan dengan tangan. Ia memberi skor kepada individu (kemungkinan membeli, churn, memerlukan bantuan) dan bertindak berdasarkan skor itu. Dan ia mengemas kini secara berterusan dan bukan menunggu seseorang menyemak semula peraturan. Untuk pandangan lebih mendalam tentang mekanismenya, lihat panduan enjin pemperibadian.
Mengukurnya lebih sukar daripada membinanya, atas beberapa sebab:
- Sentiasa tahan satu kawalan. Kekalkan bahagian pelawat layak yang dipilih secara rawak pada pengalaman lalai. Tanpa kumpulan itu, anda tidak dapat mengasingkan "pemperibadian berkesan" daripada "orang yang memang akan membeli mendapat halaman yang diperibadikan."
- Awasi keputusan yang terkeliru. Jika model menyasarkan pelawat yang sudah diramalkannya akan bertukar, peningkatan kadar penukaran mereka tidak menunjukkan banyak tentang pemperibadian.
- Perhatikan hakisan. Banyak segmen kecil bermakna sampel kecil, dan masalah perbandingan berganda kembali.
- Hormati persetujuan dan had data. Pemperibadian bergantung pada data yang anda dibenarkan gunakan. Bina di atas data pihak pertama dan persetujuan yang telah anda kumpulkan.
Mulakan dengan satu halaman trafik tinggi dan dua atau tiga segmen yang boleh anda jelaskan dalam satu ayat. Kerumitan yang tidak dapat anda jelaskan ialah kerumitan yang tidak dapat anda nyahpepijat.
Langkah demi langkah: menambah AI kepada program CRO
- Baiki pengukuran dahulu. Sahkan penukaran dijejaki dengan betul dan konsisten merentasi peranti. AI di atas analitik yang rosak hanya menjadikan ralat lebih pantas.
- Pilih satu halaman dan satu metrik utama. Halaman harga, borang pendaftaran, halaman produk atau langkah pembayaran. Tuliskan kadar penukaran garis dasar.
- Gunakan AI untuk pemerhatian. Jalankan pengelompokan sesi dan pengesanan geseran, dan ringkaskan teks tinjauan dan sokongan untuk halaman itu. Minta seseorang menyemak dapatannya.
- Jana dan pangkas hipotesis. Minta hipotesis dalam format tetap (masalah, perubahan, kesan dijangka, metrik). Potong apa-apa yang generik. Simpan lima yang boleh anda jelaskan kepada rakan sekerja yang skeptikal.
- Anggar saiz sampel sebelum melancarkan. Tentukan kesan minimum yang boleh dikesan, kira trafik yang anda perlukan, dan semak sama ada halaman itu dapat menyampaikannya dalam masa yang munasabah. Jika tidak, uji perubahan yang lebih berani atau langkah dengan trafik lebih tinggi. Lihat rangka kerja ujian A/B untuk penyediaannya.
- Pilih kaedah dengan sengaja. A/B ufuk tetap untuk keputusan yang perlu anda pertahankan; kaedah sekuensial jika anda mesti memantau secara berterusan; bandit untuk tempoh singkat dengan satu metrik.
- Daftarkan pelan lebih awal. Tuliskan metrik utama, panjang larian atau peraturan henti, dan segmen yang akan anda semak. Tahan diri daripada mengubahnya di tengah ujian.
- Semak kualiti data sebelum keputusan. Sahkan pembahagian trafik kelihatan betul dan penjejakan berfungsi bagi setiap varian.
- Baca keputusan dengan rendah hati. Lihat selang keyakinan, bukan sekadar label pemenang. "Kemenangan" yang selangnya merangkumi kesan kecil dan besar belum lagi nombor yang boleh anda gunakan untuk meramal.
- Sahkan kemenangan besar. Untuk keputusan yang mengejutkan atau berpertaruhan tinggi, jalankan semula atau tahan sebahagian trafik pada versi lama selepas pelancaran untuk mengesahkan peningkatan itu berkekalan.
Untuk melihat di mana ini terletak di antara kes penggunaan AI lain merentasi perjalanan pelanggan, lihat kes penggunaan pemasaran AI mengikut peringkat corong, dan untuk alat di sekelilingnya, stack pemasaran AI.
Kesilapan Biasa
- Membiarkan AI mengisytiharkan pemenang. Varian yang dinaikkan secara automatik hanya sebaik statistik di bawahnya. Ketahui kaedah mana yang digunakan alat anda.
- Peeking pada ujian ufuk tetap. Sumber kemenangan palsu yang paling lazim.
- Menguji terlalu banyak varian pada trafik yang terlalu sedikit. Lebih banyak varian bermakna kurang data bagi setiap varian dan lebih banyak peluang untuk kebetulan.
- Mengejar segmen selepas kejadian. "Ia berkesan untuk pengguna mudah alih di Ohio" ialah hipotesis baharu.
- Melangkau kawalan dalam pemperibadian. Tiada holdout, tiada bukti.
- Mengoptimumkan metrik yang salah. Varian yang meningkatkan klik tetapi menurunkan prospek berkelayakan atau hasil bagi setiap pelawat ialah kerugian. Pilih metrik yang berkait dengan nilai perniagaan.
Fakta Utama
- Ujian signifikan berulang (peeking) meningkatkan kadar positif palsu; dalam satu contoh kes terburuk, berhenti pada bacaan signifikan 5% pertama dalam 150 pemerhatian menghasilkan positif palsu sebanyak 26.1% daripada masa (Evan Miller, 18 April 2010).
- Simulasi Optimizely sendiri bagi ujian tanpa perbezaan sebenar mendapati lebih 57% mengisytiharkan pemenang atau yang kalah sekurang-kurangnya sekali apabila disemak selepas setiap pelawat di bawah statistik klasik (Optimizely, 20 Januari 2015).
- Ujian A/B meneroka sepanjang larian untuk mengukur kesan dengan tepat; bandit meneroka dan mengeksploitasi secara selari tetapi pilihan yang lemah apabila anda memerlukan pemenang yang teguh secara statistik (VWO / Wingify).
- Ketidakpadanan nisbah sampel, di mana pembahagian trafik yang diperhatikan berbeza daripada yang dijangka, menandakan masalah kualiti data dan dikesan dengan semakan statistik yang mudah (Fabijan et al., KDD 2019).
- Kesan kebaharuan pudar dan kesan keutamaan terbina dari semasa ke semasa, dan eksperimen sering terlalu singkat untuk mendedahkan salah satunya (Sadeghi et al., arXiv, 18 Februari 2021).
- AI paling selamat dalam CRO di mana seseorang menyemak output sebelum pelawat melihatnya, dan paling berisiko di mana ia membuat keputusan trafik langsung tanpa pelan statistik yang ditetapkan lebih awal.
Soalan Lazim tentang AI untuk Pengoptimuman Kadar Penukaran
Apakah pengoptimuman kadar penukaran AI?
Ia ialah penggunaan pembelajaran mesin dan AI generatif untuk menyokong kerja CRO: mengelompokkan rakaman sesi, meringkaskan maklum balas, menyediakan draf dan menyusun idea ujian, memperuntukkan trafik dengan algoritma bandit dan memperibadikan halaman. Ia mempercepatkan pencarian dan perangkaan masalah. Membuktikan bahawa sesuatu perubahan berkesan masih bergantung pada reka bentuk eksperimen yang kukuh.
Adakah ujian bandit lebih baik daripada ujian A/B?
Tiada satu pun yang lebih baik secara menyeluruh. Bandit mengalihkan trafik ke arah varian pendahulu semasa ujian berjalan, yang sesuai untuk tempoh singkat dan matlamat satu metrik. Ujian A/B mengekalkan pembahagian yang stabil dan memberi anggaran lebih bersih, yang sesuai untuk keputusan yang perlu anda fahami dan pertahankan, termasuk analisis segmen selepas itu.
Apakah peeking, dan mengapa ia menjadi masalah?
Peeking ialah menyemak ujian yang sedang berjalan dan berhenti apabila ia kelihatan signifikan. Ujian piawai mengandaikan satu pandangan pada saiz sampel yang telah ditetapkan, jadi semakan berulang meningkatkan peluang mengisytiharkan pemenang yang tidak benar. Tetapkan saiz sampel lebih awal atau gunakan platform yang dibina untuk ujian sekuensial.
Bolehkah pemperibadian AI menjejaskan penukaran?
Ya. Pemperibadian yang disasarkan dengan buruk boleh menunjukkan kandungan yang tidak relevan, dan tanpa kumpulan holdout yang dipilih secara rawak anda tidak dapat mengetahui sama ada ia membantu. Kekalkan kawalan dan ukur berbanding pengalaman lalai.
Berapa banyak trafik yang saya perlukan untuk menjalankan ujian CRO?
Ia bergantung pada kadar penukaran garis dasar anda dan peningkatan terkecil yang anda mahu kesan. Peningkatan yang lebih kecil memerlukan trafik jauh lebih banyak. Kira saiz sampel yang diperlukan sebelum melancarkan, dan jika halaman itu tidak dapat menyampaikannya dalam masa yang munasabah, uji perubahan yang lebih berani atau langkah dengan trafik lebih tinggi.
Patutkah AI menulis varian ujian saya?
Ia sumber draf pertama dan alternatif yang baik. Seseorang harus menyemak setiap dakwaan, nada dan sebarang keperluan pematuhan sebelum varian disiarkan, dan harus memangkas idea generik yang tidak sepadan dengan apa yang ditunjukkan data anda sendiri.

Principal Product Marketing Strategist
On this page
- Di mana AI sesuai dalam kitaran CRO
- Mencari masalah: analisis sesi dan wawasan tingkah laku
- Menjana dan mengutamakan hipotesis
- Kaedah ujian: A/B, multivariat dan bandit
- Perangkap statistik yang tidak dibaiki AI
- Peeking
- Positif palsu dan perbandingan berganda
- Ketidakpadanan nisbah sampel
- Kesan kebaharuan dan keutamaan
- Bandit dan masalah anggaran
- Pemperibadian: apa yang AI tambah dan cara mengukurnya
- Langkah demi langkah: menambah AI kepada program CRO
- Kesilapan Biasa
- Fakta Utama