IA para Otimização da Taxa de Conversão: Testes, Personalização e Insights
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
IA para otimização da taxa de conversão (CRO) significa usar aprendizado de máquina e IA generativa para descobrir onde os visitantes desistem, propor e priorizar mudanças a testar, distribuir o tráfego entre variantes e adaptar as páginas a diferentes visitantes. Ela acelera a primeira metade do CRO, que é encontrar problemas e formular hipóteses. Não muda a segunda metade. Saber se uma mudança realmente aumentou as conversões continua sendo uma questão de estatística, e as ferramentas de IA podem facilitar, e não dificultar, que você engane a si mesmo.
Esse é o fio condutor deste guia. Bem usada, a IA encurta o ciclo entre "algo parece errado" e "este é um teste que vale a pena rodar". Usada sem cuidado, produz uma pilha de "vencedores" confiantes que desaparecem depois do lançamento. Se você é novo no assunto, comece pelos fundamentos da otimização da taxa de conversão para SaaS ou para comércio eletrônico e depois volte aqui para a camada de IA.
Onde a IA se encaixa no ciclo de CRO
Um programa de CRO é um ciclo: observar o comportamento, formular uma hipótese, testá-la, aprender, repetir. A IA ajuda em pontos diferentes desse ciclo, e o nível de risco muda em cada um.
| Etapa do CRO | O que a IA faz | Risco se estiver errada |
|---|---|---|
| Observar | Agrupa sessões, resume gravações, sinaliza cliques de raiva e becos sem saída | Baixo: você revisa os achados |
| Formular hipóteses | Esboça ideias de teste a partir de análises, pesquisas e avaliações; classifica-as | Baixo: ideias são baratas |
| Criar variantes | Esboça títulos, textos e opções de layout | Médio: variantes fracas ou fora da marca desperdiçam tráfego |
| Rodar o teste | Distribui o tráfego (bandits), roda combinações multivariadas | Alto: estatística ruim produz falsos vencedores |
| Personalizar | Escolhe o conteúdo por segmento de visitantes ou por indivíduo | Médio: experiências estranhas ou erradas, difíceis de medir |
| Aprender | Resume os resultados e propõe próximos passos | Médio: os resumos podem exagerar a certeza |
O padrão a notar: a IA é mais segura onde uma pessoa revisa a saída antes que qualquer coisa chegue a um visitante, e mais arriscada onde toma decisões ao vivo sobre o tráfego. O restante deste guia segue esse gradiente.
Encontrando problemas: análise de sessões e insights comportamentais
A maioria dos programas de CRO começa com uma pergunta: onde as pessoas estão saindo, e por quê? A análise quantitativa diz onde. Gravações de sessões, mapas de calor, pesquisas e tickets de suporte dão pistas do porquê. O problema sempre foi o volume. Ninguém assiste a 10.000 gravações.
A IA ajuda de três maneiras:
- Agrupamento de sessões. Os modelos agrupam gravações por padrão de comportamento, como visitantes que rolam até os preços e saem, ou que clicam repetidamente em um elemento que não é um link. Você assiste a algumas de cada grupo em vez de amostras aleatórias.
- Detecção de atritos. As ferramentas sinalizam cliques de raiva, erros repetidos em campos de formulário, navegação de vai e volta e carrinhos abandonados como possíveis pontos problemáticos.
- Resumo qualitativo. Os modelos de linguagem leem respostas abertas de pesquisas, transcrições de chat, avaliações e texto de tickets e depois os agrupam em temas. "Não dá para saber se o frete é grátis" aparecendo em 300 comentários é uma hipótese que você não precisou caçar.
Trate tudo isso como uma pista, não como um veredicto. Um cluster é um padrão nos dados, e padrões podem ser coincidências ou artefatos de como as sessões foram amostradas. A regra que mantém as equipes honestas: todo insight revelado pela IA vira uma hipótese a ser testada, não uma mudança que vai direto para o site. Bons dados comportamentais também dependem do que você coleta desde o início, assunto tratado em dados primários para marketing com IA.
Gerando e priorizando hipóteses
Uma boa hipótese nomeia o problema, a mudança, o efeito esperado e a métrica. "Os visitantes no celular não veem a garantia, então movê-la para cima do botão aumentará o início de checkouts" é testável. "Melhorar a página" não é.
A IA generativa é boa em volume aqui. Dê a ela os achados da sua análise, os temas das pesquisas, o texto atual da página e o público, e peça vinte hipóteses nessa estrutura. Depois pode com firmeza. Os modelos tendem a sugerir melhores práticas genéricas (acrescentar urgência, acrescentar prova social) que podem ou não servir para a sua página, e não têm como saber quais das suas restrições são reais.
Para priorizar, as equipes costumam pontuar as ideias por impacto, confiança e esforço, usando frameworks como ICE ou PIE. A IA pode preencher uma pontuação de primeiro rascunho, mas desconfie do número de "impacto": é um palpite, a menos que esteja ligado a tráfego real e a uma linha de base real. Um uso melhor do modelo é como auxiliar de ordenação, com uma pessoa dona da ordem final. Pense em quantos testes você consegue rodar de forma realista. Uma página que recebe alguns milhares de visitas por mês não sustenta muitos experimentos em paralelo, então o orçamento de tráfego é, em si, um insumo de priorização. O framework de testes A/B explica como estruturar esse backlog.
Métodos de teste: A/B, multivariado e bandits
Os fornecedores de IA confundem os nomes desses métodos, então ajuda separá-los.
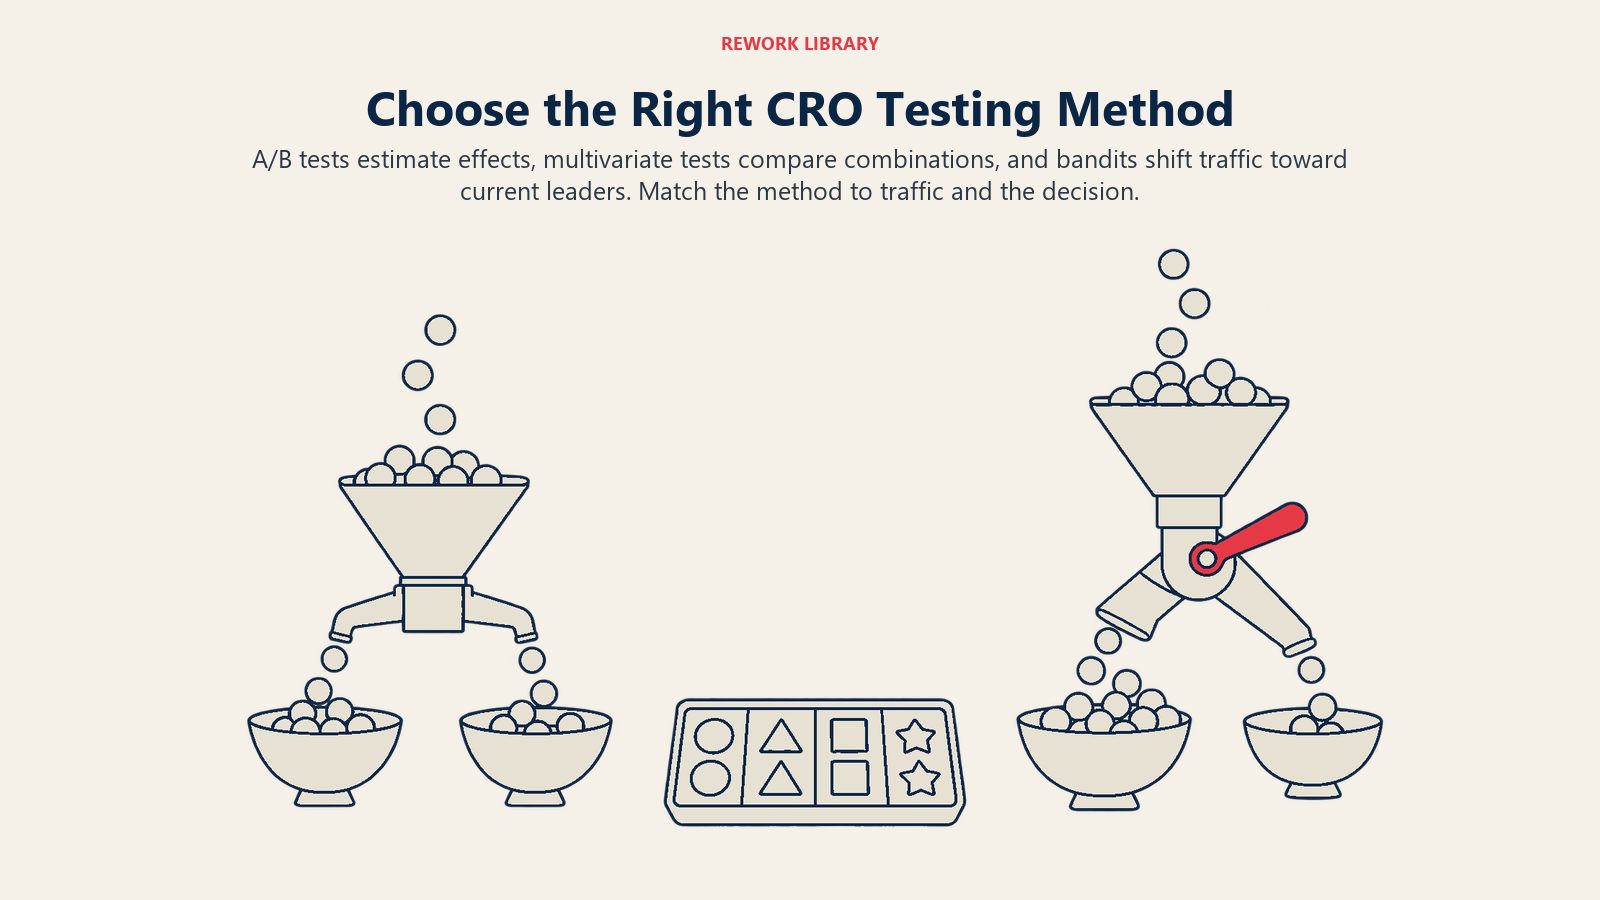
O teste A/B divide o tráfego igualmente entre um controle e uma ou mais variantes por tempo suficiente para medir uma diferença. O objetivo é uma estimativa confiável do efeito.
O teste multivariado altera vários elementos ao mesmo tempo (título, imagem, botão) e mede todas as combinações. Ele pode mostrar qual elemento importa, mas exige muito mais tráfego do que um teste A/B simples, porque o tráfego é dividido entre todas as combinações. Em uma página de pouco tráfego, isso geralmente significa que nada atinge a significância.
O teste bandit ajusta a divisão conforme os dados chegam, enviando mais tráfego às variantes que parecem estar vencendo. É aqui que o aprendizado de máquina faz trabalho real dentro do próprio teste.
A Wingify, que vende software de testes, descreve o equilíbrio assim. Um teste A/B clássico permanece em modo de exploração durante toda a execução porque existe para medir as taxas de conversão com precisão, enquanto um bandit de múltiplos braços explora e aproveita em paralelo, deslocando a maior parte do tráfego para a variação que parece melhor no momento (VWO / Wingify sobre bandits de múltiplos braços). O mesmo artigo lista onde cada um se encaixa. O teste A/B serve para decisões que exigem confiança no efeito de cada variante, inclusive a análise de segmentos depois. Os bandits servem para casos em que cada conversão perdida é custosa, a janela é curta (uma oferta por tempo limitado, uma manchete de notícia) ou você só se importa com uma métrica. Ele também lista os limites: bandits são uma escolha ruim quando você precisa de um vencedor estatisticamente robusto, otimizam um único objetivo, e as variantes de baixo desempenho recebem tráfego pequeno demais para estimar suas taxas de conversão com confiabilidade. Como o autor é um fornecedor, leia como a visão de um profissional, mas o equilíbrio que descreve é o padrão.
Uma regra de decisão simples decorre disso:
| Situação | Melhor escolha |
|---|---|
| Decisão pontual (nova página de preços, redesenho) com a qual você viverá por meses | Teste A/B de horizonte fixo |
| Você precisa saber por que algo venceu ou como foi por segmento | Teste A/B |
| Campanha, título ou promoção de curta duração em que a janela fecha logo | Bandit |
| Muitas variantes de texto de baixo risco, uma métrica | Bandit |
| Vários elementos que interagem, muito tráfego | Multivariado |
| Pouco tráfego | Teste mudanças maiores com menos variantes, não mais variantes |
Armadilhas estatísticas que a IA não corrige
Esta seção é a mais importante. As ferramentas automatizadas podem esconder problemas estatísticos atrás de um painel limpo.
Peeking
Peeking é conferir os resultados enquanto um teste está em andamento e pará-lo quando parecem significativos. Os testes de significância padrão pressupõem que você olha uma só vez, em um tamanho de amostra definido de antemão. O texto clássico de Evan Miller diz com clareza: testar a significância repetidamente sempre aumenta a taxa de falsos positivos. No pior caso do exemplo dele, um teste em que a nova versão não faz nada, parar no primeiro sinal de 5% de significância dentro de 150 observações produz um falso positivo em 26,1% das vezes (Evan Miller, "How Not To Run an A/B Test", 18 de abril de 2010). As soluções dele: decidir o tamanho da amostra antes de começar e não parar cedo, ou usar um desenho feito para olhares repetidos, como métodos sequenciais ou bayesianos.
A Optimizely fez a mesma observação ao apresentar o seu Stats Engine. Em simulações próprias de testes sem diferença real, conferir depois de cada visitante levou mais de 57% dos testes a declarar um vencedor ou perdedor pelo menos uma vez, e uma abordagem sequencial reduziu a taxa de erro da conferência contínua para 3% (Optimizely, 20 de janeiro de 2015). São simulações do próprio fornecedor, então trate os números exatos como ilustrativos. A direção é o que está bem estabelecido.
Então o que fazer? Ou você se compromete com um tamanho de amostra fixo e deixa o teste em paz até alcançá-lo, ou usa uma plataforma cuja estatística seja explicitamente feita para monitoramento contínuo (testes sequenciais). Não use uma ferramenta de horizonte fixo e depois a observe todo dia.
Falsos positivos e comparações múltiplas
Cada métrica, variante e segmento extra que você inspeciona é mais uma chance de o ruído parecer sinal. Um teste com cinco variantes, dez métricas e seis segmentos tem centenas de comparações. Algumas cruzarão a linha de significância por sorte. Esse é o problema das comparações múltiplas, e "a IA achou um segmento em que a variante B vence" é exatamente como ele se infiltra. Um segmento descoberto depois do fato é uma hipótese para um novo teste, não um resultado.
As defesas são simples, mas exigem disciplina: nomeie uma métrica principal antes do teste, limite o número de variantes, trate as métricas secundárias e os recortes por segmento como exploratórios e confirme vitórias surpreendentes com uma nova execução.
Sample ratio mismatch
Se você pretende uma divisão 50/50 e a divisão real de visitantes é visivelmente diferente, algo está quebrado na atribuição ou no rastreamento, e o resultado não é confiável. Pesquisadores da Microsoft e de outras empresas chamam isso de sample ratio mismatch e o descrevem como um sintoma de uma variedade de problemas de qualidade de dados, assim como a febre sinaliza muitas doenças (Fabijan et al., KDD 2019). Detectá-lo é uma verificação estatística simples; encontrar a causa é a parte difícil. Muitas plataformas de teste fazem essa verificação automaticamente. Se a sua não faz, execute-a você mesmo antes de ler qualquer resultado. Isso vale também para bandits, embora, com alocação adaptativa, a divisão esperada deixe de ser fixa, então use os diagnósticos da própria plataforma.
Efeitos de novidade e de primazia
Os primeiros resultados podem enganar por razões humanas. Pesquisadores da Microsoft definem a novidade como a atração exercida pela nova tecnologia, que se desfaz com o tempo, e a primazia como o engajamento que cresce à medida que os usuários adotam uma mudança, e observam que os experimentos costumam ser curtos demais para mostrar qualquer um dos dois com clareza (Sadeghi et al., 2021). Na prática: um banner chamativo pode vencer na primeira semana por ser novo, e um layout confuso, porém melhor, pode perder na primeira semana porque os usuários habituais precisam de tempo para se adaptar. Rode os testes por ciclos de negócio completos (pelo menos semanas inteiras), observe se o efeito é estável ou está à deriva e tenha cuidado redobrado com mudanças voltadas a visitantes recorrentes.
Bandits e o problema da estimação
Os bandits trocam a medição limpa por um retorno mais rápido. Como o tráfego se desloca para os primeiros líderes, as variantes mais fracas coletam poucos dados, então você aprende menos sobre elas, e uma sequência inicial de sorte pode consolidar o vencedor errado. É por isso que o artigo do fornecedor citado acima os recomenda para janelas curtas e métricas únicas, e não para decisões que você precisa explicar e defender.
Personalização: o que a IA acrescenta e como medir
A personalização no site mostra conteúdos diferentes a visitantes diferentes: um título ajustado ao setor, recomendações de produtos baseadas na navegação, uma chamada para ação diferente para clientes recorrentes. O aprendizado de máquina decide quem vê o quê, usando sinais como origem, comportamento, localização, compras anteriores ou intenção prevista.
A IA acrescenta três coisas em relação à personalização baseada em regras. Ela encontra segmentos que você não teria definido à mão. Ela pontua indivíduos (probabilidade de comprar, de cancelar, de precisar de ajuda) e age com base na pontuação. E se atualiza continuamente em vez de esperar que uma pessoa revise as regras. Para ver a mecânica com mais profundidade, consulte o guia sobre o mecanismo de personalização.
Medi-la é mais difícil do que construí-la, por alguns motivos:
- Mantenha sempre um grupo de controle (holdout). Deixe uma parcela escolhida aleatoriamente dos visitantes elegíveis na experiência padrão. Sem esse grupo, você não consegue separar "a personalização funcionou" de "pessoas que já iam comprar receberam uma página personalizada".
- Cuidado com resultados confundidos. Se o modelo direciona visitantes que ele já prevê que vão converter, um aumento na taxa de conversão deles diz pouco sobre a personalização.
- Atenção à erosão. Muitos segmentos pequenos significam amostras pequenas, e o problema das comparações múltiplas volta.
- Respeite o consentimento e os limites dos dados. A personalização depende de dados que você tem permissão de usar. Construa-a sobre dados primários e o consentimento que você coletou.
Comece com uma página de alto tráfego e dois ou três segmentos que você consiga explicar em uma frase. Complexidade que você não consegue explicar é complexidade que você não consegue depurar.
Passo a passo: adicionando IA a um programa de CRO
- Corrija primeiro a mensuração. Confirme que as conversões são rastreadas de forma correta e consistente entre dispositivos. A IA sobre uma análise quebrada só produz erros mais rápido.
- Escolha uma única página e uma métrica principal. Uma página de preços, um formulário de cadastro, uma página de produto ou uma etapa de checkout. Anote a taxa de conversão de linha de base.
- Use a IA na observação. Execute o agrupamento de sessões e a detecção de atritos e resuma o texto de pesquisas e de suporte dessa página. Peça a uma pessoa que revise os achados.
- Gere e pode as hipóteses. Peça hipóteses em um formato fixo (problema, mudança, efeito esperado, métrica). Corte tudo o que for genérico. Fique com as cinco que você conseguiria explicar a um colega cético.
- Estime o tamanho da amostra antes de lançar. Defina o seu efeito mínimo detectável, calcule o tráfego necessário e verifique se a página consegue entregá-lo em um prazo razoável. Se não, teste uma mudança mais ousada ou uma etapa de maior tráfego. Veja o framework de testes A/B para a configuração.
- Escolha o método de propósito. A/B de horizonte fixo para decisões que você precisa defender; métodos sequenciais se precisar monitorar continuamente; bandits para janelas curtas com uma única métrica.
- Registre o plano antecipadamente. Anote a métrica principal, a duração da execução ou a regra de parada e os segmentos que vai verificar. Resista a mudá-los no meio do teste.
- Verifique a qualidade dos dados antes dos resultados. Confirme que a divisão do tráfego parece correta e que o rastreamento disparou para todas as variantes.
- Leia os resultados com humildade. Olhe o intervalo de confiança, não apenas o rótulo de vencedor. Uma "vitória" cujo intervalo abrange efeitos pequenos e grandes ainda não é um número com o qual você consiga fazer previsões.
- Confirme as grandes vitórias. Para resultados surpreendentes ou de alto risco, rode de novo ou reserve uma parcela do tráfego na versão antiga após o lançamento para verificar se o ganho persiste.
Para ver onde isso se situa entre os outros casos de uso de IA ao longo da jornada do cliente, consulte casos de uso de marketing com IA por etapa do funil e, para as ferramentas ao redor, o stack de marketing com IA.
Erros comuns
- Deixar a IA declarar vencedores. Variantes promovidas automaticamente são tão boas quanto a estatística por baixo. Saiba qual método a sua ferramenta usa.
- Peeking em um teste de horizonte fixo. A fonte mais comum de falsas vitórias.
- Testar variantes demais com pouco tráfego. Mais variantes significa menos dados por variante e mais chances de um acaso.
- Perseguir segmentos depois do fato. "Funcionou para usuários de celular em Ohio" é uma nova hipótese.
- Pular o controle na personalização. Sem holdout, sem prova.
- Otimizar a métrica errada. Uma variante que aumenta os cliques, mas reduz os leads qualificados ou a receita por visitante, é uma perda. Escolha uma métrica ligada ao valor de negócio.
Fatos Principais
- Testar a significância repetidamente (peeking) aumenta a taxa de falsos positivos; em um exemplo de pior caso, parar na primeira leitura de 5% de significância dentro de 150 observações produziu um falso positivo em 26,1% das vezes (Evan Miller, 18 de abril de 2010).
- As simulações da própria Optimizely de testes sem diferença real constataram que mais de 57% declararam um vencedor ou perdedor pelo menos uma vez quando conferidos depois de cada visitante sob a estatística clássica (Optimizely, 20 de janeiro de 2015).
- Os testes A/B exploram durante toda a execução para medir os efeitos com precisão; os bandits exploram e aproveitam em paralelo, mas são uma escolha ruim quando você precisa de um vencedor estatisticamente robusto (VWO / Wingify).
- Um sample ratio mismatch, em que a divisão de tráfego observada difere da esperada, sinaliza problemas de qualidade de dados e é detectado com uma verificação estatística simples (Fabijan et al., KDD 2019).
- Os efeitos de novidade se desfazem e os de primazia crescem com o tempo, e os experimentos costumam ser curtos demais para revelar qualquer um dos dois (Sadeghi et al., arXiv, 18 de fevereiro de 2021).
- A IA é mais segura no CRO onde uma pessoa revisa a saída antes que os visitantes a vejam, e mais arriscada onde toma decisões ao vivo sobre o tráfego sem um plano estatístico definido de antemão.
Perguntas frequentes sobre IA para Otimização da Taxa de Conversão
O que é otimização da taxa de conversão com IA?
É o uso de aprendizado de máquina e IA generativa para apoiar o trabalho de CRO: agrupar gravações de sessões, resumir feedback, esboçar e classificar ideias de teste, distribuir o tráfego com algoritmos bandit e personalizar páginas. Ela acelera a descoberta e o enquadramento de problemas. Provar que uma mudança funciona ainda depende de um bom desenho de experimento.
Os testes bandit são melhores do que os testes A/B?
Nenhum é melhor em tudo. Os bandits deslocam o tráfego para a variante líder enquanto o teste roda, o que serve para janelas curtas e objetivos de uma só métrica. Os testes A/B mantêm uma divisão estável e dão estimativas mais limpas, o que serve para decisões que você precisa entender e defender, inclusive a análise de segmentos depois.
O que é peeking e por que é um problema?
Peeking é conferir um teste em andamento e pará-lo quando parece significativo. Os testes padrão pressupõem um único olhar em um tamanho de amostra predefinido, então conferências repetidas aumentam a chance de declarar um vencedor que não é real. Fixe o tamanho da amostra antecipadamente ou use uma plataforma feita para testes sequenciais.
A personalização com IA pode prejudicar a conversão?
Sim. Uma personalização mal direcionada pode mostrar conteúdo irrelevante, e sem um grupo de controle (holdout) escolhido aleatoriamente você não consegue saber se ela ajudou. Mantenha um controle e meça contra a experiência padrão.
De quanto tráfego preciso para rodar testes de CRO?
Depende da sua taxa de conversão de linha de base e do menor aumento que você quer detectar. Aumentos menores exigem muito mais tráfego. Calcule o tamanho de amostra necessário antes de lançar e, se a página não consegue entregá-lo em um prazo razoável, teste uma mudança mais ousada ou uma etapa de maior tráfego.
A IA deve escrever as minhas variantes de teste?
Ela é uma boa fonte de primeiros rascunhos e alternativas. Uma pessoa deve verificar cada afirmação, o tom e quaisquer requisitos de conformidade antes de uma variante ir ao ar, e deve podar as ideias genéricas que não combinam com o que os seus próprios dados mostram.

Principal Product Marketing Strategist
On this page
- Onde a IA se encaixa no ciclo de CRO
- Encontrando problemas: análise de sessões e insights comportamentais
- Gerando e priorizando hipóteses
- Métodos de teste: A/B, multivariado e bandits
- Armadilhas estatísticas que a IA não corrige
- Peeking
- Falsos positivos e comparações múltiplas
- Sample ratio mismatch
- Efeitos de novidade e de primazia
- Bandits e o problema da estimação
- Personalização: o que a IA acrescenta e como medir
- Passo a passo: adicionando IA a um programa de CRO
- Erros comuns
- Fatos Principais