Bahasa Indonesia
Kepercayaan Ketika Rekan Tim Anda Adalah AI
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
Memercayai rekan tim AI berarti mengkalibrasi seberapa besar Anda mengandalkan outputnya dengan bukti seberapa andal ia sebenarnya pada tugas tertentu, bukan dengan seberapa yakin nada bicaranya. Itu keterampilan yang berbeda dari memercayai kolega, karena AI tidak punya niat menipu dan tidak punya karier yang dipertaruhkan jika salah, sehingga dua sinyal yang biasanya dipakai orang untuk memutuskan siapa yang layak dipercaya pun hilang.
Kebanyakan saran tentang "memercayai AI" langsung melompat ke kebijakan: tulis pedoman penggunaan, tambahkan aturan pengungkapan, selesai. Itu perlu, tetapi bukan bagian yang sulit. Kepercayaan pada rekan tim manusia dan pada rekan tim AI berjalan dengan mekanisme yang hampir sepenuhnya berbeda, dan tim yang melewatkan perbedaan itu akhirnya terjebak dalam salah satu dari dua pola kegagalan yang mahal: diam-diam mengerjakan ulang segala yang disentuh AI, atau mengesahkan begitu saja output yang ternyata salah dengan penuh keyakinan. Artikel ini membahas mengapa mekanismenya berbeda, kedua pola kegagalan beserta riset di baliknya, seperti apa kepercayaan terkalibrasi dalam praktik, apa yang benar-benar membangunnya, dan norma tim yang membuatnya bertahan lama.
Mengapa Memercayai AI Adalah Masalah yang Berbeda dari Memercayai Manusia
Kepercayaan antarmanusia dibangun di atas fondasi yang sederhana dan sudah banyak diteliti: Anda mengamati kemampuan seseorang, integritasnya, dan apakah ia tampak peduli pada kepentingan Anda (benevolence), dalam cukup banyak situasi hingga sebuah pola muncul. Kami membahas model itu secara mendalam dalam cara membangun kepercayaan di tempat kerja. Mekanisme ini berhasil karena manusia punya niat: ia bisa memilih untuk menipu Anda, dan kemungkinan ketahuan, kerugian reputasi, adalah bagian dari hal yang menjaga kebanyakan orang tetap jujur.
Sistem AI tidak memiliki kedua bagian mekanisme itu. Ia tidak berniat menyesatkan Anda ketika salah, dan ia tidak punya reputasi yang harus dijaga, tidak ada karier yang dipertaruhkan. Itu bukan kegagalan moral, hanya jenis sistem yang berbeda, tetapi artinya jalan pintas yang biasanya dipakai orang untuk memutuskan siapa yang dipercaya (apakah orang ini bermaksud baik, apakah ia akan rugi jika tidak memenuhi janji) sama sekali tidak berlaku. Anda dibiarkan menilai sesuatu yang lebih dekat ke alat ukur daripada kolega: seberapa akurat, dalam kondisi apa, dan bagaimana Anda tahu kapan ia sudah menyimpang.
Yakin dan Salah Tampak Identik dengan Yakin dan Benar
Masalah yang lebih tajam ada pada cara penyajiannya. Orang yang tidak yakin akan jawabannya biasanya memberi sinyal lewat ragu-ragu, nada, atau bahasa tubuh. Model bahasa besar menghasilkan kutipan rekaan, angka yang salah, atau kutipan karangan dalam register yang persis sama lancar dan meyakinkannya dengan yang benar. Inilah mekanisme inti di balik halusinasi AI: sistem itu tidak berbohong, ia menghasilkan teks yang masuk akal, dan masuk akal serta benar bukanlah sifat yang sama. Tidak ada dari seberapa yakin output terdengar yang memberi tahu Anda mana yang sedang Anda hadapi.
Satu fakta itulah alasan kepercayaan pada AI tidak bisa sekadar memperluas kepercayaan pada manusia. Anda membutuhkan sinyal eksternal, bukti dari pengujian, rekam jejak pada tugas tertentu, sumber yang bisa diperiksa, karena sinyal internal yang secara naluriah dibaca manusia untuk menilai keyakinan sudah terlepas dari keandalan yang sebenarnya.
Dua Pola Kegagalan: Kurang Percaya dan Terlalu Percaya
Tim tanpa pendekatan yang disengaja tidak mendarat di tengah. Mereka berayun ke salah satu dari dua ekstrem, dan keduanya mahal dengan cara yang berbeda.
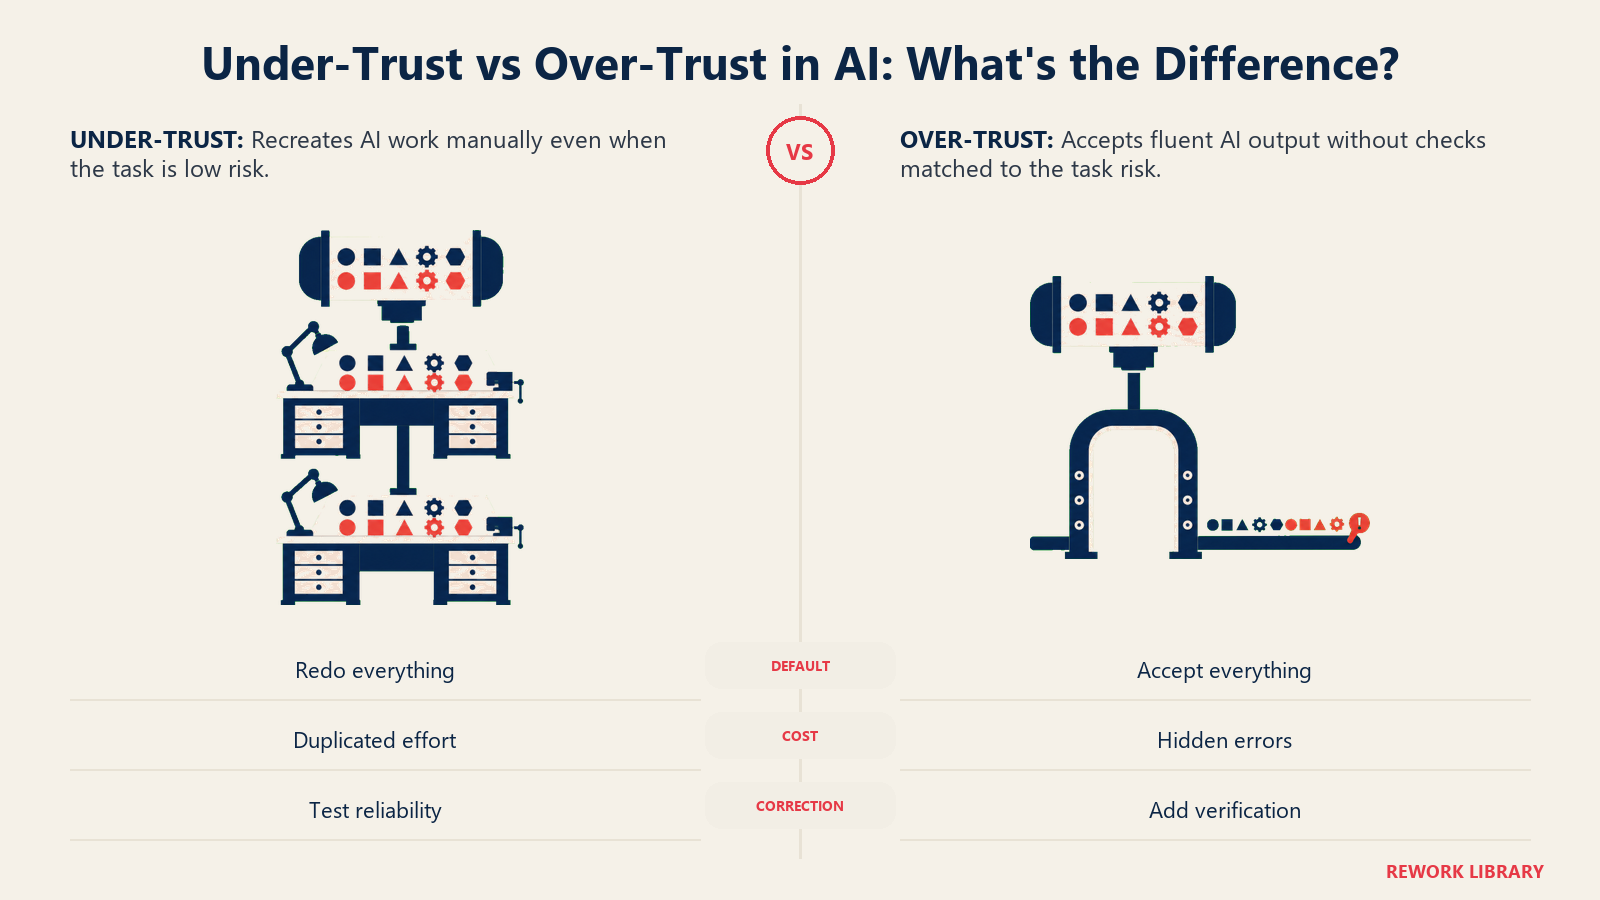
Kurang Percaya: Mengerjakan Ulang Pekerjaan Agen secara Manual
Kurang percaya tampak bertanggung jawab di permukaan. Seorang manajer meninjau setiap baris yang dihasilkan agen dengan ketelitian yang sama seperti jika ia sama sekali tidak memercayai sistemnya, yang pada dasarnya mengerjakan pekerjaan dua kali. Itu menghapus peningkatan produktivitas yang seharusnya diberikan AI. Jika memeriksa draf memakan waktu sama lamanya dengan menulisnya dari awal, organisasi sudah menambah alat tanpa mengubah outputnya, dan siapa pun yang melakukan pemeriksaan ganda itu akhirnya kelelahan atau diam-diam berhenti, yang hanya menunda masalah terlalu percaya, bukan menyelesaikannya.
Kurang percaya paling terasa pada tim yang pernah punya satu pengalaman buruk di awal dengan alat AI dan tidak pernah meninjaunya lagi. Satu fakta halusinasi yang memalukan dalam presentasi klien bisa membekukan kesediaan tim mengandalkan output AI selama setahun, bahkan setelah alatnya membaik.
Terlalu Percaya: Automation Bias dan Biaya Melewatkan Pemeriksaan
Terlalu percaya, atau automation bias, adalah kecenderungan memberi bobot lebih pada output sistem otomatis daripada yang didukung bukti, dan berhenti memverifikasi setelah sistem benar beberapa kali. Ini salah satu pola kegagalan yang paling terdokumentasi dalam riset interaksi manusia dan otomatisasi, yang berakar pada puluhan tahun studi penerbangan dan keselamatan, dan ia memburuk, bukan membaik, seiring sistem AI meningkat, karena sistem yang benar 95% dari waktu cukup meyakinkan sehingga orang berhenti memeriksa 5% sisanya.
Sebuah studi tahun 2023 di jurnal Radiology memberi angka pada seberapa parah hal ini bisa terjadi. Para peneliti meminta 27 radiolog membaca 50 mamogram, sebagian disertai saran klasifikasi BI-RADS dari sistem AI. Ketika saran AI salah, akurasi radiolog yang kurang berpengalaman anjlok dari sekitar 80% menjadi di bawah 20%. Radiolog dengan pengalaman lebih dari 15 tahun pun tidak kebal: akurasi mereka turun dari 82% menjadi 45,5%. Pengalaman mengurangi kerusakan. Pengalaman tidak mendekati menghilangkannya.
Itu lingkungan klinis, tetapi mekanismenya muncul juga dalam pekerjaan pengetahuan sehari-hari, dengan nama yang taruhannya lebih rendah: workslop. Survei September 2025 terhadap 1.150 pekerja penuh waktu di AS oleh BetterUp Labs dan Social Media Lab Stanford menemukan 40% telah menerima "workslop," konten buatan AI yang tampak rapi tetapi tidak punya substansi untuk menggerakkan tugas, dalam sebulan terakhir. Setiap kejadian memakan rata-rata dua jam untuk dibereskan, dengan perkiraan biaya $186 per karyawan per bulan, atau sekitar $9 juta per tahun untuk perusahaan dengan 10.000 orang. Workslop adalah terlalu percaya dalam praktik: seseorang menerima draf agen apa adanya, meneruskannya, dan menyerahkan verifikasi yang sebenarnya kepada siapa pun yang menerimanya berikutnya.
Fakta Penting
- Akurasi radiolog dalam membaca mamogram turun dari sekitar 80% menjadi di bawah 20% untuk pembaca yang kurang berpengalaman, dan dari 82% menjadi 45,5% untuk pembaca dengan pengalaman 15+ tahun, ketika saran sistem AI keliru, dalam studi terhadap 27 radiolog yang membaca 50 mamogram. Sumber: Automation Bias in Mammography, Radiology (RSNA), via EurekAlert
- 40% dari 1.150 pekerja penuh waktu di AS yang disurvei menerima "workslop" buatan AI dalam sebulan terakhir, dengan setiap kejadian memakan rata-rata dua jam untuk diperbaiki, perkiraan biaya $186 per karyawan per bulan, atau sekitar $9 juta per tahun untuk perusahaan dengan 10.000 orang. Sumber: BetterUp Labs, "Workslop"
- 60% eksekutif sudah memakai AI dalam pengambilan keputusan, tetapi hanya 5% yang mengatakan mereka mengelolanya dengan baik, kesenjangan yang disebut Deloitte sebagai pendorong "cultural debt" organisasi. Sumber: Deloitte 2026 Global Human Capital Trends
- 56% pemimpin merancang AI semata-mata untuk hasil bisnis; hanya 40% yang merancang untuk hasil bisnis sekaligus hasil bagi manusia, dan 42% pekerja mengatakan organisasi mereka sama sekali tidak mengevaluasi dampak AI terhadap manusia. Sumber: Deloitte 2026 Global Human Capital Trends
- Ketika manajer secara terbuka mencontohkan pemakaian AI mereka sendiri, karyawan melaporkan kenaikan 30 poin dalam kepercayaan terhadap agentic AI dan 1,4 kali lebih mungkin menjadi pengguna berfrekuensi tinggi yang ditopang jaring pengaman. Sumber: Microsoft Work Trend Index 2026
Kepercayaan Terkalibrasi: Percaya tetapi Verifikasi, dengan Spesifik
Peneliti yang mempelajari interaksi manusia dan otomatisasi memakai istilah kepercayaan terkalibrasi (disebut juga ketergantungan yang tepat) untuk keadaan sasaran di antara kedua pola kegagalan: menerima output sistem ketika bukti menunjukkan ia andal, dan menolak ketika bukti menunjukkan ia tidak andal, tugas demi tugas, bukan sebagai kebijakan menyeluruh. Pembedaan yang penting di sini adalah antara kepercayaan dan ketergantungan. Kepercayaan adalah apa yang dikatakan seseorang tentang keyakinannya terhadap sistem; ketergantungan adalah apa yang benar-benar ia lakukan dengan outputnya. Riset secara konsisten menemukan keduanya menjauh: seseorang bisa mengatakan tidak sepenuhnya memercayai alat AI dan tetap bertindak berdasarkan outputnya tanpa memeriksa, karena verifikasi memerlukan usaha dan jalan yang paling mudah adalah menerima.
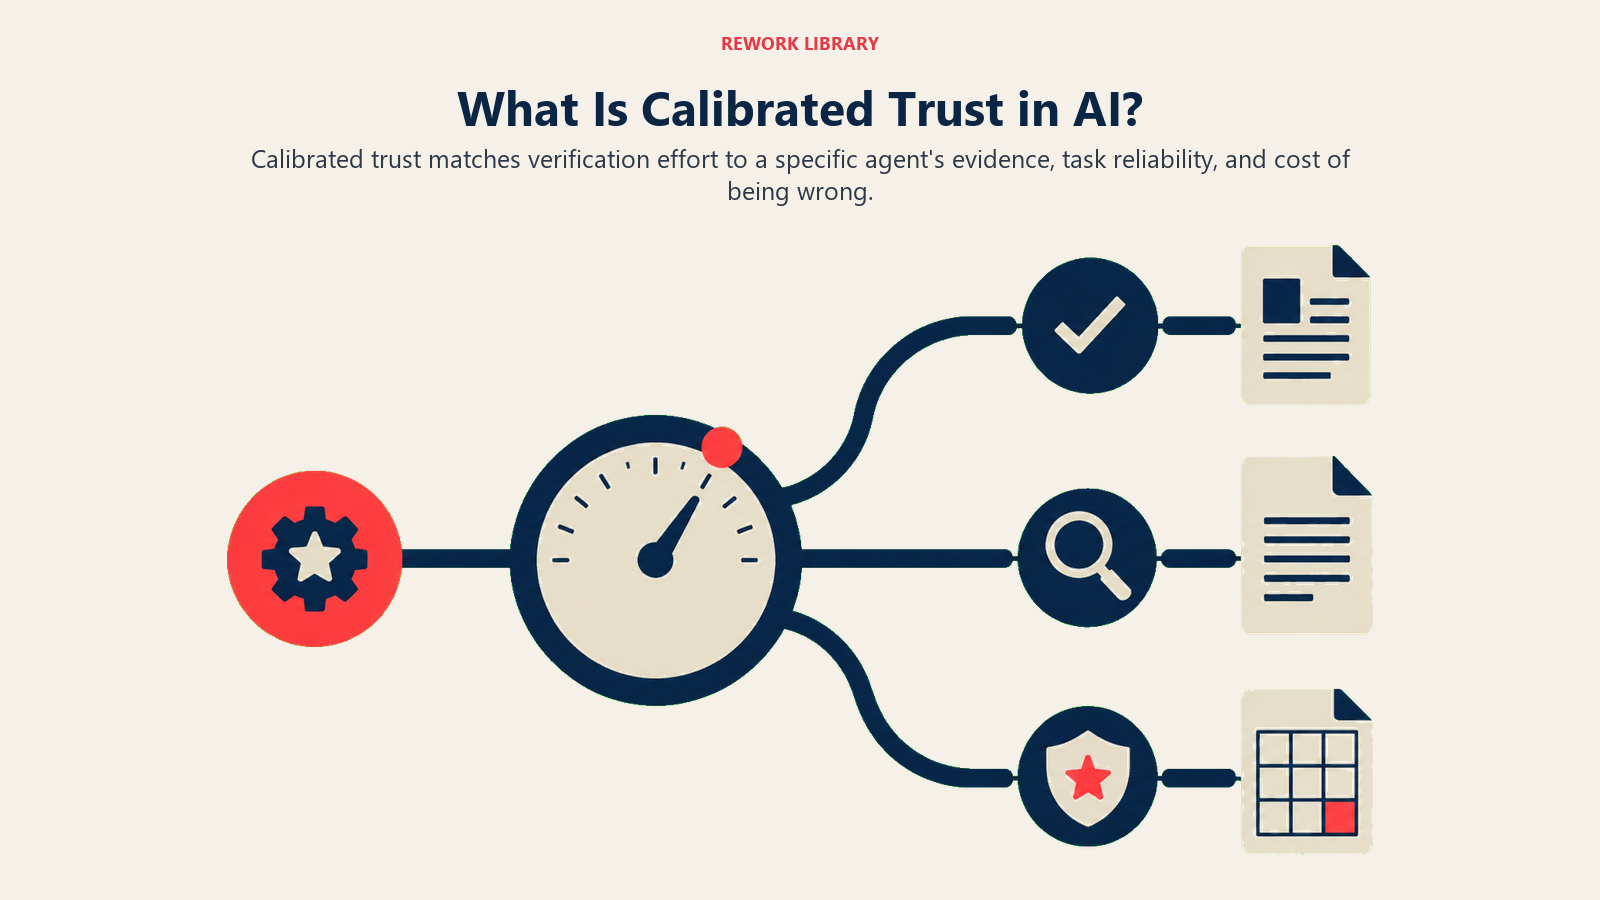
Kalibrasi hanya berhasil jika spesifik pada tugas, bukan pada alat secara keseluruhan. Agen yang andal menyusun ringkasan rapat draf pertama memiliki profil keandalan yang sama sekali berbeda dengan model yang sama ketika diminta menghitung proyeksi keuangan atau mengutip preseden hukum. "Apakah kita memercayai AI" adalah pertanyaan yang salah. "Apakah kita memercayai agen ini, pada tugas ini, berdasarkan apa yang sudah kita lihat ia lakukan dengan benar dan salah" adalah pertanyaan yang berguna.
Ketahui Di Mana Agen Andal dan Di Mana Tidak
Membangun gambaran tingkat tugas itu memerlukan pencatatan yang disengaja, bukan intuisi. Tim yang diam-diam menyadari bahwa agen unggul dalam draf pertama email rutin tetapi sering mengarang statistik dalam ringkasan riset telah melakukan kerja kalibrasi yang nyata, sekalipun tak seorang pun menuliskannya. Kesenjangan yang dimiliki kebanyakan tim bukan pada menyadarinya, melainkan pada menjadikan pengetahuan itu eksplisit dan dibagikan, bukan tersimpan di kepala satu orang, agar karyawan baru tidak mengulang kesalahan terlalu percaya yang sudah dipelajari tim lainnya untuk dihindari.
Seperti Apa Verifikasi Sehari-hari
Secara konkret, ini berarti memeriksa acak klaim yang bersumber sebelum dokumen keluar, memeriksa kewajaran setiap angka yang dihasilkan agen terhadap acuan yang diketahui, dan memperlakukan draf pertama sebagai draf untuk disunting, bukan sesuatu untuk diteruskan apa adanya. Tidak satu pun dari itu menuntut pekerjaan dikerjakan ulang dari awal, dan itulah yang membedakan kepercayaan terkalibrasi dari kurang percaya: pemeriksaan terarah di tempat agen diketahui lemah, dan penerimaan yakin di tempat ia diketahui kuat.
Apa yang Membangun Kepercayaan yang Tepat pada AI
Empat hal secara andal memindahkan tim dari menebak ke terkalibrasi, dan tak satu pun berupa sesi pelatihan satu kali.
Transparansi. Agen yang menunjukkan sumbernya, menandai tingkat keyakinannya, atau menjelaskan langkah yang diambilnya memberi seseorang sesuatu yang nyata untuk dievaluasi, bukan jawaban akhir yang rapi untuk diterima atau ditolak atas dasar iman. Tim yang bekerja dengan alat yang menampilkan penalaran atau kutipan yang terlihat cenderung berkalibrasi lebih cepat daripada tim yang terjebak dengan kotak hitam yang hanya mengembalikan hasil yang tampak bersih.
Rekam jejak. Kepercayaan pada karyawan baru terbangun dengan mengamati mereka menangani situasi nyata selama berminggu-minggu. Kepercayaan pada agen harus terbangun dengan cara yang sama, dengan mencatat secara jujur apa yang dilakukannya dengan benar dan salah pada jenis tugas tertentu, bukan dengan mengasumsikan kinerja minggu pertama memprediksi minggu kedua belas.
Pagar pengaman. Kepercayaan lebih mudah diberikan ketika biaya kesalahan terbatas. Agen yang dibatasi untuk menyusun draf, bukan mengirim; merekomendasikan, bukan mengeksekusi pembayaran; menandai, bukan menutup tiket secara otomatis, memberi orang ruang untuk memverifikasi sebelum sesuatu yang tak dapat dibatalkan terjadi. Kami membahas lebih jauh pembatasan wewenang itu dalam guardrail agen AI.
Human-in-the-loop dengan perancangan, bukan secara default. Ada perbedaan nyata antara alur kerja dengan titik pemeriksaan yang sengaja ditempatkan di tempat kesalahan paling berdampak, dan alur kerja tempat seorang manusia kebetulan melirik output karena begitulah yang selalu dilakukan. Human-in-the-loop yang dijalankan dengan baik menempatkan titik pemeriksaan di titik berdaya ungkit tertinggi, bukan di mana-mana, karena itulah yang menyebabkan pola kegagalan kurang percaya sejak awal.
Sisi Tim dan Budaya: Norma Bersama tentang Kapan Harus Memeriksa
Tidak satu pun dari hal di atas berhasil jika hanya hidup di kepala satu orang yang teliti. Titik kegagalan sebenarnya pada kebanyakan tim bukan bahwa tak seorang pun tahu harus memverifikasi output agen, melainkan bahwa tidak ada jawaban bersama yang eksplisit untuk "siapa memeriksa apa, dan kapan," sehingga semua orang kembali ke naluri masing-masing, dan naluri sangat beragam. Satu orang memeriksa acak segalanya; yang lain meneruskan draf agen tanpa melihat dua kali; tak satu pun mengikuti norma tertulis, karena memang tidak ada.
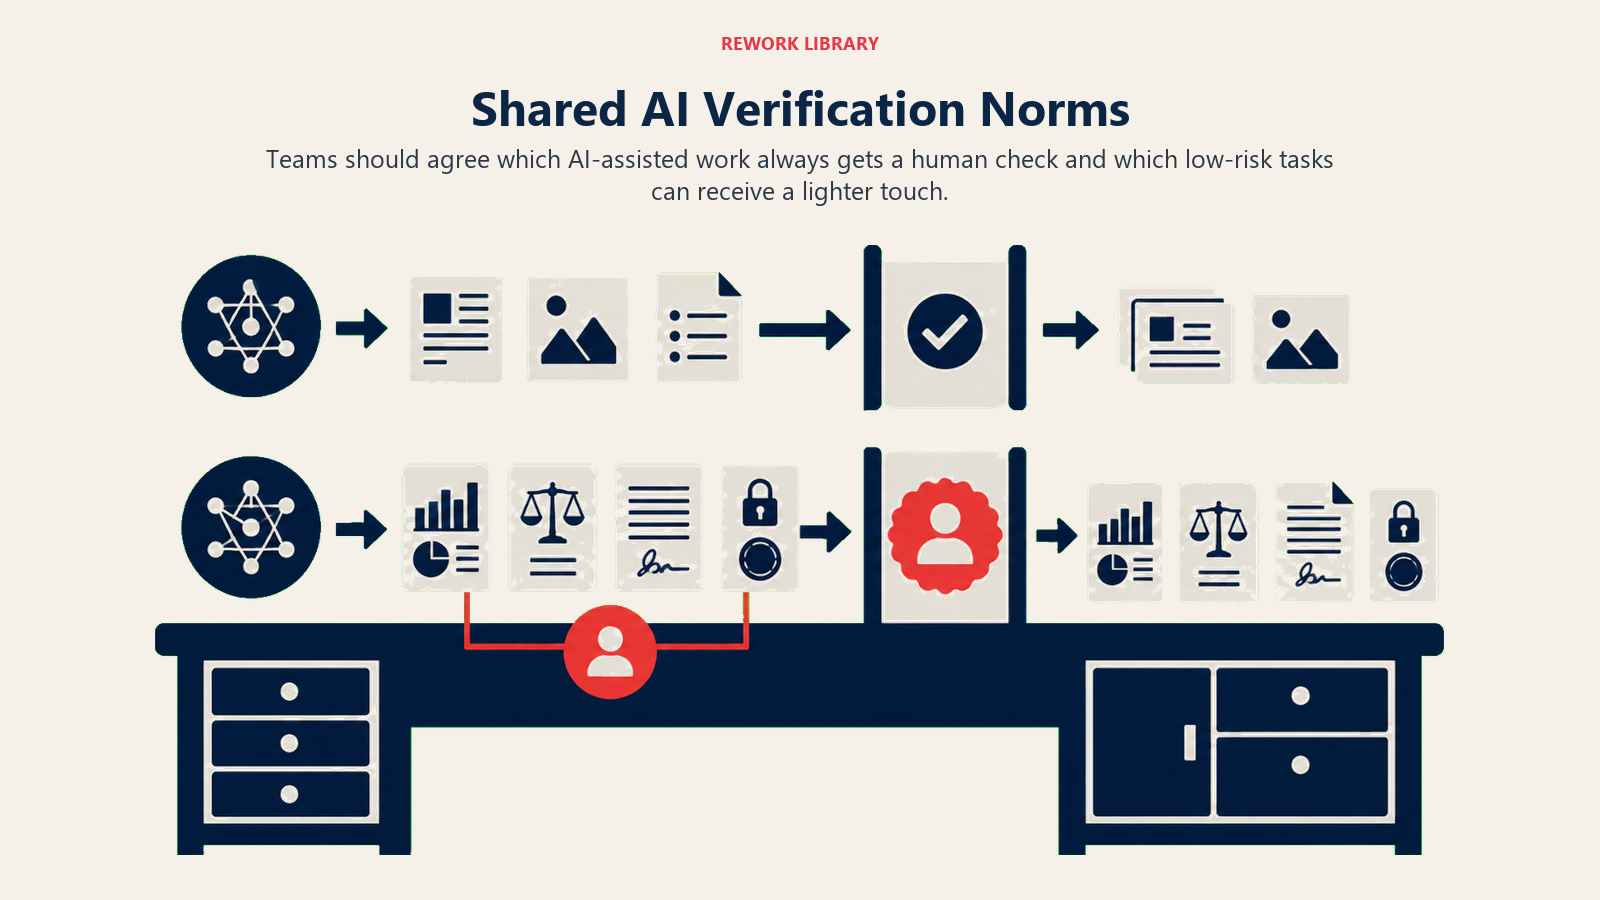
Ini sepenuhnya masalah budaya, bukan perangkat. Etiket AI dan norma tempat kerja membahas himpunan aturan tak tertulis yang lebih luas yang sedang dinegosiasikan tim seputar pengungkapan dan pemakaian yang tepat; versi khusus kepercayaannya berarti menyepakati, dengan lantang, kategori pekerjaan mana yang selalu mendapat pemeriksaan manusia sebelum apa pun terjadi ke luar (angka untuk klien, bahasa hukum, apa pun yang tak dapat dibatalkan) dan kategori mana yang cukup berisiko rendah untuk disentuh ringan. Salah membagi di salah satu arah mereproduksi salah satu dari dua pola kegagalan di atas pada tingkat tim, bukan individu.
Norma yang sama menjadi lebih penting, bukan kurang, ketika agen berhenti menjadi alat yang dioperasikan satu orang dan mulai bertindak sebagai bagian dari output nyata tim, pergeseran yang dibahas dalam tim manusia-agen. Tim tanpa norma kepercayaan bersama tidak gagal dengan gaduh. Ia mengumpulkan jenis kesenjangan yang disebut Deloitte AI cultural debt: ketergantungan berlebihan yang diam-diam di sebagian sudut, pemeriksaan ganda yang redundan secara diam-diam di sudut lain, tak seorang pun punya gambaran jelas mana yang terjadi di mana sampai kesalahan yang terlihat memaksa percakapan itu. Menyelesaikan ini dengan benar adalah satu bagian dari pergeseran yang lebih besar yang dibahas dalam seperti apa sebenarnya budaya AI-native, tempat kepercayaan, kepemilikan, dan akuntabilitas semuanya harus dibangun ulang dengan sengaja.
Semua ini tidak khas bagi perusahaan dengan tim AI khusus. Toko beranggotakan lima orang yang memakai agen untuk menyusun email penjangkauan membutuhkan jawaban eksplisit yang sama atas "siapa yang memeriksa ini sebelum keluar" seperti perusahaan beranggotakan seribu orang. Taruhannya bertambah seiring ukuran perusahaan; masalah kalibrasinya tidak.
Langkah Selanjutnya
- Cara membangun kepercayaan di tempat kerja, model kepercayaan antarmanusia yang menjadi pembanding artikel ini
- Tim manusia-agen, apa yang berubah ketika agen menjadi bagian dari output nyata, bukan sekadar alat
- AI cultural debt, apa yang terjadi ketika norma kepercayaan tak pernah dibangun dan kesenjangannya menumpuk
- Etiket AI dan norma tempat kerja, himpunan aturan tak tertulis yang lebih luas yang sedang dinegosiasikan tim seputar pemakaian AI
- Apa itu budaya AI-native?, gambaran lengkap tentang bagaimana kepercayaan dan akuntabilitas bergeser ketika agen menjadi rekan tim
- Apa itu agentic AI?, bagaimana sistem ini merencanakan dan bertindak, sebagian alasan mengapa kesalahannya tampak berbeda dari alat biasa
- Halusinasi AI, mekanisme spesifik di balik output yang yakin, lancar, dan salah
- Human-in-the-loop, cara merancang titik pemeriksaan alih-alih menyerahkannya pada kebiasaan
Kepercayaan pada rekan tim AI sebaiknya bukan perasaan pribadi yang dipikul oleh siapa pun yang kebetulan paling dekat mengamatinya. Jadikan itu pengukuran: catat di mana agen andal, di mana tidak, dan bagikan pembacaan itu ke seluruh tim agar kepercayaan terkalibrasi, bukan diasumsikan. Tim yang melakukan ini berhenti berayun antara iman buta dan kecurigaan menyeluruh, dan mulai memakai agen persis untuk apa yang telah ia buktikan, tidak lebih dan tidak kurang.

Co-Founder, Rework.com
On this page
- Mengapa Memercayai AI Adalah Masalah yang Berbeda dari Memercayai Manusia
- Yakin dan Salah Tampak Identik dengan Yakin dan Benar
- Dua Pola Kegagalan: Kurang Percaya dan Terlalu Percaya
- Kurang Percaya: Mengerjakan Ulang Pekerjaan Agen secara Manual
- Terlalu Percaya: Automation Bias dan Biaya Melewatkan Pemeriksaan
- Fakta Penting
- Kepercayaan Terkalibrasi: Percaya tetapi Verifikasi, dengan Spesifik
- Ketahui Di Mana Agen Andal dan Di Mana Tidak
- Seperti Apa Verifikasi Sehari-hari
- Apa yang Membangun Kepercayaan yang Tepat pada AI
- Sisi Tim dan Budaya: Norma Bersama tentang Kapan Harus Memeriksa
- Langkah Selanjutnya