Bahasa Indonesia
Keamanan Psikologis di Tim AI: Aman untuk Bertanya, Aman untuk Menolak
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
Keamanan psikologis di tim AI adalah konsep asli Amy Edmondson, yakni keyakinan bersama bahwa sebuah tim aman untuk mengambil risiko antarpribadi, yang diperluas ke serangkaian risiko baru yang hanya ada ketika AI mengerjakan sebagian pekerjaan. Artinya, orang merasa aman mempertanyakan hasil sebuah agen, mengakui bahwa mereka memakai AI untuk suatu tugas, menandai kesalahan AI atau menimpa rekomendasinya, dan mengatakan dengan jelas, "Saya tidak memercayai hasil ini," tanpa semua itu merugikan status, kredibilitas, atau menorehkan catatan buruk pada nama mereka.
Edmondson membangun kariernya dengan meneliti mengapa orang tetap diam di rumah sakit, kokpit pesawat, dan ruang rapat direksi, bahkan ketika bersuara dapat menyelamatkan nyawa atau sebuah proyek. Mekanisme yang ia temukan, bahwa diam adalah respons rasional terhadap ruangan yang menghukum risiko, berpindah nyaris utuh ke AI. Dulu tidak ada yang butuh izin untuk tidak memercayai sebuah spreadsheet. Kini semakin banyak tenaga kerja membutuhkan izin persis seperti itu, dan kebanyakan tim belum pernah memberikannya secara terang-terangan. Artikel ini membahas apa yang benar-benar baru tentang rasa aman di tim manusia-AI, mengapa automation bias dan kepatuhan berlebihan menjadi mode kegagalan yang muncul saat rasa aman itu tidak ada, riset nyata tentang mengapa orang berhenti bertanya "mengapa," dan apa yang dilakukan pemimpin untuk membangunnya kembali.
Memperluas Model Edmondson: Empat Hal Baru yang Perlu Orang Rasakan Aman untuk Diucapkan
Model empat tahap asli Edmondson, yaitu keamanan inklusi, pembelajar, kontributor, dan penantang, dibangun di seputar interaksi antarmanusia. Kami membahas model lengkapnya di keamanan psikologis di tempat kerja. Begitu sebuah agen AI menjadi bagian kerja dari tim, bukan alat yang dipakai satu orang secara diam-diam di samping, keempat tahap yang sama harus diregangkan untuk mencakup serangkaian momen baru yang tak pernah perlu Edmondson modelkan pada 1999, karena yang dipertanyakan dulu selalu seorang rekan kerja.
Aman Mempertanyakan Hasil AI
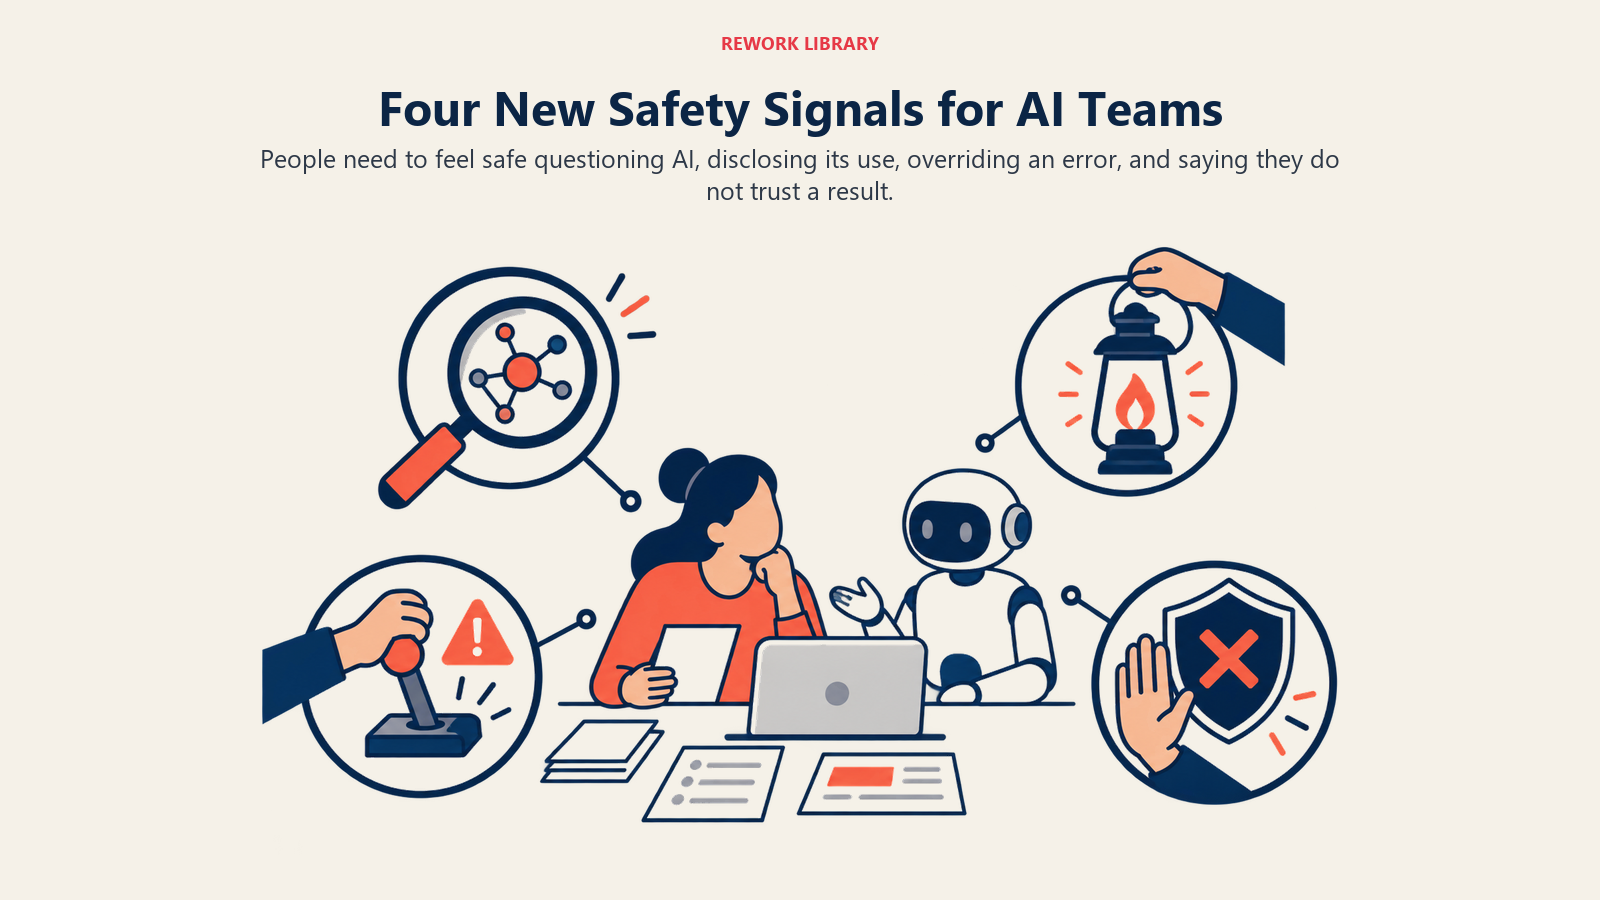
Seseorang melihat apa yang dihasilkan sebuah agen dan punya firasat mengganjal bahwa ada yang janggal: angka yang tidak cocok dengan intuisinya, kutipan yang terbaca terlalu rapi, langkah yang ia harapkan akan ditandai oleh seseorang. Keamanan penantang, dalam model Edmondson, adalah tahap ketika orang merasa bebas mempertanyakan rencana atau orang yang memimpin. Versi tim AI dari tahap itu adalah mempertanyakan mesin, dan ia membawa harga sosial yang berbeda: tak ada yang tampak buruk karena meragukan ide rekan kerja dengan cara yang sama seperti mereka bisa tampak lamban atau paranoid karena meragukan sistem yang "semua orang lain" tampaknya terima tanpa komentar.
Aman Mengakui bahwa Anda Memakai AI
Yang satu ini lebih dekat ke keamanan inklusi dan pembelajar. Memakai AI untuk draf, ringkasan, atau analisis bukanlah pengakuan dosa, tetapi diperlakukan seperti itu di banyak tim, karena tak ada yang pernah mengatakan dengan lantang bahwa itu bukan pengakuan dosa. Orang yang menyembunyikan penggunaan AI-nya tidak berbohong karena niat jahat; mereka membaca ruangan dengan benar jika ruangan itu belum pernah membuat keterbukaan terasa aman. Keheningan itu berbiaya langsung: manajer kehilangan visibilitas tentang bagaimana pekerjaan sebenarnya dihasilkan, yang berarti mereka tidak bisa menangkap mode kegagalan yang persis menjadi pokok artikel ini.
Aman Menandai Kesalahan AI atau Menimpa Rekomendasinya
Sebuah agen melakukan kesalahan, atau seseorang menimpa apa yang direkomendasikannya dan melakukan hal lain. Keduanya adalah momen keamanan kontributor, yaitu menggunakan penilaian Anda dan membuatnya diperhitungkan, tetapi kini melibatkan penimpaan sebuah sistem yang diadakan, dikonfigurasi, dan mungkin diperjuangkan oleh seseorang yang senior. Menandai kesalahan seseorang berisiko menimbulkan percakapan yang canggung. Menandai atau menimpa kesalahan sebuah sistem berisiko tampak seperti tidak memercayai investasi yang baru saja dilakukan perusahaan di sistem itu, yaitu risiko yang berbeda, dan sering lebih berat, untuk dipikul sendirian.
Aman Mengatakan "Saya Tidak Memercayai Hasil Ini"
Inilah kalimat yang paling penting, dan yang paling jarang dilatih diucapkan oleh kebanyakan tim. Ini bukan klaim teknis tentang akurasi; ini pernyataan ketidakpastian dari orang yang seharusnya tampak kompeten dan tegas. Mengatakannya tentang pekerjaan rekan kerja memang tidak nyaman, tetapi sudah akrab. Mengatakannya tentang sebuah sistem yang menghasilkan jawaban cepat, fasih, dan tampak profesional, sementara tak seorang pun di ruangan itu berkeberatan, adalah risiko antarpribadi yang benar-benar baru, yang menjadi dasar nama artikel ini.
Automation Bias dan Kepatuhan Berlebihan: Mode Kegagalan Baru
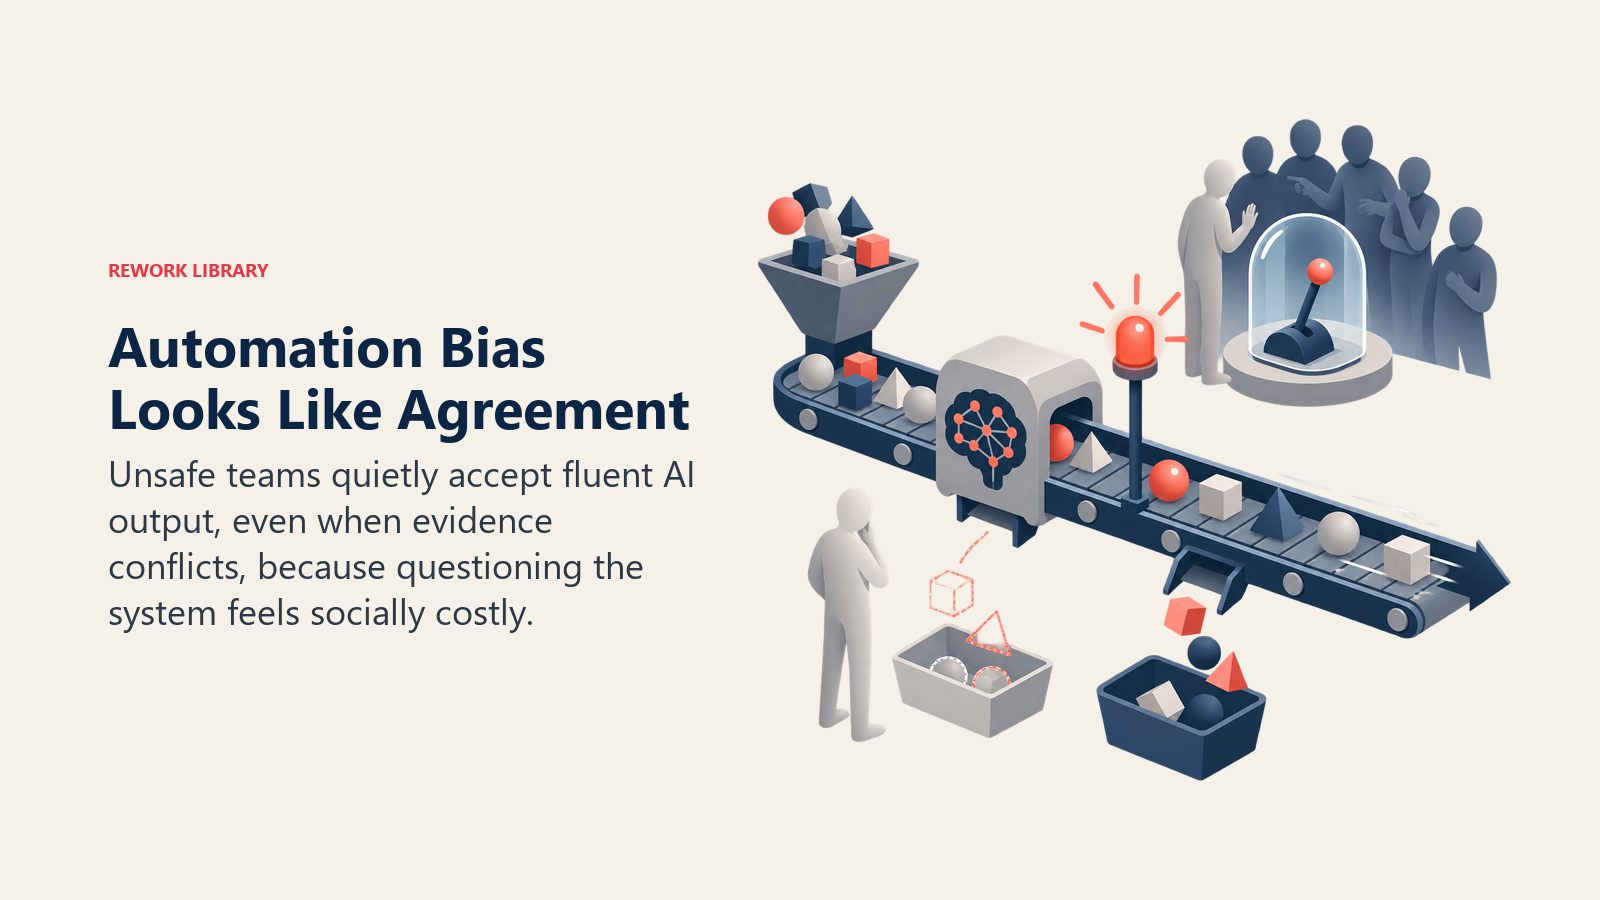
Inilah bagian yang sama sekali terlewat oleh kebanyakan saran tentang keamanan psikologis. Ketika sebuah tim tidak aman di sekitar AI, kegagalannya tidak tampak seperti konflik. Ia tampak seperti kesepakatan. Semua orang mengangguk, hasilnya dirilis, dan tim tampak selaras sempurna sampai kesalahannya muncul di tempat yang mahal.
Apa Sebenarnya Automation Bias
Peneliti Linda Skitka, Kathleen Mosier, dan Malcolm Burdick memberi nama pada pola ini dalam studi 1999 yang masih menjadi kutipan jangkar di bidangnya: automation bias, yaitu kecenderungan menerima output sistem otomatis sebagai pengganti pemeriksaan cermat yang seharusnya dilakukan seseorang sendiri. Riset mereka, yang dijalankan dalam tugas pemantauan penerbangan simulasi, menemukan sesuatu yang cukup spesifik untuk penting di sini: orang membuat dua jenis kesalahan yang berbeda. Kesalahan omisi, yaitu gagal memperhatikan masalah karena sistem otomatis tidak menandainya. Dan kesalahan komisi, yaitu secara aktif mengikuti rekomendasi otomatis meskipun informasi lain yang tersedia bagi mereka menunjukkan rekomendasi itu keliru. Sumber: Skitka, Mosier & Burdick, "Does Automation Bias Decision-Making?"
Kategori kedua itulah yang penting bagi percakapan tentang budaya. Kesalahan komisi bukan kecelakaan. Ia adalah seseorang yang memilih jawaban otomatis dibandingkan penilaiannya sendiri, pada saat itu, sering kali sementara isyarat lain terpampang tepat di hadapannya. Itu bukan kesenjangan pelatihan. Itu keputusan yang dibentuk oleh apa yang membuat orang di sekitarnya nyaman untuk dikatakan dan dilakukan.
Mengapa Keamanan Psikologis Adalah Variabel yang Hilang
Kebanyakan tulisan tentang automation bias memperlakukannya sebagai cacat kognitif individu, sesuatu yang diperbaiki dengan UI yang lebih baik atau modul pelatihan. Pembingkaian itu melewatkan sepenuhnya mekanisme di tingkat tim. Kesalahan komisi paling mudah terjadi justru ketika mempertanyakan sistem terasa mahal secara sosial dan diam terasa gratis. Balikkan insentifnya dan orang yang sama, dengan pengkabelan kognitif yang sama, berperilaku berbeda. Temuan laboratorium Skitka dan riset lapangan Edmondson menggambarkan bentuk yang sama dari dua arah: automation bias menunjukkan bahwa orang cenderung menerima saat tidak yakin, dan keamanan psikologis menunjukkan apa yang membuat bersuara saat tidak yakin menjadi mahal atau gratis. Kepatuhan berlebihan pada AI bukan jenis kegagalan manusia yang baru. Ia kegagalan tertua Edmondson, tim yang menghukum suara dan menghargai keheningan, dengan antarmuka baru.
Studi Petugas Pinjaman: Ketika Tidak Bertanya "Mengapa" Adalah Tujuannya
Studi 2026 yang dipimpin Alex Chan dari Harvard Business School memberi angka nyata tentang betapa disengajanya keheningan itu. Para peneliti meminta 2.512 peserta daring berperan sebagai petugas pemberi pinjaman yang meninjau pasangan permohonan pinjaman nyata senilai $10.000, dengan sebuah sistem AI memberikan skor risiko untuk masing-masing. Delapan puluh persen peserta ingin melihat skor risiko AI, tetapi hanya 46% yang melangkah lebih jauh dan meminta melihat penjelasan di baliknya, meskipun penjelasan itu hanya berjarak satu klik. Ketika peneliti secara acak memberi sebagian peserta bonus keuangan yang terkait dengan seberapa baik pinjaman itu benar-benar berkinerja, bukan honor tetap, penghindaran penjelasan naik 20 poin persentase, dan penghindaran melonjak lebih dari 10 poin tambahan ketika peserta punya alasan meyakini bahwa penjelasan itu mungkin mengungkap bahwa ras atau gender memengaruhi skor AI. Sumber: HBS Working Knowledge, "When AI Gives Advice, Employees Rarely Ask Why"
Pembingkaian Chan sendiri atas hasil ini adalah kalimat yang patut direnungkan: "Risiko terbesar AI bukan sekadar jawaban yang buruk atau kurangnya adopsi. Melainkan melatih orang untuk berhenti bertanya mengapa." Para pesertanya tidak bingung bagaimana melihat penalaran AI. Sebagian yang berarti dari mereka memilih untuk tidak melihat, karena melihat berisiko memunculkan sesuatu yang tidak menyenangkan. Itu bukan automation bias sebagai jalan pintas kognitif yang pasif. Itu automation bias sebagai pilihan aktif yang bermotif, yang paling mudah dibuat dalam susunan ketika insentif siapa pun tidak menghargai pertanyaan yang lebih sulit.
Fakta Penting
- Automation bias, kecenderungan menerima output sistem otomatis dibandingkan pemeriksaan cermat seseorang sendiri, didefinisikan oleh studi Skitka, Mosier, dan Burdick tahun 1999, yang menemukan orang membuat kesalahan omisi (melewatkan masalah yang tidak ditandai sistem) dan kesalahan komisi (secara aktif mengikuti rekomendasi otomatis yang buruk dibandingkan bukti yang bertentangan). Sumber: International Journal of Human-Computer Studies, via ACM
- Dalam studi 2026 terhadap 2.512 peserta yang berperan sebagai petugas pinjaman, 80% ingin melihat skor risiko sistem AI tetapi hanya 46% yang meminta melihat penjelasan di baliknya; penghindaran penjelasan naik 20 poin persentase ketika bonus keuangan dikaitkan dengan kinerja pinjaman, dan naik lebih dari 10 poin tambahan ketika penjelasan berisiko mengungkap bias ras atau gender. Sumber: HBS Working Knowledge
- Riset Harvard Business Review 2026 oleh Amy Edmondson dan Jayshree Seth menemukan bahwa meskipun perusahaan mengharapkan kenaikan produktivitas dari AI, kinerja tim justru sering menurun: orang mulai meragukan diri sendiri dan kepercayaan terkikis dengan cara yang sulit dipastikan, dinamika yang mereka sebut "ambiguitas kepercayaan." Sumber: Harvard Business Review
- Work Trend Index 2026 dari Microsoft menemukan bahwa ketika manajer secara sengaja menciptakan keamanan psikologis seputar eksperimen AI, karyawan melaporkan kesiapan dan nilai yang dirasakan terhadap AI hingga 20 poin lebih tinggi, dan 1,4 kali lebih mungkin menjadi pengguna AI agentik berfrekuensi tinggi. Sumber: Microsoft Work Trend Index 2026
- Riset Global Human Capital Trends 2026 dari Deloitte menemukan bahwa 60% eksekutif sudah memakai AI dalam pengambilan keputusan, tetapi hanya 5% yang mengatakan mereka mengelolanya dengan baik, kesenjangan yang menumpuk menjadi apa yang disebut Deloitte AI cultural debt ketika tak seorang pun cukup merasa aman untuk menyebutkan masalahnya dengan lantang. Sumber: Deloitte 2026 Global Human Capital Trends
Mengapa Keheningan Jenis Ini Mudah Terlewat
Keheningan model lama dalam rapat punya bentuk yang akrab: seseorang punya kekhawatiran, ruangan menjadi sunyi, dan semua orang bisa merasakan ketegangannya meski tak ada yang menyebutnya. Keheningan di sekitar AI sering kali sama sekali tidak terasa seperti ketegangan. Ia terasa seperti kesepakatan yang mulus, karena tunduk pada sebuah sistem tidak membawa bobot sosial yang terlihat seperti tunduk pada seseorang. Tak ada yang melihat rekan kerja diam-diam menerima angka dari AI lalu menafsirkannya sebagai mengalah seperti ketika menafsirkan seseorang menyerah pada suara keras di ruangan. Itulah yang membuatnya berbahaya: tim bisa tampak sangat aman, penuh debat terbuka tentang segala hal yang tidak mereka sepakati satu sama lain, sambil menjalankan titik buta yang tidak diperiksa di sekitar apa pun yang disentuh AI.
Riset Edmondson dan Seth tahun 2026 menyebut mekanismenya secara langsung: pemakaian AI yang berkelanjutan dapat diam-diam mengikis kepercayaan diri seseorang untuk menantang hasil AI, bahkan ketika ia memiliki keahlian persis yang diperlukan untuk menangkap apa yang salah. Itu kebalikan dari cara kepercayaan diri biasanya bekerja, karena seorang ahli di bidangnya biasanya makin tegas seiring pengalaman, bukan makin ragu. Menyaksikan jawaban yang fasih dan tampak profesional dihasilkan berulang kali mengajarkan pelajaran yang berbeda: bahwa keraguan untuk menerimanya yang perlu dibenarkan, bukan penerimaannya. Kepercayaan ketika rekan tim Anda adalah AI membahas mengapa hasil AI jauh lebih sulit dibaca tingkat keyakinannya dibandingkan hasil seseorang; ini adalah konsekuensi keamanan dari mekanisme yang sama, yang berlangsung sebagai keraguan diri yang senyap, bukan perbedaan pendapat terbuka yang bisa ditunjuk dan diperbaiki siapa pun.
Biayanya bertumpuk karena tak terlihat saat terjadi. Orang yang menelan keraguan tentang rencana rekan kerja setidaknya tahu bahwa ia melakukannya. Orang yang menerima hasil AI tanpa menyuarakan keraguan sering kali tidak mengalaminya sebagai mengalah sama sekali; rasanya hanya seperti melanjutkan pekerjaan. Kalikan itu di seluruh tim selama berbulan-bulan dan Anda mendapatkan kelompok yang diam-diam berhenti melatih penilaian persis yang menjadi alasan mereka direkrut, tanpa satu momen pun yang bisa ditunjuk siapa pun sebagai titik awal kekeliruan.
Apa yang Dilakukan Pemimpin untuk Membangun Keamanan Psikologis di Tim AI
Tim yang terhindar dari mode kegagalan ini bukan tim dengan kebijakan AI paling berhati-hati. Mereka adalah tim yang sejumlah perilaku spesifik pemimpinnya membuat bertanya, mengakui, dan meragukan menjadi bagian normal dari cara kerja, bukan pengecualian yang harus dibenarkan seseorang.
Teladankan Sendiri Sikap Mempertanyakan AI, Secara Terlihat
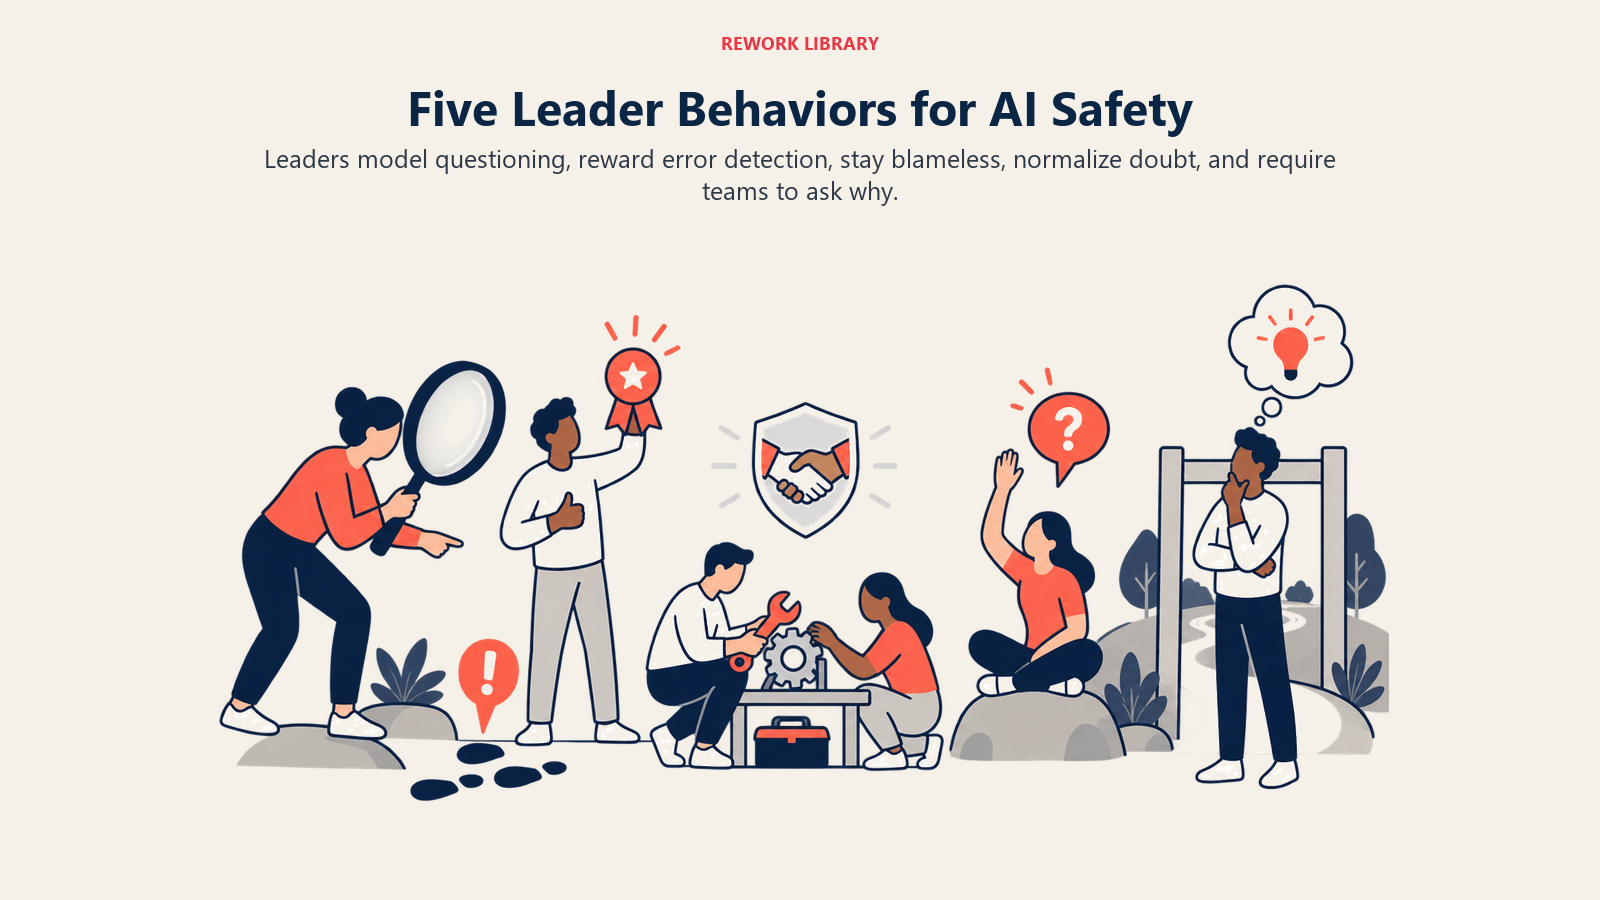
Langkah berdaya ungkit tertinggi adalah pemimpin secara terbuka meragukan hasil AI di depan tim, termasuk saat hasil itu ternyata benar. "Saya ingin mengecek angka ini sebelum kita memakainya," yang diucapkan oleh orang paling senior di ruangan, berbuat lebih banyak untuk mengizinkan perilaku yang sama pada semua orang daripada kebijakan tertulis mana pun. Riset Microsoft tentang manajer yang secara terlihat meneladankan pemakaian AI mereka sendiri menemukan efek nyata dan terukur pada kesediaan seluruh tim untuk terlibat secara kritis dengan AI, bukan sekadar adopsinya. Perilaku yang menyebar adalah tindakan mengecek yang terlihat, bukan memo yang menyatakan pengecekan dianjurkan.
Hargai Penangkapan Kesalahan, Bukan Sekadar Rilis Cepat
Jika satu-satunya hasil yang diakui dalam sebuah tim adalah kecepatan, siapa pun yang menangkap hasil AI yang cacat dan memperlambat pekerjaan untuk memperbaikinya tampak seperti orang yang melewatkan tenggat, bukan yang menyelamatkan proyek. Sistem pengakuan yang seluruhnya dibangun di seputar throughput diam-diam melatih orang untuk berhenti memeriksa terlalu teliti. Menyebut dan memberi kredit kepada siapa pun yang menangkap kesalahan AI sebelum dirilis, seperti tim yang baik memberi kredit kepada yang menemukan bug sebelum rilis, menjadikan menangkap kesalahan sebagai langkah yang membangun status, bukan yang mempertaruhkannya.
Perlakukan Kesalahan AI sebagai Tanpa Menyalahkan, Setiap Kali
Cara sebuah tim menanggapi kesalahan melatih semua orang yang menyaksikan, entah kesalahan itu berasal dari manusia atau mesin. Budaya menyalahkan vs. budaya belajar sama relevannya untuk kesalahan agen seperti untuk kesalahan seseorang. Tim yang diam-diam menyalahkan siapa pun yang "seharusnya menangkap" kesalahan AI mengajarkan semua orang bahwa langkah teraman berikutnya adalah diam, bukan menelaah. Tim yang memperlakukan kesalahan itu sebagai informasi, apa yang terlewat oleh agen dan apa yang berubah agar tidak terulang, menjaga pintu tetap terbuka bagi orang berikutnya untuk bersuara dengan jujur alih-alih melindungi diri sendiri.
Jadikan "Saya Tidak Memercayai Ini" Kalimat yang Normal
Pemimpin dapat menyebutkan hal ini secara langsung alih-alih berharap ia muncul sendiri. Mengatakan dalam rapat tim, "jika Anda melihat apa yang dihasilkan agen dan merasa ada yang janggal, itulah kalimat yang ingin saya dengar, meski Anda belum bisa menjelaskan sepenuhnya mengapa," bekerja lebih banyak daripada kesannya. Ia mengubah perasaan samar yang sulit dibenarkan menjadi kontribusi yang disambut secara eksplisit, persis kesenjangan yang ditemukan riset Chan: menghindari pertanyaan bukan karena kurang alat untuk mengajukannya, tetapi karena tak ada apa pun di ruangan itu yang memberi tahu mereka bahwa bertanya sepadan dengan gesekannya.
Bangun Kebiasaan Bertanya "Mengapa," Bukan Hanya "Apa"
Tim yang bertanya "apa yang direkomendasikan AI" lalu berhenti di sana secara struktural disiapkan untuk kepatuhan berlebihan yang dijelaskan artikel ini. Tim yang membangun "mengapa ia merekomendasikan itu, dan apakah penalarannya masuk akal" ke dalam alur kerja itu sendiri, sebagai langkah standar di atas ambang taruhan yang ditetapkan dan bukan sekadar pengecekan naluri sesekali, melakukan kebalikan dari apa yang dilakukan peserta Chan ketika bonus membuat penjelasan tidak nyaman untuk dilihat. Ini disiplin yang sama yang dibutuhkan tim manusia-agen untuk akuntabilitas secara umum, diterapkan pada momen sebelum hasil dirilis, bukan setelah ada yang sudah salah.
Audit Singkat: Apakah Tim Anda Benar-Benar Memilikinya?
Kebanyakan tim tidak bisa mengetahui apakah mereka memiliki keamanan psikologis seputar AI sampai mereka mencari sinyal spesifik, bukan sekadar suasana umum. Tabel di bawah memisahkan seperti apa wujud rasa aman yang ada dari wujud ketiadaannya, karena keduanya bisa tampak tenang di permukaan.
| Sinyal | Ada | Tidak ada |
|---|---|---|
| Mempertanyakan hasil AI | Orang berkata "Saya ingin mengecek ini" tanpa berbasa-basi atau meminta maaf lebih dulu | Keraguan baru disampaikan secara pribadi, setelah hasilnya sudah dirilis |
| Mengakui pemakaian AI | Keterbukaan adalah rutinitas, disebut dengan cara yang sama seperti menyebut sebuah sumber | Pemakaian AI hanya disebut bila ditanya langsung, atau sama sekali tidak |
| Menandai atau menimpa kesalahan AI | Orang yang menangkap kesalahan disebut namanya dan diberi kredit | Kesalahan muncul belakangan tanpa catatan jelas siapa yang nyaris menangkapnya |
| Mengatakan "Saya tidak memercayai ini" | Dikatakan terus terang dalam forum tim, diperlakukan sebagai informasi yang berguna | Hanya dikatakan empat mata, kalaupun dikatakan, dan diperlakukan sebagai pengakuan dosa |
| Perilaku pemimpin | Pemimpin secara terlihat mempertanyakan hasil AI sendiri, termasuk hasil mereka sendiri | Pemimpin menganggap hasil AI sudah final begitu orang senior menyetujuinya |
Tim yang sebagian besar mengenali dirinya di kolom kanan tidak rusak; ia hanya menjalankan susunan persis yang diprediksi oleh riset Chan maupun kerangka automation bias asli Skitka akan diam-diam mengumpulkan kesalahan komisi. Solusinya bukan alat baru. Melainkan menjadikan kolom kiri sebagai cara normal dan biasa saja yang sudah dipakai tim untuk berbicara.
Langkah Selanjutnya
Artikel ini memperluas riset dasar tentang keamanan psikologis ke konteks baru yang spesifik. Dari sini:
- Keamanan psikologis di tempat kerja, untuk model empat tahap asli Edmondson dan riset Project Aristotle Google yang menjadi dasar artikel ini
- Kepercayaan ketika rekan tim Anda adalah AI, untuk mekanisme kepercayaan yang terkalibrasi dan mengapa nada percaya diri AI tidak bisa dibaca seperti nada seseorang
- Tim manusia-agen, untuk pertanyaan kepemilikan dan akuntabilitas yang muncul begitu sebuah agen menjadi bagian kerja tim
- Budaya menyalahkan vs. budaya belajar, untuk bagaimana respons tim terhadap kesalahan apa pun, manusia atau AI, menentukan apakah orang berikutnya akan bersuara
- AI cultural debt, untuk apa yang menumpuk ketika kesenjangan kepercayaan dan rasa aman seputar AI tidak ditangani
- Etiket AI dan norma tempat kerja, untuk kumpulan aturan tak tertulis yang lebih luas seputar keterbukaan, tempat kategori risiko kedua artikel ini berada
- Frontier Firm dan bangkitnya agent boss, untuk bagaimana peran orkestrator mengubah apa yang perlu diteladankan pemimpin
- Membangun budaya yang siap AI, untuk kumpulan praktik yang lebih luas tempat ini berada
- Apa itu budaya AI-native?, untuk konsep dasar tempat pertanyaan-pertanyaan artikel ini berada
- Memimpin budaya di era AI, untuk gambaran kepemimpinan lengkap di seluruh Bagian 7
Kesehatan sebuah tim AI terlihat pada satu momen: ketika seseorang berkata "Saya tidak memercayai hasil ini," apakah ruangan memperlakukannya sebagai menjalankan tugas, atau sebagai memperlambat semua orang? Norma keterbukaan, pelaporan kesalahan, kesediaan menimpa mesin yang meyakinkan, semuanya mengikuti jawabannya. Bangunlah untuk momen itu dan sisanya menjadi lebih mudah. Hukum sekali saja dan orang diam-diam berhenti mengatakannya, tepat ketika automation bias mulai merugikan Anda.

Co-Founder, Rework.com
On this page
- Memperluas Model Edmondson: Empat Hal Baru yang Perlu Orang Rasakan Aman untuk Diucapkan
- Aman Mempertanyakan Hasil AI
- Aman Mengakui bahwa Anda Memakai AI
- Aman Menandai Kesalahan AI atau Menimpa Rekomendasinya
- Aman Mengatakan "Saya Tidak Memercayai Hasil Ini"
- Automation Bias dan Kepatuhan Berlebihan: Mode Kegagalan Baru
- Apa Sebenarnya Automation Bias
- Mengapa Keamanan Psikologis Adalah Variabel yang Hilang
- Studi Petugas Pinjaman: Ketika Tidak Bertanya "Mengapa" Adalah Tujuannya
- Fakta Penting
- Mengapa Keheningan Jenis Ini Mudah Terlewat
- Apa yang Dilakukan Pemimpin untuk Membangun Keamanan Psikologis di Tim AI
- Teladankan Sendiri Sikap Mempertanyakan AI, Secara Terlihat
- Hargai Penangkapan Kesalahan, Bukan Sekadar Rilis Cepat
- Perlakukan Kesalahan AI sebagai Tanpa Menyalahkan, Setiap Kali
- Jadikan "Saya Tidak Memercayai Ini" Kalimat yang Normal
- Bangun Kebiasaan Bertanya "Mengapa," Bukan Hanya "Apa"
- Audit Singkat: Apakah Tim Anda Benar-Benar Memilikinya?
- Langkah Selanjutnya