Arquitectura del Registro de Cliente Compartido: Cómo el Esquema del CRM se Extiende a su Plataforma de CS
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
Dos equipos, dos plataformas, un cliente.
El AE cerró el trato en el CRM. El CSM gestiona la cuenta en la plataforma de CS. Esos dos registros casi nunca tienen el mismo esquema. Así que cuando el CSM necesita saber qué casos de uso se comprometieron en el ciclo de ventas, está leyendo un PDF que le enviaron por email. Cuando el AE necesita ver el health score antes de una conversación de renovación, lo pregunta en Slack. Cuando RevOps quiere construir un análisis de NRR que combine datos de tratos con datos de salud, está pasando una semana en hojas de cálculo.
Esto no es un problema de proceso. Es un problema de arquitectura. Y los arreglos de proceso, una reunión de sincronización semanal, una checklist de handoff, un documento compartido en Notion, no sobreviven a un esquema roto. La investigación de Forrester sobre plataformas de customer success muestra que las operaciones de CS más exitosas unifican los datos del cliente de todo el stack tecnológico mediante integraciones, y que la visibilidad del health score depende por completo de que la arquitectura de datos subyacente sea sólida. Los datos fluyen entre sistemas o no fluyen. El lado de marketing y ventas de este problema (donde un único CRM actúa como fuente de verdad en todo el go-to-market) se aborda en el CRM como única fuente de verdad; este artículo retoma el tema donde ese termina, específicamente en el punto de contacto entre AE y CS.
Este artículo trata específicamente sobre la cuestión del diseño de datos en el punto de contacto entre AE y CS: qué campos se extienden del CRM a la plataforma de CS, en qué dirección fluyen los datos de cada uno, quién es responsable de cada campo y qué mecanismo de sincronización los mantiene alineados. No trata sobre el principio de tener una única fuente de verdad: eso está cubierto en el artículo Única Fuente de Verdad: Registro del Cliente. Esta es la capa de implementación.
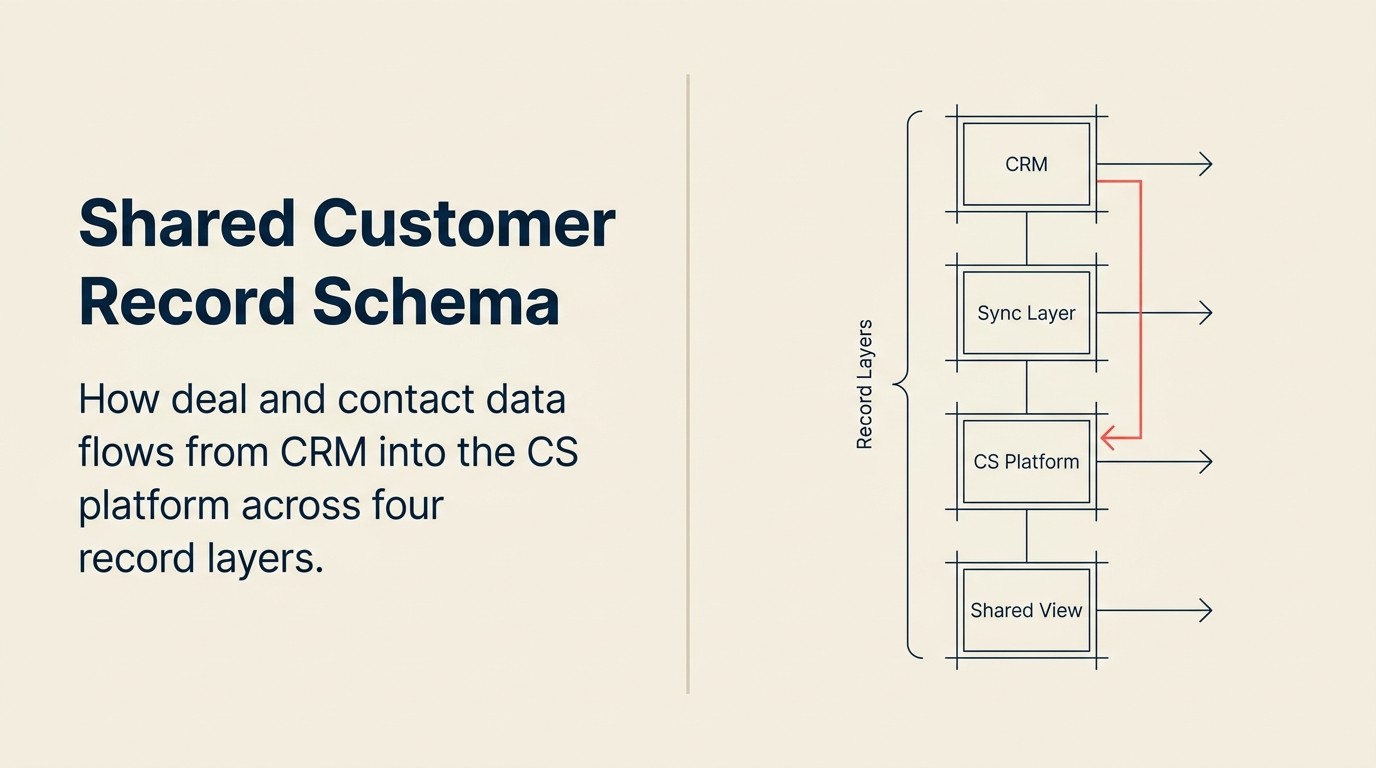
La Arquitectura de Registro de Cliente Compartido de 4 Capas define cómo se estructuran, se asignan y se sincronizan los datos de la cuenta en el punto de contacto entre AE y CS. La Capa 1 (Account Master) se origina en el CRM y es de solo lectura en CS. La Capa 2 (Deal Context) fluye del CRM a CS al cierre, una sola vez y de forma estática. La Capa 3 (Relationship Map) es de co-propiedad y se sincroniza bidireccionalmente. La Capa 4 (Health and Engagement) se origina en CS y es de solo lectura en el CRM para la visibilidad del AE. Cada capa tiene una dirección y un responsable definidos. Cuando falta alguna de las cuatro o está mal asignada, la coordinación entre el AE y el CSM se rompe de forma predecible.
Datos Clave: Desajustes de Esquema y Costo de Ingresos
- El 65% de los CSMs afirma que no tiene acceso fiable al contexto del trato del ciclo de ventas en el momento del handoff del cliente, según el Informe Anual de Benchmark de la Industria CS de Gainsight. La causa raíz es casi siempre un desajuste de esquema, no un fallo de proceso.
- Las empresas con datos de CRM y plataforma de CS bien integrados cierran un 25% más de ingresos de expansión porque los AEs tienen visibilidad del health score antes de las conversaciones de renovación, según la investigación de Revenue Operations de Forrester.
- Las organizaciones con un esquema de campos compartidos definido entre el CRM y la plataforma de CS registran un NRR entre 9 y 14 puntos porcentuales más alto que las que no lo tienen, según el informe SaaS Benchmarks de OpenView Partners.
Por Qué Esto es Diferente a "El CRM como Única Fuente de Verdad"
El concepto de única fuente de verdad establece que existe un registro autorizado para cada tipo de dato: contactos en el CRM, health scores en la plataforma de CS, con una sincronización que mantiene ambos visibles para ambos equipos. Es el principio.
Este artículo trata sobre la implementación: qué tiene que ser verdad a nivel de campo para que ese principio funcione en el punto de contacto entre AE y CS.
Las dos preguntas son diferentes. El principio de fuente única de verdad responde "¿quién es responsable de qué?" La pregunta de arquitectura responde "¿cómo llega ahí y cómo tiene que ser el esquema para que la sincronización funcione?" Se puede adoptar plenamente el principio de fuente única de verdad y aun así tener una implementación rota porque nadie diseñó el esquema compartido.
Un apunte más sobre el alcance: este artículo cubre únicamente el punto de contacto entre AE y CS: el handoff y la coordinación continua entre el equipo que cerró el trato y el equipo que gestiona la relación con el cliente. No cubre la selección de la plataforma de onboarding, la estrategia de herramientas de CS ni la mecánica de adopción posterior al onboarding. Son problemas distintos. El punto de contacto es suficientemente específico.
Las Cuatro Capas del Registro en el Punto de Contacto
Piense en el registro de cliente compartido como cuatro capas, cada una con diferente propiedad y diferente dirección de flujo de datos.
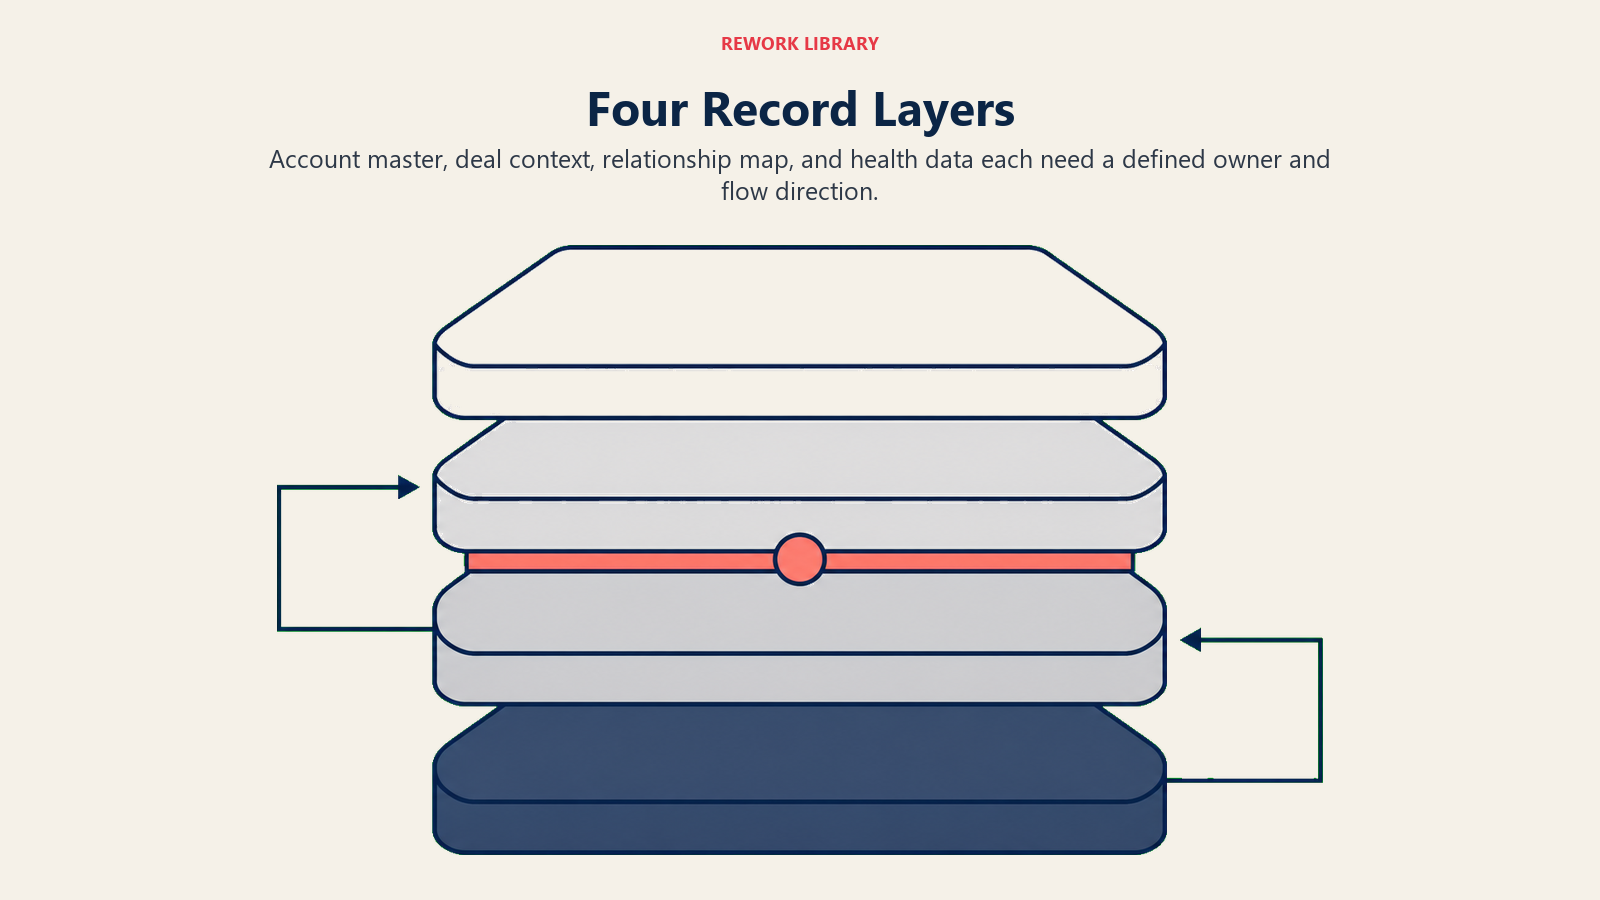
Capa 1: Account master. Perfil de la empresa, segmento de mercado, responsable AE, responsable CSM, designación de tier, valor del contrato y fecha de renovación. Esta capa es el esqueleto: indica a ambos equipos quién es el cliente y cómo es la relación comercial.
Reside en: CRM. Son datos originados en el CRM; es el registro de la relación comercial. Dirección: Solo lectura en la plataforma de CS. El equipo de CS lo lee; solo RevOps y el AE lo actualizan. Por qué importa: Si la designación de tier en el CRM no coincide con la de la plataforma de CS, la lógica de asignación de CSM se rompe. Las decisiones de cadencia de QBR se basan en el tier. Si el valor del contrato es diferente en los dos sistemas, el forecasting de renovaciones produce dos números distintos.
Capa 2: Contexto del trato. Los casos de uso cerrados, los compromisos adquiridos durante el ciclo de ventas, el mapa del champion al cierre, el nivel de descuento, el score de ajuste al ICP y las señales de alerta que el AE registró. Esta es la información que CS necesita desde el primer día para onboardear con éxito.
Reside en: CRM al cierre, luego fluye a la plataforma de CS como registro estático. Dirección: CRM → plataforma de CS, unidireccional, una sola vez. Estos datos se fijan al cierre del trato y no cambian. No es una sincronización en tiempo real: es un registro de lo que se comprometió en el momento en que el cliente firmó. Por qué importa: Sin esta capa, el CSM onboardea sin saber qué se vendió. El cliente llega con expectativas del ciclo de ventas; el CSM no tiene visibilidad sobre cuáles son esas expectativas. La confianza se erosiona en las primeras dos semanas. Las escalaciones que podrían haberse evitado ocurren porque nadie llevó el contexto del trato a través del handoff.
Capa 3: Mapa de relaciones. Contactos en la cuenta, sus roles y títulos, historial de engagement, quién es el champion, quién es el executive sponsor y señales sobre la estabilidad del champion.
Reside en: Ambos sistemas, co-propiedad. Dirección: El AE actualiza antes del cierre; el CSM es responsable después del cierre. Ambos tienen acceso de escritura. La sincronización es bidireccional en esta capa. Por qué importa: Los registros de contactos en el CRM y la plataforma de CS divergen con el tiempo. El AE conoce al champion del ciclo de ventas. El CSM conoce a seis stakeholders adicionales durante el onboarding que el CRM nunca ha registrado. Un año después, el AE entra a una llamada de renovación y el champion ha sido reemplazado por alguien con quien nunca ha hablado: porque el mapa de relaciones nunca se actualizó en el CRM. El cambio de champion es la causa más común de churn inesperado en cuentas de mid-market. La transición del champion del AE al CSM es el handoff estructurado que mantiene esta capa actualizada en el momento crítico, cerca del inicio del onboarding.
Capa 4: Salud y engagement. Datos de uso del producto, puntuaciones de NPS y CSAT, historial de tickets de soporte y el health score compuesto que CS calcula a partir de todo esto.
Reside en: Plataforma de CS. Son datos originados en CS: es el registro de cómo el cliente usa y experimenta el producto. Dirección: Solo lectura en el CRM para visibilidad del AE. El AE lo consulta antes de las conversaciones de renovación y expansión; solo CS lo actualiza. Por qué importa: Un AE que no ve el health score antes de una llamada de renovación vuela a ciegas. No sabe si está entrando a una conversación de renovación con un cliente champion o con uno en riesgo. No puede calibrar su enfoque, no puede traer a las personas adecuadas y no puede prepararse para las objeciones que el cliente probablemente planteará. Los datos de salud visibles en el CRM resuelven esto. Lo que provoca que estas capas fallen en la práctica se reduce a un conjunto específico de desajustes de esquema que conviene conocer por su nombre.
Desajustes de Esquema Comunes y su Costo
La mayoría de los fallos de integración entre CRM y plataforma de CS no son fallos de integración: son fallos de esquema. Los datos existen en ambos sistemas, pero no significan lo mismo, o residen en campos que no se mapean entre sí. La investigación de Gartner sobre plataformas de gestión de customer success identifica de forma consistente la integración bidireccional con el CRM como un criterio de evaluación principal, y la consistencia del esquema como la brecha más común que hace que las integraciones fallen en la práctica. Las decisiones sobre el stack de herramientas de alineación tomadas con anterioridad (qué CRM, qué plataforma de CS, qué capa de integración) determinan cuánto trabajo de esquema personalizado es siquiera necesario.
| Desajuste | Lo que cuesta |
|---|---|
| "Account Owner" (AE, en CRM) ≠ "CSM Owner" (plataforma de CS) sin concepto compartido de "account team" | La lógica de enrutamiento para notificaciones, asignaciones y escalaciones se rompe. Ningún equipo puede enviar una alerta a la persona correcta de forma automática. |
| "Deal stage" (CRM) no se mapea a "Onboarding stage" (plataforma de CS) | Sin visibilidad de dónde se encuentra un cliente en el recorrido post-cierre. RevOps puede ver cuándo se cerró un trato, pero no qué ocurrió con el cliente en los 90 días posteriores. |
| Campos personalizados añadidos por un equipo que no existen en el otro sistema | Los datos introducidos al cierre (por ejemplo, "complejidad de implementación: alta") nunca llegan al equipo que los necesita (CS) porque el sistema receptor no tiene ningún campo para almacenarlos. |
| Registros de contactos mantenidos por separado en CRM y plataforma de CS | El CSM gestiona la relación con un nuevo VP que se incorporó seis meses después del cierre; el CRM todavía muestra al champion original. El AE no sabe que el mapa de contactos ha cambiado. |
| "Account Tier" vs. "Customer Segment" vs. "Tier Rating": el mismo concepto, tres nombres de campo | Los informes no se unen. RevOps construye informes separados para cada sistema. El análisis de NRR se convierte en un proyecto de reconciliación manual cada trimestre. |
| El ARR de renovación se calcula de forma diferente en el CRM y en la plataforma de CS | Sales y CS llegan a la reunión de forecast de renovaciones con diferentes cifras de ARR. La conversación se convierte en un ejercicio de reconciliación en lugar de una discusión estratégica. |
Diseño del Esquema Compartido: Seis Campos que Deben ser Consistentes
No es necesario compartir todos los campos entre el CRM y la plataforma de CS. Hay que empezar con el esquema compartido mínimo viable: los campos que, si son inconsistentes, dificultan estructuralmente la coordinación entre el AE y el CSM.
| Campo | Responsable | Dirección | Por qué es fundamental |
|---|---|---|---|
| Account ID | RevOps | Ambos sistemas, mismo valor | La clave principal que hace posible la sincronización. Sin un Account ID compartido, cada integración requiere coincidencia difusa por nombre de empresa, que falla constantemente. |
| Fecha de inicio/fin del contrato | RevOps (se origina en CRM) | CRM → plataforma de CS (solo lectura) | Ambos equipos necesitan esto para la planificación de la renovación. Si las fechas divergen, coordinar la planificación de renovaciones se vuelve imposible. |
| Casos de uso comprometidos | AE (al cierre) | CRM → plataforma de CS (solo lectura, fijado al cierre) | El CSM necesita saber qué se le vendió al cliente desde el primer día. Texto libre o lista estructurada, definida al cierre, conservada como referencia estática. |
| ID del contacto champion | Co-propiedad (AE antes del cierre, CSM después del cierre) | Bidireccional | Vinculado al registro de contacto en ambos sistemas. Debe referenciar el mismo ID de contacto, de lo contrario no se pueden rastrear los cambios de champion entre sistemas. |
| Segmento / tier | RevOps | El CRM es la fuente de verdad; la plataforma de CS lo lee | Determina la asignación del CSM, la cadencia de QBR y el proceso de renovación. Debe ser consistente o ambos equipos operan con marcos de prioridad de cuentas diferentes. |
| ARR de renovación | RevOps (fuente de verdad en CRM) | CRM → plataforma de CS (solo lectura) | CS necesita esto para el forecasting de expansión y las conversaciones de renovación. El AE necesita saber qué está en juego. Ambos necesitan el mismo número. |
Estos seis campos son el mínimo. La mayoría de los equipos añadirán más con el tiempo a medida que identifiquen otras brechas. Pero empezar con estos seis, con propiedad definida y dirección de sincronización para cada uno, es suficiente para que el handoff funcione de manera fiable. La siguiente pregunta es cómo mantenerlos sincronizados sin reconstruir la integración cada vez que cambia cualquiera de las plataformas.
Mecanismos de Sincronización: Tres Enfoques Comunes y sus Ventajas e Inconvenientes
Una vez definido el esquema compartido, se necesita un mecanismo para mantenerlo sincronizado. Tres opciones están en uso habitual, cada una con ventajas e inconvenientes reales.
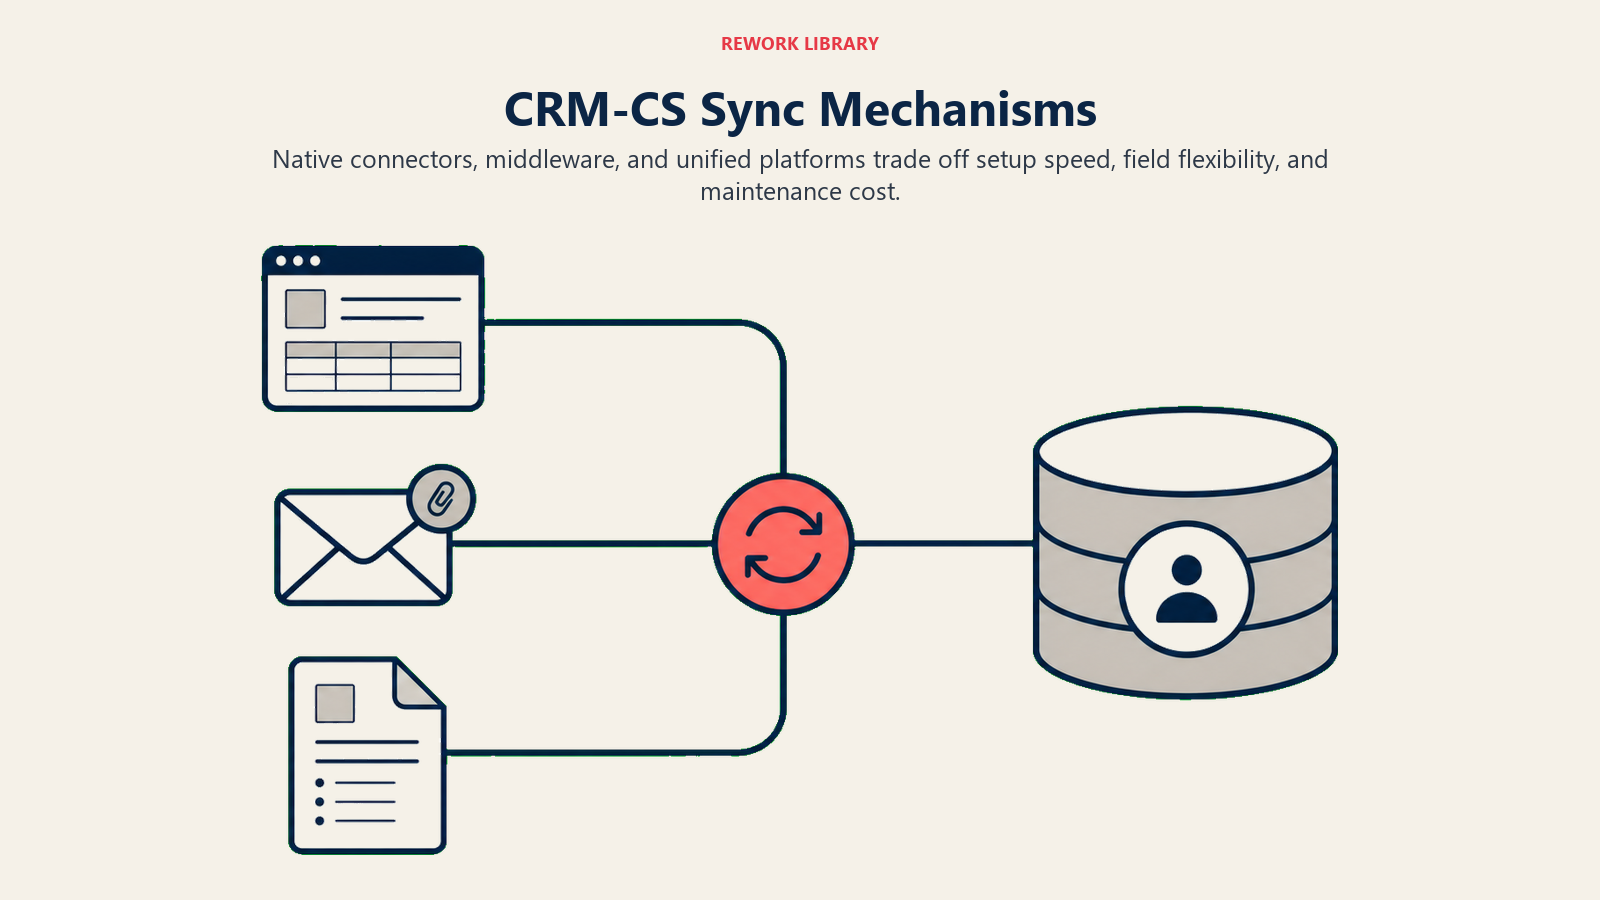
Opción 1: Integración nativa (el CRM y la plataforma de CS tienen un conector integrado)
La mayoría de los principales proveedores de CRM y plataforma de CS ofrecen integraciones nativas. HubSpot se conecta a Gainsight; Salesforce se conecta a Totango, Gainsight y ChurnZero; la mayoría tienen una configuración estándar de mapeo de campos.
Ventajas: Más fácil de configurar. Mantenida por el proveedor. Normalmente no requiere trabajo de ingeniería de RevOps para empezar a funcionar.
Inconvenientes: Limitada a los campos que el proveedor expone en la integración. Si tiene campos personalizados, y los casos de uso comprometidos y las señales de estabilidad del champion casi siempre lo son, puede que no estén disponibles en el conector nativo. Los cambios de esquema en cualquiera de los sistemas pueden romper la integración de forma silenciosa: se renombra un campo, la sincronización deja de funcionar y nadie lo nota durante semanas hasta que un CSM pregunta por qué no ve los health scores.
Mejor para: Equipos que ejecutan configuraciones estándar con las principales combinaciones de plataformas (Salesforce + Gainsight, HubSpot + ChurnZero) y requisitos de campos personalizados limitados.
Opción 2: iPaaS/middleware (Zapier, Make, Workato o similar)
Una plataforma de integración intermedia entre el CRM y la plataforma de CS, con mapeo de campos personalizado configurado por RevOps.
Ventajas: Suficientemente flexible para sincronizar campos personalizados. Puede gestionar lógica compleja (por ejemplo, "cuando el AE marca el trato como Cerrado Ganado, crear registro de cuenta de CS con estos valores de campo"). Puede modificarse a medida que el esquema evoluciona.
Inconvenientes: Requiere que RevOps construya y mantenga la integración. Se necesita experiencia de configuración al principio. Problemas de latencia con datos en tiempo real: las actualizaciones del health score en la plataforma de CS pueden tardar minutos u horas en aparecer en el CRM, lo que importa para las alertas de cuentas en riesgo. Costo operativo de la propia plataforma iPaaS.
Mejor para: Equipos con requisitos de campos personalizados complejos, múltiples integraciones que gestionar, o plataformas sin conector nativo. Requiere capacidad técnica de RevOps para la configuración.
Opción 3: Plataforma unificada (CRM y CS en el mismo sistema)
Cuando las funcionalidades de CRM y CS residen en la misma plataforma, no existe mecanismo de sincronización: el esquema es compartido por diseño. Los datos de tratos y los datos de customer success son vistas diferentes del mismo registro. La consistencia de los campos está garantizada, no mantenida.
Ventajas: Sin latencia de sincronización, sin deriva del esquema, sin mantenimiento de integración. El ideal arquitectónico para el registro de cliente compartido. El AE y el CSM trabajan literalmente en el mismo registro de cuenta con vistas diferentes.
Inconvenientes: Requiere que ambos equipos adopten la misma plataforma, lo que es un proyecto significativo de gestión del cambio y migración para organizaciones que ya han invertido en herramientas separadas de CRM y CS.
Mejor para: Equipos que construyen su stack desde cero, equipos que realizan una consolidación significativa de plataformas, o equipos donde el costo operativo de mantener una integración de dos plataformas se ha convertido en un punto de dolor recurrente.
Para la mayoría de los equipos hoy en día, la Opción 2 es la respuesta correcta: suficiente flexibilidad para gestionar campos personalizados, costo de mantenimiento manejable con un equipo pequeño de RevOps. La Opción 3 es la dirección arquitectónica a seguir, pero la inversión en migración significa que la mayoría de los equipos de mid-market trabajarán con dos plataformas en el futuro previsible.
Qué Se Rompe Cuando Se Omite la Arquitectura
Las consecuencias de un esquema compartido roto son predecibles y costosas. Se manifiestan de cuatro maneras:
El CSM onboardea a un cliente sin conocer el contexto del trato. El CSM le pregunta al cliente en la llamada de kickoff qué espera obtener del producto. El cliente dice "nos dijeron que podríamos hacer X." El CSM nunca ha escuchado que X fuera un caso de uso comprometido. La confianza se erosiona en la primera reunión. La relación comienza desde un déficit en lugar de desde una base de confianza.
El AE no puede ver el health score antes de la renovación. La conversación de expansión que debería ser un paso natural se abre con el AE descubriendo que la cuenta ha estado marcada como en riesgo durante 60 días: información que estaba en la plataforma de CS todo el tiempo, invisible para el CRM. El AE se entera por el CSM en un briefing de último minuto o entra sin preparación. Ninguno de los dos es un buen proceso de expansión.
RevOps construye dos informes separados porque los datos no se unen. El análisis de NRR requiere combinar el ARR del trato (del CRM) con el resultado de la renovación (de la plataforma de CS) y el historial del health score (de la plataforma de CS). Si el Account ID no está compartido, cada analista que intenta construir este informe hace una coincidencia difusa por nombre de empresa, resuelve conflictos manualmente y produce resultados que ambos equipos cuestionan. El análisis trimestral de NRR se convierte en un proyecto manual en lugar de un informe que se ejecuta en treinta segundos.
El cliente recibe información contradictoria del AE y del CSM. El AE cita un precio basado en su registro de CRM. El CSM cita un precio de renovación basado en el registro de la plataforma de CS. Los dos números difieren porque el ARR se actualizó en un sistema y no se sincronizó con el otro. El cliente, razonablemente, pierde confianza en la capacidad del proveedor de coordinarse internamente.
Frases Citables
Análisis de Rework: La mayoría de los equipos de RevOps abordan la integración entre CRM y CS como un proyecto de TI: seleccionar un conector, mapear los campos, declarar el éxito. La Arquitectura de Registro de Cliente Compartido de 4 Capas lo replantea como un problema de propiedad de datos. La integración en sí es menos importante que contar con responsables y direcciones de sincronización definidos para cada campo fundamental. El mismo conector iPaaS con una propiedad ambigua de los campos derivará en un conflicto de esquema en dos trimestres. El mismo conector con propiedad documentada por capa y una cadencia de revisión trimestral se mantiene fiable de forma indefinida.
Secuencia de Implementación para RevOps
Esta es una secuencia práctica para construir el esquema compartido sin hacerlo todo de una vez:
Paso 1: Auditoría de la superposición de campos actual. Extraiga la lista de campos del CRM y de la plataforma de CS. Identifique qué campos existen en ambos sistemas. Para los campos que existen en ambos, verifique si los valores coinciden para una muestra de 20-30 cuentas. Esta auditoría suele llevar a un analista de RevOps entre dos y tres días y revela más inconsistencias de las que la mayoría de los equipos esperan.
Paso 2: Definir los seis campos compartidos como esquema mínimo viable. Acordar el nombre del campo, la propiedad y la dirección de sincronización para cada uno de los seis campos indicados anteriormente. Documéntelo en un diccionario de campos compartido al que ambos equipos puedan hacer referencia: una hoja de cálculo sencilla es suficiente.
Paso 3: Elegir el mecanismo de sincronización. En función de la combinación de plataformas y los requisitos de campos personalizados, elija entre integración nativa, iPaaS o (si está evaluando una consolidación de plataformas) plataforma unificada. La decisión debe tomarse con RevOps, CS ops y Sales ops en la sala: no como una decisión de herramienta tomada únicamente por TI. La investigación de McKinsey sobre NRR encontró que las empresas SaaS del cuartil superior hacen esta inversión desde el principio, porque tanto la visibilidad de la expansión como la predicción del churn dependen de que los datos de salud sean accesibles en el mismo entorno donde se toman las decisiones de renovación.
Paso 4: Asignar la propiedad de los campos. Para cada campo compartido, defina quién tiene acceso de escritura y quién tiene acceso de solo lectura. La propiedad ambigua genera deriva de datos. Cuando dos personas pueden actualizar el mismo campo de forma independiente, los dos sistemas acaban en desacuerdo.
Paso 5: Agregar un proceso de cambio de esquema. ¿Qué ocurre cuando cualquiera de los equipos quiere añadir un nuevo campo al esquema compartido? Sin un proceso definido, los campos se añaden a un sistema sin la adición correspondiente en el otro, y el esquema diverge silenciosamente. Un proceso ligero: RevOps revisa la solicitud, añade el campo a ambos sistemas y actualiza el diccionario de campos: es suficiente para evitar esto. La plantilla de scorecard de handoff es un artefacto concreto que depende de que este esquema sea estable. Se rompe cuando los nombres de los campos cambian sin una actualización coordinada.
Anti-Patrones
Construir el esquema compartido dos años después de que la herramienta esté en uso. La migración de datos es significativamente más difícil que el diseño del esquema desde el principio. Dos años de notas de contexto de tratos no estructuradas, designaciones de tier inconsistentes y registros de contactos divergidos no se limpian rápidamente. Diseñe el esquema compartido antes de lanzar la plataforma de CS, no después de haber vivido las consecuencias de no haberlo hecho.
Dejar que cada equipo defina sus propios nombres de campo para el mismo concepto. "Account Tier" en CRM, "Customer Segment" en la plataforma de CS, "Tier Rating" en el dashboard de salud. Mismo concepto, tres nombres, cero posibilidad de unirlos en un informe. Elija un nombre y aplíquelo en ambos sistemas desde el primer día.
Tratar la sincronización como un proyecto puntual. Los esquemas se derivan. El CRM recibe un nuevo campo obligatorio en el segundo trimestre que nadie añade a la plataforma de CS. La plataforma de CS actualiza su cálculo del health score y cambia el nombre del campo. La integración nativa elimina un campo de forma silenciosa porque una actualización del proveedor cambió la API. El mantenimiento del esquema necesita un responsable, normalmente RevOps, y una cadencia de revisión trimestral. No es un proyecto con fecha de finalización.
Preguntas Frecuentes sobre la Arquitectura del Registro de Cliente Compartido
¿Qué es la Arquitectura de Registro de Cliente Compartido de 4 Capas?
Es un marco de diseño de datos que define cómo se estructura, se asigna y se sincroniza la información de la cuenta en el punto de contacto entre AE y CS. La Capa 1 (Account Master) contiene el perfil de la empresa, el segmento, el valor del contrato y la fecha de renovación: se origina en el CRM y es de solo lectura en la plataforma de CS. La Capa 2 (Deal Context) incluye los casos de uso comprometidos, las promesas hechas durante el ciclo de ventas y el score de ajuste al ICP: fluye del CRM a CS al cierre, una sola vez y de forma estática. La Capa 3 (Relationship Map) abarca los contactos, la identidad del champion y el historial de engagement: es de co-propiedad y se sincroniza bidireccionalmente. La Capa 4 (Health and Engagement) contiene el uso del producto, el NPS, el historial de soporte y el health score: se origina en CS y es de solo lectura en el CRM para la visibilidad del AE.
¿Es el CRM siempre el sistema maestro de registro, o puede la plataforma de CS cumplir ese rol?
Para la mayoría de los tipos de datos, el CRM es el maestro. Los datos comerciales (términos del contrato, ARR, fecha de renovación, tier de la cuenta) se originan en el CRM y fluyen a la plataforma de CS como referencia de solo lectura. Los datos de salud y engagement se originan en la plataforma de CS y fluyen al CRM como referencia de solo lectura para uso del AE. Ningún sistema es el maestro universal; cada capa tiene su propio sistema de origen según qué equipo genera esos datos y responde por ellos. La Arquitectura de 4 Capas hace esto explícito en lugar de asumir por defecto un único maestro en el que ninguno de los dos equipos confía plenamente.
¿Qué seis campos deben ser consistentes como mínimo entre el CRM y la plataforma de CS?
Account ID (la clave principal que hace posible la sincronización sin coincidencia difusa), fecha de inicio y fin del contrato (ambos equipos la necesitan para la planificación de la renovación), casos de uso comprometidos (el CSM necesita saber qué se vendió desde el primer día), ID del contacto champion (vinculado al registro de contacto en ambos sistemas y mantenido bidireccionalmente), segmento/tier (determina la asignación del CSM, la cadencia de QBR y el proceso de renovación) y ARR de renovación (ambos equipos necesitan el mismo número para el forecasting). Estos seis son el esquema compartido mínimo viable. Empezar aquí, con propiedad definida y dirección de sincronización para cada uno, es suficiente para que los handoffs sean fiables.
¿Cuál es la diferencia entre la arquitectura del registro de cliente compartido y el CRM como única fuente de verdad?
El concepto de única fuente de verdad establece que existe un registro autorizado para cada tipo de dato. La Arquitectura de Registro de Cliente Compartido de 4 Capas es la implementación de ese concepto en el punto de contacto entre AE y CS: define qué campos se extienden del CRM a la plataforma de CS, en qué dirección fluyen los datos de cada uno, quién tiene acceso de escritura y qué mecanismo de sincronización los mantiene alineados. Se puede adoptar plenamente el principio de fuente única de verdad y aun así tener una implementación rota porque nadie diseñó el esquema compartido. La arquitectura responde la pregunta de implementación que el principio deja abierta.
¿Cuáles son las tres opciones de mecanismo de sincronización para mantener alineados el CRM y la plataforma de CS?
La integración nativa (conector integrado del proveedor) es la más fácil de configurar, pero está limitada a los campos expuestos y es vulnerable a roturas silenciosas cuando cualquiera de los sistemas se actualiza. El middleware iPaaS (Zapier, Make, Workato) es el más flexible para campos personalizados y lógica compleja, pero requiere que RevOps lo construya y lo mantenga, e introduce latencia de sincronización. La plataforma unificada (CRM y CS en el mismo sistema) es el ideal arquitectónico: no hay sincronización alguna, porque ambos equipos trabajan en el mismo registro. Pero requiere una migración significativa de plataforma. Para la mayoría de los equipos de mid-market, iPaaS es la respuesta correcta: suficiente flexibilidad para campos personalizados y un costo de mantenimiento manejable con un equipo pequeño de RevOps.
¿Cómo se evita la deriva del esquema entre el CRM y la plataforma de CS con el tiempo?
Defina un proceso de cambio de esquema y asigne a RevOps como responsable de ese proceso. El proceso no tiene por qué ser complejo: cualquier solicitud para añadir un nuevo campo al esquema compartido va a RevOps para su revisión, RevOps añade el campo a ambos sistemas de forma simultánea y se actualiza el diccionario de campos compartido. Sin este proceso, los campos se añaden a un sistema sin la adición correspondiente en el otro, y el esquema diverge silenciosamente, a menudo en el plazo de un trimestre tras el lanzamiento. Las auditorías trimestrales del esquema, en las que RevOps extrae la lista de campos de ambos sistemas y revisa una muestra de 20-30 cuentas para comprobar la consistencia de los valores, detectan la deriva antes de que se convierta en un problema de integridad de datos.
Más Información
Principal Solution Architect
On this page
- Por Qué Esto es Diferente a "El CRM como Única Fuente de Verdad"
- Las Cuatro Capas del Registro en el Punto de Contacto
- Desajustes de Esquema Comunes y su Costo
- Diseño del Esquema Compartido: Seis Campos que Deben ser Consistentes
- Mecanismos de Sincronización: Tres Enfoques Comunes y sus Ventajas e Inconvenientes
- Qué Se Rompe Cuando Se Omite la Arquitectura
- Frases Citables
- Secuencia de Implementación para RevOps
- Anti-Patrones
- Más Información