共有顧客レコードアーキテクチャ:CRMスキーマをCSプラットフォームに拡張する方法
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
2つのチーム、2つのプラットフォーム、1人の顧客。
AEはCRMで取引をクローズしました。CSMはCSプラットフォームでアカウントを管理しています。これら2つのレコードはほぼ同じスキーマを持っていません。そのためCSMが営業サイクルでコミットされた使用ケースを知りたいとき、CSMはメールで送られてきたPDFを読んでいます。AEが更新前の会話の前にヘルススコアを知りたいとき、Slackで尋ねています。RevOpsが取引データとヘルスデータを結合したNRR分析を構築したいとき、スプレッドシートで1週間を費やしています。
これはプロセスの問題ではありません。アーキテクチャの問題です。そして週次同期ミーティング、ハンドオフチェックリスト、共有のNotionドキュメントといったプロセス上の修正は、壊れたスキーマには対処できません。Forresterのカスタマーサクセスプラットフォームに関する調査によると、最も成功しているCS組織は、統合を通じてテックスタック全体の顧客データを一元化しており、ヘルススコアの可視性は、基盤となるデータアーキテクチャが健全であるかどうかに完全に左右されます。データはシステム間を流れるか、流れないかのどちらかです。この問題のマーケティングと営業の側面(単一のCRMがGo-to-Market全体で真実の源泉として機能する場合)はシングルソースオブトゥルースとしてのCRMで扱っています。この記事は、その記事が終わるところ、つまりAEからCSへの境界に特化して話を引き継ぎます。
この記事は、AEからCSへの境界における具体的なデータ設計の問題を扱っています――どのフィールドがCRMからCSプラットフォームに拡張されるか、各フィールドのデータの流れる方向、各フィールドを誰が所有するか、そして同期を維持するメカニズムは何か。単一の真実の源泉を持つ原則についてではありません――それはシングルソースオブトゥルース:顧客レコードの記事でカバーしています。これは実装レイヤーです。
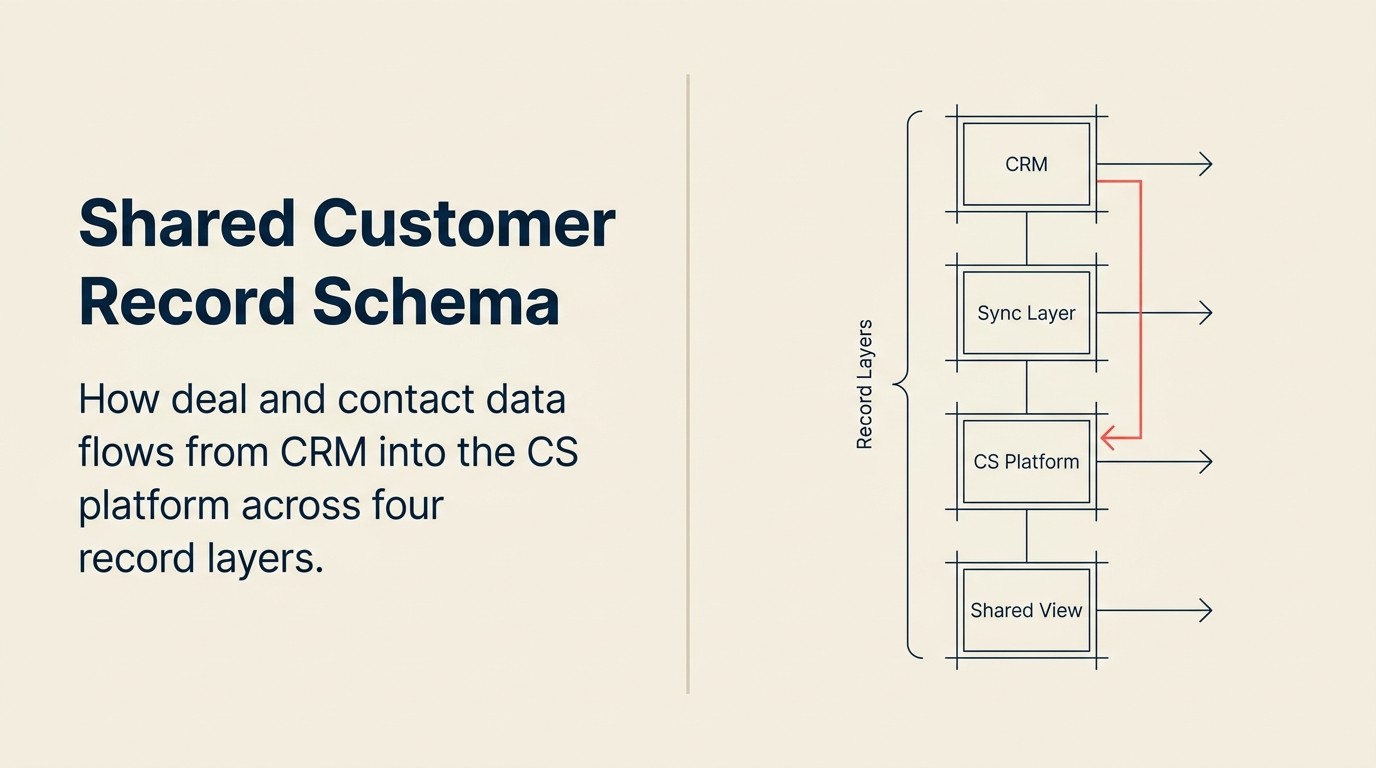
4レイヤー共有顧客レコードアーキテクチャは、AEからCSへの境界でアカウントデータをどのように構造化し、所有し、同期するかを定義するものです。レイヤー1(アカウントマスター)はCRM発で、CSでは読み取り専用です。レイヤー2(取引コンテキスト)はクローズ時にCRMからCSへ一度だけ静的に流れます。レイヤー3(リレーションシップマップ)は共同所有で、双方向に同期されます。レイヤー4(ヘルスとエンゲージメント)はCS発で、AEの視認性のためにCRMでは読み取り専用です。各レイヤーには定義された方向とオーナーがあります。4つのうちどれかが欠けていたり、オーナーが誤っていたりすると、AEとCSMの連携は予想どおりに崩れます。
重要データ:スキーマの不一致と収益コスト
- Gainsightの年次CS業界ベンチマークレポートによると、**CSMの65%**が顧客ハンドオフ時に営業サイクルからの取引コンテキストへの信頼できるアクセスがないと回答しています。根本原因はほぼ常にスキーマの不一致であり、プロセスの失敗ではありません。
- ForresterのRevenue Operations調査によると、CRMとCSプラットフォームのデータが適切に統合されている企業はAEが更新前の会話の前にヘルススコアを把握できるため、拡張収益が25%多くクローズします。
- OpenView PartnersのSaaSベンチマークレポートによると、CRMとCSプラットフォームの間で定義された共有フィールドスキーマを持つ組織は、持たない組織よりNRRが9~14パーセントポイント高い――差異は初期の拡張シグナルの視認性の向上と優れたChurn予測に起因するとされています。
「CRMをシングルソースオブトゥルースとして」との違い
シングルソースオブトゥルースの概念は、各データタイプについて1つの権威あるレコードが存在することを確立します――連絡先はCRMに、ヘルススコアはCSプラットフォームに、そして両方のチームが見られる同期があります。これが原則です。
この記事は実装についてです:AEからCSへの境界でその原則が機能するために、フィールドレベルで実際に何が真である必要があるか。
2つの問いは異なります。SoTの原則は「誰が何を所有するか?」に答えます。アーキテクチャの問いは「どのように実現されるか、同期が機能するためにスキーマはどのような形である必要があるか?」に答えます。SoTの原則を完全に支持しながらも、誰も共有スキーマを設計しなかったために実装が壊れているという状況になり得ます。
スコープについてもう1点:この記事はAEからCSへの境界のみを扱います――取引をクローズしたチームと顧客関係を管理するチームの間のハンドオフと継続的な連携。オンボーディングプラットフォームの選択、CSツール戦略、オンボーディング後の製品採用のメカニズムはカバーしていません。これらは別の問題です。境界は十分に具体的です。
境界における4つのレコード層
共有顧客レコードを4つの層として考えてください。それぞれ異なるオーナーシップと異なるデータフローの方向があります。
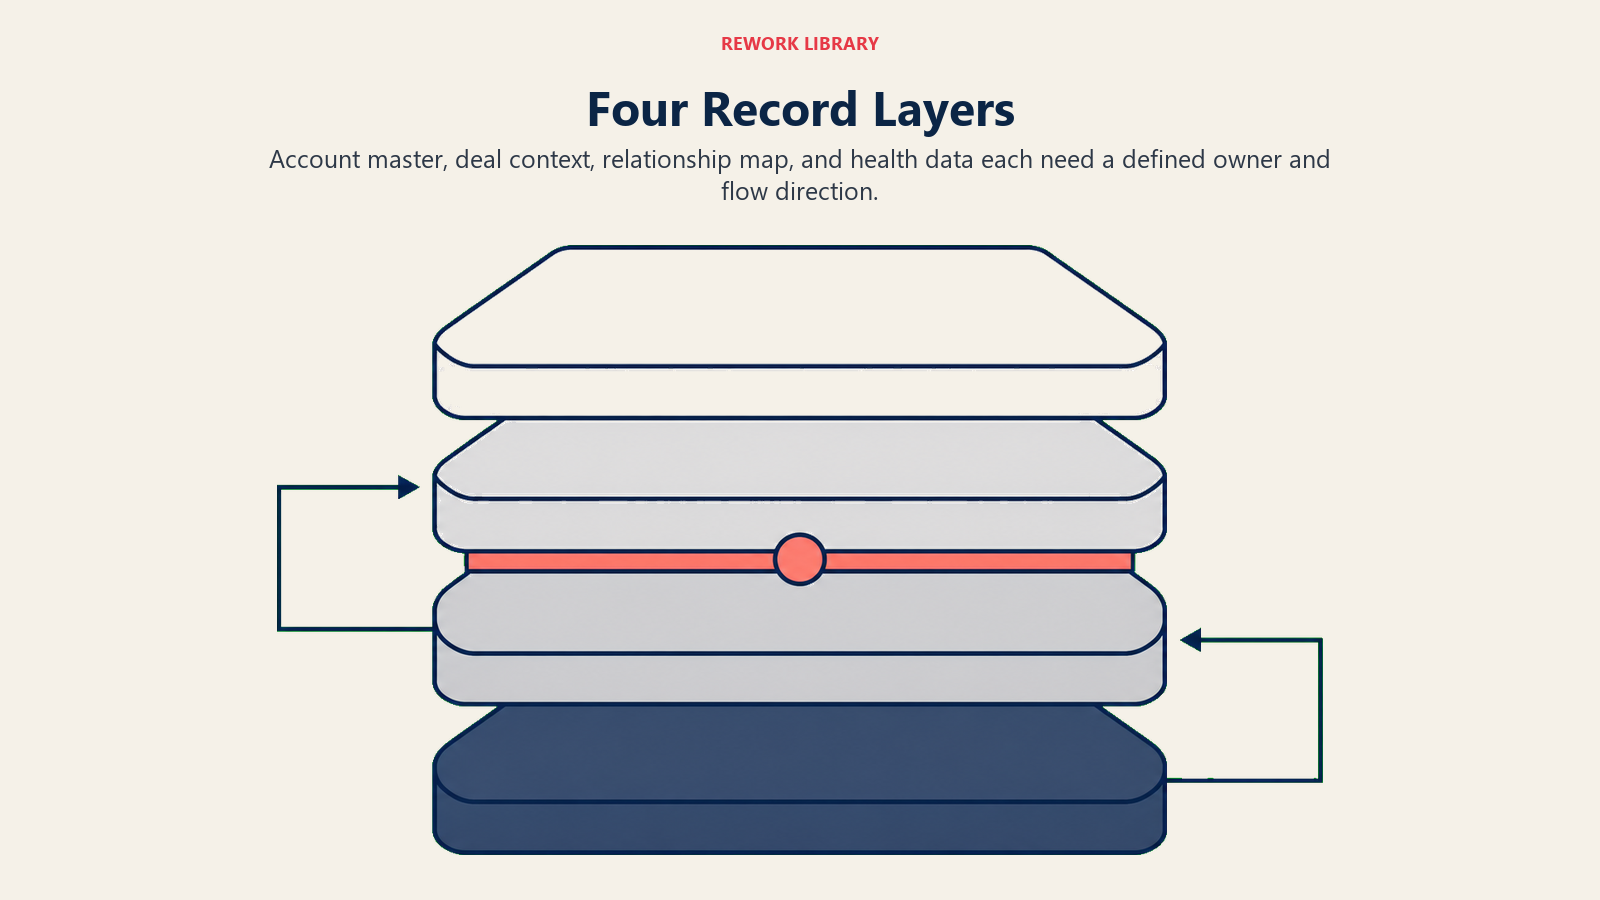
レイヤー1:アカウントマスター。 企業プロファイル、市場セグメント、AEオーナー、CSMオーナー、ティア区分、契約金額、更新日。このレイヤーは骨格です――両チームに顧客が誰で、商業的関係がどのようなものかを伝えます。
所在: CRM。これはCRM発のデータです;商業的関係のレコードです。 方向: CSプラットフォームでは読み取り専用。CSチームはそれを読みます;RevOpsとAEのみが更新します。 なぜ重要か: CRMのティア区分がCSプラットフォームのティアと一致しない場合、CSM割り当てロジックが壊れます。QBRリズムの決定はティアに基づいています。2つのシステムで契約金額が異なる場合、更新フォーキャストは2つの異なる数字を生み出します。
レイヤー2:取引コンテキスト。 クローズされた使用ケース、営業サイクル中に行われた約束、クローズ時のチャンピオンマップ、割引の深さ、ICPフィットスコア、AEが記録したレッドフラグ。これはCSが初日から成功したオンボーディングのために必要なインテリジェンスです。
所在: クローズ時はCRM、その後CSプラットフォームに静的レコードとして流れます。 方向: CRM→CSプラットフォーム、一方向、一回のみ。このデータは取引クローズ時に設定され、変更されません。ライブ同期ではありません――顧客が署名した時点でコミットされた内容のレコードです。 なぜ重要か: このレイヤーなしに、CSMは何が販売されたかを知らずにオンボーディングしています。顧客は営業サイクルからの期待を持って到着しますが、CSMにはその期待が何であるかの視認性がありません。最初の2週間で信頼が損なわれます。コンテキストが引き継がれていれば防げたエスカレーションが発生します。
レイヤー3:リレーションシップマップ。 アカウントの連絡先、役割と肩書き、エンゲージメント履歴、チャンピオンが誰か、エグゼクティブスポンサーが誰か、チャンピオンの安定性に関するフラグ。
所在: 両システム、共同所有。 方向: AEがクローズ前に更新;CSMがクローズ後を所有。両者が書き込みアクセス権を持ちます。同期はこのレイヤーでは双方向です。 なぜ重要か: CRMとCSプラットフォームの連絡先レコードは時間とともに乖離します。AEは営業サイクルからチャンピオンを知っています。CSMはオンボーディング中にCRMが知らない6人の他のステークホルダーに会います。1年後、AEは更新コールに入ったとき、チャンピオンが自分が一度も話したことのない誰かに交代していることに気づきます――リレーションシップマップがCRMで更新されていなかったからです。チャンピオン変更は、ミッドマーケットアカウントにおける予期せぬChurnの最も一般的な原因です。AEからCSMへのチャンピオン引き継ぎは、オンボーディング開始直前という重要なタイミングで、このレイヤーを最新に保つための構造化されたハンドオフです。
レイヤー4:ヘルスとエンゲージメント。 製品使用データ、NPSとCSATスコア、サポートチケット履歴、CSがこれらすべてから計算する複合ヘルススコア。
所在: CSプラットフォーム。これはCS発のデータです;顧客が実際にどのように製品を使用・体験しているかのレコードです。 方向: AEの視認性のためにCRMでは読み取り専用。AEは更新と拡張の会話の前にそれを読みます;CSのみが更新します。 なぜ重要か: 更新コールの前にヘルススコアを見られないAEは、手がかりなしに飛び込んでいます。チャンピオンの顧客との更新会話に入ろうとしているのか、リスクのある顧客との更新会話なのかを知りません。アプローチを調整できず、適切な人を連れてくることもできず、顧客が提起しそうな反論に備えることもできません。CRMで見られるヘルスデータがこれを解決します。これらのレイヤーが実際に崩れる原因は、名前を知っておく価値のある特定のスキーマの不一致に集約されます。
一般的なスキーマの不一致とそのコスト
ほとんどのCRMからCSプラットフォームへの統合の失敗は、統合の失敗ではありません――スキーマの失敗です。データは両システムに存在しますが、同じ意味を持たないか、互いにマッピングされないフィールドに存在します。Gartnerのカスタマーサクセス管理プラットフォーム調査は、双方向のCRM統合を主要な評価基準として一貫して挙げており、実務で統合が壊れる最も一般的なギャップとしてスキーマの一貫性を指摘しています。上流で行うアライメントのツールスタックの決定(どのCRM、どのCSプラットフォーム、どの統合レイヤーか)が、そもそもどれだけカスタムスキーマの作業が必要になるかを左右します。
| 不一致 | コスト |
|---|---|
| 「Account Owner」(CRMのAE)≠「CSM Owner」(CSプラットフォーム)、共有「アカウントチーム」概念なし | 通知、割り当て、エスカレーションのルーティングロジックが壊れます。どちらのチームも自動的に適切な人にアラートを送れません。 |
| 「Deal stage」(CRM)が「Onboarding stage」(CSプラットフォーム)にマッピングされない | クロージング後の顧客の状況の視認性がありません。RevOpsは取引がいつクローズしたかは見えますが、その後90日間に顧客に何が起きたかはわかりません。 |
| 一方のチームが追加したカスタムフィールドが他のシステムに存在しない | クローズ時に入力されたデータ(例:「実装複雑度:高」)は、受け取り側のシステムにそれを保持するフィールドがないため、それを必要とするチーム(CS)に届きません。 |
| CRMとCSプラットフォームで個別に管理される連絡先レコード | CSMはクローズ後6か月で入社した新しいVPとの関係を管理していますが、CRMはまだ元のチャンピオンを表示しています。AEは連絡先の状況が変わったことを知りません。 |
| 「Account Tier」vs「Customer Segment」vs「Tier Rating」――同じ概念、3つのフィールド名 | レポートが結合しません。RevOpsは各システムに対して別々のレポートを作成します。NRR分析は四半期ごとに手作業での照合プロジェクトになります。 |
| CRMとCSプラットフォームで異なる方法で計算される更新ARR | 営業とCSは更新フォーキャストミーティングに異なるARRの数字を持ち込みます。会話は戦略的な議論ではなく照合作業になります。 |
共有スキーマの設計:一貫性が必要な6つのフィールド
CRMとCSプラットフォームの間ですべてのフィールドを共有する必要はありません。最小限の共有スキーマから始める必要があります――不一致があるとAEとCSMの連携が構造的に困難になるフィールドです。
| フィールド | オーナー | 方向 | 重要な理由 |
|---|---|---|---|
| Account ID | RevOps | 両システム、同じ値 | 同期を可能にする主キー。共有アカウントIDがなければ、すべての統合は会社名のあいまい一致を必要とします――これは常に壊れます。 |
| 契約開始/終了日 | RevOps(CRMに起源) | CRM→CSプラットフォーム(読み取り専用) | 両チームが更新タイミングのためにこれを必要とします。日付が乖離すると、更新計画の調整が不可能になります。 |
| コミットされた使用ケース | AE(クローズ時) | CRM→CSプラットフォーム(読み取り専用、クローズ時設定) | CSMは初日から顧客に何が販売されたかを知る必要があります。自由テキストまたは構造化リスト、クローズ時に定義され、静的参照として引き継がれます。 |
| チャンピオン連絡先ID | 共同所有(クローズ前はAE、クローズ後はCSM) | 双方向 | 両システムの連絡先レコードにリンクされています。システム間でチャンピオンの変化を追跡できるよう、同じ連絡先IDを参照する必要があります。 |
| セグメント/ティア | RevOps | CRMが真実の源泉;CSプラットフォームはそれを読む | CSM割り当て、QBRリズム、更新プロセスを決定します。一致しなければ、両チームは異なるアカウント優先フレームワークで運営されています。 |
| 更新ARR | RevOps(CRMに真実の源泉) | CRM→CSプラットフォーム(読み取り専用) | CSは拡張フォーキャストと更新会話のためにこれを必要とします。AEは何が危機に瀕しているかを知るためにこれを必要とします。両者が同じ数字を必要とします。 |
これらの6フィールドが最小限です。ほとんどのチームは時間の経過とともに他のギャップを特定し、追加します。しかしこれらの6フィールドから始め、各フィールドに定義されたオーナーシップと同期の方向があれば、ハンドオフを確実に機能させるには十分です。次の問いは、どちらかのプラットフォームが変わるたびに統合を作り直すことなく、これらをどう同期し続けるかです。
同期メカニズム――3つの一般的なアプローチとそのトレードオフ
共有スキーマを定義したら、同期を維持するメカニズムが必要です。3つのオプションが一般的に使用されており、それぞれに実際のトレードオフがあります。
オプション1:ネイティブ統合(CRMとCSプラットフォームに組み込みコネクタがある)
主要なCRMとCSプラットフォームベンダーのほとんどがネイティブ統合を提供しています。HubSpotはGainsightと接続します;SalesforceはTotango、Gainsight、ChurnZeroと接続します;ほとんどが標準的なフィールドマッピング設定を持っています。
メリット: 設定が最も簡単。ベンダーによって維持されます。RevOpsのエンジニアリング作業が通常不要です。
デメリット: ベンダーが統合で公開しているフィールドに限定されます。カスタムフィールドがある場合――コミットされた使用ケースとチャンピオン安定性フラグはほぼ常にカスタムです――ネイティブコネクタで利用できないかもしれません。どちらかのシステムのスキーマ変更が同期を静かに壊す可能性があります:フィールドが名前変更され、同期が止まり、CSMがヘルススコアが見えないと尋ねるまで数週間誰も気づきません。
最適な場合: 主要プラットフォームの組み合わせ(Salesforce + Gainsight、HubSpot + ChurnZero)で標準設定を使用し、カスタムフィールドの要件が限られているチーム。
オプション2:iPaaS/ミドルウェア(Zapier、Make、Workato、または同様のもの)
RevOpsによって設定されたカスタムフィールドマッピングを持つ統合プラットフォームがCRMとCSプラットフォームの間に置かれます。
メリット: カスタムフィールドを同期するのに十分な柔軟性。複雑なロジックを処理できます(例:「AEが取引をClosed Wonとマークしたとき、これらのフィールド値でCSアカウントレコードを作成する」)。スキーマが進化するにつれて変更できます。
デメリット: RevOpsが統合を構築・維持する必要があります。初期設定の専門知識が必要です。リアルタイムデータのレイテンシの問題――CSプラットフォームのヘルススコアの更新がCRMに表示されるまで数分または数時間かかる場合があり、リスクのあるアカウントのアラートには重要です。iPaaSプラットフォーム自体の実行コスト。
最適な場合: 複雑なカスタムフィールド要件、管理する複数の統合、またはネイティブコネクタのないプラットフォームを持つチーム。設定のためのRevOpsの技術的能力が必要です。
オプション3:統合プラットフォーム(CRMとCSが同じシステムに)
CRMとCS機能が同じプラットフォームに存在する場合、同期メカニズムはありません――スキーマは設計によって共有されています。取引データとカスタマーサクセスデータは同じレコードの異なるビューです。フィールドの一貫性は維持されるのではなく、強制されます。
メリット: 同期のレイテンシなし、スキーマのドリフトなし、統合のメンテナンスなし。共有顧客レコードのアーキテクチャ上の理想。AEとCSMは文字通り、異なるビューを持つ同じアカウントレコードで作業しています。
デメリット: 両チームが同じプラットフォームを採用する必要があり、これは別々のCRMとCSツールにすでに投資している組織にとって重大な変更管理と移行プロジェクトです。
最適な場合: ゼロからスタックを構築しているチーム、大幅なプラットフォーム統合を行っているチーム、または2つのプラットフォームの統合を維持する運用コストが継続的な痛点になっているチーム。
今日のほとんどのチームにとって、オプション2が正解です――カスタムフィールドを処理するのに十分な柔軟性があり、小規模なRevOpsチームで管理可能なメンテナンスコスト。オプション3はアーキテクチャ上の進むべき方向ですが、移行投資により、ほとんどのミッドマーケットチームは当面2つのプラットフォームで作業することになります。
アーキテクチャをスキップするとどうなるか
壊れた共有スキーマの結果は予測可能で、コストが高いです。4つの形で現れます:
CSMが取引コンテキストを知らずに顧客をオンボーディングします。 CSMはキックオフコールで顧客に製品から何を期待しているかを尋ねます。顧客は「Xができると言われました」と言います。CSMはXをコミットされた使用ケースとして聞いたことがありません。最初のミーティングで信頼が損なわれます。信頼の基準点ではなく、欠損から関係が始まります。
AEは更新前にヘルススコアを見られません。 自然なステップであるべき拡張の会話は、AEがアカウントが60日間リスクフラグが立てられていたことを発見することで始まります――その情報はCSプラットフォームに常にあり、CRMには見えませんでした。AEはCSMからの土壇場のブリーフィングで知るか、盲目的に入るかのどちらかです。どちらも良い拡張モーションではありません。
RevOpsはデータが結合しないため2つの別々のレポートを作成します。 NRR分析は取引ARR(CRMから)と更新結果(CSプラットフォームから)とヘルススコア履歴(CSプラットフォームから)を結合する必要があります。アカウントIDが共有されていなければ、このレポートを作成しようとするすべてのアナリストは会社名のあいまい一致を行い、手動で矛盾を解決し、両チームが疑問を持つ結果を生み出します。四半期ごとのNRR分析は30秒で実行されるレポートではなく、手動プロジェクトになります。
顧客はAEとCSMから矛盾した情報を受け取ります。 AEはCRMレコードに基づいて価格を提示します。CSMはCSプラットフォームレコードに基づいて更新価格を提示します。ARRが一方のシステムで更新され、もう一方に同期されなかったため、2つの数字が異なります。顧客は、合理的に、ベンダーが内部で調整する能力に対する信頼を失います。
引用しやすいポイント
Rework分析: 多くのRevOpsチームは、CRMとCSの統合をIT上のプロジェクトとして捉えます。コネクタを選び、フィールドをマッピングし、成功を宣言するというやり方です。4レイヤー共有顧客レコードアーキテクチャは、これをデータオーナーシップの問題として捉え直します。統合そのものよりも、重要なフィールドごとにオーナーと同期の方向が定義されていることのほうが重要です。フィールドのオーナーシップが曖昧なままの同じiPaaSコネクタは、2四半期以内にスキーマの衝突へと流れていきます。レイヤーごとのオーナーシップが文書化され、四半期ごとのレビューリズムがある同じコネクタなら、いつまでも安定して機能します。
RevOpsの実装シーケンス
一度にすべてを行わずに共有スキーマを構築するための実践的なシーケンスを紹介します:
ステップ1:現在のフィールドの重複を監査します。 両CRMとCSプラットフォームからフィールドリストを取り出します。両システムに存在するフィールドを特定します。両方に存在するフィールドについて、20~30のアカウントのサンプルで値が一致するかどうか確認します。この監査は通常RevOpsアナリスト1人が2~3日かかり、ほとんどのチームが予想するよりも多くの不一致を明らかにします。
ステップ2:6つの共有フィールドを最小限の共有スキーマとして定義します。 上記の6つのフィールドそれぞれについて、フィールド名、オーナーシップ、同期の方向に合意します。両チームが参照できる共有フィールド辞書にこれを文書化します――シンプルなスプレッドシートで十分です。
ステップ3:同期メカニズムを選択します。 プラットフォームの組み合わせとカスタムフィールドの要件に基づいて、ネイティブ統合、iPaaS、または(プラットフォーム統合を評価している場合は)統合プラットフォームを選択します。この選択はRevOps、CS Ops、Sales Opsを交えて行うべきです――IT単独が行うツール決定としてではなく。McKinseyのNRR調査によると、上位四分位のSaaS企業はこの投資を早期に行っています。拡張の可視性もChurnの予測も、更新の意思決定が行われるのと同じ環境でヘルスデータにアクセスできるかどうかに依存するためです。
ステップ4:フィールドオーナーシップを割り当てます。 すべての共有フィールドについて、誰が書き込みアクセス権を持ち、誰が読み取り専用アクセス権を持つかを定義します。曖昧なオーナーシップはデータのドリフトを生み出します。2人が独立して同じフィールドを更新できる場合、2つのシステムは最終的に不一致になります。
ステップ5:スキーマ変更プロセスを追加します。 どちらかのチームが共有スキーマに新しいフィールドを追加したいとき、何が起きるか?定義されたプロセスなしに、フィールドが一方のシステムに追加され、もう一方に対応する追加がなされず、スキーマは静かに乖離します。軽量なプロセス――RevOpsがリクエストをレビューし、両システムにフィールドを追加し、フィールド辞書を更新する――がこれを防ぐのに十分です。ハンドオフスコアカードテンプレートは、このスキーマが安定していることに依存する具体的な成果物の一つです。フィールド名が調整なしに変更されると、機能しなくなります。
アンチパターン
ツールが2年間稼働した後に共有スキーマを構築します。 データ移行は最初のスキーマ設計よりも大幅に難しいです。2年分の非構造化された取引コンテキストのメモ、一貫性のないティア指定、乖離した連絡先レコードは素早くは整理できません。CSプラットフォームを立ち上げた後にその結果を経験してからではなく、立ち上げる前に共有スキーマを設計してください。
各チームが同じ概念に独自のフィールド名を定義することを許可します。 CRMの「Account Tier」、CSプラットフォームの「Customer Segment」、ヘルスダッシュボードの「Tier Rating」。同じ概念、3つの名前、レポートで結合する能力ゼロ。1つの名前を選び、初日から両システムで強制してください。
同期を一度限りのプロジェクトとして扱います。 スキーマはドリフトします。CRMはQ2に新しい必須フィールドを取得しますが、誰もCSプラットフォームに追加しません。CSプラットフォームがヘルススコアの計算を更新し、フィールド名を変更します。ベンダーの更新がAPIを変更したため、ネイティブ統合がフィールドを静かに削除します。スキーマのメンテナンスにはオーナーが必要です――通常RevOps――そして四半期ごとのレビューリズムが必要です。完了日のあるプロジェクトではありません。
共有顧客レコードアーキテクチャに関するよくある質問
4レイヤー共有顧客レコードアーキテクチャとは何ですか?
AEからCSへの境界で、アカウント情報をどのように構造化し、所有し、同期するかを定義するデータ設計フレームワークです。レイヤー1(アカウントマスター)は企業プロファイル、セグメント、契約金額、更新日を保持し、CRM発でCSプラットフォームでは読み取り専用です。レイヤー2(取引コンテキスト)はコミットされた使用ケース、営業サイクル中に行われた約束、ICPフィットスコアを扱い、クローズ時にCRMからCSへ一度だけ静的に流れます。レイヤー3(リレーションシップマップ)は連絡先、チャンピオンの特定、エンゲージメント履歴を扱い、共同所有で双方向に同期されます。レイヤー4(ヘルスとエンゲージメント)は製品使用状況、NPS、サポート履歴、ヘルススコアを保持し、CS発でAEの視認性のためにCRMでは読み取り専用です。
マスターのシステム・オブ・レコードは常にCRMですか、それともCSプラットフォームがその役割を担えますか?
ほとんどのデータタイプでは、CRMがマスターです。商業データ(契約条件、ARR、更新日、アカウントティア)はCRMで生まれ、読み取り専用の参照としてCSプラットフォームに流れます。ヘルスとエンゲージメントのデータはCSプラットフォームで生まれ、AEが使うための読み取り専用の参照としてCRMに流れます。どちらのシステムも常にマスターというわけではなく、各レイヤーは、そのデータを生成し責任を負うチームに基づいて、それぞれ固有の発生元システムを持ちます。4レイヤーアーキテクチャはこれを明示するもので、どちらのチームも完全には信頼していない単一のマスターを既定にすることはありません。
CRMとCSプラットフォームの間で最低限一貫している必要がある6つのフィールドはどれですか?
Account ID(あいまい一致なしで同期を可能にする主キー)、契約開始日と終了日(両チームが更新タイミングのために必要)、コミットされた使用ケース(CSMが初日から何が販売されたかを知る必要がある)、チャンピオン連絡先ID(両システムの連絡先レコードにリンクされ、双方向で維持される)、セグメント/ティア(CSM割り当て、QBRリズム、更新プロセスを決定する)、そして更新ARR(両チームがフォーキャストのために同じ数字を必要とする)です。この6つが最小限の共有スキーマです。ここから始め、各フィールドに定義されたオーナーシップと同期の方向を設ければ、ハンドオフを確実にするには十分です。
共有顧客レコードアーキテクチャと「CRMをシングルソースオブトゥルースとして」の違いは何ですか?
シングルソースオブトゥルースの概念は、各データタイプについて1つの権威あるレコードが存在することを確立します。4レイヤー共有顧客レコードアーキテクチャは、その概念をAEからCSへの境界で実装するものです。どのフィールドがCRMからCSプラットフォームに拡張されるか、各フィールドのデータがどの方向に流れるか、誰が書き込みアクセス権を持つか、そしてどの同期メカニズムで両者の整合を保つかを定義します。SoTの原則を完全に支持しながらも、誰も共有スキーマを設計しなかったために実装が壊れているという状況になり得ます。アーキテクチャは、SoTの原則が未解決のまま残す実装の問いに答えます。
CRMとCSプラットフォームの整合を保つ3つの同期メカニズムの選択肢は何ですか?
ネイティブ統合(ベンダー提供の組み込みコネクタ)は設定が最も簡単ですが、公開されているフィールドに限られ、どちらかのシステムが更新されると静かに壊れやすい弱点があります。iPaaSミドルウェア(Zapier、Make、Workato)はカスタムフィールドや複雑なロジックに最も柔軟ですが、RevOpsによる構築と維持が必要で、同期のレイテンシも生じます。統合プラットフォーム(CRMとCSが同じシステム)はアーキテクチャ上の理想で、両チームが同じレコードで作業するため同期自体が不要になります。ただし、大規模なプラットフォーム移行が必要です。ほとんどのミッドマーケットチームにとっては、iPaaSが正解です。カスタムフィールドに対応できる十分な柔軟性があり、小規模なRevOpsチームでも維持コストを管理できます。
CRMとCSプラットフォームの間のスキーマのドリフトを長期的にどう防ぎますか?
スキーマ変更プロセスを定義し、RevOpsをそのプロセスのオーナーにします。プロセスは複雑である必要はありません。共有スキーマへの新しいフィールド追加のリクエストはすべてRevOpsがレビューし、RevOpsが両システムに同時にフィールドを追加し、共有フィールド辞書を更新します。このプロセスがなければ、フィールドが一方のシステムに追加されても他方に対応する追加がなされず、スキーマは静かに乖離し、多くの場合は稼働後1四半期以内にそうなります。RevOpsが両システムからフィールドリストを取り出し、20~30のアカウントのサンプルで値の一貫性を確認する四半期ごとのスキーマ監査は、ドリフトがデータ整合性の問題になる前に発見します。
関連記事