Gestionar agentes de IA como parte del equipo: un manual operativo
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
Gestionar un agente de IA como parte de un equipo significa tratarlo como una fuente de capacidad con un alcance definido, un estándar de calidad medible, un traspaso explícito a un humano, un historial monitoreado y una línea de costo, las mismas disciplinas que un manager aplica a cualquier recurso que produce trabajo a nombre del equipo. La frontier firm y el agent boss trata el cambio cultural; este artículo es la mecánica que hay debajo.
La mayoría de los equipos saltan directo a "darle una tarea al agente" y descubren por las malas que nadie definió cómo se ve lo terminado, a quién se avisa cuando se equivoca ni qué pasa la semana en que el modelo empieza a razonar distinto en silencio. Este es el manual para hacerlo en orden.
Datos clave
- Cuando los managers modelaron activamente el uso de la IA ellos mismos, los empleados reportaron un aumento de 17 puntos en el valor percibido de la IA, de 22 puntos en el pensamiento crítico sobre su uso de la IA y de 30 puntos en la confianza en la IA agéntica, en un estudio liderado por Microsoft con 1,800 trabajadores. Fuente: Microsoft, 2026 Work Trend Index
- Cuando los managers crearon seguridad psicológica para experimentar, los empleados reportaron hasta 20 puntos más de preparación para la IA y tuvieron 1.4 veces más probabilidades de ser usuarios frecuentes de IA agéntica. Los factores organizacionales explican el 67% del impacto de la IA, aproximadamente el doble que el comportamiento individual. Fuente: Microsoft, 2026 Work Trend Index
- Los agentes activos dentro de Microsoft 365 crecieron 15x año contra año, y subieron a 18x en las grandes empresas. Fuente: Microsoft, 2026 Work Trend Index
- El costo de una interacción compleja y orquestada de un agente pasó de aproximadamente $0.04 en 2023 a cerca de $1.20 en 2026, un aumento de casi 30x, impulsado sobre todo por las llamadas a herramientas y los reintentos más que por el precio bruto del modelo. Fuente: EY, "Agentic AI Enterprise Token Cost"
- Gartner proyecta que más del 40% de los proyectos de IA agéntica será cancelado a finales de 2027 por costos crecientes, valor de negocio poco claro o controles de riesgo inadecuados. Fuente: EY, "Agentic AI Enterprise Token Cost"
- El agentic drift, la degradación gradual del comportamiento de un agente, suele ser provocado por actualizaciones del modelo, cambios en los datos que utiliza o cambios en el contexto de negocio, no por un único fallo dramático. Fuente: IBM, "The Hidden Risk That Degrades AI Agent Performance"
Empiece por delimitar lo que el agente realmente posee
El fallo más común en la gestión de agentes es saltarse este paso. Un equipo le da a un agente un mandato amplio, "atender los correos de onboarding de clientes", y descubre semanas después que nadie acordó qué significa "atender", así que el agente está redactando respuestas a disputas de facturación que nunca debía tocar.
Redacte el alcance como una descripción de puesto
Una lista de funciones describe lo que el agente puede hacer técnicamente. Un alcance describe de qué es responsable: los pasos del workflow que posee de principio a fin, los insumos sobre los que actúa y los resultados de los que responde. Si no puede escribir una descripción de puesto de un párrafo para él como lo haría para una nueva contratación, el alcance no está lo bastante definido como para traspasarlo.
Trace el límite de autoridad
Todo alcance necesita una lista complementaria de lo que el agente no puede decidir solo: cambiar un precio, cerrar un ticket sin un código de resolución, enviar un mensaje que supere cierto tamaño o audiencia. Ese es el borde práctico de dónde la automatización debe reemplazar un paso en lugar de solo asistirlo, escrito igual que a una nueva contratación se le da un límite de gasto antes de entregarle una tarjeta de la empresa. Los guardrails hacen exigible el límite en el código, no en una política que nadie vuelve a leer.
Dimensione el alcance a algo revisable
Si es demasiado amplio, ningún humano puede revisar con sentido diez juicios distintos a la vez. Si es demasiado estrecho, desperdicia la capacidad del agente y entierra al manager en traspasos. El tamaño correcto permite que una persona mire diez resultados y diga con credibilidad si el agente está haciendo bien el trabajo.
Fije el estándar de calidad y los criterios de aceptación antes del primer día
"Suficientemente bueno" no puede ser un juicio emitido después de los hechos, o cada revisión se convierte en un debate sobre una meta que se mueve. El estándar tiene que existir, por escrito, antes de que el agente produzca su primer resultado real.
Haga que lo "correcto" sea verificable
Los criterios de aceptación deben ser lo bastante específicos como para que una segunda persona, o una segunda ejecución del agente, pueda comprobar el trabajo contra el mismo estándar sin preguntar qué quiso decir usted. "Suena profesional" no es un criterio. "Coincide con las plantillas aprobadas, incluye el número de cuenta y señala cualquier solicitud superior a $500" sí lo es. El cambio de ejecutor a orquestador se aplica directamente: escribir un brief verificable es ahora una habilidad central de gestión.
Tome prestado del QA, no de las corazonadas
Trate el resultado del agente como un equipo de QA trata un candidato a release: defina un conjunto pequeño de casos de prueba que cubra el rango de situaciones que enfrentará, incluidos algunos deliberadamente difíciles, y ejecute las nuevas versiones contra ese conjunto antes de desplegarlas más ampliamente. La investigación de IBM sobre el agentic drift plantea preguntarse si un resultado es correcto frente a la intención, no si coincide palabra por palabra con una referencia, ya que dos ejecuciones pueden estar redactadas de forma distinta y ser ambas correctas.
Fije un umbral de confianza, no solo aprobado o reprobado
Algunos resultados son claramente correctos o incorrectos. Muchos no. Construya el estándar en torno a un umbral de confianza: por debajo de él, el resultado se enruta a revisión automáticamente; por encima, se entrega. Ese umbral sirve además de columna vertebral del diseño de escalamiento que sigue.
Diseñe a propósito el traspaso entre el agente y el humano
Un traspaso que no se diseña a propósito se diseña por accidente, normalmente como el mensaje de Slack que alguien envió la primera vez que algo salió mal. Eso es un hábito, no un proceso, y los hábitos no escalan más allá de la persona que los empezó.
Nombre los puntos de traspaso antes de que el agente se ejecute
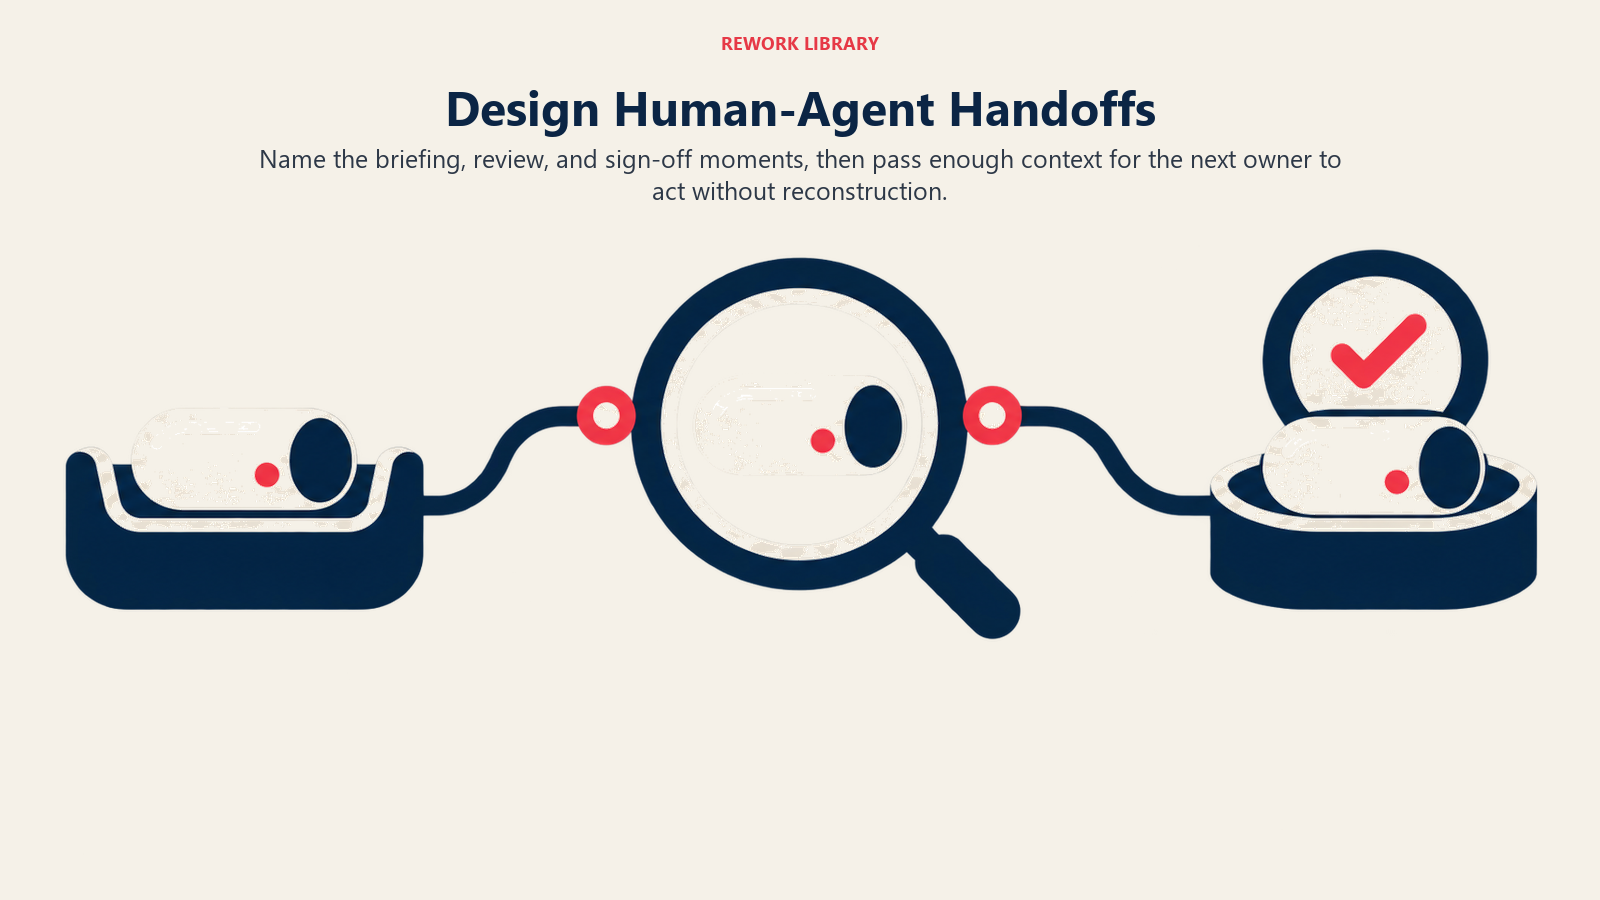
Tres momentos se repiten en casi todo workflow a cargo de un agente: antes de empezar, a mitad de la tarea si alcanza su umbral de confianza o el límite de su alcance, y después de terminar, cuando alguien revisa, aprueba o corrige el resultado. Cada uno necesita un responsable, un canal y una expectativa de tiempo de respuesta, igual que cualquier traspaso entre dos roles humanos.
Use la matriz de responsabilidades para asignar la titularidad
La tabla siguiente es una plantilla de partida. Cópiela, complete los nombres y herramientas de su equipo y revísela cada vez que cambie el alcance del agente.
| Responsabilidad de operación de agentes | Qué significa en la práctica | Quién la posee |
|---|---|---|
| Delimitar el trabajo del agente | Redactar el mandato de un párrafo y la lista explícita de lo "no permitido" | Líder del equipo o dueño del proceso |
| Fijar el estándar de calidad | Definir criterios de aceptación verificables y el umbral de confianza para entrega automática frente a revisión | Líder del equipo, con un revisor experto en la materia |
| Diseño del traspaso | Nombrar los puntos de traspaso previos, durante y posteriores a la tarea, con sus canales y tiempos de respuesta | Líder de operaciones o dueño del workflow |
| Enrutamiento del escalamiento | Decidir a quién se avisa ante un resultado de baja confianza, una violación de alcance o una falla del sistema | Manager de guardia o revisor designado |
| Monitoreo y observabilidad | Seguir la tasa de éxito de tareas, la latencia, el costo por tarea y la tasa de escalamiento en un dashboard que alguien abra | Quien posea la herramienta en la que corre el agente |
| Versionado y control de cambios | Registrar cada cambio de prompt, herramienta o modelo y ejecutar el conjunto de regresión antes de un despliegue más amplio | Ingeniería o el dueño de la plataforma de IA |
| Planificación de capacidad | Pronosticar el volumen de tareas y fijar límites de rendimiento según el ancho de banda de revisión humana | Líder del equipo, revisado mensualmente |
| Costo y presupuesto | Seguir el costo por tarea frente a un techo fijado y avisar cuando el gasto supere al valor | Socio de finanzas o el líder del equipo con autoridad presupuestaria |
| Respuesta a incidentes | Ejecutar el playbook cuando el agente falla gravemente: pausar, notificar, hallar la causa raíz, corregir, reanudar | Manager de guardia |
| Desmantelamiento | Decidir cuándo un alcance deja de valer su costo de mantenimiento y retirarlo o reducirlo | Líder del equipo, revisado trimestralmente |
Abarate el lado humano
Un traspaso que le toma a un revisor quince minutos abrir y atender se salta bajo presión de plazos, por bien diseñado que se vea en el papel. Intégrelo en la herramienta que el revisor ya usa, con el puntaje de confianza del agente, aquello específico de lo que no está seguro y aprobar o rechazar con un clic. Si revisar un escalamiento es más difícil que rehacer la tarea a mano, las personas dejan de confiar en el agente en silencio, la misma cuestión de confianza con la que chocan constantemente los equipos humano-agente.
Construya rutas de escalamiento que la gente realmente use
Las rutas de escalamiento fallan en una de dos direcciones: demasiado sensibles, de modo que se avisa a los humanos constantemente y empiezan a ignorar las alertas, o demasiado permisivas, de modo que el agente rodea un problema en lugar de plantearlo y nadie se entera hasta que el resultado ya está equivocado en producción.
Escale por niveles según la confianza y la reversibilidad
Una estructura por niveles encaja con la mayoría de los workflows de equipo: totalmente autónoma para acciones de bajo riesgo y reversibles, como las lecturas; supervisada, con una breve ventana de veto, para escrituras de riesgo medio, como enviar un mensaje; y con puerta, que exige aprobación activa, para acciones irreversibles como eliminaciones, pagos o cualquier cosa que toque un contrato de cliente. Fije los umbrales por nivel según lo costoso que sea realmente un error en su workflow, no con una cifra copiada de la publicación de blog de otro.
Dele al agente una opción real de "no sé"
Un agente que siempre suena seguro, incluso cuando no debería, es más peligroso que uno que se detiene, porque una tarea detenida se nota y una equivocada a menudo no. Incorpore "escalar a un humano" a su conjunto de resultados válidos y trate un escalamiento honesto como un éxito. Los equipos que penalizan en silencio la tasa de escalamiento como si fuera una tasa de error entrenan a sus agentes, y a sus personas, a dejar de levantar la mano.
Enrute a una persona concreta, no a una cola
Una cola compartida sin responsable es donde los escalamientos van a morir. Cada nivel debe corresponder a un rol con nombre y un tiempo de respuesta definido, como funciona una rotación de guardia ante una caída en producción. El diseño de human-in-the-loop solo se sostiene si hay un humano concreto y localizable en ese circuito.
Monitoree y observe al agente como un sistema, no como una herramienta
Una herramienta se revisa cuando algo parece estar mal. Un sistema se vigila de forma continua, porque cuando algo parece estar mal a simple vista, por lo general ya lleva un tiempo estándolo.
Siga el comportamiento, no solo la disponibilidad
El monitoreo tradicional de disponibilidad le dice que el agente está funcionando. No le dice que esté en lo correcto. La observabilidad de agentes debe cubrir la salud del sistema (disponibilidad, latencia, tasa de errores) y la salud conductual (tasa de éxito de tareas, tasa de escalamiento, deriva frente a una línea base conocida como buena). Un agente que responde al instante y con seguridad mientras se equivoca cada vez más en silencio pasa todas las comprobaciones de disponibilidad y falla a todos los usuarios que confiaron en él, el mismo riesgo de sesgo de automatización que se aborda en mantener afilado el juicio humano.
Registre lo suficiente para reconstruir lo que pasó
Cuando un resultado es incorrecto, la pregunta que importa no es solo "¿estaba mal?", sino "¿por qué?", y eso requiere un rastro: entradas, llamadas a herramientas y parámetros, y el razonamiento detrás del resultado. Sin él, cada revisión de incidente se convierte en conjeturas y el mismo fallo se repite en silencio.
Establezca un dashboard que alguien realmente abra
Un dashboard que nadie mira es decoración, no monitoreo. Elija un número reducido de métricas que correspondan a las responsabilidades de la tabla anterior, costo por tarea, tasa de éxito, tasa de escalamiento, tiempo de resolución, y colóquelas donde la persona responsable las revise con una cadencia fija, no solo cuando algo se rompe.
Versione al agente y controle el cambio como en un sistema de producción
La mayor fuente de fallos sorpresa en la gestión de agentes no es un mal funcionamiento dramático. Es un cambio sutil de comportamiento que nadie señaló como cambio, porque visto desde fuera no lo parece.
Trate cada cambio como un despliegue
Una edición de prompt, un cambio de versión del modelo, una herramienta actualizada o una nueva fuente de datos pueden alterar el comportamiento de maneras difíciles de predecir solo con el diff. La investigación de IBM sobre el agentic drift nombra justo este patrón: un agente que omite un paso que antes realizaba de forma fiable porque una actualización del modelo de base cambió cómo pondera la velocidad frente a la minuciosidad. Registre cada cambio con una marca de tiempo y una descripción, para que un cambio de comportamiento se rastree hasta una causa en lugar de investigarse desde cero.
Ejecute el conjunto de regresión antes, no después
Mantenga un conjunto fijo de tareas representativas, incluidas las difíciles, y ejecútelo contra cada versión antes de desplegar el cambio ampliamente. Es la misma lógica que una suite de regresión en software: barata de ejecutar de forma repetida, y detecta el fallo antes de que lo haga un cliente.
Deje fijada una ruta de reversión
Sepa de antemano cómo volvería a la última versión conocida como buena si un cambio sale mal: una versión de modelo fijada, un prompt guardado, un feature flag. Decidirlo durante un incidente en curso cuesta tiempo que no tiene. Desplegar agentes en producción de forma segura significa que el plan de reversión existe antes del primer despliegue, no después del primero que sale mal.
Planifique la capacidad como lo haría con un equipo en crecimiento
La capacidad de un agente no es infinita ni gratuita de escalar a demanda. Está limitada por los límites de tasa de la API, el ancho de banda de revisión, el presupuesto y el volumen de trabajo que los humanos a su alrededor pueden supervisar realmente.
Pronostique contra el ancho de banda de revisión, no solo contra el rendimiento
El agente podría procesar técnicamente diez veces el volumen actual de tareas. Lo que importa es si sus revisores pueden manejar diez veces los escalamientos y las comprobaciones puntuales que eso trae consigo. La planificación de capacidad de un workflow a cargo de un agente es, en realidad, planificación de capacidad de los humanos que lo supervisan.
Vuelva a pronosticar cuando cambie el alcance o el modelo
Un plan de capacidad construido en torno a una versión de modelo, un alcance y una mezcla de tareas queda obsoleto en el momento en que cualquiera de ellos cambia. Revíselo con la misma cadencia que el registro de versiones, ya que una mejor versión del modelo cambia cuánto tiempo de revisión necesita cada resultado.
Las cuentas de plantilla se desplazan, no desaparecen
El crecimiento de 15x año contra año de los agentes activos dentro de Microsoft 365 no vino acompañado de una caída equivalente en los humanos que gestionan esos workflows. Vino con un cambio en aquello a lo que esos humanos dedican su tiempo: menos producción, más delimitación, revisión y juicio, el hilo conductor de cómo se ve realmente el futuro del trabajo cuando los agentes asumen más ejecución. Planifique la plantilla en torno a ese cambio en lugar de suponer que la capacidad del agente es un sustituto directo de una persona.
Gestione la línea de costo como un presupuesto, no como una sorpresa
El costo de los agentes no escala como la mayoría espera. Una sola tarea puede desencadenar muchas llamadas a herramientas, reintentos y pasos de razonamiento, de modo que el costo por tarea puede moverse bruscamente incluso cuando bajan los precios del modelo por token.
Conozca su economía unitaria real
El costo por tarea, no el costo por token, es lo que importa para planificar, ya que la orquestación, los reintentos y las llamadas a herramientas suelen representar una parte grande del gasto total más allá de la factura del modelo. Compare esa cifra antes de escalar, igual que calcularía la carga total de una nueva contratación y no solo el salario base. Vea las tácticas de optimización de costos para agentes de IA para conocer formas en que los equipos reducen esa cifra sin recortar calidad.
Ponga un cortacircuitos en el presupuesto
Fije un techo de costo por tarea y avise automáticamente cuando el gasto se acerque a él, en lugar de descubrir la cifra al final de un ciclo de facturación. Esa es la respuesta práctica a la proyección de Gartner de arriba: la mayoría de las sorpresas de costo son evitables con una alerta de presupuesto que se dispare semanas antes.
Revise el costo frente al valor con la misma cadencia
Un workflow que tenía sentido automatizar al costo del trimestre pasado podría no superar el listón este trimestre, o superarlo por más si un modelo más barato se volvió viable. Revise el costo, la calidad y el volumen en conjunto, ya que el agente más barato que produce resultados poco fiables en realidad no es barato.
Nada de esto es exótico. Es la misma disciplina aplicada a cualquier recurso que produce trabajo a su nombre: definir el trabajo, fijar el estándar, diseñar el traspaso, vigilar el historial, saber lo que cuesta. Los equipos que están sacando valor real de los agentes en 2026 no son los que operan el modelo más sofisticado. Son los que escribieron este manual antes de necesitarlo, en lugar de improvisarlo durante el primer incidente.

Co-Founder, Rework.com
On this page
- Datos clave
- Empiece por delimitar lo que el agente realmente posee
- Redacte el alcance como una descripción de puesto
- Trace el límite de autoridad
- Dimensione el alcance a algo revisable
- Fije el estándar de calidad y los criterios de aceptación antes del primer día
- Haga que lo "correcto" sea verificable
- Tome prestado del QA, no de las corazonadas
- Fije un umbral de confianza, no solo aprobado o reprobado
- Diseñe a propósito el traspaso entre el agente y el humano
- Nombre los puntos de traspaso antes de que el agente se ejecute
- Use la matriz de responsabilidades para asignar la titularidad
- Abarate el lado humano
- Construya rutas de escalamiento que la gente realmente use
- Escale por niveles según la confianza y la reversibilidad
- Dele al agente una opción real de "no sé"
- Enrute a una persona concreta, no a una cola
- Monitoree y observe al agente como un sistema, no como una herramienta
- Siga el comportamiento, no solo la disponibilidad
- Registre lo suficiente para reconstruir lo que pasó
- Establezca un dashboard que alguien realmente abra
- Versione al agente y controle el cambio como en un sistema de producción
- Trate cada cambio como un despliegue
- Ejecute el conjunto de regresión antes, no después
- Deje fijada una ruta de reversión
- Planifique la capacidad como lo haría con un equipo en crecimiento
- Pronostique contra el ancho de banda de revisión, no solo contra el rendimiento
- Vuelva a pronosticar cuando cambie el alcance o el modelo
- Las cuentas de plantilla se desplazan, no desaparecen
- Gestione la línea de costo como un presupuesto, no como una sorpresa
- Conozca su economía unitaria real
- Ponga un cortacircuitos en el presupuesto
- Revise el costo frente al valor con la misma cadencia