KI-Agents als Teil des Teams führen: Ein Betriebshandbuch
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
Einen KI-Agent als Teil eines Teams zu führen heißt, ihn als Kapazitätsquelle zu behandeln: mit einem definierten Verantwortungsbereich, einem messbaren Qualitätsmaßstab, einer ausdrücklichen Übergabe an einen Menschen, einer überwachten Erfolgsbilanz und einer eigenen Kostenzeile, also mit denselben Disziplinen, die eine Führungskraft bei jeder Ressource anwendet, die Arbeit unter dem Namen des Teams erzeugt. Die Frontier Firm und der Agent Boss behandelt den kulturellen Wandel; hier geht es um die Mechanik darunter.
Die meisten Teams springen direkt zu „dem Agent eine Aufgabe geben“ und merken auf die harte Tour, dass niemand definiert hat, wie „fertig“ aussieht, wer angepingt wird, wenn es falsch ist, oder was in der Woche passiert, in der das Modell unbemerkt anders zu schlussfolgern beginnt. Dies ist das Handbuch, um es der Reihe nach zu tun.
Wichtige Fakten
- Wenn Führungskräfte die KI-Nutzung selbst aktiv vorlebten, berichteten Mitarbeitende eine um 17 Punkte höhere wahrgenommene KI-Wertschöpfung, einen um 22 Punkte höheren Wert beim kritischen Denken über die eigene KI-Nutzung und einen um 30 Punkte höheren Wert beim Vertrauen in agentenbasierte KI, in einer von Microsoft geleiteten Studie mit 1.800 Beschäftigten. Quelle: Microsoft, 2026 Work Trend Index
- Wenn Führungskräfte psychologische Sicherheit für Experimente schufen, berichteten Mitarbeitende bis zu 20 Punkte höhere KI-Bereitschaft und nutzten mit 1,4-mal höherer Wahrscheinlichkeit häufig agentenbasierte KI. Organisatorische Faktoren machen 67 % der KI-Wirkung aus, etwa das Doppelte des individuellen Verhaltens. Quelle: Microsoft, 2026 Work Trend Index
- Die Zahl aktiver Agents in Microsoft 365 wuchs im Jahresvergleich um das 15-Fache, in großen Unternehmen um das 18-Fache. Quelle: Microsoft, 2026 Work Trend Index
- Die Kosten einer komplexen, orchestrierten Agent-Interaktion stiegen von rund 0,04 \(im Jahr 2023 auf etwa 1,20\) im Jahr 2026, ein Anstieg um fast das 30-Fache, getrieben vor allem von Tool-Aufrufen und Wiederholungen und weniger von den reinen Modellpreisen. Quelle: EY, „Agentic AI Enterprise Token Cost“
- Gartner prognostiziert, dass mehr als 40 % der Projekte mit agentenbasierter KI bis Ende 2027 wegen steigender Kosten, unklaren Geschäftsnutzens oder unzureichender Risikokontrollen eingestellt werden. Quelle: EY, „Agentic AI Enterprise Token Cost“
- Agentic Drift, die schleichende Verschlechterung des Verhaltens eines Agents, wird typischerweise durch Modell-Updates, Verschiebungen in den genutzten Daten oder Änderungen im Geschäftskontext ausgelöst, nicht durch einen einzelnen dramatischen Ausfall. Quelle: IBM, „The Hidden Risk That Degrades AI Agent Performance“
Beginnen Sie damit, festzulegen, wofür der Agent tatsächlich zuständig ist
Der häufigste einzelne Fehler bei der Agent-Führung ist, diesen Schritt zu überspringen. Ein Team gibt einem Agent ein breites Mandat, „Onboarding-E-Mails von Kunden bearbeiten“, und stellt Wochen später fest, dass sich niemand darauf geeinigt hat, was „bearbeiten“ heißt, sodass der Agent Antworten auf Abrechnungsstreitigkeiten entwirft, für die er nie vorgesehen war.
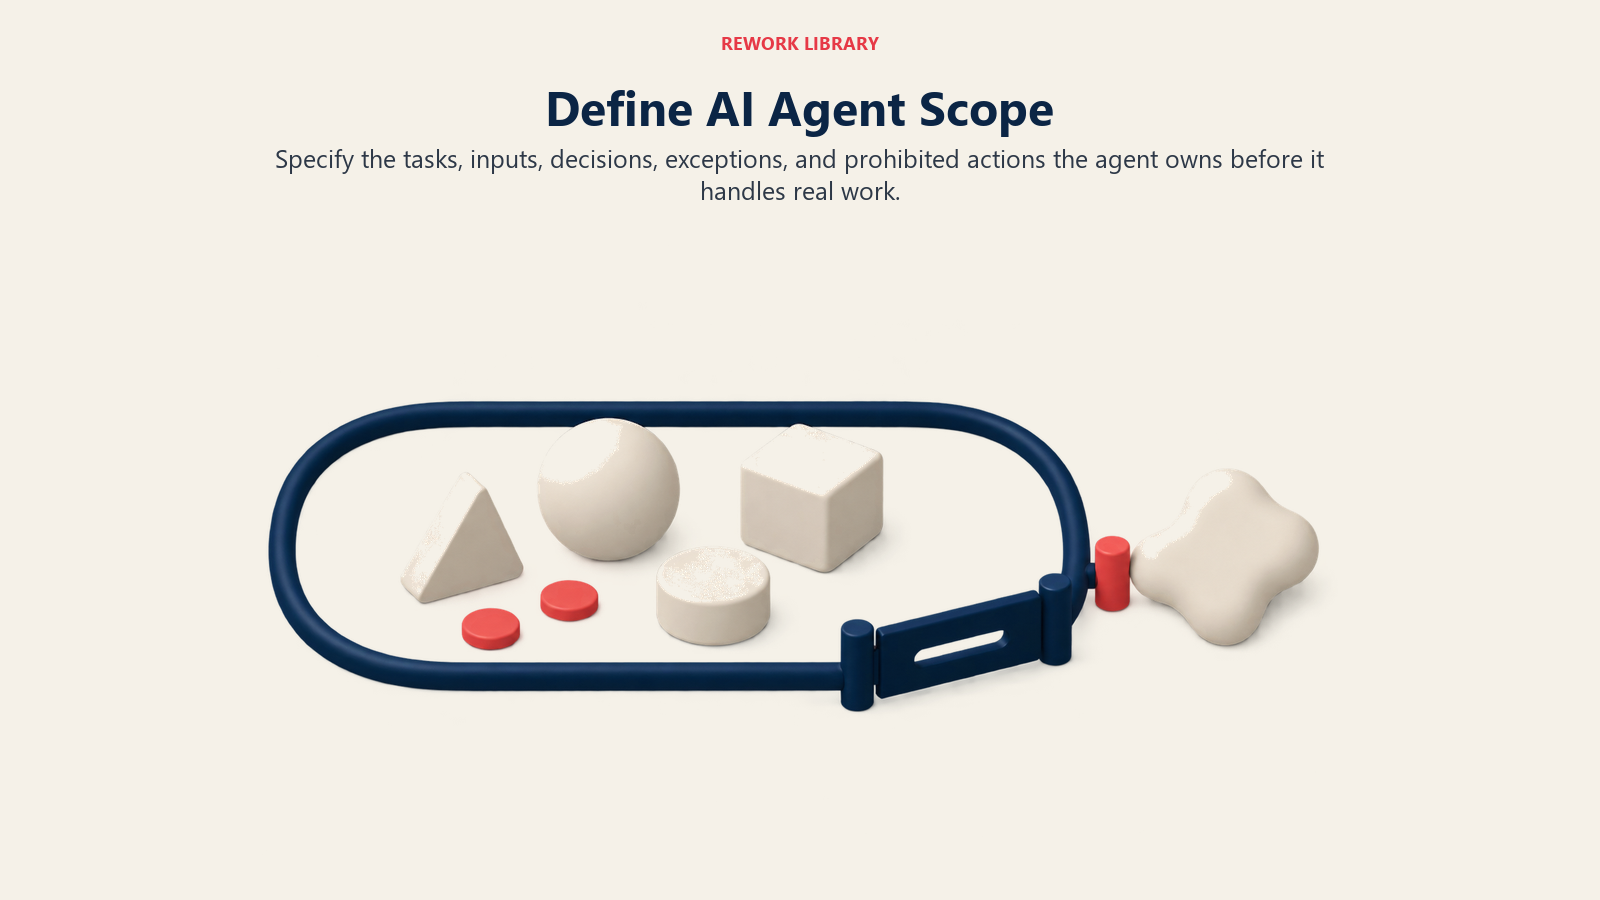
Schreiben Sie den Verantwortungsbereich wie eine Stellenbeschreibung
Eine Funktionsliste beschreibt, was der Agent technisch kann. Ein Verantwortungsbereich beschreibt, wofür er rechenschaftspflichtig ist: die Workflow-Schritte, die er von Anfang bis Ende verantwortet, die Eingaben, auf die er reagiert, und die Ergebnisse, für die er einsteht. Wenn Sie für ihn nicht wie für eine Neueinstellung eine einseitige Stellenbeschreibung in einem Absatz schreiben können, ist der Bereich nicht eng genug gefasst, um ihn zu übergeben.
Ziehen Sie die Grenze der Befugnis
Zu jedem Verantwortungsbereich gehört eine Begleitliste dessen, was der Agent nicht allein entscheiden darf: einen Preis ändern, ein Ticket ohne Lösungscode schließen, eine Nachricht ab einer bestimmten Größe oder an eine bestimmte Zielgruppe senden. Das ist die praktische Grenze dessen, wo Automatisierung einen Schritt ersetzen und wo sie ihn nur unterstützen sollte, aufgeschrieben so, wie eine Neueinstellung ein Ausgabenlimit bekommt, bevor sie eine Firmenkarte erhält. Guardrails machen die Grenze im Code durchsetzbar, statt als Richtlinie, die niemand noch einmal liest.
Bemessen Sie den Verantwortungsbereich so, dass er prüfbar bleibt
Zu breit, und kein Mensch kann zehn verschiedene Urteile gleichzeitig sinnvoll prüfen. Zu eng, und die Kapazität des Agents wird verschwendet, während die Führungskraft in Übergaben versinkt. Die richtige Größe erlaubt es einer Person, zehn Ergebnisse anzusehen und glaubwürdig zu sagen, ob der Agent seine Arbeit gut macht.
Setzen Sie Qualitätsmaßstab und Abnahmekriterien vor dem ersten Tag
„Gut genug“ darf kein Urteil sein, das erst nachträglich gefällt wird, sonst wird jede Prüfung zur Debatte über ein bewegliches Ziel. Der Maßstab muss schriftlich existieren, bevor der Agent sein erstes echtes Ergebnis liefert.
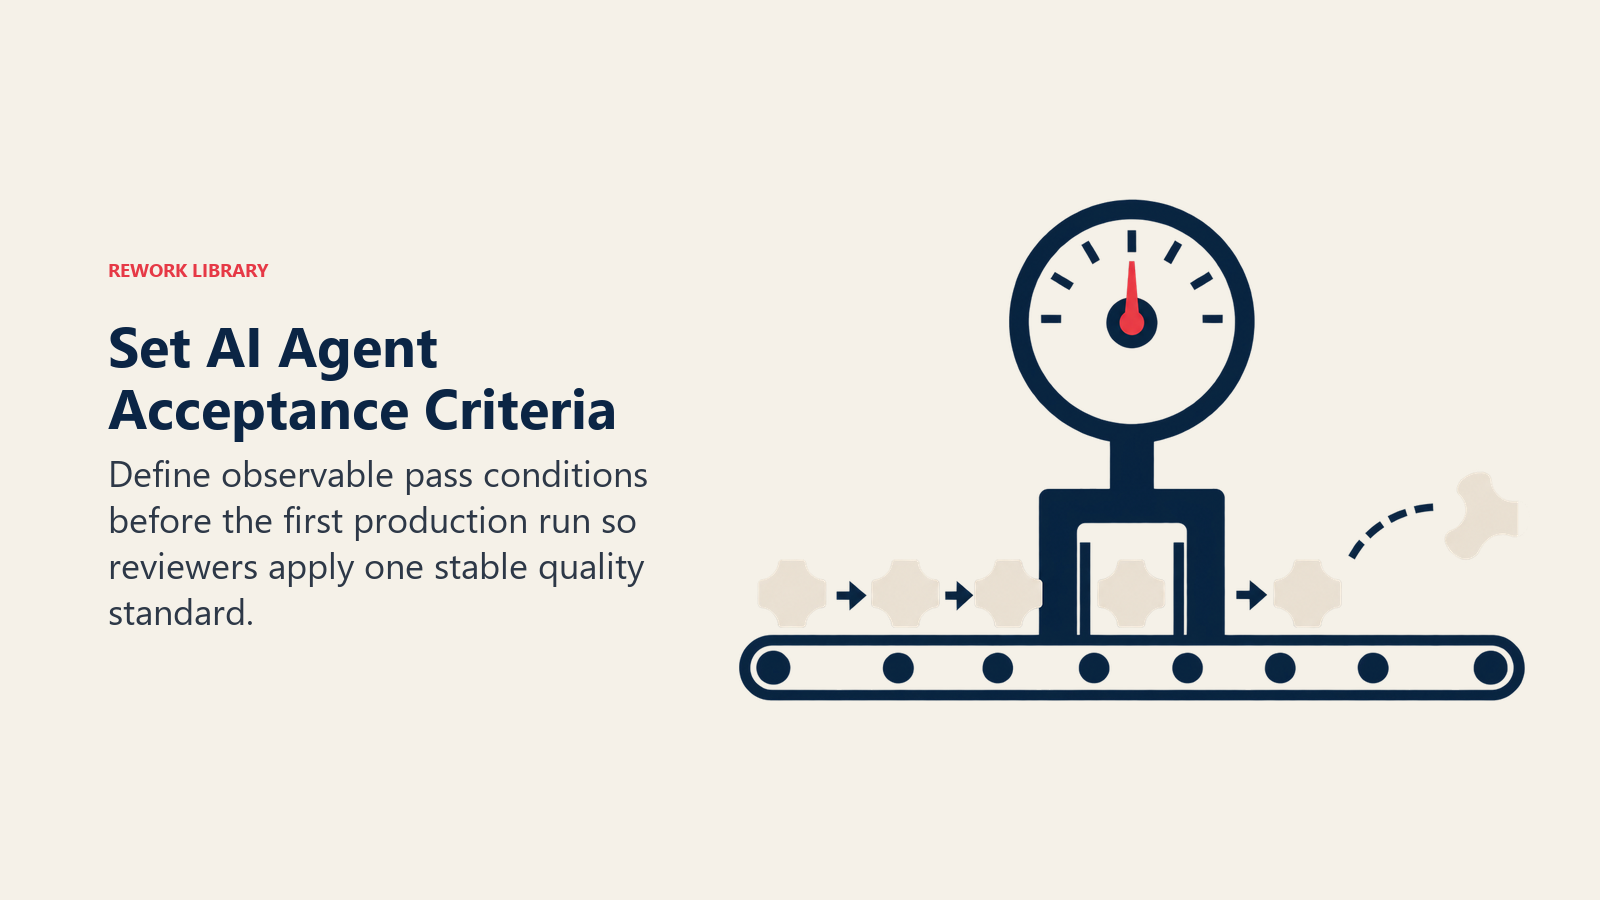
Machen Sie „richtig“ prüfbar
Abnahmekriterien sollten so konkret sein, dass eine zweite Person oder ein zweiter Agent-Durchlauf die Arbeit am selben Standard prüfen könnte, ohne nachzufragen, was Sie meinten. „Klingt professionell“ ist kein Kriterium. „Entspricht den freigegebenen Vorlagen, enthält die Kontonummer und markiert jede Anfrage über 500 $“ ist eines. Der Wandel vom Macher zum Orchestrator gilt hier unmittelbar: Ein prüfbares Briefing zu schreiben ist jetzt eine Kernkompetenz der Führung.
Orientieren Sie sich an QA, nicht an Bauchgefühl
Behandeln Sie das Ergebnis des Agents so, wie ein QA-Team einen Release Candidate behandelt: Definieren Sie eine kleine Menge von Testfällen, die das Spektrum der Situationen abdecken, auf die er trifft, darunter einige bewusst schwierige, und lassen Sie neue Versionen gegen diese Menge laufen, bevor Sie breiter ausrollen. IBMs Forschung zu Agentic Drift plädiert dafür, zu fragen, ob ein Ergebnis gemessen an der Absicht korrekt ist, nicht ob es Wort für Wort einer Referenz entspricht, da zwei Durchläufe unterschiedlich formuliert und beide richtig sein können.
Setzen Sie eine Konfidenzschwelle, nicht nur bestanden oder nicht bestanden
Manche Ergebnisse sind eindeutig richtig oder falsch. Viele nicht. Bauen Sie den Maßstab um eine Konfidenzschwelle auf: darunter geht das Ergebnis automatisch in die Prüfung, darüber wird es ausgeliefert. Diese Schwelle bildet zugleich das Rückgrat der unten beschriebenen Eskalationsgestaltung.
Gestalten Sie die Übergabe zwischen Agent und Mensch bewusst
Eine Übergabe, die nicht bewusst gestaltet wird, wird zufällig gestaltet, meist als die Slack-Nachricht, die jemand beim ersten Mal schrieb, als etwas schiefging. Das ist eine Gewohnheit, kein Prozess, und Gewohnheiten skalieren nicht über die Person hinaus, die sie begonnen hat.
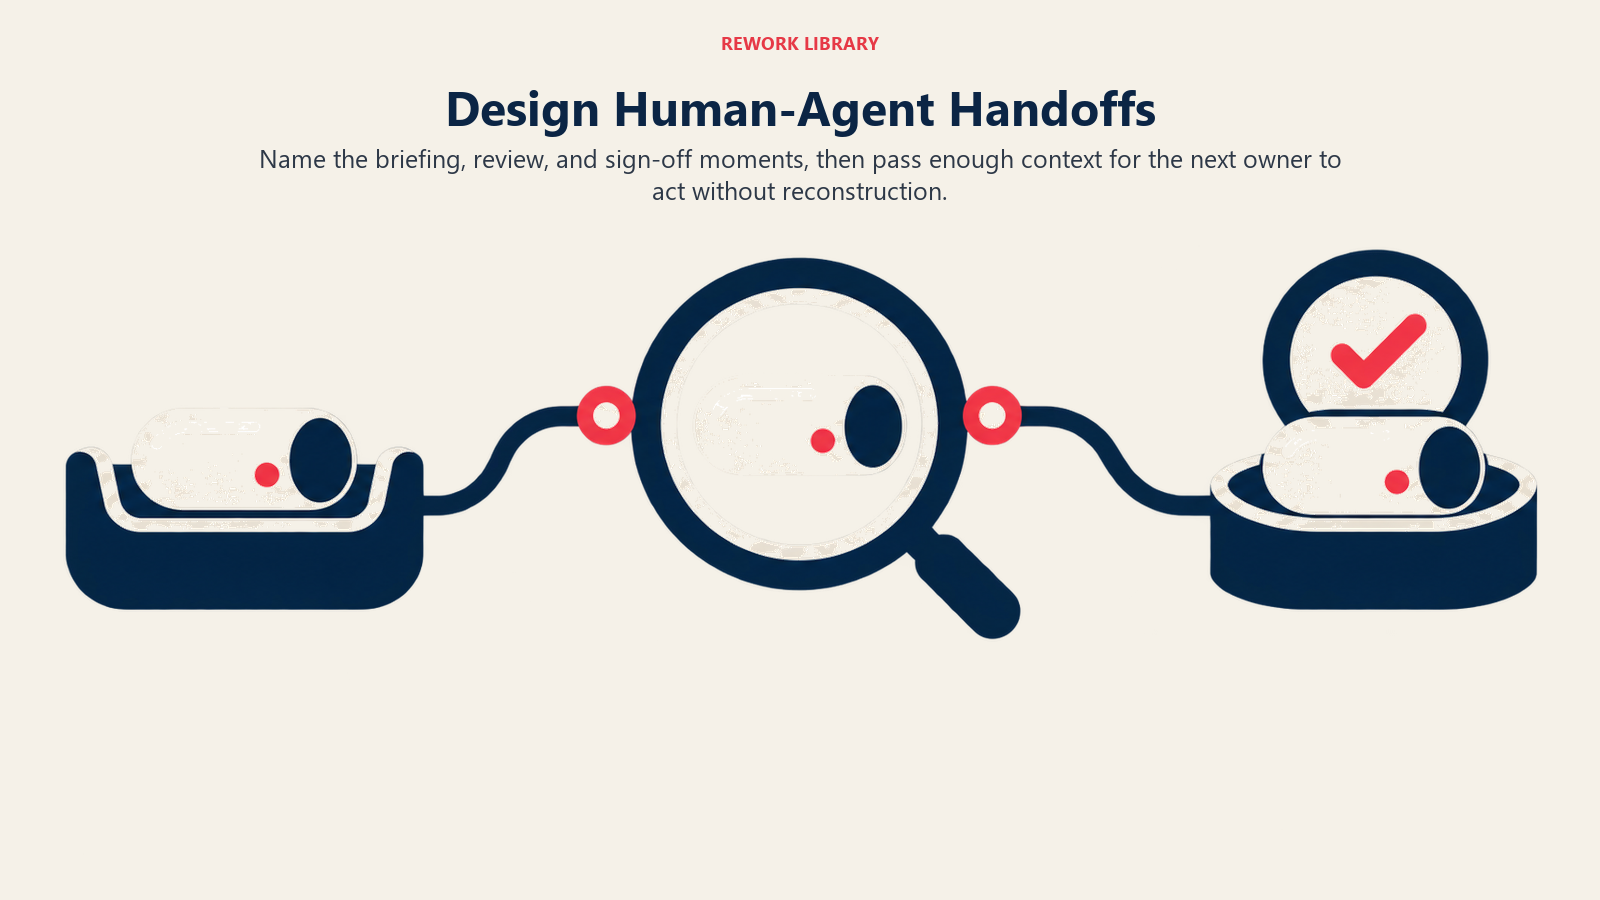
Benennen Sie die Übergabepunkte, bevor der Agent läuft
Drei Momente kehren in fast jedem Workflow wieder, den ein Agent verantwortet: bevor er startet, mitten in der Aufgabe, wenn er seine Konfidenzschwelle oder Bereichsgrenze erreicht, und nachdem er fertig ist, wenn jemand das Ergebnis prüft, freigibt oder korrigiert. Jeder braucht einen Verantwortlichen, einen Kanal und eine Erwartung an die Reaktionszeit, genau wie bei jeder Übergabe zwischen zwei menschlichen Rollen.
Nutzen Sie die Verantwortungsmatrix, um Zuständigkeiten zuzuweisen
Die folgende Tabelle ist eine Ausgangsvorlage. Kopieren Sie sie, tragen Sie die Namen und Tools Ihres Teams ein und überarbeiten Sie sie, sobald sich der Verantwortungsbereich des Agents ändert.
| Verantwortung im Agent-Betrieb | Was das in der Praxis bedeutet | Wer sie verantwortet |
|---|---|---|
| Den Auftrag des Agents eingrenzen | Das Mandat in einem Absatz und die ausdrückliche „Nicht erlaubt“-Liste schreiben | Teamleitung oder Prozessverantwortliche |
| Den Qualitätsmaßstab setzen | Prüfbare Abnahmekriterien und die Konfidenzschwelle für automatische Auslieferung vs. Prüfung definieren | Teamleitung, mit einer fachlichen Prüfperson |
| Übergabegestaltung | Die Übergabepunkte vor, während und nach der Aufgabe sowie Kanäle und Reaktionszeiten benennen | Ops Lead oder Workflow-Verantwortliche |
| Eskalationsrouting | Entscheiden, wer bei einem Ergebnis mit niedriger Konfidenz vs. einem Bereichsverstoß vs. einem Systemausfall alarmiert wird | Manager im Bereitschaftsdienst oder benannte Prüfperson |
| Monitoring und Observability | Erfolgsquote der Aufgaben, Latenz, Kosten pro Aufgabe und Eskalationsrate in einem Dashboard verfolgen, das jemand öffnet | Wer das Tool verantwortet, in dem der Agent läuft |
| Versionierung und Änderungskontrolle | Jede Änderung an Prompt, Tool oder Modell protokollieren und vor dem breiteren Rollout das Regressionsset laufen lassen | Engineering oder Verantwortliche der KI-Plattform |
| Kapazitätsplanung | Aufgabenvolumen prognostizieren und Durchsatzgrenzen gegen die Prüfkapazität der Menschen setzen | Teamleitung, monatlich überprüft |
| Kosten und Budget | Kosten pro Aufgabe gegen eine feste Obergrenze verfolgen und melden, wenn die Ausgaben dem Nutzen davonlaufen | Finance Partner oder die Teamleitung mit Budgetverantwortung |
| Incident Response | Das Playbook durchlaufen, wenn der Agent schwer versagt: pausieren, informieren, Ursache finden, beheben, fortsetzen | Manager im Bereitschaftsdienst |
| Außerbetriebnahme | Entscheiden, wann ein Verantwortungsbereich den Wartungsaufwand nicht mehr wert ist, und ihn auslaufen lassen oder verengen | Teamleitung, vierteljährlich überprüft |
Machen Sie die menschliche Seite günstig
Eine Übergabe, bei der ein Prüfer fünfzehn Minuten braucht, um sie zu öffnen und zu bearbeiten, wird unter Termindruck übersprungen, so gut sie auf dem Papier auch gestaltet ist. Bauen Sie sie in das Tool ein, das die Prüfperson ohnehin nutzt, mit dem Konfidenzwert des Agents, dem konkreten Punkt, bei dem er unsicher ist, und Freigabe oder Ablehnung mit einem Klick. Wenn das Prüfen einer Eskalation mühsamer ist, als die Aufgabe von Hand neu zu erledigen, verlieren Menschen still das Vertrauen in den Agent, dieselbe Vertrauensfrage, auf die Mensch-Agent-Teams ständig stoßen.
Bauen Sie Eskalationswege, die Menschen wirklich nutzen
Eskalationswege scheitern in einer von zwei Richtungen: zu empfindlich, sodass Menschen ständig alarmiert werden und Warnungen ignorieren, oder zu nachgiebig, sodass der Agent ein Problem umgeht, statt es zu melden, und niemand es merkt, bis das Ergebnis im Produktivbetrieb bereits falsch ist.
Staffeln Sie die Eskalation nach Konfidenz und Umkehrbarkeit
Eine gestufte Struktur passt zu den meisten Team-Workflows: vollständig autonom für risikoarme, umkehrbare Aktionen wie Lesezugriffe; beaufsichtigt, mit kurzem Einspruchsfenster, für Schreibaktionen mit mittlerem Risiko wie das Senden einer Nachricht; und mit Freigabepflicht, die aktive Zustimmung verlangt, für nicht umkehrbare Aktionen wie Löschungen, Zahlungen oder alles, was einen Kundenvertrag berührt. Legen Sie die Schwellen pro Stufe danach fest, wie teuer ein Fehler in Ihrem Workflow tatsächlich ist, nicht nach einer Zahl aus dem Blogpost eines anderen.
Geben Sie dem Agent eine echte „Ich weiß es nicht“-Option
Ein Agent, der immer selbstsicher klingt, auch wenn er es nicht sollte, ist gefährlicher als einer, der stockt, denn eine stockende Aufgabe fällt auf, eine falsche oft nicht. Nehmen Sie „an einen Menschen eskalieren“ in die Menge seiner gültigen Ergebnisse auf und behandeln Sie eine ehrliche Eskalation als Erfolg. Teams, die die Eskalationsrate stillschweigend als Fehlerquote bestrafen, erziehen ihre Agents und ihre Menschen dazu, sich nicht mehr zu melden.
Leiten Sie an eine konkrete Person, nicht an eine Warteschlange
Eine geteilte Warteschlange ohne Verantwortliche ist der Ort, an dem Eskalationen sterben. Jede Stufe sollte einer benannten Rolle mit definierter Reaktionszeit zugeordnet sein, so wie ein Bereitschaftsdienst bei einem Produktionsausfall funktioniert. Ein Human-in-the-Loop-Design trägt nur, wenn in dieser Schleife ein konkreter, erreichbarer Mensch sitzt.
Überwachen und beobachten Sie den Agent wie ein System, nicht wie ein Werkzeug
Ein Werkzeug prüft man, wenn etwas falsch aussieht. Ein System beobachtet man fortlaufend, denn bis etwas dem Auge falsch erscheint, ist es meist schon eine Weile falsch.
Verfolgen Sie das Verhalten, nicht nur die Verfügbarkeit
Klassisches Uptime-Monitoring sagt Ihnen, dass der Agent läuft. Es sagt nicht, dass er richtigliegt. Agent-Observability muss Systemgesundheit (Verfügbarkeit, Latenz, Fehlerrate) und Verhaltensgesundheit (Erfolgsquote der Aufgaben, Eskalationsrate, Drift gegenüber einer bekannten guten Baseline) abdecken. Ein Agent, der sofort und selbstsicher antwortet und dabei mit der Zeit unbemerkt mehr falsch macht, besteht jeden Uptime-Check und lässt jeden im Stich, der sich auf ihn verlassen hat, dasselbe Automation-Bias-Risiko, das das menschliche Urteilsvermögen scharf halten behandelt.
Protokollieren Sie genug, um zu rekonstruieren, was geschah
Wenn ein Ergebnis falsch ist, lautet die entscheidende Frage nicht nur „War es falsch?“, sondern „Warum?“, und dafür braucht es eine Spur: Eingaben, Tool-Aufrufe und Parameter sowie die Begründung hinter dem Ergebnis. Ohne sie wird jede Nachbesprechung eines Vorfalls zum Rätselraten, und derselbe Fehler wiederholt sich leise.
Richten Sie ein Dashboard ein, das jemand tatsächlich öffnet
Ein Dashboard, das niemand ansieht, ist Dekoration, kein Monitoring. Wählen Sie wenige Kennzahlen, die den Verantwortlichkeiten in der Tabelle oben entsprechen, Kosten pro Aufgabe, Erfolgsquote, Eskalationsrate, Zeit bis zur Lösung, und legen Sie sie dorthin, wo die verantwortliche Person sie in festem Takt prüft, nicht nur, wenn etwas kaputtgeht.
Versionieren Sie den Agent und steuern Sie Änderungen wie ein Produktionssystem
Die größte Quelle überraschender Ausfälle bei der Agent-Führung ist keine dramatische Fehlfunktion. Es ist eine stille Verhaltensverschiebung, die niemand als Änderung gemeldet hat, weil sie von außen nicht wie eine aussieht.
Behandeln Sie jede Änderung als Deployment
Eine Prompt-Änderung, eine ausgetauschte Modellversion, ein aktualisiertes Tool oder eine neue Datenquelle kann das Verhalten auf Weisen verschieben, die sich aus dem Diff allein schwer vorhersagen lassen. IBMs Forschung zu Agentic Drift benennt genau dieses Muster: ein Agent, der einen Schritt auslässt, den er früher zuverlässig ausführte, weil ein vorgelagertes Modell-Update veränderte, wie er Tempo gegen Gründlichkeit abwägt. Protokollieren Sie jede Änderung mit Zeitstempel und Beschreibung, damit sich eine Verschiebung auf eine Ursache zurückführen lässt, statt von Grund auf untersucht zu werden.
Lassen Sie das Regressionsset davor laufen, nicht danach
Halten Sie eine feste Menge repräsentativer Aufgaben vor, auch heikle, und lassen Sie sie gegen jede Version laufen, bevor Sie die Änderung breit ausrollen. Das folgt derselben Logik wie eine Regressionssuite in der Softwareentwicklung: günstig wiederholbar, und sie fängt den Fehler, bevor ein Kunde es tut.
Sichern Sie einen Rollback-Pfad
Wissen Sie im Voraus, wie Sie zur letzten bekannten guten Version zurückkehren, wenn eine Änderung schiefgeht: eine fixierte Modellversion, ein gespeicherter Prompt, ein Feature Flag. Das während eines laufenden Vorfalls zu entscheiden kostet Zeit, die Sie nicht haben. Agents in den Produktivbetrieb bringen sicher heißt, dass der Rollback-Plan vor dem ersten Deployment existiert, nicht nach dem ersten schlechten.
Planen Sie Kapazität so, wie Sie für ein wachsendes Team planen würden
Die Kapazität eines Agents ist weder unbegrenzt noch beliebig kostenlos skalierbar. Sie wird begrenzt durch API-Ratenlimits, Prüfkapazität, Budget und das Arbeitsvolumen, das die Menschen um ihn herum tatsächlich beaufsichtigen können.
Prognostizieren Sie gegen die Prüfkapazität, nicht nur gegen den Durchsatz
Der Agent könnte technisch das Zehnfache des aktuellen Aufgabenvolumens verarbeiten. Entscheidend ist, ob Ihre Prüfpersonen das Zehnfache an Eskalationen und Stichproben bewältigen können, das damit einhergeht. Kapazitätsplanung für einen Workflow, den ein Agent verantwortet, ist in Wahrheit Kapazitätsplanung für die Menschen, die ihn beaufsichtigen.
Prognostizieren Sie neu, wenn sich Verantwortungsbereich oder Modell ändern
Ein Kapazitätsplan, der um eine Modellversion, einen Verantwortungsbereich und einen Aufgabenmix herum gebaut ist, veraltet in dem Moment, in dem sich eines davon ändert. Überprüfen Sie ihn im selben Takt wie das Versionierungsprotokoll, da eine bessere Modellversion verändert, wie viel Prüfzeit jedes Ergebnis braucht.
Die Rechnung zur Personalstärke verschiebt sich, sie verschwindet nicht
Das 15-fache Jahreswachstum aktiver Agents in Microsoft 365 ging nicht mit einem entsprechenden Rückgang der Menschen einher, die diese Workflows führen. Es ging mit einer Verschiebung dessen einher, womit diese Menschen ihre Zeit verbringen: weniger Produktion, mehr Eingrenzen, Prüfen und Urteilen, der rote Faden von wie die Zukunft der Arbeit tatsächlich aussieht, sobald Agents mehr Ausführung übernehmen. Planen Sie die Personalstärke um diese Verschiebung herum, statt anzunehmen, dass Agent-Kapazität ein direkter Ersatz für einen Menschen ist.
Führen Sie die Kostenzeile wie ein Budget, nicht wie eine Überraschung
Agent-Kosten skalieren nicht so, wie die meisten erwarten. Eine einzelne Aufgabe kann viele Tool-Aufrufe, Wiederholungen und Denkschritte auslösen, sodass die Kosten pro Aufgabe stark schwanken können, selbst wenn die Preise pro Token sinken.
Kennen Sie Ihre echte Stückökonomie
Für die Planung zählen die Kosten pro Aufgabe, nicht pro Token, denn Orchestrierung, Wiederholungen und Tool-Aufrufe machen typischerweise einen großen Teil der Gesamtausgaben jenseits der Modellrechnung aus. Ermitteln Sie diese Zahl vor dem Skalieren als Benchmark, so wie Sie die Gesamtkosten einer Neueinstellung berechnen würden, nicht nur das Grundgehalt. Unter Taktiken zur Kostenoptimierung für KI-Agents finden Sie Wege, wie Teams diese Zahl senken, ohne die Qualität zu beschneiden.
Bauen Sie einen Sicherungsschalter in das Budget ein
Setzen Sie eine Kostenobergrenze pro Aufgabe und alarmieren Sie automatisch, wenn die Ausgaben sich ihr nähern, statt die Zahl erst am Ende eines Abrechnungszyklus zu entdecken. Das ist die praktische Antwort auf die Gartner-Prognose oben: Die meisten Kostenüberraschungen sind mit einem Budgetalarm vermeidbar, der Wochen früher auslöst.
Überprüfen Sie die Kosten im selben Takt gegen den Nutzen
Ein Workflow, dessen Automatisierung zu den Kosten des letzten Quartals sinnvoll war, erreicht die Hürde in diesem Quartal vielleicht nicht, oder deutlich besser, wenn ein günstigeres Modell einsetzbar wurde. Betrachten Sie Kosten, Qualität und Volumen gemeinsam, denn der billigste Agent, der unzuverlässige Ergebnisse liefert, ist nicht wirklich billig.
Häufig gestellte Fragen zur Führung von KI-Agents im Team
Was bedeutet es, einen KI-Agent in einem Team zu „führen“?
Dieselben Disziplinen anzuwenden, die eine Führungskraft bei jeder Teamressource anwendet: ein klar eingegrenzter Auftrag, ein prüfbarer Qualitätsmaßstab, eine gestaltete Übergabe an einen Menschen, überwachte Leistung, kontrollierte Versionierung, geplante Kapazität und eine verfolgte Kostenzeile. Es ist eine operative Aufgabe, keine kulturelle.
Wie unterscheidet sich die Führung eines Agents von der Führung eines Junior-Mitarbeiters?
Ein Agent liefert selbstsicheren, sauber formatierten Output, ob er stimmt oder nicht, und meldet seine eigene Unsicherheit nicht verlässlich. Qualitätsmaßstab, Eskalationsgestaltung und Prüfprozess müssen deshalb ausdrücklicher sein.
Was löst die Notwendigkeit aus, einen Agent neu zu versionieren oder neu zu testen?
Jede Änderung an Modellversion, Prompt, angebundenen Tools oder genutzten Datenquellen. Diese können das Verhalten auf nicht offensichtliche Weise verschieben, weshalb ein festes Regressionsset laufen sollte, bevor etwas breit ausgeliefert wird.
Wie sollte ein Eskalationsweg tatsächlich aussehen?
Eine gestufte Struktur nach Konfidenz und Umkehrbarkeit: vollständig autonom bei risikoarmen Aktionen, ein kurzes menschliches Einspruchsfenster bei Schreibaktionen mit mittlerem Risiko und verpflichtende aktive Freigabe bei nicht umkehrbaren oder folgenreichen Aktionen. Jede Stufe braucht eine benannte, erreichbare verantwortliche Person mit definierter Reaktionszeit, keine geteilte Warteschlange.
Wie plant man die Kapazität für ein Team, zu dem KI-Agents gehören?
Prognostizieren Sie das Volumen gegen die Prüfkapazität Ihrer Menschen, nicht nur gegen den reinen Durchsatz des Agents, da die Aufsichtskapazität weit langsamer wächst als die Agent-Kapazität. Prognostizieren Sie neu, wann immer sich Verantwortungsbereich oder zugrunde liegendes Modell des Agents ändern.
Warum schwanken die Agent-Kosten so stark, obwohl die Modellpreise sinken?
Weil die Kosten pro Aufgabe stark von Tool-Aufrufen, Wiederholungen und mehrstufigem Schlussfolgern abhängen, nicht nur vom Preis pro Token. Ein großer Teil der Gesamtkosten liegt in der Orchestrierung außerhalb der Modellrechnung, weshalb die Kosten pro Aufgabe, verfolgt gegen eine Budgetobergrenze, wichtiger sind als der Listenpreis.
Nichts davon ist exotisch. Es ist dieselbe Disziplin, die auf jede Ressource angewendet wird, die Arbeit unter Ihrem Namen erzeugt: den Auftrag definieren, den Maßstab setzen, die Übergabe gestalten, die Erfolgsbilanz beobachten, wissen, was es kostet. Die Teams, die 2026 echten Nutzen aus Agents ziehen, betreiben nicht das ausgefeilteste Modell. Sie haben dieses Handbuch aufgeschrieben, bevor sie es brauchten, statt es während des ersten Vorfalls zu improvisieren.

Co-Founder, Rework.com
On this page
- Wichtige Fakten
- Beginnen Sie damit, festzulegen, wofür der Agent tatsächlich zuständig ist
- Schreiben Sie den Verantwortungsbereich wie eine Stellenbeschreibung
- Ziehen Sie die Grenze der Befugnis
- Bemessen Sie den Verantwortungsbereich so, dass er prüfbar bleibt
- Setzen Sie Qualitätsmaßstab und Abnahmekriterien vor dem ersten Tag
- Machen Sie „richtig“ prüfbar
- Orientieren Sie sich an QA, nicht an Bauchgefühl
- Setzen Sie eine Konfidenzschwelle, nicht nur bestanden oder nicht bestanden
- Gestalten Sie die Übergabe zwischen Agent und Mensch bewusst
- Benennen Sie die Übergabepunkte, bevor der Agent läuft
- Nutzen Sie die Verantwortungsmatrix, um Zuständigkeiten zuzuweisen
- Machen Sie die menschliche Seite günstig
- Bauen Sie Eskalationswege, die Menschen wirklich nutzen
- Staffeln Sie die Eskalation nach Konfidenz und Umkehrbarkeit
- Geben Sie dem Agent eine echte „Ich weiß es nicht“-Option
- Leiten Sie an eine konkrete Person, nicht an eine Warteschlange
- Überwachen und beobachten Sie den Agent wie ein System, nicht wie ein Werkzeug
- Verfolgen Sie das Verhalten, nicht nur die Verfügbarkeit
- Protokollieren Sie genug, um zu rekonstruieren, was geschah
- Richten Sie ein Dashboard ein, das jemand tatsächlich öffnet
- Versionieren Sie den Agent und steuern Sie Änderungen wie ein Produktionssystem
- Behandeln Sie jede Änderung als Deployment
- Lassen Sie das Regressionsset davor laufen, nicht danach
- Sichern Sie einen Rollback-Pfad
- Planen Sie Kapazität so, wie Sie für ein wachsendes Team planen würden
- Prognostizieren Sie gegen die Prüfkapazität, nicht nur gegen den Durchsatz
- Prognostizieren Sie neu, wenn sich Verantwortungsbereich oder Modell ändern
- Die Rechnung zur Personalstärke verschiebt sich, sie verschwindet nicht
- Führen Sie die Kostenzeile wie ein Budget, nicht wie eine Überraschung
- Kennen Sie Ihre echte Stückökonomie
- Bauen Sie einen Sicherungsschalter in das Budget ein
- Überprüfen Sie die Kosten im selben Takt gegen den Nutzen