Como Gerenciar Agentes de IA como Parte da Equipe: Um Manual de Operação
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
Gerenciar um agente de IA como parte de uma equipe significa tratá-lo como uma fonte de capacidade com escopo definido, um padrão de qualidade mensurável, uma passagem explícita para um humano, um histórico monitorado e uma linha de custo, as mesmas disciplinas que um gestor aplica a qualquer recurso que produz trabalho em nome da equipe. A frontier firm e o agent boss trata da mudança cultural; este texto trata da mecânica que está por baixo dela.
A maioria das equipes pula direto para "dar uma tarefa ao agente" e descobre do pior jeito que ninguém definiu como é o "pronto", quem é acionado quando ele erra ou o que acontece na semana em que o modelo passa a raciocinar de outro jeito, sem avisar. Este é o manual para fazer isso na ordem certa.
Fatos principais
- Quando os gestores usaram a IA de forma ativa e visível, os colaboradores relataram um aumento de 17 pontos no valor percebido da IA, de 22 pontos no pensamento crítico sobre o próprio uso de IA e de 30 pontos na confiança em IA agêntica, em um estudo liderado pela Microsoft com 1.800 trabalhadores. Fonte: Microsoft, 2026 Work Trend Index
- Quando os gestores criaram segurança psicológica para a experimentação, os colaboradores relataram até 20 pontos a mais de prontidão para a IA e tinham 1,4 vez mais chances de ser usuários frequentes de IA agêntica. Fatores organizacionais respondem por 67% do impacto da IA, cerca do dobro do comportamento individual. Fonte: Microsoft, 2026 Work Trend Index
- Os agentes ativos dentro do Microsoft 365 cresceram 15 vezes em relação ao ano anterior, chegando a 18 vezes em grandes empresas. Fonte: Microsoft, 2026 Work Trend Index
- O custo de uma interação complexa e orquestrada de agentes subiu de cerca de $0,04 em 2023 para cerca de $1,20 em 2026, um aumento de quase 30 vezes, impulsionado principalmente por chamadas de ferramentas e novas tentativas, e não pelo preço bruto do modelo. Fonte: EY, "Agentic AI Enterprise Token Cost"
- A Gartner projeta que mais de 40% dos projetos de IA agêntica serão cancelados até o fim de 2027 por custos crescentes, valor de negócio pouco claro ou controles de risco inadequados. Fonte: EY, "Agentic AI Enterprise Token Cost"
- O agentic drift, a degradação gradual do comportamento de um agente, costuma ser desencadeado por atualizações do modelo, mudanças nos dados que ele consulta ou alterações no contexto de negócio, e não por uma única falha dramática. Fonte: IBM, "The Hidden Risk That Degrades AI Agent Performance"
Comece Definindo o Que o Agente Realmente Assume
A falha mais comum no gerenciamento de agentes é pular esta etapa. Uma equipe dá ao agente um mandato amplo, "cuidar dos e-mails de onboarding de clientes", e descobre semanas depois que ninguém combinou o que "cuidar" significa, e o agente está redigindo respostas a disputas de cobrança que nunca deveria tocar.
Escreva o escopo como uma descrição de cargo
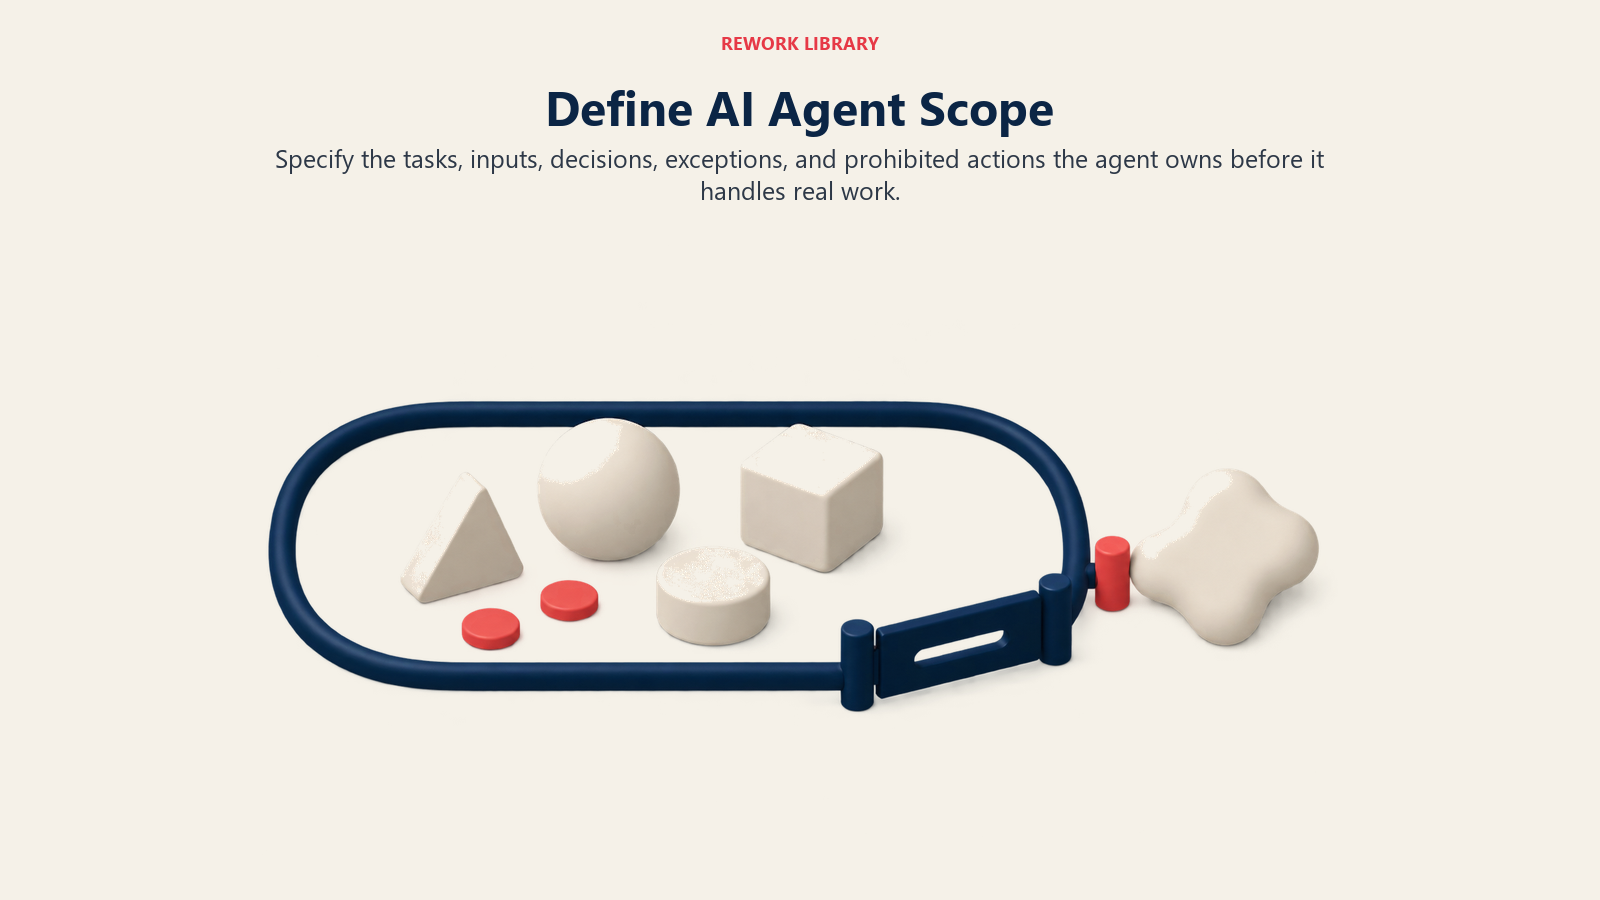
Uma lista de funcionalidades descreve o que o agente consegue fazer tecnicamente. Um escopo descreve aquilo de que ele é responsável: as etapas do workflow que assume de ponta a ponta, as entradas sobre as quais age e as saídas pelas quais responde. Se você não consegue escrever uma descrição de cargo de um parágrafo para ele, como faria para uma nova contratação, o escopo não está fechado o suficiente para ser delegado.
Trace o limite da autoridade
Todo escopo precisa de uma lista companheira do que o agente não pode decidir sozinho: alterar um preço, encerrar um ticket sem um código de resolução, enviar uma mensagem acima de certo tamanho ou público. Esse é o limite prático de onde a automação deve substituir uma etapa e onde deve apenas auxiliar, registrado por escrito como se dá a uma pessoa recém-contratada um limite de gastos antes de lhe entregar o cartão corporativo. Os guardrails tornam o limite aplicável no código, e não numa política que ninguém relê.
Dimensione o escopo para algo revisável
Amplo demais, e nenhum humano consegue conferir de forma significativa dez julgamentos diferentes ao mesmo tempo. Estreito demais, e desperdiça a capacidade do agente enquanto enterra o gestor em passagens de bastão. O tamanho certo permite que uma pessoa olhe dez saídas e diga com credibilidade se o agente está fazendo bem o trabalho.
Defina o Padrão de Qualidade e os Critérios de Aceitação Antes do Primeiro Dia
"Bom o suficiente" não pode ser um julgamento feito depois do fato, ou toda revisão vira um debate sobre um alvo móvel. O padrão precisa existir, por escrito, antes de o agente produzir sua primeira saída real.
Torne o "correto" verificável
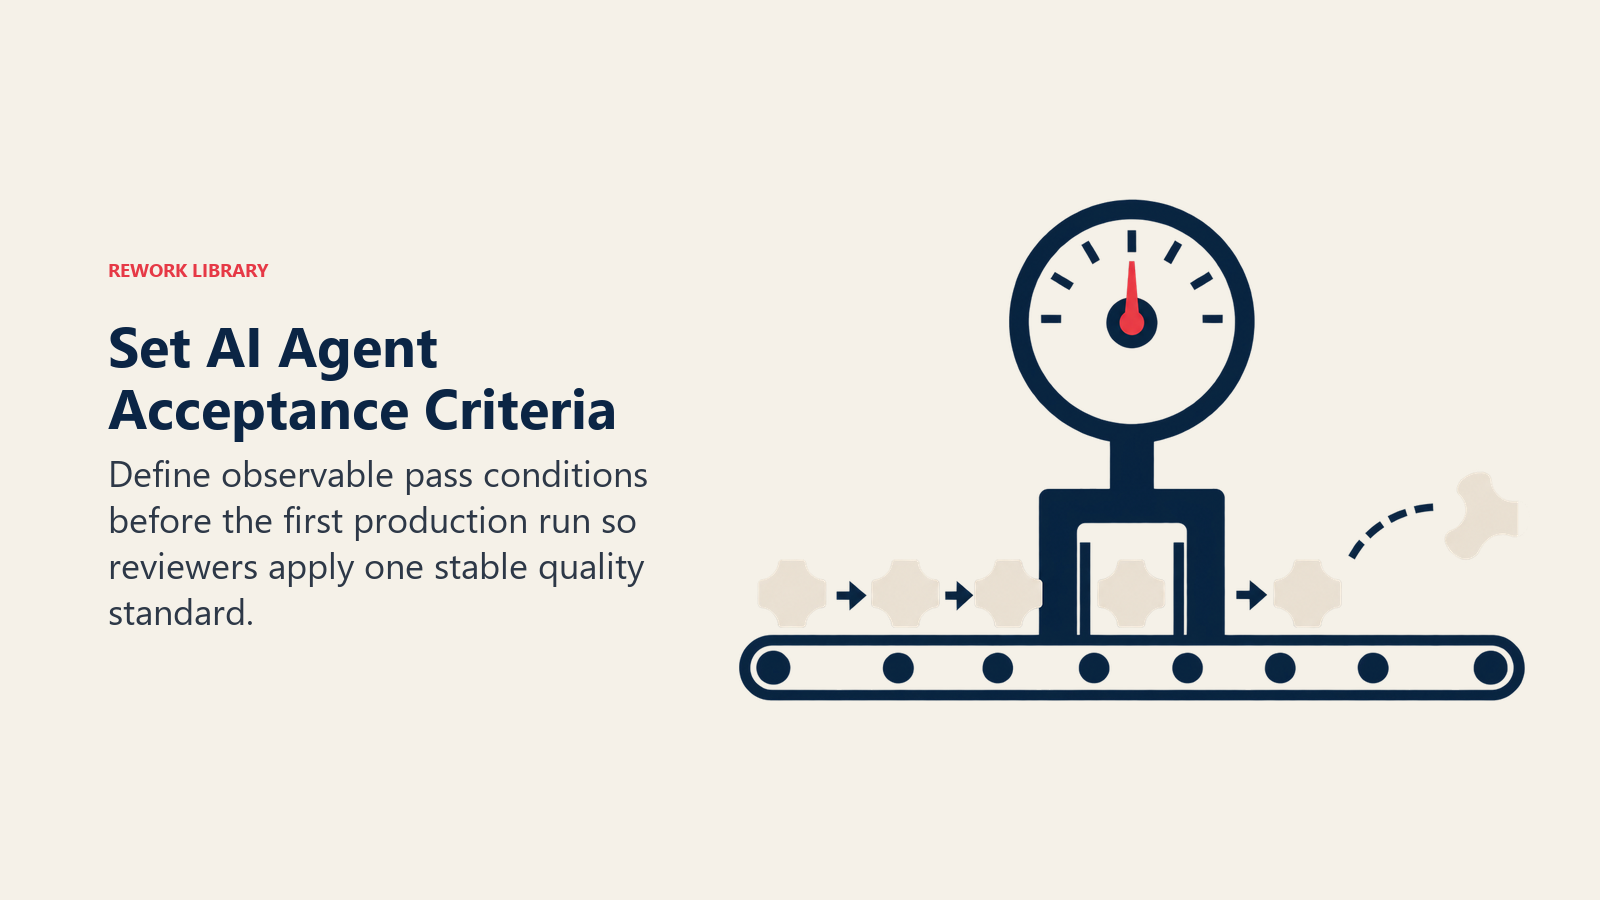
Os critérios de aceitação devem ser específicos o bastante para que uma segunda pessoa, ou uma segunda execução do agente, possa conferir o trabalho pelo mesmo critério sem perguntar o que você quis dizer. "Soa profissional" não é um critério. "Segue os templates aprovados, inclui o número da conta e sinaliza qualquer solicitação acima de $500" é. A mudança de executor a orquestrador se aplica diretamente: escrever um briefing verificável agora é uma habilidade central de gestão.
Inspire-se em QA, não em intuição
Trate a saída do agente como uma equipe de QA trata uma versão candidata: defina um pequeno conjunto de casos de teste que cubra a variedade de situações que ele enfrentará, incluindo alguns deliberadamente difíceis, e execute as novas versões contra esse conjunto antes de liberá-las de forma mais ampla. A pesquisa da IBM sobre agentic drift defende perguntar se uma saída está correta em relação à intenção, e não se ela coincide palavra por palavra com uma referência, já que duas execuções podem ser redigidas de forma diferente e ambas estarem certas.
Defina um limiar de confiança, não apenas aprovado ou reprovado
Algumas saídas estão claramente certas ou erradas. Muitas não. Construa o padrão em torno de um limiar de confiança: abaixo dele, a saída é encaminhada automaticamente para revisão; acima dele, é liberada. Esse limiar é também a espinha dorsal do desenho de escalonamento abaixo.
Desenhe de Propósito a Passagem de Bastão entre Agente e Humano
Uma passagem de bastão que não é desenhada de propósito é desenhada por acidente, em geral como a mensagem de Slack que alguém mandou na primeira vez que algo deu errado. Isso é um hábito, não um processo, e hábitos não escalam além da pessoa que os começou.
Nomeie os pontos de passagem antes de o agente rodar
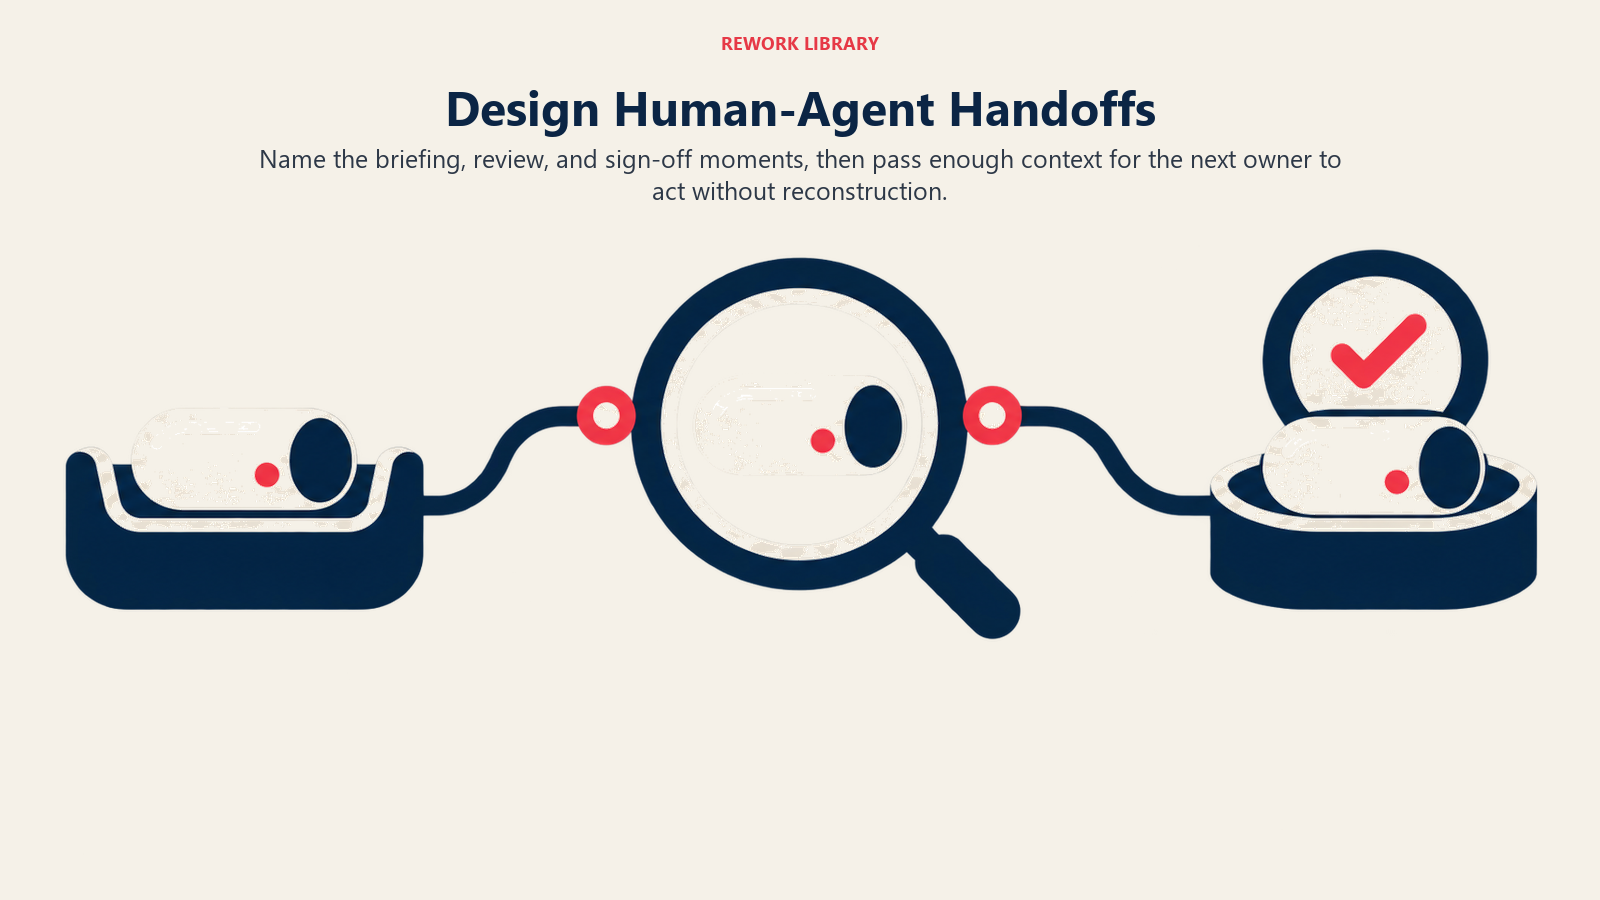
Três momentos se repetem em quase todo workflow assumido por um agente: antes de ele começar, no meio da tarefa se atingir o limiar de confiança ou o limite de escopo, e depois de terminar, quando alguém revisa, aprova ou corrige a saída. Cada um precisa de um responsável, um canal e uma expectativa de tempo de resposta, como em qualquer passagem entre dois papéis humanos.
Use a matriz de responsabilidades para atribuir a titularidade
A tabela abaixo é um template inicial. Copie-a, preencha com os nomes e ferramentas da sua equipe e revise-a sempre que o escopo do agente mudar.
| Responsabilidade de agent-ops | O que significa na prática | Quem é o responsável |
|---|---|---|
| Definir o escopo do trabalho do agente | Escrever o mandato de um parágrafo e a lista explícita do que "não é permitido" | Líder da equipe ou dono do processo |
| Definir o padrão de qualidade | Estabelecer critérios de aceitação verificáveis e o limiar de confiança para liberar automaticamente vs. revisar | Líder da equipe, com um revisor especialista no assunto |
| Desenho da passagem de bastão | Nomear os pontos de passagem antes, durante e depois da tarefa, os canais e os tempos de resposta | Líder de operações ou dono do workflow |
| Roteamento de escalonamento | Decidir quem é acionado para uma saída de baixa confiança vs. uma violação de escopo vs. uma falha de sistema | Gestor de plantão ou revisor designado |
| Monitoramento e observabilidade | Acompanhar taxa de sucesso das tarefas, latência, custo por tarefa e taxa de escalonamento em um dashboard que alguém abre | Quem é dono da ferramenta em que o agente roda |
| Versionamento e controle de mudanças | Registrar toda mudança de prompt, ferramenta ou modelo e rodar o conjunto de regressão antes de uma liberação mais ampla | Engenharia ou o dono da plataforma de IA |
| Planejamento de capacidade | Prever o volume de tarefas e definir limites de vazão em relação à capacidade de revisão humana | Líder da equipe, com revisão mensal |
| Custo e orçamento | Acompanhar o custo por tarefa contra um teto definido e sinalizar quando o gasto superar o valor | Parceiro de finanças ou o líder da equipe com autoridade orçamentária |
| Resposta a incidentes | Executar o playbook quando o agente falha gravemente: pausar, notificar, achar a causa raiz, corrigir, retomar | Gestor de plantão |
| Descomissionamento | Decidir quando um escopo deixa de valer o custo de manutenção e aposentá-lo ou reduzi-lo | Líder da equipe, revisado trimestralmente |
Torne barato o lado humano
Uma passagem de bastão que leva quinze minutos para o revisor abrir e agir é ignorada sob pressão de prazo, por mais bem desenhada que pareça no papel. Incorpore-a à ferramenta que o revisor já usa, com a pontuação de confiança do agente, o ponto específico sobre o qual ele tem dúvida e aprovação ou rejeição com um clique. Se revisar um escalonamento é mais difícil do que refazer a tarefa à mão, as pessoas deixam de confiar no agente em silêncio, a mesma questão de confiança com que as equipes humano-agente esbarram o tempo todo.
Crie Caminhos de Escalonamento que as Pessoas Realmente Usem
Os caminhos de escalonamento falham em uma de duas direções: sensíveis demais, de modo que os humanos são acionados o tempo todo e passam a ignorar os alertas; ou permissivos demais, de modo que o agente contorna um problema em vez de levantá-lo, e ninguém descobre até a saída já estar errada em produção.
Organize o escalonamento em camadas por confiança e reversibilidade
Uma estrutura em camadas se encaixa na maioria dos workflows de equipe: totalmente autônoma para ações de baixo risco e reversíveis, como leituras; supervisionada, com uma janela curta de veto, para escritas de risco médio, como enviar uma mensagem; e com gate, exigindo aprovação ativa, para ações irreversíveis, como exclusões, pagamentos ou qualquer coisa que toque um contrato de cliente. Defina os limiares de cada camada com base no custo real de um erro no seu workflow, e não num número copiado do post de blog de outra pessoa.
Dê ao agente uma opção real de "não sei"
Um agente que sempre soa confiante, mesmo quando não deveria, é mais perigoso do que um que trava, pois uma tarefa travada é notada e uma errada muitas vezes não. Inclua "escalar para um humano" entre as saídas válidas dele e trate um escalonamento honesto como um sucesso. As equipes que penalizam em silêncio a taxa de escalonamento como se fosse taxa de erro treinam seus agentes, e suas pessoas, a parar de levantar a mão.
Encaminhe para uma pessoa específica, não para uma fila
Uma fila compartilhada sem dono é onde os escalonamentos vão morrer. Cada camada deve corresponder a um papel nomeado, com tempo de resposta definido, como funciona um rodízio de plantão numa queda de produção. O desenho de human-in-the-loop só se sustenta se houver um humano específico e acessível nesse ciclo.
Monitore e Observe o Agente como um Sistema, Não como uma Ferramenta
Uma ferramenta você confere quando algo parece errado. Um sistema você acompanha continuamente, porque, quando algo parece errado a olho nu, em geral já estava errado havia algum tempo.
Acompanhe o comportamento, não apenas a disponibilidade
O monitoramento tradicional de disponibilidade diz que o agente está rodando. Não diz que está certo. A observabilidade de agentes precisa cobrir a saúde do sistema (disponibilidade, latência, taxa de erro) e a saúde comportamental (taxa de sucesso das tarefas, taxa de escalonamento, desvio em relação a uma linha de base sabidamente boa). Um agente que responde de imediato e com confiança enquanto, em silêncio, vai errando mais com o tempo passa em todas as verificações de disponibilidade e falha com todos os usuários que dependeram dele, o mesmo risco de viés de automação tratado em como manter o julgamento humano afiado.
Registre o bastante para reconstruir o que aconteceu
Quando uma saída está errada, a pergunta que importa não é só "estava errada?", é "por quê?", e isso exige um rastro: as entradas, as chamadas de ferramentas e seus parâmetros, e o raciocínio por trás da saída. Sem isso, toda revisão de incidente vira adivinhação, e a mesma falha se repete em silêncio.
Monte um dashboard que alguém realmente abra
Um dashboard que ninguém olha é decoração, não monitoramento. Escolha um número pequeno de métricas que correspondam às responsabilidades da tabela acima, custo por tarefa, taxa de sucesso, taxa de escalonamento, tempo até a resolução, e coloque-as onde a pessoa responsável as confira em cadência fixa, e não só quando algo quebra.
Versione o Agente e Controle as Mudanças como um Sistema de Produção
A maior fonte de falhas surpresa no gerenciamento de agentes não é um mau funcionamento dramático. É uma mudança silenciosa de comportamento que ninguém sinalizou como mudança, porque, vista de fora, não parece uma.
Trate cada mudança como um deploy
Uma edição de prompt, uma troca de versão do modelo, uma ferramenta atualizada ou uma nova fonte de dados podem mudar o comportamento de formas difíceis de prever só pelo diff. A pesquisa da IBM sobre agentic drift nomeia exatamente esse padrão: um agente que pula uma etapa que antes executava sem falhas porque uma atualização do modelo de base mudou como ele pondera velocidade contra rigor. Registre toda mudança com data e hora e uma descrição, para que uma alteração de comportamento possa ser rastreada até uma causa em vez de ser investigada do zero.
Rode o conjunto de regressão antes, não depois
Mantenha um conjunto fixo de tarefas representativas, incluindo as complicadas, e execute-o contra cada versão antes de liberar a mudança de forma ampla. É a mesma lógica de uma suíte de regressão em software: barata de rodar repetidamente e captura a falha antes que um cliente o faça.
Congele um caminho de reversão
Saiba de antemão como você voltaria à última versão sabidamente boa se uma mudança desse errado: uma versão de modelo fixada, um prompt salvo, uma feature flag. Decidir isso durante um incidente em andamento custa um tempo que você não tem. Colocar agentes em produção com segurança significa que o plano de reversão existe antes do primeiro deploy, e não depois do primeiro ruim.
Planeje a Capacidade como Planejaria para uma Equipe em Crescimento
A capacidade de um agente não é infinita nem escalável sob demanda de graça. Ela é limitada por limites de taxa de API, capacidade de revisão, orçamento e o volume de trabalho que os humanos ao redor conseguem de fato supervisionar.
Preveja com base na capacidade de revisão, não apenas na vazão
O agente pode processar tecnicamente dez vezes o volume atual de tarefas. O que importa é se seus revisores aguentam dez vezes os escalonamentos e as checagens por amostragem que vêm com isso. O planejamento de capacidade de um workflow assumido por um agente é, na verdade, o planejamento de capacidade dos humanos que o supervisionam.
Refaça a previsão quando o escopo ou o modelo mudar
Um plano de capacidade construído em torno de uma versão de modelo, um escopo e uma combinação de tarefas fica obsoleto no instante em que qualquer um desses muda. Revise-o na mesma cadência do registro de versionamento, já que uma versão melhor do modelo muda quanto tempo de revisão cada saída exige.
As contas de quadro de pessoal mudam, não desaparecem
O crescimento de 15 vezes ano a ano dos agentes ativos dentro do Microsoft 365 não veio acompanhado de uma queda equivalente no número de humanos que gerenciam esses workflows. Veio acompanhado de uma mudança no que esses humanos fazem com o tempo: menos produção, mais definição de escopo, revisão e julgamento, o fio condutor de como é, de fato, o futuro do trabalho quando os agentes assumem mais da execução. Planeje o quadro de pessoal em torno dessa mudança, em vez de supor que a capacidade de um agente substitui uma pessoa na proporção de um para um.
Gerencie a Linha de Custo como um Orçamento, Não como uma Surpresa
O custo de agentes não escala do jeito que a maioria espera. Uma única tarefa pode disparar muitas chamadas de ferramentas, novas tentativas e etapas de raciocínio, de modo que o custo por tarefa pode variar bruscamente mesmo com a queda dos preços por token dos modelos.
Conheça a sua economia unitária real
O custo por tarefa, e não o custo por token, é o que importa para o planejamento, já que a orquestração, as novas tentativas e as chamadas de ferramentas costumam representar uma grande parte do gasto total além da fatura do modelo. Faça o benchmark desse número antes de escalar, como você calcularia o custo total de uma nova contratação, e não só o salário-base. Veja as táticas de otimização de custos para agentes de IA para formas de as equipes reduzirem esse número sem cortar a qualidade.
Coloque um disjuntor no orçamento
Defina um teto de custo por tarefa e dispare um alerta automático quando o gasto se aproximar dele, em vez de descobrir o número no fim do ciclo de cobrança. Essa é a resposta prática à projeção da Gartner acima: a maioria das surpresas de custo é evitável com um alerta de orçamento que dispara semanas antes.
Revise o custo contra o valor na mesma cadência
Um workflow que fazia sentido automatizar ao custo do trimestre passado pode não passar do limite neste trimestre, ou passar com folga se um modelo mais barato se tornar viável. Revise custo, qualidade e volume em conjunto, já que o agente mais barato que produz uma saída pouco confiável não é, de fato, barato.
Nada disso é exótico. É a mesma disciplina aplicada a qualquer recurso que produz trabalho em seu nome: definir a tarefa, estabelecer o padrão, desenhar a passagem de bastão, acompanhar o histórico, saber quanto custa. As equipes que extraem valor real dos agentes em 2026 não são as que rodam o modelo mais sofisticado. São as que escreveram este manual antes de precisar dele, em vez de improvisá-lo durante o primeiro incidente.

Co-Founder, Rework.com
On this page
- Fatos principais
- Comece Definindo o Que o Agente Realmente Assume
- Escreva o escopo como uma descrição de cargo
- Trace o limite da autoridade
- Dimensione o escopo para algo revisável
- Defina o Padrão de Qualidade e os Critérios de Aceitação Antes do Primeiro Dia
- Torne o "correto" verificável
- Inspire-se em QA, não em intuição
- Defina um limiar de confiança, não apenas aprovado ou reprovado
- Desenhe de Propósito a Passagem de Bastão entre Agente e Humano
- Nomeie os pontos de passagem antes de o agente rodar
- Use a matriz de responsabilidades para atribuir a titularidade
- Torne barato o lado humano
- Crie Caminhos de Escalonamento que as Pessoas Realmente Usem
- Organize o escalonamento em camadas por confiança e reversibilidade
- Dê ao agente uma opção real de "não sei"
- Encaminhe para uma pessoa específica, não para uma fila
- Monitore e Observe o Agente como um Sistema, Não como uma Ferramenta
- Acompanhe o comportamento, não apenas a disponibilidade
- Registre o bastante para reconstruir o que aconteceu
- Monte um dashboard que alguém realmente abra
- Versione o Agente e Controle as Mudanças como um Sistema de Produção
- Trate cada mudança como um deploy
- Rode o conjunto de regressão antes, não depois
- Congele um caminho de reversão
- Planeje a Capacidade como Planejaria para uma Equipe em Crescimento
- Preveja com base na capacidade de revisão, não apenas na vazão
- Refaça a previsão quando o escopo ou o modelo mudar
- As contas de quadro de pessoal mudam, não desaparecem
- Gerencie a Linha de Custo como um Orçamento, Não como uma Surpresa
- Conheça a sua economia unitária real
- Coloque um disjuntor no orçamento
- Revise o custo contra o valor na mesma cadência