Vertrauen, wenn Ihr Teammitglied eine KI ist
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
Einem KI-Teammitglied zu vertrauen heißt, das Maß, in dem Sie sich auf seinen Output verlassen, an Belegen dafür auszurichten, wie zuverlässig es bei einer bestimmten Aufgabe tatsächlich ist, und nicht daran, wie selbstsicher es klingt. Das ist eine andere Fähigkeit, als einer Kollegin zu vertrauen, denn eine KI hat keine Täuschungsabsicht und keine Karriere, die auf dem Spiel steht, wenn sie falsch liegt, wodurch die beiden Signale wegfallen, mit denen Menschen normalerweise entscheiden, wem sie glauben.
Die meisten Ratschläge zum „Vertrauen in KI“ springen direkt zur Richtlinie: eine Nutzungsleitlinie schreiben, eine Offenlegungsregel ergänzen, fertig. Das ist nötig, aber nicht der schwierige Teil. Vertrauen zu einem menschlichen und zu einem KI-Teammitglied folgt fast völlig verschiedenen Mechaniken, und Teams, die den Unterschied übersehen, landen in einem von zwei kostspieligen Fehlermustern: im Stillen alles neu zu machen, was die KI angefasst hat, oder Output abzustempeln, der sich als selbstsicher falsch erweist. Dieser Artikel behandelt, warum die Mechaniken sich unterscheiden, beide Fehlermuster mit der Forschung dazu, wie kalibriertes Vertrauen in der Praxis aussieht, was es tatsächlich aufbaut und welche Teamnormen es dauerhaft machen.
Warum Vertrauen in eine KI ein anderes Problem ist als Vertrauen in einen Menschen
Menschliches Vertrauen ruht auf einem einfachen, gut erforschten Fundament: Sie beobachten die Fähigkeit eines Menschen, seine Integrität und ob er sich offenbar um Ihre Interessen sorgt (Wohlwollen), über genug Situationen hinweg, dass sich ein Muster abzeichnet. Dieses Modell behandeln wir ausführlich in wie Sie Vertrauen am Arbeitsplatz aufbauen. Der Mechanismus funktioniert, weil ein Mensch Absichten hat: Er kann sich entscheiden, Sie zu täuschen, und die Möglichkeit, ertappt zu werden, also ein Reputationsschaden, hält die meisten Menschen ehrlich.
Ein KI-System hat keinen der beiden Teile dieses Mechanismus. Es beabsichtigt nicht, Sie in die Irre zu führen, wenn es falsch liegt, und es hat keine Reputation zu schützen und keine Karriere auf dem Spiel. Das ist kein moralisches Versagen, es ist schlicht ein anderer Systemtyp, aber es bedeutet, dass die Abkürzungen, mit denen Menschen normalerweise entscheiden, wem sie vertrauen (meint diese Person es gut, hat sie etwas zu verlieren, wenn sie nicht liefert), schlicht nicht greifen. Sie bewerten etwas, das eher einem Messinstrument gleicht als einer Kollegin: Wie genau ist es, unter welchen Bedingungen, und woran merken Sie, wenn es abgedriftet ist?
Selbstsicher und falsch sieht genauso aus wie selbstsicher und richtig
Das schärfere Problem ist die Darstellung. Ein Mensch, der sich einer Antwort nicht sicher ist, signalisiert das meist durch Zögern, Tonfall oder Körpersprache. Ein großes Sprachmodell liefert eine erfundene Quellenangabe, eine falsche Zahl oder ein erfundenes Zitat im exakt gleichen flüssigen, sicheren Register wie eine korrekte Antwort. Das ist die Kernmechanik hinter KI-Halluzination: Das System lügt nicht, es erzeugt plausiblen Text, und plausibel und wahr sind nicht dieselbe Eigenschaft. Nichts daran, wie selbstsicher der Output klingt, verrät Ihnen, was von beidem Sie vor sich haben.
Diese eine Tatsache ist der Grund, warum sich Vertrauen in KI nicht einfach aus Vertrauen in Menschen ableiten lässt. Sie brauchen externe Signale, Belege aus Tests, eine Erfolgsbilanz bei einer bestimmten Aufgabe, prüfbare Quellen, weil das innere Signal, das Menschen instinktiv als Zeichen von Sicherheit lesen, von tatsächlicher Zuverlässigkeit entkoppelt wurde.
Die zwei Fehlermuster: Untervertrauen und Übervertrauen
Teams ohne bewussten Ansatz landen nicht in der Mitte. Sie schwingen an eines von zwei Extremen, und beide sind auf unterschiedliche Weise teuer.
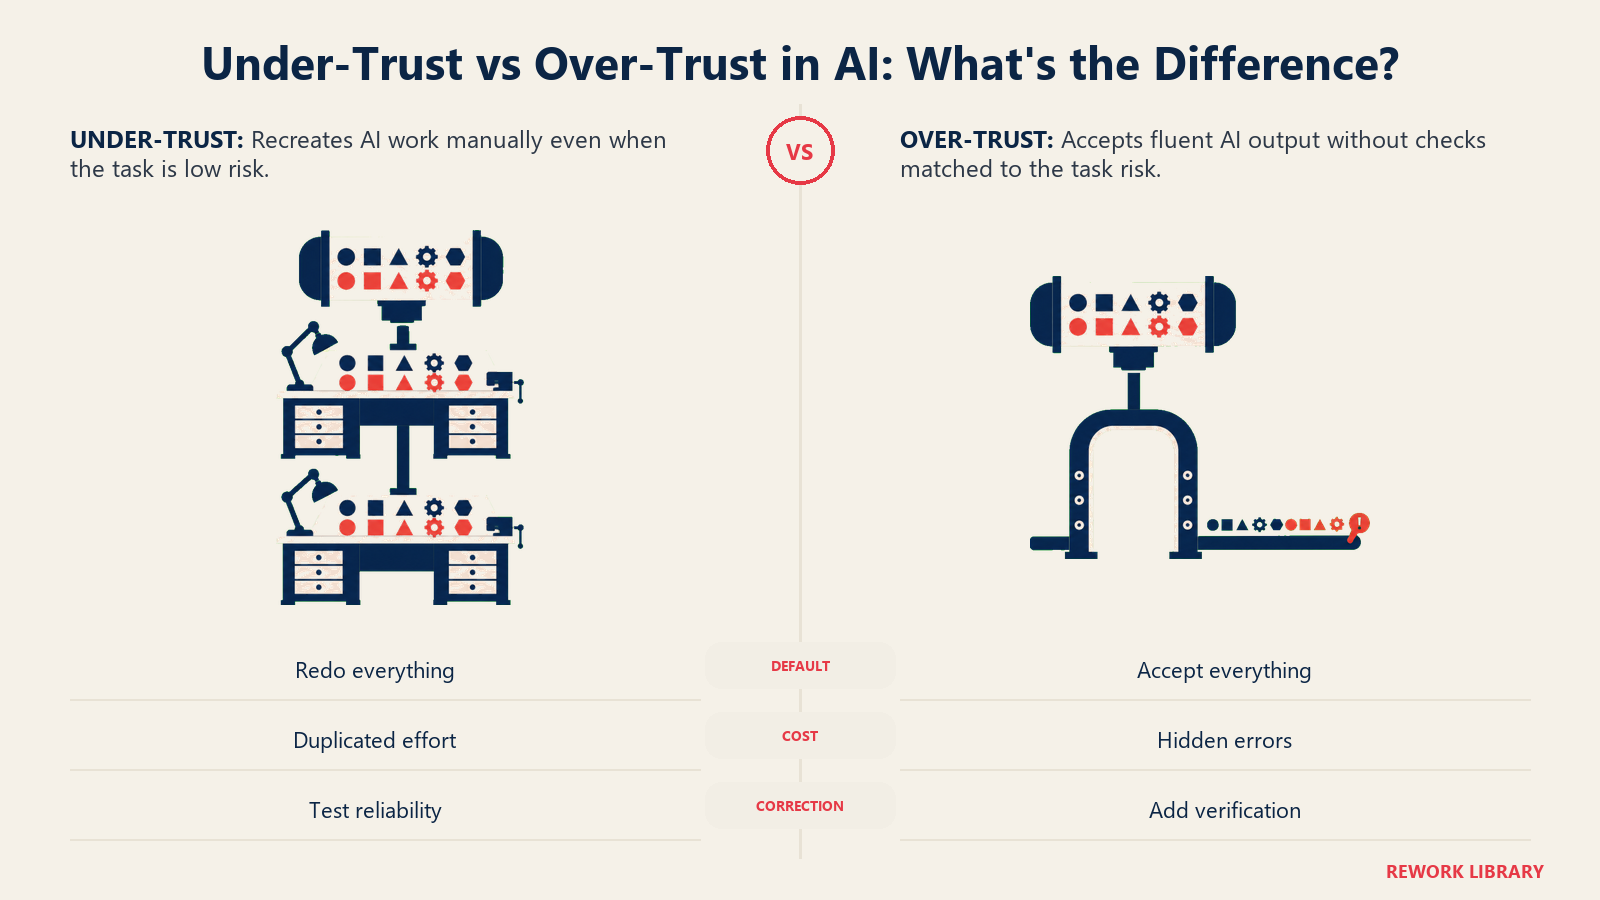
Untervertrauen: Die Arbeit des Agenten von Hand wiederholen
Untervertrauen wirkt an der Oberfläche verantwortungsvoll. Eine Führungskraft prüft jede Zeile, die ein Agent liefert, mit derselben Strenge, als traute sie dem System überhaupt nicht, und macht die Arbeit damit praktisch doppelt. Das vernichtet den Produktivitätsgewinn, den die KI bringen sollte. Wenn das Prüfen eines Entwurfs so lange dauert wie das Schreiben von Grund auf, hat die Organisation ein Tool hinzugefügt, ohne ihren Output zu verändern, und wer die Doppelprüfung übernimmt, brennt irgendwann aus oder hört im Stillen auf, was das Übervertrauensproblem nur verschiebt, statt es zu lösen.
Untervertrauen zeigt sich am stärksten in Teams, die eine schlechte frühe Erfahrung mit einem KI-Tool gemacht und sie nie überprüft haben. Eine einzige peinliche halluzinierte Tatsache in einer Kundenpräsentation kann die Bereitschaft eines Teams, sich auf KI-Output zu verlassen, ein Jahr lang einfrieren, selbst nachdem sich das Tool verbessert hat.
Übervertrauen: Automation Bias und der Preis des ausgelassenen Checks
Übervertrauen, oder Automation Bias, ist die Neigung, dem Output eines automatisierten Systems mehr Gewicht zu geben, als die Belege hergeben, und mit dem Überprüfen aufzuhören, sobald ein System ein paarmal richtig lag. Es ist eines der am besten dokumentierten Fehlermuster der Forschung zu Mensch und Automatisierung, zurückreichend auf Jahrzehnte von Studien aus Luftfahrt und Sicherheitstechnik, und es wird mit besseren KI-Systemen schlimmer, nicht besser, denn ein System, das zu 95 % richtig liegt, ist selbstsicher genug, dass Menschen bei den übrigen 5 % nicht mehr nachsehen.
Eine Studie von 2023 in der Fachzeitschrift Radiology beziffert, wie gravierend das werden kann. Forschende ließen 27 Radiologinnen und Radiologen 50 Mammografien beurteilen, manche mit einem BI-RADS-Klassifikationsvorschlag eines KI-Systems. Wenn der Vorschlag der KI falsch war, brach die Genauigkeit bei weniger erfahrenen Radiologen von etwa 80 % auf unter 20 % ein. Auch Radiologen mit mehr als 15 Jahren Erfahrung waren nicht immun: Ihre Genauigkeit fiel von 82 % auf 45,5 %. Erfahrung minderte den Schaden. Beseitigt hat sie ihn bei Weitem nicht.
Das ist ein klinischer Rahmen, doch der Mechanismus zeigt sich auch in gewöhnlicher Wissensarbeit unter einem harmloseren Namen: Workslop. Eine Umfrage von BetterUp Labs und dem Social Media Lab der Stanford University unter 1.150 US-Vollzeitbeschäftigten im September 2025 ergab, dass 40 % im Monat davor „Workslop“ erhalten hatten, KI-generierte Inhalte, die gepflegt aussehen, aber nicht genug Substanz haben, um eine Aufgabe voranzubringen. Jeder Fall kostete im Schnitt zwei Stunden Klärung, geschätzt 186 \(pro Beschäftigtem und Monat, bei einem Unternehmen mit 10.000 Beschäftigten also rund 9 Mio.\) pro Jahr. Workslop ist Übervertrauen in der Praxis: Jemand hat den Entwurf eines Agenten für bare Münze genommen, weitergereicht und die eigentliche Prüfung dem Nächsten überlassen.
Wichtige Fakten
- Die Genauigkeit von Radiologen bei der Beurteilung von Mammografien sank bei weniger erfahrenen Befundern von etwa 80 % auf unter 20 % und bei Befundern mit 15+ Jahren Erfahrung von 82 % auf 45,5 %, wenn der Vorschlag eines KI-Systems falsch war, in einer Studie mit 27 Radiologen, die 50 Mammografien beurteilten. Quelle: Automation Bias in Mammography, Radiology (RSNA), via EurekAlert
- 40 % von 1.150 befragten US-Vollzeitbeschäftigten erhielten im Monat davor KI-generierten „Workslop“, wobei jeder Fall im Schnitt zwei Stunden Korrektur kostete, geschätzt 186 \(pro Beschäftigtem und Monat oder rund 9 Mio.\) pro Jahr für ein Unternehmen mit 10.000 Beschäftigten. Quelle: BetterUp Labs, „Workslop“
- 60 % der Führungskräfte nutzen KI bereits bei Entscheidungen, aber nur 5 % sagen, sie steuerten sie gut, eine Lücke, die Deloitte als Treiber organisationaler „Kulturschulden“ benennt. Quelle: Deloitte 2026 Global Human Capital Trends
- 56 % der Führungskräfte gestalten KI ausschließlich für Geschäftsergebnisse; nur 40 % gestalten sie für Geschäfts- und menschliche Ergebnisse zugleich, und 42 % der Beschäftigten sagen, ihre Organisation bewerte die Wirkung von KI auf Menschen überhaupt nicht. Quelle: Deloitte 2026 Global Human Capital Trends
- Wenn Führungskräfte ihre eigene KI-Nutzung sichtbar vorlebten, berichteten Beschäftigte von einem Anstieg des Vertrauens in agentische KI um 30 Punkte und waren 1,4-mal wahrscheinlicher, zu häufigen, durch ein Sicherheitsnetz abgesicherten Nutzern zu werden. Quelle: Microsoft Work Trend Index 2026
Kalibriertes Vertrauen: Vertrauen, aber prüfen, mit konkreten Angaben
Forschende, die die Interaktion von Mensch und Automatisierung untersuchen, nennen den Zielzustand zwischen den beiden Fehlermustern kalibriertes Vertrauen (auch angemessener Verlass): den Output eines Systems zu akzeptieren, wenn die Belege sagen, dass es zuverlässig ist, und zu widersprechen, wenn die Belege das Gegenteil sagen, Aufgabe für Aufgabe statt als Pauschalregel. Der entscheidende Unterschied besteht zwischen Vertrauen und Verlass. Vertrauen ist, was jemand über ein System zu glauben angibt; Verlass ist, was er mit dessen Output tatsächlich tut. Die Forschung findet durchgängig, dass beides auseinanderdriftet: Jemand kann sagen, er traue einem KI-Tool nicht völlig, und dennoch ungeprüft nach dessen Output handeln, weil Verifikation Mühe kostet und der Weg des geringsten Widerstands das Akzeptieren ist.
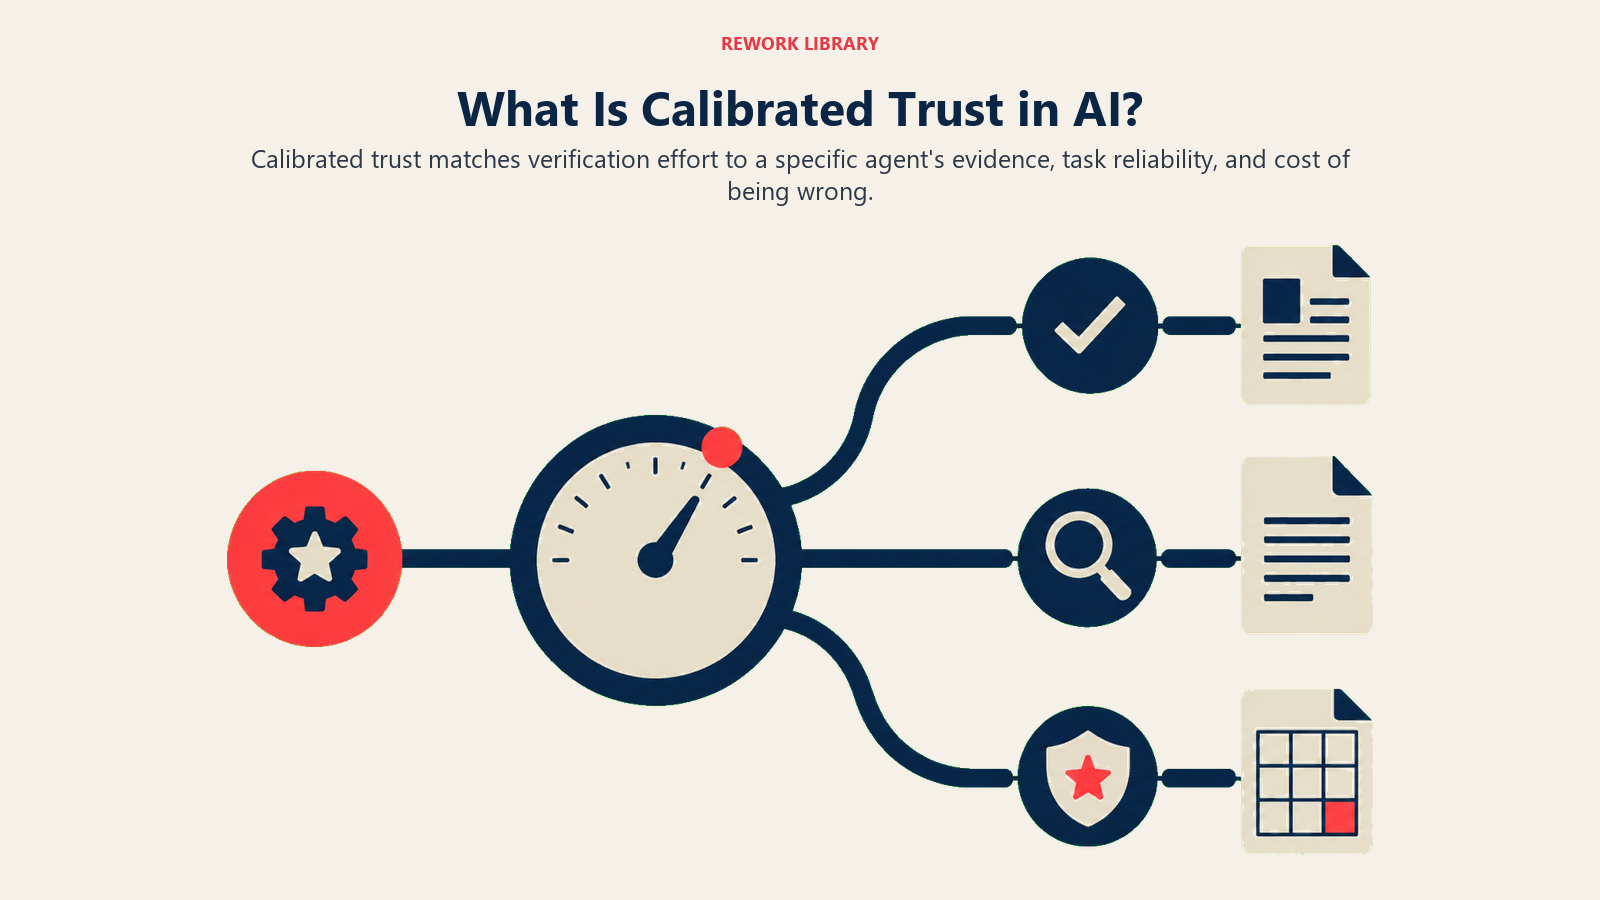
Kalibrierung funktioniert nur, wenn sie sich auf die Aufgabe bezieht, nicht auf das Tool als Ganzes. Ein Agent, der verlässlich einen ersten Entwurf einer Meeting-Zusammenfassung schreibt, hat ein völlig anderes Zuverlässigkeitsprofil als dasselbe Modell, das eine Finanzprognose berechnen oder einen Rechtsprechungsverweis zitieren soll. „Vertrauen wir der KI“ ist die falsche Frage. „Vertrauen wir diesem Agenten bei dieser Aufgabe, gestützt darauf, was wir ihn tatsächlich richtig und falsch machen sahen“ ist die nützliche.
Wissen, wo der Agent zuverlässig ist und wo nicht
Dieses aufgabenbezogene Bild aufzubauen, verlangt gezieltes Nachhalten, keine Intuition. Ein Team, das im Stillen bemerkt hat, dass ein Agent erste Entwürfe von Routine-E-Mails zuverlässig hinbekommt, aber in Recherchezusammenfassungen regelmäßig Statistiken erfindet, hat echte Kalibrierungsarbeit geleistet, auch wenn das niemand aufgeschrieben hat. Die Lücke der meisten Teams ist nicht das Bemerken, sondern dieses Wissen ausdrücklich zu machen und zu teilen, statt es im Kopf einer Person zu lassen, damit eine neue Kollegin nicht den Übervertrauensfehler wiederholt, den der Rest des Teams längst zu vermeiden gelernt hat.
Wie Verifikation im Alltag konkret aussieht
Konkret heißt das: belegte Behauptungen stichprobenartig prüfen, bevor ein Dokument nach außen geht, jede Zahl, die ein Agent liefert, mit einer bekannten Basis plausibilisieren und einen ersten Entwurf als Entwurf behandeln, den man bearbeitet, nicht als etwas, das man unverändert weiterleitet. Nichts davon verlangt, die Arbeit von Grund auf zu wiederholen, und genau das unterscheidet kalibriertes Vertrauen von Untervertrauen: gezieltes Prüfen dort, wo der Agent bekanntermaßen schwach ist, und selbstbewusstes Akzeptieren dort, wo er bekanntermaßen stark ist.
Was angemessenes KI-Vertrauen aufbaut
Vier Dinge führen ein Team zuverlässig vom Raten zur Kalibrierung, und keines davon ist eine einmalige Schulung.
Transparenz. Ein Agent, der seine Quellen zeigt, seine Sicherheit kennzeichnet oder die gegangenen Schritte erklärt, gibt einem Menschen etwas Reales zum Bewerten, statt eine polierte Endantwort, die man auf Treu und Glauben annimmt oder verwirft. Teams, die mit Tools arbeiten, die sichtbare Begründungen oder Quellenangaben liefern, kalibrieren tendenziell schneller als Teams, die an einer Blackbox hängen, die nur ein sauber aussehendes Ergebnis zurückgibt.
Erfolgsbilanz. Vertrauen in eine neue Kollegin entsteht, indem man beobachtet, wie sie über Wochen mit echten Situationen umgeht. Vertrauen in einen Agenten sollte ebenso entstehen, indem man ehrlich Buch führt, was er bei bestimmten Aufgabentypen richtig und falsch gemacht hat, und nicht annimmt, die Leistung in Woche eins sage die in Woche zwölf voraus.
Leitplanken. Vertrauen lässt sich leichter gewähren, wenn die Kosten eines Fehlers begrenzt sind. Ein Agent, der Entwürfe schreibt, aber nicht versendet; empfiehlt, aber keine Zahlung ausführt; markiert, aber kein Ticket automatisch schließt, gibt Menschen Raum zur Prüfung, bevor etwas Unumkehrbares passiert. Wie sich diese Befugnisse eingrenzen lassen, vertiefen wir in Leitplanken für KI-Agenten.
Human-in-the-Loop durch Design, nicht durch Gewohnheit. Es gibt einen echten Unterschied zwischen einem Workflow mit einem Prüfpunkt, der bewusst dort sitzt, wo Fehler am meisten zählen, und einem, in dem ein Mensch den Output eben nur überfliegt, weil es schon immer so gemacht wurde. Human-in-the-Loop richtig umgesetzt setzt den Prüfpunkt an die wirkungsvollste Stelle, nicht überall, denn genau das verursacht das Fehlermuster Untervertrauen überhaupt erst.
Der Team- und Kulturaspekt: Gemeinsame Normen dafür, wann geprüft wird
Nichts davon funktioniert, wenn es im Kopf einer einzelnen sorgfältigen Person lebt. Der eigentliche Bruchpunkt in den meisten Teams ist nicht, dass niemand weiß, dass man Agenten-Output prüfen sollte, sondern dass es keine gemeinsame, ausdrückliche Antwort auf „wer prüft was und wann“ gibt, sodass jeder auf den eigenen Instinkt zurückfällt, und Instinkte gehen weit auseinander. Eine Person prüft alles stichprobenartig; eine andere leitet Agenten-Entwürfe ohne zweiten Blick weiter; keine folgt einer schriftlichen Norm, weil es keine gibt.
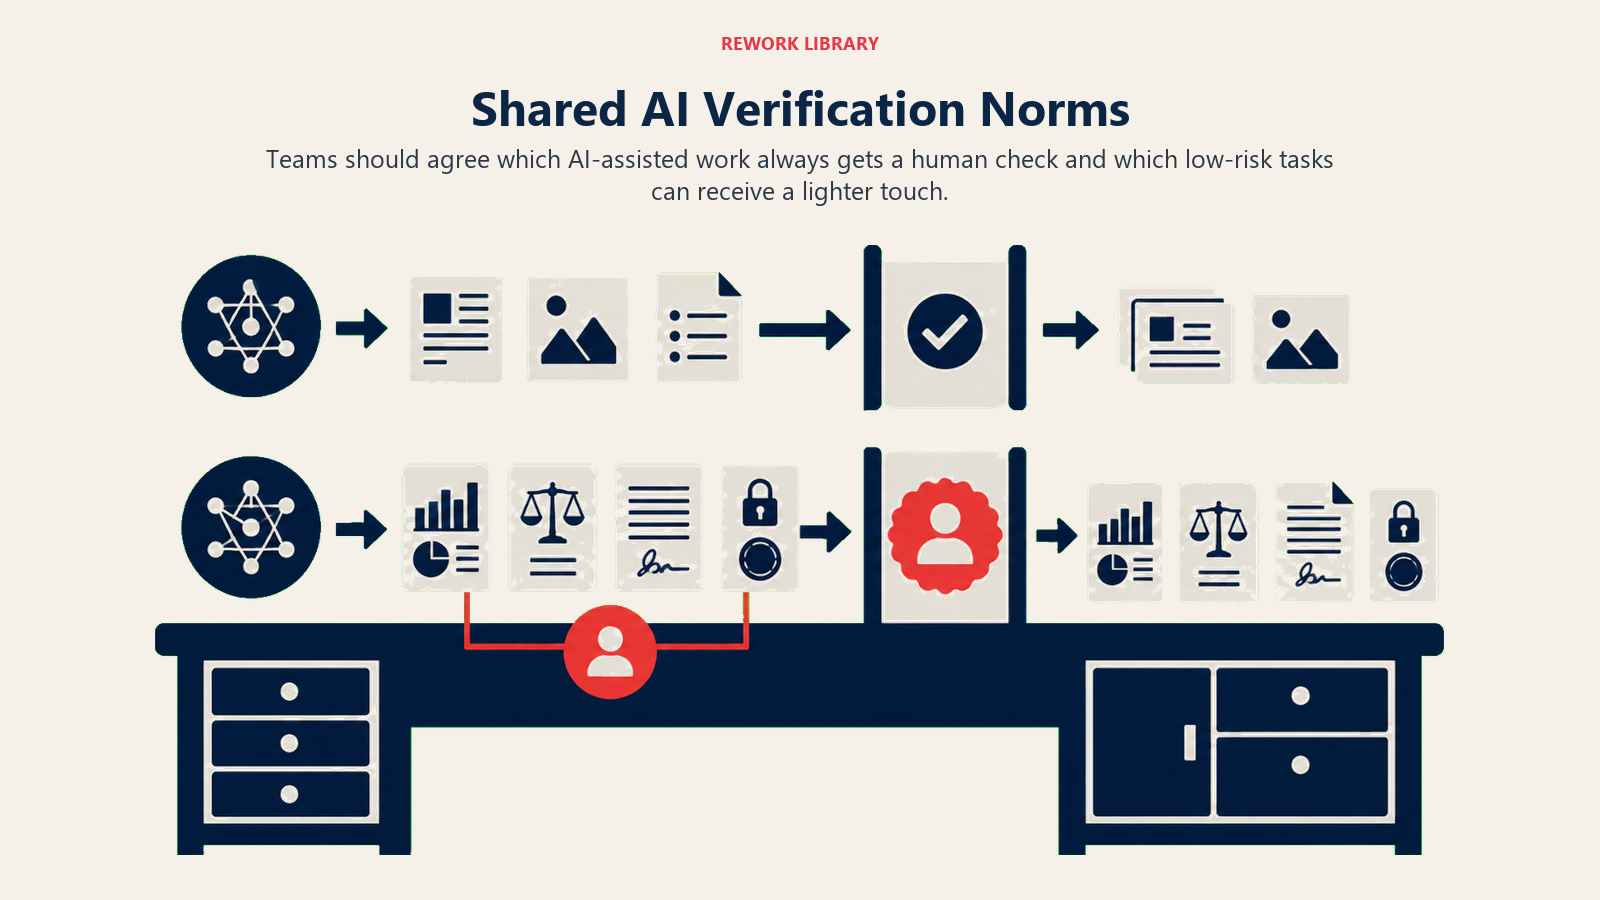
Das ist ein Kulturproblem, kein Tooling-Problem. KI-Etikette und Normen am Arbeitsplatz behandelt das breitere Set ungeschriebener Regeln, die Teams rund um Offenlegung und angemessene Nutzung aushandeln; die vertrauensspezifische Version heißt, laut zu vereinbaren, welche Arbeitskategorien immer eine menschliche Prüfung erhalten, bevor etwas nach außen geht (kundenbezogene Zahlen, juristische Formulierungen, alles Unumkehrbare) und welche unkritisch genug für eine leichte Hand sind. Diese Aufteilung in die eine oder andere Richtung falsch zu setzen, reproduziert eines der beiden Fehlermuster oben auf Teamebene statt auf individueller Ebene.
Dieselben Normen werden wichtiger, nicht unwichtiger, wenn Agenten aufhören, Tools zu sein, die eine Person bedient, und anfangen, als Teil des tatsächlichen Outputs des Teams zu agieren, der Wandel aus Teams aus Mensch und Agent. Ein Team ohne gemeinsame Vertrauensnormen scheitert nicht laut. Es häuft die Art Lücke an, die Deloitte KI-Kulturschulden nennt: stilles Übervertrauen in manchen Ecken, stilles redundantes Doppelprüfen in anderen, und niemand hat ein klares Bild davon, was wo passiert, bis ein sichtbarer Fehler das Gespräch erzwingt. Das richtig hinzubekommen, ist ein Baustein des größeren Wandels aus wie eine KI-native Kultur tatsächlich aussieht, in dem Vertrauen, Eigenverantwortung und Verantwortlichkeit gezielt neu aufgebaut werden müssen.
Nichts davon ist auf Unternehmen mit eigenen KI-Teams beschränkt. Ein Betrieb mit fünf Personen, der einen Agenten Outreach-E-Mails entwerfen lässt, braucht dieselbe ausdrückliche Antwort auf „wer prüft das, bevor es rausgeht“ wie ein Konzern mit tausend Beschäftigten. Der Einsatz wächst mit der Unternehmensgröße; das Kalibrierungsproblem nicht.
Wie es weitergeht
- Wie Sie Vertrauen am Arbeitsplatz aufbauen, die Modelle für Vertrauen zwischen Menschen, von denen sich dieser Artikel abgrenzt
- Teams aus Mensch und Agent, was sich ändert, wenn ein Agent Teil des tatsächlichen Outputs wird und nicht nur ein Tool ist
- KI-Kulturschulden, was geschieht, wenn Vertrauensnormen nie entstehen und sich die Lücke aufsummiert
- KI-Etikette und Normen am Arbeitsplatz, das breitere Set ungeschriebener Regeln, die Teams rund um den Einsatz von KI aushandeln
- Was ist eine KI-native Kultur?, das Gesamtbild, wie sich Vertrauen und Verantwortlichkeit verschieben, sobald Agenten Teammitglieder sind
- Was ist agentische KI?, wie diese Systeme planen und handeln, ein Grund dafür, dass ihre Fehler anders aussehen als die eines einfachen Tools
- KI-Halluzination, der konkrete Mechanismus hinter selbstsicherem, flüssigem, falschem Output
- Human-in-the-Loop, wie Sie den Prüfpunkt gestalten, statt ihn der Gewohnheit zu überlassen
Häufig gestellte Fragen zum Vertrauen in KI bei der Arbeit
Worin unterscheidet sich Vertrauen in eine KI von Vertrauen in einen Kollegen?
Vertrauen in einen Menschen entsteht dadurch, dass man über die Zeit seine Fähigkeit, seine Integrität und ob er sich offenbar um Ihre Interessen sorgt beobachtet, auch weil ein Mensch etwas zu verlieren hat, wenn er Sie täuscht. Ein KI-System hat weder eine Täuschungsabsicht noch eine Reputation auf dem Spiel, sodass diese Abkürzungen nicht greifen und selbstsicherer, flüssiger Output ebenso falsch sein kann wie richtig.
Was ist Automation Bias?
Automation Bias ist die Neigung, dem Output eines automatisierten Systems mehr Gewicht zu geben, als die Belege hergeben, und ihn nicht mehr selbst zu prüfen, sobald das System ein paarmal richtig lag. Es ist eines der am besten erforschten Fehlermuster in der Forschung zu Mensch und Automatisierung und wird tendenziell schlimmer, je genauer ein System wird, denn ein System, das meist richtig liegt, macht es unwahrscheinlicher, dass Menschen die Fälle bemerken, in denen es falsch liegt.
Was ist der Unterschied zwischen Untervertrauen und Übervertrauen in KI?
Untervertrauen heißt, die Arbeit einer KI aus Gewohnheit von Hand zu wiederholen, was den Produktivitätsgewinn zunichtemacht, den das Tool bringen sollte. Übervertrauen heißt, KI-Output ungeprüft zu akzeptieren, weil er selbstsicher klingt, und so gelangen KI-generierter „Workslop“ und sachliche Fehler in fertige Arbeit. Kalibriertes Vertrauen liegt dazwischen: prüfen, wo die Belege sagen, dass die KI schwach ist, akzeptieren, wo sie sagen, dass die KI stark ist.
Was bedeutet „kalibriertes Vertrauen“ in der Praxis?
Kalibriertes Vertrauen heißt, das Maß, in dem Sie sich auf den Output eines KI-Systems verlassen, an tatsächlichen, aufgabenbezogenen Belegen für seine Zuverlässigkeit auszurichten und nicht daran, wie selbstsicher es klingt. Es verlangt, nachzuhalten, was ein bestimmter Agent bei bestimmten Aufgabentypen richtig und falsch macht, und den Prüfaufwand entsprechend anzupassen, statt einer Pauschalregel „immer vertrauen“ oder „immer doppelt prüfen“ zu folgen.
Was ist „Workslop“, und wie hängt es mit dem Vertrauen in KI zusammen?
Workslop sind KI-generierte Inhalte, die gepflegt aussehen, aber nicht genug Substanz haben, um eine Aufgabe voranzubringen, ein Begriff, den Forschende von BetterUp Labs und dem Social Media Lab der Stanford University geprägt haben. Er ist ein direktes Symptom von Übervertrauen: Jemand hat einen KI-Entwurf ohne ausreichende Prüfung akzeptiert und weitergereicht und die Verifikation dem Nächsten überlassen, was laut einer Umfrage von 2025 für ein Unternehmen mit 10.000 Beschäftigten geschätzt rund 9 Mio. $ pro Jahr kostet.
Macht mehr Erfahrung immun gegen Automation Bias?
Nein, sie mindert den Schaden, beseitigt ihn aber nicht. Eine Studie mit 27 Radiologen ergab, dass bei falschem Diagnosevorschlag der KI die Genauigkeit weniger erfahrener Befunder von etwa 80 % auf unter 20 % sank, während sie bei Befundern mit 15+ Jahren Erfahrung von 82 % auf 45,5 % fiel. Erfahrung hilft, mehr Fehler zu erkennen, macht aber niemanden immun gegen eine selbstsicher falsche Empfehlung.
Wie hilft Human-in-the-Loop-Design, angemessenes Vertrauen aufzubauen?
Human-in-the-Loop funktioniert, wenn der Prüfpunkt bewusst dort sitzt, wo ein Fehler am meisten zählt, typischerweise bevor etwas Externes oder Unumkehrbares geschieht, und nicht als reflexhaftes Überfliegen von allem, was ein Agent anfasst. Gut gemacht kann ein Team Teilen eines Workflows, die keine Prüfung brauchen, echtes Vertrauen schenken und trotzdem die Fehler abfangen, die tatsächlich etwas kosten würden.
Was ist der erste Schritt für ein Team, das noch keine Vertrauensnormen für KI festgelegt hat?
Legen Sie als Team ausdrücklich fest, welche Kategorien KI-gestützter Arbeit immer eine menschliche Prüfung erhalten, bevor etwas nach außen geht (Kundenzahlen, juristische Formulierungen, alles Unumkehrbare) und welche unkritisch genug für eine leichtere Hand sind. Die meisten Teams haben bereits eine informelle Antwort in den Gewohnheiten einer sorgfältigen Person; die Arbeit besteht darin, sie gemeinsam und einheitlich zu machen statt individueller Instinkt.
Vertrauen in ein KI-Teammitglied sollte kein privates Gefühl dessen sein, der es zufällig am genauesten beobachtet. Machen Sie daraus stattdessen eine Messung: Halten Sie nach, wo der Agent zuverlässig ist und wo nicht, und teilen Sie dieses Bild im Team, damit Vertrauen kalibriert ist statt angenommen. Teams, die das tun, hören auf, zwischen blindem Glauben und pauschalem Misstrauen zu schwanken, und setzen den Agenten genau für das ein, was er sich verdient hat, nicht mehr und nicht weniger.

Co-Founder, Rework.com
On this page
- Warum Vertrauen in eine KI ein anderes Problem ist als Vertrauen in einen Menschen
- Selbstsicher und falsch sieht genauso aus wie selbstsicher und richtig
- Die zwei Fehlermuster: Untervertrauen und Übervertrauen
- Untervertrauen: Die Arbeit des Agenten von Hand wiederholen
- Übervertrauen: Automation Bias und der Preis des ausgelassenen Checks
- Wichtige Fakten
- Kalibriertes Vertrauen: Vertrauen, aber prüfen, mit konkreten Angaben
- Wissen, wo der Agent zuverlässig ist und wo nicht
- Wie Verifikation im Alltag konkret aussieht
- Was angemessenes KI-Vertrauen aufbaut
- Der Team- und Kulturaspekt: Gemeinsame Normen dafür, wann geprüft wird
- Wie es weitergeht