Psychologische Sicherheit in KI-Teams: Sicher hinterfragen, sicher Nein sagen
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
Psychologische Sicherheit in KI-Teams ist Amy Edmondsons ursprüngliches Konzept, die gemeinsame Überzeugung, dass ein Team ein sicherer Ort für zwischenmenschliche Risiken ist, übertragen auf neue Risiken, die erst entstehen, wenn KI einen Teil der Arbeit übernimmt. Sie bedeutet, dass Menschen sich sicher fühlen, die Ergebnisse eines Agenten zu hinterfragen, zuzugeben, dass sie bei einer Aufgabe KI genutzt haben, einen KI-Fehler zu melden oder dessen Empfehlung zu übersteuern und klar zu sagen: „Ich traue diesem Ergebnis nicht“, ohne dass sie dafür Status oder Glaubwürdigkeit verlieren oder einen Minuspunkt kassieren.
Edmondson hat ihre Laufbahn der Frage gewidmet, warum Menschen in Krankenhäusern, Cockpits und Vorstandsetagen schweigen, selbst wenn Reden ein Leben oder ein Projekt retten würde. Der Mechanismus, den sie fand, nämlich dass Schweigen eine rationale Reaktion auf einen Raum ist, der Risiko bestraft, lässt sich fast unverändert auf KI übertragen. Früher brauchte niemand eine Erlaubnis, um einer Tabelle zu misstrauen. Heute braucht ein wachsender Teil der Belegschaft genau diese Erlaubnis, und die meisten Teams haben sie nie ausdrücklich erteilt. Dieser Artikel behandelt, was an Sicherheit in Teams aus Mensch und KI wirklich neu ist, warum Automation Bias und übermäßige Fügsamkeit die Fehlerform sind, die auftritt, wenn sie fehlt, echte Forschung dazu, warum Menschen aufhören, nach dem „Warum“ zu fragen, und was Führungskräfte tun, um sie wiederherzustellen.
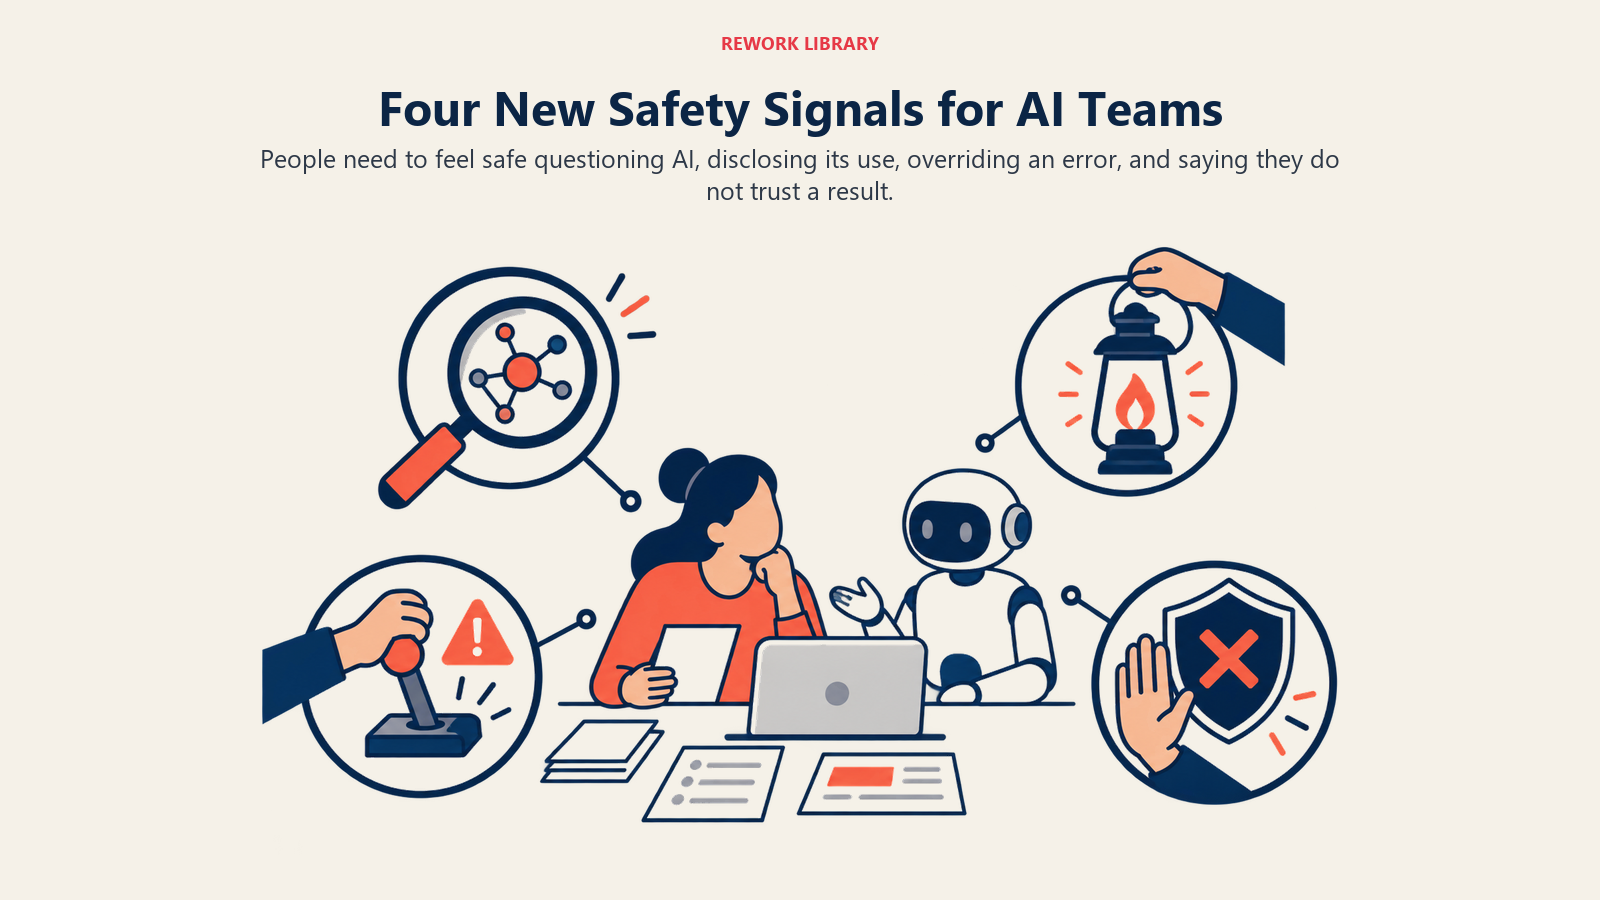
Edmondsons Modell erweitern: Vier neue Dinge, die Menschen sich sicher zu sagen trauen müssen
Edmondsons ursprüngliches Vier-Stufen-Modell aus Inklusions-, Lern-, Beitrags- und Herausforderungssicherheit wurde rund um Interaktionen zwischen Menschen gebaut. Das vollständige Modell behandeln wir unter psychologische Sicherheit am Arbeitsplatz. Sobald ein KI-Agent ein fester Teil des Teams ist und nicht ein Werkzeug, das jemand nebenbei still nutzt, müssen sich dieselben vier Stufen auf eine neue Reihe von Momenten ausdehnen, die Edmondson 1999 nicht modellieren musste, weil das Hinterfragte damals immer ein Kollege war.
Sicher KI-Ergebnisse hinterfragen
Jemand betrachtet, was ein Agent geliefert hat, und hat das nagende Gefühl, dass etwas nicht stimmt: eine Zahl, die nicht zur eigenen Intuition passt, eine Quellenangabe, die zu glatt klingt, ein Schritt, den man von einem Menschen erwartet hätte. Herausforderungssicherheit ist in Edmondsons Modell die Stufe, auf der Menschen sich frei fühlen, den Plan oder die verantwortliche Person zu hinterfragen. Die KI-Team-Version dieser Stufe ist das Hinterfragen der Maschine, und sie hat andere soziale Kosten: Wer die Idee eines Kollegen anzweifelt, steht nicht so schlecht da, wie jemand langsam oder paranoid wirken kann, der ein System infrage stellt, das „alle anderen“ scheinbar kommentarlos hinnehmen.
Sicher zugeben, dass Sie KI genutzt haben
Das liegt näher an Inklusions- und Lernsicherheit. KI für einen Entwurf, eine Zusammenfassung oder eine Analyse zu nutzen, ist kein Geständnis, wird in vielen Teams aber wie eines behandelt, weil niemand ausdrücklich gesagt hat, dass es keines ist. Wer seine KI-Nutzung verbirgt, lügt nicht aus Bosheit; er liest den Raum richtig, wenn dieser Raum Offenlegung nie als sicher erscheinen ließ. Dieses Schweigen hat direkte Kosten: Eine Führungskraft verliert den Einblick, wie die Arbeit tatsächlich entstanden ist, und kann damit genau die Fehlerform nicht auffangen, um die es in diesem Artikel geht.
Sicher einen KI-Fehler melden oder eine Empfehlung übersteuern
Ein Agent macht etwas falsch, oder jemand übersteuert, was er empfohlen hat, und tut etwas anderes. Beides sind Momente der Beitragssicherheit, also das eigene Urteil einzusetzen und damit Gewicht zu haben, doch nun geht es darum, ein System zu übersteuern, das von jemand Ranghohem beschafft, konfiguriert und vermutlich auch befürwortet wurde. Den Fehler eines Menschen zu melden, riskiert ein unangenehmes Gespräch. Den Fehler eines Systems zu melden oder zu übersteuern, riskiert den Eindruck, man vertraue der Investition nicht, die das Unternehmen gerade getätigt hat, und das ist ein anderes, oft schwereres Risiko, das man allein tragen muss.
Sicher sagen: „Ich traue diesem Ergebnis nicht“
Das ist der wichtigste Satz, und der, den die meisten Teams am wenigsten geübt haben. Er ist keine technische Aussage über Genauigkeit, sondern eine Unsicherheitsbekundung von jemandem, der kompetent und entschlossen wirken soll. Ihn über die Arbeit eines Kollegen zu sagen, ist unangenehm, aber vertrautes Terrain. Ihn über ein System zu sagen, das eine schnelle, flüssige, professionell wirkende Antwort geliefert hat, während im Raum niemand sonst widerspricht, ist das wirklich neue zwischenmenschliche Risiko, nach dem dieser Artikel benannt ist.
Automation Bias und übermäßige Fügsamkeit: Die neue Fehlerform
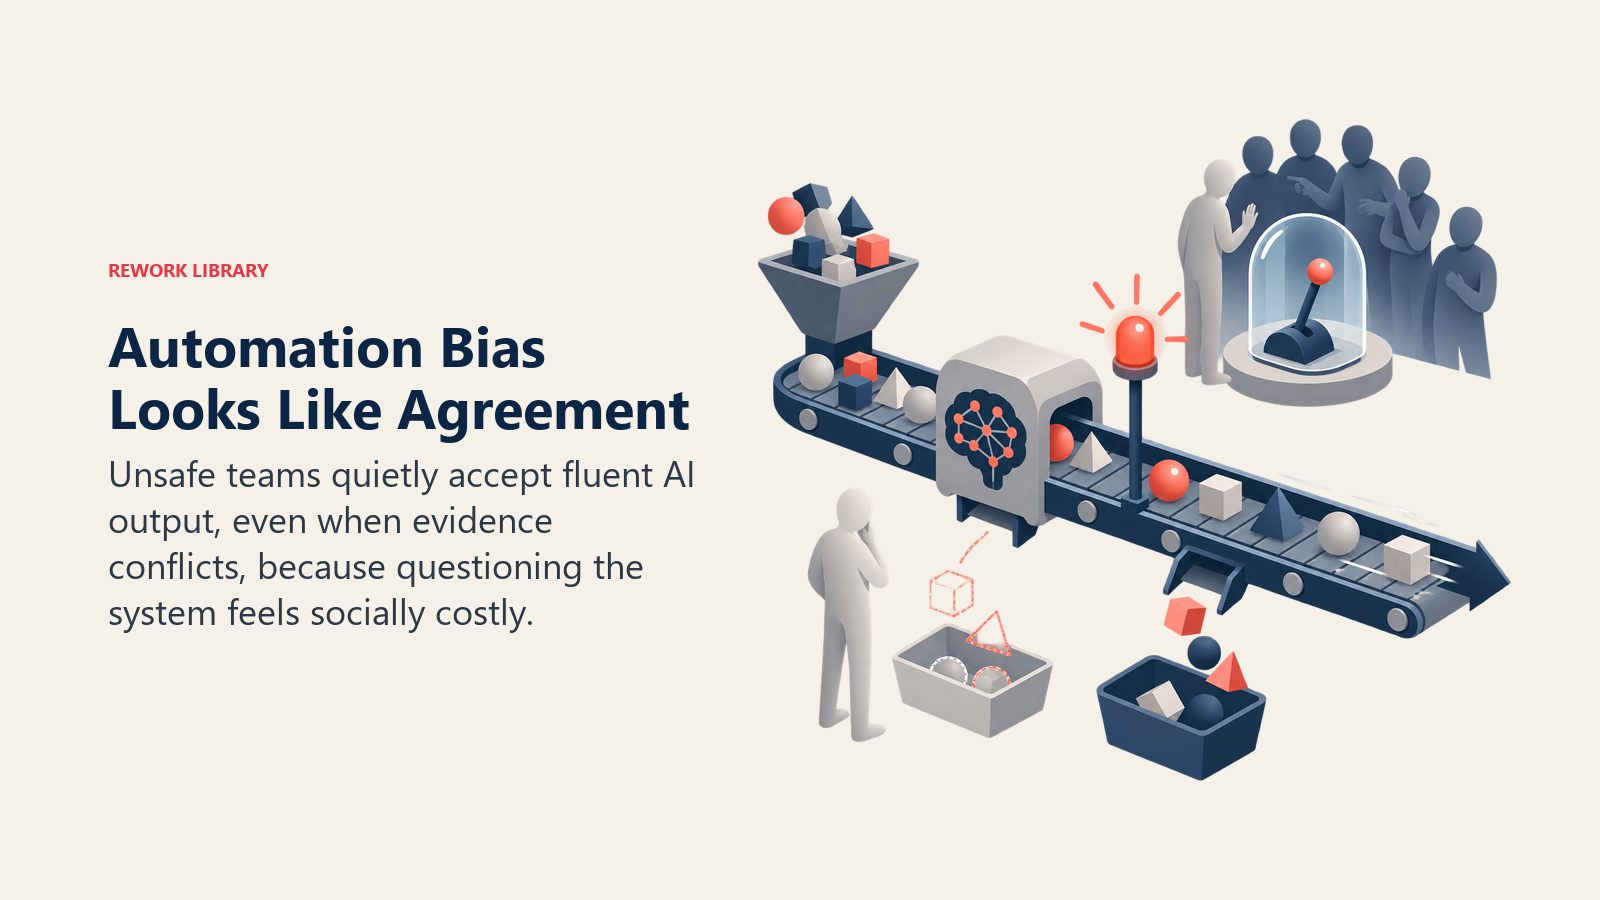
Hier ist der Teil, den die meisten Ratschläge zu psychologischer Sicherheit völlig übersehen. Wenn ein Team im Umgang mit KI unsicher ist, sieht der Fehler nicht nach Konflikt aus. Er sieht nach Einigkeit aus. Alle nicken, das Ergebnis geht raus, und das Team wirkt perfekt abgestimmt, bis der Fehler an einer teuren Stelle auftaucht.
Was Automation Bias eigentlich ist
Die Forschenden Linda Skitka, Kathleen Mosier und Malcolm Burdick gaben diesem Muster 1999 in einer Studie einen Namen, die bis heute die maßgebliche Quelle des Fachgebiets ist: Automation Bias, die Neigung, das Ergebnis eines automatisierten Systems als Ersatz für die wachsame Kontrolle zu akzeptieren, die ein Mensch sonst selbst leisten würde. Ihre Untersuchung, durchgeführt in einer simulierten Flugüberwachungsaufgabe, ergab etwas, das konkret genug ist, um hier zu zählen: Menschen machten zwei unterschiedliche Arten von Fehlern. Unterlassungsfehler, bei denen ein Problem unbemerkt blieb, weil das automatisierte System es nicht meldete. Und Begehungsfehler, bei denen eine automatisierte Empfehlung aktiv befolgt wurde, obwohl andere verfügbare Informationen darauf hindeuteten, dass sie falsch war. Quelle: Skitka, Mosier & Burdick, „Does Automation Bias Decision-Making?“
Diese zweite Kategorie ist für ein Kulturgespräch die wichtige. Ein Begehungsfehler ist kein Versehen. Es ist ein Mensch, der im Moment die automatisierte Antwort dem eigenen Urteil vorzieht, oft während andere Hinweise direkt vor ihm liegen. Das ist keine Schulungslücke. Es ist eine Entscheidung, die davon geprägt ist, was der Raum um diese Person herum zu sagen und zu tun erträglich macht.
Warum psychologische Sicherheit die fehlende Variable ist
Das meiste, was über Automation Bias geschrieben wird, behandelt ihn als individuellen kognitiven Mangel, den man mit besserer Benutzeroberfläche oder einem Schulungsmodul behebt. Diese Rahmung übersieht den Mechanismus auf Teamebene völlig. Ein Begehungsfehler ist genau dann am leichtesten zu machen, wenn das Hinterfragen des Systems sozial teuer und das Schweigen kostenlos erscheint. Dreht man den Anreiz um, verhält sich dieselbe Person mit derselben kognitiven Verdrahtung anders. Skitkas Laborbefund und Edmondsons Feldforschung beschreiben dieselbe Form aus zwei Richtungen: Automation Bias zeigt, dass Menschen bei Unsicherheit standardmäßig zustimmen, und psychologische Sicherheit zeigt, was das Äußern bei Unsicherheit teuer oder kostenlos macht. Übermäßige Fügsamkeit gegenüber KI ist keine neue Art menschlichen Versagens. Es ist Edmondsons ältestes, ein Team, das Stimme bestraft und Schweigen belohnt, nur mit neuer Oberfläche.
Die Kreditsachbearbeiter-Studie: Wenn das Nichtfragen nach dem „Warum“ der Punkt ist
Eine Studie von 2026 unter Leitung von Alex Chan von der Harvard Business School belegt mit echten Zahlen, wie bewusst dieses Schweigen sein kann. Die Forschenden ließen 2.512 Online-Teilnehmende als Kreditsachbearbeiter agieren und Paare echter Kreditanträge über je 10.000 $ prüfen, wobei ein KI-System für jeden einen Risikowert lieferte. Achtzig Prozent der Teilnehmenden wollten den Risikowert der KI sehen, aber nur 46 % gingen weiter und baten um die Erklärung dahinter, obwohl diese nur einen Klick entfernt war. Als die Forschenden einigen Teilnehmenden zufällig einen finanziellen Bonus zuwiesen, der daran gekoppelt war, wie gut der Kredit tatsächlich lief, statt eines Pauschalhonorars, stieg die Erklärungsvermeidung um 20 Prozentpunkte, und die Vermeidung sprang um mehr als 10 weitere Punkte, wenn Teilnehmende Grund zu der Annahme hatten, die Erklärung könnte offenlegen, dass Hautfarbe oder Geschlecht den KI-Wert beeinflusst hatten. Quelle: HBS Working Knowledge, „When AI Gives Advice, Employees Rarely Ask Why“
Chans eigene Einordnung des Ergebnisses ist der Satz, bei dem man verweilen sollte: „Das größte Risiko von KI sind nicht nur schlechte Antworten oder mangelnde Akzeptanz. Es ist, Menschen darauf zu trainieren, nicht mehr nach dem Warum zu fragen.“ Seine Teilnehmenden waren nicht ratlos, wie man die Argumentation der KI einsehen kann. Ein erheblicher Teil entschied sich, nicht hinzuschauen, weil Hinschauen etwas Unbequemes zutage fördern könnte. Das ist nicht Automation Bias als passive kognitive Abkürzung. Es ist Automation Bias als aktive, motivierte Entscheidung, die am leichtesten fällt, wenn niemandes Anreize die schwierigere Frage belohnen.
Wichtige Fakten
- Automation Bias, die Neigung, das Ergebnis eines automatisierten Systems der wachsamen eigenen Kontrolle vorzuziehen, wurde durch die Studie von Skitka, Mosier und Burdick von 1999 definiert, die zeigte, dass Menschen sowohl Unterlassungsfehler (ein Problem übersehen, das das System nicht meldete) als auch Begehungsfehler (eine schlechte automatisierte Empfehlung entgegen gegenteiliger Belege aktiv befolgen) machen. Quelle: International Journal of Human-Computer Studies, via ACM
- In einer Studie von 2026 mit 2.512 Teilnehmenden als Kreditsachbearbeitern wollten 80 % den Risikowert eines KI-Systems sehen, aber nur 46 % baten um die Erklärung dahinter; die Erklärungsvermeidung stieg um 20 Prozentpunkte, wenn ein finanzieller Bonus an die Kreditleistung gekoppelt war, und um mehr als 10 weitere Punkte, wenn die Erklärung eine ethnische oder geschlechtsbezogene Verzerrung hätte offenlegen können. Quelle: HBS Working Knowledge
- Die Forschung von Amy Edmondson und Jayshree Seth im Harvard Business Review von 2026 ergab, dass die Teamleistung trotz der Produktivitätsgewinne, die Unternehmen von KI erwarten, oft sinkt: Menschen beginnen, an sich selbst zu zweifeln, und Vertrauen erodiert auf schwer zu fassende Weise, eine Dynamik, die sie als „Vertrauensambiguität“ beschreiben. Quelle: Harvard Business Review
- Der Work Trend Index 2026 von Microsoft ergab: Wenn Führungskräfte gezielt psychologische Sicherheit rund um das Experimentieren mit KI schufen, berichteten Beschäftigte von bis zu 20 Punkten höherer KI-Bereitschaft und wahrgenommenem Nutzen und wurden 1,4-mal wahrscheinlicher zu häufigen Nutzern agentischer KI. Quelle: Microsoft Work Trend Index 2026
- Die Forschung der Deloitte Global Human Capital Trends 2026 ergab, dass 60 % der Führungskräfte KI bereits bei Entscheidungen einsetzen, aber nur 5 % sagen, dass sie das gut steuern, eine Lücke, die sich zu dem summiert, was Deloitte KI-Kulturschulden nennt, wenn sich niemand sicher genug fühlt, das Problem laut zu benennen. Quelle: Deloitte 2026 Global Human Capital Trends
Warum diese Art des Schweigens leicht übersehen wird
Altmodisches Schweigen in Meetings hat eine vertraute Gestalt: Jemand hat ein Bedenken, der Raum wird still, und alle spüren die Spannung, auch wenn sie niemand benennt. Schweigen rund um KI fühlt sich oft gar nicht nach Spannung an. Es fühlt sich nach reibungsloser Zustimmung an, weil das Nachgeben gegenüber einem System nicht dasselbe sichtbare soziale Gewicht hat wie das Nachgeben gegenüber einem Menschen. Niemand sieht einem Kollegen zu, wie er still die Zahl einer KI akzeptiert, und deutet das als Einknicken, so wie man es deuten würde, wenn jemand vor einer lauten Stimme im Raum kapituliert. Genau das macht es gefährlich: Ein Team kann völlig sicher wirken, voller offener Debatten über alles, worin man sich uneinig ist, und zugleich einen ungeprüften blinden Fleck bei allem haben, was die KI berührt.
Die Forschung von Edmondson und Seth aus 2026 benennt den Mechanismus direkt: Anhaltende KI-Nutzung kann das Vertrauen einer Person in die eigene Fähigkeit, das Ergebnis einer KI zu hinterfragen, still aushöhlen, selbst wenn sie genau die Expertise hat, um zu erkennen, was falsch ist. Das ist das Gegenteil davon, wie Selbstvertrauen normalerweise funktioniert, denn ein Fachexperte wird mit der Erfahrung meist bestimmter, nicht zurückhaltender. Wer immer wieder zusieht, wie eine flüssige, professionell wirkende Antwort entsteht, lernt eine andere Lektion: dass das Zögern, sie zu akzeptieren, der Rechtfertigung bedarf und nicht die Akzeptanz selbst. Vertrauen, wenn Ihr Teamkollege eine KI ist behandelt, warum sich bei KI-Ergebnissen die Zuversicht so viel schwerer ablesen lässt als bei einem Menschen; dies hier ist die Sicherheitsfolge derselben Mechanik, die sich als stiller Selbstzweifel zeigt statt als offener Widerspruch, auf den jemand zeigen und den man beheben könnte.
Die Kosten summieren sich, weil sie im Moment des Geschehens unsichtbar sind. Wer einen Zweifel am Plan eines Kollegen hinunterschluckt, weiß zumindest, dass er es getan hat. Wer das Ergebnis einer KI ohne ausgesprochenen Zweifel akzeptiert, erlebt es oft gar nicht als Nachgeben; es fühlt sich einfach nach Weitermachen an. Multipliziert man das über Monate mit einem Team, entsteht eine Gruppe, die still aufgehört hat, genau das Urteilsvermögen auszuüben, für das sie eingestellt wurde, ohne dass sich ein einzelner Moment benennen ließe, an dem etwas schiefging.
Was Führungskräfte tun, um psychologische Sicherheit in KI-Teams aufzubauen
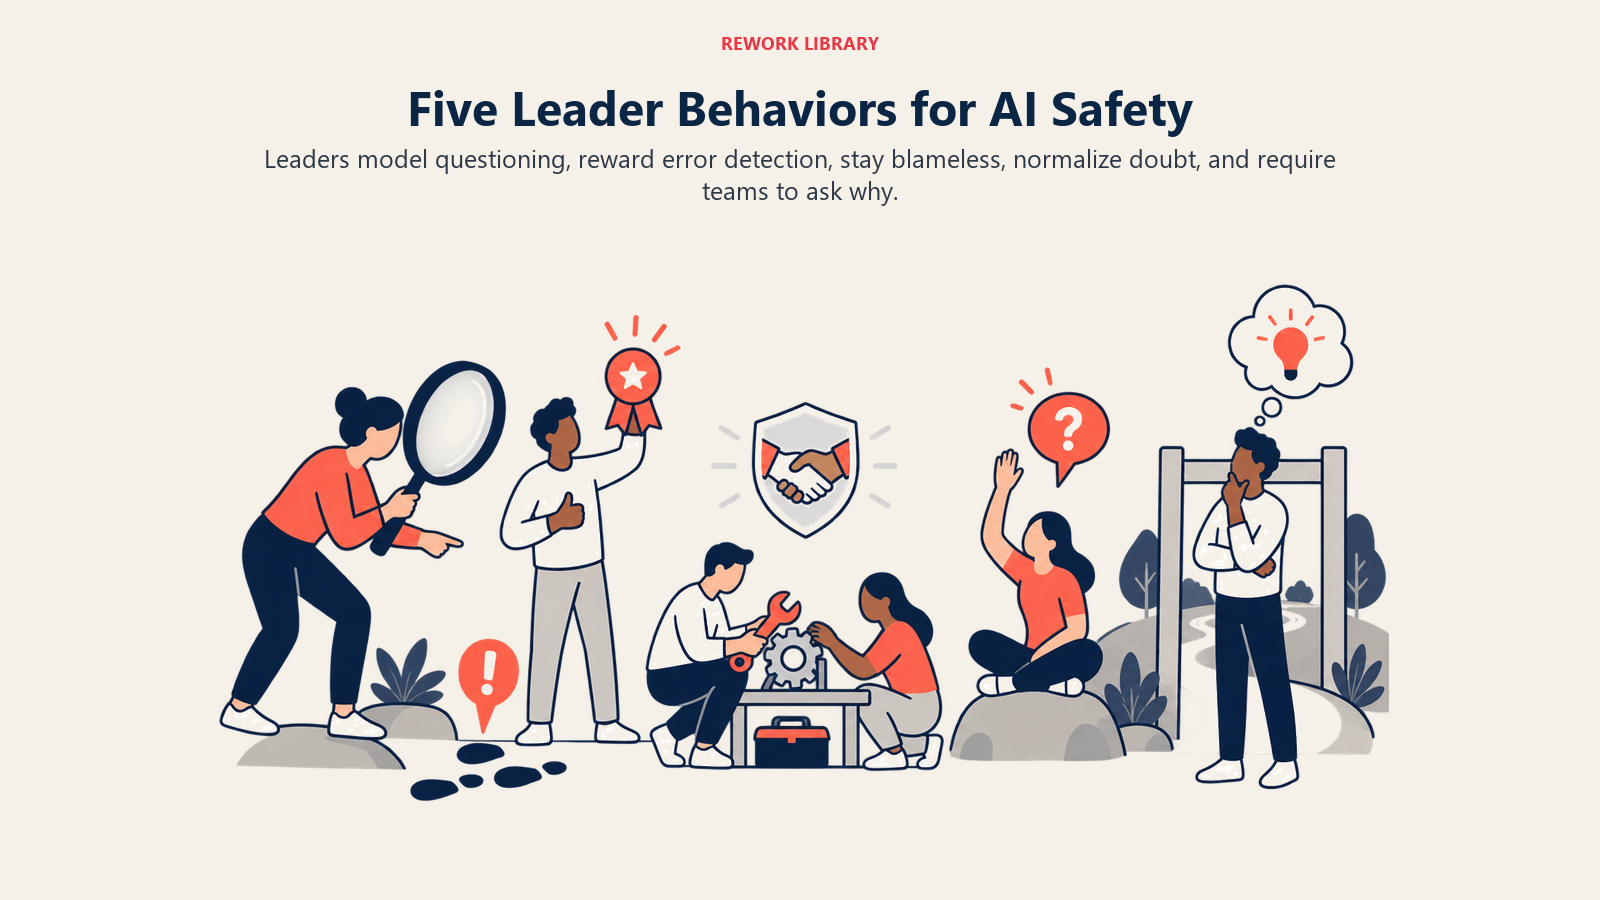
Die Teams, die diese Fehlerform vermeiden, sind nicht die mit der vorsichtigsten KI-Richtlinie. Es sind die, in denen eine Handvoll konkreter Führungsverhaltensweisen das Hinterfragen, Zugeben und Zweifeln zu einem normalen Teil der Arbeit macht und nicht zu einer Ausnahme, die jemand rechtfertigen muss.
Das Hinterfragen von KI selbst sichtbar vorleben
Der wirksamste Schritt ist, dass eine Führungskraft ein KI-Ergebnis vor dem Team öffentlich anzweifelt, auch in den Fällen, in denen es sich als richtig herausstellt. „Ich möchte diese Zahl prüfen, bevor wir sie verwenden“, gesagt von der ranghöchsten Person im Raum, erlaubt allen anderen dasselbe Verhalten wirksamer als jede schriftliche Richtlinie. Die Forschung von Microsoft zu Führungskräften, die ihre eigene KI-Nutzung sichtbar vorleben, fand echte, messbare Effekte auf die Bereitschaft des ganzen Teams, sich kritisch mit KI auseinanderzusetzen, nicht nur auf deren reine Nutzung. Was sich verbreitet, ist der sichtbare Akt des Prüfens, nicht ein Memo, das Prüfen für erwünscht erklärt.
Das Entdecken des Fehlers belohnen, nicht nur schnelles Liefern
Wenn das einzige anerkannte Ergebnis in einem Team Geschwindigkeit ist, steht, wer ein fehlerhaftes KI-Ergebnis entdeckt und die Arbeit bremst, um es zu beheben, als die Person da, die die Frist verpasst hat, und nicht als die, die das Projekt gerettet hat. Anerkennungssysteme, die ganz auf Durchsatz ausgerichtet sind, trainieren Menschen still dazu, nicht zu genau hinzusehen. Wer einen KI-Fehler vor der Auslieferung entdeckt, sollte benannt und gewürdigt werden, so wie ein gutes Team würdigt, wer vor dem Release einen Bug fand. Dadurch wird das Auffangen von Fehlern zu einem statusfördernden Schritt statt zu einem statusgefährdenden.
KI-Fehler jedes Mal schuldfrei behandeln
Wie ein Team auf einen Fehler reagiert, trainiert alle, die zusehen, ob der Fehler von einem Menschen oder einer Maschine kam. Schuldkultur vs. Lernkultur ist für den Fehler eines Agenten genauso relevant wie für den eines Menschen. Ein Team, das still die Person verantwortlich macht, die den KI-Fehler „hätte entdecken müssen“, lehrt alle, dass der sicherste Zug beim nächsten Mal Schweigen ist, nicht Prüfung. Ein Team, das den Fehler als Information behandelt, also was der Agent übersehen hat und was sich ändert, damit es nicht wieder passiert, hält die Tür offen, dass der Nächste ehrlich spricht, statt sich selbst zu decken.
„Ich traue dem nicht“ zu einem normalen Satz machen
Führungskräfte können das direkt ansprechen, statt zu hoffen, dass es von selbst entsteht. Wenn sie in einem Teammeeting sagen: „Wenn Sie je anschauen, was ein Agent geliefert hat, und denken, da stimmt etwas nicht, ist das genau der Satz, den ich hören will, auch wenn Sie noch nicht genau erklären können, warum“, wirkt das mehr, als man erwarten würde. Es verwandelt ein vages, schwer zu begründendes Gefühl in einen ausdrücklich willkommenen Beitrag, und zwar genau in der Lücke, in die laut Chans Forschung Menschen fallen: eine Frage zu meiden, nicht weil ihnen die Mittel zum Fragen fehlen, sondern weil im Raum nichts darauf hindeutete, dass sich der Aufwand des Fragens lohnt.
Die Gewohnheit aufbauen, nach dem „Warum“ zu fragen, nicht nur nach dem „Was“
Teams, die fragen „Was hat die KI empfohlen?“ und dabei stehen bleiben, sind strukturell auf die übermäßige Fügsamkeit programmiert, die dieser Artikel beschreibt. Teams, die „Warum hat sie das empfohlen, und hält die Begründung stand?“ in den Arbeitsablauf selbst einbauen, als Standardschritt ab einer definierten Risikoschwelle statt als gelegentlichen Bauchcheck, tun das Gegenteil von Chans Teilnehmenden, für die ein Bonus die Erklärung unbequem machte. Es ist dieselbe Disziplin, die Teams aus Menschen und Agenten für Verantwortlichkeit insgesamt brauchen, angewandt auf den Moment, bevor ein Ergebnis ausgeliefert wird, und nicht erst, nachdem schon etwas schiefgegangen ist.
Ein kurzer Check: Hat Ihr Team das wirklich?
Die meisten Teams können nicht sagen, ob sie rund um KI psychologische Sicherheit haben, bis sie nach konkreten Signalen suchen statt nach einem allgemeinen Gefühl. Die Tabelle unten trennt, wie die Anwesenheit von Sicherheit tatsächlich aussieht und wie ihre Abwesenheit, denn beides kann an der Oberfläche ruhig wirken.
| Signal | Vorhanden | Fehlt |
|---|---|---|
| KI-Ergebnisse hinterfragen | Menschen sagen „Ich möchte das prüfen“, ohne vorher abzuschwächen oder sich zu entschuldigen | Zweifel werden nur privat geäußert, nachdem das Ergebnis schon ausgeliefert wurde |
| KI-Nutzung zugeben | Offenlegung ist Routine und wird so erwähnt, wie man eine Quelle erwähnt | KI-Nutzung wird nur auf direkte Nachfrage erwähnt oder gar nicht |
| KI-Fehler melden oder übersteuern | Die Person, die den Fehler entdeckt hat, wird genannt und gewürdigt | Der Fehler taucht später auf, ohne klare Spur, wer ihn beinahe entdeckt hätte |
| „Ich traue dem nicht“ sagen | Wird in Teamrunden klar gesagt und als nützliche Information behandelt | Wird, wenn überhaupt, nur unter vier Augen gesagt und als Geständnis behandelt |
| Verhalten der Führung | Führungskräfte hinterfragen KI-Ergebnisse sichtbar selbst, auch ihre eigenen | Führungskräfte behandeln KI-Ergebnisse als erledigt, sobald eine ranghohe Person sie freigegeben hat |
Ein Team, das sich überwiegend in der rechten Spalte wiedererkennt, ist nicht kaputt; es betreibt schlicht genau das Setup, von dem Chans Forschung und Skitkas ursprüngliches Automation-Bias-Modell vorhersagen, dass es still Begehungsfehler ansammelt. Die Lösung ist kein neues Tool. Sie besteht darin, die linke Spalte zur normalen, unauffälligen Art zu machen, wie das Team ohnehin spricht.
Wie es weitergeht
Dieser Artikel überträgt die grundlegende Forschung zu psychologischer Sicherheit auf einen konkreten neuen Kontext. Von hier aus geht es weiter mit:
- Psychologische Sicherheit am Arbeitsplatz, für Edmondsons ursprüngliches Vier-Stufen-Modell und Googles Project-Aristotle-Forschung, auf denen dieser Artikel aufbaut
- Vertrauen, wenn Ihr Teamkollege eine KI ist, für die Mechanik kalibrierten Vertrauens und warum sich der selbstsichere Ton einer KI nicht so lesen lässt wie der eines Menschen
- Teams aus Menschen und Agenten, für die Fragen zu Zuständigkeit und Verantwortlichkeit, die auftauchen, sobald ein Agent ein fester Teil des Teams ist
- Schuldkultur vs. Lernkultur, dazu, wie die Reaktion eines Teams auf jeden Fehler, ob menschlich oder von der KI, darüber entscheidet, ob der Nächste sich äußert
- KI-Kulturschulden, dafür, was sich ansammelt, wenn Lücken bei Vertrauen und Sicherheit rund um KI unbehandelt bleiben
- KI-Etikette und Normen am Arbeitsplatz, für das breitere Set ungeschriebener Regeln zur Offenlegung, in das die zweite Risikokategorie dieses Artikels gehört
- Die Frontier Firm und der Aufstieg des Agent Boss, dazu, wie die Orchestrator-Rolle verändert, was Führungskräfte vorleben müssen
- Eine KI-bereite Kultur aufbauen, für das breitere Set an Praktiken, in das sich das einfügt
- Was ist KI-native Kultur?, für das grundlegende Konzept, in dem die Fragen dieses Artikels stehen
- Kultur im Zeitalter der KI führen, für das gesamte Führungsbild über alle Abschnitte von Abschnitt 7 hinweg
Häufig gestellte Fragen zu psychologischer Sicherheit in KI-Teams
Was ist psychologische Sicherheit in KI-Teams?
Es ist Amy Edmondsons ursprüngliches Konzept, die gemeinsame Überzeugung, dass ein Team ein sicherer Ort für zwischenmenschliche Risiken ist, übertragen auf Risiken, die erst entstehen, wenn KI Teil des Workflows ist: das Ergebnis eines Agenten hinterfragen, zugeben, dass man KI genutzt hat, einen KI-Fehler melden oder übersteuern und „Ich traue diesem Ergebnis nicht“ sagen, ohne dass es Glaubwürdigkeit kostet.
Wie unterscheidet sich psychologische Sicherheit im Umgang mit KI von der zwischen Menschen?
Der Mechanismus ist derselbe, das soziale Signal ist anders. Schweigen über die fehlerhafte Idee eines Kollegen zeigt sich meist als sichtbare Spannung im Raum. Schweigen über das fehlerhafte Ergebnis einer KI sieht dagegen oft nach reibungsloser Zustimmung aus, weil das Nachgeben gegenüber einem System nicht dasselbe offensichtliche soziale Gewicht hat wie das gegenüber einem Menschen, wodurch das Problem viel leichter übersehen wird.
Was ist Automation Bias, und wie hängt er mit psychologischer Sicherheit zusammen?
Automation Bias, 1999 von den Forschenden Skitka, Mosier und Burdick definiert, ist die Neigung, das Ergebnis eines automatisierten Systems anstelle der eigenen wachsamen Kontrolle zu akzeptieren, was zu Unterlassungsfehlern und Begehungsfehlern führt. Psychologische Sicherheit ist die fehlende Variable, die die meisten Erklärungen auslassen: Menschen machen weit eher einen Begehungsfehler, also schlechten automatisierten Rat aktiv zu befolgen, wenn das Hinterfragen des Systems sozial teuer und das Schweigen kostenlos erscheint.
Was ergab die Kreditsachbearbeiter-Studie der Harvard Business School zu Beschäftigten und KI-Ratschlägen?
Der Forscher Alex Chan ließ 2.512 Teilnehmende KI-bewertete Kreditanträge prüfen und stellte fest, dass 80 % den Risikowert der KI sehen wollten, aber nur 46 % um die Begründung dahinter baten. Die Vermeidung stieg stark an, wenn ein finanzieller Bonus an die Kreditleistung gekoppelt war oder wenn die Erklärung eine Verzerrung hätte offenlegen können, was zeigt, dass das Nichtfragen nach dem „Warum“ oft eine motivierte Entscheidung ist und kein Mangel an Neugier.
Was bedeutet „Vertrauensambiguität“ im Zusammenhang mit KI und psychologischer Sicherheit?
Es ist ein Begriff aus der Harvard-Business-Review-Forschung von Amy Edmondson und Jayshree Seth aus 2026. Er beschreibt, was passiert, wenn ein Team erwartet, dass Vertrauen in KI gerechtfertigt ist, es aber nicht wirklich empfindet, und diese Lücke sich nicht ansprechen lässt. Bleibt sie unbehandelt, höhlt sie still das Vertrauen der Menschen in ihre Fähigkeit aus, das Ergebnis einer KI zu hinterfragen, auch wenn sie die Expertise dafür haben.
Was ist das deutlichste Zeichen dafür, dass einem Team psychologische Sicherheit rund um KI fehlt?
Zweifel an KI-Ergebnissen tauchen nur privat und im Nachhinein auf, statt laut in dem Raum, in dem die Entscheidung fällt. Ein Team, das bei jeder KI-berührten Entscheidung ruhig und einig wirkt, ganz ohne sichtbare Debatte, ist öfter ein Zeichen fehlender Sicherheit als ein Zeichen dafür, dass die KI immer recht hat.
Was kann eine Führungskraft diese Woche tun, um damit anzufangen?
Das Ergebnis einer KI vor dem Team sichtbar hinterfragen, auch in Fällen, in denen es sich als richtig herausstellt, und direkt sagen, dass das Entdecken eines Fehlers mehr Anerkennung verdient als schnelles Liefern ohne Prüfung. Beide Schritte kosten nichts, wirken sofort und wirken genau der Anreizstruktur entgegen, die stille übermäßige Fügsamkeit hervorbringt.
Bremst der Aufbau dieser Art psychologischer Sicherheit Teams aus?
Nicht dauerhaft. Es bremst einzelne Entscheidungen, bei denen eine Prüfung tatsächlich etwas auffängt, und das ist der Sinn, verhindert aber die viel größeren Kosten eines ungeprüften Fehlers, der ausgeliefert und später wieder aufgerollt werden muss. Die Forschung von Microsoft aus 2026 ergab, dass Teams mit mehr psychologischer Sicherheit beim Experimentieren mit KI höhere KI-Bereitschaft und höheren Nutzen verzeichneten, nicht geringere Produktivität.
Die Gesundheit eines KI-Teams zeigt sich in einem einzigen Moment: Wenn jemand sagt „Ich traue diesem Ergebnis nicht“, behandelt der Raum das als Erledigen der eigenen Aufgabe oder als Bremse für alle? Die Offenlegungsnormen, die Fehlermeldung, die Bereitschaft, eine selbstsichere Maschine zu übersteuern, ergeben sich alle aus der Antwort. Bauen Sie für diesen Moment, und der Rest wird leichter. Bestrafen Sie ihn einmal, und Menschen hören still auf, es zu sagen, und genau dann beginnt der Automation Bias, Sie etwas zu kosten.

Co-Founder, Rework.com
On this page
- Edmondsons Modell erweitern: Vier neue Dinge, die Menschen sich sicher zu sagen trauen müssen
- Sicher KI-Ergebnisse hinterfragen
- Sicher zugeben, dass Sie KI genutzt haben
- Sicher einen KI-Fehler melden oder eine Empfehlung übersteuern
- Sicher sagen: „Ich traue diesem Ergebnis nicht“
- Automation Bias und übermäßige Fügsamkeit: Die neue Fehlerform
- Was Automation Bias eigentlich ist
- Warum psychologische Sicherheit die fehlende Variable ist
- Die Kreditsachbearbeiter-Studie: Wenn das Nichtfragen nach dem „Warum“ der Punkt ist
- Wichtige Fakten
- Warum diese Art des Schweigens leicht übersehen wird
- Was Führungskräfte tun, um psychologische Sicherheit in KI-Teams aufzubauen
- Das Hinterfragen von KI selbst sichtbar vorleben
- Das Entdecken des Fehlers belohnen, nicht nur schnelles Liefern
- KI-Fehler jedes Mal schuldfrei behandeln
- „Ich traue dem nicht“ zu einem normalen Satz machen
- Die Gewohnheit aufbauen, nach dem „Warum“ zu fragen, nicht nur nach dem „Was“
- Ein kurzer Check: Hat Ihr Team das wirklich?
- Wie es weitergeht