KI-Content-Wiederverwendung: Aus einem Asset viele machen
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
KI-Content-Wiederverwendung bedeutet, ein umfangreiches Ausgangsmaterial, etwa eine Webinar-Aufzeichnung, einen Forschungsbericht oder einen langen Artikel, mit Hilfe von KI in mehrere kleinere, kanalspezifische Assets zu verwandeln: einen Zusammenfassungsartikel, eine Reihe von LinkedIn-Beiträgen, eine E-Mail, ein Skript für ein Kurzvideo, eine Foliengliederung. Die Methode, die funktioniert, ist ein Kreislauf aus vier Schritten: die Quelle transkribieren, ihre Aussagen und Zitate extrahieren, sie für jeden Kanal anpassen und von einem Menschen prüfen lassen, bevor etwas erscheint. In den ersten drei Schritten übernimmt die KI die mechanische Arbeit. Den vierten verantworten Menschen.
Für Content- und Kampagnenmanager liegt der Reiz auf der Hand. Ein einstündiges Webinar oder ein Report mit 30 Seiten enthält bereits die Expertise, die Daten und die Geschichten. Was fehlt, ist eine Form, die in einen Feed, ein Postfach oder ein Verkaufsgespräch passt. KI verkürzt die Zeit zwischen „Wir haben ein großartiges Asset“ und „Es wirkt an sechs Stellen“.
Wiederverwendung ist aber auch der Bereich, in dem KI-Inhalte am unauffälligsten schiefgehen. Eine Zusammenfassung kann sich von den Fakten entfernen. Ein Beitrag kann sich von Ihrer Markenstimme entfernen. Zehn nahezu identische Seiten können für eine Suchmaschine wie skalierter Füllstoff aussehen. Dieser Leitfaden gibt Ihnen den Prozess, eine Zuordnungstabelle zum Kopieren und die Qualitätschecks, die abgeleitete Inhalte veröffentlichungswürdig halten.
Warum sich Wiederverwendung für KI eignet (und wo nicht)
Wiederverwendung beginnt mit Material, das Sie bereits besitzen und freigegeben haben. Das ist sicherer, als ein Modell aus dem Nichts schreiben zu lassen, denn das Modell wandelt Text um, den Sie prüfen können, statt Fakten aus dem Gedächtnis abzurufen. Googles Leitfaden zu generativer KI macht die Unterscheidung direkt: Generative KI könne besonders nützlich sein, um ein Thema zu recherchieren und Originalinhalten Struktur zu geben, während das Erzeugen vieler Seiten ohne Mehrwert für Nutzer gegen die Spam-Richtlinie zu skaliertem Content-Missbrauch verstoßen könne.
Dieser Satz ist ein brauchbarer Test für jedes Wiederverwendungsprojekt. Fügen Sie etwas Originalem Struktur, Klarheit und einen neuen Blickwinkel hinzu? Oder produzieren Sie Masse?
Wichtige Fakten: KI-Content-Wiederverwendung
- Google sagt, generative KI könne nützlich sein, um ein Thema zu recherchieren und Originalinhalten Struktur zu geben, doch ihr Einsatz zum Erzeugen vieler Seiten ohne Mehrwert für Nutzer könne gegen die Spam-Richtlinie zu skaliertem Content-Missbrauch verstoßen (Google Search Central).
- Googles Leitfaden hält fest, dass generative Modelle eine wahrscheinliche Wortfolge vorhersagen, statt Fakten abzurufen, die Ausgaben also Ungenauigkeiten enthalten können, und bezeichnet die manuelle Faktenprüfung vor der Veröffentlichung als entscheidend (Google Search Central).
- Diese Prüfung gilt auch für Metadaten, die in Suchergebnissen erscheinen können: Title-Elemente, Meta-Beschreibungen, strukturierte Daten und Alt-Texte von Bildern (Google Search Central).
- Findet Google mehrere Seiten mit demselben oder sehr ähnlichem Hauptinhalt, bündelt es sie in einem Cluster und wählt eine als kanonische Seite; eine von Ihnen angegebene kanonische Präferenz ist ein Hinweis, keine Regel (Google Search Central).
- Weiterleitungen und rel="canonical"-Annotationen sind starke Canonical-Signale, die Aufnahme in die Sitemap ist ein schwaches (Google Search Central).
- Googles Spam-Richtlinie führt das erneute Veröffentlichen von Inhalten anderer Websites ohne eigenen Originalinhalt oder Mehrwert als missbräuchliches Scraping auf (Google Search Central).
Wo KI nicht passt: bei Quellen, die von Anfang an dünn sind. Wenn das Webinar unauffällig war, retten zehn abgeleitete Beiträge es nicht. Wiederverwendung vervielfacht, was in der Quelle steckt. Sie fügt nicht hinzu, was fehlt.
Die Methode in vier Schritten
Schritt 1: Einlesen und transkribieren
Alles Weitere hängt von einer sauberen Textfassung der Quelle ab. Bei Audio und Video heißt das ein Transkript mit Sprecherkennzeichnung und Zeitstempeln. Bei einem PDF-Report heißt es extrahierter Text plus eine getrennte Liste der Diagramme, Tabellen und Abbildungen, denn sie enthalten die Zahlen, die Menschen zitieren wollen.
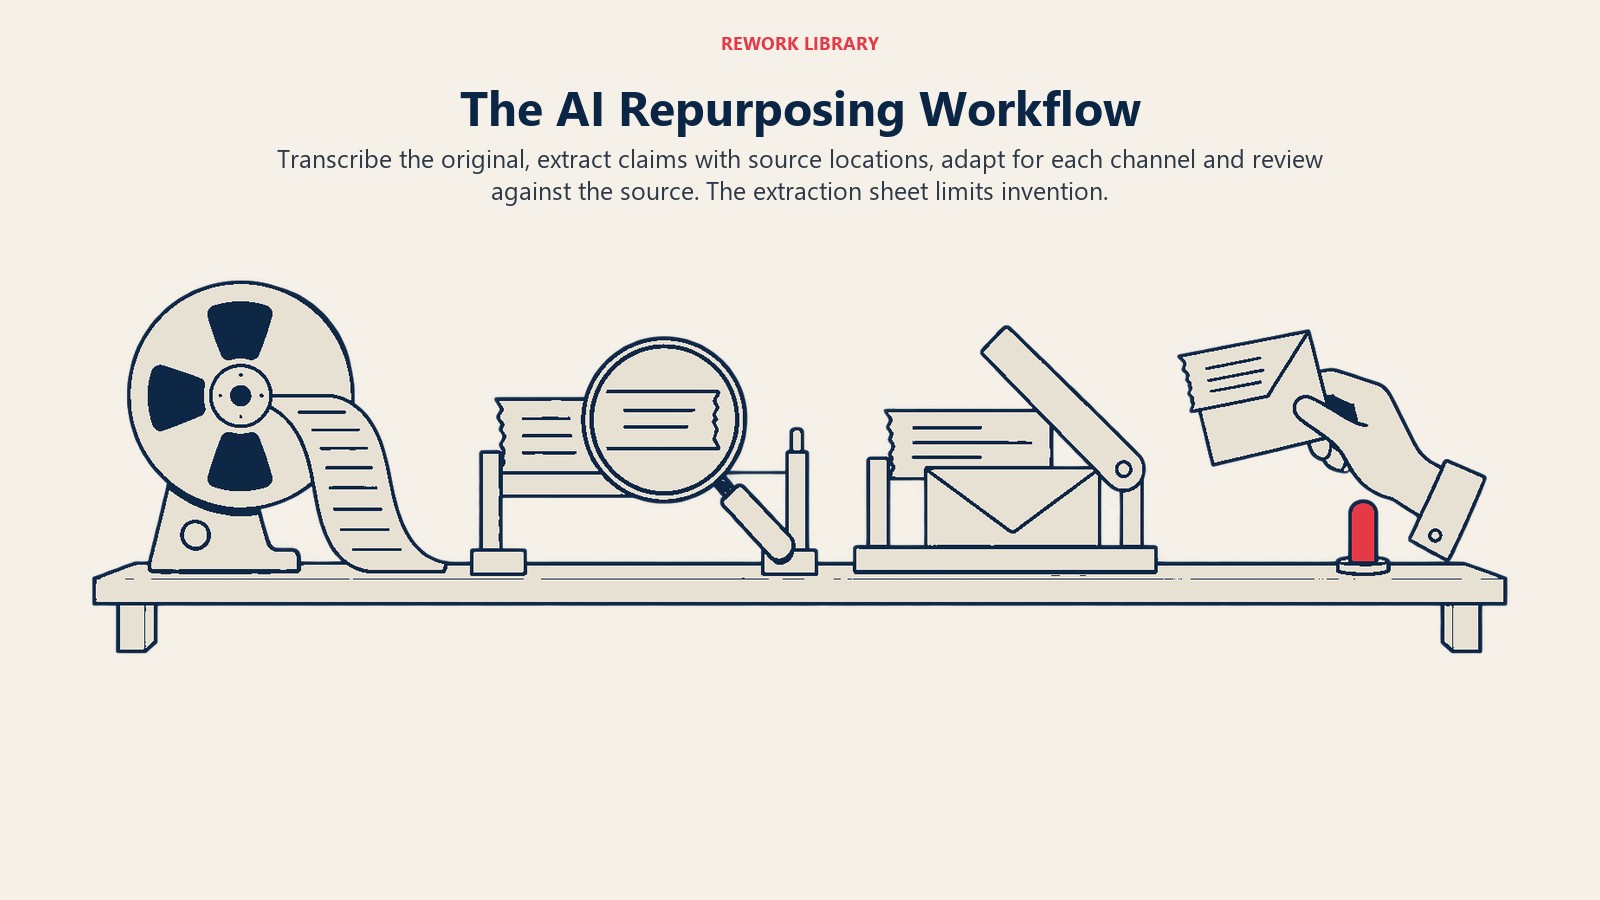
Zwei Gewohnheiten ersparen später Ärger:
- Behalten Sie das Transkript als einzige Wahrheitsquelle. Jedes abgeleitete Asset sollte auf eine Passage darin zurückführbar sein. Fragt ein Prüfer „Woher stammt diese Aussage?“, zeigen Sie auf einen Zeitstempel oder eine Seitenzahl.
- Korrigieren Sie Namen, Produktbegriffe und Zahlen zuerst im Transkript. Spracherkennungs-Tools stolpern über Eigennamen und Zahlen. Ein Fehler, den Sie einmal an der Quelle beheben, wird nicht in acht Assets kopiert.
Das ist die „Ingest“-Fähigkeit in der Praxis: unstrukturiertes Audio, Video und Dokumente in eine Form zu bringen, die der Rest Ihres Workflows nutzen kann.
Schritt 2: Extrahieren und analysieren
Bitten Sie das Modell nicht, „aus diesem Webinar in einem Zug einen LinkedIn-Beitrag zu schreiben“. Lassen Sie es zuerst das Rohmaterial in einer strukturierten Liste herausziehen:
- Die drei bis fünf Hauptargumente, jeweils in einem Satz
- Jede Statistik oder Tatsachenbehauptung, mit Zeitstempel oder Seite der Fundstelle
- Direkte Zitate, die sich wiederverwenden lassen, mit dem Namen des Sprechers
- Fragen des Publikums und die gegebenen Antworten
- Begriffe, die eine verständliche Definition brauchen
- Alles, was der Sprecher als Meinung statt als Tatsache geäußert hat
Dieses Extraktionsblatt ist das wertvollste Artefakt im Prozess. Es ist kurz genug, dass ein Mensch es in zehn Minuten prüfen kann, und es wird zur einzigen Eingabe, die der Anpassungsschritt verwenden darf. Ein Modell, das aus dem Blatt statt aus seiner eigenen Erinnerung an das Thema schreibt, hat weit weniger Spielraum zum Erfinden. Warum das wichtig ist, erfahren Sie unter KI-Halluzination.
Schritt 3: Je Kanal anpassen
Erzeugen Sie nun Entwürfe, Kanal für Kanal, jeweils aus dem Extraktionsblatt plus einem kurzen Kanal-Briefing. Das Briefing sollte festhalten:
- Zielgruppe und Aufgabe. Wer liest das, und was soll er als Nächstes tun?
- Formatgrenzen. Länge, Struktur, Handlungsaufforderungen.
- Regeln zur Markenstimme. Ihre Richtlinien zur Tonalität plus zwei oder drei freigegebene Beispiele. Wenn Sie noch keine schriftlichen Richtlinien haben, beginnen Sie mit den KI-Richtlinien zur Markenstimme.
- Blickwinkel. Jedes abgeleitete Asset sollte mit einem anderen Punkt aus dem Blatt beginnen. Zehn Beiträge, die alle mit derselben Erkenntnis eröffnen, sind ein einziger Beitrag, wiederholt.
- Quellenregel. „Verwende nur Aussagen aus dem Extraktionsblatt. Braucht ein Satz einen Fakt, der dort fehlt, markiere ihn mit [QUELLE FEHLT].“
Diese letzte Regel ist günstig und wirksam. Sie macht aus einer stillen Erfindung eine sichtbare Markierung.
Wenn Ihre abgeleiteten Assets Video enthalten, hat die Seite mit Kurzvideo-Skripten und Schnitt eigene Besonderheiten, die KI im Video-Marketing behandelt.
Schritt 4: Prüfen, bevor es erscheint
Ein menschlicher Prüfer kontrolliert jedes abgeleitete Asset anhand des Extraktionsblatts und des Originals. Was zu prüfen ist, behandelt der nächste Abschnitt. Das Prinzip ist einfach: Die KI entwirft, eine Person genehmigt, und nichts wird auf Zuruf eines Modells veröffentlicht.
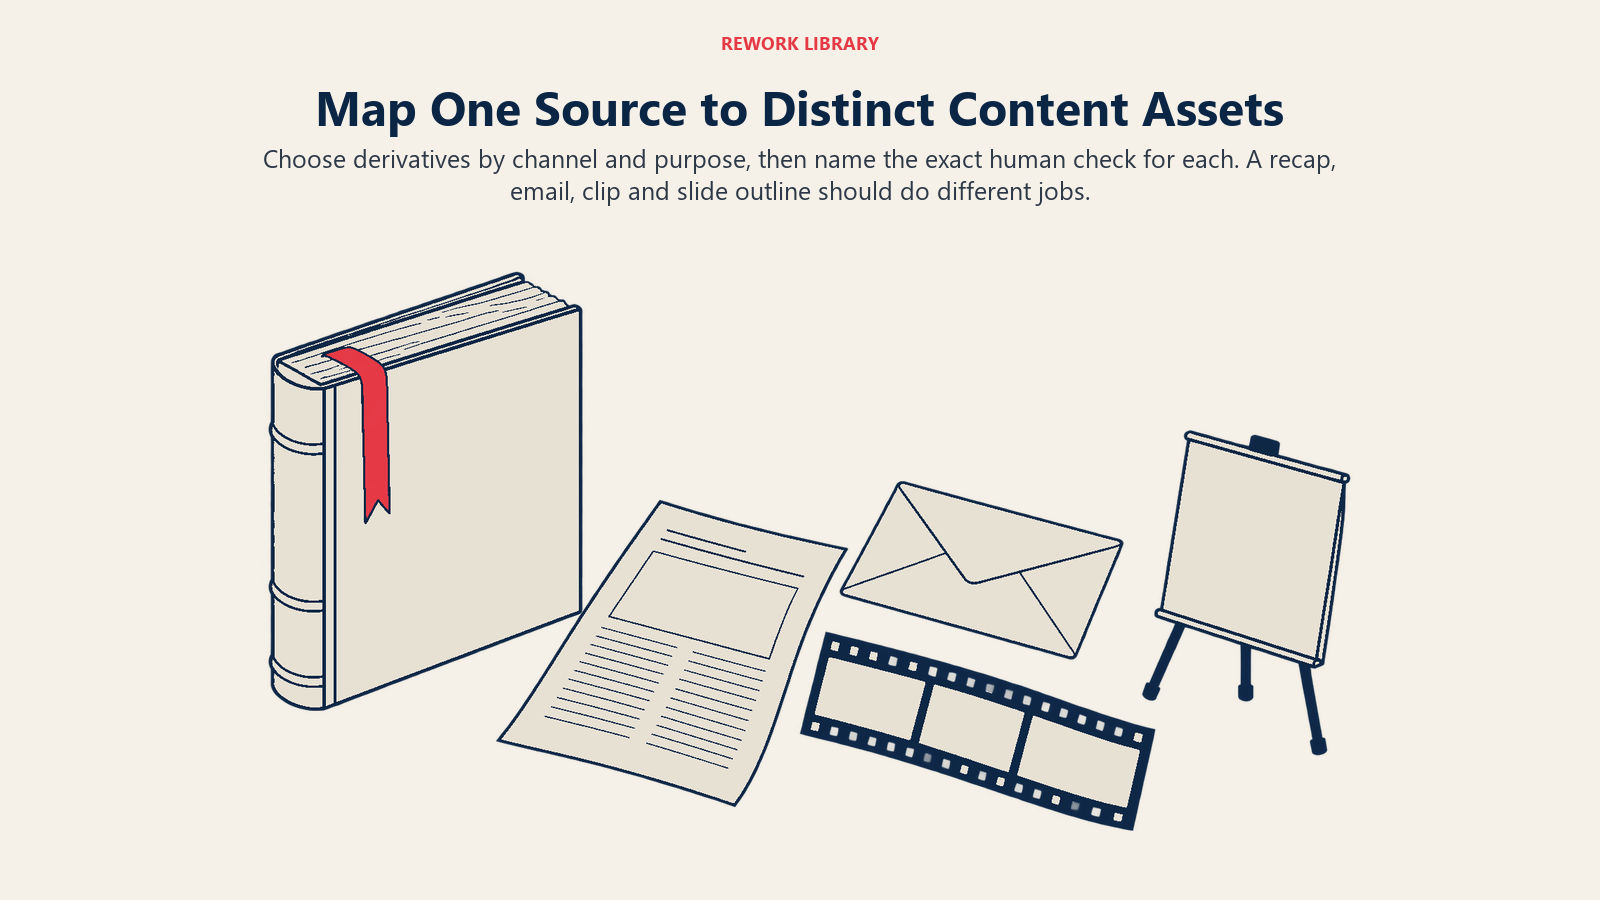
Eine Quelle, viele Assets: eine Zuordnungstabelle
Die folgende Tabelle zeigt, wie sich ein einzelnes Webinar auffächern könnte. Ersetzen Sie die Quelle durch einen Report oder einen langen Artikel, und die Form bleibt gleich. Entscheidend ist, dass jede Zeile benennt, was die KI tut und was der Mensch bestätigt.
| Abgeleitetes Asset | Kanal | KI-Schritt | Menschliche Prüfung |
|---|---|---|---|
| Zusammenfassungsartikel (800 bis 1.200 Wörter) | Blog | Entwurf aus dem Extraktionsblatt, gegliedert nach den Hauptargumenten | Jede Aussage und Zahl am Transkript prüfen; eine eigene Sichtweise ergänzen; Titel und Meta-Beschreibung selbst schreiben |
| Zitatkarten (3 bis 5) | LinkedIn, Instagram | Mögliche Zitate mit Zeitstempeln herausziehen; kurze Bildunterschriften vorschlagen | Wortlaut auf Wörtlichkeit prüfen; Freigabe des Sprechers für zugeordnete Zitate einholen |
| Beitragsreihe (4 bis 6 Beiträge) | LinkedIn, X | Je Hauptargument einen Beitrag entwerfen, jeweils mit anderem Aufhänger | Markenstimme anhand der Richtlinien prüfen; wiederholte Einstiege entfernen; sicherstellen, dass keine Aussage über das hinausgeht, was der Sprecher gesagt hat |
| E-Mail für das Nurturing | Die zwei wichtigsten Argumente zu einer kurzen E-Mail mit einer Handlungsaufforderung verdichten | Angebot, Links und Compliance-Formulierungen prüfen; Betreffzeile testen | |
| Skripte für Kurzvideos (2 bis 3) | Social Video | Die in sich geschlossensten Segmente von 30 bis 60 Sekunden finden; Untertitel entwerfen | Prüfen, ob jeder Clip auch ohne Kontext Sinn ergibt; Untertitel mit dem Ton abgleichen |
| Foliengliederung | Sales Enablement | Argumente und Datenpunkte in eine Gliederung Folie für Folie umwandeln | Vertriebsleiter bestätigt, dass sie zu seinem tatsächlichen Pitch passt; die Quelle jedes Diagramms prüfen |
| FAQ-Block | Webseite, Vertriebsunterlagen | Fragen und Antworten des Publikums in saubere Frage-Antwort-Paare überführen | Fachexperte bestätigt, dass die Antworten noch aktuell sind |
| Notizen zu Podcast- oder Audio-Ausschnitten | Show Notes | Mit Zeitstempeln und einer Liste der erwähnten Links zusammenfassen | Prüfen, dass jede verlinkte Ressource existiert und das aussagt, was Sie behaupten |
| Internes Briefing | Vertrieb und Support | Zentrale Aussagen und vorgebrachte Einwände zusammenfassen | Produkt oder Recht bestätigt, dass nichts zu viel verspricht |
Beachten Sie, dass die Spalte „Menschliche Prüfung“ nie „überfliegen“ lautet. Sie benennt, was eine Person konkret bestätigen muss. Das macht die Prüfung im gesamten Team schnell und einheitlich.
Die wichtigsten Qualitätschecks
Faktendrift
Faktendrift entsteht, wenn sich eine Aussage bei jedem Umschreiben ein wenig verändert. „Viele Teams berichteten von Verbesserungen“ wird zu „die meisten Teams verzeichneten große Verbesserungen“ und dann zu „Teams erzielen dreifache Ergebnisse“. Kein einzelner Schritt wirkt wie Lügen, doch das Endergebnis entspricht nicht dem, was die Quelle sagte.
Beugen Sie vor, indem Sie jedes abgeleitete Asset mit dem Extraktionsblatt vergleichen, nicht mit dem vorherigen Entwurf. Prüfen Sie Zahlen Zeichen für Zeichen. Prüfen Sie, ob Einschränkungen erhalten blieben: „in unserer Stichprobe“, „bei Enterprise-Accounts“, „im Jahr 2026“. Und denken Sie daran, dass Googles Leitfaden rät, alle KI-generierten Inhalte vor der Veröffentlichung manuell auf Fakten zu prüfen, einschließlich Metadaten wie Titel, Meta-Beschreibungen, strukturierte Daten und Alt-Texte von Bildern. Bei einem wiederverwendeten Beitrag werden diese Felder oft zuletzt ausgefüllt und am wenigsten geprüft.
Drift der Markenstimme
Modelle tendieren zu einem generischen, geglätteten Register. Über eine Reihe abgeleiteter Assets hinweg verflacht Ihre eigene Stimme allmählich, und Leser merken es, auch wenn sie nicht sagen können, warum. Prüfen Sie einen Stapel nebeneinander, nicht einzeln. Wenn drei Beiträge von jedem Unternehmen Ihrer Kategorie stammen könnten, schreiben Sie die Eröffnungszeilen von Hand um. Ein Prompt allein löst das selten; ein Vorher-nachher-Beispiel aus Ihrem eigenen Archiv hilft mehr. Die tiefere Methode steht in den KI-Richtlinien zur Markenstimme, die Prompting-Seite behandelt Prompt Engineering.
Duplikate und Canonical-Überlegungen
Wenn Sie einen Zusammenfassungsartikel, eine längere Fassung davon und eine Transkriptseite veröffentlichen, entstehen womöglich mehrere URLs mit nahezu identischem Hauptinhalt. Googles Dokumentation erklärt, dass es Seiten mit demselben oder sehr ähnlichem Hauptinhalt in einem Cluster bündelt und eine als kanonische auswählt. Etwas Duplizierung auf einer Website ist normal und kein Verstoß gegen die Spam-Richtlinien, kann aber Leser verwirren und die Erfolgsmessung erschweren.
Praktische Regeln:
- Lassen Sie jede Seite ihre eigene URL verdienen. Eine Zusammenfassung, ein Deep-Dive und ein Transkript sollten sich in Zweck und Tiefe unterscheiden. Lassen sich zwei Seiten ohne Verlust zusammenführen, führen Sie sie zusammen.
- Wählen Sie die Seite, die ranken soll, und signalisieren Sie das. Weiterleitungen und rel="canonical"-Annotationen sind starke Signale; die Aufnahme in die Sitemap ist ein schwaches. Bedenken Sie, dass es weiterhin ein Hinweis und keine Anweisung ist, sorgen Sie also auch für echte inhaltliche Unterschiede.
- Bleiben Sie konsequent. Verlinken Sie intern auf die URL, die Sie als kanonisch ansehen, und senden Sie für dieselbe Seite keine widersprüchlichen Canonical-Signale.
- Gehen Sie mit syndizierten Kopien sorgsam um. Wenn Sie einen Artikel auf einer anderen Website erneut veröffentlichen, bringt die Kopie nichts, solange sie nicht auf die Quelle verweist. Googles Spam-Richtlinie nennt das erneute Veröffentlichen von Inhalten anderer Websites ohne eigenen Originalinhalt oder Mehrwert missbräuchliches Scraping, daher sollten Partner und Ihre eigenen Zweitangebote klar auf die Quelle zurückverlinken.
- Social-Media-Beiträge sind nicht das Problem. Kurze Beiträge auf Social-Plattformen sind andere Formate auf anderen Oberflächen. Bei der Frage nach doppeltem Content geht es vor allem um Seiten im offenen Web.
- Übersetzte Fassungen sind etwas anderes. Google behandelt Sprachfassungen nur dann als Duplikate, wenn der Hauptinhalt in derselben Sprache vorliegt. Eine echte Übersetzung des Haupttextes ist also kein Duplikat, eine Seite mit nur übersetztem Kopfbereich dagegen schon. Siehe Googles Überblick zur Kanonisierung.
Offenlegung und Kontext
Googles Leitfaden legt nahe, dass die Offenlegung der Entstehung von Inhalten Ihren Lesern mehr Kontext geben kann, zum Beispiel durch Hintergrund dazu, wie Automatisierung eingesetzt wurde. Für Blogtexte gibt es keine einheitlich vorgeschriebene Kennzeichnung, legen Sie also Ihre eigene Regel fest und wenden Sie sie konsequent an. Ein dezenter Hinweis auf Seiten, deren Entwurf wesentlich von KI geprägt wurde, ist eine vernünftige Option, und zitierte Sprecher sollten stets mit Namen genannt werden.
Manche Regeln sind verbindlicher. Für E-Commerce sagt Google, dass das Merchant Center eigene Richtlinien für KI-generierte Inhalte hat, darunter Bildmetadaten und die Kennzeichnung KI-generierter Produktdaten, laut derselben Leitfadenseite. Prüfen Sie die Regeln jeder Plattform, auf der Sie veröffentlichen, und holen Sie bei regulierten Aussagen rechtlichen Rat ein.
Ein weiterer Punkt zur Offenlegung wird leicht übersehen: die Einwilligung von Sprechern und Kunden. Eine Webinar-Aufzeichnung gibt Ihnen womöglich keine Erlaubnis, das Zitat eines Kunden in eine Social-Grafik zu schneiden. Klären Sie die Nutzungsrechte, bevor Sie die Worte eines Menschen zu einem neuen Asset machen.
Beispiele nach Marketingfunktion
Hier sind Illustrationen dafür, wie verschiedene Teams den Kreislauf anwenden könnten. Es sind hypothetische Szenarien, keine Fallstudien.
- Content-Marketing. Ein Team veröffentlicht einen jährlichen Benchmark-Report. Es extrahiert die fünf wichtigsten Ergebnisse und gibt jedem einen eigenen kurzen Artikel, einen Diagramm-Beitrag und einen Newsletter-Abschnitt, die alle auf den vollständigen Report zurückverlinken. Die breitere Planungssicht finden Sie im Workflow für KI im Content-Marketing.
- Demand Generation. Ein B2B-Softwareteam könnte ein Webinar mit einem Kundenpanel in eine Nurture-Serie aus drei E-Mails verwandeln, jede aufgebaut um einen Einwand, den die Panelisten behandelt haben.
- Produktmarketing. Ein Launch-Briefing wird zu einem One-Pager für Sales Enablement, einer FAQ und einem kurzen Dokument zur Einwandbehandlung, alle aus demselben Extraktionsblatt gezogen, damit die Aussagen übereinstimmen.
- Events. Eine Konferenz-Keynote ergibt einen Zusammenfassungsbeitrag, ein Clip-Paket für den Sprecher und eine Nachfass-E-Mail für Teilnehmer, die die Session verpasst haben.
- Kundenmarketing. Ein langes Kundeninterview wird zu einer Zitatbibliothek. Jedes Zitat wird vom Kunden freigegeben, bevor es irgendwohin geht.
Schritt für Schritt: den Workflow einrichten
- Wählen Sie das Ausgangsasset. Nehmen Sie etwas Originales, Umfangreiches und kürzlich Freigegebenes. Meiden Sie Assets mit ungeklärten rechtlichen oder inhaltlichen Fragen.
- Prüfen Sie die Rechte. Klären Sie, wer in der Aufzeichnung auftritt und was Sie wiederverwenden dürfen. Holen Sie für namentlich genannte Zitate eine schriftliche Freigabe ein.
- Transkribieren und bereinigen. Korrigieren Sie Namen, Produktbegriffe und Zahlen. Ergänzen Sie Zeitstempel oder Seitenverweise.
- Erstellen Sie das Extraktionsblatt. Argumente, Aussagen mit Fundstelle, Zitate, Publikumsfragen, als Meinung gekennzeichnete Meinungen. Lassen Sie den Eigentümer der Quelle es prüfen.
- Legen Sie die Menge der abgeleiteten Assets fest. Nutzen Sie die Zuordnungstabelle oben. Wählen Sie die drei bis sechs aus, die zu Ihrer Zielgruppe und Ihrer Kapazität passen. Mehr ist nicht besser.
- Schreiben Sie Kanal-Briefings. Ein kurzes Briefing pro Kanal, mit Zielgruppe, Format, Regeln zur Markenstimme und der Regel „nur das Blatt verwenden“.
- Entwürfe erzeugen, dann redigieren. Geben Sie jedem abgeleiteten Asset einen eigenen Blickwinkel. Redigieren Sie die Markenstimme dort von Hand, wo es am meisten zählt, meist in der ersten und letzten Zeile.
- Gehen Sie die Prüf-Checkliste durch. Fakten gegen das Blatt, Markenstimme gegen die Richtlinien, Links funktionsfähig, Metadaten geprüft, Rechte geklärt, Entscheidungen zu Duplikaten getroffen.
- Legen Sie Canonical und interne Verlinkung fest. Entscheiden Sie, welche Seite die primäre ist, verlinken Sie abgeleitete Assets auf sie zurück und vermeiden Sie nahezu identische Seiten.
- Planen und messen. Staffeln Sie die Veröffentlichung, damit sich die Geschichte über Wochen entfaltet. Verfolgen Sie den Beitrag jedes Assets, behalten Sie die Formate, die Aufmerksamkeit erzeugen, und stellen Sie die anderen ein.
Wenn Sie noch am größeren Content-Programm arbeiten, zu dem diese Assets gehören, ist die KI-Content-Strategie die naheliegende Ergänzung, und KI-Marketing-Anwendungsfälle nach Funnel-Phase zeigt, wo jedes abgeleitete Asset im Weg des Käufers einzuordnen ist.
Häufige Fallstricke
- Das Extraktionsblatt überspringen. Wer direkt aus dem Transkript promptet, lädt das Modell ein, Lücken aus dem Gedächtnis zu füllen.
- Masse zum Ziel machen. Zehn dünne abgeleitete Assets sind schlechter als drei gute, und in großer Zahl ähneln sie dem Muster, das Googles Spam-Richtlinie beschreibt.
- Identische Aufhänger. Wenn jedes Asset mit derselben Erkenntnis beginnt, sieht das Publikum Wiederholung statt einer Kampagne.
- Kontext entfernen. Eine aus einer Folie herausgelöste Statistik ohne Datum, Stichprobe oder Definition wird als eigenständiger Beitrag irreführend.
- Die Metadaten vergessen. Titel, Beschreibungen und Alt-Texte sind ebenfalls veröffentlichte Inhalte und brauchen dieselbe Prüfung.
- Kein Verantwortlicher für die Prüfung. Wenn „alle“ prüfen, prüft niemand. Benennen Sie pro Asset einen verantwortlichen Prüfer.
- Duplikate ohne Plan veröffentlichen. Legen Sie die kanonische Seite fest, bevor Sie nahezu identische Fassungen veröffentlichen, nicht erst, nachdem sich der Traffic aufgeteilt hat.
- Die Einwilligung ignorieren. Ein aufgezeichneter Gast hat einem Webinar zugestimmt, nicht unbedingt einer Zitatgrafik mit seinem Gesicht.

Principal Product Marketing Strategist
On this page
- Warum sich Wiederverwendung für KI eignet (und wo nicht)
- Die Methode in vier Schritten
- Schritt 1: Einlesen und transkribieren
- Schritt 2: Extrahieren und analysieren
- Schritt 3: Je Kanal anpassen
- Schritt 4: Prüfen, bevor es erscheint
- Eine Quelle, viele Assets: eine Zuordnungstabelle
- Die wichtigsten Qualitätschecks
- Faktendrift
- Drift der Markenstimme
- Duplikate und Canonical-Überlegungen
- Offenlegung und Kontext
- Beispiele nach Marketingfunktion
- Schritt für Schritt: den Workflow einrichten
- Häufige Fallstricke