チームメイトがAIのとき、信頼をどう築くか
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
AIチームメイトを信頼するとは、その成果物にどれだけ頼るかを、聞こえ方の自信ではなく、特定のタスクで実際にどれだけ信頼できるかを示す証拠に合わせて較正することです。これは同僚を信頼することとは別のスキルです。AIには欺く意図もなく、間違えたときに危うくなるキャリアもないため、人が誰を信じるかを判断するときに普段使う2つのシグナルが失われるからです。
「AIを信頼する」ことに関するアドバイスの多くは、すぐに方針の話へ飛びます。利用ガイドラインを書き、開示ルールを加えれば完了、というわけです。それは必要ですが、難しいのはそこではありません。人のチームメイトへの信頼と、AIのチームメイトへの信頼は、ほとんど完全に異なる仕組みで動いており、その違いを見逃したチームは、コストのかかる2つの失敗パターンのどちらかに陥ります。AIが手を付けたものをすべて黙ってやり直すか、自信たっぷりに間違っている成果物を形だけの承認で通してしまうかです。この記事では、仕組みが異なる理由、2つの失敗パターンとその裏づけとなる調査、実践における較正された信頼の姿、それを実際に育てるもの、そしてそれを持続させるチームの規範を取り上げます。
AIを信頼することが、人を信頼することと違う問題である理由
人間の信頼は、単純でよく研究された土台の上に築かれます。相手の能力、誠実さ、そして自分の利益を気にかけているかどうか(善意)を、パターンが見えてくるだけの十分な数の場面にわたって観察するのです。このモデルは、職場で信頼を築く方法で詳しく取り上げています。この仕組みが機能するのは、人には意図があるからです。人はあなたを欺くことを選べますし、見つかる可能性、つまり評判を失うコストがあることが、ほとんどの人を誠実に保つ要因の一部です。
AIシステムには、その仕組みのどちらの部分もありません。間違えたときに、あなたを惑わせるつもりはなく、守るべき評判も、かかっているキャリアもありません。それは道徳的な欠陥ではなく、単に異なる種類のシステムだということですが、人が普段誰を信頼するかを判断する近道(この人は善意があるか、成果を出せなかったら失うものがあるか)は、そもそも当てはまりません。評価するのは、同僚というよりも測定器に近いものです。どれだけ正確か、どんな条件で、そしてドリフトしたことにどうやって気づくか、ということです。
自信たっぷりに間違っているのは、自信たっぷりに正しいのと見分けがつかない
より鋭い問題は、提示のされ方です。答えに自信がない人は、たいてい言葉の濁し方、口調、ボディランゲージでそれを示します。大規模言語モデルは、でっち上げの引用、間違った数字、存在しない発言を、正しいものとまったく同じ、流暢で確信に満ちた調子で出力します。これがAIのハルシネーションの中核にある仕組みです。システムは嘘をついているのではなく、もっともらしい文章を生成しているのであり、もっともらしいことと真実であることは、同じ性質ではありません。出力がどれだけ自信ありげに聞こえるかは、どちらを見ているのかを何も教えてくれません。
この1つの事実こそ、AIへの信頼が、人への信頼の延長ではありえない理由です。テストによる証拠、特定のタスクでの実績、確認できる出典といった外部のシグナルが必要になります。人間が自信を読み取るときに本能的に使う内部のシグナルは、実際の信頼性から切り離されてしまっているからです。
2つの失敗パターン:過小信頼と過信
意図的なアプローチを持たないチームは、中間には落ち着きません。2つの極端のどちらかに振れ、どちらも異なる形でコストがかかります。
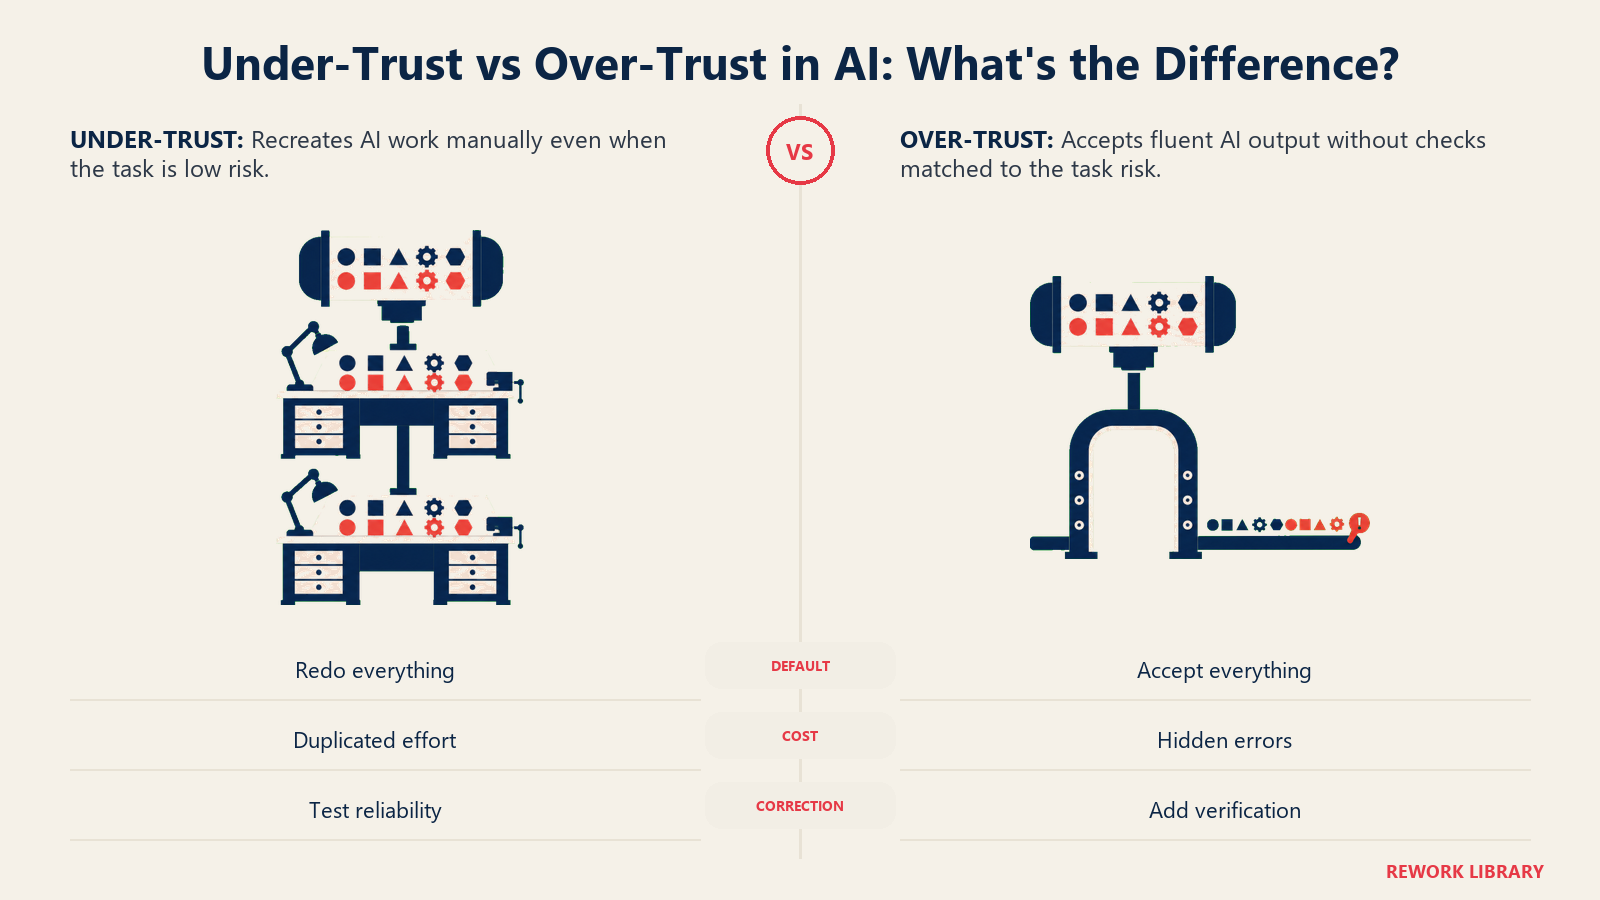
過小信頼:エージェントの仕事を手作業でやり直す
過小信頼は、表面上は責任ある態度に見えます。マネージャーが、システムをまったく信頼していないかのような厳しさで、エージェントが作り出す一行一行をレビューし、事実上、仕事を二度行っています。それは、AIが生み出すはずだった生産性の向上を打ち消します。下書きの確認にゼロから書くのと同じ時間がかかるなら、組織はアウトプットを何も変えずにツールを追加しただけです。そして二重チェックを担う人は、いずれ燃え尽きるか、静かにやめてしまい、過信の問題を解決するのではなく先送りするだけになります。
過小信頼が最も強く表れるのは、AIツールで最初に1度苦い経験をし、その後見直されなかったチームです。顧客向け資料にハルシネーションによる事実が1つ紛れ込んで恥をかいただけで、ツールが改善した後でも、AIの成果物に頼ろうとするチームの意欲が1年間凍りつくことがあります。
過信:自動化バイアスと、確認を省くコスト
過信、あるいは自動化バイアスとは、自動化されたシステムの出力に、証拠が裏づける以上の重みを与え、システムが数回正しかったというだけで検証をやめてしまう傾向のことです。航空や安全に関する数十年にわたる研究にさかのぼる、人と自動化の研究で最もよく記録された失敗パターンの一つであり、AIシステムが改善するにつれて、改善されるどころか悪化します。95%の確率で正しいシステムは、残りの5%を人が確認しなくなるのに十分な自信を生むからです。
2023年にRadiology誌に掲載された研究は、これがどれほど深刻になりうるかを数字で示しました。研究者は27人の放射線科医に50枚のマンモグラフィを読影させ、一部にはAIシステムによるBI-RADS分類の提案を添えました。AIの提案が間違っていたとき、経験の浅い放射線科医の精度は、およそ80%から20%未満にまで落ち込みました。15年を超える経験を持つ放射線科医も例外ではなく、精度は82%から45.5%に低下しました。経験は被害を減らしましたが、なくすには遠く及びませんでした。
これは臨床の場面ですが、同じ仕組みは、ごく普通の知的労働にも、より軽い名前で現れます。ワークスロップです。BetterUp LabsとStanfordのSocial Media Labが2025年9月に米国のフルタイム労働者1,150人を対象に行った調査では、40%が前の月に「ワークスロップ」、つまり見た目は洗練されているものの、タスクを前に進める中身を欠いたAI生成コンテンツを受け取っていました。1件あたり平均2時間の対応を要し、推定コストは従業員1人あたり月186ドル、従業員10,000人規模の会社では年間およそ900万ドルにのぼります。ワークスロップは、実践における過信です。誰かがエージェントの下書きを額面どおりに受け入れ、そのまま回し、実際の検証を次に受け取る人に任せたのです。
重要な事実
- 27人の放射線科医が50枚のマンモグラフィを読影した研究で、AIシステムの提案が誤っていたとき、マンモグラフィ読影の精度は、経験の浅い読影者でおよそ80%から20%未満に、経験15年以上の読影者でも82%から45.5%に低下しました。出典:Automation Bias in Mammography, Radiology (RSNA), via EurekAlert
- 調査対象の米国フルタイム労働者1,150人のうち40%が、前の月にAI生成の「ワークスロップ」を受け取っており、1件あたり平均2時間の修正コスト、推定で従業員1人あたり月186ドル、従業員10,000人規模の会社では年間約900万ドルにのぼります。出典:BetterUp Labs, "Workslop"
- 経営幹部の60%がすでに意思決定にAIを使っていますが、うまく管理できていると答えるのは5%にとどまり、Deloitteはこのギャップを、組織の「カルチャー負債」の要因として挙げています。出典:Deloitte 2026 Global Human Capital Trends
- リーダーの56%が、ビジネス成果のみを目的にAIを設計しており、ビジネスと人の両方の成果を目的に設計しているのは40%にとどまります。また、42%の働き手が、自社はAIの人への影響をまったく評価していないと答えています。出典:Deloitte 2026 Global Human Capital Trends
- マネージャーが自らのAI利用を目に見える形でお手本として示したとき、従業員はエージェント型AIへの信頼が30ポイント上昇したと報告し、セーフティネットに支えられた高頻度ユーザーになる可能性が1.4倍高まりました。出典:Microsoft Work Trend Index 2026
較正された信頼:具体性を伴う「信頼するが検証する」
人と自動化の相互作用を研究する研究者は、2つの失敗パターンの間にある目標の状態を、較正された信頼(適切な依存とも呼ばれます)という言葉で表します。証拠がシステムは信頼できると示すときにはその出力を受け入れ、そうでないと示すときには異を唱える。それを、一律の方針ではなく、タスクごとに行うということです。ここで重要な区別は、信頼と依存の違いです。信頼とは、人がそのシステムについて信じていると語ることであり、依存とは、その出力を実際にどう扱うかです。調査は、この2つが乖離することを一貫して明らかにしています。AIツールを完全には信頼していないと言いながら、確認せずにその出力に基づいて行動することは起こります。検証には労力がかかり、最も楽な道は受け入れることだからです。
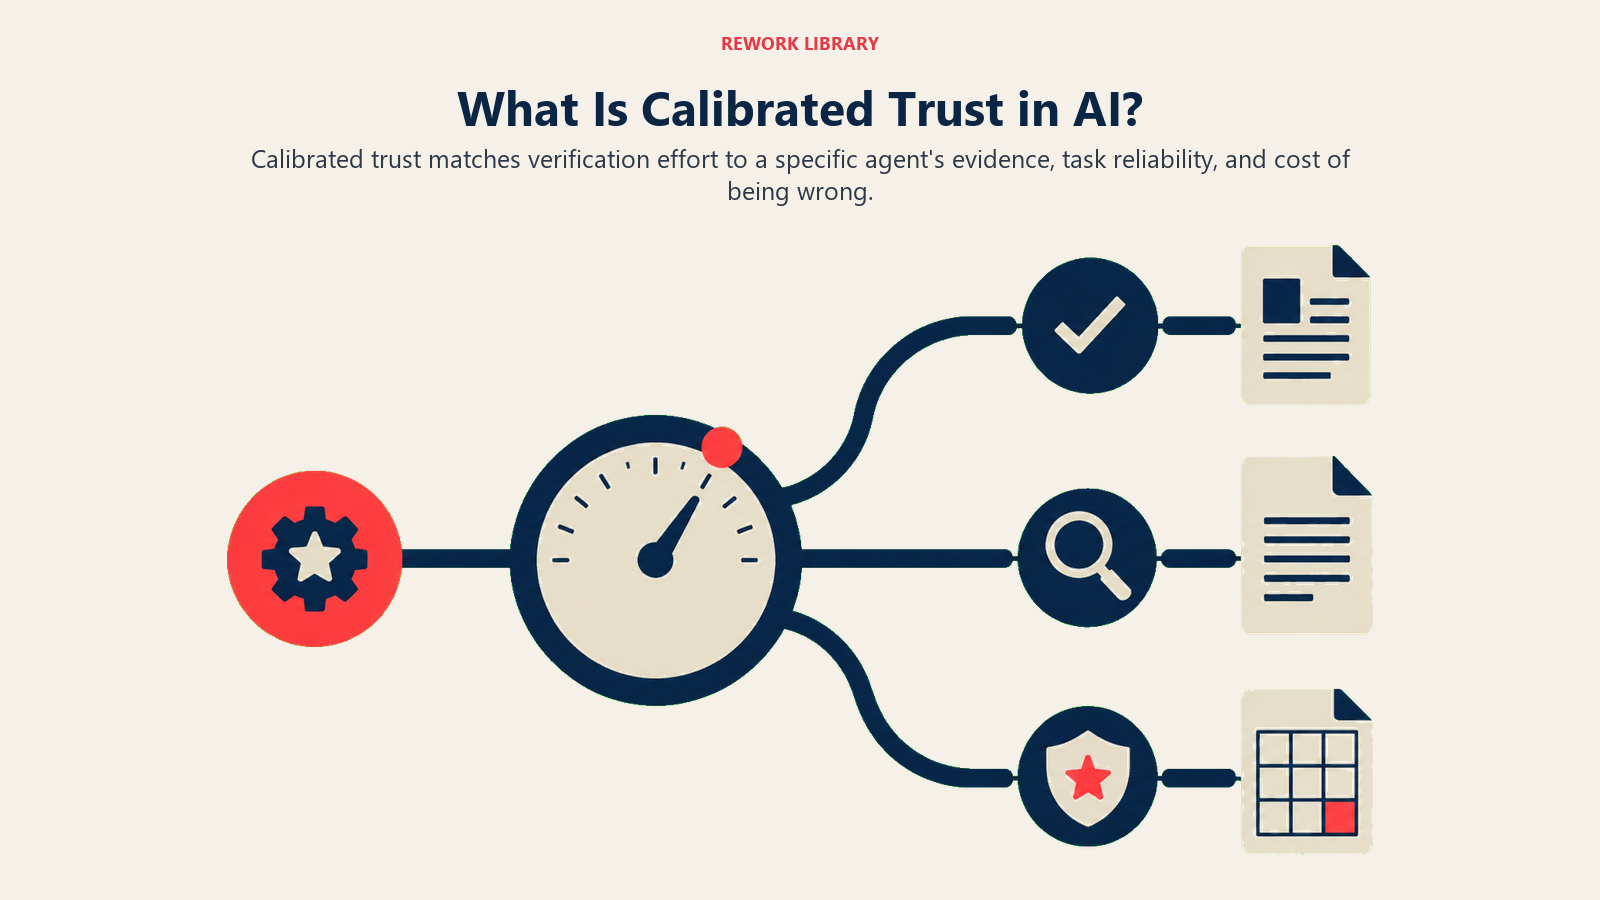
較正が機能するのは、ツール全体ではなく、タスクごとに具体的に行うときだけです。会議の議事録の最初のたたき台を確実に作成するエージェントと、同じモデルに財務予測の計算や判例の引用をさせる場合とでは、信頼性のプロファイルがまったく異なります。「AIを信頼するか」は、間違った問いです。「このエージェントを、このタスクで、実際に何を正しく、何を間違えるのを見てきたかに基づいて、信頼するか」が、役に立つ問いです。
エージェントが信頼できる場面と、そうでない場面を知る
そのタスクレベルの全体像を作るには、直感ではなく、意図的な記録が必要です。エージェントが定型メールの最初のドラフトは見事にこなすのに、調査要約では統計を頻繁にでっち上げることに、チームが静かに気づいているなら、誰も書き留めていなくても、それは本物の較正の作業をしたことになります。ほとんどのチームに欠けているのは気づきではなく、その知識を一人の頭の中に置いたままにせず、明示して共有することです。そうすれば、新入社員が、チームの他の人々がすでに避けるようになった過信の間違いを繰り返さずに済みます。
日々の検証とは具体的にどういうものか
具体的には、文書を社外に出す前に出典付きの主張を抜き打ちで確認すること、エージェントが出した数字を既知のベースラインに照らして妥当性を確認すること、最初のドラフトを、そのまま転送するものではなく、編集するためのドラフトとして扱うことです。そのどれも、ゼロから仕事をやり直す必要はなく、そこが較正された信頼と過小信頼を分けるところです。エージェントが弱いと分かっている部分には的を絞った確認を行い、強いと分かっている部分には自信を持って受け入れます。
適切なAIへの信頼を育てるもの
チームを当て推量から較正へと確実に移行させるものが4つあり、そのどれも、1回限りの研修ではありません。
透明性。 出典を示し、確信度にフラグを立て、取ったステップを説明するエージェントは、人に評価できる本物の材料を与えます。洗練された最終回答を、信じて受け入れるか退けるかしかできない状態とは違います。推論や引用が見えるツールを使うチームは、きれいに見える結果だけを返すブラックボックスに頼るチームより、早く較正できる傾向があります。
実績。 新入社員への信頼は、数週間にわたって実際の状況への対処を見ることで築かれます。エージェントへの信頼も同じように築くべきです。特定のタスクの種類で、何を正しく、何を間違えたかを正直に記録することで築くのであり、1週目のパフォーマンスが12週目を予測すると想定するのではありません。
ガードレール。 間違いのコストに上限があると、信頼は広げやすくなります。送信ではなく下書き、支払いの実行ではなく推奨、チケットの自動クローズではなくフラグ付けに権限を絞ったエージェントは、取り返しのつかないことが起こる前に、人が検証する余地を与えます。その権限の絞り方は、AIエージェントのガードレールで詳しく取り上げています。
デフォルトではなく、設計としてのヒューマン・イン・ザ・ループ。 エラーが最も重要な場所にチェックポイントを意図的に置いたワークフローと、昔からそうしてきたからという理由で、人がなんとなく出力にざっと目を通すだけのワークフローとの間には、大きな違いがあります。うまく行われるヒューマン・イン・ザ・ループは、あらゆる場所ではなく、最もレバレッジの高い地点にチェックポイントを置きます。あらゆる場所に置こうとすることこそが、そもそも過小信頼という失敗パターンを引き起こすのです。
チームと文化の観点:いつ確認するかの共有された規範
上記のどれも、一人の慎重な人の頭の中にあるだけでは機能しません。ほとんどのチームで実際に破綻するのは、エージェントの出力を検証すべきだと誰も知らないことではなく、「誰が、何を、いつ確認するのか」についての共有された明確な答えがないことです。だから全員が自分の直感に従い、直感は大きくばらつきます。ある人はすべてを抜き打ちで確認し、別の人はエージェントのドラフトを見直しなしに回します。どちらも文書化された規範には従っていません。そんなものは存在しないからです。
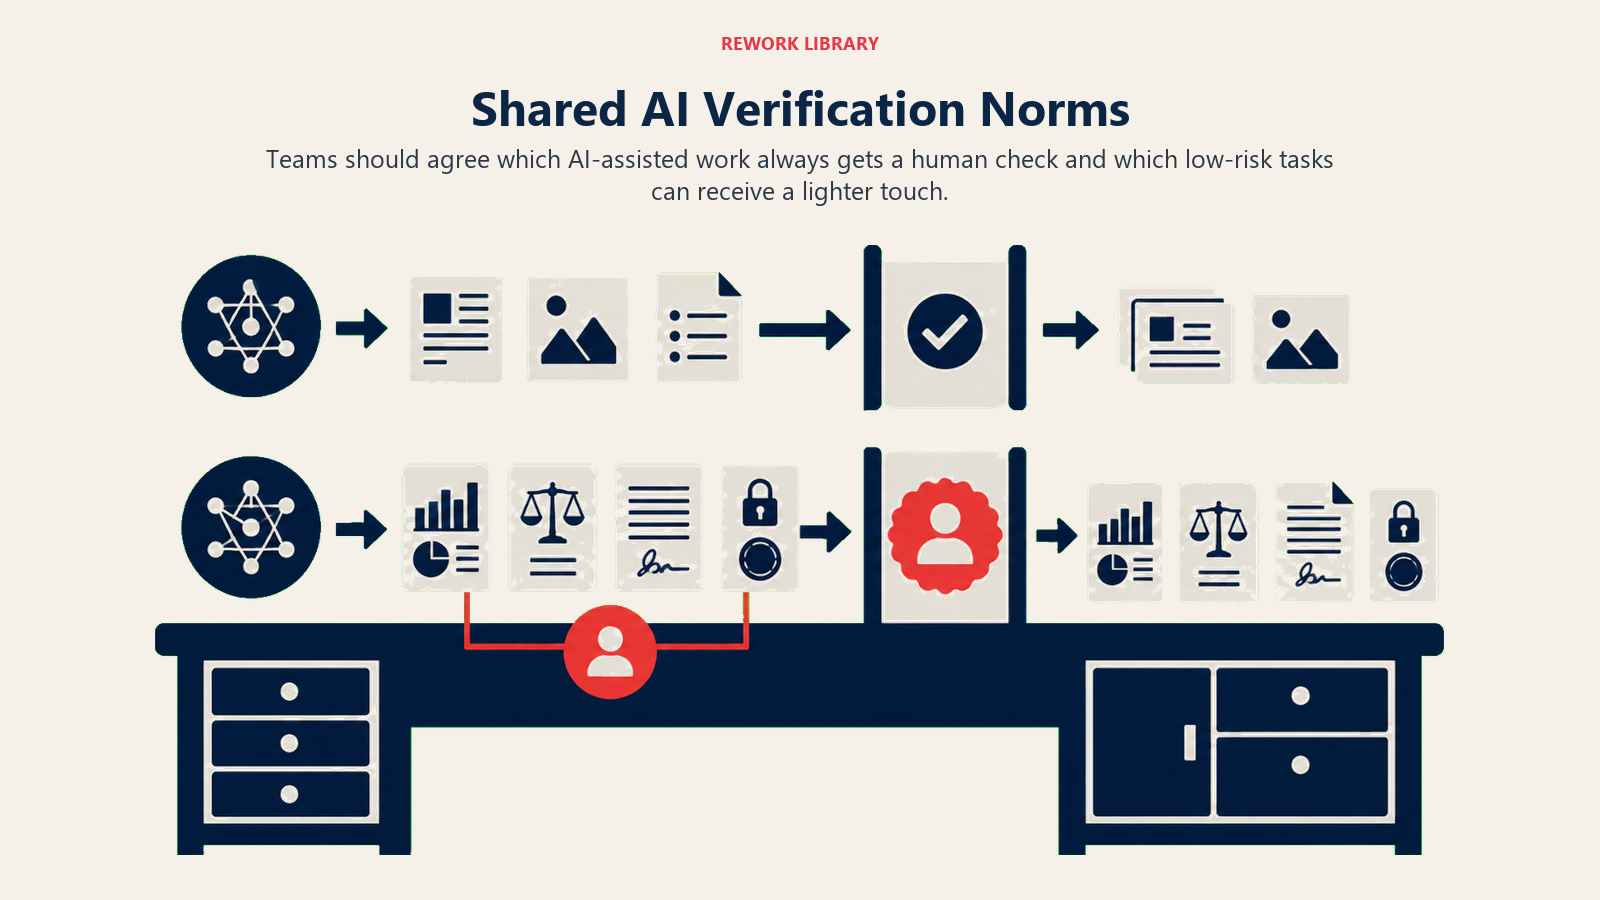
これはツールの問題ではなく、まぎれもなく文化の問題です。AIエチケットと職場の規範では、開示や適切な利用をめぐってチームが折り合いを付けつつある、より広い不文律を取り上げています。信頼に特化したバージョンとは、社外に出る前に必ず人のチェックを受けるべき仕事の種類(顧客向けの数字、法務の文言、取り返しのつかないすべてのもの)と、軽いチェックで済む程度にリスクの低い種類とを、声に出して合意することを意味します。この線引きをどちらの方向に誤っても、上の2つの失敗パターンの一つを、個人ではなくチームのレベルで再現することになります。
エージェントが一人の人が操作するツールではなくなり、チームの実際の成果物の一部として動きはじめるにつれ、同じ規範はより重要になります。この変化は人とエージェントのチームで取り上げています。共有された信頼の規範を持たないチームは、派手に失敗することはありません。DeloitteがAIカルチャー負債と呼ぶギャップを積み上げます。ある場所では静かな過度の依存、別の場所では静かな冗長な二重チェックが起きており、目に見えるミスが議論を迫るまで、どこで何が起きているのか、誰も明確な全体像を持っていません。これを正しく行うことは、AIネイティブ文化の実像で取り上げているより大きな変化の一部であり、そこでは信頼、当事者意識、説明責任のすべてを、意図的に作り直す必要があります。
これは、専任のAIチームを持つ企業に限った話ではありません。従業員5人の会社がエージェントでアウトリーチのメールを下書きするときも、「これを送る前に誰が確認するのか」という、従業員1,000人の大企業と同じ明確な答えが必要です。リスクは会社の規模に応じて拡大しますが、較正の問題はそうではありません。
次に読むべき記事
- 職場で信頼を築く方法:この記事が対比している、人と人の信頼モデル
- 人とエージェントのチーム:エージェントが単なるツールではなく、実際の成果物の一部になると何が変わるか
- AIカルチャー負債:信頼の規範が築かれず、ギャップが積み上がるとどうなるか
- AIエチケットと職場の規範:AIの利用をめぐってチームが折り合いを付けつつある、より広い不文律
- AIネイティブ文化とは:エージェントがチームメイトになったとき、信頼と説明責任がどう変わるかの全体像
- エージェント型AIとは:これらのシステムがどう計画し行動するか。そのエラーが単純なツールとは異なって見える理由の一部です
- AIのハルシネーション:自信に満ちた、流暢で、誤った出力の背後にある具体的な仕組み
- ヒューマン・イン・ザ・ループ:チェックポイントを習慣任せにせず、設計する方法
職場でAIを信頼することに関するよくある質問
AIを信頼することは、同僚を信頼することとどう違いますか?
人への信頼は、その人の能力、誠実さ、そして自分の利益を気にかけているかどうかを、時間をかけて観察することで築かれます。人にはあなたを欺いた場合に失うものがあることも、その一因です。AIシステムには欺く意図も、守るべき評判もないため、そうした近道は当てはまらず、自信に満ちた流暢な出力が、正しいのと同じくらい間違っていることもありえます。
自動化バイアスとは何ですか?
自動化バイアスとは、自動化されたシステムの出力に、証拠が裏づける以上の重みを与え、システムが数回正しかった後は、独自の検証をやめてしまう傾向のことです。人と自動化の研究で最も研究されている失敗パターンの一つで、システムの精度が上がるほど悪化する傾向があります。たいてい正しいシステムは、間違いに人が気づく可能性を下げるからです。
AIの過小信頼と過信の違いは何ですか?
過小信頼とは、習慣からAIの仕事を手作業でやり直すことで、ツールがもたらすはずだった生産性の向上を打ち消してしまいます。過信とは、自信ありげに聞こえるからと検証せずにAIの出力を受け入れることで、AI生成の「ワークスロップ」や事実の誤りが完成した仕事に紛れ込むのはこのためです。較正された信頼はその中間に位置します。証拠がAIの弱さを示すところでは検証し、強さを示すところでは受け入れます。
実践における「較正された信頼」とは何を意味しますか?
較正された信頼とは、AIシステムの出力にどれだけ頼るかを、聞こえ方の自信ではなく、タスクごとの実際の信頼性の証拠に合わせることです。特定のエージェントが特定のタスクの種類で何を正しく、何を間違えるかを記録し、「常に信頼する」「常に二重チェックする」という一律のルールではなく、それに応じて検証の労力を調整する必要があります。
「ワークスロップ」とは何で、AIへの信頼とどう関係しますか?
ワークスロップとは、見た目は洗練されているものの、タスクを前進させる中身を欠いたAI生成コンテンツのことで、BetterUp LabsとStanfordのSocial Media Labの研究者が名付けた言葉です。過信の直接的な症状であり、誰かが十分な精査なしにAIのドラフトを受け入れて回し、検証を次の受け手に任せるものです。2025年の調査では、従業員10,000人規模の会社で年間約900万ドルのコストになると推定されています。
経験を積めば、自動化バイアスの影響を受けなくなりますか?
いいえ、被害を減らしますが、なくしはしません。27人の放射線科医を対象とした研究では、AIの診断提案が誤っていたとき、経験の浅い読影者の精度はおよそ80%から20%未満に低下し、経験15年以上の読影者でも精度は82%から45.5%に落ちました。経験は誤りをより多く見つける助けになりますが、自信たっぷりの誤った推奨に対して、誰かを免疫にするわけではありません。
ヒューマン・イン・ザ・ループの設計は、適切な信頼を築くのにどう役立ちますか?
ヒューマン・イン・ザ・ループが機能するのは、エージェントが手を付けたものすべてをなんとなくざっと確認するのではなく、エラーが最も重要になる地点、通常は社外向けや取り返しのつかないことが起こる前に、チェックポイントを意図的に置いたときです。うまく行われれば、チェックの要らないワークフローの部分には本物の信頼を広げつつ、実際にコストを生むエラーは捉えることができます。
AIの信頼に関する規範をまだ何も決めていないチームが、最初にすべきことは何ですか?
社外で何かが起こる前に、AIが支援した仕事のどの種類に必ず人のチェックを入れるか(顧客向けの数字、法務の文言、取り返しのつかないすべてのもの)と、どの種類が軽いチェックで済むほどリスクが低いかを、チームとして明確にすることです。ほとんどのチームには、一人の慎重な人の習慣の中に、すでに非公式な答えがあります。必要なのは、それを個人の直感ではなく、共有された一貫したものにすることです。
AIチームメイトへの信頼は、それを最もよく見ている誰かが抱える、私的な感覚であってはいけません。代わりに、測定に変えましょう。エージェントが信頼できる場面とそうでない場面を記録し、その見立てをチーム全体で共有して、信頼を、想定ではなく較正されたものにします。そうすれば、盲信と全面的な疑いの間を揺れ動くのをやめ、エージェントが獲得したとおりの、過不足のない使い方を始められます。
