Bahasa Indonesia
Segmentasi Pelanggan dengan AI: Dari Daftar Statis ke Segmen Perilaku
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
Segmentasi pelanggan dengan AI berarti memakai pembelajaran mesin untuk mengelompokkan pelanggan menurut apa yang mereka lakukan dan apa yang kemungkinan mereka lakukan berikutnya, bukan menyortirnya berdasarkan atribut tetap seperti usia, jabatan, atau wilayah. Kelompok dibangun dari perilaku (kunjungan, pembelian, tampilan produk, keterlibatan email), diperbarui otomatis saat data baru masuk, dan sering diberi skor berdasarkan probabilitas tindakan di masa depan seperti membeli atau berhenti berlangganan (churn).
Daftar demografis memberi tahu siapa seseorang. Segmen perilaku memberi tahu apa yang sedang ia lakukan sekarang. Perbedaan itu penting karena dua manajer pemasaran berusia 35 tahun di daftar Anda bisa berperilaku sama sekali berbeda: yang satu membaca tiga halaman harga dalam seminggu, yang lain hanya membuka satu newsletter setahun lalu. Daftar statis memperlakukan keduanya sama. Segmen perilaku tidak.
Panduan ini ditujukan bagi manajer pemasaran dan kepala growth yang sudah paham dasarnya dan ingin tahu apa yang ditambahkan lapisan AI. Isinya mencakup tiga jenis segmen AI (perilaku, prediktif, dan lookalike), apa yang sebenarnya disediakan platform, cara penerapannya langkah demi langkah, dan di mana hal ini biasanya salah. Jika Anda butuh dasar-dasarnya lebih dulu, mulailah dari segmentasi pelanggan untuk e-commerce. Untuk metode statistik di baliknya, lihat business clustering.
Daftar statis versus segmen AI
Segmentasi tradisional adalah klasifikasi sekali jalan. Seseorang membuat aturan ("Wilayah = EMEA dan ukuran perusahaan > 200"), mengekspor daftarnya, lalu memakainya sampai ada yang ingat untuk menyegarkannya. Metode ini punya kekuatan nyata: transparan, mudah dijelaskan kepada tim penjualan, dan murah. Namun ia juga punya tiga kelemahan.
- Cepat usang. Keanggotaan hanya berubah ketika seseorang menjalankan ulang aturannya.
- Melihat atribut, bukan intent. Demografi menggambarkan profil, bukan momen pembelian.
- Ada batasnya. Aturan buatan tangan sulit dirawat jika jumlah segmen melebihi segelintir.
Segmentasi AI mengubah mekanismenya. Segmen ditentukan oleh pola dalam data perilaku, keanggotaan dihitung ulang terus-menerus, dan jumlah segmen yang berguna tidak dibatasi oleh berapa banyak aturan yang sanggup dikelola tim. Pola personalization engine menjelaskan ujung ekstremnya: satu profil per orang, diperbarui pada setiap interaksi. Sebagian besar tim pemasaran berada di antaranya, dan itu tidak masalah.
| Segmentasi daftar statis | Segmentasi perilaku dengan AI | |
|---|---|---|
| Ditentukan oleh | Atribut yang Anda pilih sebelumnya | Pola yang ditemukan dalam data perilaku |
| Penyegaran | Manual | Otomatis, sering kali harian |
| Pertanyaan khas | "Siapa yang masuk tier mid-market?" | "Siapa yang kemungkinan membeli minggu ini?" |
| Kekuatan | Jelas, dapat diaudit, mudah dijadikan brief | Bereaksi terhadap intent dan menemukan kelompok yang tidak terpikirkan |
| Kelemahan | Usang, dangkal, sulit diskalakan | Butuh data bersih dan pemeriksaan wajar oleh manusia |
Tiga jenis segmen AI
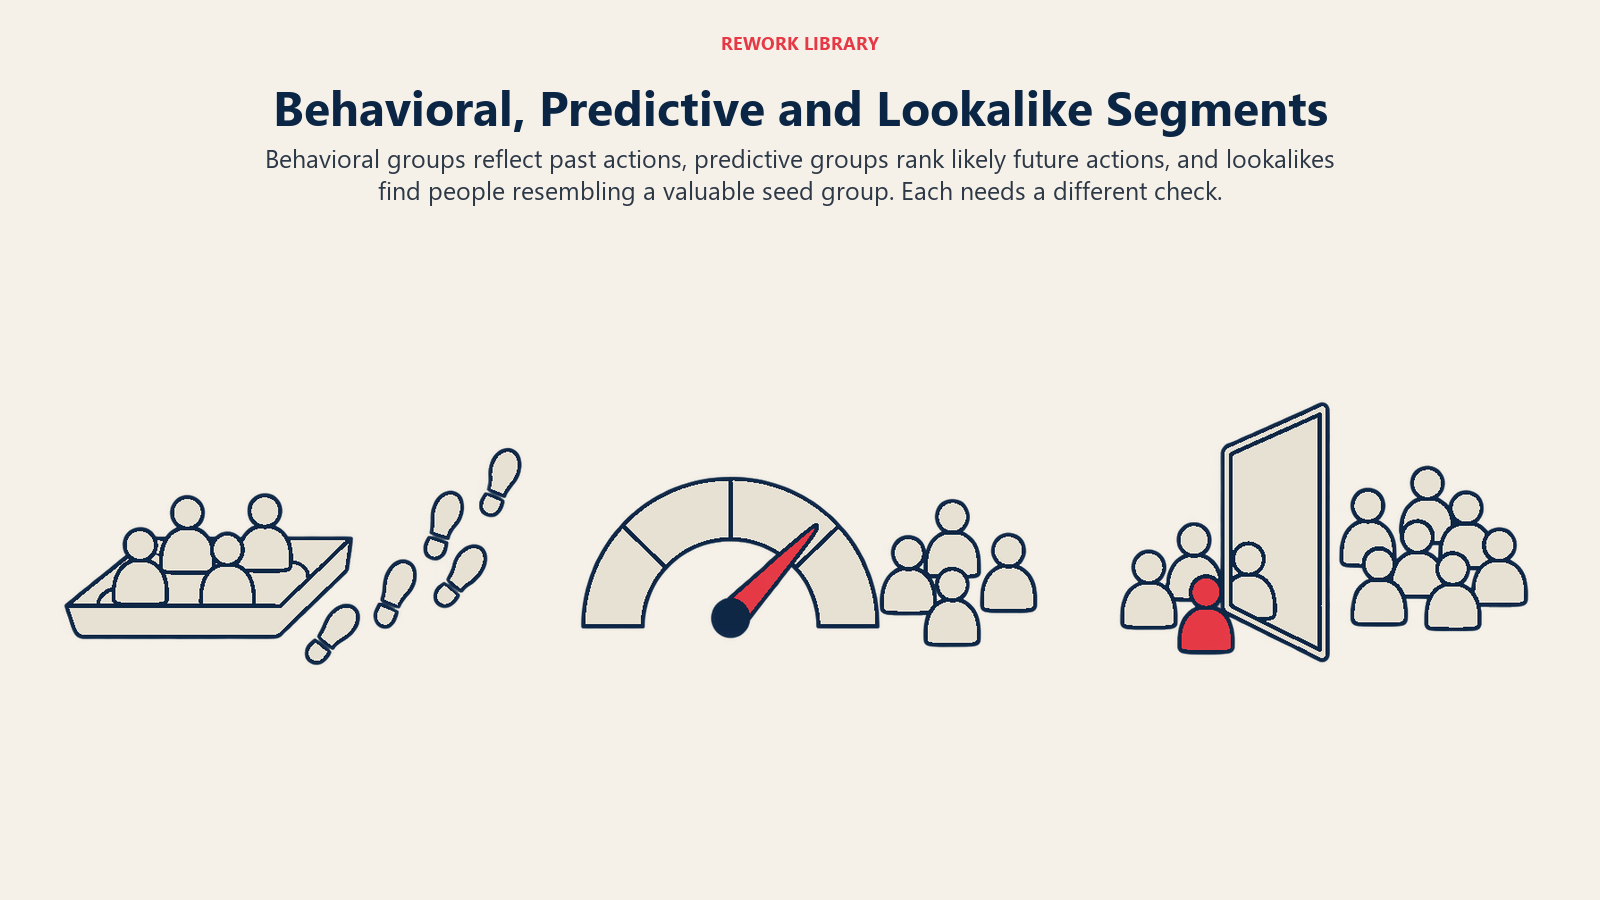
Sebagian besar alat menawarkan campuran ketiganya. Mengetahui mana yang Anda pakai memberi tahu data apa yang dibutuhkan dan bagaimana menilainya.
Segmen perilaku
Segmen perilaku mengelompokkan orang menurut apa yang telah mereka lakukan: halaman yang dilihat, produk yang dimasukkan keranjang, fitur yang dipakai, email yang diklik, frekuensi pembelian. Sebagian berupa aturan yang Anda tulis ("melihat halaman harga dua kali dalam tujuh hari"). Sebagian lain berasal dari clustering, ketika algoritma menemukan kelompok pelanggan yang mirip tanpa diberi tahu apa yang harus dicari. Kekuatan clustering adalah kemampuannya memunculkan pola yang tidak akan Anda definisikan sendiri, misalnya kelompok yang hanya membeli saat promosi. Kelemahannya, algoritma memberi Anda kelompok, bukan nama atau makna. Seseorang tetap harus membaca tiap klaster dan memutuskan apa artinya. Artikel tentang clustering menjelaskan bagaimana kelompok-kelompok itu terbentuk.
Segmen prediktif
Segmen prediktif meranking orang berdasarkan kemungkinan tindakan di masa depan. Inilah versi yang paling banyak dijadikan produk oleh platform, sehingga dokumentasinya konkret. Google Analytics 4 menawarkan tiga metrik prediktif. Probabilitas pembelian adalah peluang bahwa pengguna yang aktif dalam 28 hari terakhir akan mencatat key event tertentu dalam 7 hari ke depan. Probabilitas churn mencakup pengguna yang aktif dalam 7 hari terakhir dan memperkirakan peluang mereka tidak aktif dalam 7 hari berikutnya. Prediksi pendapatan memperkirakan berapa yang akan dibelanjakan pengguna dalam 28 hari ke depan. GA4 membangun audiens yang disarankan dari skor-skor ini, dan definisi audiens yang disarankan memakai batas persentil: probabilitas churn di atas persentil ke-80, probabilitas pembelian di atas persentil ke-90, dan prediksi pendapatan di atas persentil ke-95 untuk audiens pembelanja teratas.
Klaviyo melakukan hal serupa untuk e-commerce. Analitik prediktifnya menampilkan untuk setiap profil prediksi nilai seumur hidup pelanggan (perkiraan belanja selama setahun ke depan), risiko churn, rata-rata jarak antarpesanan, dan perkiraan tanggal pesanan berikutnya. Klaviyo mencatat bahwa prediksi paling andal untuk kelompok pelanggan, bukan untuk individu, dan ini aturan yang baik untuk segmen prediktif apa pun. Perlakukan skor sebagai cara memprioritaskan kelompok, bukan vonis atas satu orang. Untuk cara skor nilai itu dibangun, lihat memprediksi nilai seumur hidup pelanggan dengan AI.
Segmen lookalike
Segmen lookalike (atau serupa) dimulai dari kelompok yang sudah Anda hargai, misalnya pelanggan terbaik Anda, lalu mencari orang baru yang mirip dengan mereka. Platform melakukan pencocokan memakai sinyal yang tidak pernah Anda lihat. Customer Match milik Google adalah contoh terdokumentasi yang paling jelas: Anda mengunggah daftar pelanggan, dan iklan dapat menjangkau pelanggan tersebut serta orang lain yang mirip. Di YouTube, halaman itu menyebutkan bahwa pengiklan dapat menargetkan segmen yang mirip dengan pelanggan paling bernilai mereka. Halaman itu juga menyebutkan bahwa Smart Bidding dan optimized targeting otomatis menyertakan daftar Customer Match kecuali Anda memilih keluar. Ini penting diketahui, karena daftar Anda mungkin ikut membentuk penayangan iklan bahkan saat Anda tidak merencanakannya. AI dalam iklan berbayar membahas bagaimana audiens otomatis itu berinteraksi dengan penawaran dan di mana kendali Anda berakhir.
Kualitas lookalike sepenuhnya bergantung pada daftar seed. Jika Anda memakai semua orang yang pernah mendaftar, hasilnya audiens luas yang rata-rata. Jika Anda memakai pelanggan yang memperpanjang dua kali, hasilnya jauh lebih dekat dengan yang Anda inginkan.
Persyaratan platform
Persyaratan yang terdokumentasi menunjukkan mengapa segmentasi AI gagal pada data yang kecil atau berantakan. Periksa hal ini sebelum merencanakan program.
| Fitur platform | Yang dihasilkan | Persyaratan terdokumentasi |
|---|---|---|
| Audiens prediktif GA4 | Audiens berbasis pembelian, churn, dan pendapatan | Minimal 1.000 pengguna yang kembali dan memicu kondisi prediktif, serta minimal 1.000 yang tidak, dalam periode tujuh hari dalam 28 hari; kualitas model harus bertahan dari waktu ke waktu; event purchase memerlukan value dan currency |
| Analitik prediktif Klaviyo | Prediksi CLV, risiko churn, tanggal pesanan berikutnya | Minimal 500 pelanggan yang pernah memesan, riwayat pesanan 180 hari dengan pesanan dalam 30 hari terakhir, dan sebagian pelanggan dengan 3 pesanan atau lebih |
| Customer Match Google | Penargetan pelanggan yang Anda unggah plus orang yang mirip | Keanggotaan kedaluwarsa setelah 540 hari; minimal 100 anggota harus ditambahkan atau diperbarui dalam jangka itu agar daftar tetap memenuhi syarat |
Sumber: metrik prediktif GA4, Klaviyo, dan Customer Match Google Ads. Halaman GA4 menambahkan bahwa prediksi dibuat setiap hari dan bahwa jika kualitas model turun di bawah ambang minimum, pembaruan berhenti dan prediksi bisa menjadi tidak tersedia. Jadi audiens prediktif bisa menghilang diam-diam. Pasang pemeriksaan untuk itu.
Ambang-ambang ini adalah jawaban praktis atas pertanyaan "apakah bisnis saya sudah siap?" Perusahaan B2B dengan 300 pelanggan tidak bisa memakai model pembelian prediktif yang dibangun dari ribuan event. Perusahaan itu masih bisa memakai aturan perilaku, dan bisa memakai lookalike berbasis CRM, tetapi tidak boleh berpura-pura bahwa model akan menemukan pola yang tidak ada dalam data.
Contoh menurut fungsi
Segmen baru berarti jika ada yang bertindak berdasarkan segmen itu. Berikut gambarannya di berbagai tim.
Pemasaran email dan siklus hidup. Pertahankan segmen siklus hidup berbasis aturan (baru, aktif, mulai menjauh) sebagai tulang punggung, lalu tambahkan skor prediktif di atasnya untuk menentukan intensitas pesan. Pelanggan yang mulai menjauh dengan kemungkinan tinggi mendapat pengingat personal. Yang kemungkinannya rendah mendapat sentuhan yang lebih ringan. Mekanismenya ada di AI untuk pemasaran email.
Media berbayar. Unggah pelanggan terbaik Anda (bukan seluruh database) sebagai seed, lalu pakai untuk eksklusi sekaligus ekspansi. Mengecualikan pelanggan yang ada dari kampanye akuisisi mencegah Anda membayar untuk menjangkau orang yang sudah membeli.
Merchandising e-commerce. Klaster pelanggan yang hanya membeli pada hari diskon mendapat beranda dan penawaran yang berbeda dari klaster yang membeli barang pengisian ulang dengan harga penuh. Segmenlah yang menentukan pesan, bukan sebaliknya.
Demand generation B2B. Sinyal perilaku seperti kunjungan berulang ke halaman harga, kehadiran di webinar, dan pembacaan dokumentasi produk dapat mendefinisikan segmen "sedang di pasar" yang ditindaklanjuti penjualan dalam sehari. Ini berkaitan erat dengan lead scoring dan berjalan berdampingan dengan AI untuk account-based marketing.
Customer success. Probabilitas churn menjadi daftar pantauan. Skor yang naik memicu check-in sebelum pelanggan membatalkan, bukan sesudahnya.
Langkah demi langkah: peluncurannya
- Pilih satu keputusan yang akan diubah oleh segmen. "Siapa yang mendapat penawaran win-back?" adalah keputusan. "Memahami pelanggan kita lebih baik" bukan. Tanpa keputusan, segmen hanyalah laporan.
- Audit datanya. Daftar event yang Anda tangkap, bagaimana identitas terhubung antara web, aplikasi, email, dan CRM, dan seberapa bersih catatan pembelian. Dasarnya dibahas dalam data first-party untuk pemasaran AI.
- Mulai dari aturan. Bangun tiga atau empat segmen perilaku dengan tangan. Segmen itu mengajarkan apa yang penting dalam data Anda dan memberi baseline untuk dikalahkan.
- Tambahkan lapisan prediktif jika ambang terpenuhi. Pakai model bawaan platform lebih dulu. Periksa batas minimum di tabel di atas sebelum mengaktifkannya.
- Beri nama setiap segmen dengan bahasa yang jelas. "Klaster 4" tidak berguna bagi copywriter. "Pembeli berulang yang terdorong diskon" adalah sesuatu yang bisa ditulis oleh tim.
- Ambil sampel sebelum meluncurkan. Tarik 20 orang dari tiap segmen dan tanyakan apakah pengelompokannya masuk akal secara bisnis. Jika Anda tidak bisa menjelaskan apa kesamaan mereka, jangan kirim pesan yang disesuaikan.
- Uji terhadap kontrol. Tahan irisan acak dari setiap kampanye dan bandingkan. Segmen yang tidak mengungguli kontrol tanpa penargetan belum layak dipertahankan.
- Tetapkan ritme penyegaran dan peninjauan. Segmen bergeser seiring produk, harga, dan pelanggan berubah. Tinjau menurut kalender, bukan saat ada yang mengeluh.
- Hentikan yang tidak berhasil. Lebih sedikit segmen yang mendorong tindakan berbeda lebih baik daripada banyak segmen yang mendorong tindakan yang sama.
Privasi dan persetujuan
Segmentasi adalah profiling, dan profiling membawa bobot hukum di banyak tempat. Di bawah GDPR, Pasal 21 memberi orang hak untuk menolak kapan saja pemrosesan untuk pemasaran langsung, termasuk profiling yang terkait dengannya, dan setelah mereka menolak, datanya tidak boleh lagi dipakai untuk tujuan itu. Pasal 22 mengatur hak untuk tidak dikenai keputusan yang semata-mata didasarkan pada pemrosesan otomatis, termasuk profiling, jika keputusan itu berdampak hukum atau signifikan serupa. Segmen pemasaran biasa jarang mencapai ambang kedua itu, tetapi keputusan soal harga, kredit, atau kelayakan bisa.
Dalam praktiknya: pastikan opt-out mengalir ke setiap segmen dan setiap daftar yang diunggah, catat asal setiap titik data, dan hindari menyimpulkan sifat sensitif. Aturan platform untuk daftar pelanggan yang diunggah menambahkan syarat sendiri, jadi bacalah sebelum mengunggah. Minta pimpinan hukum atau privasi Anda meninjau segmen apa pun yang melampaui penggunaan pemasaran yang lugas.
Fakta Utama: Segmentasi pelanggan dengan AI
- Probabilitas pembelian GA4 memperkirakan apakah pengguna aktif akan mencatat key event dalam 7 hari ke depan; probabilitas churn dan prediksi pendapatan mencakup jendela 7 hari dan 28 hari (Google Analytics Help).
- Audiens prediktif GA4 memerlukan minimal 1.000 pengguna yang kembali dan memicu kondisi prediktif serta 1.000 yang tidak (Google Analytics Help).
- Audiens yang disarankan GA4 memakai batas persentil: churn di atas persentil ke-80, pembelian di atas persentil ke-90, dan prediksi pendapatan di atas persentil ke-95 (Google Analytics Help).
- Analitik prediktif Klaviyo memerlukan minimal 500 pelanggan dengan pesanan dan riwayat pesanan 180 hari, serta menyatakan bahwa prediksi paling andal untuk kelompok, bukan individu (Klaviyo Help Center).
- Google Customer Match memungkinkan iklan menjangkau pelanggan yang Anda unggah dan orang lain yang mirip; daftar memerlukan minimal 100 anggota yang ditambahkan atau diperbarui dalam 540 hari agar tetap memenuhi syarat (Google Ads Help).
- Berdasarkan Pasal 21 GDPR, seseorang dapat menolak kapan saja profiling yang terkait dengan pemasaran langsung, dan datanya tidak boleh lagi dipakai untuk itu (teks GDPR).
Kesalahan umum
- Melakukan segmentasi tanpa keputusan. Peta indah kelompok pelanggan tidak mengubah apa pun jika tidak ada kampanye, penawaran, atau tindakan penjualan yang berbeda menurut kelompok.
- Menggunakan daftar yang salah sebagai seed lookalike. Seed yang tidak dibedakan menghasilkan audiens yang tidak dibedakan. Pakai pelanggan paling bernilai.
- Memercayai skor pada data yang tipis. Di bawah batas minimum platform, prediksi hanyalah derau dengan label yang terdengar yakin.
- Memperlakukan probabilitas sebagai fakta. Skor persentil ke-90 berarti "lebih mungkin daripada kebanyakan orang", bukan "pasti membeli".
- Melewatkan pemeriksaan manusia. Klaster bersifat matematis, belum tentu bermakna. Seseorang harus membacanya.
- Terlalu banyak segmen. Jika Anda tidak bisa menulis pesan yang berbeda untuk tiap segmen, gabungkan.
- Membiarkan segmen membusuk. Model dilatih ulang dan perilaku pelanggan bergeser. Segmen yang dibangun setahun lalu mungkin menggambarkan tidak seorang pun.
- Mengabaikan sinyal persetujuan. Kontak yang berhenti berlangganan atau menolak tetapi tetap ada di daftar yang diunggah adalah masalah kepatuhan sekaligus masalah merek.
- Menilai hanya dari keterlibatan. Rasio klik yang lebih tinggi dalam suatu segmen tidak membuktikan pendapatan. Bandingkan hasil hilir dengan kontrol.
