Bahasa Indonesia
Templat Deskripsi Pekerjaan Site Reliability Engineer - Panduan 2026
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
Yang Akan Anda Dapatkan dari Panduan Ini
- Templat deskripsi pekerjaan Site Reliability Engineer yang lengkap
- Persyaratan gabungan software engineering dan administrasi sistem
- Tanggung jawab otomasi, monitoring, dan respons insiden
- Manajemen error budget dan praktik reliability engineering
- Tugas on-call dan ekspektasi perencanaan kapasitas
- Penilaian keterampilan teknis mencakup infrastructure as code dan skalabilitas
Ringkasan Singkat
Site Reliability Engineer (SRE) adalah profesional khusus yang menerapkan prinsip software engineering pada masalah infrastruktur dan operasional. Mereka menjembatani kesenjangan antara development dan operations, memastikan sistem tetap andal, skalabel, dan dikelola secara efisien melalui otomasi dan praktik engineering.
Mengapa Peran Ini Penting
Site Reliability Engineer sangat penting bagi organisasi teknologi modern karena mereka memastikan layanan digital tetap tersedia, berperforma baik, dan skalabel seiring pertumbuhan bisnis. Seiring perusahaan semakin bergantung pada sistem terdistribusi yang kompleks dan infrastruktur cloud, SRE menyediakan keahlian yang dibutuhkan untuk menjaga kualitas layanan sambil memungkinkan pengembangan fitur yang cepat. Mereka berperan sebagai penjaga keandalan sistem, menerapkan praktik yang mencegah outage, mengurangi downtime, dan menciptakan proses operasional yang berkelanjutan serta dapat berkembang seiring pertumbuhan organisasi.
Templat Deskripsi Pekerjaan Utama
Tentang Peran Ini
Kami mencari Site Reliability Engineer yang terampil untuk bergabung dengan tim engineering kami dan mengambil tanggung jawab atas keandalan, skalabilitas, dan performa sistem produksi kami. Dalam peran ini, Anda akan bekerja di persimpangan antara software engineering dan operasional sistem, menerapkan prinsip engineering untuk menyelesaikan tantangan infrastruktur dan menghilangkan operational toil melalui otomasi.
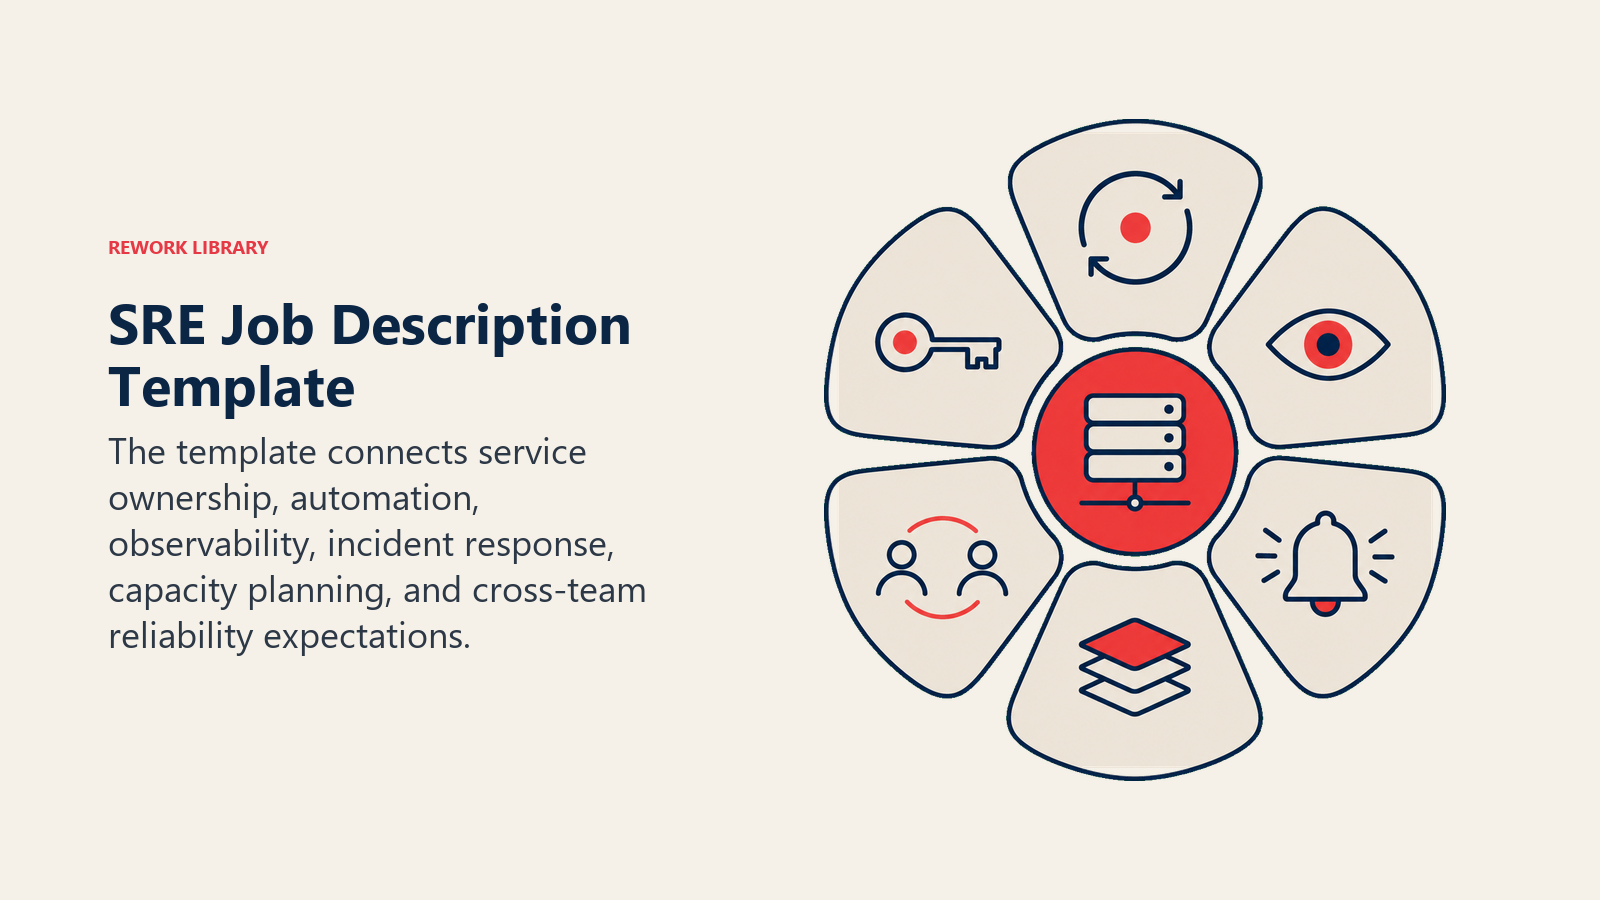
Sebagai SRE, Anda akan berkolaborasi erat dengan tim development untuk memastikan layanan kami memenuhi target keandalan sambil menjaga kecepatan deployment yang tinggi. Anda akan merancang dan menerapkan solusi monitoring, merespons insiden produksi, dan membangun tools yang memungkinkan engineer lain melakukan deploy dan mengoperasikan layanan secara aman dan efisien. Posisi ini membutuhkan kedalaman teknis dalam sistem terdistribusi sekaligus kemampuan berpikir strategis tentang keandalan layanan dan keunggulan operasional.
Anda akan melapor kepada Engineering Manager atau SRE Lead dan bekerja erat dengan tim development, platform engineer, dan tim security untuk menjaga service level objective (SLO) kami sambil mendukung pertumbuhan bisnis dan inovasi.
Tanggung Jawab Utama
Manajemen Keandalan Sistem: Memantau sistem produksi, membangun framework SLI/SLO, dan menjaga target ketersediaan layanan melalui sistem monitoring dan alerting yang proaktif
Respons dan Manajemen Insiden: Memimpin upaya respons insiden, melakukan post-incident review, dan menerapkan langkah pencegahan untuk mengurangi mean time to recovery (MTTR) dan mencegah masalah berulang
Pengembangan Otomasi dan Tooling: Membangun dan memelihara automation tools, deployment pipeline, dan platform self-service yang mengurangi pekerjaan operasional manual dan meningkatkan produktivitas developer
Perencanaan Kapasitas dan Optimasi Performa: Menganalisis metrik performa sistem, memprediksi kebutuhan kapasitas, dan mengoptimalkan pemanfaatan sumber daya untuk memastikan scaling yang hemat biaya
Implementasi Infrastructure as Code: Merancang dan memelihara infrastruktur menggunakan pendekatan berbasis code, memastikan manajemen environment yang konsisten, reproducible, dan version-controlled
Observability dan Monitoring: Menerapkan solusi monitoring, logging, dan tracing yang komprehensif untuk memberikan visibilitas terhadap perilaku dan performa sistem
Kolaborasi dengan Tim Development: Bekerja sama dengan tim engineering untuk meningkatkan keandalan layanan, meninjau desain arsitektur, dan membangun best practice operasional
Dukungan On-Call: Berpartisipasi dalam rotasi on-call untuk memastikan ketersediaan sistem 24/7 dan respons cepat terhadap masalah produksi
Dokumentasi dan Berbagi Pengetahuan: Membuat dan memelihara runbook operasional, dokumentasi sistem, serta berbagi pengetahuan melalui kegiatan pelatihan dan mentoring
Peningkatan Berkelanjutan: Mengidentifikasi peluang untuk meningkatkan keandalan sistem, efisiensi operasional, dan produktivitas tim melalui perbaikan proses dan adopsi teknologi
Persyaratan
Kualifikasi Wajib:
- Gelar sarjana di bidang Ilmu Komputer, Engineering, atau pengalaman praktis setara dengan 3-5 tahun pengalaman di software development atau systems engineering
- Keterampilan pemrograman yang kuat dalam bahasa seperti Python, Go, Java, atau sejenisnya, dengan pengalaman membangun software berkualitas produksi
- Pengalaman langsung dengan platform cloud (AWS, GCP, Azure) dan sistem container orchestration seperti Kubernetes
- Kemahiran dengan tools Infrastructure as Code (Terraform, Ansible, CloudFormation) dan implementasi CI/CD pipeline
- Pengalaman dengan tools monitoring dan observability (Prometheus, Grafana, ELK stack, Datadog, atau platform sejenis)
- Pemahaman tentang prinsip sistem terdistribusi, arsitektur microservices, dan teknologi database
- Pengetahuan tentang konsep networking, praktik security, dan dasar-dasar administrasi sistem
- Pengalaman dengan proses incident management dan analisis post-mortem
Kualifikasi yang Diutamakan:
- Sertifikasi SRE atau DevOps dari cloud provider besar atau vendor teknologi terkait
- Pengalaman dengan teknologi service mesh (Istio, Linkerd) dan fitur Kubernetes tingkat lanjut
- Latar belakang di sistem terdistribusi skala besar atau aplikasi web dengan traffic tinggi
- Pengalaman dengan praktik chaos engineering dan metodologi reliability testing
- Pengetahuan tentang tools dan metodologi performance testing
Yang Kami Tawarkan
- Kompensasi Kompetitif: Kisaran gaji pokok $130.000 - $200.000 ditambah ekuitas dan bonus kinerja
- Pengembangan Profesional: Kehadiran konferensi, penggantian biaya sertifikasi, dan waktu belajar khusus
- Lingkungan Kerja Fleksibel: Budaya remote-first dengan akses kantor opsional dan jadwal kerja fleksibel
- Benefit Komprehensif: Asuransi kesehatan, gigi, mata, kontribusi 401(k), dan kebijakan PTO yang murah hati
- Pertumbuhan Teknis: Akses ke teknologi mutakhir, tantangan teknis yang kompleks, dan peluang mentorship
- Dampak: Pengaruh langsung terhadap keandalan sistem dan pengalaman pengguna bagi jutaan pelanggan
Variasi Konteks
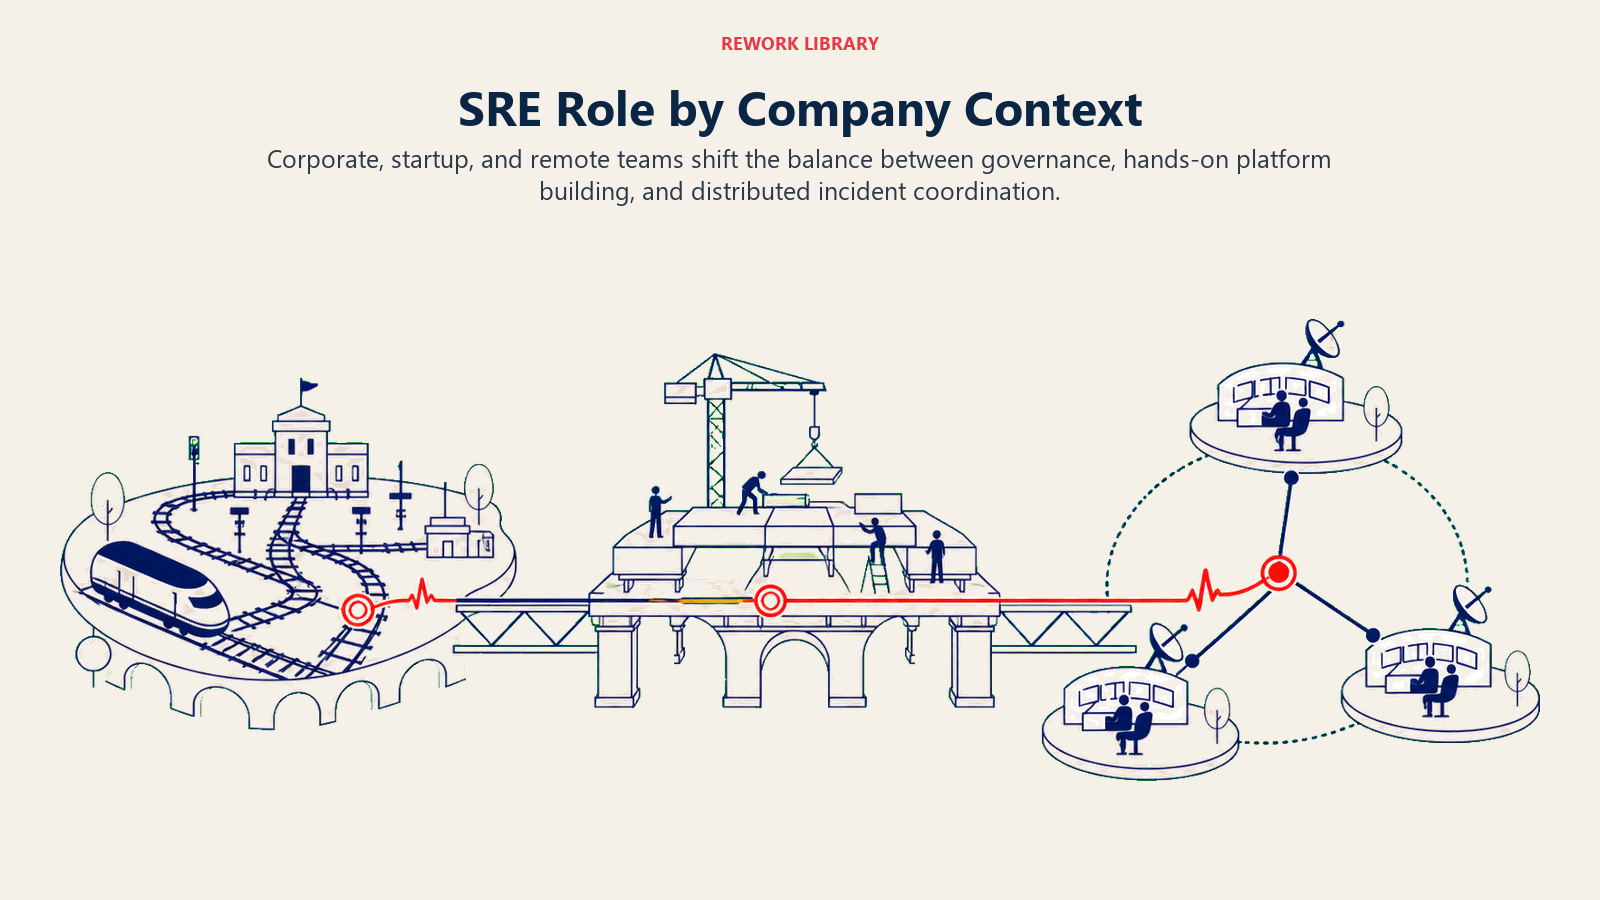
Lingkungan Korporat
Organisasi enterprise besar biasanya mengharuskan SRE bekerja dalam framework governance dan persyaratan kepatuhan yang sudah mapan. Anda dapat mengharapkan proses change management yang lebih formal, persyaratan dokumentasi yang ekstensif, dan integrasi dengan tools serta kebijakan security enterprise. Peran ini sering melibatkan dukungan terhadap sistem legacy di samping infrastruktur cloud modern.
Lingkungan Startup
Startup yang tumbuh cepat membutuhkan SRE yang bisa membangun praktik keandalan dari nol sambil mendukung pengembangan produk yang cepat. Anda akan memiliki tanggung jawab yang lebih luas, bekerja dengan tim yang lebih kecil, dan perlu membuat keputusan arsitektural dengan sumber daya yang terbatas. Fokusnya adalah membangun fondasi yang skalabel dan dapat mendukung pertumbuhan di masa depan.
Lingkungan Remote/Hybrid
Peran SRE remote membutuhkan keterampilan komunikasi yang kuat untuk mengoordinasikan respons insiden lintas zona waktu dan mendokumentasikan pengetahuan sistem untuk tim yang terdistribusi. Anda perlu mahir menggunakan collaboration tools dan mampu memberikan mentorship serta berbagi pengetahuan melalui kanal digital.
Pertimbangan Industri
| Industri | Persyaratan Utama | Aspek Unik |
|---|---|---|
| Financial Services | Kepatuhan regulasi, fokus security, persyaratan low-latency | Kepatuhan PCI DSS, sistem trading real-time, disaster recovery |
| E-commerce | Ketersediaan tinggi saat periode puncak, skala global | Kesiapan Black Friday, pemrosesan pembayaran, sistem inventori |
| Healthcare | Kepatuhan HIPAA, privasi data, keandalan sistem | Perlindungan data pasien, integrasi perangkat medis, kritikalitas uptime |
| Gaming | Latensi rendah, distribusi global, lonjakan traffic | Multiplayer real-time, content delivery, event musiman |
| Media/Streaming | Content delivery, CDN global, optimasi bandwidth | Pemrosesan video, live streaming, distribusi konten |
| SaaS | Multi-tenancy, keandalan API, isolasi pelanggan | Pemisahan data tenant, API rate limiting, SLA pelanggan |
Panduan Kompensasi
Informasi Gaji
Kisaran Rata-Rata Nasional: $130.000 - $200.000 per tahun
| Lokasi | Entry Level | Mid-Level | Level Senior |
|---|---|---|---|
| San Francisco, CA | $150.000 - $180.000 | $180.000 - $220.000 | $220.000 - $280.000 |
| New York, NY | $140.000 - $170.000 | $170.000 - $210.000 | $210.000 - $270.000 |
| Seattle, WA | $135.000 - $165.000 | $165.000 - $200.000 | $200.000 - $250.000 |
| Austin, TX | $120.000 - $145.000 | $145.000 - $180.000 | $180.000 - $230.000 |
| Denver, CO | $115.000 - $140.000 | $140.000 - $175.000 | $175.000 - $220.000 |
| Remote | $125.000 - $155.000 | $155.000 - $190.000 | $190.000 - $240.000 |
Faktor yang Memengaruhi Kompensasi:
- Keahlian cloud dan sertifikasi dapat menambah premi 10-20%
- Tanggung jawab on-call biasanya mencakup kompensasi tambahan
- Paket ekuitas bervariasi secara signifikan tergantung tahap dan ukuran perusahaan
Data gaji berdasarkan riset pasar 2024 dari Glassdoor, Levels.fyi, dan survei industri.
Pertanyaan Wawancara
Pertanyaan Teknis/Fungsional
Desain Sistem dan Arsitektur:
- Jelaskan bagaimana Anda akan merancang sistem monitoring untuk arsitektur microservices dengan 50+ service.
- Jelaskan langkah demi langkah pendekatan Anda dalam menerapkan circuit breaker dan retry logic pada sistem terdistribusi.
- Bagaimana Anda akan merancang sistem auto-scaling yang menangani pola traffic yang dapat diprediksi maupun yang tidak?
- Jelaskan bagaimana Anda akan menerapkan blue-green deployment untuk layanan produksi yang kritis.
Respons Insiden dan Troubleshooting:
- Jelaskan proses Anda dalam merespons outage produksi yang memengaruhi 20% pengguna.
- Bagaimana Anda akan melakukan troubleshoot pada layanan yang mengalami peningkatan latensi tetapi tidak ada perubahan error rate?
- Jelaskan langkah demi langkah bagaimana Anda akan menyelidiki dan menyelesaikan memory leak pada aplikasi yang di-containerize.
- Jelaskan pendekatan Anda dalam melakukan post-incident review yang efektif.
Otomasi dan Infrastruktur:
- Bagaimana Anda akan mengotomasi provisioning application stack yang lengkap menggunakan Infrastructure as Code?
- Jelaskan strategi Anda dalam menerapkan migrasi database tanpa downtime (zero-downtime).
Pertanyaan Perilaku
Pemecahan Masalah dan Pengambilan Keputusan:
- Ceritakan saat Anda harus membuat keputusan penting selama insiden produksi dengan informasi yang tidak lengkap.
- Jelaskan situasi ketika Anda mengidentifikasi dan menghilangkan sumber operational toil yang signifikan.
- Berikan contoh saat Anda harus menyeimbangkan tekanan pengiriman fitur dengan kekhawatiran terhadap keandalan sistem.
Kolaborasi dan Komunikasi:
- Ceritakan saat Anda harus meyakinkan developer untuk mengubah praktik deployment mereka demi alasan keandalan.
- Jelaskan bagaimana Anda membantu meningkatkan pengalaman on-call bagi tim Anda.
Pembelajaran dan Adaptasi:
- Berikan contoh saat Anda harus dengan cepat mempelajari teknologi baru untuk menyelesaikan masalah produksi.
Pertanyaan Kecocokan Budaya
- Bagaimana pendekatan Anda dalam menyeimbangkan inovasi dan stabilitas pada sistem produksi?
- Apa filosofi Anda tentang error budget dan bagaimana hal itu memengaruhi prioritas development?
- Bagaimana Anda mengikuti perkembangan praktik dan teknologi SRE?
Tips Evaluasi:
- Cari kandidat yang menunjukkan kedalaman teknis sekaligus keterampilan kolaborasi
- Nilai pengalaman mereka dalam respons insiden dan kemampuan bekerja di bawah tekanan
- Evaluasi pemahaman mereka tentang prinsip dan praktik reliability engineering
Tips Perekrutan
Panduan Sourcing Singkat
Platform Teratas untuk Perekrutan SRE:
- LinkedIn: Pencarian lanjutan untuk jabatan SRE, DevOps, dan Infrastructure Engineer
- Stack Overflow Jobs: Komunitas teknis dengan kehadiran SRE yang kuat
- AngelList: Sangat baik untuk posisi SRE di startup
- Dice: Job board yang berfokus pada teknologi
Komunitas Profesional:
- Peserta dan pembicara konferensi SRECon
- User group dan meetup cloud provider
- Anggota komunitas CNCF dan Kubernetes
- Meetup DevOps dan infrastruktur lokal
Tips Optimasi Postingan:
- Soroti teknologi dan tools spesifik yang digunakan dalam stack Anda
- Sebutkan ekspektasi on-call dan proses respons insiden sejak awal
- Tekankan peluang belajar dan tantangan teknis
- Sertakan detail tentang proyek otomasi dan infrastruktur
Tanda Bahaya yang Harus Dihindari
- Latar Belakang Ops Saja: Kandidat tanpa pengalaman software development mungkin kesulitan dengan fokus engineering pada SRE
- Tidak Ada Pengalaman Insiden: Kurangnya pengalaman respons insiden produksi menunjukkan pengetahuan praktis yang belum memadai
- Pemikiran yang Hanya Berfokus pada Tools: Kandidat yang hanya berfokus pada tools tanpa memahami prinsip yang mendasarinya
- Komunikasi yang Buruk: SRE harus mampu berkomunikasi secara efektif selama insiden dan dengan tim development
- Tidak Memiliki Automation Mindset: Kandidat yang tidak secara alami berpikir untuk menghilangkan pekerjaan manual melalui code
- Pendekatan yang Berorientasi Menyalahkan: Kandidat yang berfokus pada mencari kesalahan alih-alih perbaikan sistemik selama diskusi insiden
FAQ Perekrutan Site Reliability Engineer untuk Pemberi Kerja
Apa perbedaan antara SRE dan DevOps Engineer?
SRE berfokus secara khusus pada keandalan, menerapkan prinsip software engineering pada masalah operasional. DevOps Engineer biasanya memiliki tanggung jawab yang lebih luas mencakup seluruh siklus hidup pengiriman software, sementara SRE mengkhususkan diri pada keandalan sistem produksi.
Seberapa penting pengalaman on-call bagi kandidat SRE?
Pengalaman on-call sangat penting karena menunjukkan keterampilan respons insiden yang praktis dan pemahaman terhadap perilaku sistem produksi. Kandidat tanpa pengalaman ini mungkin memerlukan pelatihan dan mentoring tambahan.
Haruskah kami mewajibkan sertifikasi cloud untuk posisi SRE?
Meskipun sertifikasi dapat menunjukkan pengetahuan, pengalaman praktis langsung lebih bernilai. Carilah kandidat yang dapat menunjukkan pengalaman nyata dalam mengelola infrastruktur cloud, bukan hanya kredensial sertifikasi.
Bagaimana kami mengevaluasi keterampilan otomasi kandidat SRE?
Mintalah contoh spesifik proyek otomasi yang pernah mereka bangun, termasuk masalah yang diselesaikan dan tools yang digunakan. Mintalah contoh code atau repository GitHub yang menunjukkan kemampuan pemrograman mereka.
Struktur tim seperti apa yang paling cocok untuk SRE?
SRE dapat ditempatkan di dalam tim product atau diorganisasikan dalam tim platform yang terpusat. Struktur terbaik bergantung pada ukuran dan kebutuhan organisasi Anda, tetapi pastikan ada jalur komunikasi yang jelas antara SRE dan tim development.
FAQ Site Reliability Engineer untuk Pencari Kerja
Bahasa pemrograman apa yang harus saya pelajari untuk peran SRE?
Python dan Go paling umum digunakan, tetapi fokuslah mendalami satu bahasa dibandingkan mempelajari banyak bahasa secara dangkal. Shell scripting dan bahasa infrastructure-as-code seperti HCL (Terraform) juga bernilai.
Bagaimana saya bisa mendapatkan pengalaman SRE tanpa memiliki jabatan SRE?
Fokuslah pada proyek otomasi, implementasi monitoring, dan respons insiden dalam peran Anda saat ini. Berkontribusilah pada proyek infrastruktur open-source dan bangun proyek pribadi yang menunjukkan keterampilan SRE.
Apakah gelar ilmu komputer diwajibkan untuk posisi SRE?
Meskipun lebih disukai, pengalaman setara dapat menggantikan pendidikan formal. Fokuslah membangun keterampilan yang terbukti dalam pemrograman, administrasi sistem, dan manajemen infrastruktur.
Seberapa menekan tanggung jawab on-call bagi SRE?
Tingkat stres on-call bervariasi tergantung organisasi dan kematangan sistem. Tim SRE yang dikelola dengan baik memiliki rotasi on-call yang wajar, dokumentasi yang baik, dan berfokus pada pengurangan frekuensi insiden melalui pencegahan.
Bagaimana jalur perkembangan karier untuk SRE?
SRE dapat berkembang menjadi Senior SRE, Staff SRE, atau peran kepemimpinan SRE. Sebagian bertransisi ke platform engineering, peran arsitektur, atau posisi engineering management.
Senior Operations & Growth Strategist
On this page
- Ringkasan Singkat
- Mengapa Peran Ini Penting
- Templat Deskripsi Pekerjaan Utama
- Tentang Peran Ini
- Tanggung Jawab Utama
- Persyaratan
- Yang Kami Tawarkan
- Variasi Konteks
- Lingkungan Korporat
- Lingkungan Startup
- Lingkungan Remote/Hybrid
- Pertimbangan Industri
- Panduan Kompensasi
- Informasi Gaji
- Pertanyaan Wawancara
- Pertanyaan Teknis/Fungsional
- Pertanyaan Perilaku
- Pertanyaan Kecocokan Budaya
- Tips Perekrutan
- Panduan Sourcing Singkat
- Tanda Bahaya yang Harus Dihindari