Confiança quando o seu colega de equipe é uma AI
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
Confiar em um colega de equipe AI significa calibrar o quanto você depende da saída dele pela evidência de quão confiável ele realmente é em uma determinada tarefa, e não pelo quão confiante ele soa. É uma habilidade diferente de confiar em um colega, porque uma AI não tem intenção de enganar e não tem carreira em jogo se estiver errada, o que remove os dois sinais que as pessoas normalmente usam para decidir em quem acreditar.
A maioria dos conselhos sobre "confiar na AI" pula direto para a política: escrever uma diretriz de uso, acrescentar uma regra de divulgação e pronto. Isso é necessário, mas não é a parte difícil. A confiança em um colega humano e em um colega AI funciona com mecânicas quase totalmente diferentes, e as equipes que não percebem a diferença acabam presas em um de dois modos de falha caros: refazer em silêncio tudo o que a AI tocou ou carimbar uma saída que se revela confiantemente errada. Este artigo trata de por que as mecânicas diferem, dos dois modos de falha com a pesquisa por trás deles, de como é a confiança calibrada na prática, do que de fato a constrói e das normas de equipe que a tornam duradoura.
Por que confiar em uma AI é um problema diferente de confiar em uma pessoa
A confiança humana se apoia em uma base simples e bem estudada: você observa a capacidade de alguém, sua integridade e se a pessoa parece se importar com os seus interesses (benevolência), em situações suficientes para que um padrão surja. Tratamos desse modelo em profundidade em como construir confiança no ambiente de trabalho. O mecanismo funciona porque uma pessoa tem intenção: ela pode escolher enganar você, e a possibilidade de ser pega, de um custo de reputação, é parte do que mantém a maioria das pessoas honesta.
Um sistema de AI não tem nenhuma das duas partes desse mecanismo. Ele não pretende induzir você ao erro quando está errado e não tem reputação a proteger, nem carreira em jogo. Não é uma falha moral, é só um tipo diferente de sistema, mas significa que os atalhos que as pessoas normalmente usam para decidir em quem confiar (essa pessoa tem boas intenções, tem algo a perder se não entregar) simplesmente não se aplicam. Você fica avaliando algo mais próximo de um instrumento de medição do que de um colega: quão preciso ele é, em que condições e como saber quando ele saiu da calibração.
Confiante e errado parece idêntico a confiante e certo
O problema mais agudo é a apresentação. Uma pessoa que não tem certeza de uma resposta costuma sinalizar isso com hesitação, tom de voz ou linguagem corporal. Um modelo de linguagem de grande porte produz uma citação inventada, um número errado ou uma frase fabricada exatamente no mesmo registro fluente e seguro de uma resposta correta. Essa é a mecânica central por trás da alucinação de AI: o sistema não está mentindo, está gerando texto plausível, e plausível e verdadeiro não são a mesma propriedade. Nada no quão confiante a saída soa diz qual das duas você está vendo.
Esse único fato é o motivo de a confiança em AI não poder simplesmente estender a confiança em pessoas. Você precisa de sinais externos, evidência de testes, histórico em uma tarefa específica, fontes que dê para conferir, porque o sinal interno que os humanos leem por instinto como confiança foi desacoplado da confiabilidade real.
Os dois modos de falha: desconfiança excessiva e confiança excessiva
As equipes sem uma abordagem deliberada não caem no meio. Elas oscilam para um dos dois extremos, e ambos custam caro, cada um à sua maneira.
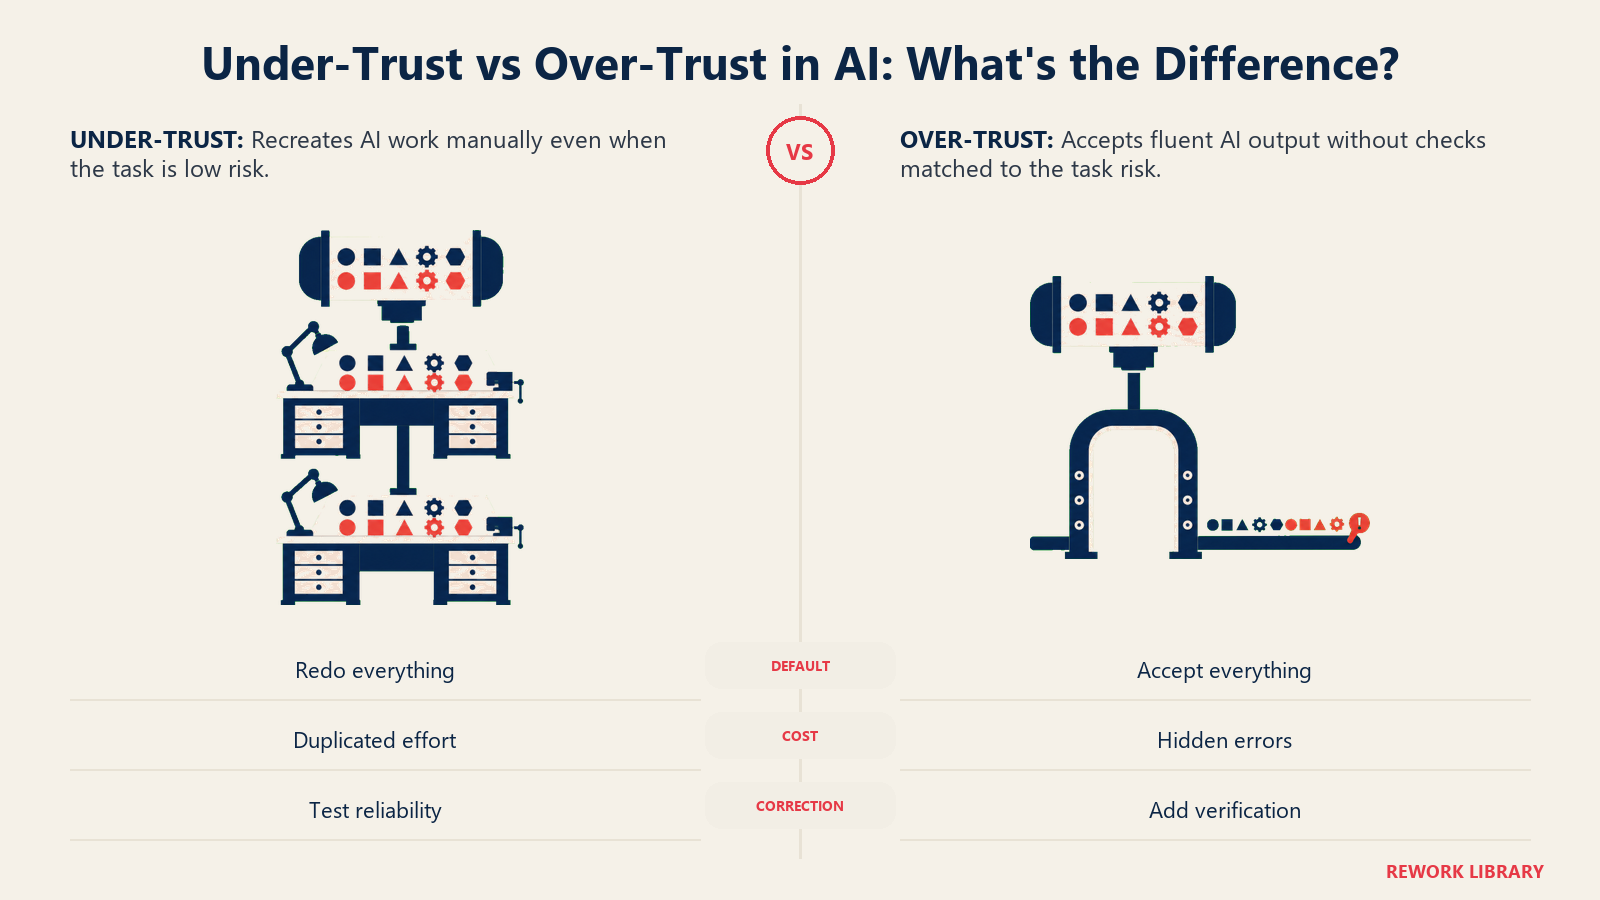
Desconfiança excessiva: refazer o trabalho do agente à mão
A desconfiança excessiva parece responsável na superfície. Um gestor revisa cada linha que um agente produz com o mesmo escrutínio que aplicaria se não confiasse no sistema de forma alguma, na prática fazendo o trabalho duas vezes. Isso apaga o ganho de produtividade que a AI deveria entregar. Se conferir um rascunho leva o mesmo tempo que escrevê-lo do zero, a organização acrescentou uma ferramenta sem mudar o resultado, e quem faz a dupla checagem acaba esgotado ou para em silêncio, o que só adia o problema da confiança excessiva em vez de resolvê-lo.
A desconfiança excessiva aparece com mais força em equipes que tiveram uma única experiência ruim no início com uma ferramenta de AI e nunca voltaram a ela. Um único fato alucinado e constrangedor em uma apresentação para o cliente pode congelar por um ano a disposição de uma equipe de depender da saída da AI, mesmo depois de a ferramenta melhorar.
Confiança excessiva: viés de automação e o custo de pular a checagem
A confiança excessiva, ou viés de automação, é a tendência de dar à saída de um sistema automatizado mais peso do que as evidências sustentam, e de parar de verificar depois que o sistema acertou algumas vezes. É um dos modos de falha mais bem documentados na pesquisa sobre interação entre humanos e automação, com décadas de estudos de aviação e segurança, e piora, não melhora, à medida que os sistemas de AI evoluem, porque um sistema que acerta 95% das vezes é confiante o bastante para fazer as pessoas pararem de checar os outros 5%.
Um estudo de 2023 na revista Radiology quantificou a gravidade que isso pode alcançar. Os pesquisadores pediram que 27 radiologistas lessem 50 mamografias, algumas acompanhadas da sugestão de classificação BI-RADS de um sistema de AI. Quando a sugestão da AI estava errada, a precisão dos radiologistas menos experientes despencou de cerca de 80% para menos de 20%. Os radiologistas com mais de 15 anos de experiência também não ficaram imunes: a precisão deles caiu de 82% para 45,5%. A experiência reduziu o dano. Não chegou perto de eliminá-lo.
Esse é um cenário clínico, mas o mecanismo aparece também no trabalho do conhecimento comum, sob um nome de menor risco: workslop. Uma pesquisa de setembro de 2025 com 1.150 trabalhadores em tempo integral dos EUA, feita pela BetterUp Labs e pelo Social Media Lab de Stanford, constatou que 40% haviam recebido "workslop", conteúdo gerado por AI que parece polido, mas não tem a substância para fazer uma tarefa avançar, no mês anterior. Cada ocorrência levou em média duas horas para ser resolvida, a um custo estimado de $186 por colaborador por mês, ou cerca de $9 milhões por ano para uma empresa de 10.000 pessoas. O workslop é a confiança excessiva na prática: alguém aceitou o rascunho de um agente pelo valor de face, repassou e deixou a verificação de verdade para quem o recebeu em seguida.
Fatos Relevantes
- A precisão dos radiologistas nas leituras de mamografia caiu de cerca de 80% para menos de 20% entre os leitores menos experientes, e de 82% para 45,5% entre os leitores com mais de 15 anos de experiência, quando a sugestão de um sistema de AI estava incorreta, em um estudo com 27 radiologistas lendo 50 mamografias. Fonte: Automation Bias in Mammography, Radiology (RSNA), via EurekAlert
- 40% de 1.150 trabalhadores em tempo integral dos EUA pesquisados receberam "workslop" gerado por AI no mês anterior, com cada ocorrência custando em média duas horas para corrigir, cerca de $186 por colaborador por mês, ou aproximadamente $9 milhões por ano para uma empresa de 10.000 pessoas. Fonte: BetterUp Labs, "Workslop"
- 60% dos executivos já usam AI na tomada de decisão, mas apenas 5% dizem geri-la bem, uma lacuna que a Deloitte aponta como um dos fatores da "dívida cultural" organizacional. Fonte: Deloitte 2026 Global Human Capital Trends
- 56% dos líderes projetam a AI exclusivamente para resultados de negócio; só 40% a projetam tanto para resultados de negócio quanto humanos, e 42% dos trabalhadores dizem que a organização nem sequer avalia o impacto da AI sobre as pessoas. Fonte: Deloitte 2026 Global Human Capital Trends
- Quando os gestores demonstraram de forma visível o próprio uso de AI, os colaboradores relataram um aumento de 30 pontos na confiança em agentic AI e tiveram 1,4 vez mais chances de se tornarem usuários frequentes dela, apoiados por uma rede de segurança. Fonte: Microsoft Work Trend Index 2026
Confiança calibrada: confie, mas verifique, com detalhes concretos
Os pesquisadores que estudam a interação entre humanos e automação usam o termo confiança calibrada (também chamada de dependência adequada) para o estado-alvo entre os dois modos de falha: aceitar a saída de um sistema quando a evidência diz que ele é confiável e contestar quando a evidência diz que não é, tarefa por tarefa, e não como política geral. A distinção que importa aqui é entre confiança e dependência. Confiança é o que alguém diz acreditar sobre um sistema; dependência é o que a pessoa realmente faz com a saída dele. A pesquisa encontra de forma consistente que as duas se afastam: alguém pode dizer que não confia totalmente numa ferramenta de AI e mesmo assim agir sobre a saída sem conferir, porque verificar dá trabalho e o caminho de menor resistência é aceitar.
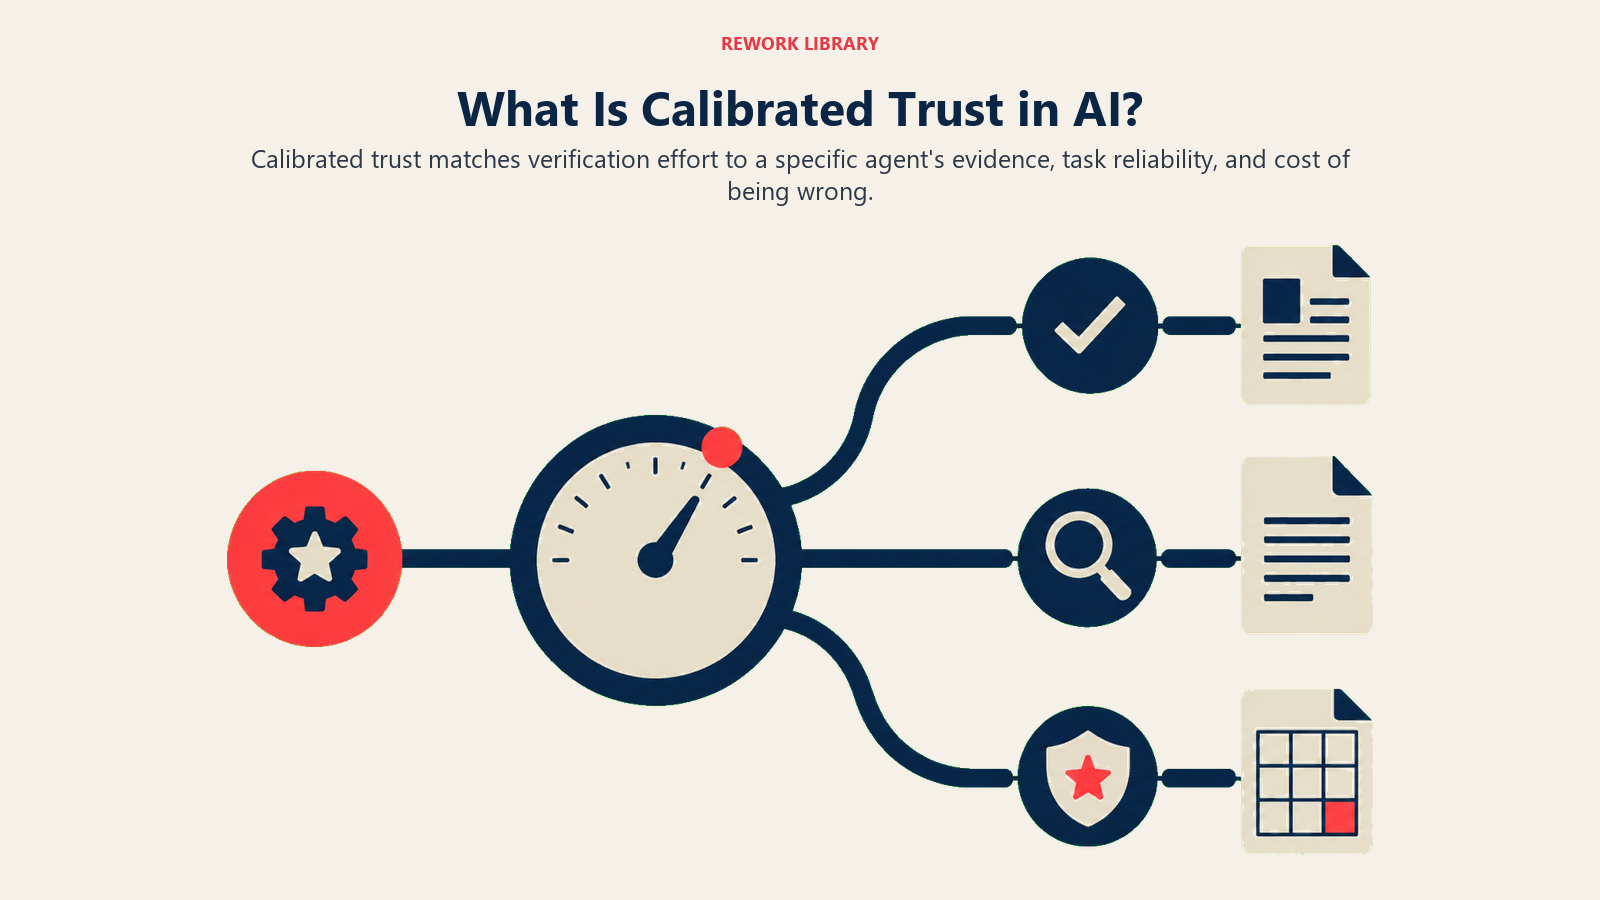
A calibração só funciona quando é específica para a tarefa, não para a ferramenta como um todo. Um agente que redige com confiabilidade um primeiro resumo de reunião tem um perfil de confiabilidade completamente diferente do mesmo modelo quando pedem a ele que calcule uma projeção financeira ou cite um precedente jurídico. "Confiamos na AI?" é a pergunta errada. "Confiamos neste agente, nesta tarefa, com base no que realmente o vimos acertar e errar?" é a pergunta útil.
Saiba onde o agente é confiável e onde não é
Montar esse retrato no nível da tarefa exige acompanhamento deliberado, não intuição. Uma equipe que percebeu em silêncio que um agente acerta primeiros rascunhos de e-mails de rotina, mas inventa estatísticas com frequência em resumos de pesquisa, fez um trabalho de calibração real, mesmo que ninguém tenha escrito. A lacuna da maioria das equipes não está em perceber, está em tornar esse conhecimento explícito e compartilhado em vez de ficar na cabeça de uma pessoa, para que um novo contratado não repita o erro de confiança excessiva que o resto da equipe já aprendeu a evitar.
Como é a verificação no dia a dia
Na prática, isso significa conferir por amostragem as afirmações com fonte antes de um documento sair da empresa, validar qualquer número produzido por um agente contra uma referência conhecida e tratar um primeiro rascunho como rascunho a editar, não como algo a encaminhar como está. Nada disso exige refazer o trabalho do zero, e é isso que separa a confiança calibrada da desconfiança excessiva: checagem direcionada onde o agente é sabidamente fraco e aceitação confiante onde é sabidamente forte.
O que constrói uma confiança adequada em AI
Quatro coisas movem uma equipe de forma confiável do palpite para a calibração, e nenhuma delas é um treinamento pontual.
Transparência. Um agente que mostra suas fontes, sinaliza seu nível de confiança ou explica os passos que deu dá à pessoa algo concreto para avaliar, em vez de uma resposta final polida para aceitar ou rejeitar por fé. As equipes que trabalham com ferramentas que expõem o raciocínio ou as citações tendem a calibrar mais rápido do que as presas a uma caixa-preta que só devolve um resultado de aparência limpa.
Histórico. A confiança em um novo contratado se constrói observando-o lidar com situações reais ao longo de semanas. A confiança em um agente deve se construir do mesmo jeito, mantendo um registro honesto do que ele acertou e errou em tipos de tarefa específicos, e não supondo que o desempenho da primeira semana prevê o da décima segunda.
Limites de proteção. A confiança é mais fácil de estender quando o custo de um erro é limitado. Um agente restrito a redigir, não a enviar; a recomendar, não a executar um pagamento; a sinalizar, não a fechar um ticket automaticamente, dá às pessoas margem para verificar antes que algo irreversível aconteça. Aprofundamos como delimitar essa autoridade em guardrails de agentes de AI.
Human-in-the-loop por projeto, não por padrão. Há uma diferença real entre um fluxo de trabalho com um ponto de checagem posicionado de propósito onde os erros mais importam e outro em que um humano apenas dá uma olhada na saída porque sempre foi assim. O human-in-the-loop bem feito coloca o ponto de checagem no ponto de maior alavancagem, e não em toda parte, que é justamente o que causa o modo de falha da desconfiança excessiva.
O ângulo da equipe e da cultura: normas compartilhadas sobre quando checar
Nada disso funciona se ficar na cabeça de uma pessoa cuidadosa. O ponto de falha real na maioria das equipes não é que ninguém saiba que deve verificar a saída do agente, é que não existe uma resposta compartilhada e explícita para "quem checa o quê e quando", então cada um segue o próprio instinto, e os instintos variam muito. Uma pessoa confere tudo por amostragem; outra encaminha os rascunhos do agente sem olhar de novo; nenhuma segue uma norma escrita, porque não existe uma.
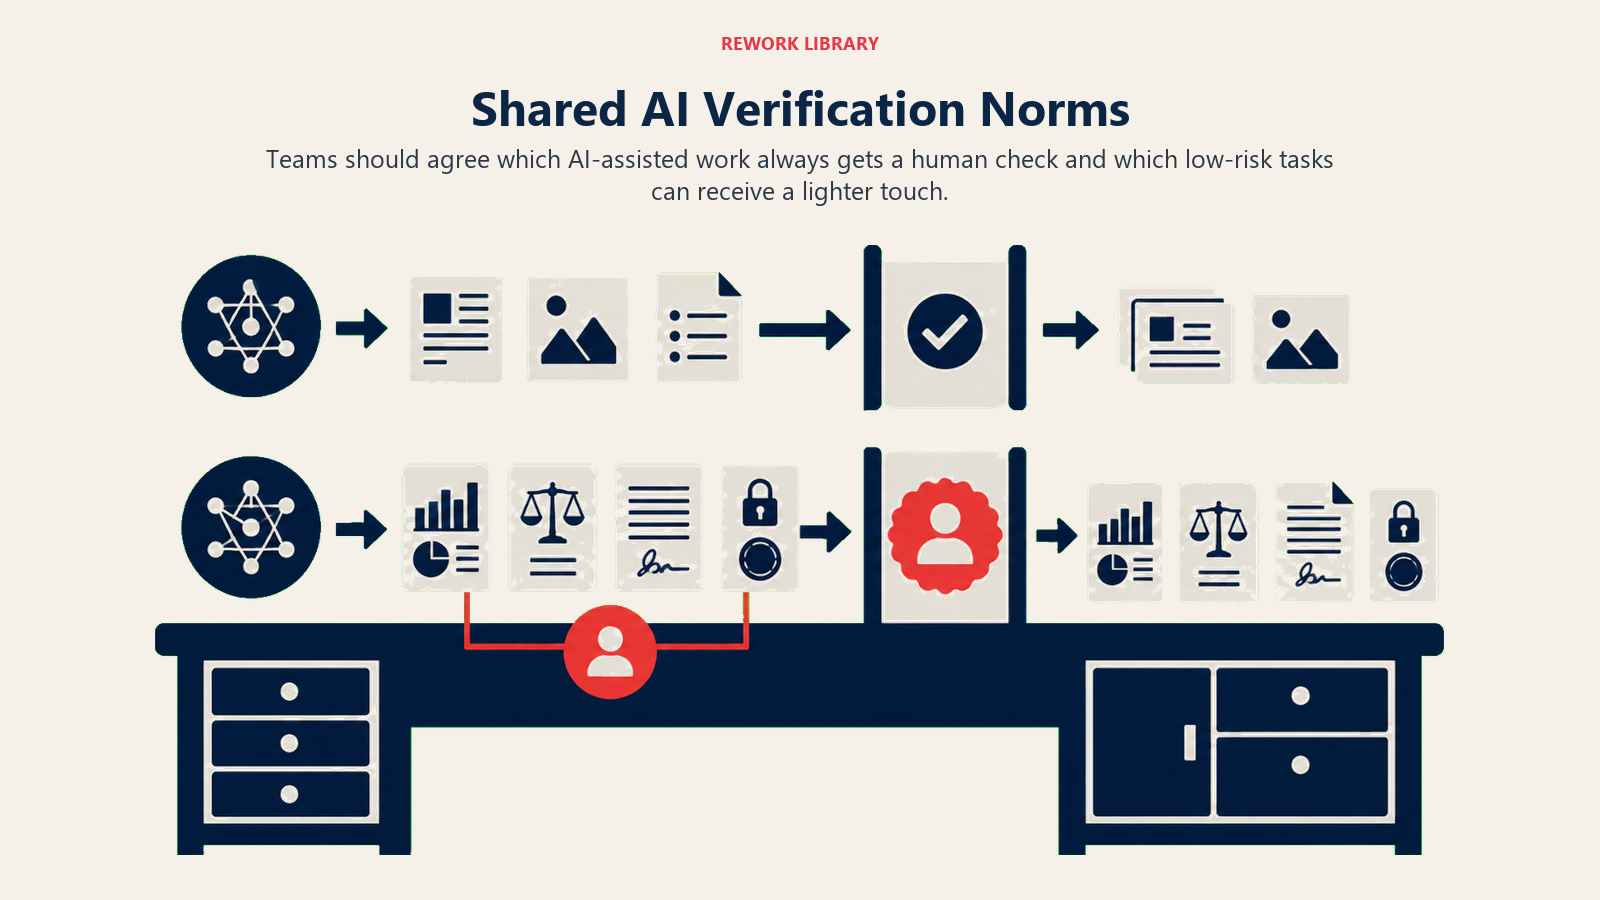
Isto é, em essência, um problema de cultura, não de ferramenta. Etiqueta de AI e normas no ambiente de trabalho trata do conjunto mais amplo de regras não escritas que as equipes estão negociando em torno de divulgação e uso adequado; a versão específica da confiança significa combinar, em voz alta, quais categorias de trabalho sempre passam por uma checagem humana antes de qualquer coisa sair da empresa (números para clientes, linguagem jurídica, qualquer coisa irreversível) e quais têm risco baixo o bastante para um toque leve. Errar essa divisão em qualquer direção reproduz um dos dois modos de falha acima no nível da equipe e não do indivíduo.
As mesmas normas importam mais, não menos, quando os agentes deixam de ser ferramentas operadas por uma pessoa e passam a atuar como parte do resultado real da equipe, a mudança tratada em equipes de humanos e agentes. Uma equipe sem normas de confiança compartilhadas não falha de forma barulhenta. Ela acumula o tipo de lacuna que a Deloitte chama de dívida cultural da AI: dependência excessiva silenciosa em alguns cantos, dupla checagem redundante silenciosa em outros, e ninguém com um retrato claro do que acontece onde até que um erro visível force a conversa. Acertar isso é uma peça da mudança maior tratada em como é, de fato, uma cultura AI-native, em que confiança, ownership e responsabilização precisam ser reconstruídos de propósito.
Nada disso é exclusivo de empresas com equipes de AI dedicadas. Uma empresa de cinco pessoas que usa um agente para redigir e-mails de prospecção precisa da mesma resposta explícita para "quem confere isto antes de sair" que uma empresa de mil pessoas. O que está em jogo cresce com o tamanho da empresa; o problema de calibração, não.
Próximos passos
- Como construir confiança no ambiente de trabalho, os modelos de confiança entre humanos com os quais este artigo faz contraste
- Equipes de humanos e agentes, o que muda quando um agente passa a fazer parte do resultado real, e não é só uma ferramenta
- Dívida cultural da AI, o que acontece quando as normas de confiança nunca são construídas e a lacuna se acumula
- Etiqueta de AI e normas no ambiente de trabalho, o conjunto mais amplo de regras não escritas que as equipes estão negociando em torno do uso de AI
- O que é uma cultura AI-native?, o retrato completo de como a confiança e a responsabilização mudam quando os agentes são colegas de equipe
- O que é agentic AI?, como esses sistemas planejam e agem, parte do motivo de seus erros serem diferentes dos de uma ferramenta simples
- Alucinação de AI, o mecanismo específico por trás da saída confiante, fluente e errada
- Human-in-the-loop, como projetar o ponto de checagem em vez de deixá-lo ao hábito
A confiança em um colega de equipe AI não deveria ser um sentimento privado carregado por quem por acaso o observa mais de perto. Torne-a uma medição: acompanhe onde o agente é confiável, onde não é e compartilhe essa leitura com a equipe, para que a confiança seja calibrada em vez de presumida. As equipes que fazem isso param de oscilar entre a fé cega e a suspeita generalizada e passam a usar o agente exatamente para aquilo que ele conquistou, nem mais nem menos.

Co-Founder, Rework.com
On this page
- Por que confiar em uma AI é um problema diferente de confiar em uma pessoa
- Confiante e errado parece idêntico a confiante e certo
- Os dois modos de falha: desconfiança excessiva e confiança excessiva
- Desconfiança excessiva: refazer o trabalho do agente à mão
- Confiança excessiva: viés de automação e o custo de pular a checagem
- Fatos Relevantes
- Confiança calibrada: confie, mas verifique, com detalhes concretos
- Saiba onde o agente é confiável e onde não é
- Como é a verificação no dia a dia
- O que constrói uma confiança adequada em AI
- O ângulo da equipe e da cultura: normas compartilhadas sobre quando checar
- Próximos passos