ROI nach ACE-Fähigkeit: Welche AI-Investitionen zahlen sich am schnellsten aus

Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
Die meisten AI-Budgetgespräche gehen aus demselben Grund schief: Sie behandeln alle AI-Investitionen als austauschbar. Eine Board-Präsentation fasst „AI-Ausgaben" in einer einzigen Zeile zusammen und fordert eine einzige Return-on-Investment-Zahl (ROI). Aber ein AI, der am Anfang Ihres Workflows Dokumente Ingestet, liefert eine grundlegend andere Rendite als einer, der am Ende Bestellungen Executed.
Sie als gleichwertig zu behandeln ist der Grund, warum die falschen Projekte zuerst genehmigt werden und man dem Board dann erklären muss, warum „AI" nicht geliefert hat, was versprochen wurde.
Das ACE Framework definiert fünf Fähigkeiten von Business-AI: Ingest, Analyze, Predict, Generate und Execute. Jede operiert an einem anderen Punkt in der Wertschöpfungskette. Jede hat ein anderes ROI-Profil: was Sie messen, wie typische Renditen aussehen und wie schwer es ist, Kausalität nachzuweisen. Das Verstehen dieser Profile ermöglicht es Ihnen, Investitionen rational zu sequenzieren und ehrliche Erwartungen bei Stakeholdern zu setzen.
Dieser Artikel ordnet jede der fünf Fähigkeiten ihrem ROI-Profil zu, einschließlich einer einfachen ROI-Rechenvorlage, die Sie für interne Präsentationen anpassen können.
Warum ROI je nach ACE-Fähigkeit variiert
Key Facts: AI-Fähigkeits-ROI-Realität
- Agentic-AI-Deployments (Execute-schwere) liefern in Enterprise-Umgebungen durchschnittlich 171 % ROI, etwa 3x traditionelle Automatisierungsrenditen, aber nur 15-25 % der Unternehmen haben AI über die Pilot-Phase hinaus skaliert. (Menlo Ventures / Bain)
- Die Zeit bis zum ROI reicht von zwei Wochen für Kundenservice-Automatisierung (Generate + Execute) bis zu 12+ Monaten für Supply-Chain-Orchestrierung (Predict + Execute). (AI Monk)
- Die durchschnittliche Organisation hat 2025 46 % der AI-Proof-of-Concepts vor der Produktion aufgegeben, mit Attributionsschwierigkeiten und unklaren Kennzahlen als Hauptgründen. (Master of Code)
ROI ist nicht gleichmäßig über AI-Typen hinweg, weil Wertschöpfung an verschiedenen Punkten in einem Geschäftsprozess stattfindet.
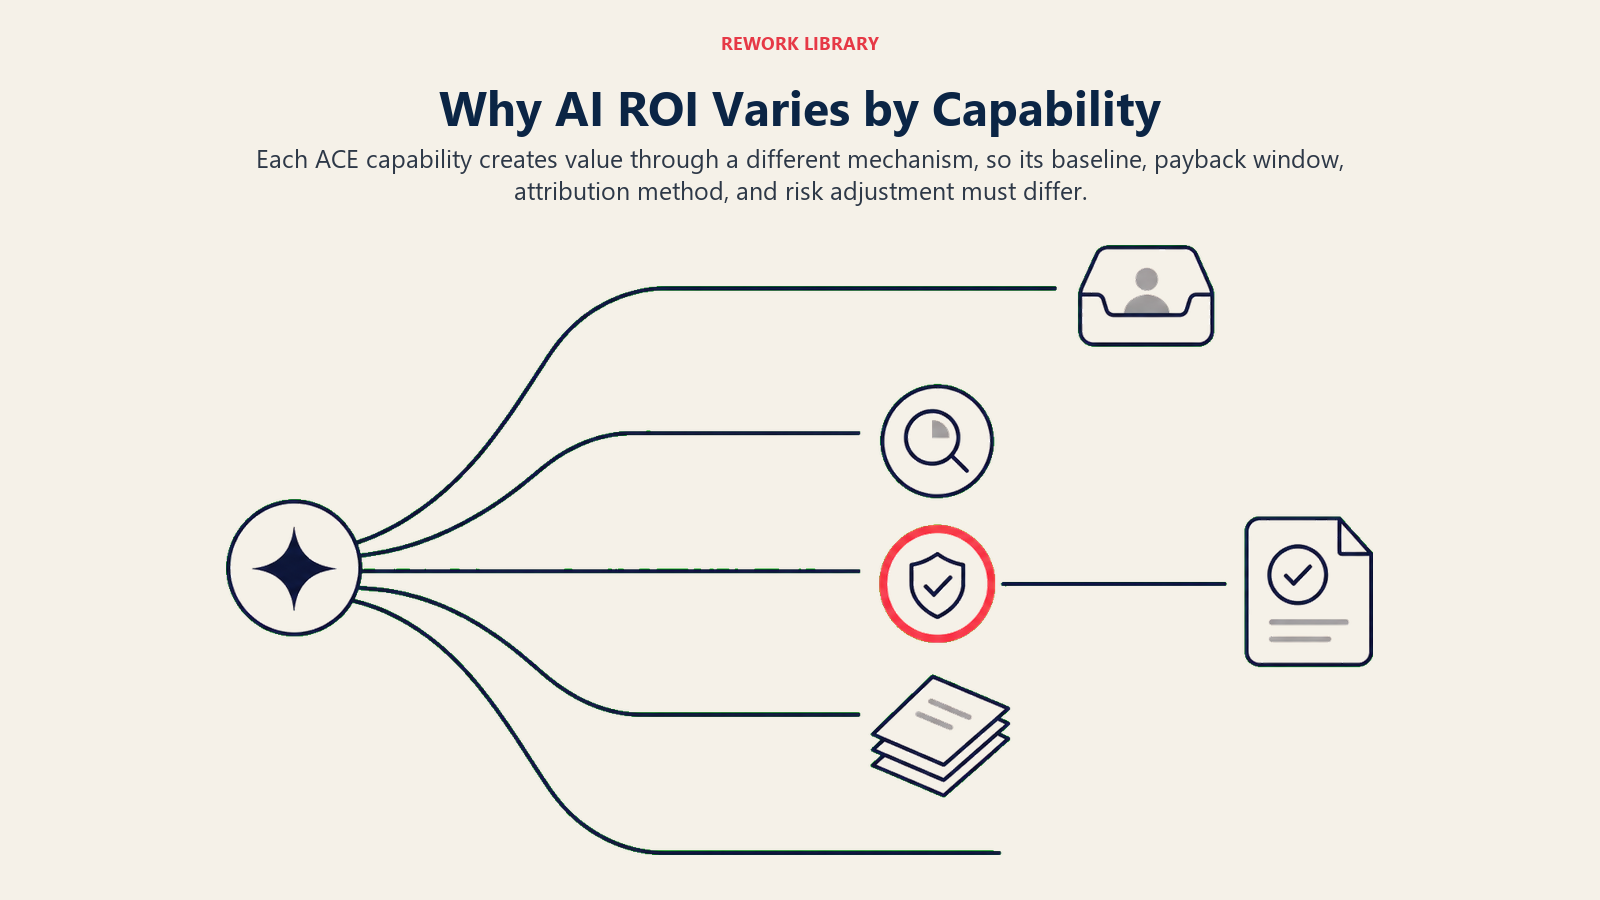
Ingest liegt stromaufwärts, in dem Moment, in dem Informationen in Ihre Systeme eintreten. Sein Nutzen ist für Umsatzkennzahlen unsichtbar. Analyze liegt in der Mitte und beeinflusst, wie schnell und gut Menschen Entscheidungen treffen. Predict liegt am Wendepunkt zwischen „wir haben Daten" und „wir handeln danach" und hat das höchste theoretische Umsatz-Attributionspotenzial. Generate erzeugt Artefakte, die Menschen dann nutzen, und schafft eine Schicht zwischen AI-Output und Geschäftsergebnis. Execute verändert den Zustand direkt und ist die Fähigkeit, die messbaren Kosten- oder Umsatzereignissen am nächsten ist.
Diese Progression von stromaufwärts nach stromabwärts ist auch eine Progression von schwerer zu messbar nach leichter zu messbar. Aber sie ist das Gegenteil der Risikohierarchie: Execute ist am leichtesten im ROI nachzuweisen und auch am teuersten, wenn etwas schief läuft.
Einige weitere Variablen erklären die Streuung.
Attribution wird schwieriger mit Entscheidungskomplexität. Wenn ein AI einen ersten Entwurf generiert, den ein Rep in eine gewinnende E-Mail bearbeitet, wie viel von diesem Deal geht auf den AI? Sie wissen es nicht. Wenn ein AI eine Bestellung aufgibt, die einen Engpass verhindert, sind die Kosten des verhinderten Engpasses zurechenbar. Der eine hat eine saubere Kausalkette, der andere nicht.
Time-to-Value variiert. Ingest-Fähigkeiten (optische Zeichenerkennung, Transkription, Dokumentenparsing) gehören oft zu den schnellsten zu deployen und günstigsten zu messen. Execute-Fähigkeiten dauern am längsten, um sicher zu deployen, schaffen aber die beständigste Kostenreduktion, wenn sie laufen.
Messinfrastruktur ist entscheidend. Den Predict-ROI nachzuweisen erfordert A/B-Testing-Infrastruktur: eine Kontrollgruppe, die das Modell nicht nutzt, gegenüber einer Testgruppe, die es nutzt. Die meisten Unternehmen haben diese Infrastruktur nicht aufgebaut, wenn sie ihr erstes AI-Projekt starten. Das ist kein technisches Problem, sondern ein Prozessproblem.
Ingest-ROI-Profil
Was Ingest tut: Konvertiert rohe Signale (Bilder, Audio, gescannte PDFs, Dokumentenströme) in Informationen, mit denen AI arbeiten kann. OCR (Optical Character Recognition), Speech-to-Text, Dokumentenparsing und strukturierte Datenextraktion sind kanonische Ingest-Operationen.
Primäre Kennzahlen:
- Reduktion der manuellen Dateneingabezeit (Stunden/Woche, pro Operator)
- Datengenauigkeitsrate (Fehler pro 1.000 Datensätze, vor vs. nach)
- Verarbeitungsdurchsatz (verarbeitete Dokumente pro Stunde)
Typische Renditen: Ein Finance-Team, das manuell Rechnungen in ein ERP-System (Enterprise Resource Planning) eingibt, könnte 30 Sekunden bis 2 Minuten pro Dokument benötigen. Ein Ingest-AI, der dieselben Dokumente verarbeitet, läuft typischerweise unter 3 Sekunden mit 95-99 % Genauigkeit. Für ein Team, das 500 Rechnungen täglich verarbeitet, sind das 4-8 Stunden manuelle Arbeit täglich, die eliminiert werden, plus eine messbare Reduktion von Eingabefehlern, die zuvor nachgelagerte Abstimmungsprobleme verursacht haben.
Kosten pro Extraktion gegenüber der menschlichen Baseline ist die sauberste ROI-Vorlage für Ingest. Wenn eine Stunde menschlicher Dateneingabe 25 \(kostet und Sie 10.000 Dokumente pro Monat mit je 2 Minuten verarbeiten, betragen Ihre manuellen Kosten rund 8.300\) pro Monat. Ein Ingest-AI für 500 $ pro Monat (üblich bei Dokumentenautomatisierungs-Tools für den Mittelstand) zeigt eine klare Amortisation.
Messherausforderung: Ingest-Vorteile sind stromaufwärts. Weniger Fehler in Quelldaten bedeuten weniger Probleme drei Schritte später in der Kreditorenbuchhaltung, in Kundendatensätzen oder im CRM (Customer Relationship Management). Aber „die Abstimmungsprobleme, die wir nicht hatten" erscheinen nicht im Dashboard. Sie müssen die richtigen Proxy-Kennzahlen (Fehlerraten, Nachbearbeitungsstunden) vor der Einführung messen, um den Vorher-Nachher-Vergleich zu ermöglichen. Die meisten Teams überspringen diesen Schritt und können dann nicht nachweisen, was sie gespart haben. Der Artikel Vision Extract Pattern behandelt den Ingest-Use-Case am ausführlichsten, einschließlich der Genauigkeits-Benchmarks, die Sie als Baselines vor dem Deployment verwenden sollten.
ROI-Rechenvorlage:
Monatliche Einsparungen = (Dokumente/Monat × durchschn._manuelle_Zeit_Min / 60) × stündliche_Arbeitskosten
ROI = (monatliche_Einsparungen - Tool_Kosten) / Tool_Kosten × 100%
Analyze-ROI-Profil
Was Analyze tut: Gibt dem Ingestierten Sinn. Klassifikation, Extraktion, Zusammenfassung, Sentimentdetektion und Entitätserkennung sind alles Analyze-Operationen. Analyze ist das, was rohen Text oder Daten in etwas Handlungsfähiges für einen Menschen umwandelt.
Primäre Kennzahlen:
- Entscheidungsgeschwindigkeit: Zeit von Informationsverfügbarkeit bis Entscheidung (Stunden bis Minuten)
- Analyst-Kapazitäts-Redeployment: freigesetzte Stunden pro Woche für urteilsstärkere Arbeit
- Klassifikationsgenauigkeit vs. menschliche Baseline
Typische Renditen: Ein Kundenservice-Team, das 2.000 Tickets täglich klassifiziert, verbringt erhebliche Analysten-Zeit mit der Weiterleitung von Arbeit, bevor sie überhaupt angetastet wird. Ein Analyze-AI, der eingehende Tickets mit 90 %+ Genauigkeit klassifiziert und taggt, befreit Routing-Entscheidungen vollständig und senkt die Zeit bis zur ersten menschlichen Antwort von Stunden auf Sekunden.
In recherchelastigen Rollen (Competitive Intelligence, Finanzanalyse, juristische Prüfung) können Analyze-Fähigkeiten Stunden an Synthese auf Minuten verdichten. Der typisch berichtete Produktivitätsgewinn für Wissensarbeiter, die AI-Zusammenfassungs- und Extraktionstools nutzen, liegt bei 20-40 % in der aufgabenbezogenen Zeit, abhängig von der Komplexität des Quellmaterials.
Messherausforderung: Entscheidungsqualität ist schwer von AI-Analysequalität zu trennen. Wenn Ihr Analyst nach dem Lesen einer AI-generierten Zusammenfassung bessere Entscheidungen trifft, wie viel dieses Ergebnisses gehört dem AI und wie viel dem Urteilsvermögen des Analysten? Die Entscheidungsgeschwindigkeit können Sie präzise messen. Die Umschichtung von Analystenkapazität können Sie mit Zeiterfassung messen. Aber die Umsatzattribution aus schnelleren oder besseren Entscheidungen erfordert kontrollierte Experimente, die die meisten Unternehmen nicht entworfen haben. Das RAG Assistant Pattern zeigt, wie Sie die Analyze-Fähigkeit instrumentieren, um Verbesserungen der Entscheidungsqualität über die Zeit zu verfolgen.
Die praktische Empfehlung: beginnen Sie damit, den Proxy zu messen (Zeiteinsparungen, Durchsatz), nicht die Umsatzauswirkung. Verwenden Sie die ersten sechs Monate, um Baseline-Daten aufzubauen. Die Umsatzattribution kommt später, sobald Sie genug Entscheidungen mit bekannten Ergebnissen haben.
Predict-ROI-Profil
Was Predict tut: Bewertet Wahrscheinlichkeiten, prognostiziert Ergebnisse, priorisiert Optionen und erkennt Anomalien. Lead-Scoring, Churn-Prediction, Nachfrageprognose und Betrugserkennung sind kanonische Predict-Anwendungen.
Primäre Kennzahlen:
- Conversion Rate (von Modell als „hoch" bewertete Leads vs. nicht bewertete)
- Churn-Reduktionsrate (markierte vs. nicht markierte Accounts, 90-Tage-Ergebnisvergleich)
- Prognosegenauigkeit (Mean Absolute Percentage Error, MAPE, vor vs. nach AI-Prognose)
- False-Positive/Negative-Raten für Anomalieerkennung
Typische Renditen: Predict hat das höchste Umsatz-Attributionspotenzial aller ACE-Fähigkeiten, weil es direkt beeinflusst, welche Maßnahmen Menschen bei den wertvollsten Geschäftsergebnissen ergreifen. Ein gut kalibriertes Lead-Scoring-Modell, das Reps hilft, die obersten 20 % der Leads zu priorisieren (die typischerweise 60-80 % der Conversions ausmachen), kann die Quotenerreichung ohne zusätzlichen Headcount spürbar verbessern. Churn-Prediction-Modelle, die gefährdete Accounts 30-60 Tage vor dem Erneuerungsentscheidungsfenster identifizieren, geben Customer-Success-Teams Zeit zum Eingreifen.
Die Bandbreite der berichteten Ergebnisse ist hier größer als bei jeder anderen Fähigkeit. Schwache Predict-Implementierungen (Modelle, die auf unzureichenden Daten trainiert und ohne Adoptionsprozesse für Reps eingeführt wurden) zeigen nahezu keinen Lift. Starke Implementierungen mit richtiger A/B-Testing-Infrastruktur und Integration in den Rep-Workflow zeigen in vergleichbaren Benchmarks 10-30 % Verbesserung der Conversion Rate. McKinseys Analyse des wirtschaftlichen Potenzials von generativer AI hebt Marketing und Vertrieb als die Domain hervor, wo Predict- und Scoring-Fähigkeiten den messbarsten Wert konzentrieren, mit einer geschätzten Verbesserung der Vertriebsproduktivität um 3-5 % gegenüber den aktuellen globalen Vertriebsausgaben.
Messherausforderung: Predict-ROI ist am schwierigsten sauber zuzuschreiben. Es erfordert A/B-Testing-Infrastruktur, um den Modellbeitrag von allem anderen, was gleichzeitig passiert (Rep-Können, Produktänderungen, Marktbedingungen, Preisbewegungen), zu isolieren. Ohne eine Holdout-Gruppe wissen Sie nicht, ob die Konversionsverbesserung vom Modell oder von Rep-Verhaltensweisen stammt, die zufällig damit korrelieren.
Die meisten Unternehmen, die Predict-ROI ohne A/B-Testing behaupten, berichten Korrelation, keine Kausalität. Das ist kein Grund, die Predict-Fähigkeit zu meiden, sondern ein Grund, die Messinfrastruktur vor dem Deployment zu entwerfen, nicht danach. Das Scoring and Routing Pattern behandelt das A/B-Testing-Design für Predict-Deployments, einschließlich des Aufbaus von Holdout-Gruppen, die Vertriebsteams akzeptieren.
Generate-ROI-Profil
Was Generate tut: Erzeugt neue Artefakte aus Prompts und Kontext. E-Mail-Entwürfe, Berichte, Code, Zusammenfassungen, Bilder und strukturierte Pläne sind alles Generate-Outputs. Das Artefakt existiert in Entwurfsform, bis ein Mensch es überprüft und einsetzt.
Primäre Kennzahlen:
- Erstentwurf-Zeiteinsparungen (Minuten pro Artefakt)
- Inhaltsvolumen bei konstantem Headcount
- Bearbeitungs-zu-Veröffentlichungs-Zykluszeit (Zeit vom Briefing bis zum endgültigen Entwurf)
- Markenkonsistenz-Score (bei AI mit Style-Guide-Enforcement)
Typische Renditen: Generate-Fähigkeit liefert die klarsten Zeiteinsparungen aller ACE-Fähigkeiten, und diese Einsparungen sind schnell zu messen, weil die Erstentwurf-Zeit leicht zu beobachten ist. Ein Marketing-Team, das zuvor 4 Stunden für einen Blog-Beitrag aufgewendet hat, berichtet typischerweise 45-90 Minuten für denselben Artikel mit AI-Drafting. Ein Sales Rep, der einen benutzerdefinierten Vorschlag entwirft, kam von 60-90 Minuten auf 15-20 Minuten.
Die Rechnung beim Inhaltsvolumen ist einfach: Wenn ein Team vor AI 8 Blog-Beiträge pro Monat produziert hat und jetzt mit demselben Headcount 18 produziert, können Sie die effektiven Kosten pro Beitrag berechnen und mit dem vergleichen, was freie Autoren berechnen würden. Inhaltsvolumen bei konstantem Headcount ist eine saubere, vertretbare Generate-ROI-Kennzahl.
Messherausforderung: Qualitätsmessung ist der schwierige Teil. Volumen ist leicht zu messen; Qualität nicht. Ein Erstentwurf, der erhebliche menschliche Bearbeitung erfordert, um veröffentlichungsfähig zu werden, erfasst weniger ROI als einer, der nur leichte Bearbeitung benötigt. Die Messung der „Edit Distance" (wie stark sich das Endergebnis vom AI-Entwurf unterscheidet) liefert einen Qualitäts-Proxy, erfordert aber Tooling und konsequentes Tracking, das die meisten Teams nicht haben.
Generate-ROI wird in frühen Pilots oft überschätzt, weil Teams die Zeiteinsparungen des AI-Entwurfs messen, ohne Überprüfungszeit, Qualitätsverlust (Inhalte, die technisch existieren, aber schlecht performen) und die Koordinationskosten für die Verwaltung des AI-generierten Volumens zu berücksichtigen.
Die ehrliche Einordnung: Generate spart erhebliche Zeit bei Erstentwürfen. Es ersetzt nicht das Urteilsvermögen, das nötig ist, um diese Entwürfe gut zu machen. Die Forschung der MIT Sloan zum Skalieren von generativer AI am Arbeitsplatz fand, dass die Zufriedenheit der Mitarbeitenden mit AI-Drafting-Tools stärker mit wahrgenommenen Qualitätsverbesserungen korreliert als mit der reinen Zeitersparnis, weshalb es wichtig ist, beide Dimensionen zu messen.
Execute-ROI-Profil
Was Execute tut: Verändert den Zustand außerhalb des AI-Systems. Sendet E-Mails, aktualisiert Datensätze, löst Workflows aus, führt Transaktionen durch und leitet Arbeit weiter. Execute ist der Punkt, an dem AI aufhört, Vorschläge zu generieren, und beginnt, Maßnahmen mit realen Konsequenzen zu ergreifen.
Primäre Kennzahlen:
- Prozessautomatisierungsrate (Prozentsatz eines Workflows ohne menschliche Intervention behandelt)
- Zykluszeit-Komprimierung (Zeit von Auslösung bis Abschluss)
- Fehlerreduktionsrate (Prozessfehler vor vs. nach Automatisierung)
- Kosten-pro-Transaktion vs. menschliche Baseline
Typische Renditen: Execute-Fähigkeit liefert die direkteste Kostenreduktion aller ACE-Fähigkeiten, wenn sie gut funktioniert. Ein AP-Automatisierungssystem (Accounts Payable), das eine Rechnung erhält, sie mit einer Bestellung abgleicht, Ausnahmen an Menschen weiterleitet und genehmigte Rechnungen automatisch zahlt, komprimiert einen 5-7-tägigen Prozess für die eindeutigen Fälle auf denselben oder nächsten Tag. In transaktionsstarken Umgebungen (E-Commerce, Finanzdienstleistungen, Logistik) eliminiert Execute-Automatisierung im großen Maßstab ganze Rollenkategorien oder verhindert erhebliches Headcount-Wachstum, wenn das Volumen skaliert.
Aber die Renditen sind nur dann sauber, wenn der Prozess selbst klar definiert ist. Execute, angewendet auf einen unordentlichen, ausnahmenlastigen Prozess, liefert nicht die erwarteten Einsparungen und schafft oft neue Probleme: im großen Maßstab falsch ausgeführte Aktionen, falsch behandelte Sonderfälle, Lücken im Audit Trail.
Messherausforderung: Execute-ROI ist am klarsten zu messen, aber Vorfälle sind am teuersten zu beheben. Ein falsch konfigurierter Execute-Workflow, der falsche Rechnungs-E-Mails an 10.000 Kunden sendet oder Käufe jenseits der Genehmigungsgrenzen auto-genehmigt, schafft Kosten, die die Einsparungen weit übersteigen. Das ROI-Kalkül muss risikobereinigte Vorfallswahrscheinlichkeit einschließen, nicht nur die Steady-State-Einsparungen.
Das richtige Governance-Modell für Execute: erwartete Einsparungen messen, Vorfallswahrscheinlichkeit und -kosten schätzen, prüfen, ob der risikobereinigte ROI weiterhin trägt, und dann mit einer Human-in-the-Loop-Freigabestufe deployen, die Sie erst entfernen, wenn Vertrauen aufgebaut ist. Siehe Governance by Pattern für das Aufsichtsmodell und AI Pattern Cost Overruns für die Vorfallskostenkategorien, die in jedes risikobereinigte Execute-ROI-Modell einfließen müssen.
Das Fähigkeits-ROI-Profil pro Fähigkeit
Das Fähigkeits-ROI-Profil pro Fähigkeit ordnet jede der fünf ACE-Fähigkeiten (Ingest, Analyze, Predict, Generate, Execute) ihrer eigenen Messmethodik, dem typischen Rendite-Fenster und der Attributionsschwierigkeit zu. Anstatt „AI ROI" als eine einzige Zahl zu behandeln, ermöglicht dieses Profil Programmsponsorinnen und -sponsoren, fähigkeitsspezifische Investitionsfälle mit der richtigen Messinfrastruktur für jeden zu präsentieren.
Quotable: „Predict-Fähigkeit hat das höchste Umsatz-Attributionspotenzial aller ACE-Fähigkeiten, weil sie direkt bestimmt, welche Maßnahmen Menschen bei den wertvollsten Geschäftsergebnissen ergreifen. Sie erfordert aber auch A/B-Testing-Infrastruktur, die die meisten Unternehmen nicht aufbauen, bis ihr erster Predict-Einsatz keinen vertretbaren ROI nachweist."
Quotable: „Execute-Fähigkeits-ROI ist am klarsten zu messen und am teuersten, wenn etwas schief läuft. Ein falsch konfigurierter Execute-Workflow, der falsche Abrechnung an 10.000 Kunden sendet, schafft Kosten, die ein volles Jahr Automatisierungseinsparungen übersteigen."
Quotable: „Beginnen Sie mit Generate. Es erfordert keine Integration, keine historischen Daten und keinen Genehmigungsprozess für den Einsatz. Der ROI ist ungenau aber real, und er baut Team-Vertrautheit mit AI auf, bevor Sie Fähigkeiten angehen, die mehr kosten, wenn sie scheitern."
| ACE-Fähigkeit | Time-to-Value | Attributionsschwierigkeit | Primäre ROI-Kennzahl | Typische Renditen |
|---|---|---|---|---|
| Ingest | 2-6 Wochen | Niedrig (direkte Arbeitskosten) | Kosten pro extrahiertem Dokument | 500 $/Mo AI vs. 8.300 $/Mo manuell bei 10.000 Dokumenten |
| Analyze | 4-8 Wochen | Mittel (Entscheidungsqualität) | Entscheidungsgeschwindigkeit, Analysten-Kapazität | 20-40 % Zeiteinsparung pro Wissensarbeiter |
| Predict | 3-6 Monate | Hoch (A/B-Test erforderlich) | Conversion Rate, Churn-Reduktion | 10-30 % Conversion-Lift mit richtigen Kontrollen |
| Generate | 2-4 Wochen | Niedrig-Mittel (Volumen klar, Qualität weniger) | Erstentwurf-Zeit, Inhaltsvolumen | 60-75 % Reduktion der Erstentwurf-Zeit |
| Execute | 2-4 Monate | Niedrig (direkte Kosten pro Transaktion) | Prozessautomatisierungsrate, Zykluszeit | Eliminiert proportionales Headcount-Wachstum bei Skalierung |
Rework-Analyse: Basierend auf Deployment-Sequenzierungsmustern bauen Unternehmen, die mit Generate- oder Ingest-Fähigkeiten beginnen, Messkompetenz und organisationales Vertrauen auf, bevor sie Predict und Execute angehen, wo die Einsätze und die Messkomplexität beide höher sind. Mit Execute zu beginnen, weil es die höchste ROI-Obergrenze hat, ist der häufigste Sequenzierungsfehler in frühen AI-Programmen.
Investitionssequenzierung nach Reifestufe
Die Sequenzierung ist wichtig, weil dieselbe ACE-Fähigkeit auf einer Reifestufe hohe Renditen bringen und auf einer anderen ablenken oder riskant sein kann.
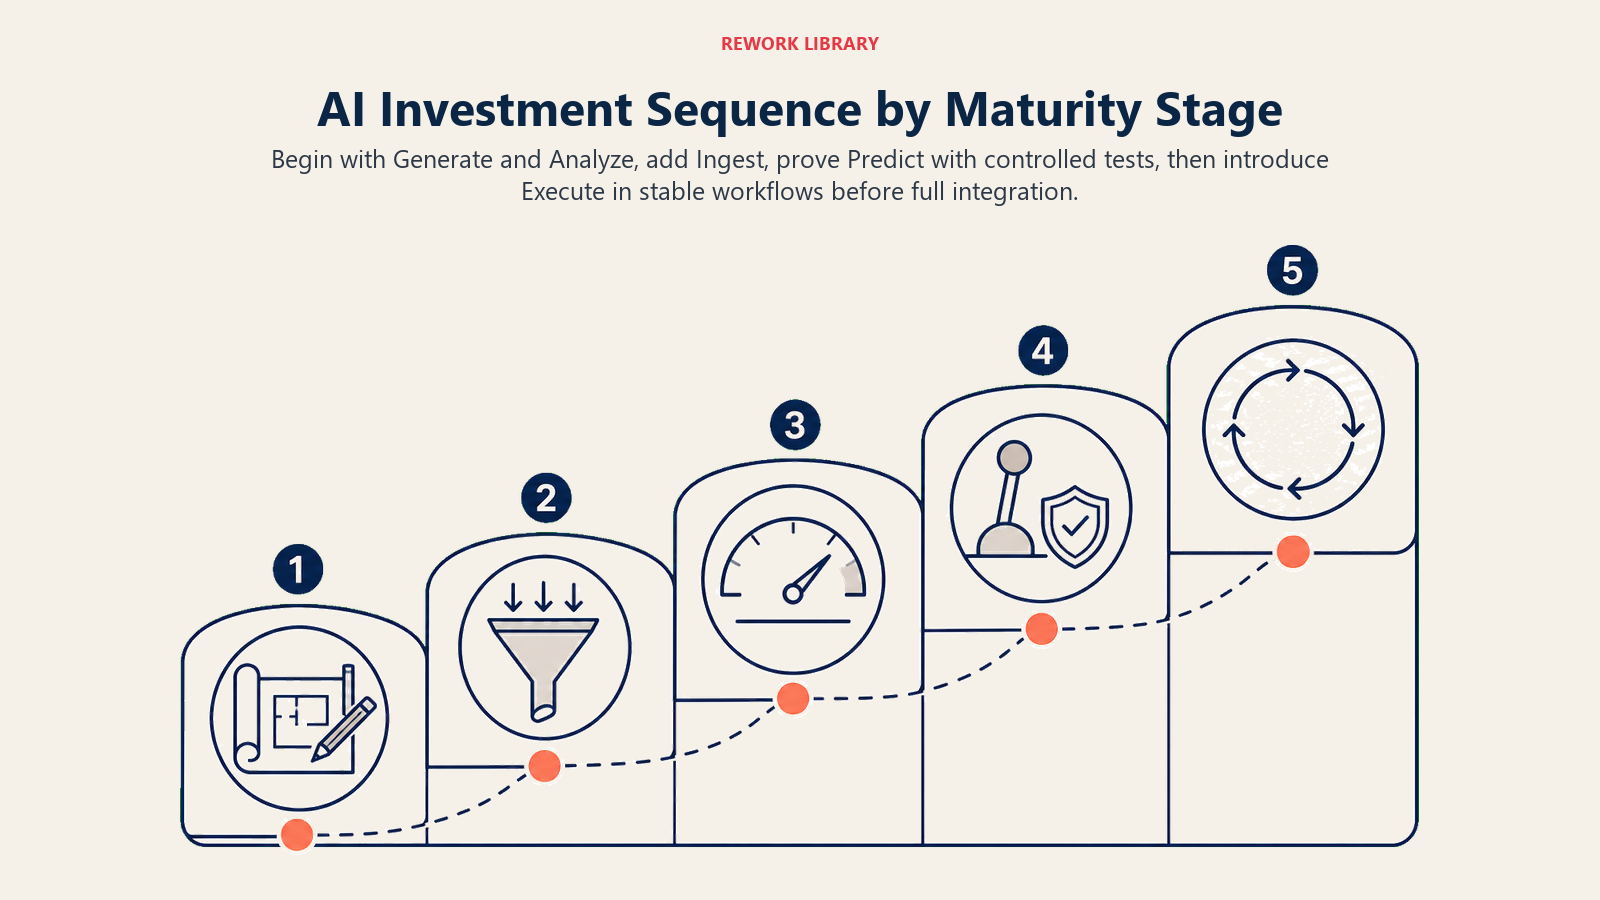
Die ACE-Fähigkeiten ergeben nicht alle gleichzeitig Sinn. Unternehmen auf verschiedenen Reifestufen sollten unterschiedlich priorisieren.
Stufe 1 (Ad-hoc): Beginnen Sie mit Generate. Es erfordert keine Integration, keine historischen Daten und keinen Genehmigungsprozess für den Einsatz. Der ROI ist ungenau aber real, und er baut Team-Vertrautheit mit AI auf, bevor Sie schwierigere Fähigkeiten angehen. Fügen Sie Analyze für interne Dokumentzusammenfassungen und Ticket-Klassifikation hinzu.
Stufe 2 (Pilot): Fügen Sie Ingest für Ihre hochvolumigsten Dokument- oder Dateneingabe-Workflows hinzu. Der ROI ist messbar, die Integration ist begrenzt und das Risiko ist gering. Beginnen Sie, die Messinfrastruktur für Predict zu entwerfen (Baseline-Conversion-Raten, historisches Daten-Audit), auch wenn Sie Predict noch nicht einsetzen.
Stufe 3 (Skaliert): Setzen Sie Predict bei Ihrem ersten Use-Case ein, bei dem Sie 12+ Monate saubere historische Daten mit bekannten Ergebnissen haben. Investieren Sie in die A/B-Testing-Infrastruktur. Überspringen Sie das nicht; behaupteter Predict-ROI ohne Holdout-Gruppen ist gegenüber einem skeptischen CFO nicht vertretbar.
Stufe 4 (Integriert): Führen Sie Execute für Ihre hochvolumigsten, vorhersehbarsten Workflows zuerst ein. Nicht für ausnahmeintensive Prozesse. Nicht für kundennahe Transaktionen, bis Konfidenzintervalle etabliert sind. Bauen Sie Incident-Response-Playbooks vor dem Deployment auf.
Stufe 5 (Transformational): Alle fünf Fähigkeiten laufen, integriert miteinander, mit Menschen, die überwachen anstatt routinemäßige Arbeit auszuführen. Der ROI wird auf dieser Stufe auf Ebene der Geschäftsergebnisse gemessen, nicht auf Ebene der Fähigkeiten.
Das Sequenzierungsprinzip ist einfach: Beginnen Sie mit Fähigkeiten, die am günstigsten zu messen und am wenigsten riskant sind, wenn etwas schief geht. Arbeiten Sie in Richtung Fähigkeiten, die die höchsten Renditen und das höchste Risiko haben. Überspringen Sie die Messinfrastruktur unterwegs nicht.
Es für Ihren CFO zusammenstellen
Die Board-Präsentation, die genehmigt wird, ist nicht die, die die höchste ROI-Zahl verspricht. Es ist die, die spezifisch ist über das Gemessene, ehrlich über das Schwer-zu-Beweisende und so sequenziert, dass sie organisationales Vertrauen aufbaut.
Verwenden Sie die obigen Fähigkeitsprofile, um jede Investition mit ihrem eigenen Messmodell zu rahmen, anstatt eines einzigen gemischten ROI-Anspruchs. „Unser Ingest-Projekt für AP-Automatisierung zeigt einen projizierten 3,2x ROI gegen eine messbare Baseline" ist eine finanzierbare Aussage. „AI wird unser Unternehmen um 30 % verbessern" ist es nicht.
Für Fähigkeiten, bei denen Attribution wirklich schwierig ist (Analyze, Generate, besonders Predict), rahmen Sie die frühe Investition als Messinfrastruktur: Sie bauen die Baseline und den A/B-Testing-Apparat auf, damit die skalierte Investition vertretbaren ROI hat. Das ist ehrlich, und so arbeiten die Unternehmen, die das gut machen, tatsächlich.
Die 5 Dimensionen des AI ROI und Warum AI ROI schwer zu beweisen ist erweitern dieses Framework weiter. Die SaaS AI Maturity Stages ordnen die Sequenzierungslogik dem Branchenkontext zu. Und das CFO-Gespräch über das AI-Budget zeigt, wie man fähigkeitsspezifische ROI-Profile in Budgetsprache übersetzt, die genehmigt wird.
Die hier gezeigte fähigkeitsspezifische Sicht ist der Ausgangspunkt. Zu verstehen, dass der ROI von Ingest und Generate leicht zu messen und von mittlerer Größenordnung ist, während der Predict-ROI schwer zu messen und potenziell groß ist, sagt Ihnen, wie Sie Ihre Investition in Phasen aufteilen und wie Sie sie gegenüber den Personen kommunizieren, die das Budget genehmigen.
Häufig gestellte Fragen
Welche ACE-Fähigkeit zahlt sich am schnellsten zurück?
Generate- und Ingest-Fähigkeiten zeigen typischerweise den schnellsten ROI, oft innerhalb von zwei bis sechs Wochen nach dem Deployment. Generate reduziert die Erstentwurf-Zeit um 60-75 %, was sofort messbar ist. Ingest eliminiert manuelle Dateneingabe zu berechenbaren Kosten pro Dokument. Keine der beiden erfordert A/B-Testing-Infrastruktur oder mehrmonatige Attributionsfenster.
Welche ACE-Fähigkeit hat das höchste ROI-Potenzial?
Predict-Fähigkeit hat das höchste Umsatz-Attributionspotenzial, weil sie direkt beeinflusst, welche Maßnahmen Menschen bei den wertvollsten Geschäftsergebnissen ergreifen. Lead-Scoring, Churn-Prediction und Nachfrageprognose können 10-30 % Konversions- oder Bindungsverbesserung mit richtigem kontrollierten Experimentdesign zeigen. Der Kompromiss ist, dass Predict auch die meiste Messinfrastruktur erfordert, um ROI glaubwürdig nachzuweisen.
Warum ist Execute-ROI am leichtesten zu messen?
Execute verändert den Zustand direkt und auf messbare Weise: Prozessautomatisierungsrate, Zykluszeit-Komprimierung, Kosten pro Transaktion. Im Gegensatz zu Predict oder Analyze erfordert Execute-ROI keine Attribution durch menschliche Entscheidungsfindung. Execute-Vorfälle sind jedoch am kostspieligsten zu beheben, daher muss der risikobereinigte ROI Vorfallswahrscheinlichkeit und Behebungskosten einschließen.
In welcher Reihenfolge sollten Unternehmen ACE-Fähigkeiten einsetzen?
Die empfohlene Sequenzierung ist: Stufe 1 (Generate + Analyze für risikoarme interne Workflows), Stufe 2 (Ingest für hochvolumigste Dokument-Workflows), Stufe 3 (Predict mit richtiger A/B-Testing-Infrastruktur), Stufe 4 (Execute für gut definierte, ausnahmenarme Prozesse). Diese Reihenfolge bewegt sich von günstigst-zu-messen und niedrigstem-Risiko-wenn-falsch hin zu höchster-Rendite und höchsten-Einsätzen.
Warum scheitern die meisten AI-Pilots beim Nachweis von ROI?
Die durchschnittliche Organisation hat 2025 46 % der AI-Proof-of-Concepts vor der Produktion aufgegeben, hauptsächlich aufgrund von Attributionsschwierigkeiten und unklaren Kennzahlen. Die Ursachen ordnen sich direkt fähigkeitsspezifischen Fehlern zu: Predict ohne A/B-Testing-Infrastruktur einsetzen, Generate nach Volumen ohne Qualitätskontrollen messen und Execute ohne risikobereinigte ROI-Modelle einsetzen, die Vorfallswahrscheinlichkeit einschließen.
Wie unterscheidet sich Analyze-ROI von Predict-ROI?
Analyze erzeugt Erkenntnisse, auf die Menschen dann handeln, was Attribution indirekt macht. Seine primäre ROI-Kennzahl ist Entscheidungsgeschwindigkeit und freigesetzte Analysten-Kapazität, keine Umsatzergebnisse. Predict bewertet Wahrscheinlichkeiten, die menschliche Handlungen bei hochwertigen Entscheidungen (kaufen, abwandern, ausfallen) leiten, was Attribution durch kontrollierte Experimente möglich macht. Analyze ist einfacher einzusetzen, aber schwerer mit Umsatz zu verbinden; Predict ist schwerer einzusetzen, aber direkter Umsatzergebnissen zuzuschreiben.
