IP und Urheberrecht in AI-Outputs: Was CEOs und Legal Teams 2026 wissen müssen
 Ihr Marketing-Team generiert monatlich 200 Inhaltsstücke mit AI-Unterstützung. Ihre Entwickler verwenden GitHub Copilot zum Schreiben von Produktionscode. Ihr Legal-Team entwirft Vertragsklauseln mit Claude. Ihr Produkt-Team generiert UI-Copy mit einem benutzerdefinierten AI-Workflow.
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
Ihre IP-Richtlinie wurde 2019 geschrieben. Sie sagt nichts über AI.
Diese Lücke existiert in den meisten Organisationen und schafft drei Expositionskategorien, die General Counsels und CEOs verstehen müssen. Das ACE Framework (Ingest, Analyze, Predict, Generate, Execute) ist hier nützlicher Kontext: Generate-Fähigkeit schafft das höchste Volumen an IP-Fragen, weil sie Artefakte in großem Maßstab produziert, während Execute-Fähigkeit die folgenreichsten schafft, weil AI-Aktionen Drittanbieter-Rechte ohne menschliche Überprüfung auslösen können.
Sie besitzen möglicherweise nicht, was Ihr AI produziert. Sie reproduzieren möglicherweise unwissentlich Inhalte, die Sie nicht reproduzieren dürfen. Und wenn Ihre Kunden Daten in Ihre AI-Systeme hochladen, ist die Frage, wem die abgeleiteten Ergebnisse gehören, möglicherweise nicht zu Ihren Gunsten beantwortet.
Keines dieser Risiken ist vollständig durch geltendes Recht gelöst. Die Rechtslandschaft für AI und geistiges Eigentum (IP) ist im Jahr 2026 aktiv umstritten, mit mehreren großen Verfahren in der Beweisaufnahme oder in der Berufung in den USA, der EU und dem Vereinigten Königreich. Aber vertretbare Positionen existieren, und die Organisationen, die diese Positionen jetzt klar in ihren Verträgen und Richtlinien etablieren, werden besser positioniert sein als jene, die auf eine Klärung des Rechts warten.
Dieser Artikel ist keine Rechtsberatung. Er ist ein Rahmen für CEOs, General Counsels (GC) und CIOs, um die Expositionsdimensionen zu verstehen, ihre aktuelle Position zu bewerten und die Richtlinien- und Vertragslücken zu identifizieren, die es wert sind, angegangen zu werden.
Die Eigentümerschaftsfrage: Aktueller rechtlicher Status
Key Facts: AI-Urheberrecht und IP
- Über 70 Verletzungsklagen wurden von Urheberrechtsinhabern gegen AI-Unternehmen eingereicht, wobei der Vergleich Bartz v. Anthropic 2025 eine Zahlung von 1,5 Milliarden Dollar ergab, der größten in der US-Urheberrechtsgeschichte. (Copyright Alliance)
- Der US Supreme Court lehnte Certiorari im März 2026 ab und bestätigte damit menschliche Urheberschaft als grundlegende Anforderung des US-Urheberrechts. Damit ist das Argument vom Tisch, AI-Outputs könnten eigenständigen Urheberrechtsschutz erhalten.
- 72 % der S&P-500-Unternehmen haben 2025 mindestens ein wesentliches AI-Risiko offengelegt, gegenüber 12 % im Jahr 2023, wobei IP- und Urheberrechtsexposition zu den am häufigsten offengelegten Kategorien gehört. (Harvard Law School Forum)
Die grundlegende Frage ist einfach: Wenn ein AI ein Inhaltsstück generiert, wem gehört es?
In den Vereinigten Staaten hat das Copyright Office klar erklärt, dass Werke, die vollständig von AI ohne menschliche Urheberschaft generiert werden, nicht für den Schutz nach dem Urheberrechtsgesetz in Frage kommen. Das Urheberrechtsgesetz schützt ursprüngliche Werke menschlicher Autoren. AI ist kein rechtlicher Autor.
Das Leitfaden des US Copyright Office zu AI und sein Teil-2-Urheberrechts-Bericht (Januar 2025) klären diese Position: AI-generierte Inhalte mit "ausreichender menschlicher Urheberschaft" können Urheberrechtsschutz erhalten, aber das Copyright Office bewertet Ansprüche auf menschliche Urheberschaft von Fall zu Fall. Je stärker ein Mensch den konkreten Ausdruck gestaltet hat (und nicht nur einen allgemeinen Prompt geliefert hat), desto stärker ist der Anspruch. Das Office verlangt außerdem, dass Antragsteller AI-generierte Inhalte in Registrierungsanträgen offenlegen und die spezifischen Beiträge des menschlichen Autors erläutern.
Was das praktisch bedeutet: Wenn Ihr Mitarbeiter einen Prompt schreibt, der sagt "schreib einen Blog-Beitrag über Lieferkettenstörungen", ist der resultierende Inhalt möglicherweise nicht urheberrechtlich schutzfähig. Wenn Ihr Mitarbeiter ein detailliertes Creative Brief schreibt, den AI-Entwurf erheblich bearbeitet, originale Analyse hinzufügt und spezifische gestalterische Entscheidungen durch den Überarbeitungsprozess trifft, hat das resultierende Werk einen stärkeren Anspruch auf menschliche Urheberschaft. Das Gesetz zieht keine klare Linie, und verschiedene Gerichte können sie unterschiedlich ziehen.
Der Fall Thaler v. Perlmutter (2023) bestätigte, dass vollständig AI-generierte Werke ohne menschliche Urheberschaft keinen Urheberrechtsschutz erhalten können. Das Gericht stellte fest, dass die Register of Copyrights zu Recht den Urheberrechtsschutz für ein Bild verweigert hatte, das von einem AI-System ohne bedeutenden menschlichen kreativen Beitrag generiert wurde. Dieser Fall betraf das Szenario "nur AI". Das Szenario mit teilweise menschlicher Urheberschaft wird noch ausgearbeitet.
In der Europäischen Union ist die Situation im Prinzip ähnlich, aber durch den EU AI Act kompliziert. Das EU-Urheberrechtsrahmen erfordert menschliche Urheberschaft für Schutz. Der EU AI Act regelt die Urheberrechtsinhaberschaft nicht direkt, stellt aber Transparenzanforderungen an AI-generierte Inhalte, insbesondere eine Offenlegungspflicht, wenn AI Inhalte generiert, die Verbraucher über ihre menschliche Herkunft täuschen könnten.
Das EU-Recht kennt ein verwandtes Schutzrecht für Datenbankhersteller und einige weitere Leistungsschutzrechte, die für AI-gestützte Zusammenstellungen gelten können, aber die Eigentümerschaftsfrage für AI-generierte ausdrucksstarke Inhalte ist im Wesentlichen dieselbe wie in den USA.
Im Vereinigten Königreich enthält das Copyright, Designs and Patents Act 1988 eine Bestimmung für "computererzeugte Werke", die möglicherweise Urheberrecht für AI-Ergebnisse ermöglicht, wobei der Schutz bei der Person liegt, "durch die die Vorkehrungen für die Schaffung des Werkes getroffen werden." Ob diese Bestimmung auf moderne generative AI-Ergebnisse ausgedehnt wird, ist ungetestet, und britische Gerichte haben bis 2026 nicht darüber entschieden.
Die praktische Implikation für Ihr Unternehmen: Wenn Ihr AI Inhalte generiert, die vollständig oder erheblich AI-generiert sind mit minimalem menschlichem kreativem Beitrag, besitzen Sie ihn möglicherweise nicht im traditionellen Urheberrechtssinn. Wettbewerber könnten Ihre AI-generierten Blog-Posts, Marketing-Texte oder Produktbeschreibungen ohne Verletzung Ihres Urheberrechts reproduzieren.
Das bedeutet nicht, dass AI-generierte Inhalte wertlos oder schutzlos sind. Geschäftsgeheimnisschutz kann für Ihre Prompts und Workflows gelten. Datenbankrechte können für Zusammenstellungen gelten. Vertragliche Schutzmaßnahmen können die Vervielfältigung unabhängig vom Urheberrecht einschränken. Aber die einfache Annahme "wir haben es gemacht, also gehört es uns" gilt für vollständig AI-generierte Outputs möglicherweise nicht.
Dokumentation als Risikoabsicherung
Die stärkste einzelne Maßnahme, die Organisationen ergreifen können, um AI-gestützte Arbeit zu schützen, ist die Dokumentation des menschlichen kreativen Beitrags zu dieser Arbeit.
Das bedeutet:
- Aufzeichnungen über menschliche Redaktionsentscheidungen führen, nicht nur das Endergebnis
- Die Prompts, Überarbeitungen und menschlichen Auswahlentscheidungen dokumentieren, die das Endwerk geformt haben
- Sicherstellen, dass die Erstellung AI-gestützter Inhalte sinnvolle menschliche Überprüfung und Modifikation beinhaltet, nicht nur die Akzeptanz von AI-Output
- Versionsgeschichte beibehalten, die zeigt, wo Menschen gestalterische Entscheidungen getroffen haben, die sich von der ursprünglichen Generierung des AI unterscheiden
Diese Dokumentation dient zwei Zwecken. Sie stärkt Urheberrechtsansprüche in Jurisdiktionen, die menschliche Urheberschaft erfordern. Und sie etabliert einen Nachweis menschlicher Beteiligung, der in vertraglichen oder regulatorischen Kontexten relevant werden kann.
Der Dokumentationsaufwand ist nicht groß. Ein einfaches Protokoll aus verwendetem Prompt, vorgenommenen menschlichen Bearbeitungen, freigebendem Reviewer und Datum schafft eine Nachweisspur, die deutlich stärker ist als gar keine Dokumentation. Die Building Your AI Use Policy liefert Ihnen den Richtlinienrahmen, der diese Dokumentation zu einem Standardbestandteil AI-gestützter Workflows macht, statt zu einer Ad-hoc-Praxis, der nur manche Mitarbeiter folgen.
Die 3 rechtlichen Fragen für AI-Output
Die 3-rechtlichen-Fragen-für-AI-Output ist ein Entscheidungsrahmen zur Bewertung von IP- und Urheberrechtsexposition in jedem AI-generierten Content-Workflow: (1) Besitzen wir es? (Gibt es ausreichend dokumentierte menschliche Urheberschaft, um Urheberrecht in dieser Jurisdiktion zu beanspruchen?), (2) Verletzt es? (Reproduziert der AI-Output Trainingsdaten, zu deren Nutzung der Anbieter nicht berechtigt war, und sind wir in der Haftungskette?), und (3) Decken unsere Verträge es ab? (Sprechen sowohl Anbieterverträge als auch Kundenverträge explizit AI-Output-Eigentümerschaft, Trainingsdaten-Nichtnutzung und Entschädigungsumfang an?) Jede Frage erfordert eine andere Bewertung und einen anderen Satz von Abhilfemaßnahmen.
Quotable: "Der US Supreme Court lehnte Certiorari im März 2026 ab und bestätigte damit menschliche Urheberschaft als grundlegende Anforderung des US-Urheberrechts. Wenn Ihr AI Inhalte mit minimalem menschlichem kreativem Beitrag generiert, besitzen Sie ihn möglicherweise nicht im traditionellen Urheberrechtssinn, und Wettbewerber könnten ihn ohne Verletzung Ihres Urheberrechts reproduzieren."
Quotable: "Der Vergleich Bartz v. Anthropic ergab 2025 eine Zahlung von 1,5 Milliarden Dollar, der größten in der US-Urheberrechtsgeschichte. IP-Entschädigungsklauseln in Enterprise-AI-Verträgen haben realen, aber ungetesteten Wert. 'Der Anbieter hat es getan' ist keine vollständige Verteidigung." (Copyright Alliance)
Quotable: "Die meisten Enterprise-IP-Richtlinien wurden für eine Vor-AI-Welt geschrieben. Wenn Ihre Richtlinie nichts über AI sagt, beantwortet sie nicht, wem der AI-abgeleitete Bericht aus Kundendaten gehört, ob der Blog-Beitrag, den Ihr Marketing-Team diesen Monat produziert hat, urheberrechtlich schutzfähig ist oder was Ihre Mitarbeiter in externe AI-Tools einfügen dürfen."
| Expositionstyp | Wer haftet | Primäre Abhilfemaßnahme | Vertragsabdeckung |
|---|---|---|---|
| Eigentümerschaftslücke | Ihre Organisation (kein Urheberrecht für nur-AI-Arbeit) | Menschliche Urheberschaftsbeiträge und Überarbeitungsentscheidungen dokumentieren | Explizite Output-Eigentümerschaftsgewährung vom Anbieter |
| Trainingsdaten-Verletzung | Primär Anbieter; Ihre Org in der Reproduktionskette | Enterprise-Verträge mit IP-Entschädigung verwenden; Hochrisiko-Inhaltskategorien vermeiden | IP-Entschädigungsklausel mit Mindestdeckungslimit |
| Kunden-Daten-IP-Mehrdeutigkeit | Ungeklärt ohne explizite Kundenvertragskonditionen | SaaS-Bedingungen aktualisieren, um AI-abgeleitete Output-Eigentümerschaft anzusprechen | Kundenvertragsklausel zu AI-Output-Eigentümerschaft und Datennichtnutzung |
| Mitarbeiter-Datenexposition | Ihre Organisation | AI-Nutzungsrichtlinie mit Datenklassifizierungsregeln; genehmigte Tool-Liste | Enterprise-Anbietervertrag mit Trainingsdaten-Nichtnutzungsbestimmung |
Rework Analysis: Basierend auf Rechtsexpositionsmustern in den Jahren 2025-2026 teilen die Organisationen mit den vertretbarsten AI-IP-Positionen drei Merkmale: Sie führen Versionsverläufe, die dokumentieren, wo menschliche Redaktionsentscheidungen getrennt von der AI-Generierung getroffen wurden, sie haben aktuelle Enterprise-Vereinbarungen, die von Legal geprüft (und nicht nur über Standard-Click-through-Bedingungen akzeptiert) wurden, und ihre IP-Richtlinie benennt AI-generierte Inhalte ausdrücklich als Kategorie, die vor der Veröffentlichung Dokumentation und Prüfung erfordert.
Trainingsdaten-Kontaminationsrisiko
Die zweite Expositionsdimension betrifft, was in die AI-Modelle eingegangen ist, die Sie verwenden. Wenn ein Foundation-Modell auf urheberrechtlich geschütztem Material trainiert wurde und das Modell dieses Material eng reproduziert, können Sie (als Nutzer) in der Haftungskette für diese Reproduktion sein.
Das ist der Kern der größten derzeit anhängigen Prozesse.
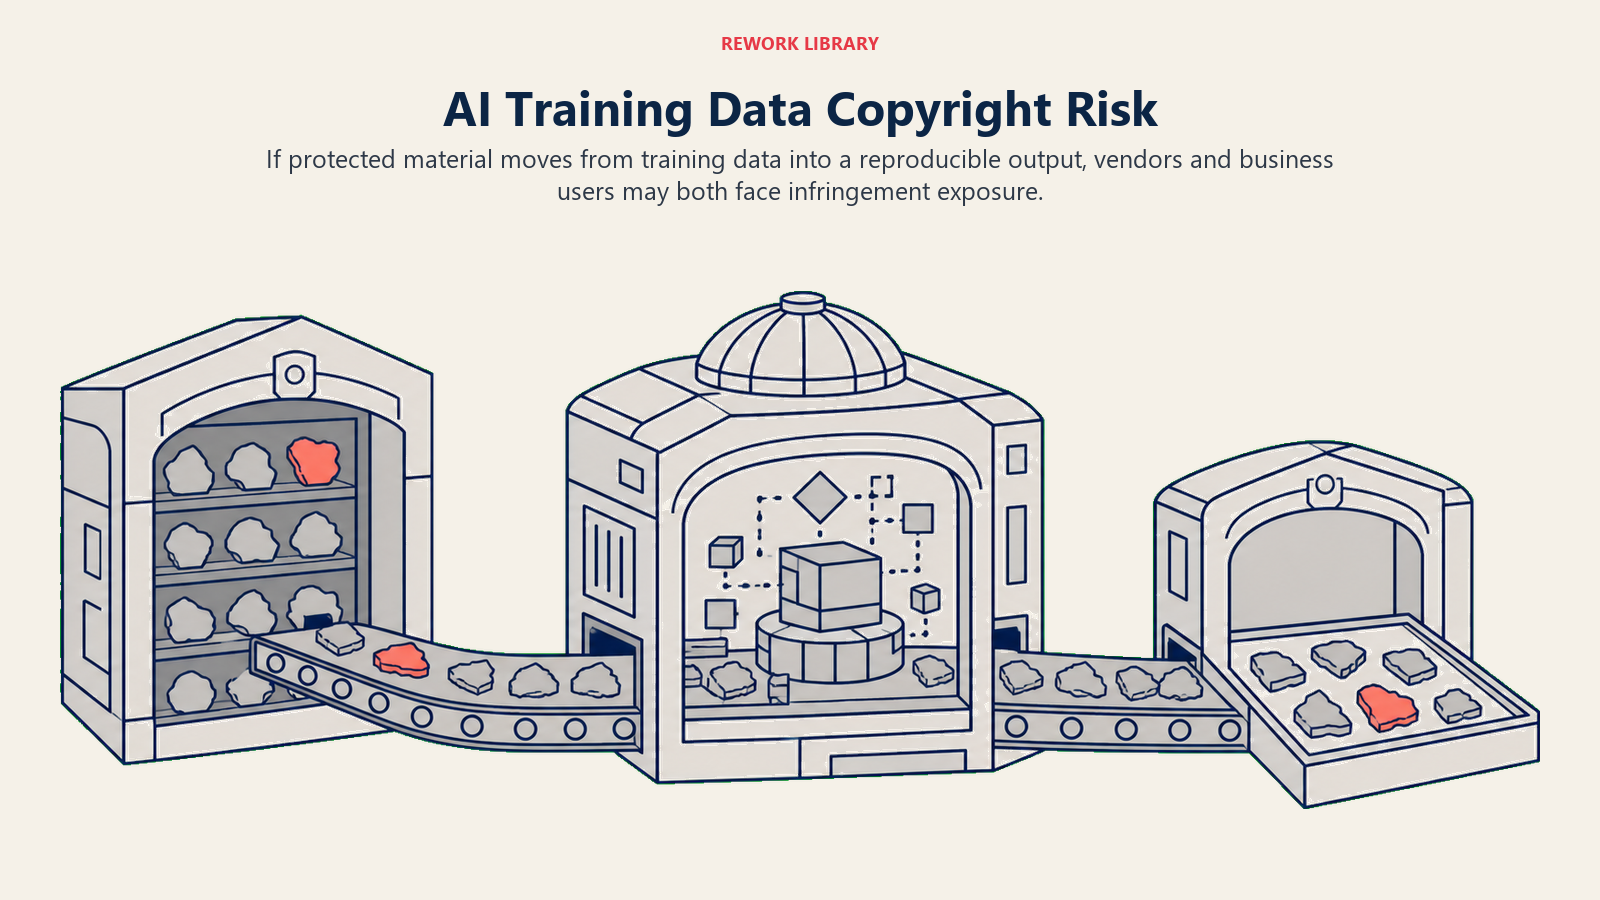
The New York Times v. Microsoft Corporation (1:23-cv-11195), eingereicht im Dezember 2023, behauptet, dass GPT-Modelle auf Millionen von Times-Artikeln ohne Erlaubnis trainiert wurden und dass die Modelle Times-Inhalte auf Prompts hin wortwörtlich reproduzieren können. Der Fall befindet sich ab 2026 in aktiver Litigation, wobei der Antrag von OpenAI auf Abweisung im April 2025 teilweise abgelehnt wurde.
Getty Images hat Klage gegen Stability AI in mehreren Jurisdiktionen eingereicht und behauptet, dass Stable Diffusion auf der lizenzierten Bilderbibliothek von Getty ohne Erlaubnis trainiert wurde und dass das Modell Bilder generieren kann, die Getty-Originalen stark ähneln, einschließlich ihrer Wasserzeichen.
Die Authors Guild hat eine Sammelklage im Namen von Autoren eingereicht, deren Bücher angeblich ohne Einwilligung in LLM-Trainingsdaten (Large Language Model) verwendet wurden.
Diese Fälle haben noch keine endgültigen Ergebnisse produziert, aber sie schaffen vier Arten von Geschäftsrisiken:
Direkte Verletzungsexposition: Wenn die von Ihnen verwendeten AI-Modelle Inhalte ausgeben, die urheberrechtlich geschützte Werke eng reproduzieren, befinden Sie sich möglicherweise in der Reproduktionskette. Die Frage, ob Sie oder Ihr Anbieter die primär haftende Partei ist, ist umstritten, aber "der Anbieter hat es getan" ist keine vollständige Verteidigung. Das Vendor Evaluation Framework for AI Tools enthält IP-Entschädigung als bewertete Dimension in der Bewertung der Datenpraktiken, und genau dort sollten Sie diese Exposition aufdecken, bevor Sie einen Enterprise-AI-Vertrag unterzeichnen.
Unsicherer Entschädigungswert: Die meisten AI-Anbieter bieten in ihren Enterprise-Vereinbarungen eine Form von IP-Entschädigung an. Aber Umfang, Limits und Durchsetzbarkeit dieser Entschädigungsklauseln sind in den großen Fällen ungetestet. Bis die Fälle entschieden sind, ist der Entschädigungswert spekulativ.
Transparenzpflichten zu Trainingsdaten: Der EU AI Act (für viele Bestimmungen in 2025 und 2026 wirksam) verlangt von Anbietern von AI-Modellen mit allgemeinem Verwendungszweck, Zusammenfassungen der verwendeten Trainingsdaten zu veröffentlichen. Das ist primär eine Pflicht der AI-Anbieter, nicht der Betreiber. Aber es erzeugt Druck für Einblick in das, was in die von Ihnen eingesetzten Modelle eingegangen ist.
Sektorspezifische Exposition: Das Trainingsdatenrisiko ist in manchen Inhaltskategorien höher als in anderen. AI-Systeme, die Code (GitHub-Copilot-Verfahren), visuelle Kunst (Midjourney- und Stability-AI-Verfahren) und journalismusnahe Inhalte (NYT v. OpenAI) generieren, sind am aktivsten umstritten. Wenn Ihre AI-Outputs in diese Kategorien fallen, ist das Trainingsdatenrisiko akuter.
Was Anbieterverträge tatsächlich sagen
Enterprise-AI-Anbieterverträge variieren erheblich bei IP-Bestimmungen. Die Überprüfung des tatsächlichen Vertragswortlauts ist unerlässlich; Marketingmaterialien der Anbieter zu IP sind nicht verlässlich.
Wichtige Klauseln, die zu suchen und zu verhandeln sind:
IP-Eigentümerschaftsgewährung: Gewährt der Anbieter Ihnen explizit die Eigentümerschaft an den mit dem Service generierten Outputs? Die Enterprise-Bedingungen von OpenAI legen fest, dass der Kunde Eigentümer der Inputs und Outputs ist. Die kommerziellen Bedingungen von Anthropic gewähren dem Kunden ebenfalls die Output-Eigentümerschaft. Aber "Eigentümerschaft" in einer Jurisdiktion, die AI-generiertes Urheberrecht möglicherweise nicht anerkennt, ist Eigentümerschaft an weniger, als Sie denken.
Trainingsdaten-Nichtnutzung: Enterprise-Vereinbarungen von großen Anbietern verbieten typischerweise die Nutzung Ihrer Eingaben für Modelltraining. Bestätigen Sie, dass dies in Ihrem spezifischen Vertrag steht und dass es sowohl für Ihre Prompts als auch für alle Nutzerdaten gilt, die diese Prompts enthalten.
IP-Entschädigung: Entschädigt der Anbieter Sie gegen IP-Ansprüche Dritter, die aus AI-Outputs entstehen? Was sind die Limits, Ausschlüsse und Bedingungen? OpenAI und Microsoft haben IP-Entschädigungsprogramme angeboten; Anthropic hat ähnliche Bestimmungen in den Enterprise-Bedingungen. Aber Entschädigungsklauseln haben Ausnahmen, Begrenzungen der erfassten Ansprüche und Bedingungen, die sie weniger umfassend machen, als sie erscheinen. Lassen Sie den spezifischen Wortlaut von Legal prüfen.
Transparenz zu Trainingsdaten: Gibt der Enterprise-Vertrag Ihnen Informationen darüber, worauf das Modell trainiert wurde? Das ist in Standardbedingungen selten verfügbar, aber für die Due Diligence relevant, besonders in regulierten Branchen.
Zu verhandelnde Vertragsbestimmungen, wenn noch nicht vorhanden:
- Explizite Output-Eigentümerschaftsgewährung
- Trainingsdaten-Nichtnutzung mit Prüfrechten
- IP-Entschädigung mit Mindestdeckungslimit
- Verpflichtung, Sie zu benachrichtigen, wenn der Anbieter einen Anspruch erhält, der Ihre Nutzung der Outputs beeinflussen würde
Die Kunden-IP-Frage
Wenn Ihr Produkt AI verwendet und Ihre Kunden Daten in Ihr AI-System hochladen, haben Sie eine dritte Expositionsdimension: Wem gehören die aus Kundendaten abgeleiteten Erkenntnisse?
Diese Frage gilt für:
- SaaS-Produkte (Software-as-a-Service), die AI zur Analyse von Kunden-hochgeladenen Daten verwenden
- AI-Funktionen, die Berichte, Zusammenfassungen oder Empfehlungen aus Kundendaten generieren
- Automatisierungs-Workflows, die Kundeninformationen verarbeiten, um AI-gestützte Outputs zu produzieren
Die Antworten gehören in Ihre Kundenverträge, nicht in einen Rechtsstreit.
Ihre Kundenverträge sollten ansprechen:
- Wem die AI-abgeleiteten Outputs gehören, die aus Kundendaten generiert werden
- Ob Sie Kundendaten zur Verbesserung Ihrer AI-Systeme verwenden können (die meisten Enterprise-Kunden werden Nein sagen)
- Wie AI-Outputs aus Kundendaten bei der Vertragsbeendigung behandelt werden
- Was Kunden mit AI-generierten Erkenntnissen Ihrer Plattform tun dürfen und was nicht
Das Data Classification for AI Access-Framework hilft Ihnen abzubilden, welche Kundendatenkategorien in welche AI-Systeme fließen, damit Ihre Verträge zu Datentypen konkret werden können, statt generische Auffangklauseln zu verwenden.
Wenn Ihre aktuellen SaaS-Bedingungen AI-abgeleitete Outputs nicht spezifisch ansprechen, haben Sie wahrscheinlich Bestimmungen, die für eine Vor-AI-Architektur geschrieben wurden und nicht sauber passen. Der Satz "Daten, die Sie hochladen, bleiben Ihre Daten" beantwortet nicht, wem der Erkenntnisbericht gehört, den Ihr AI aus diesen Daten generiert hat.
Was Ihre IP-Richtlinie über AI sagen muss
Die meisten Unternehmens-IP-Richtlinien wurden für eine Welt geschrieben, in der IP-Erstellung human-getrieben war. Eine aktualisierte Richtlinie muss drei AI-spezifische Fragen ansprechen.
AI-Output-Eigentümerschaftsansprüche und Dokumentationsanforderungen. Die Richtlinie sollte spezifizieren: welches Niveau menschlichen Beitrags erforderlich ist, bevor Ihre Organisation Urheberrecht an AI-gestützter Arbeit geltend macht, welche Dokumentation Mitarbeiter pflegen müssen, um diese Ansprüche zu unterstützen, und welcher Prüfprozess gilt, bevor AI-generierte Inhalte veröffentlicht, eingereicht oder verkauft werden.
Einschränkungen für das Hochladen von Drittanbieter-Inhalten in AI-Tools. Mitarbeiter, die AI-Tools nutzen, kopieren regelmäßig Drittanbieter-Inhalte in Prompts (Wettbewerbsinhalte zur Analyse, Nachrichtenartikel zur Zusammenfassung, externe Dokumente zur Prüfung). Ihre IP-Richtlinie muss ansprechen: welche Drittanbieter-Inhalte in AI-Prompts einbezogen werden können, welche Einschränkung für die Wiedergabe von aus Trainingsdaten stammenden AI-Outputs in öffentlich sichtbarer Arbeit gilt und wie der Eskalationsprozess aussieht, wenn Mitarbeiter unsicher sind.
Kunden-Datenhandhabung für AI-abgeleitete Outputs. Für Organisationen mit AI-Produkten sollte die Richtlinie mit Ihren Kundenvertragsbestimmungen übereinstimmen: welche Kundendaten in AI-Systeme fließen, wem die Outputs gehören und wie der Governance-Prozess für Änderungen an der AI-Datenhandhabung aussieht.
Die Richtlinie braucht auch einen Eigentümer. AI- und IP-Richtlinienfragen werden regelmäßig entstehen und zeitnahe Antworten benötigen. Wenn die Richtlinie geschrieben ist, aber keine benannte Person für die Beantwortung von Richtlinienfragen und die Eskalation neuartiger Situationen verantwortlich ist, funktioniert die Richtlinie nicht.
Die ehrliche Position für 2026
Die ehrliche Formulierung dieses Themas: Wir befinden uns in einer Periode rechtlicher Ungewissheit. Die wichtigsten Fälle werden sich nicht in den nächsten 12 bis 18 Monaten lösen. Verschiedene Jurisdiktionen bewegen sich in verschiedene Richtungen mit verschiedenen Geschwindigkeiten. Die regulatorischen Anforderungen an AI-Anbieter werden strenger, was künftig besseren Einblick in Trainingsdaten ermöglichen kann, aber diese Transparenz ist heute nicht verfügbar.
In dieser Umgebung ist das Ziel nicht rechtliche Gewissheit. Es ist vertretbare Positionierung und klares Risikobewusstsein.
Vertretbare Positionierung: Menschlichen Beitrag dokumentieren, Anbieterverträge mit von Legal überprüften IP-Bestimmungen aushandeln und Ihre IP-Richtlinie aktualisieren, um AI explizit anzusprechen.
Klares Risikobewusstsein: Verstehen Sie, welche Ihrer AI-generierten Outputs in Hochrisiko-Kategorien fallen (Code, visuelle Kunst, journalismusnahe Inhalte), wissen Sie, welche Anbieterverfahren laufen und welche Ansprüche sie erheben, und lassen Sie Ihren General Counsel zur Exposition briefen.
Für den Risikoregister-Eintrag, der IP- und Urheberrechtsrisiken entspricht, gibt AI-Risikoregister: Was zu verfolgen ist Ihnen das Scoring- und Tracking-Format. Building Your AI Use Policy behandelt den breiteren Richtlinienrahmen, dessen Bestandteil dieser IP-Abschnitt ist. Und die Datenpraktiken-Dimension des Vendor Evaluation Framework for AI Tools ist der Punkt, an dem IP-Risiko im Beschaffungsprozess sichtbar wird.
Die Lücke zwischen Organisationen, die diese Management-Arbeit geleistet haben, und jenen, die es nicht getan haben, wird sichtbar werden, wenn die ersten großen Durchsetzungsmaßnahmen die anhängigen Fälle zu ihrem Abschluss begleiten.
Häufig gestellte Fragen
Wem gehört AI-generierter Inhalt?
In den Vereinigten Staaten hat das Copyright Office bestätigt, dass Werke, die vollständig von AI ohne menschliche Urheberschaft generiert werden, nicht für Urheberrechtsschutz in Frage kommen. Der US Supreme Court bestätigte menschliche Urheberschaft im März 2026 als grundlegend. Wenn Ihr AI Inhalte mit minimalem menschlichem kreativem Beitrag generiert, besitzen Sie ihn möglicherweise nicht nach Urheberrecht, und Wettbewerber könnten ihn ohne Verletzung reproduzieren. AI-gestützte Inhalte mit dokumentierter, substanzieller menschlicher Urheberschaft haben einen stärkeren Anspruch.
Können AI-Outputs Urheberrecht verletzen?
Ja. Wenn das von Ihnen verwendete Foundation-Modell auf urheberrechtlich geschütztem Material ohne Erlaubnis trainiert wurde und das Modell dieses Material eng reproduziert, befinden Sie sich möglicherweise in der Haftungskette für diese Reproduktion. Über 70 Verletzungsklagen wurden bis 2026 gegen AI-Unternehmen eingereicht. Der Vergleich Bartz v. Anthropic zahlte 2025 1,5 Milliarden Dollar. Die meisten Enterprise-AI-Anbieter bieten IP-Entschädigung an, aber diese Klauseln sind vor Gericht nicht vollständig getestet und haben Limits, Ausnahmen und Bedingungen, die eine rechtliche Prüfung erfordern.
Welche menschliche Urheberschaftsdokumentation ist für AI-gestützte Inhalte erforderlich?
Dokumentieren Sie: die verwendeten Prompts, die spezifischen menschlichen Redaktionsentscheidungen und Überarbeitungen, wer den Output überprüft und genehmigt hat, das Datum und die Versionsgeschichte, die zeigt, wo Menschen gestalterische Entscheidungen getroffen haben, die sich von der Generierung des AI unterscheiden. Diese Dokumentation dient zwei Zwecken: sie stärkt Urheberrechtsansprüche und sie etabliert einen menschlichen Überprüfungsnachweis, der in vertraglichen oder regulatorischen Kontexten relevant sein kann. Der Dokumentationsaufwand ist gering. Ein einfaches Protokoll schafft deutlich stärkeren Schutz als gar keine Dokumentation.
Welche IP-Vertragsklauseln sollten in jedem Enterprise-AI-Vertrag stehen?
Vier Klauseln sind wesentlich: (1) Explizite Output-Eigentümerschaftsgewährung an Ihre Organisation. (2) Trainingsdaten-Nichtnutzungsbestimmung, die bestätigt, dass Ihre Eingaben nicht für das Training der Modelle des Anbieters verwendet werden, mit Prüfrechten. (3) IP-Entschädigung gegen Ansprüche Dritter aus AI-Outputs, mit einem Mindestdeckungslimit. (4) Verpflichtung des Anbieters, Sie zu benachrichtigen, wenn er einen Anspruch erhält, der Ihre Nutzung ihrer Outputs beeinflussen würde. "Eigentümerschaft" in Standard-Click-through-Bedingungen ist weniger, als es scheint, wenn das zugrunde liegende Urheberrecht unsicher ist.
Wem gehören AI-abgeleitete Erkenntnisse aus Kundendaten?
Das hängt vollständig davon ab, was Ihre Kundenverträge sagen. Die meisten SaaS-Bedingungen vor 2024 sprechen AI-abgeleitete Outputs nicht spezifisch an. Der Satz "Daten, die Sie hochladen, bleiben Ihre Daten" beantwortet nicht, wem die AI-generierte Zusammenfassung oder Analyse dieser Daten gehört. Kundenverträge sollten explizit ansprechen: wem AI-abgeleitete Outputs aus Kundendaten gehören, ob Sie Kundendaten zur Verbesserung Ihrer AI-Systeme verwenden können, wie AI-Outputs bei Vertragsbeendigung behandelt werden und was Kunden mit AI-generierten Erkenntnissen Ihrer Plattform tun dürfen.
Was sollte eine AI-IP-Richtlinie enthalten?
Drei AI-spezifische Anforderungen: (1) Standards für die menschliche Beitragsdokumentation, die spezifizieren, welches Niveau menschlicher kreativer Beteiligung erforderlich ist, bevor Ihre Organisation Urheberrecht an AI-gestützter Arbeit geltend macht, und welche Aufzeichnungen Mitarbeiter führen müssen. (2) Einschränkungen für Drittanbieter-Inhalte in AI-Prompts, die festlegen, welche Inhaltskategorien (Wettbewerbsmaterialien, lizenzierte Drittanbieter-Inhalte, vertrauliche Kundendaten) nicht in Prompts externer AI-Tools einbezogen werden dürfen. (3) Kunden-Datenhandhabungsregeln für AI-abgeleitete Outputs, die mit Ihren Kundenvertragsbestimmungen übereinstimmen. Die Richtlinie braucht auch einen benannten Eigentümer, der Fragen beantwortet und neuartige Situationen in Echtzeit eskaliert.

Co-Founder, Rework.com