AIによる採用前アセスメント:仕組み、妥当性、法的リスク
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
AIによる採用前アセスメントとは、求職者が受けるテスト(ゲーム、職務シミュレーション、録画の動画面接、スキル演習)で、その回答を、職務での成果を予測する機械学習モデルがスコア化するものです。 出力は通常、スコア、順位、または合否の区分で、採用の判断に使われます。このテストの価値は、2つのことで決まります。スコアが本当に職務遂行能力を予測しているか(妥当性)、そして候補者のグループを公平に扱っているか(不利益な影響)です。
本ページは、こうしたツールを売り込まれている、あるいはすでに使っている人事ディレクター、タレントアクイジションのリーダー、採用担当マネージャー向けです。スコアリングの仕組み、どの種類のアセスメントが成果を予測するかについての研究、不利益な影響の測定方法、法的リスクの出どころを説明します。これは一般的な情報であり、法的助言ではありません。採用全体の像については、まず採用におけるAIの中心記事から始めてください。
重要なポイント
- 米国のUniform Guidelinesのもとでは、あるグループの選考通過率が、最も高い通過率のグループの4分の5(80%)に満たない場合、一般に不利益な影響のエビデンスとして扱われます。ただし、それより小さな差でも該当しうるとされています(29 CFR 1607.4(D))。
- 選考手法の妥当性を2022年に再推定した研究では、構造化面接がr = .42、職務知識テストが.40、ワークサンプルテストが.33、認知能力が.31でした(HumRRO on Sackett et al., 2022)。
- ニューヨーク市は、自動雇用判断ツールの使用前の1年以内のバイアス監査、公開される概要、候補者への通知を求めており、執行は2023年7月5日に始まりました(NYC DCWP)。
- EU AI法は、雇用と労働者管理のためのAIツールを高リスクとして挙げ、その規則は2027年12月2日から適用されます。また、職場での感情認識を禁止しており、この禁止は2025年2月から施行されています(European Commission)。
AIによる採用前アセスメントとは何か
このカテゴリーには4つの形式があり、AIの関与の度合いが異なります。
| 形式 | 候補者が行うこと | AIがスコア化するもの | 主なリスク |
|---|---|---|---|
| ゲームベース | 短いタスク(記憶、リスク、パターン、注意)をプレイする | ゲーム内での行動を、特性や能力に対応づけたもの | 職務タスクとの結び付きが弱い、アクセシビリティ |
| 職務シミュレーション / ワークサンプル | 現実的な課題(チケットの仕分け、スプレッドシートの編集、返信の作成)を行う | 評価基準に照らした成果物の質(自動化される場合もある) | 評価基準のずれ、構築コスト |
| 録画の動画面接 | カメラの前で、決められた質問に答える | 発言内容の書き起こし(音声やその他のシグナルを使う場合もある) | 不透明なシグナル、同意に関する法律、感情の推測 |
| スキル・知識テスト | 質問に答える、あるいは問題(コーディング、言語、計算)を解く | 正誤、難易度の適応 | 不正行為、テスト内容の漏えい |
単純なスコアリング(正解の鍵に照らして正答を数える)は、本来のAIではありません。AIが登場するのは、モデルがどの回答パターンを良いものとして扱うかを学習するとき、あるいは話し言葉や文章のような自由記述の出力を読み取るときです。
スコアリングの仕組み
AIアセスメントの多くは同じ4つのステップをたどり、それはACE FrameworkのIngest、Analyze、Predictの各段階に対応します。
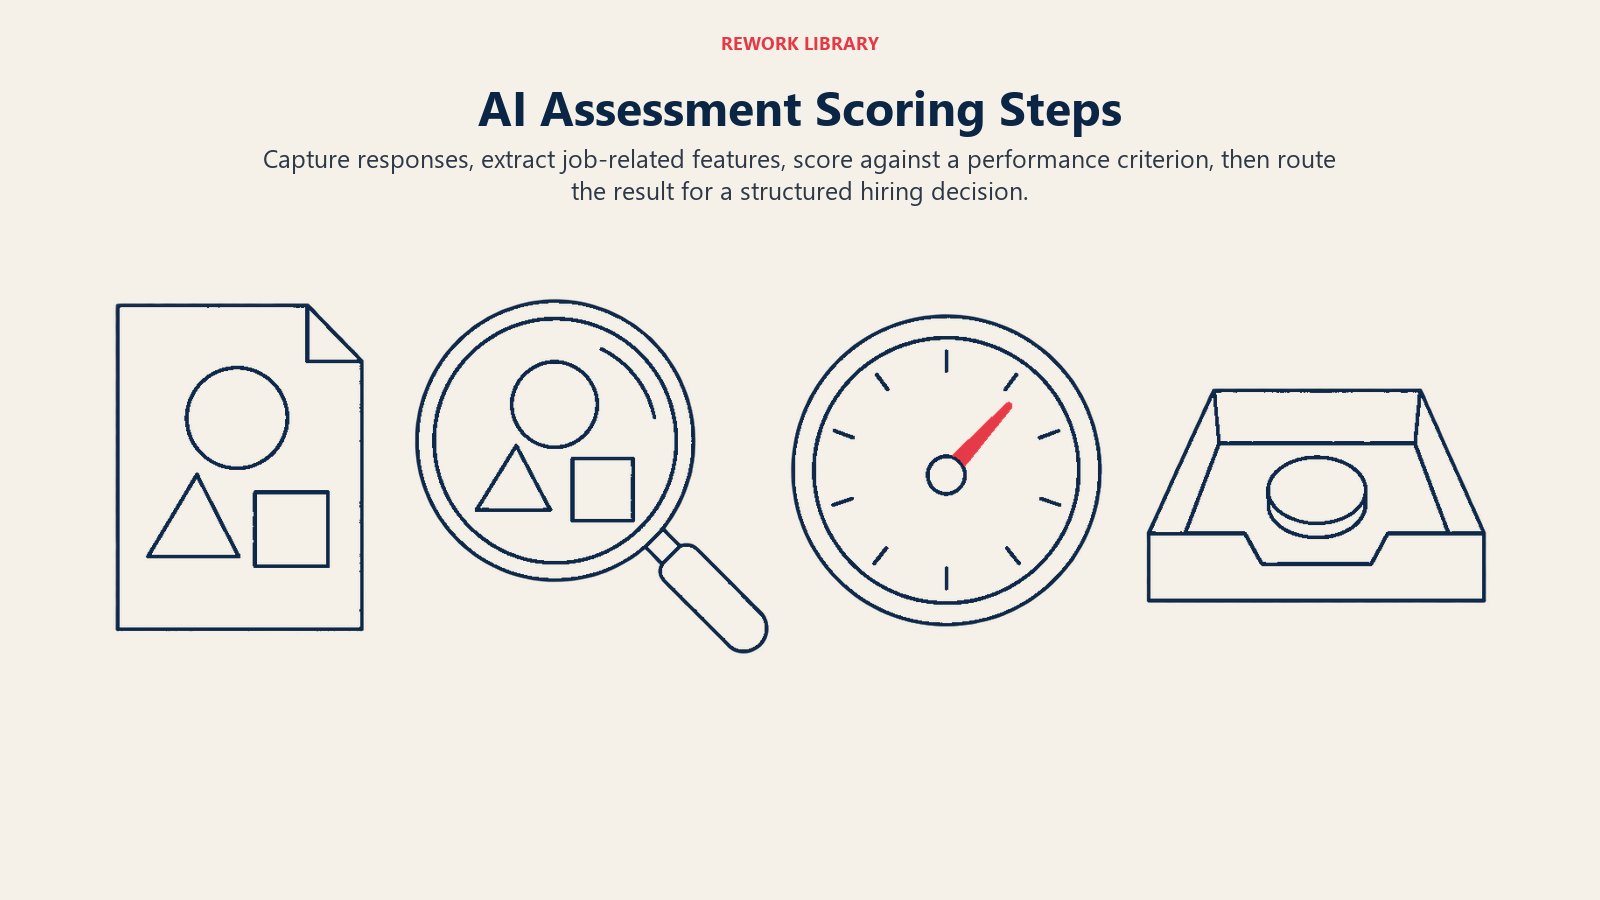
- 取得。 プラットフォームが、クリック、応答時間、回答、動画、書き起こし、提出されたコードなど、生の行動を記録します。
- 特徴量の抽出。 生のデータが、時間的な制約のもとでの正確さ、候補者が使った語数、回答でカバーしたトピックなど、測定可能な特徴量になります。
- モデルによるスコアリング。 学習済みのモデルが特徴量をスコアに対応づけます。学習には「基準」、つまりすでにその職務に就いている人の上司による評価や営業成績など、職務での成功を表す指標が必要です。
- 区分けと振り分け。 スコアが順位や区分(推奨、要レビュー、非推奨)に変換され、候補者は次の段階に振り分けられます。
結果が信頼できるかどうかは、2つの詳細で決まります。1つ目は、モデルが何を予測するように学習されたかです。基準が「採用して、定着した人」であれば、モデルは過去の好みを、欠点も含めて学習します。2つ目は、モデルの特徴量が職務に関連しているかです。過去のデータで成功と相関しているだけの特徴量が、気づかないうちに、年齢、性別、障害の代理になることがあります。
最もよく知られた警告となる事例は、Amazonが構築した採用モデルです。約10年分の、大半が男性のものである履歴書から学習したうえで、候補者を1から5の星でスコア化しました。「women's」という語を含む履歴書にペナルティを与え、女性のみの2つの大学の卒業生を低く評価し、経営陣はそれを信頼しなくなってチームを解散しました(Reuters report, as carried by Euronews)。これはアセスメントではなく履歴書のツールでしたが、仕組みは同じです。偏った過去から学び、それを大規模に再現するのです。
2つ目の事例は、ベンダーが軌道修正した例です。HireVueは2021年1月、動画アセスメントから顔分析を取り除いたと発表し、言語分析のほうが予測力が高くなり、視覚的な分析はもはや大きな価値を加えなくなったと説明しました(SHRM)。購入者にとっての教訓は、モデルがどのようなシグナルを使っているかを尋ね、職務と結び付けられないシグナルは断ることです。
妥当性:スコアは職務遂行能力を予測するか
妥当性は、最も重要でありながら、最も問われない問いです。妥当なアセスメントは、後の職務遂行能力と相関するスコアを生み出します。相関はrで表され、0は関係なし、1は完全な予測を意味します。現実の選考手法は、1をはるかに下回ります。
Uniform Guidelinesは、妥当性は通常は職務分析である職務情報のレビューに基づくべきだとし、3種類のエビデンスを示しています。基準関連妥当性(スコアが成果と相関する)、内容的妥当性(テストが実際の職務内容をサンプルにしている)、構成概念妥当性(職務に関連する、定義された特性を測定している)です。ガイドラインはまた、知能や性格のような抽象的な特性には、内容的妥当性は適さないと述べています(29 CFR 1607.14)。特性を測定すると主張するのが通常である、ゲームベースのツールにとっては、これが重要です。
どの手法の予測力が最も高いかについては、Sackettらによる2022年の広く引用される再分析が、それまでの推定値を引き下げました。それは、範囲の制限に対する過剰な補正で膨らんでいたと彼らは主張しています。修正後の数値は、構造化面接がr = .42、職務知識テストが.40、経験的に重み付けしたバイオデータが.38、ワークサンプルテストが.33、認知能力が.31です(HumRRO summary)。マネージャーにとって、ここから3つの教訓が得られます。
- 実際の職務に根ざした手法は、成績が良い傾向があります。 ワークサンプルと職務知識テストは、仕事そのものに直接似ています。
- 最良の手法でも、予測力は中程度です。 どのスコアも、人についての評決として扱ってはいけません。
- ベンダーの主張は、自社の職務に合っている必要があります。 コールセンターのオペレーターに関する妥当性の検証研究は、エンジニアリングマネージャーの職務についてほとんど何も語りません。ガイドライン自身の移転可能性の基準は、このために存在します。
この研究のポイントは、AIによるスコアリングが従来のスコアリングより優れているか劣っているかではありません。「AI」というラベルよりも、形式とその職務との結び付きのほうが重要だということです。AIがスコア化するワークサンプルは、ワークサンプルの強みを引き継ぎます。職務分析の裏付けがないAIがスコア化するゲームは、何も引き継ぎません。
不利益な影響と5分の4ルール
不利益な影響とは、意図の有無にかかわらず、選考手続きがあるグループを別のグループより目立って高い割合で振るい落とすことを指します。米国のUniform Guidelinesは、それを見つけるための経験則を示しています。ある人種、性別、民族グループの選考通過率が、最も高い通過率のグループの4分の5(80%)に満たない場合は、一般に不利益な影響のエビデンスと見なされます。その閾値を上回る通過率は、一般にそうではありません。同じ段落は、それより小さな差でも、特に統計的および実務的に有意であれば不利益な影響になりうること、少数の人数に基づく差は信頼できない場合があることも付け加えています(29 CFR 1607.4(D))。
仮の例で計算を示します。グループAの200人の候補者がアセスメントを受け、100人が合格したとします。通過率は50%です。グループBは100人の候補者のうち30人が合格し、通過率は30%です。30%を50%で割ると0.60になり、0.80のラインを下回るため、結果はレビュー対象としてフラグが立ちます。かわりに100人中42人が合格していれば、比率は0.84となり、このルールだけではフラグは立ちません。
このルールを危険なものではなく有用なものに保つために、3つの注意点があります。
- これはスクリーニングの経験則であり、セーフハーバーではありません。 80%のテストを通ったからといってツールが適法とは限らず、通らなかったからといって違法とは限りません。より詳しく調べる出発点です。
- すべての段階で実施します。 全体の通過率に加えて、各アセスメント、カットスコア、区分もテストします。全体では問題なく見えるアセスメントでも、あるカットスコアに害が集中していることがあります。
- 不利益な影響は、妥当性の問いを呼び起こします。 技術的な基準のもとでは、相関が低いのに不利益な影響が大きい手続きは厳しく検討され、利用者は、同等以上の妥当性を持つほかの手続きが利用できないかを検討すべきとされています(29 CFR 1607.14)。平易に言えば、2つのツールの予測力が同じで、一方が保護対象のグループの人をより多く振るい落とすなら、もう一方を使うということです。
法的リスクの所在
雇用主は、購入したツールについて責任を負います。以下のルールは大まかに要約したもので、頻繁に変わるため、採用を行うそれぞれの地域で、顧問弁護士とともに最新の条文を確認してください。
米国の連邦差別禁止法。 上記のUniform Guidelinesは、AIがスコア化するものを含む選考手続き全般に適用されます。Americans with Disabilities Actは、別の論点を加えます。司法省のガイダンスは、オンラインのゲームや性格アセスメントは、意図した職務に関連するスキルだけを測定すべきで、損なわれた感覚、手先、話す能力を測定してはならず、テストでその職務をこなせる人が排除されてしまう場合は、雇用主がアクセス可能なテストやその他の調整を提供しなければならないとしています。また、差別的な技術が他社に由来する場合でも、雇用主が責任を負い続けるとも述べています(ADA.gov AI guidance)。
ニューヨーク市。 Local Law 144は、自動雇用判断ツールを対象とします。ツールは使用前の1年以内にバイアス監査を受け、監査に関する情報は公開され、候補者は通知を受けなければなりません。市は、通知はツールを使用する10営業日前に行うものとしており、執行は2023年7月5日に開始されました(NYC DCWP)。
イリノイ州。 2020年1月1日に施行されたArtificial Intelligence Video Interview Actは、AIで動画面接を分析する雇用主に対し、通知を行い、AIの仕組みと評価する特性を説明し、事前に応募者の同意を得て、動画を見られる人を限定し、依頼から30日以内にコピーを破棄することを求めています(SHRM summary)。2026年1月1日に施行されたIllinois Human Rights Actの別の改正は、採用やその他の雇用判断で、保護対象属性に対して差別的となる形でAIを使うことを禁止し、郵便番号をその代理として使うことを禁じ、従業員への通知を求めています(Crowell & Moring)。
欧州連合。 欧州委員会は、雇用と労働者管理のためのAIツールを高リスクとして挙げ、例として履歴書の仕分けソフトウェアを示しています。高リスクシステムには、リスク管理、データセットの品質、ログの記録、文書化、人による監督に関する義務が課され、雇用についてはAI Omnibusの改正のもと、2027年12月2日から適用されます。職場での感情認識は、2025年2月から禁止されています(European Commission)。そのため、顔や声から感情を推測する動画アセスメントは、EUでの採用には問題となります。
米国のほかの州にも、採用におけるAIについての独自の規則や審議中の規則があり、延期されたり範囲を狭められたりを繰り返しているものもあります。本記事を含め、どのコンプライアンスのチェックリストも、出発点として扱ってください。
職種別の実例
同じアセスメントの形式でも、職務によって働き方が異なります。
- カスタマーサポート。 候補者が3件の現実的なチケットに答えるシミュレーションで、正確さ、トーン、ポリシーの使い方を評価基準でスコア化します。職務と結び付けやすく、監査もしやすいものです。
- セールス。 動画で録画するロールプレイで、声や表情のシグナルではなく、内容(ディスカバリーの質問をしたか、反論に対応したか)でスコア化します。内容に基づくスコアリングは、説明しやすく、弁護しやすいものです。
- エンジニアリング。 制限時間付きのコーディング課題をテストケースで評価し、人が解答の考え方をレビューします。スキルには適していますが、協働については何も語りません。
- 財務とオペレーション。 正解の鍵がわかっているスプレッドシートの演習と、いくつかの判断を要する問題です。大半はルールで、AIはほとんど使いません。それが長所です。
- 大量採用の時給制ポジション。 短い状況判断の質問と基本的なスキルチェックで、候補者を面接に振り分けるために使い、レビューなしの不合格には決して使いません。スキルベース採用のアプローチはここに合います。資格ではなく、その人に何ができるかに焦点を当てるからです。
AIアセスメントを導入する:ステップごとに
- 職務から始めます。 4から6の重要なタスクと、その背後にあるスキルを書き出します。職務を説明できなければ、そのためのテストを検証することはできません。
- 機能する範囲で最小限のAIを選びます。 それらのタスクに結び付いたワークサンプルや知識テストを優先します。AIによるスコアリングは、自由記述の回答を読むなど、時間の節約が明らかな場合にだけ加えます。
- ベンダーにエビデンスを求めます。 妥当性の検証研究、対象とした職種と母集団、モデルが使う特徴量、グループ別の結果を含む直近のバイアス監査を依頼します。同等のポジションについての研究がなければ、自社での検証を計画します。
- スコアの役割を決めます。 構造化された判断への入力の1つとして使い、自動的な関門にはしません。これがヒューマン・イン・ザ・ループ設計の実践であり、レビュー担当者にはスコアを上書きする実質的な権限が必要です。
- カットスコアは慎重に設定します。 カットスコアを高くすると、通常は不利益な影響が増えます。ローンチ前に、各閾値の影響をテストします。
- 配慮の提供を事前に計画します。 アセスメントが何であり、どうスコア化されるかを候補者に伝え、代替の形式を依頼する明確な方法を示します。
- 実際の結果で5分の4のチェックを行います。 アセスメントと全体のファネルについて、グループ別の通過率を、意味のある量のデータで、予定を決めて比較します。
- 法的な通知を処理します。 採用するすべての地域について、通知、同意、監査の義務を確認し、監査と通知の記録を保管します。
- レビューして、使うのをやめます。 妥当性と影響を、少なくとも年1回、また職務やモデルが変わった後に再確認します。基準を満たさないツールは外します。
ベンダーの選択肢については、採用前アセスメントツールのおすすめの比較記事をご覧ください。AIが履歴書や面接をどう選別するかも検討している場合は、AIによる履歴書スクリーニングと面接におけるAIをご覧ください。
よくある落とし穴
- 「AI搭載」を妥当性の証明として扱う。 そのラベルは、スコアがどう作られるかを示すもので、何かを予測するかどうかを示すものではありません。
- 職務との結び付きがない特性ゲームを使う。 記憶やリスクのタスクが仕事とどう関係するかを説明できなければ、規制当局や原告も同じ問いを投げかけます。
- スコアで自動的に不合格にする。 自動的な不合格は、ほとんどの法的枠組みが拠りどころにしている、人による確認を取り除きます。
- バイアスのテストをローンチ時の1回だけにする。 候補者の母集団、カットスコア、モデルは変わります。一度きりの監査は陳腐化します。
- アクセシビリティを無視する。 時間制限付き、視覚中心、運動機能に依存するタスクは、その職務をこなせる人を振るい落とすことがあります。
- ベンダーに頼る。 連邦の障害に関するガイダンスは、ツールを使う雇用主が結果に責任を負うと明言しています。
- 候補者への説明がない。 なぜその人のスコアが低かったのかを誰も説明できなければ、弁護できません。選考において説明可能なAIが重要である理由であり、AIにおけるバイアスがあらゆるベンダーとの会話に含まれるべき理由です。
次に読む記事
職務を1つ選び、その重要なタスクを書き出し、デモを見る前に、検討中のアセスメントをそれらと照らし合わせてください。そのうえで、妥当性の検証研究と不利益な影響の結果を求めます。セクション全体の地図は採用におけるAIの中心記事に、人事機能全体の視点はAI in HRにあります。

Senior Customer Retention Strategist