Evaluaciones preselectivas con IA: cómo funcionan, validez y riesgo legal
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
Una evaluación preselectiva con IA es una prueba que realiza un candidato a un empleo (un juego, una simulación de trabajo, una entrevista grabada en video o un ejercicio de habilidades) cuyas respuestas puntúa un modelo de aprendizaje automático que predice qué tan bien desempeñaría la persona el puesto. El resultado suele ser una puntuación, una clasificación o una banda de aprobado o no aprobado que alimenta una decisión de contratación. La prueba es tan buena como dos cosas: si la puntuación realmente predice el desempeño laboral (validez) y si trata con equidad a los grupos de candidatos (impacto adverso).
Esta página está dirigida a directores de recursos humanos, líderes de adquisición de talento y gerentes contratantes a quienes les ofrecen estas herramientas o que ya las usan. Explica cómo funciona la puntuación, qué dice la investigación sobre qué tipos de evaluación predicen el desempeño, cómo se mide el impacto adverso y de dónde viene la exposición legal. Es información general, no asesoría jurídica. Para el panorama más amplio del reclutamiento, comience con el eje de IA en el reclutamiento.
Datos clave
- Según las Uniform Guidelines de Estados Unidos, una tasa de selección de cualquier grupo inferior a cuatro quintos (80%) de la tasa del grupo con la tasa más alta se trata en general como evidencia de impacto adverso, aunque diferencias menores también pueden contar (29 CFR 1607.4(D)).
- Una reestimación de 2022 de la validez de los métodos de selección situó las entrevistas estructuradas en r = 0,42, las pruebas de conocimiento del puesto en 0,40, las pruebas de muestra de trabajo en 0,33 y la capacidad cognitiva en 0,31 (HumRRO on Sackett et al., 2022).
- La ciudad de Nueva York exige una auditoría de sesgos de una herramienta automatizada de decisión de empleo dentro del año previo a su uso, un resumen público y un aviso a los candidatos, y la aplicación comenzó el 5 de julio de 2023 (NYC DCWP).
- La EU AI Act clasifica como de alto riesgo las herramientas de IA para el empleo y la gestión de trabajadores, con esas reglas aplicables desde el 2 de diciembre de 2027, y prohíbe el reconocimiento de emociones en los lugares de trabajo, una prohibición vigente desde febrero de 2025 (European Commission).
Qué cuenta como evaluación preselectiva con IA
La categoría abarca cuatro formatos, y difieren en cuánto hace la IA.
| Formato | Qué hace el candidato | Qué puntúa la IA | Riesgo principal |
|---|---|---|---|
| Basado en juegos | Juega tareas cortas (memoria, riesgo, patrones, atención) | El comportamiento en el juego, asociado a rasgos o habilidades | Vínculo débil con las tareas del puesto; accesibilidad |
| Simulación de trabajo / muestra de trabajo | Realiza una tarea realista: clasificar tickets, editar una hoja de cálculo, redactar una respuesta | La calidad del resultado frente a una rúbrica, a veces automatizada | Deriva de la rúbrica; costo de construcción |
| Entrevista grabada en video | Responde preguntas fijas frente a la cámara | El contenido de la transcripción, a veces la voz u otras señales | Señales opacas; leyes de consentimiento; inferencia de emociones |
| Prueba de habilidades y conocimientos | Responde preguntas o resuelve problemas (programación, idioma, cálculo) | Correcto o incorrecto, dificultad adaptativa | Trampas, filtración del contenido de la prueba |
La puntuación simple (contar respuestas correctas frente a una clave) no es realmente IA. La parte de IA llega cuando un modelo aprende qué patrones de respuesta tratar como buenos, o cuando lee resultados abiertos como el habla y la escritura.
Cómo funciona la puntuación
La mayoría de las evaluaciones con IA siguen los mismos cuatro pasos, que corresponden a las etapas Ingest, Analyze y Predict del ACE Framework.
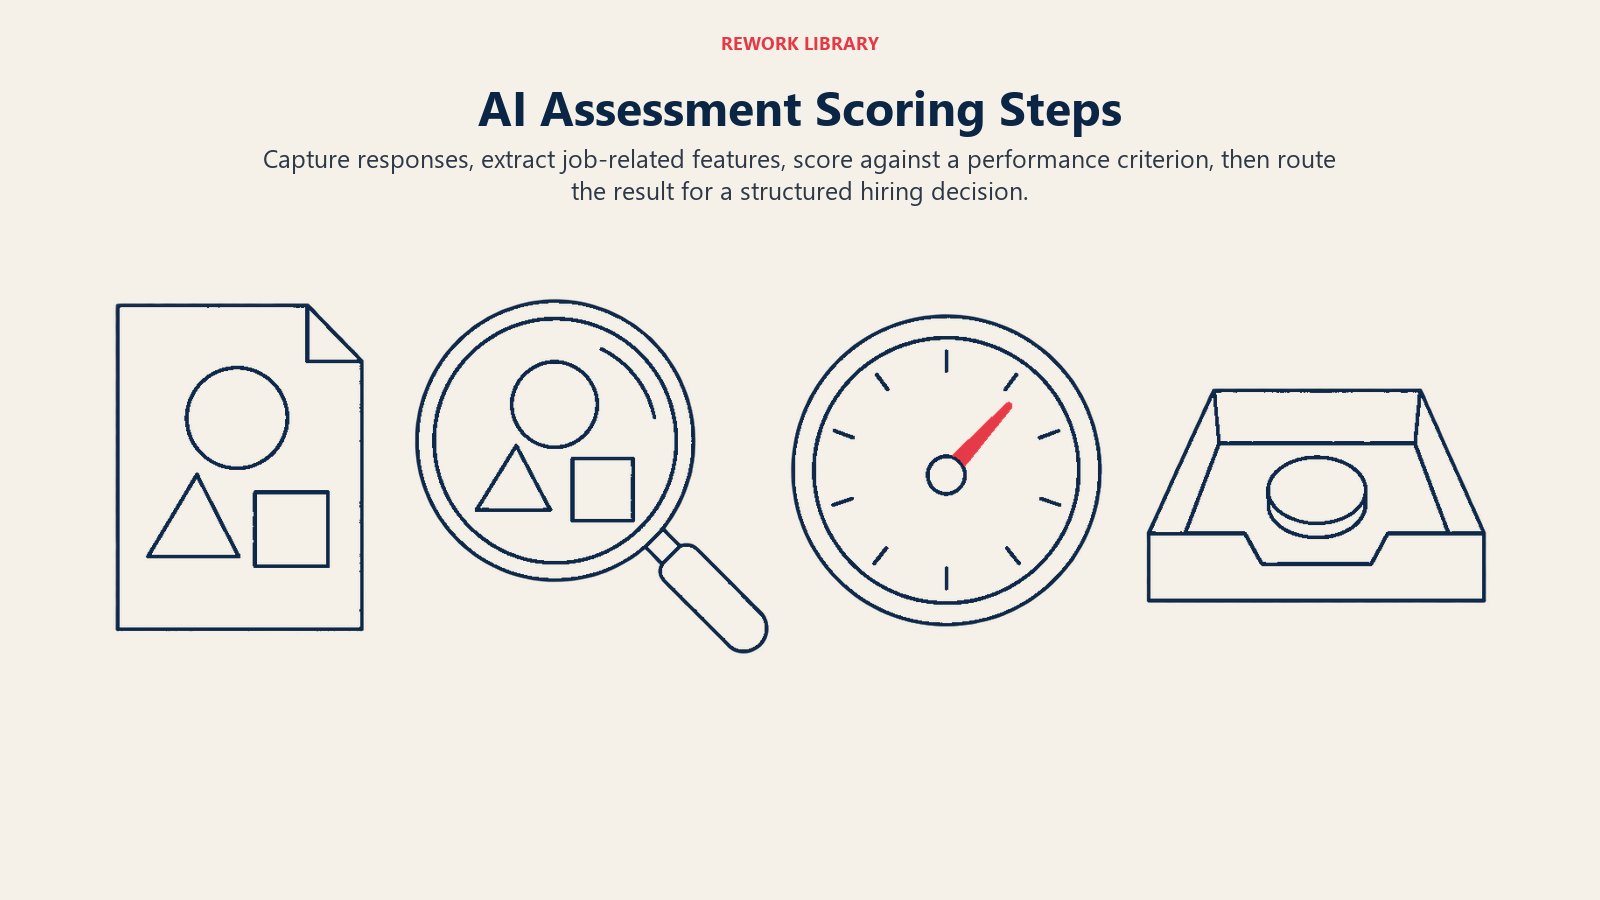
- Captura. La plataforma registra el comportamiento en bruto: clics, tiempos de respuesta, respuestas, un video, una transcripción, código enviado.
- Extracción de características. Los datos en bruto se convierten en características medibles, como la precisión bajo presión de tiempo, cuántas palabras usó un candidato o los temas cubiertos en una respuesta.
- Puntuación del modelo. Un modelo entrenado asocia las características con una puntuación. El entrenamiento necesita un «criterio», es decir, una medida del éxito en el puesto, como las calificaciones de los gerentes o los resultados de ventas de las personas que ya ocupan el puesto.
- Bandas y enrutamiento. La puntuación se convierte en una clasificación o en una banda (recomendado, a revisar, no recomendado), y el candidato pasa a la siguiente etapa.
Dos detalles deciden si el resultado es confiable. Primero, qué se entrenó al modelo a predecir. Si el criterio es «las personas que contratamos y conservamos», el modelo aprende sus preferencias pasadas, defectos incluidos. Segundo, si las características del modelo están relacionadas con el puesto. Una característica que simplemente se correlaciona con el éxito en sus datos históricos puede sustituir en silencio a la edad, el género o la discapacidad.
El caso de advertencia más conocido es un modelo de reclutamiento que construyó Amazon, que puntuaba a los candidatos de una a cinco estrellas tras aprender de unos diez años de currículums, en su mayoría de hombres. Penalizaba los currículums que contenían la palabra «women's» y rebajaba a las egresadas de dos universidades solo para mujeres, y los directivos perdieron la fe en él y disolvieron el equipo (Reuters report, as carried by Euronews). Era una herramienta de currículums, no una evaluación, pero el mecanismo es idéntico: aprender de un pasado sesgado y reproducirlo a escala.
Un segundo caso muestra a un proveedor corrigiendo el rumbo. HireVue dijo en enero de 2021 que había eliminado el análisis facial de sus evaluaciones en video, y explicó que el análisis del lenguaje se había vuelto más predictivo y que el análisis visual ya no aportaba un valor significativo (SHRM). La lección para los compradores es preguntar qué señales usa un modelo y rechazar las señales que no pueda vincular con el puesto.
Validez: ¿predice la puntuación el desempeño laboral?
La validez es la pregunta que más importa y que menos se hace. Una evaluación válida produce puntuaciones que se correlacionan con el desempeño laboral posterior. La correlación se expresa como r, donde 0 significa que no hay relación y 1 significa predicción perfecta. Los métodos de selección reales quedan muy por debajo de 1.
Las Uniform Guidelines dicen que la validez debe basarse en una revisión de la información del puesto, normalmente un análisis del puesto, y describen tres tipos de evidencia: relacionada con el criterio (las puntuaciones se correlacionan con el desempeño), de contenido (la prueba muestrea contenido real del puesto) y de constructo (mide un rasgo definido que se relaciona con el puesto). Las guías también señalan que la validez de contenido no es adecuada para rasgos abstractos como la inteligencia o la personalidad (29 CFR 1607.14). Eso importa para las herramientas basadas en juegos, que suelen afirmar que miden rasgos.
Sobre qué métodos predicen mejor, un reanálisis de 2022 muy citado, de Sackett y colegas, redujo estimaciones anteriores que, según argumentaron, se habían inflado por una corrección excesiva del rango restringido. Sus cifras revisadas: entrevistas estructuradas r = 0,42, pruebas de conocimiento del puesto 0,40, datos biográficos con clave empírica 0,38, pruebas de muestra de trabajo 0,33 y capacidad cognitiva 0,31 (HumRRO summary). De ahí se desprenden tres conclusiones para los gerentes:
- Los métodos basados en el puesto real suelen funcionar bien. Las muestras de trabajo y las pruebas de conocimiento del puesto se parecen directamente al trabajo.
- Incluso los mejores métodos son predictores moderados. Ninguna puntuación debe tratarse como un veredicto sobre una persona.
- La afirmación del proveedor debe coincidir con su puesto. Un estudio de validación con agentes de un centro de llamadas dice poco sobre un puesto de gerente de ingeniería. Los propios estándares de transportabilidad de las Guidelines existen por esta razón.
El punto de esta investigación no es que la puntuación con IA sea mejor o peor que la puntuación tradicional. Es que el formato y su vínculo con el puesto importan más que la etiqueta «IA». Una muestra de trabajo puntuada por IA hereda las fortalezas de la muestra de trabajo; un juego puntuado por IA sin un análisis del puesto detrás no hereda nada.
Impacto adverso y la regla de los cuatro quintos
El impacto adverso significa que un procedimiento de selección descarta a un grupo a una tasa notablemente mayor que a otro, lo haya querido alguien o no. Las Uniform Guidelines de Estados Unidos dan una regla general para detectarlo. Una tasa de selección de cualquier grupo racial, de sexo o étnico inferior a cuatro quintos (80%) de la tasa del grupo con la tasa más alta se considera en general evidencia de impacto adverso. Una tasa por encima de ese umbral, en general, no. El mismo párrafo añade que diferencias menores también pueden ser impacto adverso, sobre todo cuando son significativas en términos estadísticos y prácticos, y que las diferencias basadas en cifras pequeñas pueden no ser fiables (29 CFR 1607.4(D)).
Un ejemplo hipotético muestra la aritmética. Supongamos que 200 candidatos del Grupo A hacen una evaluación y 100 la aprueban, una tasa del 50%. El Grupo B tiene 100 candidatos y 30 aprueban, una tasa del 30%. Divida 30% entre 50% y obtendrá 0,60, por debajo de la línea de 0,80, de modo que el resultado queda marcado para revisión. Si en cambio hubieran aprobado 42 de los 100, la razón sería 0,84 y la marca no se activaría solo por la regla.
Tres advertencias mantienen la regla útil y no peligrosa:
- Es una heurística de detección, no un puerto seguro. Superar la prueba del 80% no significa que una herramienta sea lícita, y no superarla no significa que sea ilícita. Es el comienzo de una revisión más atenta.
- Aplíquela en cada etapa. Pruebe la tasa de aprobación global y también cada evaluación, puntuación de corte y banda. Una evaluación que parece correcta en conjunto puede concentrar el daño en una puntuación de corte.
- El impacto adverso desencadena una pregunta de validez. Según los estándares técnicos, los procedimientos con correlaciones bajas pero gran impacto adverso reciben una revisión minuciosa, y los usuarios deben considerar si hay otros procedimientos con igual o mayor validez disponibles (29 CFR 1607.14). En términos sencillos: si dos herramientas predicen igual de bien y una descarta a más personas de un grupo protegido, use la otra.
Dónde está la exposición legal
Los empleadores cargan con la responsabilidad por las herramientas que compran. Las reglas siguientes se resumen a grandes rasgos y cambian a menudo, así que verifique el texto vigente con un asesor jurídico en cada lugar donde contrata.
Ley federal antidiscriminación de Estados Unidos. Las Uniform Guidelines mencionadas se aplican a los procedimientos de selección en general, incluidos los puntuados por IA. La Americans with Disabilities Act añade una cuestión aparte: la guía del Departamento de Justicia dice que los juegos en línea y las evaluaciones de personalidad deben medir solo las habilidades relevantes para el puesto que pretenden medir, no habilidades sensoriales, manuales o del habla deterioradas, y que el empleador debe ofrecer una prueba accesible u otros ajustes cuando una prueba eliminaría a alguien que puede hacer el trabajo. También dice que el empleador sigue siendo responsable cuando la tecnología discriminatoria proviene de otra empresa (ADA.gov AI guidance).
Ciudad de Nueva York. La Local Law 144 abarca las herramientas automatizadas de decisión de empleo. La herramienta debe haber pasado una auditoría de sesgos en el año previo a su uso, la información sobre la auditoría debe ser pública y los candidatos deben recibir un aviso. La ciudad dice que el aviso debe darse 10 días hábiles antes de usar la herramienta, y comenzó a aplicar la ley el 5 de julio de 2023 (NYC DCWP).
Illinois. La Artificial Intelligence Video Interview Act, vigente desde el 1 de enero de 2020, exige a los empleadores que usan IA para analizar entrevistas en video que den aviso, expliquen cómo funciona la IA y qué características evalúa, obtengan de antemano el consentimiento del postulante, limiten quién ve el video y destruyan las copias dentro de los 30 días siguientes a una solicitud (SHRM summary). Una enmienda aparte a la Illinois Human Rights Act, vigente desde el 1 de enero de 2026, prohíbe usar IA en la contratación y otras decisiones de empleo de maneras que discriminen a clases protegidas, prohíbe usar el código postal como sustituto de ellas y exige dar aviso a los empleados (Crowell & Moring).
Unión Europea. La Comisión clasifica como de alto riesgo las herramientas de IA para el empleo y la gestión de trabajadores, con el software de clasificación de CV como ejemplo. Los sistemas de alto riesgo tienen obligaciones en materia de gestión de riesgos, calidad de los conjuntos de datos, registro, documentación y supervisión humana, y para el empleo se aplican desde el 2 de diciembre de 2027 según las enmiendas del AI Omnibus. El reconocimiento de emociones en los lugares de trabajo está prohibido desde febrero de 2025 (European Commission). Por lo tanto, cualquier evaluación en video que infiera emociones a partir del rostro o la voz es un problema para la contratación en la UE.
Otros estados de Estados Unidos tienen reglas propias o pendientes sobre la IA en la contratación, y algunas se han retrasado o reducido en repetidas ocasiones. Trate cualquier lista de verificación de cumplimiento, incluida esta, como un punto de partida.
Ejemplos reales por función
El mismo formato de evaluación funciona de manera distinta según el puesto.
- Atención al cliente. Una simulación en la que el candidato responde tres tickets realistas, puntuados con una rúbrica de precisión, tono y uso de las políticas. Fácil de vincular con el puesto, fácil de auditar.
- Ventas. Un juego de roles grabado en video, puntuado por el contenido (si hizo preguntas de descubrimiento, si manejó una objeción) y no por señales de voz o faciales. La puntuación basada en el contenido es más fácil de explicar y de defender.
- Ingeniería. Una tarea de programación cronometrada evaluada con casos de prueba, con una persona que revisa el razonamiento de la solución. Buena para las habilidades, muda sobre la colaboración.
- Finanzas y operaciones. Un ejercicio de hoja de cálculo con una clave de respuestas conocida y unas pocas decisiones de criterio. Sobre todo reglas, poca IA, lo cual es una ventaja.
- Puestos por hora de alto volumen. Preguntas breves de juicio situacional y una verificación básica de habilidades, usadas para dirigir a los candidatos a una entrevista, nunca para rechazar sin revisión. El enfoque de la contratación basada en habilidades encaja aquí, porque se centra en lo que una persona puede hacer y no en las credenciales.
Cómo implantar una evaluación con IA, paso a paso
- Parta del puesto. Anote las 4 a 6 tareas críticas y las habilidades que las sustentan. Si no puede describir el puesto, no puede validar una prueba para él.
- Elija la menor cantidad de IA que funcione. Prefiera muestras de trabajo y pruebas de conocimientos vinculadas a esas tareas. Añada la puntuación con IA solo donde ahorre claramente tiempo, como al leer respuestas abiertas.
- Pida evidencia al proveedor. Solicite el estudio de validación, los tipos de puesto y las poblaciones que abarcó, las características que usa el modelo y la auditoría de sesgos más reciente con resultados por grupo. Si no hay un estudio para un puesto comparable, planifique una validación local.
- Decida el papel de la puntuación. Úsela como un insumo de una decisión estructurada, no como una barrera automática. Esta es la práctica del diseño human-in-the-loop (persona en el circuito), y los revisores necesitan autoridad real para anular la puntuación.
- Fije las puntuaciones de corte con cautela. Las puntuaciones de corte más altas suelen aumentar el impacto adverso. Pruebe el efecto de cada umbral antes del lanzamiento.
- Planifique las adaptaciones desde el principio. Diga a los candidatos qué es la evaluación y cómo se puntúa, y ofrezca una vía clara para solicitar un formato alternativo.
- Aplique la verificación de los cuatro quintos a resultados reales. Compare las tasas de aprobación por grupo para la evaluación y para todo el embudo, según un calendario, con suficiente volumen para que signifique algo.
- Atienda los avisos legales. Confirme las obligaciones de aviso, consentimiento y auditoría de cada lugar donde contrata, y conserve los registros de la auditoría y del aviso.
- Revise y retire. Vuelva a comprobar la validez y el impacto al menos una vez al año, y después de cualquier cambio en el puesto o en el modelo. Descarte las herramientas que fallen.
Para opciones de proveedores, consulte la comparativa de las mejores herramientas de evaluación preselectiva. Si además está decidiendo cómo la IA filtra currículums y entrevistas, consulte el filtrado de currículums con IA y la IA en las entrevistas.
Errores comunes
- Tratar «con IA» como prueba de validez. La etiqueta dice cómo se genera la puntuación, no si predice algo.
- Usar juegos de rasgos sin vínculo con el puesto. Si no puede explicar por qué una tarea de memoria o de riesgo se relaciona con el trabajo, un regulador o un demandante hará la misma pregunta.
- Dejar que la puntuación rechace a las personas automáticamente. El rechazo automático elimina la verificación humana en la que se apoyan la mayoría de los marcos legales.
- Probar el sesgo una sola vez al lanzamiento. Los grupos de candidatos, las puntuaciones de corte y los modelos cambian. Una auditoría puntual queda obsoleta.
- Ignorar la accesibilidad. Las tareas cronometradas, visuales o con mucha exigencia motriz pueden descartar a personas que podrían hacer el trabajo.
- Depender del proveedor. La guía federal sobre discapacidad es explícita en que el empleador que usa la herramienta es dueño del resultado.
- Sin explicación para los candidatos. Si nadie puede decir por qué alguien obtuvo una puntuación baja, no puede defenderlo. Por eso la IA explicable importa en la selección, y por eso el sesgo en la IA debe estar en toda conversación con proveedores.
Siguientes pasos
Elija un puesto, escriba sus tareas críticas y compare con ellas cualquier evaluación que esté considerando antes de ver una demo. Luego pida el estudio de validación y los resultados de impacto adverso. El mapa completo de la sección está en el eje de IA en el reclutamiento, y la visión de toda la función está en IA en recursos humanos.

Senior Customer Retention Strategist
On this page
- Datos clave
- Qué cuenta como evaluación preselectiva con IA
- Cómo funciona la puntuación
- Validez: ¿predice la puntuación el desempeño laboral?
- Impacto adverso y la regla de los cuatro quintos
- Dónde está la exposición legal
- Ejemplos reales por función
- Cómo implantar una evaluación con IA, paso a paso
- Errores comunes
- Siguientes pasos