従業員エンゲージメントのためのAI:パルスサーベイ、感情分析、行動
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
従業員エンゲージメントのためのAIとは、言語モデルと統計分析を使ってサーベイのスコアと自由記述コメントを読み取り、テーマごとにまとめ、マネージャーが動くべき箇所を示すことです。これにより、フィードバックは誰も開かないレポートではなく、意思決定につながります。 サーベイ自体はあまり変わっていません。変わったのは、数千件の自由記述コメントを数分で読めるようになったことで、そこから2つの新しい問いが生まれます。コメントを書いた人をどう守るのか、そして、マネージャーは実際に次に何をするのか、です。
本記事は、エンゲージメントサーベイを実施する、または結果を受け取る人事責任者、ピープルマネージャー、部門長向けです。人事におけるAIの従業員体験のセクションに属し、分析面に焦点を当てています。自動化されたサーベイアシスタントの構築面のブループリントについては、AIエンゲージメントサーベイエージェントをご覧ください。
重要なポイント
- Gallupの「State of the Global Workplace 2026」レポートは、2025年1月から12月に収集したデータにより、世界の従業員の20%がエンゲージしており、16%が積極的にエンゲージしていないことを明らかにしました(Gallup)。
- 同レポートによると、世界のエンゲージメントは2022年と2023年に23%でピークを迎え、2024年には21%、2025年には20%に低下しました(Gallup)。
- Gallupはまた、マネージャーは個人貢献者よりもわずかにエンゲージメントが高く、22%対19%であると報告しています(Gallup)。
- Microsoft Viva Glintの既定の設定では、回答者が5人未満のグループのスコアは非表示になり、回答者が10人未満のグループのコメントも非表示になります(Microsoft Learn)。
- Viva GlintのCopilotによるコメント要約は、最も関連性の高いコメントを最大8,000件まで最大10のトピックにまとめ、コメント数がプログラムの機密保持のしきい値を下回る場合は回答を返しません(Microsoft Learn)。
- Culture Ampは、コメントの最小数を適用する際にコメントではなく人数を数え、小さなチームが引き算で割り出されないように、追加のグループを非表示にすることもできます(Culture Amp)。
AIはサーベイデータで実際に何をするのか
エンゲージメントサーベイは、2種類のデータを生みます。評価式の質問(「このチームを働く場としてすすめたい」を1から5で採点するもの)は構造化された数値であり、統計が得意とする領域です。自由記述コメントはテキストで、最近までは誰かが読む必要があり、たいていは粗く、遅れてしまっていました。言語モデルが変えたのは、後者の半分です。
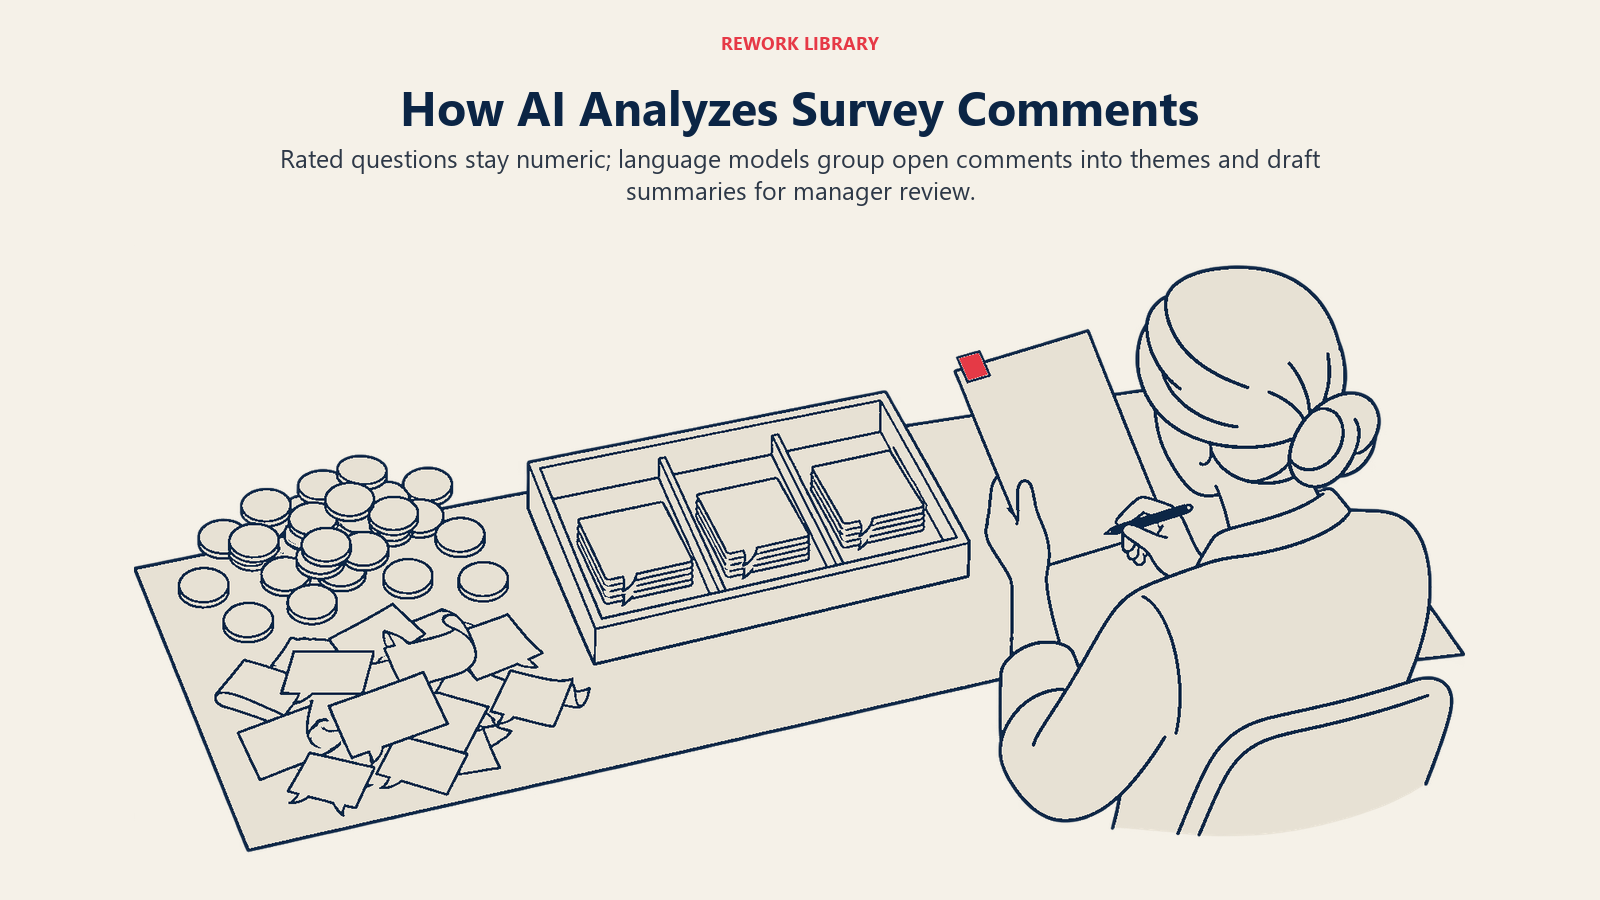
ACE Frameworkの用語でいえば、これは主にingest(回答と、チーム・勤務地・勤続年数といった人事属性の取り込み)、analyze(グループ化とスコアリング)、generate(要約と次のステップの提案)にあたります。予測を必要とすることはまれで、そのため候補者のスクリーニングよりもリスクの低いテーマです。それでも機微なデータを扱うので、ガードレールは重要です。
主な役割は、多くのチームが導入する順に並べると次のとおりです。
- テーマの検出。 モデルがコメントを読み、業務量、給与、キャリアの成長、特定のマネージャー、ツール、スケジュールなどにまとめます。人が行えば数日かかる作業です。モデルなら数分で、複数の言語のコメントにも対応できます。
- 感情のスコアリング。 各コメントやテーマに、肯定的、中立、否定的の傾きを付けます。これが感情分析で、振り分けには役立ちますが、皮肉、略語、文化の違いには弱い面があります。
- ドライバー分析。 統計により、どのサーベイ項目が総合的なエンゲージメントや継続勤務の意向と連動して動くかがわかるので、どのグループにとってどの話題が最も重要かが見えてきます。
- マネージャー向けの要約。 リーダーは、400行の生のコメントではなく、平易な言葉で書かれた3段落を受け取ります。Viva GlintのMicrosoft Copilotによるコメント要約は、この機能の商用の一例です(Microsoft Learn)。
- 行動の提案。 モデルが、テーマに結びついた会話のきっかけや小さな実験を提案します。これらは下書きであり、チームに合うものはマネージャーが決めます。
頻繁なパルスサーベイがいま意味を持つ理由
年次サーベイには、タイミングの問題があります。結果が整理され、報告され、議論される頃には、それが描いていた状況がすでに変わっていることも少なくありません。パルスサーベイは、数週間ごとに少数の質問をするので、マネージャーはより新しい状況を把握できます。
問題はボリュームです。サーベイが増えればコメントも増え、すべてを読めないチームは尋ねること自体をやめてしまいます。AIによって、頻繁な実施サイクルが現実的になります。読む作業が、サーベイの回数に比例して増えなくなるからです。
必要性は抽象的なものではありません。Gallupの2026年のレポートでは、世界のエンゲージメントはピークの23%から20%に低下しており、80%の従業員がエンゲージしているグループの外にいます(Gallup)。自社の正確な数字がどうであれ、年に1度のアンケートが示せる以上に、学べることはたいていあります。
プライバシーと匿名性:省けない部分
従業員が正直に答えるのは、コメントが自分にたどられることはないと信じられる場合に限ります。AIは、この点を一方では難しくし、もう一方では容易にします。難しくなるのは、モデルが小さなチームのコメントを見事に要約するため、書いた人が一目でわかってしまう(「このチームで夜勤をしている唯一の人」)ことがあるからです。容易になるのは、同じソフトウェアがルールを自動的に適用できるからです。
匿名と機密の違い
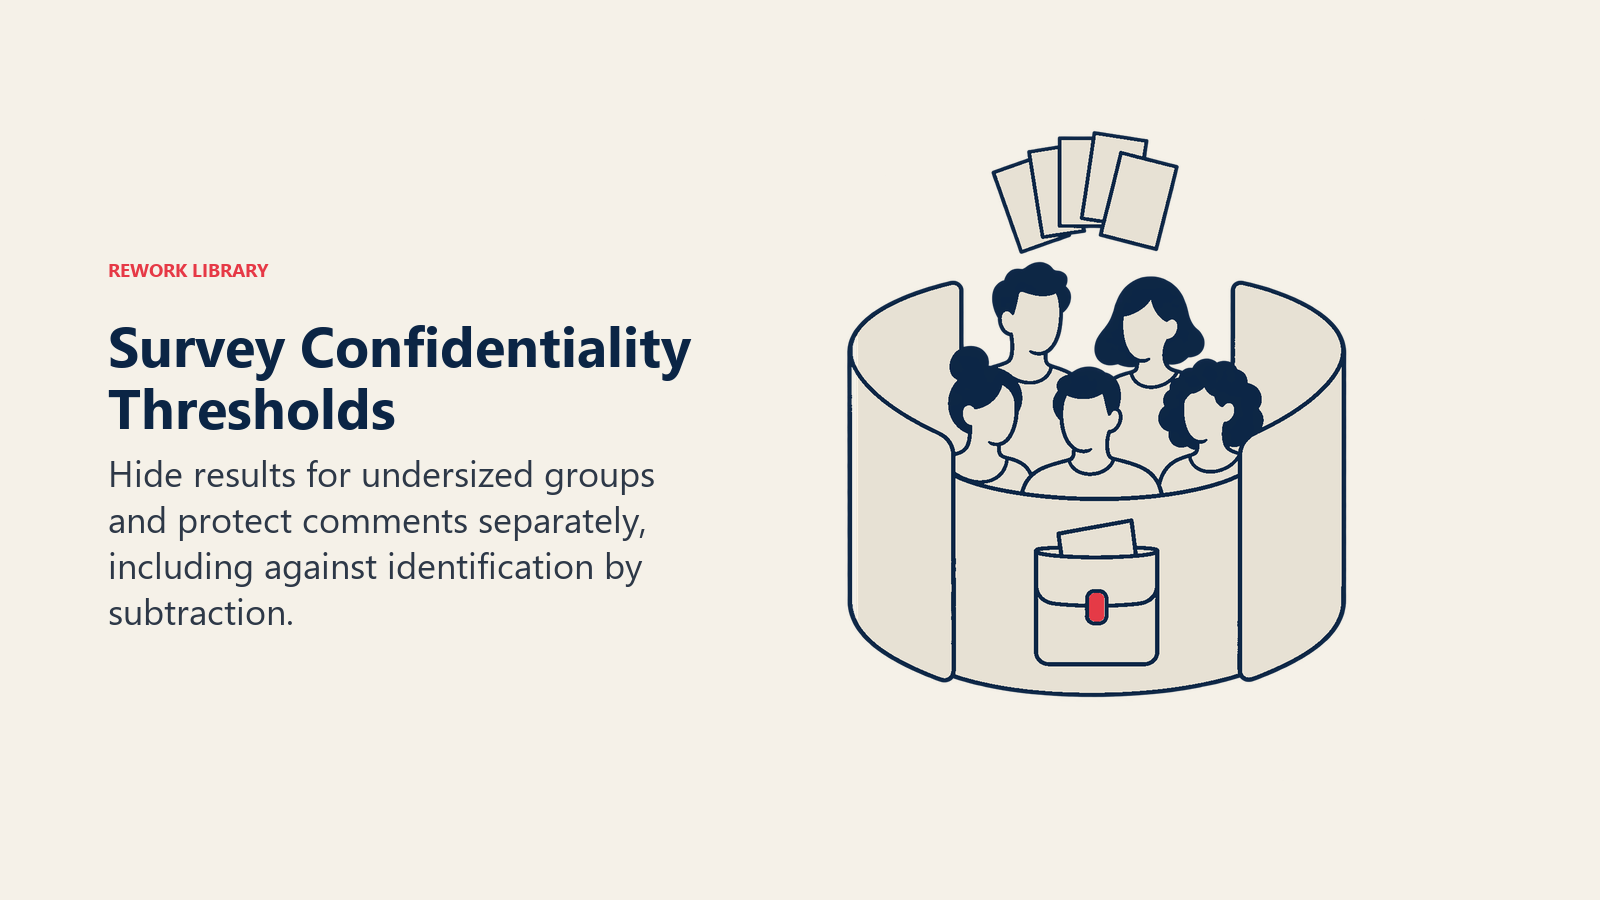
これらの言葉は、同じ意味ではありません。匿名サーベイは、個人を特定する情報を一切収集しません。機密サーベイは、回答を従業員の記録に紐づけます(チーム、勤務地、勤続年数別に報告できるようにするため)が、個人は表示されないことを約束します。ほとんどのエンゲージメントプラットフォームは、匿名ではなく機密です。サーベイの案内には、どちらを意味しているかを明記してください。
最小グループのしきい値
標準的な保護は最小グループサイズです。回答者が定められた人数に満たないグループには、結果を表示しません。唯一の共通の数字はありません。ベンダーが独自の既定値を設定し、管理者が変更でき、多くの場合、スコアよりもコメントに高い基準を使います。
| プラットフォーム | ドキュメントの記載 | コメントは別に扱われるか |
|---|---|---|
| Microsoft Viva Glint | 既定では回答者5人未満のスコアは非表示。機密サーベイは最小3人まで設定可能(Microsoft Learn) | はい。既定では回答者10人 |
| Culture Amp | 「レポートグループの最小人数」を満たすまで結果を非表示にする。ヘルプの例では5を使用(Culture Amp) | はい。サーベイに回答した人数で数え、レポートの最小人数と同じに設定されることが多い |
| Qualtrics | 管理者がデータを表示するために必要な最小回答数を設定する。ヘルプページに既定値の記載なし(Qualtrics) | はい。コメントには別の最小数 |
パターンに注目してください。どのプラットフォームも、スコアとコメントを分けて扱っています。1つの文は、平均値よりもはるかに簡単に個人を特定できるからです。
1つの数字を超える防御策
最小数だけでは穴があり、優れたプラットフォームはそれを塞いでいます。
- 次のグループも非表示にします。 非常に小さなチームだけが非表示で、その親グループが表示されていると、引き算で小さなチームの結果がわかってしまいます。Viva Glintの既定の非表示しきい値である2は、十分な回答がカバーされるまで次に小さいグループを非表示にします(Microsoft Learn)。Culture Ampの間接的な特定の防止設定も、同様の働きをします。
- フィルターの制限。 Culture Ampは、レポートの最小人数より小さくなるフィルターをブロックするので、誰も絞り込みを重ねて個人にたどり着けません(Culture Amp)。
- 回答でフィルターするときの追加の保護。 Viva Glintは、好意的に回答した全員など、質問への回答でレポートを絞り込む場合、スコアは最小10人、コメントは最小20人を適用します(Microsoft Learn)。
- 同じルールを守るAI。 あらゆる要約ツールが、しきい値に従うことを確認してください。Viva GlintのCopilotは、コメント数がプログラムのしきい値を下回る場合は応答せず、ログイン中のユーザーが閲覧を許可されているデータだけを読み取ります(Microsoft Learn)。
これらはすべて、特定の製品の機能に関する事実であり、法的な基準ではないものとして扱ってください。自社のしきい値は、人事、プライバシー、法務のチームが一緒に決めることであり、現地のデータ保護法がさらに要件を加えることもあります。
ステップごとの展開方法
- まず意思決定を定義します。 結果に基づいて何を変えるのかを書き出します。人員配置、業務量、表彰、マネージャーへのコーチングなどです。意思決定が結びついていないサーベイは、単なる気分の確認にすぎません。
- 最初のサーベイの前にプライバシーのルールを決めます。 スコアとコメントそれぞれの最小グループサイズ、誰が何を見られるか、サーベイが匿名か機密かを決めます。プラットフォームによっては、サーベイの開始後にこれらが固定されるため、早めに決めてください。たとえばViva Glintでは、プログラムが回答を収集した後は、管理者がサーベイ単位のしきい値を変更できません(Microsoft Learn)。
- データの基盤を整えます。 チーム別のレポートには、正確なチームの割り当てが必要です。人事システムの組織図が古いと、結果が誤ったマネージャーに割り当てられてしまいます。整理の方法は、AIのための人事データの基盤で解説しています。
- サーベイを短くします。 評価式の質問5〜10問に自由記述の問い1〜2問のほうが、60項目のアンケートよりも優れています。小さなチームがプライバシーのしきい値を超えられるかは回答率で決まり、長いアンケートは回答率を下げがちです。
- AIが何をするかを従業員に伝えます。 モデルがコメントをテーマにまとめること、出力を誰が見るのか、何が決して表示されないのかを説明してください。沈黙は疑念を招きます。
- AIのテーマを元のコメントと照らして確認します。 最初の2サイクルは、人事の担当者がコメントのサンプルを読み、生成されたテーマと比べてください。見落とされた話題、本来は別にすべきなのに統合された話題、誤って割り当てられた感情がないかを確認します。
- マネージャーには1ページを渡します。 マネージャーに必要なのは、上位2つの強み、上位2つの懸念、提案される会話であり、ダッシュボードではありません。
- 2週間以内にチームでの対話を行います。 マネージャーはテーマをチームと共有し、その背景を尋ね、担当者と期限を明確にした1〜2つの行動に合意します。
- ループを閉じます。 サーベイをきっかけに何が変わったかを、組織に伝えます。人は、結果を目にしてはじめて、再び回答します。
結果をマネージャーの行動につなげる
ほとんどのエンゲージメントの取り組みで足りていないのは、分析ではありません。その後に何が起こるかです。優れたAIの要約は読む手間を減らすので、空いた時間は対話に使うべきです。
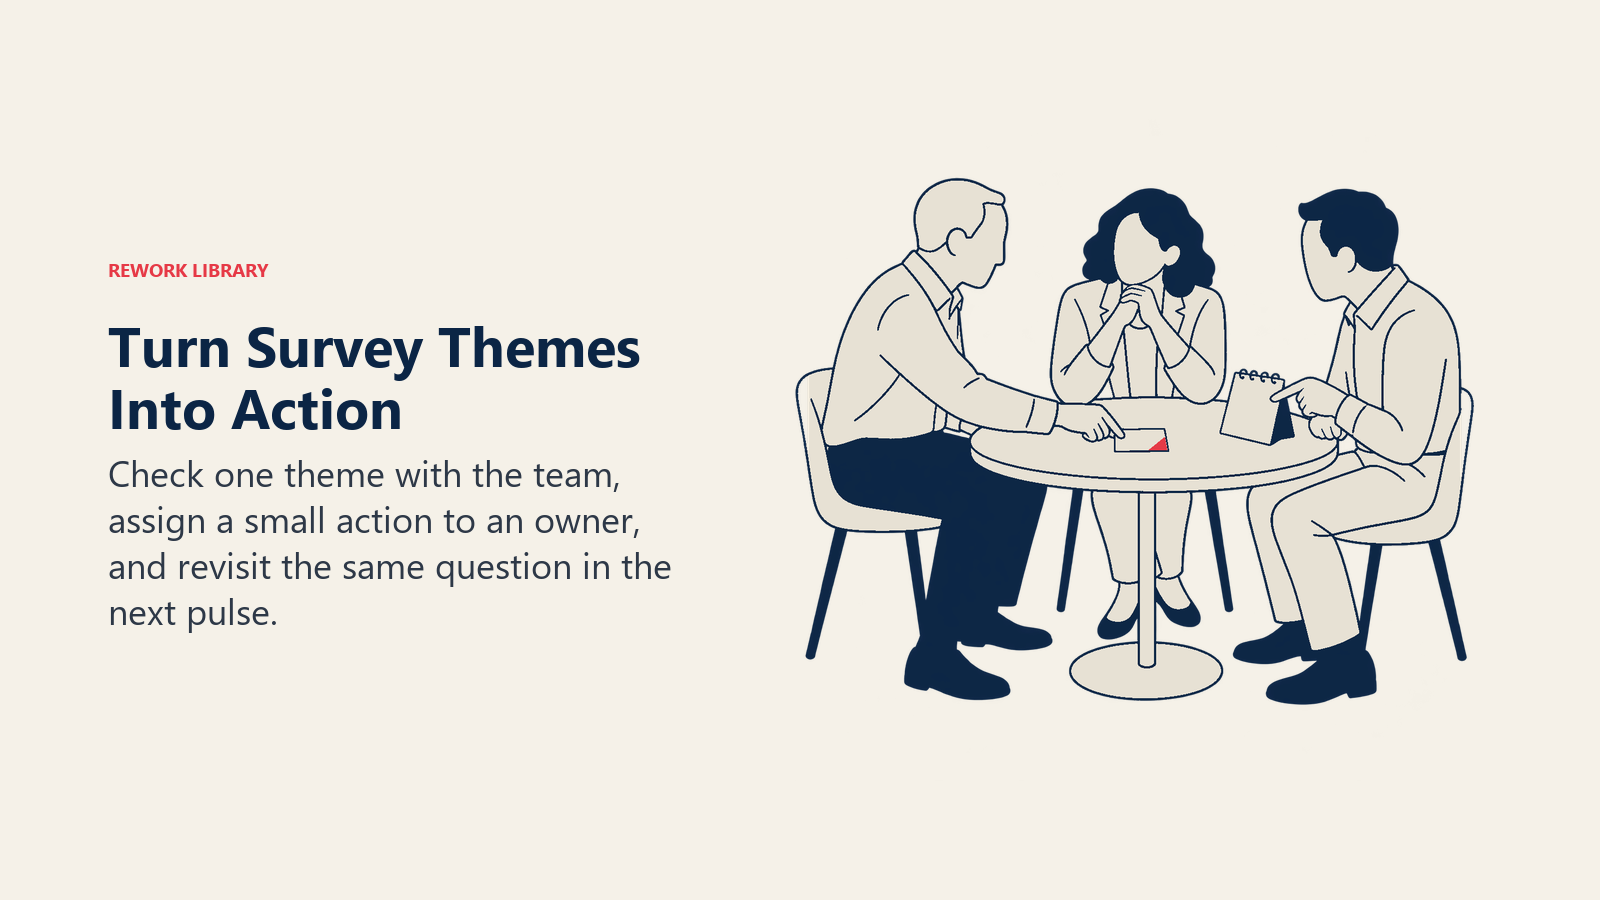
マネージャーが従える、シンプルな枠組みは次のとおりです。
- テーマを1つ選びます。 5つではありません。コメントが最も多く、スコアが最も低いテーマが、よい出発点です。
- チームと一緒に確かめます。 要約は仮説です。「これはみなさんの実感に合っていますか? その背景には何がありますか?」と尋ねてください。
- 小さな行動を選びます。 定例会議を動かす、止まっている承認を進める、スケジュールを調整し直す。小さくても目に見えるもののほうが、大きくて曖昧なものよりも優れています。
- 担当者と期限を決めます。
- 次のパルスで再確認します。 変化を比較できるように、同じ質問を使います。
職種別の実例
シフト勤務者のいるオペレーションチーム。 マネージャーは、複数のコメントにわたって「ほとんど予告のないシフト変更」が最も多い否定的なテーマであることに気づきます。ワークライフバランスについての一般的な話をする代わりに、彼女は1週間前にスケジュールを掲示することを約束し、次のパルスで同じ質問を確認します。
営業チーム。 要約では、同僚からの支援に関するスコアは高い一方、担当テリトリーの変更が不明確だというコメントが繰り返されています。営業責任者は、テリトリーの決め方を説明する短いセッションを開き、そのテーマが薄れていくかを確認します。
エンジニアリングチーム。 コメントは、コードレビューの遅さと優先順位の不明確さに集中しています。チームリーダーは、レビューを1営業日以内に完了するというルールを、1か月間試します。
HRビジネスパートナー。 全社を通して、モデルが4つの部門に現れるキャリアパスに関するテーマを浮かび上がらせます。これはマネージャーのレベルでは解決できないため、人事がエスカレーションします。ここで出番となるのがピープルアナリティクスとAIで、サーベイのテーマを昇進や勤続年数といったデータと組み合わせます。
しきい値に満たない小さなチーム。 4人のチームは最小数を満たしません。マネージャーにはチーム単位のレポートが届きませんし、届くべきでもありません。代わりにオープンな対話の場を持ち、チームが直接フィードバックを共有することを選べます。上位の部門のレポートが、見せられる範囲で状況を示します。
よくある落とし穴
- 要約を真実とみなすこと。 モデルは少数派の意見を見落としたり、声の大きいテーマを過大に評価したりすることがあります。元のコメントをサンプルで確認してください。
- 「より多くのデータ」を得るためにしきい値を低く設定しすぎること。 3人のチームに自分たちのコメントを見せれば、機密保持の約束が台無しになり、人々に正直でいることをやめさせてしまいます。
- マネージャーに書き手を探させること。 明示的に禁止してください。コメントした人を特定する行為が一度でもあれば、率直なフィードバックは何年も失われかねません。
- サーベイデータを人事評価の判断と混ぜること。 コメントが評価に影響しうると思えば、人はコメントを書かなくなります。方針でもツールでも、両者を切り離してください。
- 注意なくサーベイの回答から離職を予測すること。 可能ではありますが、それは別の、よりリスクの高い使い方であり、独自の保護策が必要です。AIによる離職予測をご覧ください。
- サーベイをして、その後は沈黙すること。 前回の後の沈黙ほど、次回の回答率を下げるものはありません。
- 翻訳の確認を省くこと。 感情分析ツールの品質は言語によって異なるため、主要な言語グループごとに、堪能な読み手に出力を確認してもらってください。
測定すべき指標
取り組みは、ダッシュボードの利用ではなく、成果で判断してください。
- 参加: チーム別の回答率と、プライバシーのしきい値を超えたチームの数。
- スピード: サーベイの締め切りから、最初のチームでの対話までの日数。
- 実行: 担当者を決めた行動があるチームの割合と、完了した割合。
- 変化: 対象とした質問の、パルスごとの変化。
- 信頼: 「自分のフィードバックは活用されると信じている」のような質問を、時系列で追跡します。
サーベイの質問やマネージャー向けの話題を下書きする際には、汎用の文章作成アシスタントも役立ちます。これについては人事チーム向け生成AIで解説しています。

Senior Customer Retention Strategist