KI-gestützte Eignungsdiagnostik vor der Einstellung: Funktionsweise, Validität und rechtliche Risiken
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
Ein KI-gestützter Eignungstest vor der Einstellung ist ein Test, den ein Stellenbewerber absolviert (ein Spiel, eine Job-Simulation, ein aufgezeichnetes Videointerview oder eine Skills-Aufgabe) und dessen Antworten ein Modell des maschinellen Lernens bewertet, das vorhersagt, wie gut die Person in einer Rolle abschneiden würde. Das Ergebnis ist meist ein Score, ein Ranking oder ein Bestanden/Nicht-bestanden-Band, das in eine Einstellungsentscheidung einfließt. Der Test ist nur so gut wie zwei Dinge: ob der Score die Arbeitsleistung tatsächlich vorhersagt (Validität) und ob er Gruppen von Bewerbern fair behandelt (Adverse Impact).
Diese Seite richtet sich an HR-Direktoren, Leiter von Talent Acquisition und einstellende Führungskräfte, denen diese Tools angeboten werden oder die sie bereits nutzen. Sie erklärt, wie das Scoring funktioniert, was die Forschung dazu sagt, welche Testarten die Leistung vorhersagen, wie Adverse Impact gemessen wird und woher das rechtliche Risiko kommt. Es sind allgemeine Informationen, keine Rechtsberatung. Für das gesamte Bild des Recruitings beginnen Sie mit dem Hub KI im Recruiting.
Wichtige Fakten
- Nach den US-amerikanischen Uniform Guidelines wird eine Auswahlquote für eine Gruppe, die weniger als vier Fünftel (80 %) der Quote der Gruppe mit der höchsten Quote beträgt, im Allgemeinen als Hinweis auf Adverse Impact gewertet, wobei auch kleinere Unterschiede zählen können (29 CFR 1607.4(D)).
- Eine Neuschätzung der Validität von Auswahlverfahren aus dem Jahr 2022 setzte strukturierte Interviews bei r = 0,42, Fachwissenstests bei 0,40, Arbeitsproben bei 0,33 und kognitive Fähigkeiten bei 0,31 an (HumRRO zu Sackett et al., 2022).
- New York City verlangt ein Bias-Audit eines automatisierten Einstellungsentscheidungs-Tools innerhalb eines Jahres vor seinem Einsatz, eine öffentliche Zusammenfassung und eine Mitteilung an Kandidaten, und die Durchsetzung begann am 5. Juli 2023 (NYC DCWP).
- Der EU AI Act stuft KI-Tools für Beschäftigung und Personalführung als Hochrisiko ein, mit Geltung dieser Regeln ab dem 2. Dezember 2027, und verbietet Emotionserkennung am Arbeitsplatz, ein Verbot, das seit Februar 2025 gilt (European Commission).
Was als KI-gestützter Eignungstest vor der Einstellung gilt
Die Kategorie umfasst vier Formate, und sie unterscheiden sich darin, wie viel die KI leistet.
| Format | Was der Kandidat tut | Was die KI bewertet | Hauptrisiko |
|---|---|---|---|
| Spielbasiert | Spielt kurze Aufgaben (Gedächtnis, Risiko, Muster, Aufmerksamkeit) | Verhalten im Spiel, abgebildet auf Eigenschaften oder Fähigkeiten | Schwacher Bezug zu Arbeitsaufgaben; Barrierefreiheit |
| Job-Simulation / Arbeitsprobe | Erledigt eine realistische Aufgabe: Tickets sichten, eine Tabelle bearbeiten, eine Antwort schreiben | Qualität des Ergebnisses anhand eines Bewertungsrasters, teils automatisiert | Abweichung des Rasters; Aufwand beim Aufbau |
| Aufgezeichnetes Videointerview | Beantwortet vorgegebene Fragen vor der Kamera | Inhalt des Transkripts, teils Stimme oder andere Signale | Undurchsichtige Signale; Einwilligungsgesetze; Emotionsableitung |
| Skills- und Wissenstest | Beantwortet Fragen oder löst Probleme (Programmieren, Sprache, Rechnen) | Richtig/falsch, adaptive Schwierigkeit | Täuschung, Durchsickern von Testinhalten |
Einfaches Scoring (richtige Antworten gegen einen Schlüssel zählen) ist nicht wirklich KI. Der KI-Anteil kommt hinzu, wenn ein Modell lernt, welche Antwortmuster als gut zu werten sind, oder wenn es offene Ergebnisse wie Sprache und Text liest.
Wie das Scoring funktioniert
Die meisten KI-Tests folgen denselben vier Schritten, die den Phasen Ingest, Analyze und Predict des ACE Framework entsprechen.
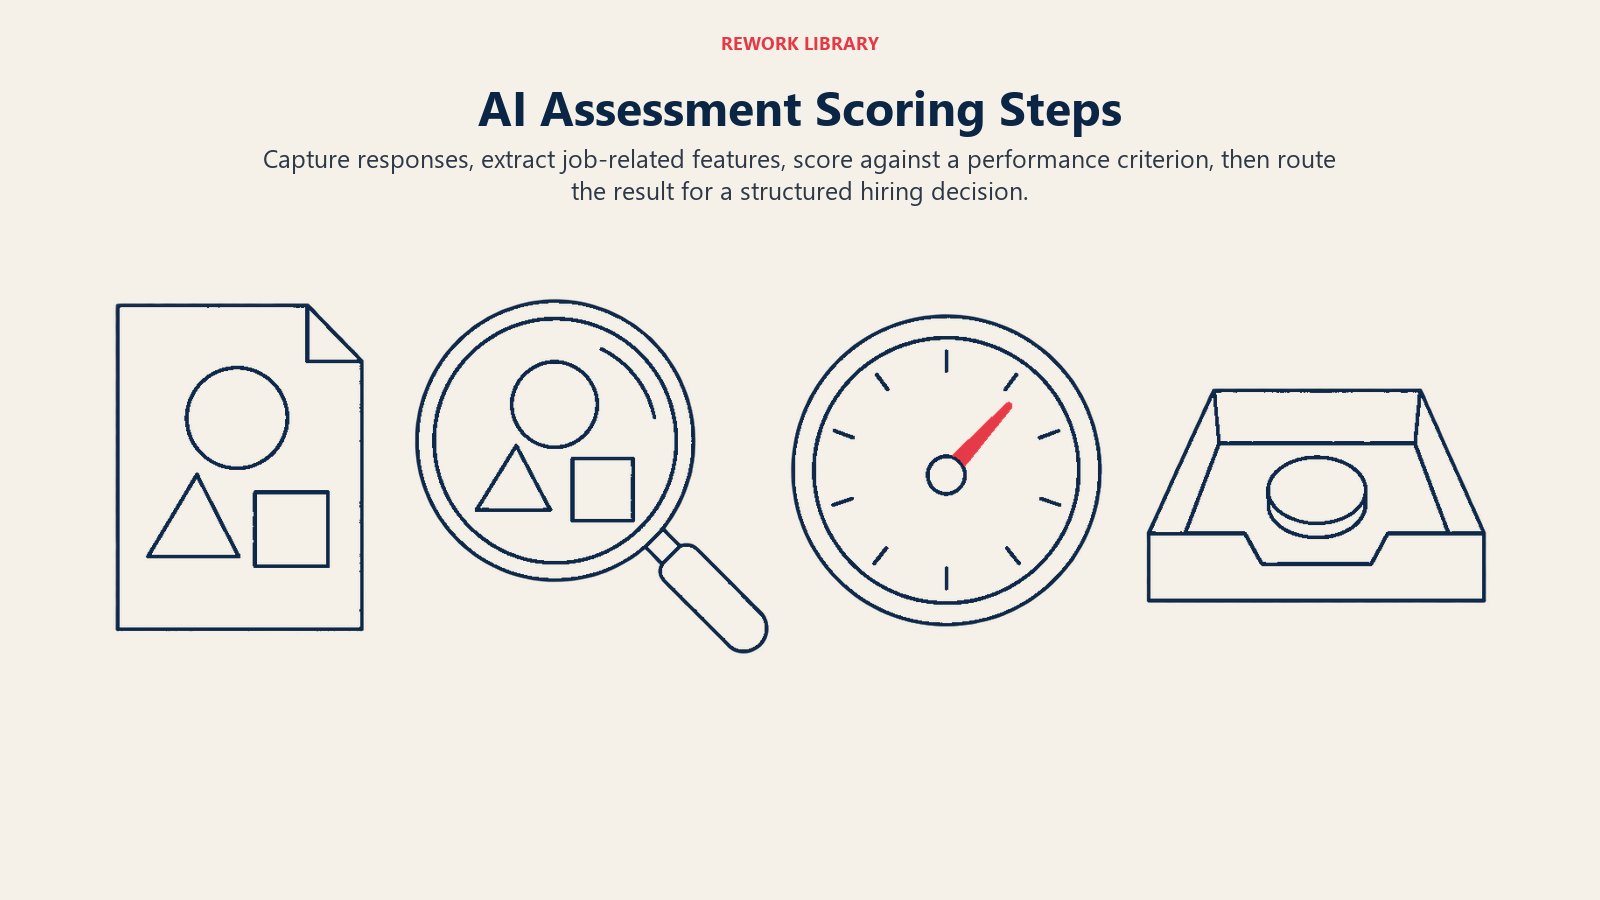
- Erfassung. Die Plattform zeichnet das Rohverhalten auf: Klicks, Antwortzeiten, Antworten, ein Video, ein Transkript, eingereichten Code.
- Merkmalsextraktion. Aus den Rohdaten werden messbare Merkmale, etwa Genauigkeit unter Zeitdruck, wie viele Wörter ein Kandidat verwendet hat oder welche Themen eine Antwort abdeckt.
- Modell-Scoring. Ein trainiertes Modell bildet Merkmale auf einen Score ab. Das Training braucht ein „Kriterium“, also ein Maß für den Berufserfolg, etwa Beurteilungen durch Führungskräfte oder Vertriebsergebnisse von Personen, die die Rolle bereits ausüben.
- Einstufung und Weiterleitung. Der Score wird in einen Rang oder ein Band übersetzt (empfohlen, prüfen, nicht empfohlen), und der Kandidat wird in die nächste Phase geleitet.
Zwei Einzelheiten entscheiden, ob das Ergebnis vertrauenswürdig ist. Erstens: worauf das Modell trainiert wurde. Lautet das Kriterium „Leute, die wir eingestellt und gehalten haben“, lernt das Modell Ihre bisherigen Vorlieben, Mängel eingeschlossen. Zweitens: ob die Merkmale des Modells berufsbezogen sind. Ein Merkmal, das in Ihren historischen Daten lediglich mit Erfolg korreliert, kann unauffällig für Alter, Geschlecht oder Behinderung stehen.
Der bekannteste warnende Fall ist ein Recruiting-Modell von Amazon, das Kandidaten mit einem bis fünf Sternen bewertete, nachdem es aus rund zehn Jahren Lebensläufen gelernt hatte, die überwiegend von Männern stammten. Es wertete Lebensläufe ab, die das Wort „women's“ enthielten, und stufte Absolventinnen zweier reiner Frauen-Colleges herab, und die Führungsebene verlor das Vertrauen und löste das Team auf (Reuters-Bericht, wiedergegeben von Euronews). Es war ein Lebenslauf-Tool, kein Eignungstest, aber der Mechanismus ist identisch: aus einer verzerrten Vergangenheit lernen und sie im großen Maßstab reproduzieren.
Ein zweiter Fall zeigt einen Anbieter, der den Kurs korrigiert. HireVue erklärte im Januar 2021, die Gesichtsanalyse aus seinen Video-Eignungstests entfernt zu haben, und begründete das damit, dass die Sprachanalyse aussagekräftiger geworden sei und die visuelle Analyse keinen nennenswerten Mehrwert mehr bringe (SHRM). Die Lehre für Käufer: Fragen Sie, welche Signale ein Modell nutzt, und lehnen Sie Signale ab, die Sie nicht mit der Stelle verbinden können.
Validität: Sagt der Score die Arbeitsleistung voraus?
Die Validität ist die Frage, die am meisten zählt und am seltensten gestellt wird. Ein valider Test liefert Scores, die mit der späteren Arbeitsleistung korrelieren. Die Korrelation wird als r ausgedrückt, wobei 0 keinen Zusammenhang und 1 eine perfekte Vorhersage bedeutet. Reale Auswahlverfahren liegen deutlich unter 1.
Die Uniform Guidelines besagen, dass Validität auf einer Auswertung von Informationen zur Stelle beruhen sollte, in der Regel einer Arbeitsanalyse, und beschreiben drei Arten von Belegen: kriteriumsbezogen (Scores korrelieren mit der Leistung), inhaltlich (der Test bildet echte Arbeitsinhalte ab) und konstruktbezogen (er misst eine definierte Eigenschaft mit Bezug zur Stelle). Die Guidelines halten außerdem fest, dass inhaltliche Validität für abstrakte Eigenschaften wie Intelligenz oder Persönlichkeit nicht geeignet ist (29 CFR 1607.14). Das ist für spielbasierte Tools wichtig, die meist behaupten, Eigenschaften zu messen.
Zur Frage, welche Verfahren am besten vorhersagen, senkte eine viel zitierte Neuanalyse von Sackett und Kollegen aus dem Jahr 2022 frühere Schätzungen, die ihrer Ansicht nach durch Überkorrektur wegen eingeschränkter Streubreite überhöht waren. Ihre überarbeiteten Werte: strukturierte Interviews r = 0,42, Fachwissenstests 0,40, empirisch gewichtete Biodaten 0,38, Arbeitsproben 0,33 und kognitive Fähigkeiten 0,31 (Zusammenfassung von HumRRO). Daraus ergeben sich drei Erkenntnisse für Führungskräfte:
- Verfahren, die auf der tatsächlichen Stelle beruhen, schneiden tendenziell gut ab. Arbeitsproben und Fachwissenstests ähneln der Arbeit unmittelbar.
- Selbst die besten Verfahren sind mittelmäßige Prädiktoren. Kein Score sollte als Urteil über einen Menschen behandelt werden.
- Die Behauptung des Anbieters muss zu Ihrer Stelle passen. Eine Validierungsstudie zu Call-Center-Mitarbeitenden sagt wenig über die Rolle einer Engineering-Führungskraft. Dafür gibt es die Übertragbarkeitsstandards der Guidelines.
Der Kern dieser Forschung ist nicht, dass KI-Scoring besser oder schlechter ist als herkömmliches Scoring. Er lautet, dass das Format und sein Bezug zur Stelle mehr zählen als das Etikett „KI“. Eine KI-bewertete Arbeitsprobe erbt die Stärken der Arbeitsprobe; ein KI-bewertetes Spiel ohne Arbeitsanalyse dahinter erbt nichts.
Adverse Impact und die Vier-Fünftel-Regel
Adverse Impact bedeutet, dass ein Auswahlverfahren eine Gruppe spürbar häufiger aussortiert als eine andere, unabhängig davon, ob das jemand beabsichtigt hat. Die US-amerikanischen Uniform Guidelines geben eine Faustregel, um es zu erkennen. Eine Auswahlquote für eine Rasse, ein Geschlecht oder eine ethnische Gruppe, die weniger als vier Fünftel (80 %) der Quote der Gruppe mit der höchsten Quote beträgt, gilt im Allgemeinen als Hinweis auf Adverse Impact. Eine Quote über dieser Schwelle gilt im Allgemeinen nicht als solcher. Derselbe Absatz ergänzt, dass auch kleinere Unterschiede Adverse Impact sein können, besonders wenn sie statistisch und praktisch bedeutsam sind, und dass Unterschiede auf Grundlage kleiner Fallzahlen womöglich nicht verlässlich sind (29 CFR 1607.4(D)).
Ein hypothetisches Beispiel zeigt die Rechnung. Angenommen, 200 Kandidaten aus Gruppe A absolvieren einen Test und 100 bestehen, eine Quote von 50 %. Gruppe B hat 100 Kandidaten, von denen 30 bestehen, eine Quote von 30 %. Teilen Sie 30 % durch 50 %, und Sie erhalten 0,60, unter der Linie von 0,80, sodass das Ergebnis zur Prüfung markiert wird. Hätten stattdessen 42 der 100 bestanden, läge das Verhältnis bei 0,84, und die Markierung würde allein nach der Regel nicht ausgelöst.
Drei Vorbehalte halten die Regel nützlich statt gefährlich:
- Sie ist eine Faustregel zur Vorprüfung, kein sicherer Hafen. Das Bestehen des 80-%-Tests bedeutet nicht, dass ein Tool rechtmäßig ist, und das Nichtbestehen bedeutet nicht, dass es unrechtmäßig ist. Sie löst einen genaueren Blick aus.
- Wenden Sie sie in jeder Phase an. Testen Sie die gesamte Bestehensquote und zusätzlich jeden einzelnen Test, Grenzwert und jedes Band. Ein Test, der insgesamt unauffällig aussieht, kann den Schaden an einem Grenzwert bündeln.
- Adverse Impact wirft eine Validitätsfrage auf. Nach den technischen Standards werden Verfahren mit niedrigen Korrelationen, aber großem Adverse Impact genau geprüft, und Anwender sollten erwägen, ob andere Verfahren mit größerer oder gleicher Validität verfügbar sind (29 CFR 1607.14). In einfachen Worten: Wenn zwei Tools gleich gut vorhersagen und eines mehr Personen aus einer geschützten Gruppe aussortiert, nutzen Sie das andere.
Wo das rechtliche Risiko liegt
Arbeitgeber tragen die Haftung für Tools, die sie kaufen. Die folgenden Regeln sind auf hoher Ebene zusammengefasst und ändern sich oft, prüfen Sie den aktuellen Wortlaut daher mit Ihrer Rechtsberatung an jedem Ort, an dem Sie einstellen.
US-Bundesrecht gegen Diskriminierung. Die oben genannten Uniform Guidelines gelten für Auswahlverfahren allgemein, auch für KI-bewertete. Der Americans with Disabilities Act bringt ein eigenes Thema hinzu: Die Hinweise des Justizministeriums besagen, dass Online-Spiele und Persönlichkeitstests nur die berufsrelevanten Fähigkeiten messen dürfen, die sie messen sollen, nicht beeinträchtigte sensorische, manuelle oder sprachliche Fähigkeiten, und dass ein Arbeitgeber einen zugänglichen Test oder andere Anpassungen bereitstellen muss, wenn ein Test jemanden ausschließen würde, der die Arbeit leisten kann. Sie halten außerdem fest, dass der Arbeitgeber verantwortlich bleibt, wenn die diskriminierende Technologie von einem anderen Unternehmen stammt (ADA.gov AI guidance).
New York City. Das Local Law 144 erfasst automatisierte Einstellungsentscheidungs-Tools. Das Tool muss innerhalb eines Jahres vor dem Einsatz einem Bias-Audit unterzogen werden, Informationen zum Audit müssen öffentlich sein, und Kandidaten müssen eine Mitteilung erhalten. Die Stadt gibt an, dass die Mitteilung 10 Werktage vor dem Einsatz des Tools fällig ist, und sie begann die Durchsetzung am 5. Juli 2023 (NYC DCWP).
Illinois. Der Artificial Intelligence Video Interview Act, in Kraft seit dem 1. Januar 2020, verlangt von Arbeitgebern, die KI zur Analyse von Videointerviews einsetzen, eine Mitteilung, die Erklärung, wie die KI funktioniert und welche Merkmale sie bewertet, die vorherige Einwilligung des Bewerbers, die Begrenzung des Kreises, der das Video sieht, und die Vernichtung von Kopien innerhalb von 30 Tagen nach einem Antrag (Zusammenfassung von SHRM). Eine separate Änderung des Illinois Human Rights Act, in Kraft seit dem 1. Januar 2026, verbietet den Einsatz von KI bei Einstellungen und anderen Beschäftigungsentscheidungen in einer Weise, die geschützte Gruppen diskriminiert, verbietet die Postleitzahl als Stellvertreter für sie und verlangt eine Mitteilung an Beschäftigte (Crowell & Moring).
Europäische Union. Die Kommission stuft KI-Tools für Beschäftigung und Personalführung als Hochrisiko ein, mit Software zur Sortierung von Lebensläufen als Beispiel. Hochrisiko-Systeme unterliegen Pflichten zu Risikomanagement, Datenqualität, Protokollierung, Dokumentation und menschlicher Aufsicht, und für den Beschäftigungsbereich gelten diese ab dem 2. Dezember 2027 nach den Änderungen des AI Omnibus. Emotionserkennung am Arbeitsplatz ist seit Februar 2025 verboten (European Commission). Jeder Video-Eignungstest, der Emotionen aus Gesicht oder Stimme ableitet, ist daher für Einstellungen in der EU ein Problem.
Andere US-Bundesstaaten haben eigene oder geplante Regeln zu KI bei Einstellungen, und manche wurden wiederholt verschoben oder eingeschränkt. Betrachten Sie jede Compliance-Checkliste, auch diese, als Ausgangspunkt.
Praxisbeispiele nach Funktion
Dasselbe Testformat funktioniert je nach Stelle unterschiedlich.
- Kundensupport. Eine Simulation, in der der Kandidat drei realistische Tickets beantwortet, bewertet anhand eines Rasters für Genauigkeit, Tonfall und Richtlinienanwendung. Leicht mit der Stelle zu verbinden, leicht zu prüfen.
- Vertrieb. Ein auf Video aufgezeichnetes Rollenspiel, bewertet nach Inhalt (wurden Bedarfsfragen gestellt, wurde ein Einwand behandelt) statt nach Stimme oder Gesichtssignalen. Inhaltsbasiertes Scoring ist leichter zu erklären und zu verteidigen.
- Softwareentwicklung. Eine zeitlich begrenzte Programmieraufgabe, ausgewertet anhand von Testfällen, wobei ein Mensch die Begründung der Lösung prüft. Gut für Skills, stumm bei der Zusammenarbeit.
- Finanzen und Operations. Eine Tabellenaufgabe mit bekanntem Lösungsschlüssel und einigen Ermessensentscheidungen. Überwiegend Regeln, wenig KI, was ein Vorteil ist.
- Stellen mit Stundenlohn und hohem Volumen. Kurze Fragen zur situativen Urteilsfähigkeit und ein einfacher Skills-Check, genutzt, um Kandidaten in ein Gespräch zu leiten, nie um ohne Prüfung abzulehnen. Der Ansatz des skillbasierten Recruitings passt hierher, weil er sich auf das konzentriert, was eine Person kann, statt auf Abschlüsse.
So führen Sie einen KI-Eignungstest ein, Schritt für Schritt
- Gehen Sie von der Stelle aus. Schreiben Sie die 4 bis 6 kritischen Aufgaben und die dahinterstehenden Skills auf. Wenn Sie die Stelle nicht beschreiben können, können Sie keinen Test dafür validieren.
- Wählen Sie so wenig KI wie nötig. Bevorzugen Sie Arbeitsproben und Wissenstests, die an diese Aufgaben gebunden sind. Ergänzen Sie KI-Scoring nur dort, wo es klar Zeit spart, etwa beim Lesen offener Antworten.
- Verlangen Sie vom Anbieter Belege. Fordern Sie die Validierungsstudie an, die abgedeckten Stellenarten und Gruppen, die vom Modell genutzten Merkmale und das jüngste Bias-Audit mit Ergebnissen auf Gruppenebene. Gibt es keine Studie für eine vergleichbare Rolle, planen Sie eine lokale Validierung.
- Legen Sie die Rolle des Scores fest. Nutzen Sie ihn als eine Eingabe für eine strukturierte Entscheidung, nicht als automatische Hürde. Das ist die Praxis des Human-in-the-Loop-Designs, und Prüfer brauchen echte Befugnis, den Score zu übersteuern.
- Setzen Sie Grenzwerte vorsichtig. Höhere Grenzwerte erhöhen meist den Adverse Impact. Testen Sie die Wirkung jeder Schwelle vor dem Start.
- Planen Sie Anpassungen von Anfang an. Sagen Sie Kandidaten, was der Test ist und wie er bewertet wird, und geben Sie einen klaren Weg, ein alternatives Format zu beantragen.
- Führen Sie die Vier-Fünftel-Prüfung an echten Ergebnissen durch. Vergleichen Sie Bestehensquoten nach Gruppen für den Test und für den gesamten Funnel, nach Zeitplan und mit genug Volumen, um aussagekräftig zu sein.
- Erledigen Sie die rechtlichen Mitteilungen. Klären Sie Pflichten zu Mitteilung, Einwilligung und Audit für jeden Ort, an dem Sie einstellen, und bewahren Sie Nachweise zu Audit und Mitteilung auf.
- Prüfen und ausmustern. Prüfen Sie Validität und Wirkung mindestens jährlich und nach jeder Änderung an der Stelle oder am Modell erneut. Trennen Sie sich von Tools, die durchfallen.
Anbieteroptionen finden Sie in der Übersicht der besten Tools für Eignungstests vor der Einstellung. Wenn Sie auch entscheiden, wie KI Lebensläufe und Gespräche bewertet, lesen Sie KI-gestützte Lebenslauf-Vorauswahl und KI in Vorstellungsgesprächen.
Häufige Fallstricke
- „KI-gestützt“ als Beleg für Validität behandeln. Das Etikett sagt, wie der Score entsteht, nicht ob er etwas vorhersagt.
- Eigenschaftsspiele ohne Bezug zur Stelle nutzen. Wenn Sie nicht erklären können, warum eine Gedächtnis- oder Risikoaufgabe mit der Arbeit zusammenhängt, stellt eine Aufsichtsbehörde oder ein Kläger dieselbe Frage.
- Den Score Menschen automatisch ablehnen lassen. Automatische Ablehnung beseitigt die menschliche Kontrolle, auf die sich die meisten Rechtsrahmen stützen.
- Verzerrung nur einmal zum Start testen. Bewerberpools, Grenzwerte und Modelle ändern sich. Ein einmaliges Audit veraltet.
- Barrierefreiheit ignorieren. Zeitgebundene, visuell oder motorisch anspruchsvolle Aufgaben können Menschen aussortieren, die die Arbeit leisten könnten.
- Sich auf den Anbieter verlassen. Die Hinweise des Bundes zu Behinderung sind eindeutig, dass der Arbeitgeber, der das Tool nutzt, das Ergebnis verantwortet.
- Keine Erklärung für Kandidaten. Wenn niemand sagen kann, warum jemand schlecht abschnitt, können Sie es nicht verteidigen. Deshalb ist erklärbare KI bei der Auswahl wichtig, und deshalb gehört Bias in der KI in jedes Gespräch mit Anbietern.
Wie es weitergeht
Wählen Sie eine Rolle, schreiben Sie ihre kritischen Aufgaben auf und vergleichen Sie jeden Test, den Sie erwägen, damit, bevor Sie eine Demo sehen. Verlangen Sie dann die Validierungsstudie und die Ergebnisse zum Adverse Impact. Die vollständige Übersicht des Bereichs finden Sie im Hub KI im Recruiting, die Sicht auf die gesamte Funktion unter KI im Personalwesen.

Senior Customer Retention Strategist
On this page
- Wichtige Fakten
- Was als KI-gestützter Eignungstest vor der Einstellung gilt
- Wie das Scoring funktioniert
- Validität: Sagt der Score die Arbeitsleistung voraus?
- Adverse Impact und die Vier-Fünftel-Regel
- Wo das rechtliche Risiko liegt
- Praxisbeispiele nach Funktion
- So führen Sie einen KI-Eignungstest ein, Schritt für Schritt
- Häufige Fallstricke
- Wie es weitergeht