AI履歴書スクリーニング:仕組み、精度、バイアスのリスク
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
AI履歴書スクリーニングとは、各履歴書を読み取って構造化データ(役職、スキル、日付、学歴)に変換し、職務の要件に照らしてスコア化または順位づけすることで、採用担当者が最も適合度の高い応募者から確認できるようにするソフトウェアです。 応募数の多い職種では時間を節約できますが、与えられた基準と履歴をそのまま反映するだけです。どちらかが偏っていれば、順位づけも偏り、それが大規模に広がります。
本記事は、スクリーニングの導入を検討している、またはすでに導入していて何を確認すべきかを知りたい人事部長、タレントアクイジションの責任者、採用担当マネージャー向けです。仕組み、記録された失敗例、段階的な設定手順、安全策を取り上げます。AI for HRコレクションの採用セクションに位置づけられているため、採用全体の流れはAIによる採用活動から始めてください。これは一般的な情報であり、法的助言ではありません。
重要なポイント
- Amazonの実験的な採用エンジンは、候補者を1から5の星で評価し、10年間に提出された履歴書(大半は男性のもの)で学習し、「women's」という語を含む履歴書にペナルティを与えました。このチームは解散されました(Reuters、2018年10月)。
- ワシントン大学による3つの言語モデルのテストでは、550件以上の履歴書と500件以上の求人を比較したところ、白人に結びつく名前が85%の確率で好まれたのに対し、黒人に結びつく名前は9%でした。黒人男性に結びつく名前が、白人男性に結びつく名前より好まれたことは一度もありませんでした(University of Washington、2024年10月)。
- Harvard Business SchoolとAccentureの調査では、90%を超える雇用主が、中程度のスキルや高度なスキルを持つ候補者のフィルタリングや順位づけに採用システムを使っていると回答し、88%が、資格のある高度スキルの候補者が求人票の基準と完全には一致しないという理由でふるい落とされていることに同意しました(The Register、2021年のレポートの要約)。
- 米国連邦の「5分の4」ガイドラインでは、選考通過率が最も高いグループの80%を下回る場合、一般にアドバースインパクトの証拠とみなされます(29 CFR 1607.4)。
- 欧州委員会は、CVの仕分けソフトウェアを高リスクAIに分類しており、その規則は2027年12月2日から適用されます(European Commission)。
AI履歴書スクリーニングの仕組み
ほとんどのシステムは3つの段階で動き、どの段階での失敗も最終的な順位づけに影響します。
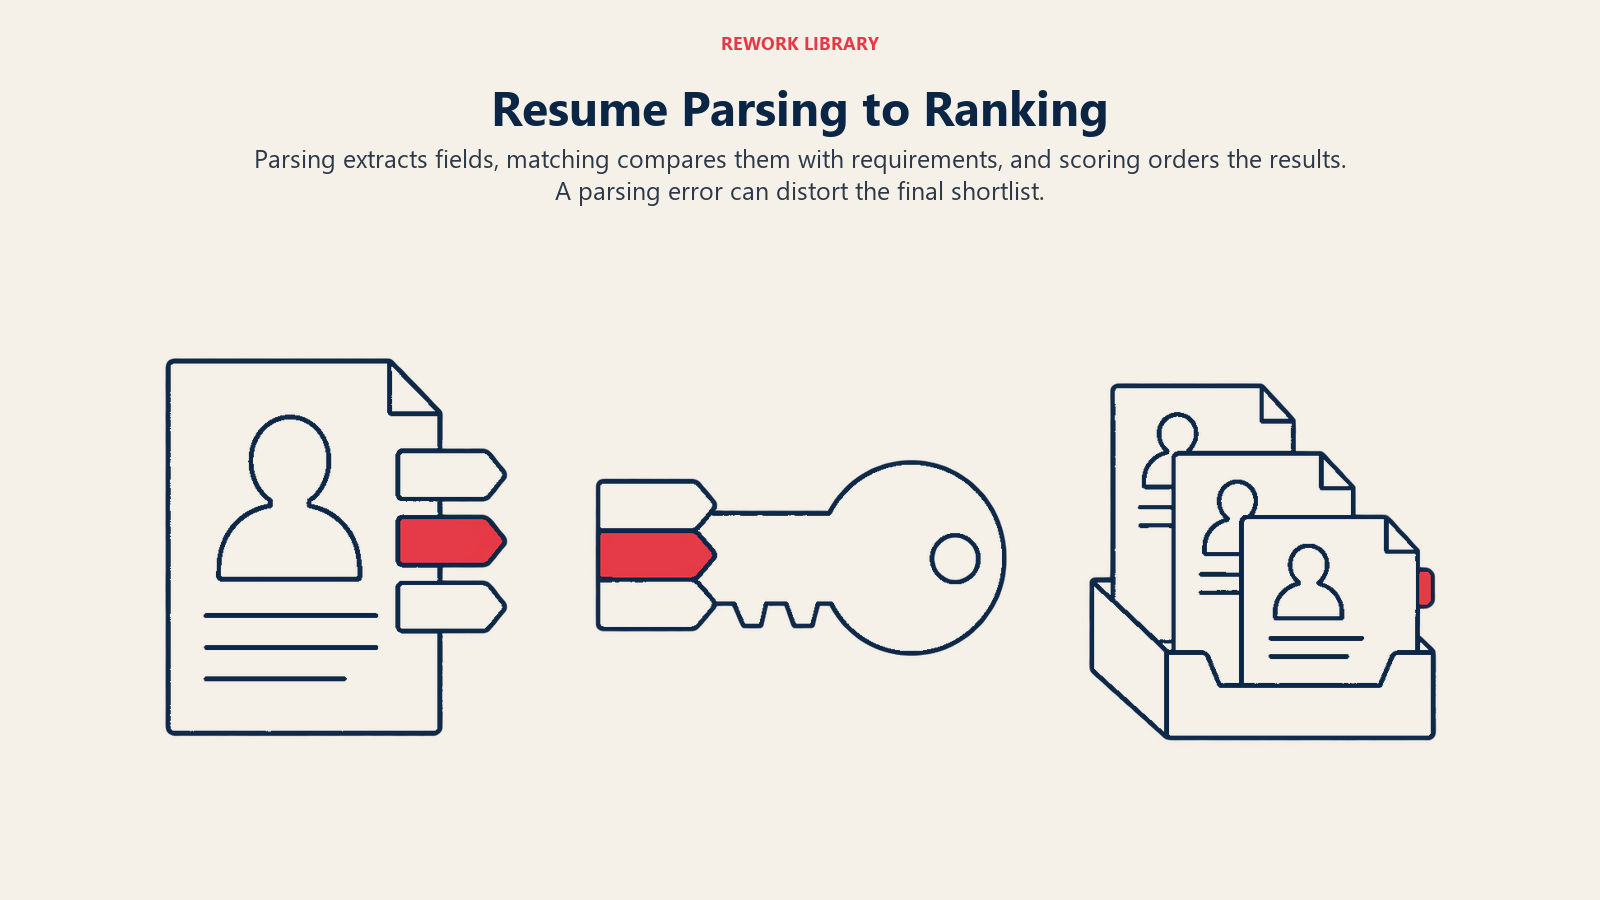
第1段階:解析。 ソフトウェアがPDF、Wordファイル、Webフォームからテキストを抽出し、氏名、勤務先、役職、日付、学歴、スキルといった項目に振り分けます。これはACE Frameworkの「Ingest」にあたる段階で、見た目以上に壊れやすい部分です。2段組みのレイアウト、画像内のテキスト、凝った書式、英語以外の文字によって項目が混乱し、優秀な候補者が中身のほとんどない記録として届くことがあります。
第2段階:マッチング。 システムが解析された記録を職務と照合します。従来のツールはキーワードで照合します。履歴書に「SQL」や「forecasting」が含まれているかどうか、という具合です。新しいツールは意味を読み取る言語モデルを使うため、「地域予算を管理した」という記述が、その語句がなくても「財務計画」に数えられることがあります。これが「Analyze」の段階です。
第3段階:スコア化と順位づけ。 システムはマッチ結果をスコア、評価、ショートリスト、または合否に変換します。自分で書いたルール(「営業職として2年以上」など)を使うものもあれば、過去の採用と不採用からパターンを学習するものもあります。後者は、意図せず履歴を学習してしまうおそれがあるタイプです。ACEの用語では、ドキュメントレビューのパターンが、スコアリング・ルーティングのパターンにつながっている状態です。
以下のすべてに共通する区別が1つあります。読み取って擁護できる基準を適用するスクリーニングと、過去の判断から独自の基準を推論するスクリーニングとでは、挙動がまったく異なります。 前者は監査できます。後者は、何を学習したのか誰も書き残していないため、テストが必要です。
記録された失敗例が示すもの
廃止されたAmazonの採用モデル
Reutersは2018年、Amazonの機械学習チームが2014年から履歴書審査ツールを開発してきたものの、2015年までに、ソフトウェア開発者などの技術職について性別に中立な評価をしていないことが判明したと報じました。モデルは、提出された10年分の履歴書(大半は男性のもの)から学習し、男性の候補者が望ましいと自ら学び取っていました。「women's chess club captain」のように「women's」という語を含む履歴書にペナルティを与え、女子大2校の卒業生を低く評価しました。Amazonはそれらの語に対して中立になるようプログラムを修正しましたが、この取り組みに詳しい人々は、システムが候補者を選別する別の差別的な方法を見つけないという保証にはならないと語りました。会社はチームを解散しました(Reuters)。
教訓は、AIが特別に偏っているということではありません。過去の採用を模倣するよう学習したモデルは、盲点も含めて過去の採用を模倣する、ということです。気づいた代理変数を1つ修正しても、他のものがなくなるわけではありません。AmazonはReutersに対し、このツールを採用担当者が候補者の評価に使ったことはないと述べましたが、採用担当者がその推奨を見ていたことは否定しませんでした。
言語モデルによる順位づけの名前バイアス
ワシントン大学の研究者は、3つの言語モデルを使い、9つの職種にわたる550件以上の実際の履歴書を500件以上の求人に照らして順位づけするテストを行いました。名前のみを変え、白人と黒人の男女に結びつく120の名前を使いました。300万件を超える比較の結果、白人に結びつく名前は85%、黒人に結びつく名前は9%の確率で好まれました。男性に結びつく名前は52%、女性に結びつく名前は11%の確率で好まれ、黒人男性に結びつく名前が白人男性に結びつく名前より好まれたことは一度もありませんでした(University of Washington)。
範囲には注意して読んでください。これは汎用モデルを対象にした統制された研究テストであり、市販のスクリーニング製品の監査ではありません。この結果が示すのは、ベンダーのモデルが中立だと決めつけるのではなく、自社の設定をテストすべき理由です。
優秀な候補者が静かに不採用になる
バイアスだけが精度の問題ではありません。Harvard Business SchoolとAccentureの「Hidden Workers」レポートは、調査対象の雇用主の90%超が採用システムで候補者をフィルタリングまたは順位づけしており、88%が、資格のある高度スキルの候補者が求人票の基準と完全には一致しないという理由で選別から漏れていることに同意したと報告しています。中程度のスキルの労働者では、この数字は94%でした(The Register)。レポートはまた、学位をある資質の代わりとみなす、職歴の空白を自動的に不採用にするといった、硬直した代理指標も指摘しています。これは自社で制御できる設計上の問題であり、スキルベース採用とも重なります。
職種別の実例
| 職種 | スクリーニングの対象 | 役立つ場面 | 機能しなくなる場面 |
|---|---|---|---|
| カスタマーサポート | 繁忙期チームへの数百人の応募者 | 語学力、シフトの可否、サポート経験で仕分けする | 役職名が合わない転職者に不利になる |
| ソフトウェアエンジニアリング | バックエンド職の応募者 | 役職名にとらわれず、関連するプロジェクトや言語を見つけ出す | 「過去の採用者に似ている」ことを学習し、均質なチームを再現しかねない |
| 営業 | エントリーレベルのSDR応募者 | ノルマを持った経験や顧客対応の経験を見つけ出す | 有名企業や有名大学を過大評価する |
| 経理・財務 | 経理スタッフの応募者 | 必要な資格やソフトウェアの経験を確実に確認する | 職歴に空白がある候補者を自動的に不採用にする |
| オペレーションと倉庫 | 1つの募集に対し多数の時給制応募者 | 応募資格に関する質問と勤務地を素早く確認する | 硬直した足切りの質問で、問題のなかったはずの人を落とす |
| 医療 | 看護師と関連職 | 免許や資格の項目を確認する | 標準的でない形式で記載された資格を見逃す |
パターンはこうです。スクリーニングは、検証できて職務に関連する要件(免許、資格、勤務地、勤務可能時間)で最もよく機能し、「カルチャーフィット」や「ポテンシャル」のような主観的または推論による判断では最も機能しません。
段階的な導入の進め方
- 購入前に、スクリーニングの役割を決めます。 最低限の要件を確認するだけにするのか、順位づけまで行うのかを書き出します。確認するだけの方が、順位づけよりはるかに擁護しやすくなります。
- 要件は、好みではなく基準として書きます。 必須条件(職務上、法的に必要な免許など)と、あればよい条件を分けます。必須条件と記したものは足切りになるため、そのリストは短く保ってください。基準を明確に保つ方法は、AIによる職務記述書の作成で扱っています。
- 入力を確認します。 解析の品質、一貫した役職名、整った応募者記録が出力を左右します。何から直すべきかは、AIのための人事データ基盤で説明しています。
- 可能な限り、読み取れるルールを選びます。 ベンダーには、システムが何をスコア化するのか、何で学習したのか、特定の候補者がなぜその順位になったのかを確認できるかどうかを尋ねてください。AI採用スクリーナーエージェントのページでは、適切に範囲を絞ったスクリーニングエージェントが何をし、何を人に引き継ぐかを紹介しています。
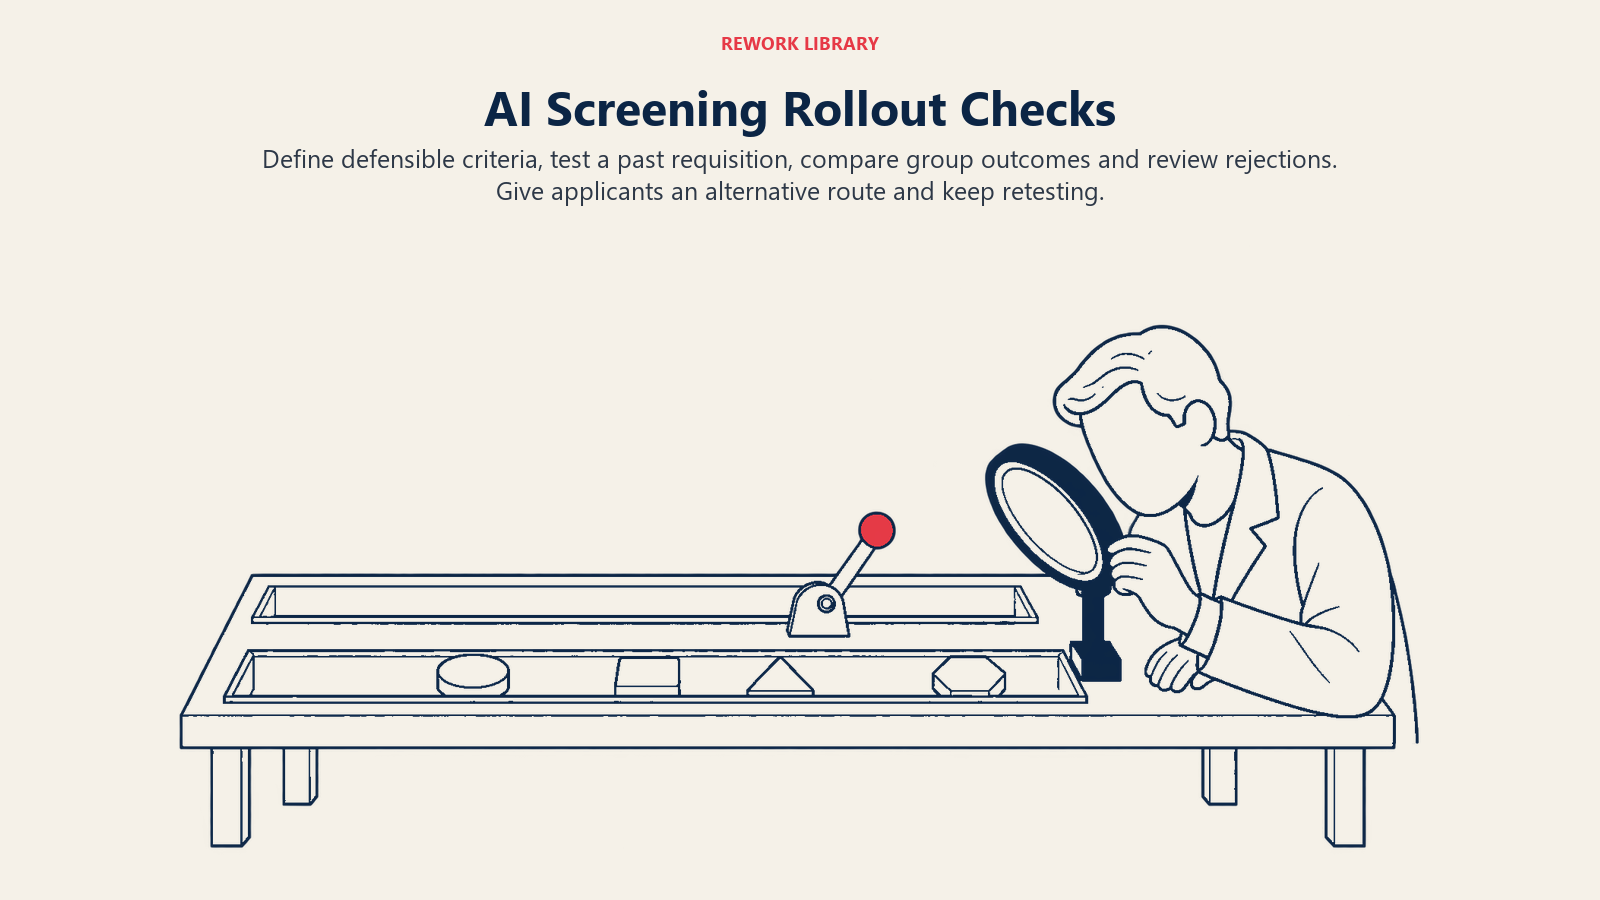
- 過去のデータでテストします。 すでに判断が済んだ過去の募集でスクリーニングを実行し、その出力を、実際に次の選考へ進んだ人や採用された人と比較します。
- グループごとに成果を測定します。 各段階でグループごとの選考通過率を計算し、最も高いグループの通過率と比較します。5分の4ガイドラインはスクリーニング上のシグナルであり、法的なセーフハーバーではありませんが、80%を下回る結果は調査を始める合図です(29 CFR 1607.4)。対象となる場合は、正式なバイアス監査も実施してください(次のセクションを参照)。
- 判断に人を残します。 足切りに基づくすべての不採用は採用担当者が確認し、「低評価」の山からも毎週ランダムに抽出して確認してください。ヒューマン・イン・ザ・ループの考え方が、設計の基準になります。
- 候補者に逃げ道を用意します。 自動化されたツールが関わっていることを応募者に伝え、代替の応募ルートや配慮の申請を提供してください。
- モニタリングと再テストを行います。 職務要件、応募者層、モデルは変化します。グループ比較は定期的に、また基準を変更するたびに再実行してください。
適用される規則
規制は地域によって異なり、急速に変化しています。採用を行う場所ごとに、最新の要件を弁護士に確認してください。
- ニューヨーク市。 Local Law 144は、雇用主と職業紹介事業者が自動化された雇用判断ツールを使用することを、使用前1年以内にバイアス監査を受けていること、監査の概要が公開されていること、使用の10営業日前に候補者へ通知されていることを条件としています。消費者・労働者保護局は2023年7月5日に執行を開始しました(NYC DCWP)。
- 欧州連合。 CVの仕分けソフトウェアなど、雇用に使われるAIシステムは高リスクに分類され、その規則は2027年12月2日から適用されます(European Commission)。
- 米国のその他の州。 いくつかの州が、雇用におけるAIに関する独自の法律を成立させたり施行を延期したりしており、成立後に改正されたものもあります。目にした日付は、頼りにする週に確認し直すべきものと考えてください。
- 既存の差別禁止法。 ソフトウェアを使っても、責任は移りません。差別的影響の原則は選考ツール全般に適用されるため、上記の5分の4の比較が標準的な最初のチェックです。
法域をまたいで機能するガバナンス体制としては、NISTのAI Risk Management Framework(2023年1月26日公表、任意)が、作業をGovern、Map、Measure、Manageに整理しています(NIST)。社内のスクリーニング方針の骨組みとして役立ちます。
実際に機能する安全策
安全策は、いくつもの層として考えてください。単独で十分なものはありません。
- 範囲を絞ります。 職務に関連し検証できる基準でスクリーニングしてください。氏名、写真、卒業年、住所のように、保護対象の属性の代理となる項目は、モデルが見る前に除外します。
- 説明可能な出力を優先します。 順位の理由が採用担当者に見えなければ、誤りに気づけません。説明可能なAIを参照してください。
- 導入前と定期的に監査します。 最終的な採用だけでなく、あらゆる段階で、グループ単位の選考通過率を確認します。
- 不採用を抜き打ちチェックします。 バイアスは、誰も読まない山の中に隠れています。
- 出口を守ります。 異議申し立ての経路と、代替の応募ルートを用意します。
- 判断に責任を持ちます。 不利な結果はすべて、名前の決まった担当者が承認します。経営陣に説明する必要がある場合は、AIにおけるバイアスが偏りの発生源を解説しています。
よくある落とし穴
- 「ベンダーの監査に合格した」を「自社でも安全」と取り違えること。 監査は、特定のデータに対するツールを対象にしたものです。自社の職種群と応募者層は異なります。
- 順位を過信すること。 採用担当者は上位10人を読み、残りは無視します。そのためアルゴリズムの順序が、そのまま決定になってしまいます。
- 代理変数を1つ直しただけで、バイアスの見直しを済ませたことにすること。 Amazonのように偏った語を1つ取り除いても、相関する他のシグナルが同じ働きを続けることは防げません。
- 自社の履歴で学習させること。 過去の採用が1つのプロフィールに偏っていれば、そこから学習するモデルも同じ偏りを持ちます。
- 見直しのない足切りの質問。 職歴の空白や学位を理由とした自動不採用は、資格のある人が消えていく場所です。
- 候補者への通知を省くこと。 一部の法域では、それだけで違反になります。
- 再テストをしないこと。 導入時には問題のなかったスクリーニングも、要件の変化とともにドリフトすることがあります。

Senior Customer Retention Strategist