AIによる従業員の離職予測:シグナル、モデル、倫理
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
従業員の離職予測とは、機械学習を使って、人事データや業務データから、各従業員やチームが一定期間内に退職する可能性を推定し、退職届が出される前にマネージャーが原因に手を打てるようにすることです。 出力は通常、確率またはリスクの区分です。これは予報であって判決ではなく、どのモデルが出力するかよりも、それをどう使うかのほうが重要です。
本記事は、「離職リスク」のダッシュボードを提案されている、あるいは自社で構築を検討している人事責任者、ピープルアナリティクスの担当者、マネージャー向けです。モデルの仕組み、モデルが頼りにするシグナル、見出しの数字が示すよりも精度に限界がある理由、スコアを誰かが目にする前に引いておくべき倫理上の線について扱います。AI in HRのセクションに属し、ピープルアナリティクスとAIを土台にしています。
重要なポイント
- 米国の雇用主では、2026年8月に310万人の自己都合退職があり、その月の退職率は1.9%でした(BLS JOLTS)。ある1か月に退職することはまれな出来事であり、だからこそ予測は難しいのです。
- Expert Systems with Applications に掲載された2024年の系統的レビューは、2012年から2023年4月までに発表された52件の研究を対象とし、20種類を超える機械学習の手法が使われていることを確認して、給与と残業が最も重要な予測因子であると報告しています(Expert Systems with Applications, via UAEU)。
- 2019年のカンピナス大学の研究は、ブラジルの実在の飲料会社の従業員8,724人の記録で分類器を学習させ、テストデータで全体の精度79%を報告しました(UNICAMP)。
- GDPR第22条のもとでは、プロファイリングを含む自動処理のみに基づいて重大な影響を及ぼす決定の対象とされない権利が個人にあり、管理者は少なくとも人による介入と異議を申し立てる手段を提供しなければなりません(EUR-Lex)。
- 欧州委員会は、雇用と労働者管理のためのAIツールを高リスクに挙げており、その規則は2027年12月2日から適用されます。また、職場での感情認識は禁止される行為に挙げられています(European Commission)。
離職予測モデルの仕組み
ACE Frameworkの用語でいえば、離職予測モデルは構造化された人事データをIngestし、誰が残り誰が辞めたかの履歴をAnalyzeし、まだ辞めていない人についての確率をPredictします。これは、自社の従業員に向けたスコアリングのパターンであり、チームの突然の変化を抽出する異常検知の層が加わることもよくあります。
その仕組みは、簡単に説明できます。
- 期間を決めます。 「この人は退職するか」よりも、「この人は今後6か月以内に退職するか」のほうが、明確な問いです。
- 履歴を構築します。 過去のスナップショットごとに、その時点で本人について把握していた情報と、その後の期間内に退職したかどうかを記録します。
- 学習させます。 モデルは、スナップショット内のどのパターンが退職に先立つ傾向があったかを学習します。一般的な手法は、ロジスティック回帰、決定木、ランダムフォレスト、勾配ブースティング木です。より新しい研究では、キャリア履歴に対するディープラーニングを使っており、たとえば2025年1月のarXiv論文は、実世界のデータセットを使って複数企業にまたがる離職を予測しています(arXiv)。
- 現在の従業員をスコア化します。 在籍中の全員に確率が付与されます。
- 説明します。 有用なシステムは、どの要因がスコアを押し上げたかも示すので、人がその理由が実在し、対処できるものかを判断できます。これが説明可能なAIの考え方です。
2つの枠組みの点を押さえておくと、多くの混乱を避けられます。第一に、これは小規模で偏りのあるデータセットに対する予測分析であり、クリックや購入の予測とはまったく異なる挙動をします。第二に、予測が記述するのは相関です。モデルは、3年間昇進していない人がよく辞めることを学習できても、昇進していれば引き留められたかどうかは教えてくれません。
よく使われる予測シグナル
ほとんどのモデルは、いくつかのデータの系統に基づいています。表は、それらを有用性と機微性の傾向別にまとめたものです。
| シグナルの系統 | 例 | 退職を予測する理由 | 機微性 |
|---|---|---|---|
| 報酬 | 市場と比べた給与、前回の昇給からの期間、賞与の変更 | 給与の差が、転職先を探す理由になります | 中 |
| 業務量 | 残業時間、取得した休暇、シフトの変動 | 慢性的な過負荷は、バーンアウトと退職に先行します | 中 |
| キャリアの動き | 現職の在任期間、昇進、社内異動、スキルの成長 | キャリアが停滞すると、人は外へ向かいます | 低 |
| マネージャーとチーム | マネージャーの交代、チームの退職履歴、管理するスパン | 退職は特定のマネージャーの周辺に集中します | 中 |
| 勤続年数とライフステージ | 勤続年数の区分、通勤距離、年齢 | 退職率はステージによって異なります | 高(保護対象の属性の代理になりえます) |
| エンゲージメント | サーベイのスコア、回答率、コメントのテーマ | 意欲の低下が先に表れる傾向があります | 中 |
| 行動とデジタル | メールやカレンダーのパターン、入退室データ、求人サイトでの活動 | 離脱の兆候を反映しますが、侵襲的です | 非常に高 |
2024年のレビューに含まれる研究は、給与と残業が最も強い要因だと指摘しており、これは直感に合います。これらは確実に記録され、時間とともに変化し、実際の退職理由とつながっているからです。表の下のほうのシグナルは、最も慎重に扱うべきものです。年齢や通勤距離は、保護対象の属性の代理を静かに務めることがあります。メッセージのパターンや閲覧履歴のようなデジタルの痕跡は、不正確であるうえに信頼を損ない、EUでは職場での感情の推測は明確に禁止されています。
モデルに与える入力として現実的なものを知りたい場合は、AIのためのHRデータの基盤から始めてください。離職予測の失敗したプロジェクトの多くは、アルゴリズムではなく、データ品質でつまずきます。
理解しておくべき精度の限界
ベンダーが「精度90%」と言っても、それが伝える情報はごくわずかです。その理由を説明します。
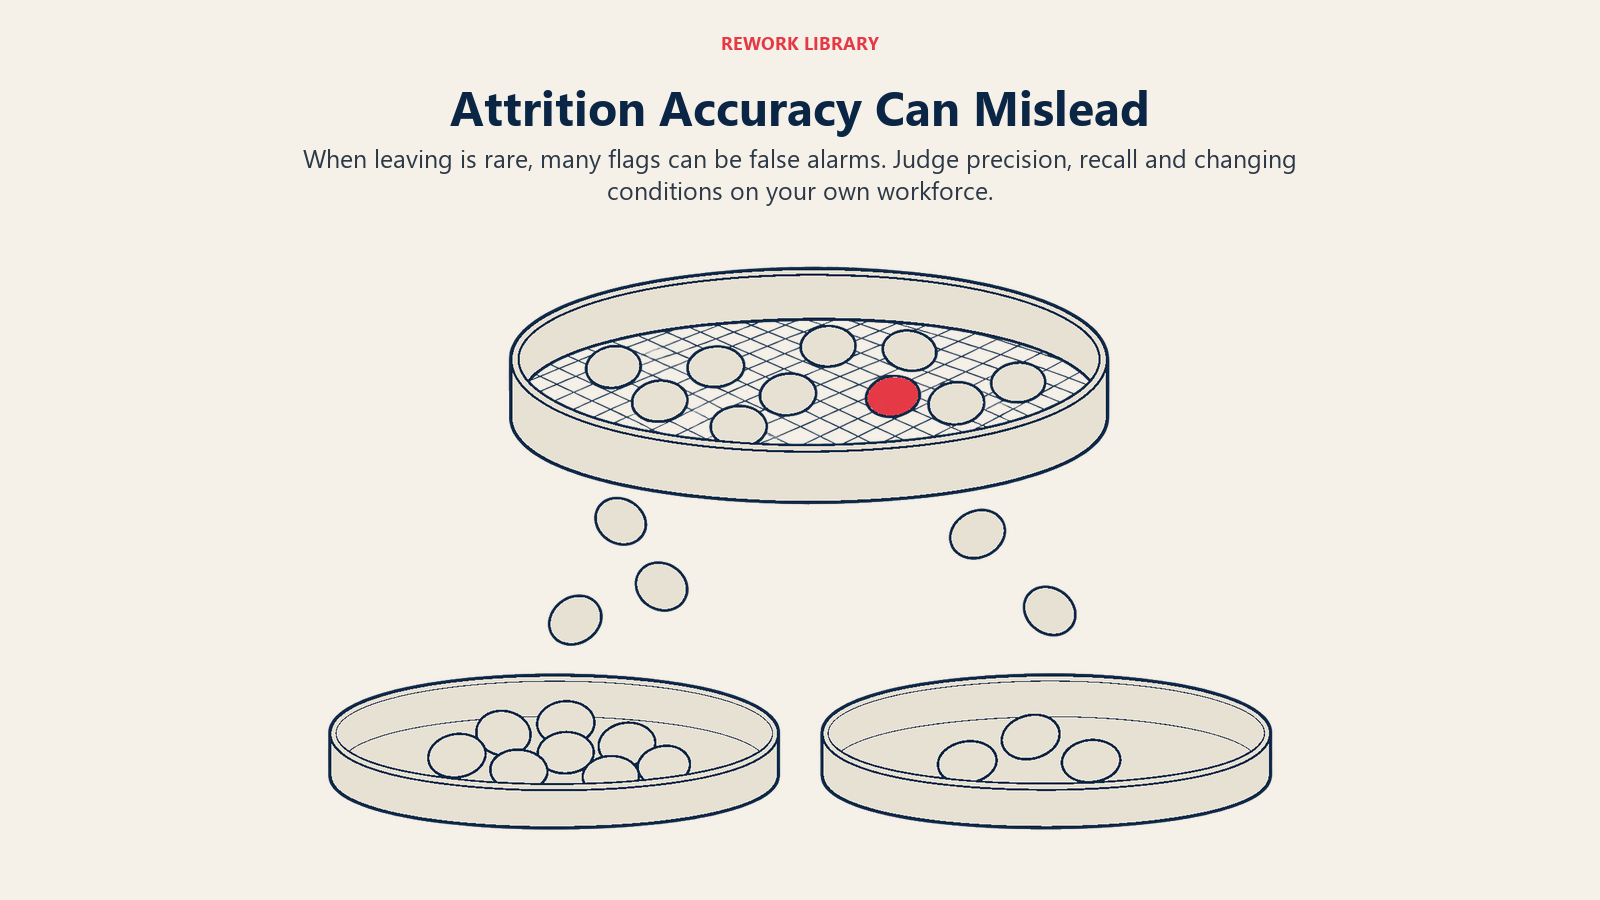
退職はまれなので、精度は実態よりよく見えます。 BLSは2026年8月の退職率を1.9%と報告しました。1年間で見ても、ほとんどの従業員は残ります。「全員が残る」と予測するモデルは、大半の場合に当たりますが、役には立ちません。精度は、退職者を重視する指標に置き換える必要があります。適合率(抽出した人のうち何人が辞めたか)、再現率(辞めた人のうち何人を抽出できたか)、AUCです。
当たりよりも空振りのほうが多くなります。 以下は仮定の例であり、測定結果ではありません。従業員1,000人のうち、今年150人が退職するとします。優れたモデルが150人のうち105人を捉え(再現率70%)、残る850人のうち170人を誤って抽出する(空振り20%)とします。抽出された人は275人で、そのうち実際に辞めるのは105人、約38%にすぎません。そのリストを見ているマネージャーは、大半が残ったはずの人を見ていることになります。
公表された数字は、そのまま持ち込めません。 ブラジルの飲料会社の研究は、実際の従業員8,724人で全体の精度79%を報告しました。ある1社、ある期間、ある項目の組み合わせでの結果が、別の場面にそのまま当てはまることはまれです。公表された研究のなかには合成のサンプル人事ファイルで構築されたものもあり、実際の従業員についてはほとんど何も語りません。どのモデルも、自社の履歴で判断してください。
世界は変わります。 組織再編、給与の凍結、採用ブームの前に学習したモデルは、現在の従業員とは別の従業員を学習しています。スコアはずれていき、誰も再テストしないモデルは、精度が落ちながらも権威があるように見え続けます。
予測は因果ではありません。 優れたスコアでも、どこを見るべきかを示すだけです。原因は、人と話すことで見つかります。
職種別の実例
HRビジネスパートナー。 パートナーは、四半期ごとに、個人のスコアではなくチームレベルのリスクを確認します。あるエンジニアリング部門で、残業が多く、2年間昇進がない状況から、リスクが高く出ています。パートナーは、特定の個人を名指しせず、業務量とキャリアパスの問題としてディレクターに提起します。
現場オペレーションのマネージャー。 シフト制の拠点では、シフトの変動と未払い残業のパターンが退職を予測します。マネージャーは、勤務表を見直し、連続する遅番に上限を設けます。このモデルの価値は、どの従業員でもなく、勤務表の作成プロセスを指し示したことにありました。
報酬チーム。 市場の給与が動いた職種で、最後の昇給から長く経過した人を、モデルが繰り返し抽出します。報酬チームはこれを使って、的を絞った給与見直しを実施します。これは明確で、わかりやすい根拠のある、正当化しやすい対応です。
営業部門のリーダー。 営業ディレクターに、2四半期連続でクォータを達成できないセールスは、より高い率で退職すると示されます。対応は、本人への警告ではなく、早い段階でのコーチングとテリトリーの見直しです。
法務とプライバシー。 顧問弁護士が、どのデータを合法的に使えるか、従業員にどのような通知を行うか、データ保護影響評価が必要かを確認します。このチームは、パイロット導入の後ではなく、前に議論の場にいるべきです。
離職リスクのスコアに基づく対応の倫理
スコアは、本人が提供しておらず、存在すら知らないかもしれない、その人に関する新しい種類の情報を生み出します。それをどう扱うかが、本当の試金石です。
人に関する決定に使わせないでください。 どうせ辞める人だからという理屈で、リスクスコアを理由に昇進、プロジェクト、研修、昇給の機会を減らしてはいけません。それでは予測が自己成就してしまいます。違法となる可能性もあります。GDPR第22条は、重大な影響を及ぼす、自動処理のみに基づく決定を制限しており、EU AI法は雇用に関するAIを高リスクとして扱っています。米国やそのほかの地域で事業を行う場合は、規則が異なり、変わり続けているため、法域ごとに法的助言を得てください。
個人を監視するためではなく、条件を改善するためにスコアを使ってください。 最も倫理的な使い方は、モデルが浮かび上がらせた原因を直すことです。給与の差、過負荷、閉ざされたキャリア、問題のあるマネージャーなどです。最も非倫理的な使い方は、特定の個人が「リスクあり」だとマネージャーにこっそり伝え、その人を管理させることです。
スコアは、初期設定ではライン管理職に見せないでください。 チームや部門レベルの集計ビューなら、ラベル付けをせずに洞察が得られます。個人のスコアを使わざるをえない場合は、閲覧できる人を限定し、理由を記録し、予定を決めて削除します。
バイアスを確認してください。 許されている場合は、性別、年齢、人種、障害、介護の状況で定義したグループ間で、モデルの誤りを比較します。育児休業の前後で退職が多いという履歴があるために、30代の女性を過剰に抽出するモデルは、真実ではなく、パターンを符号化しています。この概念はAIにおけるバイアスで説明しています。
オープンにしてください。 どのデータを使い、何のために使うのかを従業員に伝えます。秘密のスコアリングは、ほとんどの離職よりも早く、信頼を損ないます。
行動の監視には近づかないでください。 メッセージの閲覧、閲覧履歴の追跡、気分の推測によって「離脱」を見つけようとするのは、侵襲的で、誤りが多く、EUでの感情認識は禁止されています。人を詳細に見張らなければならないシグナルは、間違ったシグナルです。
離職予測を導入する手順:ステップごとに
- まず意思決定を定義します。 リスクがどこに集中しているかがわかったら、何を変えるかを書き出します。答えが「何もしない」なら、構築しないでください。
- 安価な代替手段から始めます。 退職データ、退職面談のテーマ、エンゲージメントのスコア、マネージャー別および勤続年数の区分別の退職率を確認します。多くの組織は、モデルを使わずに主要な要因を見つけています。
- データを監査します。 少なくとも数年分にわたって、採用、退職(自己都合と会社都合を分けたもの)、給与履歴、役割の変更、マネージャーの割り当ての一貫した記録があることを確認します。会社都合の退職は、目的変数から除外します。
- 範囲をチームレベルに設定します。 出力は集計すること、誰が何を見られるか、どの対応が範囲内かを決めます。
- 機能する最もシンプルなモデルを選びます。 説明付きのロジスティック回帰か木構造モデルで、通常は十分です。「勤続年数の区分と給与の位置」のような基本的なベースラインと比較してください。
- 正直にテストします。 古いデータで学習させ、直近の期間でテストします。精度だけでなく、適合率、再現率、AUCを報告し、グループ間で誤りを確認します。
- プライバシーの対応を行います。 適法性の根拠を文書化し、必要な場合は影響評価を実施し、従業員に伝えます。
- 人によるレビューのループを設けてパイロット導入します。 人事がマネージャーと同席し、要因が自分たちの見ているものと合っているかを尋ねます。モデルが誤ったケースを記録してください。
- モデルではなく、施策を測定します。 目的は、惜しまれる退職を減らすことです。対応を実施したチームとしていないチームを比較し、給与の見直しや業務量の変更といった対応が成果を動かしたかどうかを追跡します。
- 予定を決めて再テストします。 少なくとも年に1回、そして大きな組織変更の後に再評価します。
これが従業員のジャーニー全体にどう収まるかは、従業員ライフサイクル全体のAIをご覧ください。また、これを導入した人事部門で誰が何を担うかは、AIと人事オペレーティングモデルをご覧ください。
よくある落とし穴
- 見出しの精度の数字だけで購入する。 適合率、再現率、使用したデータ、テストの方法を求めてください。
- データを直す前に予測する。 退職理由のコーディング(自己都合、会社都合、定年)が乱れていると、目的変数が台無しになります。
- チーム単位で足りるのに個人をスコア化する。 個人へのラベル付けは、リスクを増やすだけで、洞察はほとんど増えません。
- モデルを隠す。 秘密のスコアリングを従業員が知ったら、そのダメージはどんな利益も上回ります。
- スコアを原因とみなす。 モデルが示すのは、どこを見るべきかです。理由は、人が教えてくれます。
- 高いスコアにだけ対応する。 優秀な人のなかには、低いスコアのまま静かに辞める人もいれば、抽出されても完全に落ち着いている人もいます。
- 再テストをしない。 古くなったモデルは、自信満々に間違えます。
AIによる従業員の離職予測に関するよくある質問
従業員の離職予測とは何ですか?
給与、業務量、勤続年数、昇進、マネージャーの履歴といった人事データに基づき、機械学習を使って、従業員やチームが一定期間内に退職する可能性を推定することです。出力は確率またはリスクの区分で、人事が対処可能な原因をどこで探すかを判断するのに役立ちます。
離職予測モデルはどのくらい正確ですか?
データに大きく左右されます。ブラジルの実在の飲料会社の従業員8,724人を対象とした公表済みの研究は全体の精度79%を報告しましたが、ほかのデータセットでは結果が異なります。退職はまれなので、精度だけでは誤解を招きます。自社の履歴で測定した適合率、再現率、AUCを求めてください。
どのデータが退職者を予測しますか?
52件の研究を対象とした2024年のレビュー全体で、給与と残業が最も強い要因です。キャリアの動き、マネージャーの交代、チームの退職履歴、エンゲージメントのスコアも役立ちます。年齢の代理、メッセージの内容、閲覧履歴のような機微なデータや侵襲的なデータは、確かな利得がほとんどないままリスクを増やします。
どの従業員が辞めるかを予測することは合法ですか?
条件付きで合法であることが多いです。EUでは、GDPR第22条が、重大な影響を及ぼす自動処理のみに基づく決定を制限しており、AI法は雇用に関するAIを高リスクに分類し、その規則を2027年12月2日から適用します。規則は国によって異なるため、顧問弁護士を関与させ、個人に関するあらゆる決定には人が関わる形を保ってください。
マネージャーに個人の離職リスクのスコアを見せるべきですか?
初期設定では、見せるべきではありません。チームレベルのビューなら、誰にもラベルを付けずに洞察が得られますが、個人のスコアは、マネージャーがその人をすでに辞めたものとして扱うことを誘発します。個人のスコアを使わざるをえない場合は、アクセスを制限し、目的を文書化し、昇給、プロジェクト、昇進を見送るために使うことは決してしないでください。
モデルがチームを抽出したら、どうすべきですか?
調査のきっかけとして扱ってください。給与の位置、残業、昇進履歴、マネージャーの交代を確認し、チームと話し、変えられるものを変えます。そのうえで、退職が減るかどうかを測定してください。価値はスコアではなく、施策にあるからです。

Senior Customer Retention Strategist