Segurança psicológica em equipes com AI: seguro para questionar, seguro para dizer não
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
A segurança psicológica em equipes com AI é o conceito original de Amy Edmondson, a crença compartilhada de que a equipe é segura para assumir riscos interpessoais, estendido a um novo conjunto de riscos que só existem quando a AI faz parte do trabalho. Significa que as pessoas se sentem seguras para questionar o resultado de um agente, admitir que usaram AI em uma tarefa, sinalizar um erro da AI ou rejeitar sua recomendação, e dizer com todas as letras "eu não confio neste resultado", sem que nada disso lhes custe status, credibilidade ou uma marca negativa ao lado do nome.
Edmondson construiu a carreira estudando por que as pessoas ficam em silêncio em hospitais, cabines de avião e salas de diretoria mesmo quando falar salvaria uma vida ou um projeto. O mecanismo que ela encontrou, o de que o silêncio é uma resposta racional a uma sala que pune o risco, se transfere quase intacto para a AI. Antes, ninguém precisava de permissão para desconfiar de uma planilha. Hoje, uma parcela crescente da força de trabalho precisa exatamente dessa permissão, e a maioria das equipes nunca a concedeu em voz alta. Este artigo cobre o que há de realmente novo na segurança em equipes de humanos e AI, por que o viés de automação e a deferência excessiva são o modo de falha que aparece quando ela falta, pesquisas reais sobre por que as pessoas param de perguntar "por quê" e o que os líderes fazem para reconstruí-la.
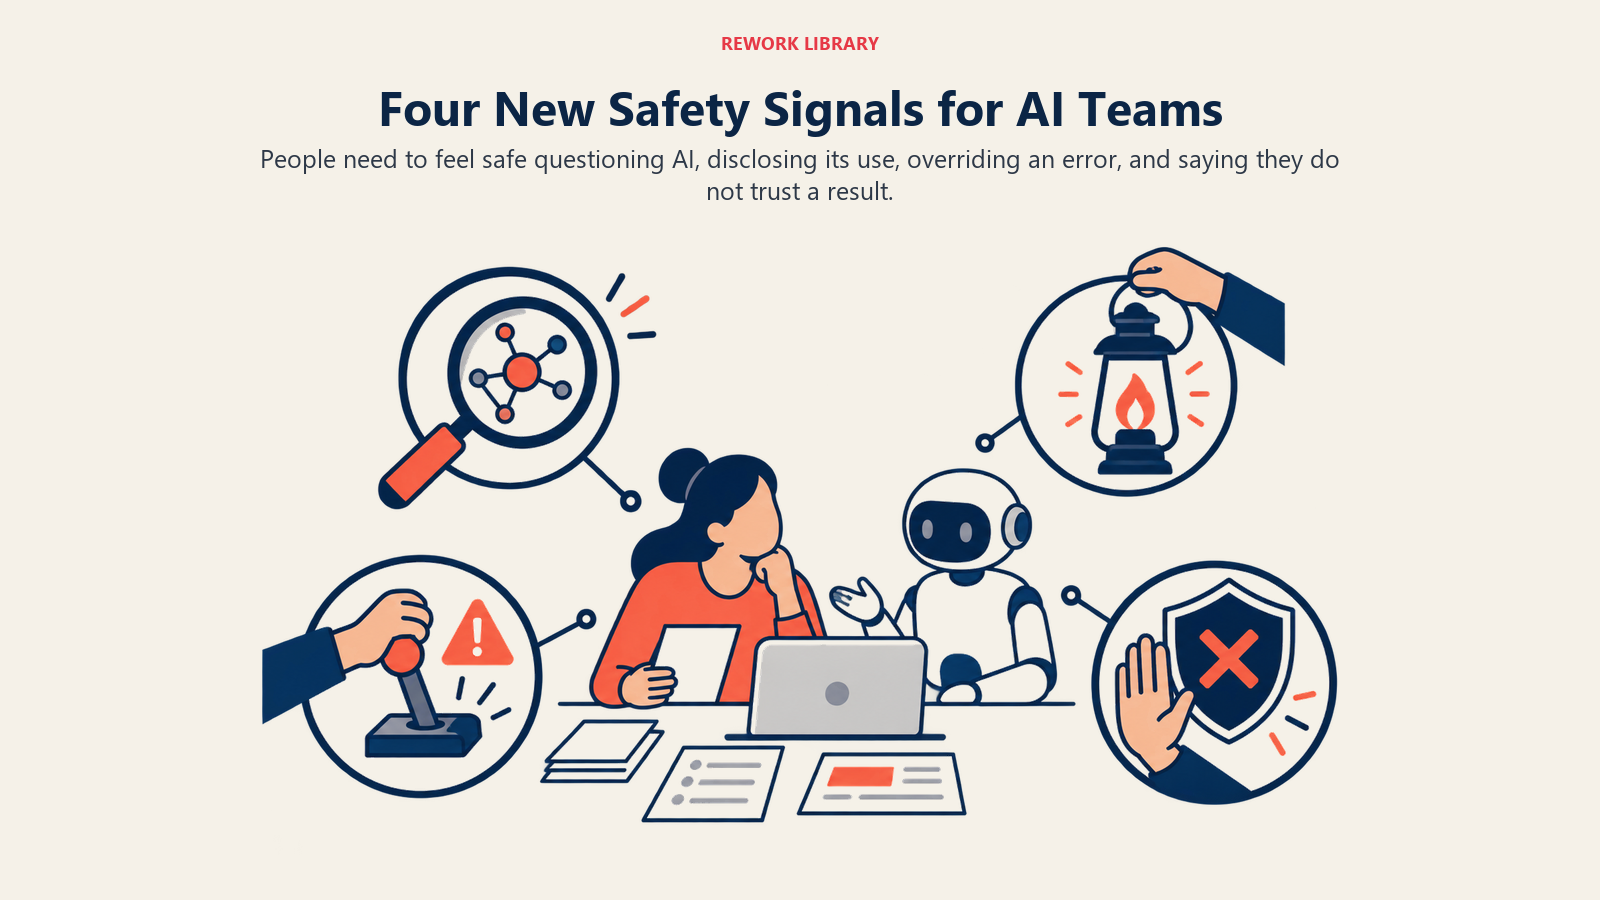
Estendendo o modelo de Edmondson: quatro coisas novas que as pessoas precisam se sentir seguras para dizer
O modelo original de quatro etapas de Edmondson, segurança de inclusão, do aprendiz, do contribuidor e do questionador, foi construído em torno de interações entre pessoas. Cobrimos esse modelo completo em segurança psicológica no trabalho. Quando um agente de AI passa a ser uma parte atuante da equipe, e não uma ferramenta que alguém usa discretamente por conta própria, as mesmas quatro etapas precisam se esticar para cobrir um novo conjunto de momentos que Edmondson nunca precisou modelar em 1999, porque aquilo que era questionado sempre foi um colega.
Seguro para questionar o resultado da AI
Alguém olha para o que um agente produziu e tem a sensação incômoda de que algo está errado: um número que não bate com a intuição, uma citação que parece limpa demais, uma etapa que esperaria que uma pessoa sinalizasse. A segurança do questionador, no modelo de Edmondson, é a etapa em que as pessoas se sentem livres para questionar o plano ou quem está no comando. A versão dessa etapa para equipes com AI é questionar a máquina, e isso tem um custo social diferente: ninguém fica mal por duvidar da ideia de um colega do mesmo jeito que pode parecer lento ou paranoico ao reavaliar um sistema que "todos os outros" parecem aceitar sem comentar.
Seguro para admitir que você usou AI
Este item fica mais perto da segurança de inclusão e do aprendiz. Usar AI em um rascunho, em um resumo ou em uma análise não é uma confissão, mas é tratado como uma em muitas equipes, porque ninguém disse em voz alta que não é. Quem esconde o uso de AI não está mentindo por malícia; está lendo a sala corretamente se a sala nunca fez a divulgação parecer segura. Esse silêncio tem um custo direto: o gestor perde a visibilidade de como o trabalho foi de fato produzido, o que significa que não consegue detectar justamente o modo de falha de que este artigo trata.
Seguro para sinalizar um erro da AI ou rejeitar sua recomendação
Um agente erra, ou uma pessoa rejeita o que ele recomendou e faz algo diferente. Os dois são momentos de segurança do contribuidor, usar o próprio julgamento e vê-lo valer, mas agora envolvem contrariar um sistema que foi adquirido, configurado e provavelmente defendido por alguém sênior. Sinalizar o erro de uma pessoa arrisca uma conversa constrangedora. Sinalizar ou rejeitar o erro de um sistema arrisca parecer que você não confia no investimento que a empresa acabou de fazer, um tipo de risco diferente, e muitas vezes mais pesado, de carregar sozinho.
Seguro para dizer "eu não confio neste resultado"
Esta é a frase que mais importa, e a que a maioria das equipes tem menos prática em dizer. Não é uma afirmação técnica sobre precisão; é uma declaração de incerteza vinda de alguém que deveria parecer competente e decidido. Dizê-la sobre o trabalho de um colega é desconfortável, mas é terreno conhecido. Dizê-la sobre um sistema que produziu uma resposta rápida, fluente e com ar profissional, sem que mais ninguém na sala objete, é o risco interpessoal genuinamente novo que dá nome a este artigo.
Viés de automação e deferência excessiva: o novo modo de falha
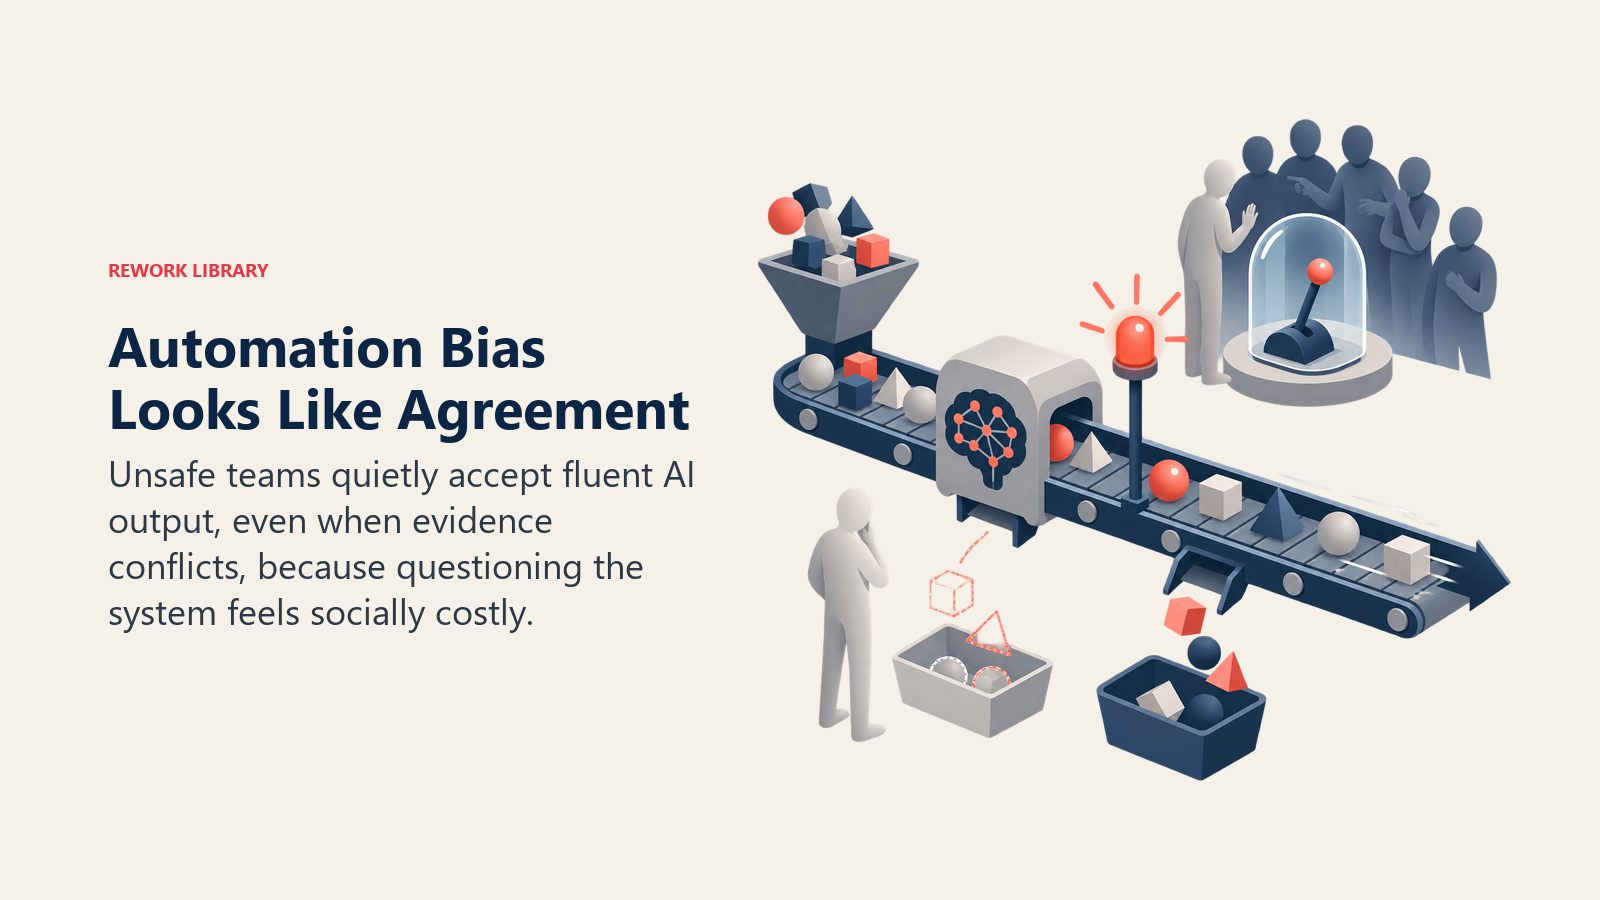
Eis a parte que a maioria dos conselhos sobre segurança psicológica ignora por completo. Quando uma equipe não se sente segura em relação à AI, a falha não se parece com conflito. Ela se parece com concordância. Todos assentem, o resultado é entregue e a equipe parece perfeitamente alinhada até o momento em que o erro aparece em algum lugar caro.
O que o viés de automação realmente é
Os pesquisadores Linda Skitka, Kathleen Mosier e Malcolm Burdick deram nome a esse padrão em um estudo de 1999 que ainda é a citação de referência na área: viés de automação, a tendência de aceitar o resultado de um sistema automatizado como substituto da checagem vigilante que a pessoa faria por conta própria. A pesquisa deles, realizada em uma tarefa simulada de monitoramento de voo, encontrou algo específico o bastante para importar aqui: as pessoas cometiam dois tipos distintos de erro. Erros de omissão, deixar de notar um problema porque o sistema automatizado não o sinalizou. E erros de comissão, seguir ativamente uma recomendação automatizada mesmo quando outras informações disponíveis sugeriam que ela estava errada. Fonte: Skitka, Mosier & Burdick, "Does Automation Bias Decision-Making?"
Essa segunda categoria é a importante para uma conversa sobre cultura. Um erro de comissão não é um acidente. É uma pessoa escolhendo a resposta automatizada em vez do próprio julgamento, naquele momento, muitas vezes com outros sinais bem diante dos olhos. Isso não é uma lacuna de treinamento. É uma decisão moldada pelo que a sala ao redor dessa pessoa torna confortável dizer e fazer.
Por que a segurança psicológica é a variável que falta
A maior parte dos textos sobre viés de automação o trata como uma falha cognitiva individual, algo a ser corrigido com uma interface melhor ou um módulo de treinamento. Esse enquadramento ignora por completo o mecanismo no nível da equipe. Um erro de comissão é mais fácil de cometer justamente quando questionar o sistema parece socialmente custoso e ficar em silêncio parece gratuito. Inverta o incentivo e a mesma pessoa, com a mesma estrutura cognitiva, se comporta de outra forma. A descoberta do laboratório de Skitka e a pesquisa de campo de Edmondson descrevem o mesmo formato por dois ângulos: o viés de automação mostra que as pessoas adotam a aceitação como padrão sob incerteza, e a segurança psicológica mostra o que torna falar sob incerteza custoso ou gratuito. A deferência excessiva à AI não é um novo tipo de falha humana. É a mais antiga de Edmondson, uma equipe que pune a voz e premia o silêncio, com uma interface nova.
O estudo dos analistas de crédito: quando não perguntar "por quê" é o ponto
Um estudo de 2026 liderado por Alex Chan, da Harvard Business School, põe números reais no quanto esse silêncio pode ser deliberado. Os pesquisadores pediram a 2.512 participantes online que atuassem como analistas de crédito, revisando pares de pedidos reais de empréstimo de $10.000, com um sistema de AI fornecendo uma pontuação de risco para cada um. Oitenta por cento dos participantes quiseram ver a pontuação de risco da AI, mas apenas 46% foram além e pediram para ver a explicação por trás dela, mesmo estando a um clique de distância. Quando os pesquisadores atribuíram aleatoriamente a alguns participantes um bônus financeiro atrelado ao desempenho real do empréstimo, em vez de um valor fixo, a recusa em ver a explicação subiu 20 pontos percentuais, e essa recusa saltou mais de 10 pontos adicionais quando os participantes tinham motivo para crer que a explicação poderia revelar que raça ou gênero havia influenciado a pontuação da AI. Fonte: HBS Working Knowledge, "When AI Gives Advice, Employees Rarely Ask Why"
A formulação do próprio Chan para o resultado é a frase que vale a pena ruminar: "O maior risco da AI não é apenas respostas ruins ou falta de adoção. É treinar as pessoas a parar de perguntar por quê." Seus participantes não estavam confusos sobre como ver o raciocínio da AI. Uma parcela significativa deles escolheu não olhar, porque olhar arriscava trazer à tona algo inconveniente. Isso não é o viés de automação como atalho cognitivo passivo. É o viés de automação como escolha ativa e motivada, facilitada por um arranjo em que os incentivos de ninguém premiavam fazer a pergunta mais difícil.
Fatos Relevantes
- O viés de automação, a tendência de aceitar o resultado de um sistema automatizado em vez da checagem vigilante da própria pessoa, foi definido pelo estudo de 1999 de Skitka, Mosier e Burdick, que constatou que as pessoas cometem tanto erros de omissão (deixar passar um problema que o sistema não sinalizou) quanto erros de comissão (seguir ativamente uma má recomendação automatizada contra evidências em contrário). Fonte: International Journal of Human-Computer Studies, via ACM
- Em um estudo de 2026 com 2.512 participantes atuando como analistas de crédito, 80% quiseram ver a pontuação de risco de um sistema de AI, mas apenas 46% pediram para ver a explicação por trás dela; a recusa em ver a explicação subiu 20 pontos percentuais quando um bônus financeiro foi atrelado ao desempenho do empréstimo, e subiu mais de 10 pontos adicionais quando a explicação corria o risco de revelar viés racial ou de gênero. Fonte: HBS Working Knowledge
- A pesquisa de 2026 de Amy Edmondson e Jayshree Seth na Harvard Business Review constatou que, apesar dos ganhos de produtividade que as empresas esperam da AI, o desempenho das equipes muitas vezes piora: as pessoas passam a duvidar de si mesmas e a confiança se desgasta de maneiras difíceis de identificar, uma dinâmica que elas descrevem como "ambiguidade de confiança". Fonte: Harvard Business Review
- O Work Trend Index 2026 da Microsoft constatou que, quando os gestores criaram deliberadamente segurança psicológica em torno da experimentação com AI, os funcionários relataram até 20 pontos a mais de prontidão e de valor percebido da AI, e tinham 1,4 vez mais probabilidade de se tornar usuários frequentes de AI agêntica. Fonte: Microsoft Work Trend Index 2026
- A pesquisa Global Human Capital Trends 2026 da Deloitte constatou que 60% dos executivos já usam AI na tomada de decisões, mas apenas 5% dizem gerenciar isso bem, uma lacuna que se acumula no que a Deloitte chama de AI cultural debt quando ninguém se sente seguro o bastante para nomear o problema em voz alta. Fonte: Deloitte 2026 Global Human Capital Trends
Por que esse tipo de silêncio é fácil de não perceber
O silêncio tradicional em reuniões tem um formato conhecido: alguém tem uma preocupação, a sala fica quieta e todos sentem a tensão, mesmo que ninguém a nomeie. O silêncio em torno da AI muitas vezes não parece tensão nenhuma. Parece concordância tranquila, porque deferir a um sistema não carrega o mesmo peso social visível de deferir a uma pessoa. Ninguém vê um colega aceitar em silêncio o número de uma AI e interpreta isso como recuar, como interpretaria alguém cedendo a uma voz alta na sala. É isso que a torna perigosa: uma equipe pode parecer perfeitamente segura, cheia de debate aberto sobre tudo em que as pessoas discordam entre si, enquanto mantém um ponto cego não examinado em tudo que a AI toca.
A pesquisa de 2026 de Edmondson e Seth nomeia o mecanismo diretamente: o uso prolongado de AI pode corroer discretamente a confiança de uma pessoa na própria capacidade de questionar o resultado da AI, mesmo quando ela tem exatamente a expertise necessária para perceber o que está errado. É o oposto de como a confiança costuma funcionar, já que um especialista de domínio normalmente fica mais assertivo com a experiência, não menos. Ver uma resposta fluente e de aparência profissional ser produzida repetidamente ensina outra lição: que o que precisa de justificativa é hesitar em aceitá-la, e não a aceitação em si. Confiança quando o seu colega de equipe é uma AI explica por que o resultado da AI é muito mais difícil de avaliar quanto à confiança do que o de uma pessoa; esta é a consequência para a segurança dessa mesma mecânica, que se manifesta como dúvida silenciosa em relação a si mesmo, e não como uma discordância aberta que alguém poderia apontar e corrigir.
O custo se acumula porque é invisível enquanto acontece. Quem engole uma dúvida sobre o plano de um colega pelo menos sabe que fez isso. Quem aceita o resultado de uma AI sem verbalizar uma dúvida muitas vezes nem sente que cedeu; simplesmente sente que seguiu em frente. Multiplique isso por uma equipe ao longo de meses e você tem um grupo que deixou de exercitar discretamente o próprio julgamento para o qual foi contratado, sem nenhum momento que alguém possa apontar como aquele em que as coisas deram errado.
O que os líderes fazem para construir segurança psicológica em equipes com AI
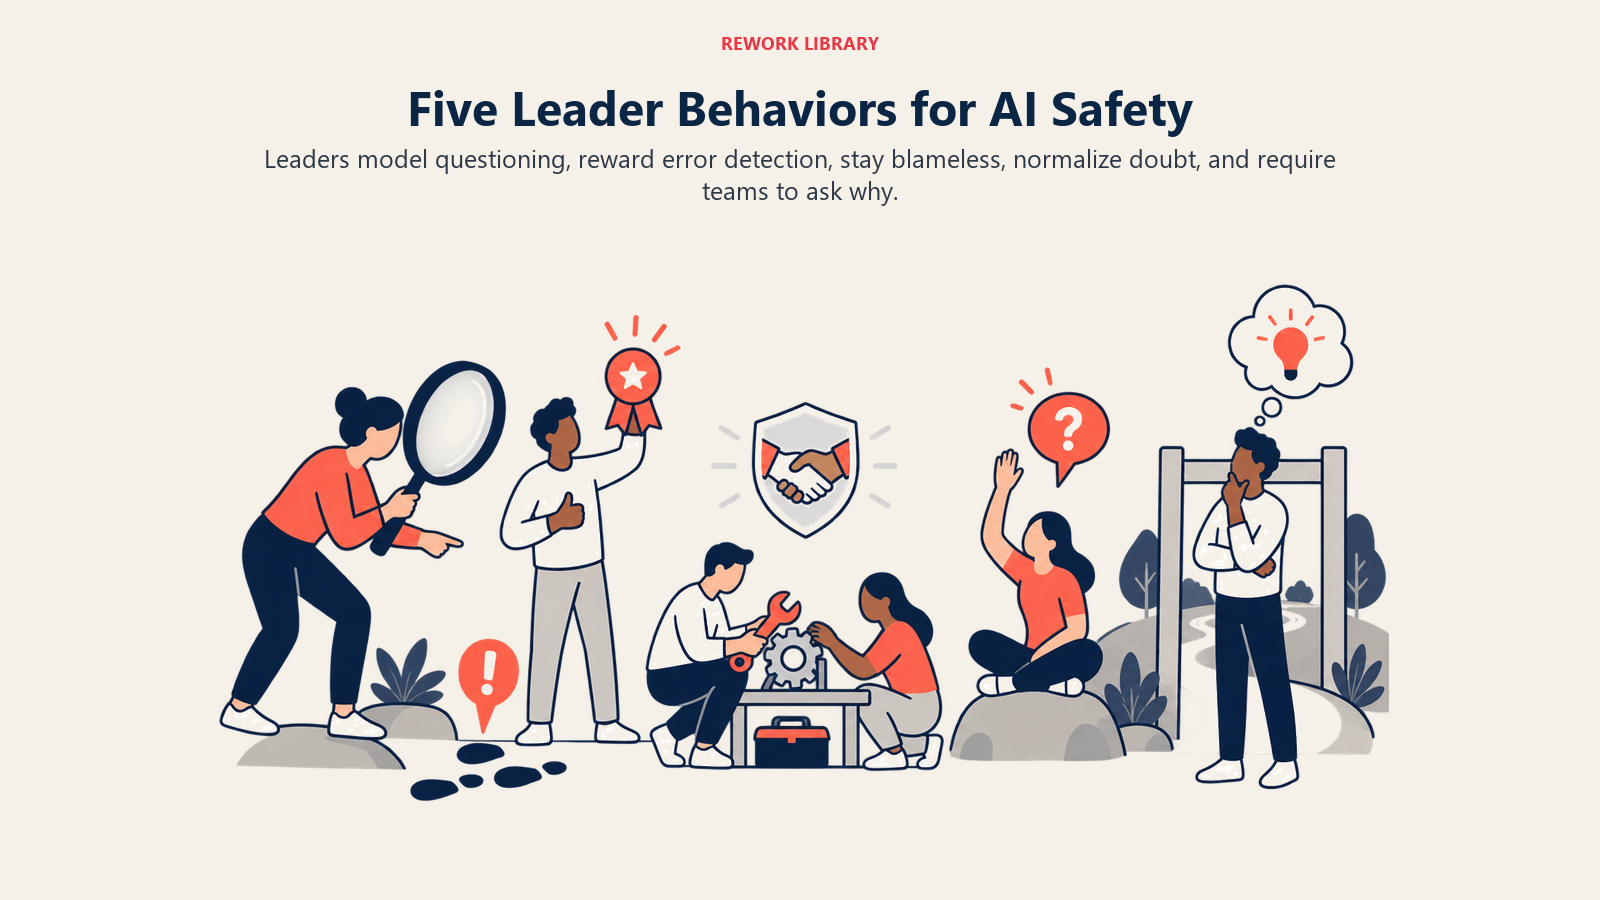
As equipes que evitam esse modo de falha não são as que têm a política de AI mais cautelosa. São aquelas em que um punhado de comportamentos específicos dos líderes faz de questionar, admitir e duvidar uma parte normal da forma como o trabalho é feito, e não uma exceção que alguém precisa justificar.
Modele o questionamento da AI você mesmo, de forma visível
A jogada de maior alavancagem é um líder reavaliar publicamente o resultado de uma AI diante da equipe, inclusive nas vezes em que ele acaba estando certo. "Quero conferir este número antes de usá-lo", dito pela pessoa mais sênior da sala, faz mais para autorizar o mesmo comportamento nos demais do que qualquer política escrita. A pesquisa da Microsoft sobre gestores que modelam de forma visível o próprio uso de AI encontrou efeitos reais e mensuráveis na disposição de toda a equipe de se engajar criticamente com a AI, e não apenas na adoção pura e simples. O comportamento que se espalha é o ato visível de checar, e não um memorando dizendo que checar é incentivado.
Premie quem pega o erro, não apenas quem entrega rápido
Se o único resultado reconhecido em uma equipe é a velocidade, quem identifica um resultado falho da AI e desacelera as coisas para corrigi-lo parece a pessoa que perdeu o prazo, não a que salvou o projeto. Sistemas de reconhecimento construídos inteiramente em torno de vazão treinam as pessoas, sem alarde, a parar de olhar de perto. Nomear e dar crédito a quem pegou um erro da AI antes de ele ser entregue, como uma boa equipe faz com quem achou um bug antes do lançamento, faz da detecção de erros um movimento que constrói status, e não que o arrisca.
Trate os erros da AI como sem culpa, sempre
A forma como uma equipe reage a um erro treina todos que estão observando, seja o erro de uma pessoa ou de uma máquina. Cultura da culpa versus cultura de aprendizado é tão relevante para o erro de um agente quanto para o de uma pessoa. Uma equipe que culpa em silêncio quem "deveria ter pego" o erro da AI ensina a todos que a jogada mais segura da próxima vez é o silêncio, não o escrutínio. Uma equipe que trata o erro como informação, o que o agente deixou passar e o que muda para que não se repita, mantém a porta aberta para a próxima pessoa se manifestar com honestidade em vez de se proteger.
Faça de "eu não confio nisto" uma frase normal
Os líderes podem nomear isso diretamente em vez de esperar que surja sozinho. Dizer, em uma reunião de equipe, "se você olhar para o que um agente produziu e achar que algo está errado, essa é exatamente a frase que eu quero ouvir, mesmo que você ainda não consiga explicar bem por quê" rende mais do que parece. Isso converte uma sensação vaga e difícil de justificar em uma contribuição explicitamente bem-vinda, justamente a lacuna em que a pesquisa de Chan encontrou as pessoas: evitar uma pergunta não por falta de ferramentas para fazê-la, mas porque nada na sala lhes dizia que perguntar valia o atrito.
Crie o hábito de perguntar "por quê", e não só "o quê"
Equipes que perguntam "o que a AI recomendou" e param aí estão estruturalmente preparadas para a deferência excessiva que este artigo descreve. Equipes que incorporam ao próprio fluxo de trabalho o "por que ela recomendou isso e o raciocínio se sustenta", como uma etapa padrão acima de um limite definido de risco, e não como uma checagem de intuição ocasional, fazem o oposto do que os participantes de Chan fizeram quando um bônus tornou inconveniente olhar a explicação. É a mesma disciplina de que as equipes de humanos e agentes precisam para a responsabilização em geral, aplicada ao momento antes de o resultado ser entregue, e não depois que algo já deu errado.
Uma auditoria rápida: a sua equipe realmente tem isso?
A maioria das equipes não consegue dizer se tem segurança psicológica em torno da AI até procurar sinais específicos, e não uma impressão geral. A tabela abaixo separa o que a presença de segurança realmente parece do que a sua ausência parece, já que ambas podem aparentar calma na superfície.
| Sinal | Presente | Ausente |
|---|---|---|
| Questionar o resultado da AI | As pessoas dizem "quero conferir isto" sem rodeios nem pedir desculpas antes | As dúvidas são levantadas só em particular, depois que o resultado já foi entregue |
| Admitir o uso de AI | A divulgação é rotina, mencionada do mesmo jeito que se mencionaria uma fonte | O uso de AI só é mencionado quando perguntam diretamente, ou nunca |
| Sinalizar ou rejeitar erros da AI | Quem pegou o erro é nomeado e recebe crédito | O erro aparece depois, sem registro claro de quem quase o pegou |
| Dizer "eu não confio nisto" | Dito com clareza em reuniões de equipe e tratado como informação útil | Dito só em conversas individuais, se dito, e tratado como uma confissão |
| Comportamento do líder | Os líderes questionam visivelmente o resultado da AI, inclusive o próprio | Os líderes tratam o resultado da AI como definitivo depois que uma pessoa sênior o aprovou |
Uma equipe que se reconhece principalmente na coluna da direita não está quebrada; está simplesmente rodando o arranjo exato que tanto a pesquisa de Chan quanto o framework original de viés de automação de Skitka preveem que vai acumular, sem alarde, erros de comissão. A solução não é uma nova ferramenta. É fazer da coluna da esquerda a forma normal e corriqueira de a equipe já conversar.
Próximos passos
Este artigo estende a pesquisa fundamental sobre segurança psicológica para um contexto novo e específico. A partir daqui:
- Segurança psicológica no trabalho, para o modelo original de quatro etapas de Edmondson e a pesquisa Project Aristotle, do Google, em que este artigo se apoia
- Confiança quando o seu colega de equipe é uma AI, para a mecânica da confiança calibrada e por que o tom confiante da AI não pode ser lido como o de uma pessoa
- Equipes de humanos e agentes, para as questões de responsabilidade e prestação de contas que surgem quando um agente passa a fazer parte da equipe
- Cultura da culpa versus cultura de aprendizado, para ver como a reação de uma equipe a qualquer erro, humano ou de AI, define se a próxima pessoa se manifesta
- AI cultural debt, para o que se acumula quando as lacunas de confiança e segurança em torno da AI ficam sem tratamento
- Etiqueta de AI e normas de trabalho, para o conjunto mais amplo de regras não escritas sobre divulgação em que a segunda categoria de risco deste artigo se insere
- A Frontier Firm e a ascensão do agent boss, para entender como o papel de orquestrador muda o que os líderes precisam modelar
- Construindo uma cultura pronta para AI, para o conjunto mais amplo de práticas em que isto se encaixa
- O que é cultura AI-native?, para o conceito fundamental em que as perguntas deste artigo se inserem
- Liderando a cultura na era da AI, para o panorama completo de liderança em toda a Seção 7
A saúde de uma equipe com AI aparece em um único momento: quando alguém diz "eu não confio neste resultado", a sala trata isso como fazer o trabalho ou como atrasar todo mundo? As normas de divulgação, o relato de erros e a disposição de rejeitar uma máquina confiante decorrem da resposta. Construa para esse momento e o resto fica mais fácil. Puna-o uma vez e as pessoas param de dizê-lo em silêncio, que é exatamente quando o viés de automação começa a lhe custar caro.

Co-Founder, Rework.com
On this page
- Estendendo o modelo de Edmondson: quatro coisas novas que as pessoas precisam se sentir seguras para dizer
- Seguro para questionar o resultado da AI
- Seguro para admitir que você usou AI
- Seguro para sinalizar um erro da AI ou rejeitar sua recomendação
- Seguro para dizer "eu não confio neste resultado"
- Viés de automação e deferência excessiva: o novo modo de falha
- O que o viés de automação realmente é
- Por que a segurança psicológica é a variável que falta
- O estudo dos analistas de crédito: quando não perguntar "por quê" é o ponto
- Fatos Relevantes
- Por que esse tipo de silêncio é fácil de não perceber
- O que os líderes fazem para construir segurança psicológica em equipes com AI
- Modele o questionamento da AI você mesmo, de forma visível
- Premie quem pega o erro, não apenas quem entrega rápido
- Trate os erros da AI como sem culpa, sempre
- Faça de "eu não confio nisto" uma frase normal
- Crie o hábito de perguntar "por quê", e não só "o quê"
- Uma auditoria rápida: a sua equipe realmente tem isso?
- Próximos passos