Keselamatan Psikologi dalam Pasukan AI: Selamat untuk Mempersoalkan, Selamat untuk Menolak
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
Keselamatan psikologi dalam pasukan AI ialah konsep asal Amy Edmondson, iaitu kepercayaan bersama bahawa sesebuah pasukan selamat untuk mengambil risiko interpersonal, yang dikembangkan kepada set risiko baharu yang hanya wujud apabila AI melakukan sebahagian daripada kerja. Ia bermakna orang berasa selamat mempersoalkan output ejen, mengaku mereka menggunakan AI untuk sesuatu tugas, menandakan ralat AI atau mengatasi cadangannya, dan berkata dengan jelas, "Saya tidak mempercayai hasil ini," tanpa semua itu merugikan status, kredibiliti atau menambah catatan buruk pada nama mereka.
Edmondson membina kariernya dengan mengkaji mengapa orang berdiam diri di hospital, kokpit dan bilik lembaga pengarah walaupun bersuara boleh menyelamatkan nyawa atau projek. Mekanisme yang ditemuinya, bahawa berdiam diri ialah tindak balas rasional terhadap bilik yang menghukum risiko, berpindah hampir utuh kepada AI. Dahulu tiada sesiapa memerlukan kebenaran untuk tidak mempercayai hamparan. Kini bahagian tenaga kerja yang semakin besar memerlukan kebenaran itu, dan kebanyakan pasukan tidak pernah memberikannya secara lantang. Artikel ini merangkumi apa yang benar-benar baharu tentang keselamatan dalam pasukan manusia-AI, mengapa bias automasi dan kepatuhan berlebihan ialah mod kegagalan yang muncul apabila keselamatan tiada, kajian sebenar tentang mengapa orang berhenti bertanya "mengapa," dan apa yang dilakukan pemimpin untuk membinanya semula.
Memanjangkan Model Edmondson: Empat Perkara Baharu yang Orang Perlu Rasa Selamat untuk Katakan
Model empat peringkat asal Edmondson, iaitu keselamatan inklusi, pelajar, penyumbang dan pencabar, dibina berdasarkan interaksi antara manusia. Kami menghuraikan model penuh itu dalam keselamatan psikologi di tempat kerja. Sebaik sahaja ejen AI menjadi bahagian kerja pasukan dan bukan alat yang digunakan seseorang secara senyap di tepi, empat peringkat yang sama perlu diregangkan untuk merangkumi set detik baharu yang tidak pernah perlu dimodelkan Edmondson pada 1999, kerana perkara yang dipersoalkan dahulu sentiasa seorang rakan sekerja.
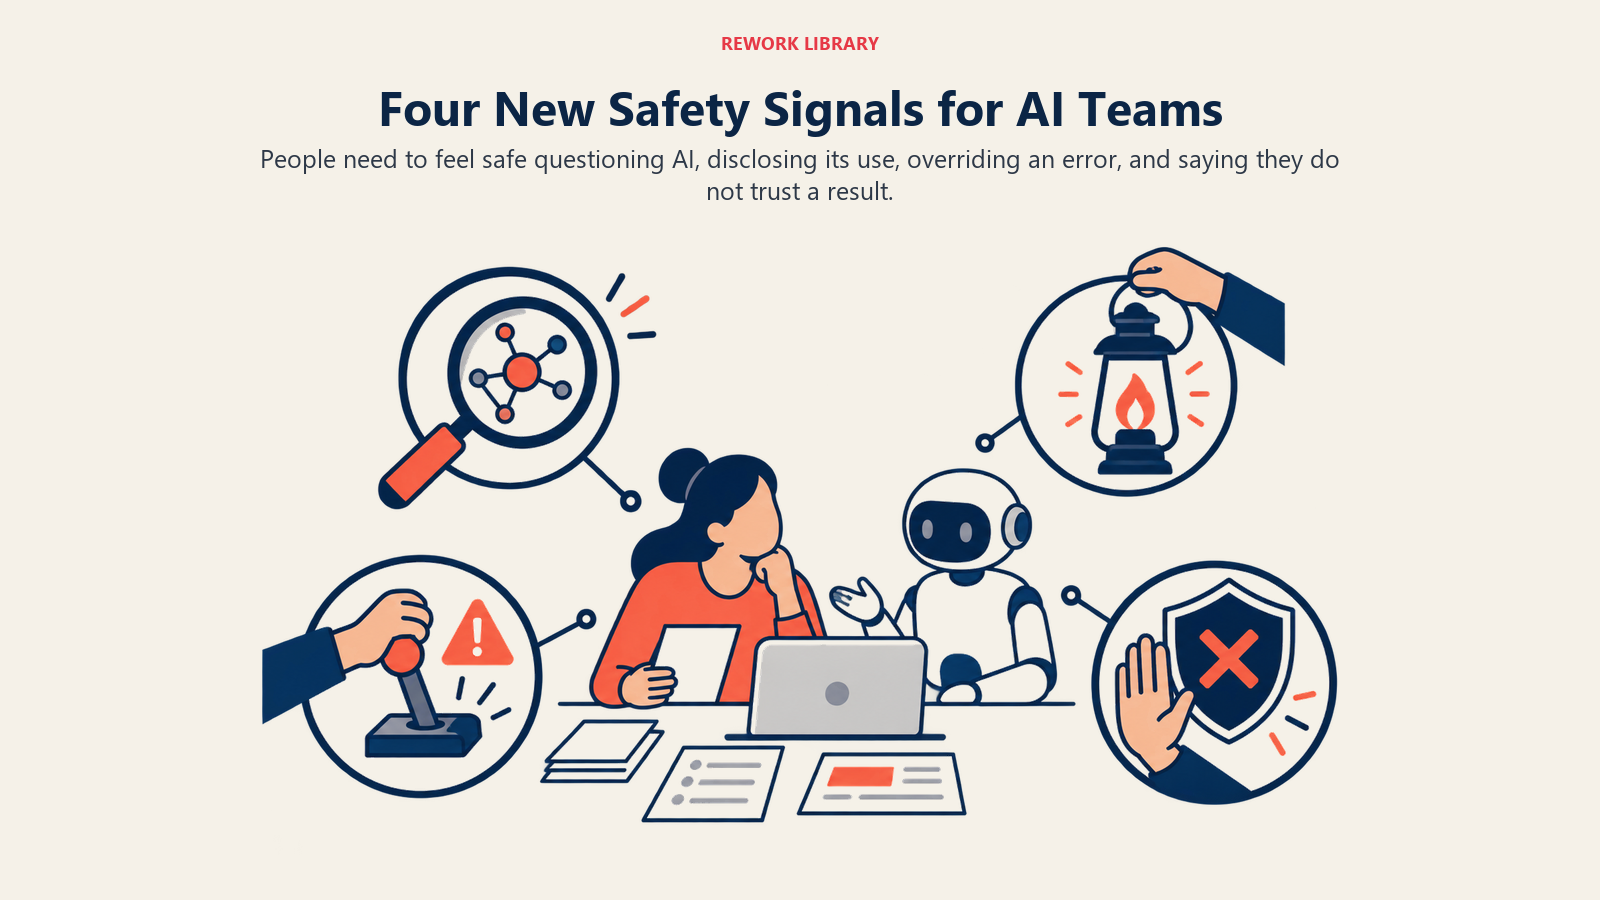
Selamat untuk Mempersoalkan Output AI
Seseorang melihat apa yang dihasilkan ejen dan berasa ada sesuatu yang tidak kena: angka yang tidak sepadan dengan gerak hatinya, petikan yang kedengaran terlalu bersih, langkah yang dijangka akan ditandakan oleh seorang manusia. Keselamatan pencabar, dalam model Edmondson, ialah peringkat apabila orang bebas mempersoalkan pelan atau orang yang memimpin. Versi peringkat itu dalam pasukan AI ialah mempersoalkan mesin, dan ia membawa kos sosial yang berbeza: tiada sesiapa kelihatan buruk kerana meragui idea rakan sekerja dengan cara yang sama mereka mungkin kelihatan lambat atau paranoid kerana menyemak semula sistem yang "semua orang lain" nampaknya terima tanpa komen.
Selamat untuk Mengaku Anda Menggunakan AI
Yang ini lebih dekat dengan keselamatan inklusi dan pelajar. Menggunakan AI untuk draf, ringkasan atau sekeping analisis bukan satu pengakuan, tetapi ia dilayan seperti pengakuan dalam banyak pasukan, kerana tiada sesiapa menyatakan dengan lantang bahawa ia bukan. Orang yang menyembunyikan penggunaan AI tidak berbohong kerana niat jahat; mereka membaca keadaan bilik dengan betul jika bilik itu tidak pernah menjadikan pendedahan terasa selamat. Kesenyapan itu mempunyai kos langsung: pengurus kehilangan penglihatan tentang bagaimana kerja sebenarnya dihasilkan, yang bermakna mereka tidak dapat mengesan mod kegagalan yang menjadi tajuk artikel ini.
Selamat untuk Menandakan Ralat AI atau Mengatasi Cadangannya
Ejen tersilap, atau seseorang mengatasi apa yang dicadangkannya lalu melakukan sesuatu yang berbeza. Kedua-duanya ialah detik keselamatan penyumbang, menggunakan pertimbangan anda dan memastikan ia diambil kira, tetapi kini ia melibatkan pengatasan sistem yang dibeli, dikonfigurasi dan mungkin dijuarai oleh seseorang yang kanan. Menandakan kesilapan seseorang berisiko perbualan yang janggal. Menandakan atau mengatasi kesilapan sistem berisiko kelihatan seperti anda tidak mempercayai pelaburan yang baru dibuat syarikat padanya, iaitu jenis risiko yang berbeza dan sering lebih berat untuk ditanggung seorang diri.
Selamat untuk Berkata "Saya Tidak Mempercayai Hasil Ini"
Inilah ayat yang paling penting, dan yang paling kurang dilatih untuk dikatakan oleh kebanyakan pasukan. Ia bukan dakwaan teknikal tentang ketepatan; ia pernyataan ketidakpastian daripada seseorang yang sepatutnya kelihatan cekap dan tegas. Mengatakannya tentang kerja rakan sekerja memang tidak selesa tetapi wilayah yang biasa. Mengatakannya tentang sistem yang menghasilkan jawapan yang pantas, lancar dan kelihatan profesional, dengan tiada sesiapa lain dalam bilik membantah, ialah risiko interpersonal yang benar-benar baharu yang menjadi nama artikel ini.
Bias Automasi dan Kepatuhan Berlebihan: Mod Kegagalan Baharu
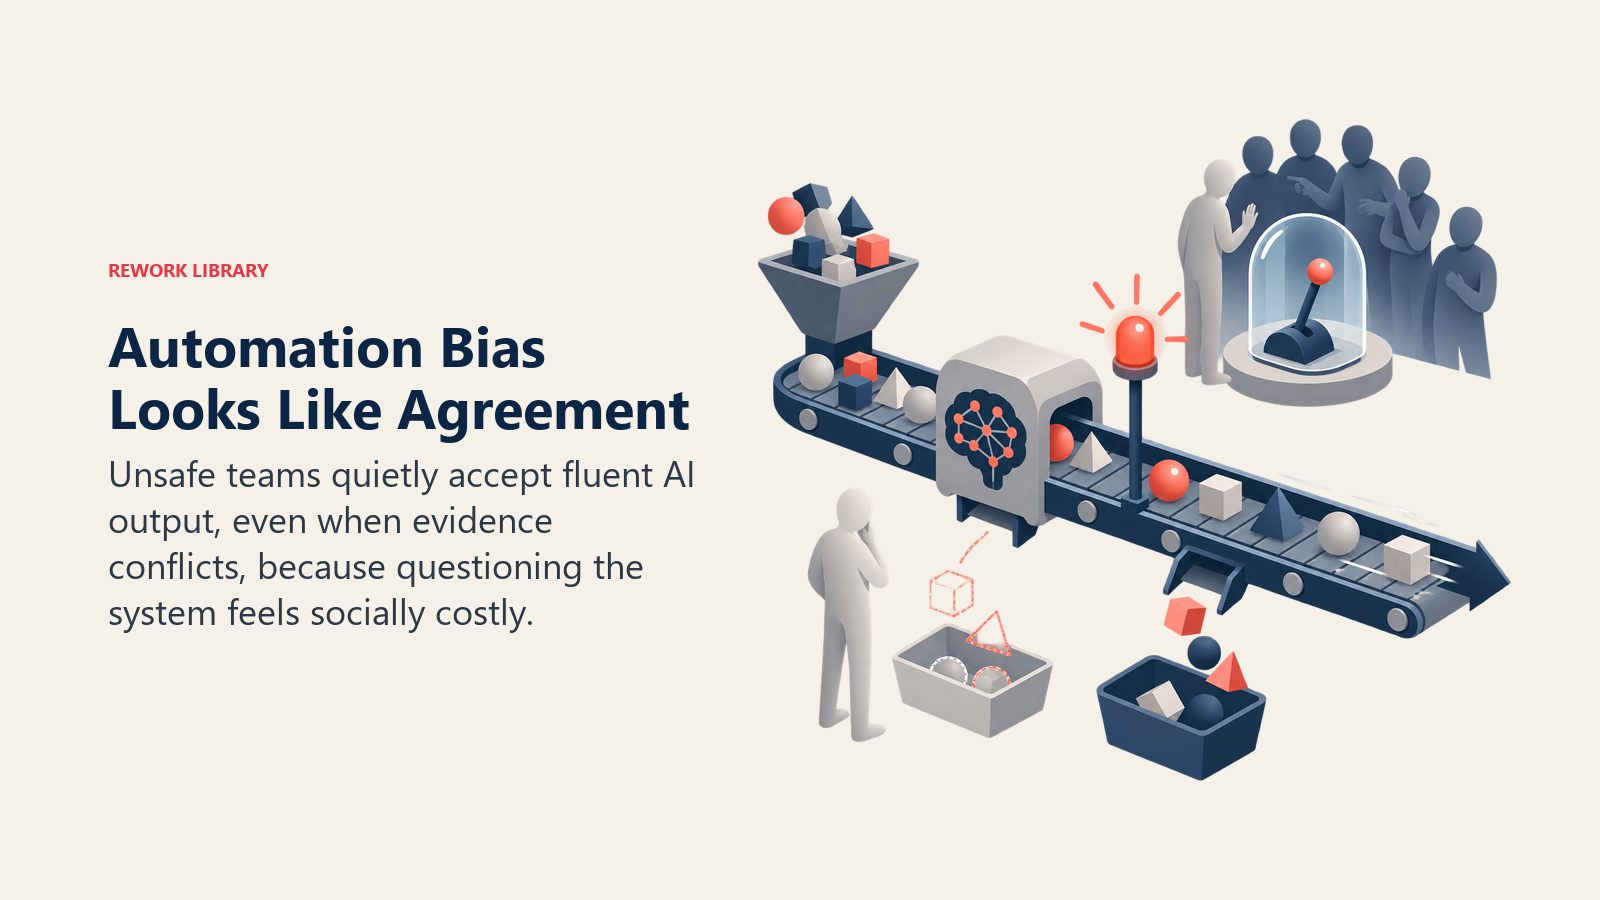
Inilah bahagian yang terlepas sepenuhnya daripada kebanyakan nasihat keselamatan psikologi. Apabila sesebuah pasukan tidak selamat berhubung AI, kegagalan itu tidak kelihatan seperti konflik. Ia kelihatan seperti persetujuan. Semua orang mengangguk, output dihantar, dan pasukan kelihatan sepenuhnya sepakat sehingga kesilapan muncul di tempat yang mahal.
Apakah Bias Automasi Sebenarnya
Penyelidik Linda Skitka, Kathleen Mosier dan Malcolm Burdick memberi nama kepada corak ini dalam kajian 1999 yang masih menjadi rujukan utama bidang ini: bias automasi, iaitu kecenderungan menerima output sistem automatik sebagai ganti semakan teliti yang sepatutnya dilakukan sendiri oleh seseorang. Penyelidikan mereka, yang dijalankan dalam tugas pemantauan penerbangan simulasi, mendapati sesuatu yang cukup khusus untuk penting di sini: orang membuat dua jenis ralat yang berbeza. Ralat peninggalan, gagal menyedari masalah kerana sistem automatik tidak menandakannya. Dan ralat komisen, secara aktif mengikut cadangan automatik walaupun maklumat lain yang ada pada mereka mencadangkan ia salah. Sumber: Skitka, Mosier & Burdick, "Does Automation Bias Decision-Making?"
Kategori kedua itu yang penting untuk perbincangan budaya. Ralat komisen bukan kemalangan. Ia seseorang yang memilih jawapan automatik berbanding pertimbangannya sendiri, pada saat itu, sering ketika petunjuk lain berada betul-betul di hadapannya. Itu bukan jurang latihan. Ia keputusan yang dibentuk oleh apa yang bilik di sekeliling orang itu menjadikan selesa untuk dikatakan dan dilakukan.
Mengapa Keselamatan Psikologi Ialah Pemboleh Ubah yang Hilang
Kebanyakan tulisan tentang bias automasi menganggapnya kecacatan kognitif individu, sesuatu yang diperbaiki dengan UI yang lebih baik atau modul latihan. Rangka itu terlepas mekanisme peringkat pasukan sepenuhnya. Ralat komisen paling mudah dibuat tepat apabila mempersoalkan sistem terasa mahal dari segi sosial dan berdiam diri terasa percuma. Balikkan insentif itu dan orang yang sama, dengan wayar kognitif yang sama, berkelakuan berbeza. Penemuan makmal Skitka dan penyelidikan lapangan Edmondson menggambarkan bentuk yang sama dari dua arah: bias automasi menunjukkan orang lalai kepada penerimaan apabila tidak pasti, dan keselamatan psikologi menunjukkan apa yang menjadikan bersuara ketika tidak pasti mahal atau percuma. Kepatuhan berlebihan kepada AI bukan jenis kegagalan manusia yang baharu. Ia kegagalan tertua Edmondson, pasukan yang menghukum suara dan memberi ganjaran kepada kesenyapan, dengan antara muka baharu.
Kajian Pegawai Pinjaman: Apabila Tidak Bertanya "Mengapa" Ialah Intinya
Kajian 2026 yang diketuai Alex Chan dari Harvard Business School memberi angka sebenar tentang betapa disengajanya kesenyapan itu. Penyelidik meminta 2,512 peserta dalam talian bertindak sebagai pegawai pinjaman yang menyemak pasangan permohonan pinjaman sebenar $10,000, dengan sistem AI memberikan skor risiko bagi setiap satu. Lapan puluh peratus peserta mahu melihat skor risiko AI, tetapi hanya 46% yang pergi lebih jauh dan meminta untuk melihat penjelasan di sebaliknya, walaupun penjelasan itu hanya satu klik jauhnya. Apabila penyelidik secara rawak memberi sebahagian peserta bonus kewangan yang dikaitkan dengan prestasi sebenar pinjaman dan bukannya yuran tetap, pengelakan penjelasan meningkat 20 mata peratusan, dan pengelakan melonjak lebih 10 mata tambahan apabila peserta ada sebab untuk percaya penjelasan itu mungkin mendedahkan bahawa bangsa atau jantina telah mempengaruhi skor AI. Sumber: HBS Working Knowledge, "When AI Gives Advice, Employees Rarely Ask Why"
Rangka Chan sendiri tentang keputusan itu ialah baris yang wajar direnungkan: "Risiko terbesar AI bukan sekadar jawapan yang salah atau kekurangan penerimaan. Ia melatih orang supaya berhenti bertanya mengapa." Peserta beliau tidak keliru tentang cara melihat penaakulan AI. Sebahagian bermakna daripada mereka memilih untuk tidak melihat, kerana melihat berisiko mendedahkan sesuatu yang menyusahkan. Itu bukan bias automasi sebagai jalan pintas kognitif yang pasif. Ia bias automasi sebagai pilihan aktif yang bermotivasi, dipermudah oleh persediaan yang insentif sesiapa pun tidak memberi ganjaran kepada soalan yang lebih sukar.
Fakta Utama
- Bias automasi, kecenderungan menerima output sistem automatik berbanding semakan teliti seseorang sendiri, ditakrifkan oleh kajian Skitka, Mosier dan Burdick pada 1999, yang mendapati orang membuat kedua-dua ralat peninggalan (terlepas masalah yang tidak ditandakan sistem) dan ralat komisen (secara aktif mengikut cadangan automatik yang buruk berbanding bukti yang bercanggah). Sumber: International Journal of Human-Computer Studies, via ACM
- Dalam kajian 2026 terhadap 2,512 peserta yang bertindak sebagai pegawai pinjaman, 80% mahu melihat skor risiko sistem AI tetapi hanya 46% meminta penjelasan di sebaliknya; pengelakan penjelasan meningkat 20 mata peratusan apabila bonus kewangan dikaitkan dengan prestasi pinjaman, dan meningkat lebih 10 mata tambahan apabila penjelasan berisiko mendedahkan bias kaum atau jantina. Sumber: HBS Working Knowledge
- Penyelidikan Harvard Business Review 2026 oleh Amy Edmondson dan Jayshree Seth mendapati bahawa walaupun syarikat menjangka keuntungan produktiviti daripada AI, prestasi pasukan sering merosot: orang mula meragui diri sendiri dan kepercayaan terhakis dengan cara yang sukar ditentukan, dinamik yang mereka gambarkan sebagai "kekaburan kepercayaan." Sumber: Harvard Business Review
- Work Trend Index Microsoft 2026 mendapati bahawa apabila pengurus dengan sengaja mewujudkan keselamatan psikologi sekitar percubaan AI, pekerja melaporkan kesediaan dan nilai AI yang dirasakan sehingga 20 mata lebih tinggi, dan 1.4 kali lebih berkemungkinan menjadi pengguna berkekerapan tinggi AI agentik. Sumber: Microsoft Work Trend Index 2026
- Penyelidikan Global Human Capital Trends Deloitte 2026 mendapati 60% eksekutif sudah menggunakan AI dalam membuat keputusan, tetapi hanya 5% berkata mereka mengurusnya dengan baik, jurang yang bertambah menjadi apa yang Deloitte panggil hutang budaya AI apabila tiada sesiapa cukup selamat untuk menamakan masalah itu dengan lantang. Sumber: Deloitte 2026 Global Human Capital Trends
Mengapa Kesenyapan Jenis Ini Mudah Terlepas Pandang
Kesenyapan dalam mesyuarat cara lama mempunyai bentuk yang biasa: seseorang ada kebimbangan, bilik menjadi sunyi, dan semua orang dapat merasakan ketegangan walaupun tiada sesiapa menamakannya. Kesenyapan berhubung AI sering tidak terasa seperti ketegangan langsung. Ia terasa seperti persetujuan yang lancar, kerana tunduk kepada sistem tidak membawa bobot sosial yang kelihatan seperti tunduk kepada seseorang. Tiada sesiapa memerhati rakan sekerja menerima angka AI secara senyap lalu membacanya sebagai mengalah seperti mereka membaca seseorang tunduk kepada suara yang lantang dalam bilik. Itulah yang menjadikannya berbahaya: pasukan boleh kelihatan sepenuhnya selamat, penuh perbahasan terbuka tentang segala perkara yang orang tidak sepakati sesama mereka, sambil menjalankan titik buta yang tidak diperiksa sekitar apa sahaja yang disentuh AI.
Penyelidikan Edmondson dan Seth pada 2026 menamakan mekanismenya secara langsung: penggunaan AI yang berterusan boleh menghakis secara senyap keyakinan seseorang terhadap keupayaannya sendiri mencabar output AI, walaupun mereka mempunyai kepakaran tepat yang diperlukan untuk mengesan apa yang salah. Itu bertentangan dengan cara keyakinan biasanya berfungsi, kerana pakar bidang lazimnya menjadi lebih tegas dengan pengalaman, bukan kurang. Menonton jawapan yang lancar dan kelihatan profesional dihasilkan berulang kali mengajar pengajaran yang berbeza: bahawa teragak-agak menerimanya yang perlu dibenarkan, bukan penerimaan itu sendiri. Kepercayaan apabila rakan sepasukan anda ialah AI menerangkan mengapa output AI jauh lebih sukar dibaca untuk keyakinan berbanding seseorang; ini akibat keselamatan daripada mekanik yang sama, berlaku sebagai keraguan diri yang senyap dan bukan perbezaan pendapat terbuka yang boleh ditunjuk dan diperbaiki sesiapa.
Kosnya bertambah kerana ia tidak kelihatan ketika berlaku. Orang yang menelan keraguan tentang pelan rakan sekerja sekurang-kurangnya tahu dia melakukannya. Orang yang menerima output AI tanpa menyuarakan keraguan sering tidak mengalaminya sebagai mengalah langsung; ia hanya terasa seperti meneruskan. Darabkan itu merentasi pasukan selama berbulan-bulan dan anda mendapat kumpulan yang secara senyap telah berhenti menggunakan pertimbangan tepat yang menjadi sebab ia diambil bekerja, tanpa satu detik pun yang boleh ditunjuk sesiapa sebagai tempat segala-galanya menjadi salah.
Apa yang Dilakukan Pemimpin untuk Membina Keselamatan Psikologi dalam Pasukan AI
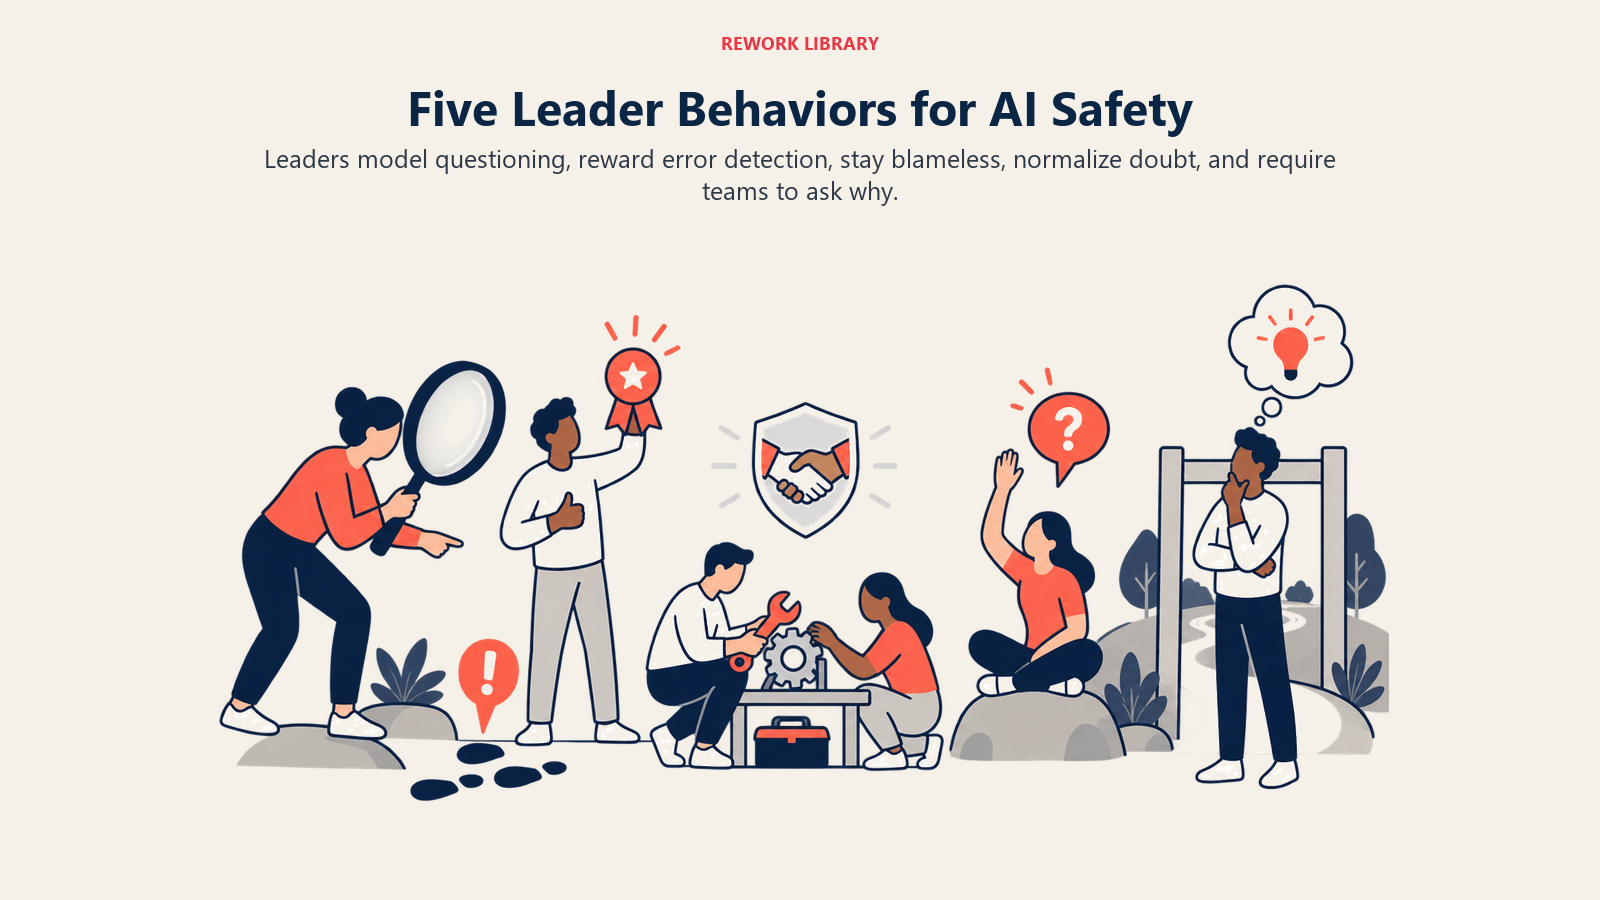
Pasukan yang mengelak mod kegagalan ini bukan yang mempunyai dasar AI paling berhati-hati. Mereka ialah pasukan yang segelintir tingkah laku pemimpin tertentu menjadikan mempersoalkan, mengaku dan meragui sebagai bahagian biasa cara kerja dilakukan, bukan pengecualian yang perlu dibenarkan seseorang.
Tunjukkan Sendiri Cara Mempersoalkan AI, Secara Ketara
Langkah berdaya ungkit tertinggi ialah pemimpin secara terbuka meragui output AI di hadapan pasukan, termasuk ketika ia ternyata betul. "Saya mahu menyemak angka ini sebelum kita menggunakannya," yang diucapkan oleh orang paling kanan dalam bilik, berbuat lebih banyak untuk membenarkan tingkah laku yang sama dalam diri semua orang berbanding sebarang dasar bertulis. Penyelidikan Microsoft tentang pengurus yang secara ketara menunjukkan penggunaan AI mereka sendiri mendapati kesan sebenar yang boleh diukur terhadap kesanggupan seluruh pasukan melibatkan diri secara kritis dengan AI, bukan sekadar penerimaan mentahnya. Tingkah laku yang merebak ialah tindakan menyemak yang kelihatan, bukan memo yang mengatakan menyemak digalakkan.
Beri Ganjaran kepada Mengesan Ralat, Bukan Sekadar Menghantar dengan Pantas
Jika satu-satunya hasil yang diiktiraf dalam sesebuah pasukan ialah kepantasan, sesiapa yang mengesan output AI yang cacat dan memperlahankan kerja untuk membetulkannya kelihatan seperti orang yang terlepas tarikh akhir, bukan yang menyelamatkan projek. Sistem pengiktirafan yang dibina sepenuhnya berdasarkan daya pemprosesan secara senyap melatih orang supaya berhenti melihat terlalu teliti. Menamakan dan mengiktiraf sesiapa yang mengesan ralat AI sebelum dihantar, seperti pasukan yang baik mengiktiraf sesiapa yang ternampak pepijat sebelum keluaran, menjadikan mengesan kesilapan sebagai langkah membina status dan bukan yang berisiko kepada status.
Layan Kesilapan AI sebagai Tanpa Menyalahkan, Setiap Kali
Cara pasukan bertindak balas terhadap kesilapan melatih semua yang memerhati, sama ada kesilapan itu datang daripada seseorang atau mesin. Budaya menyalahkan berbanding budaya pembelajaran sama relevan untuk ralat ejen seperti untuk ralat seseorang. Pasukan yang secara senyap menyalahkan sesiapa yang "sepatutnya mengesan" kesilapan AI mengajar semua orang bahawa langkah paling selamat pada kali berikutnya ialah berdiam diri, bukan meneliti. Pasukan yang menganggap kesilapan itu sebagai maklumat, apa yang terlepas daripada ejen dan apa yang berubah supaya ia tidak berulang, memastikan pintu terbuka untuk orang seterusnya bersuara dengan jujur dan bukannya melindungi diri sendiri.
Jadikan "Saya Tidak Mempercayai Ini" Ayat yang Biasa
Pemimpin boleh menamakan perkara ini secara langsung dan bukannya berharap ia muncul sendiri. Mengatakan, dalam mesyuarat pasukan, "jika anda pernah melihat apa yang dihasilkan ejen dan rasa ada yang tidak kena, itulah ayat yang saya mahu dengar, walaupun anda belum dapat menerangkan sebabnya sepenuhnya" melakukan lebih banyak kerja daripada yang kelihatan. Ia menukar perasaan yang kabur dan sukar dibenarkan kepada sumbangan yang dialu-alukan secara eksplisit, tepat jurang yang didapati kajian Chan menjadi tempat orang terjatuh: mengelak soalan bukan kerana mereka kekurangan alat untuk bertanya, tetapi kerana tiada apa dalam bilik memberitahu mereka bertanya berbaloi dengan geseran itu.
Bina Tabiat Bertanya "Mengapa," Bukan Sekadar "Apa"
Pasukan yang bertanya "apa yang dicadangkan AI" lalu berhenti di situ disediakan secara struktur untuk kepatuhan berlebihan yang diterangkan artikel ini. Pasukan yang membina "mengapa ia mencadangkan itu, dan adakah penaakulannya kukuh" ke dalam aliran kerja itu sendiri, sebagai langkah piawai di atas ambang pertaruhan yang ditetapkan dan bukan semakan gerak hati sekali-sekala, melakukan perkara yang bertentangan dengan peserta Chan apabila bonus menjadikan penjelasan tidak selesa untuk dilihat. Ia disiplin sama yang diperlukan pasukan manusia-ejen untuk akauntabiliti secara umum, diterapkan pada saat sebelum output dihantar dan bukan selepas sesuatu sudah menjadi salah.
Audit Pantas: Adakah Pasukan Anda Benar-benar Memilikinya?
Kebanyakan pasukan tidak dapat memastikan sama ada mereka mempunyai keselamatan psikologi sekitar AI sehingga mereka mencari isyarat tertentu, bukan perasaan umum. Jadual di bawah mengasingkan rupa kehadiran keselamatan sebenarnya daripada rupa ketiadaannya, kerana kedua-duanya boleh kelihatan tenang di permukaan.
| Isyarat | Ada | Tiada |
|---|---|---|
| Mempersoalkan output AI | Orang berkata "saya mahu menyemak ini" tanpa berselindung atau memohon maaf dahulu | Keraguan hanya dibangkitkan secara peribadi, selepas output sudah dihantar |
| Mengaku menggunakan AI | Pendedahan adalah rutin, disebut sama seperti seseorang menyebut sumber | Penggunaan AI hanya disebut apabila ditanya terus, atau langsung tidak disebut |
| Menandakan atau mengatasi ralat AI | Orang yang mengesan ralat dinamakan dan diberi kredit | Ralat muncul kemudian tanpa rekod jelas siapa yang hampir mengesannya |
| Berkata "Saya tidak mempercayai ini" | Dikatakan dengan jelas dalam suasana pasukan, dianggap maklumat berguna | Dikatakan hanya secara satu-lawan-satu, jika dikatakan pun, dan dianggap pengakuan |
| Tingkah laku pemimpin | Pemimpin secara ketara mempersoalkan sendiri output AI, termasuk output mereka sendiri | Pemimpin menganggap output AI sebagai selesai apabila orang kanan telah meluluskannya |
Pasukan yang mengenali dirinya kebanyakannya dalam lajur kanan tidak rosak; ia sekadar menjalankan persediaan tepat yang kedua-dua kajian Chan dan rangka kerja bias automasi asal Skitka ramalkan akan mengumpul ralat komisen secara senyap. Penyelesaiannya bukan alat baharu. Ia menjadikan lajur kiri cara biasa dan tidak luar biasa pasukan itu sudah bercakap.
Langkah Seterusnya
Artikel ini memanjangkan penyelidikan asas tentang keselamatan psikologi ke dalam konteks baharu yang khusus. Dari sini:
- Keselamatan psikologi di tempat kerja, untuk model empat peringkat asal Edmondson dan penyelidikan Project Aristotle Google yang menjadi asas artikel ini
- Kepercayaan apabila rakan sepasukan anda ialah AI, untuk mekanik kepercayaan terkalibrasi dan sebab nada AI yang yakin tidak boleh dibaca seperti nada seseorang
- Pasukan manusia-ejen, untuk persoalan pemilikan dan akauntabiliti yang timbul apabila ejen menjadi bahagian kerja pasukan
- Budaya menyalahkan berbanding budaya pembelajaran, untuk bagaimana tindak balas pasukan terhadap sebarang kesilapan, manusia atau AI, membentuk sama ada orang seterusnya bersuara
- Hutang budaya AI, untuk apa yang terkumpul apabila jurang kepercayaan dan keselamatan sekitar AI tidak ditangani
- Etika AI dan norma tempat kerja, untuk set peraturan tidak bertulis yang lebih luas sekitar pendedahan yang menjadi tempat kategori risiko kedua artikel ini berada
- Frontier Firm dan kebangkitan agent boss, untuk bagaimana peranan orkestrator mengubah apa yang perlu ditunjukkan pemimpin
- Membina budaya yang bersedia untuk AI, untuk set amalan yang lebih luas tempat ini berada
- Apakah budaya AI-native?, untuk konsep asas tempat soalan artikel ini berada
- Memimpin budaya dalam era AI, untuk gambaran kepimpinan penuh merentasi keseluruhan Bahagian 7
Kesihatan sesebuah pasukan AI terserlah dalam satu detik: apabila seseorang berkata "saya tidak mempercayai hasil ini," adakah bilik itu menganggapnya sebagai melaksanakan tugas, atau sebagai memperlahankan semua orang? Norma pendedahan, pelaporan ralat dan kesanggupan mengatasi mesin yang yakin semuanya mengikut jawapannya. Binalah untuk detik itu dan selebihnya menjadi lebih mudah. Hukum ia sekali dan orang secara senyap berhenti mengatakannya, tepat ketika bias automasi mula merugikan anda.

Co-Founder, Rework.com
On this page
- Memanjangkan Model Edmondson: Empat Perkara Baharu yang Orang Perlu Rasa Selamat untuk Katakan
- Selamat untuk Mempersoalkan Output AI
- Selamat untuk Mengaku Anda Menggunakan AI
- Selamat untuk Menandakan Ralat AI atau Mengatasi Cadangannya
- Selamat untuk Berkata "Saya Tidak Mempercayai Hasil Ini"
- Bias Automasi dan Kepatuhan Berlebihan: Mod Kegagalan Baharu
- Apakah Bias Automasi Sebenarnya
- Mengapa Keselamatan Psikologi Ialah Pemboleh Ubah yang Hilang
- Kajian Pegawai Pinjaman: Apabila Tidak Bertanya "Mengapa" Ialah Intinya
- Fakta Utama
- Mengapa Kesenyapan Jenis Ini Mudah Terlepas Pandang
- Apa yang Dilakukan Pemimpin untuk Membina Keselamatan Psikologi dalam Pasukan AI
- Tunjukkan Sendiri Cara Mempersoalkan AI, Secara Ketara
- Beri Ganjaran kepada Mengesan Ralat, Bukan Sekadar Menghantar dengan Pantas
- Layan Kesilapan AI sebagai Tanpa Menyalahkan, Setiap Kali
- Jadikan "Saya Tidak Mempercayai Ini" Ayat yang Biasa
- Bina Tabiat Bertanya "Mengapa," Bukan Sekadar "Apa"
- Audit Pantas: Adakah Pasukan Anda Benar-benar Memilikinya?
- Langkah Seterusnya