Predicción de la rotación de empleados con IA: señales, modelos y ética
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
La predicción de rotación de empleados es el uso del aprendizaje automático para estimar, a partir de datos de recursos humanos y de trabajo, qué probabilidad tiene cada empleado o equipo de irse en un periodo determinado, de modo que los gerentes puedan actuar sobre las causas antes de que llegue una renuncia. El resultado suele ser una probabilidad o una banda de riesgo. Es un pronóstico, no un veredicto, y la forma en que lo use importa más que el modelo que lo produzca.
Esta guía está dirigida a líderes de recursos humanos, responsables de people analytics y gerentes a quienes les ofrecen un dashboard de «riesgo de fuga», o que piensan construir uno. Explica cómo funcionan los modelos, las señales en las que se apoyan, por qué la precisión es más limitada de lo que sugiere una cifra de titular y las líneas éticas que conviene trazar antes de que alguien vea una puntuación. Forma parte de la sección IA en recursos humanos y se apoya en la analítica de personas y la IA.
Datos clave
- Los empleadores de Estados Unidos registraron 3,1 millones de renuncias voluntarias en agosto de 2026, una tasa de renuncias del 1,9 por ciento en el mes (BLS JOLTS). Irse en un mes cualquiera es un evento poco frecuente, y por eso predecirlo es difícil.
- Una revisión sistemática de 2024 en Expert Systems with Applications abarcó 52 estudios publicados entre 2012 y abril de 2023, encontró más de 20 técnicas de aprendizaje automático en uso e informó que el salario y las horas extra son los factores predictivos más críticos (Expert Systems with Applications, via UAEU).
- Un estudio de 2019 de la Universidad de Campinas entrenó un clasificador con registros de 8724 empleados de una empresa real de bebidas de Brasil e informó una precisión global del 79% sobre los datos de prueba (UNICAMP).
- Según el Artículo 22 del GDPR, las personas tienen derecho a no ser objeto de una decisión basada únicamente en el tratamiento automatizado, incluida la elaboración de perfiles, que les afecte de manera significativa, y los responsables deben ofrecer al menos intervención humana y una forma de impugnarla (EUR-Lex).
- La Comisión Europea clasifica como de alto riesgo las herramientas de IA para el empleo y la gestión de trabajadores, con reglas aplicables desde el 2 de diciembre de 2027, y clasifica el reconocimiento de emociones en los lugares de trabajo como una práctica prohibida (European Commission).
Cómo funcionan los modelos de rotación
En los términos del ACE Framework, un modelo de rotación ingiere datos estructurados de recursos humanos, analiza el historial de quién se quedó y quién se fue, y predice una probabilidad para las personas que aún no se han ido. Es el patrón de puntuación aplicado a su propia plantilla, a menudo con una capa de anomalías que señala un cambio repentino en un equipo.
La mecánica es sencilla de describir:
- Elija una ventana. «¿Se irá esta persona en los próximos 6 meses?» es una pregunta más clara que «¿Se irá?»
- Construya un historial. Para cada instantánea pasada, registre lo que sabía de la persona entonces y si se fue en la ventana siguiente.
- Entrene. Un modelo aprende qué patrones de la instantánea solían anteceder a una salida. Las técnicas comunes son la regresión logística, los árboles de decisión, los bosques aleatorios y los árboles con refuerzo del gradiente. Investigaciones más recientes usan aprendizaje profundo sobre trayectorias profesionales, como un artículo de arXiv de enero de 2025 que predice la rotación en varias empresas con un conjunto de datos del mundo real (arXiv).
- Puntúe a la plantilla actual. Cada persona que sigue en la empresa recibe una probabilidad.
- Explique. Un sistema útil también dice qué factores elevaron la puntuación, para que una persona pueda decidir si el motivo es real y corregible. Esta es la idea detrás de la IA explicable.
Dos puntos de enfoque evitan mucha confusión. Primero, se trata de analítica predictiva sobre un conjunto de datos pequeño y desequilibrado, que se comporta de forma muy distinta a predecir clics o compras. Segundo, una predicción describe correlación. Un modelo puede aprender que las personas sin ascenso en tres años suelen irse, sin decirle si un ascenso las habría retenido.
Señales predictivas comunes
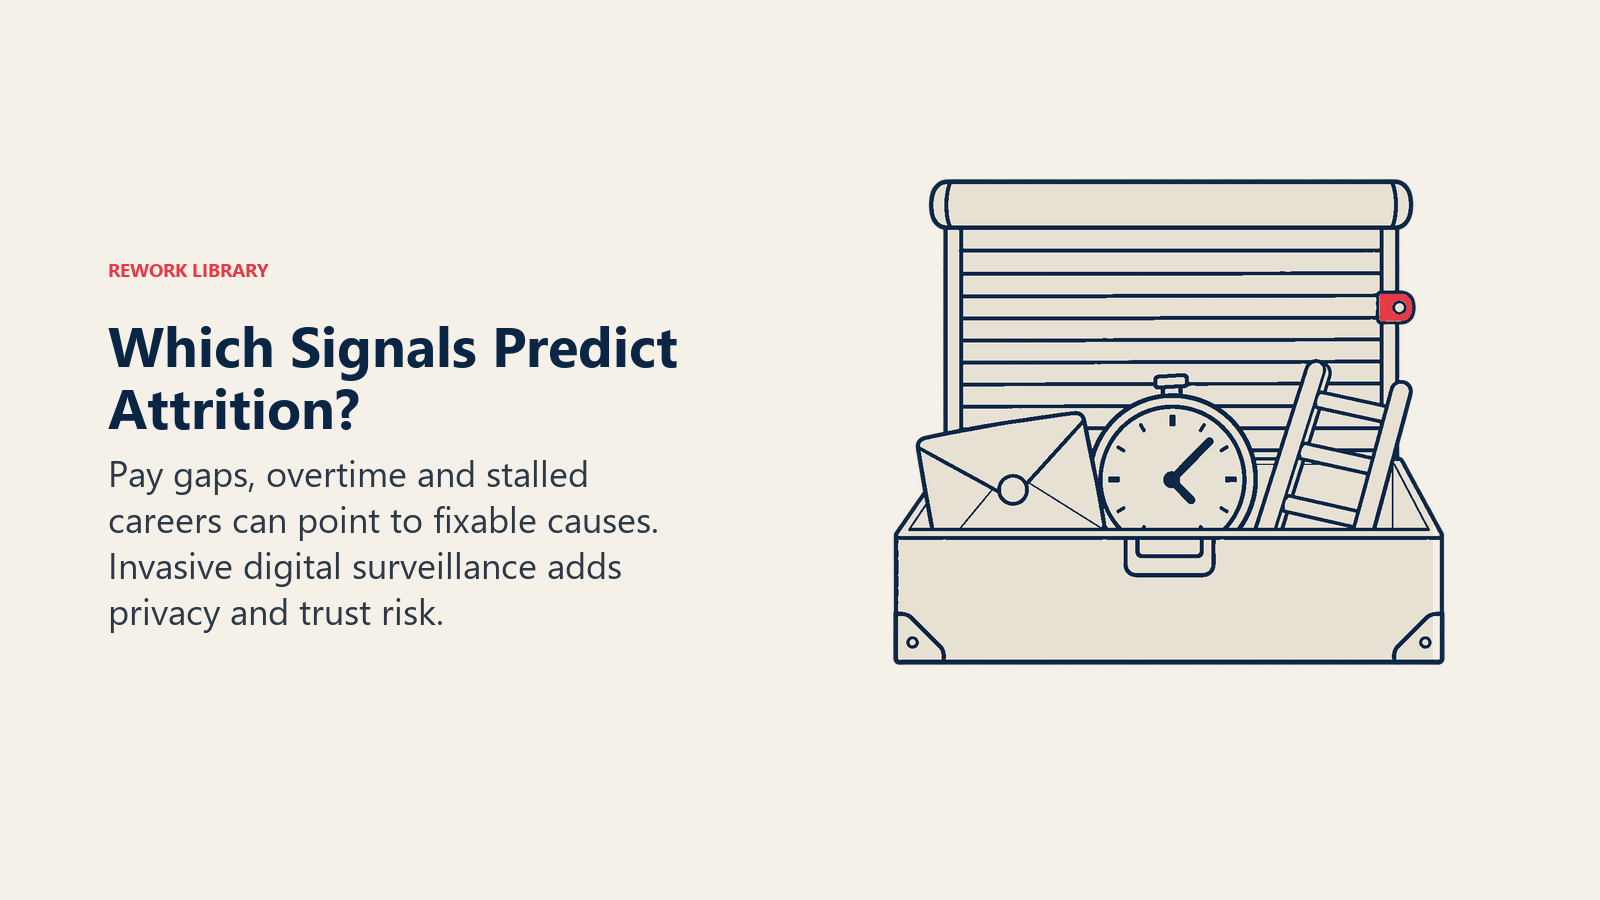
La mayoría de los modelos se nutre de unas pocas familias de datos. La tabla las agrupa según su utilidad y su sensibilidad habituales.
| Familia de señales | Ejemplos | Por qué predice las salidas | Sensibilidad |
|---|---|---|---|
| Compensación | Salario frente al mercado, tiempo desde el último aumento, cambios en bonos | Las brechas salariales dan a las personas un motivo para buscar | Media |
| Carga de trabajo | Horas extra, tiempo libre tomado, volatilidad de los horarios | La sobrecarga sostenida antecede al agotamiento y a las salidas | Media |
| Movimiento profesional | Tiempo en el puesto, ascensos, traslados internos, crecimiento de habilidades | Las carreras estancadas empujan a las personas hacia fuera | Baja |
| Gerente y equipo | Cambios de gerente, historial de salidas del equipo, tramo de control | Las salidas se agrupan en torno a gerentes concretos | Media |
| Antigüedad y etapa de vida | Tramo de antigüedad, distancia del trayecto al trabajo, edad | Las tasas de salida difieren según la etapa | Alta, puede servir de proxy de rasgos protegidos |
| Compromiso | Puntuaciones de encuestas, participación, temas de los comentarios | El desinterés suele aparecer primero | Media |
| Conductual y digital | Patrones de correo o calendario, datos de credenciales, actividad en bolsas de empleo | Refleja el retraimiento, pero es invasivo | Muy alta |
Los estudios de la revisión de 2024 señalan el salario y las horas extra como los factores más fuertes, lo cual concuerda con la intuición: se registran de forma fiable, cambian con el tiempo y se conectan con motivos reales para irse. Las señales del final de la tabla son aquellas con las que hay que ser más cuidadoso. La edad y la distancia del trayecto pueden sustituir en silencio a características protegidas. El rastro digital, como los patrones de mensajes o la navegación, es a la vez impreciso y corrosivo para la confianza, y en la UE inferir emociones en el trabajo está directamente prohibido.
Si quiere saber qué es realista alimentar a un modelo, comience con los fundamentos de datos de recursos humanos para la IA. La mayoría de los proyectos de rotación fallidos fracasan por la calidad de los datos, no por los algoritmos.
Límites de precisión que debe entender
Un proveedor que cita «90% de precisión» le dice muy poco. Esta es la razón.
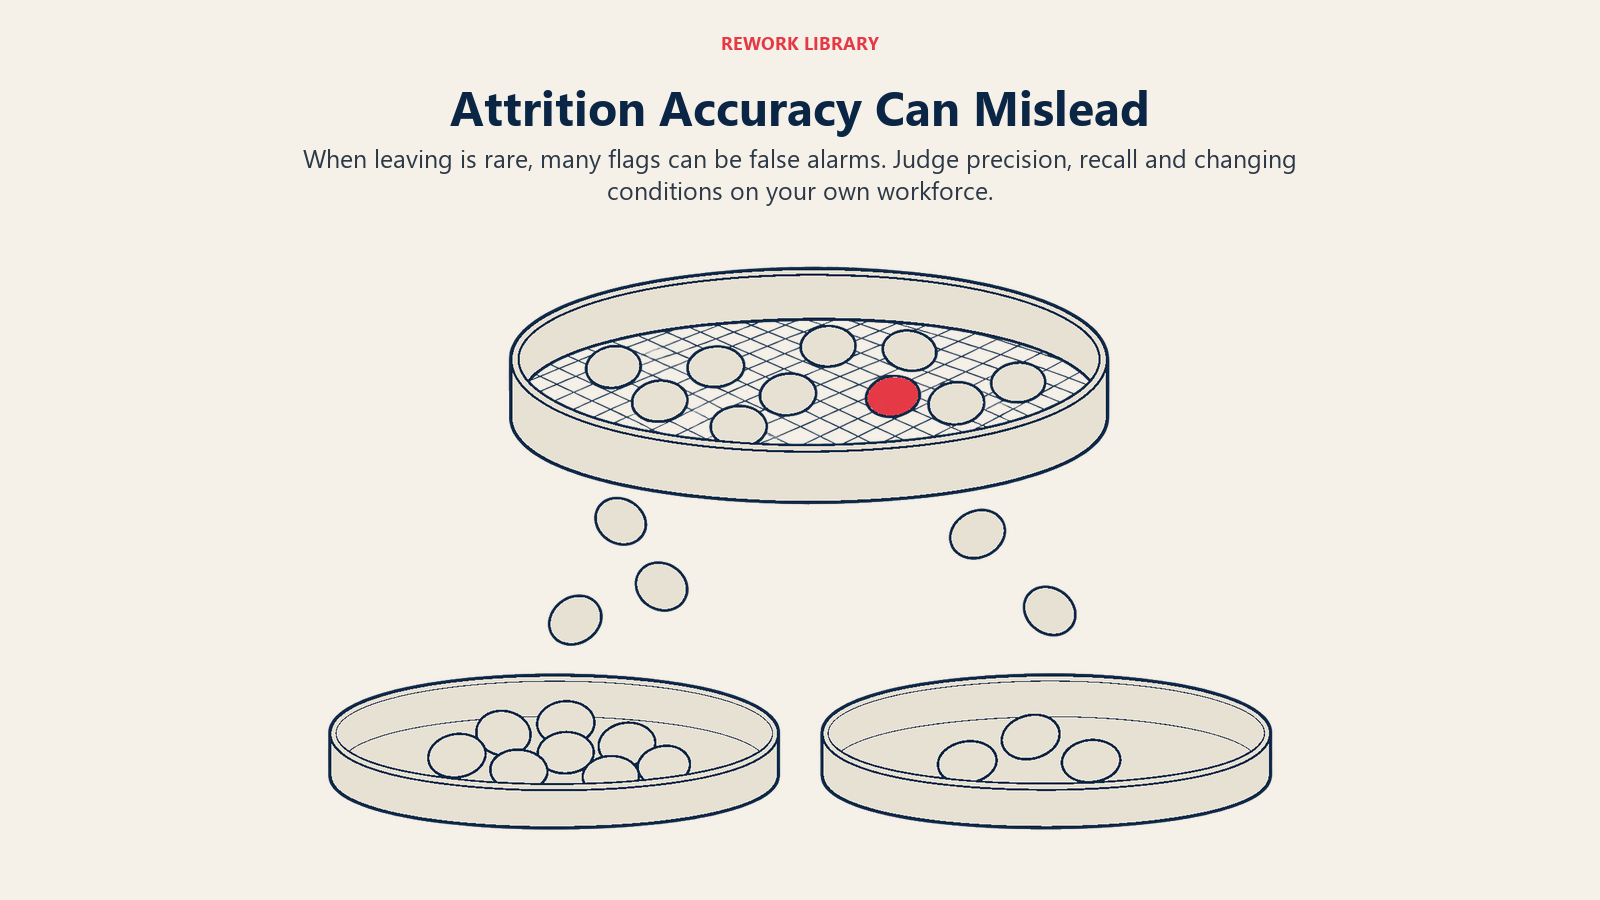
Irse es poco frecuente, así que la precisión halaga. El BLS informó una tasa de renuncias del 1,9 por ciento en agosto de 2026. Incluso a lo largo de un año, la mayoría de los empleados se queda. Un modelo que predice «todos se quedan» acierta casi siempre y no sirve de nada. La precisión debe sustituirse por medidas que se fijen en quienes se van: la exactitud (de las personas señaladas, cuántas se fueron), la sensibilidad o recall (de las personas que se fueron, cuántas fueron señaladas) y el AUC.
Las falsas alarmas superan a los aciertos. Esta es una ilustración hipotética, no un resultado medido. Tome 1000 empleados de los cuales 150 se irán este año. Un buen modelo detecta 105 de los 150 (70% de recall) y señala por error a 170 de los 850 que se quedan (20% de falsas alarmas). Son 275 personas señaladas, y solo 105 de ellas, alrededor del 38%, se van en realidad. Un gerente que mira esa lista está mirando sobre todo a personas que se habrían quedado.
Las cifras publicadas no son transferibles. El estudio de la empresa brasileña de bebidas informó una precisión global del 79% sobre una plantilla real de 8724 personas. Los resultados de una empresa, un periodo y un conjunto de campos rara vez se trasladan, y algunos estudios publicados se basan en archivos de muestra sintéticos de recursos humanos, que dicen poco sobre plantillas reales. Juzgue cualquier modelo con su propio historial.
El mundo cambia. Un modelo entrenado antes de una reorganización, un congelamiento salarial o un auge de contrataciones aprendió una plantilla distinta de la que tiene ahora. Las puntuaciones se desvían, y un modelo que nadie vuelve a probar sigue pareciendo autorizado mientras empeora.
Predicción no es causalidad. Incluso una buena puntuación solo le dice dónde mirar. La causa se descubre hablando con las personas.
Ejemplos reales por función
Socio estratégico de recursos humanos (HRBP). Un socio revisa el riesgo a nivel de equipo cada trimestre, no las puntuaciones individuales. Un grupo de ingeniería muestra un riesgo elevado, con muchas horas extra y sin ascensos en dos años. El socio lo plantea al director como un problema de carga de trabajo y de trayectoria profesional, sin señalar a ningún individuo.
Gerente de operaciones de primera línea. En una sede con turnos, la volatilidad de los horarios y los patrones de horas extra no pagadas predicen las salidas. El gerente corrige los roles y limita los turnos nocturnos consecutivos. El valor del modelo fue apuntar al proceso de programación, no a ningún trabajador.
Equipo de compensación. El modelo señala una y otra vez a personas que llevan mucho tiempo sin aumento en un puesto donde el salario de mercado subió. Compensación lo usa para hacer una revisión salarial dirigida, una acción clara y defendible con una justificación simple.
Liderazgo de ventas. A un director de ventas se le muestra que los representantes que no alcanzan la cuota dos trimestres seguidos se van en mayor proporción. La respuesta es coaching y revisión de territorios antes, no una advertencia al representante.
Jurídico y privacidad. El asesor jurídico confirma qué datos se pueden usar legalmente, qué aviso reciben los empleados y si se necesita una evaluación de impacto en la protección de datos. Este equipo debe estar presente antes del piloto, no después.
La ética de actuar ante una puntuación de riesgo de fuga
Una puntuación crea un nuevo tipo de información sobre una persona que ella no le dio y que quizá ignora que existe. La forma de manejarla es la verdadera prueba.
No deje que toque las decisiones sobre personas. Una puntuación de riesgo nunca debe reducir el acceso de alguien a ascensos, proyectos, formación o aumentos con el argumento de que de todos modos se va. Eso convierte una predicción en una profecía autocumplida. También puede ser ilegal: el Artículo 22 del GDPR limita las decisiones basadas únicamente en el tratamiento automatizado que afecten de manera significativa a las personas, y la EU AI Act trata la IA de empleo como de alto riesgo. Si opera en Estados Unidos o en otro lugar, las reglas difieren y siguen cambiando, así que busque asesoría jurídica para cada jurisdicción.
Use la puntuación para mejorar las condiciones, no para vigilar a individuos. Los usos más éticos corrigen las causas que el modelo sacó a la luz: brechas salariales, sobrecarga, carreras bloqueadas, un mal gerente. Los usos menos éticos avisan a un gerente de que una persona con nombre está «en riesgo» para que la gestione.
Mantenga las puntuaciones lejos de los gerentes de línea por defecto. Las vistas agregadas a nivel de equipo o departamento le dan la visión sin el etiquetado. Si hay que usar puntuaciones individuales, limite quién las ve, registre el porqué y elimínelas según un calendario.
Revise el sesgo. Compare los errores del modelo entre grupos definidos por género, edad, raza, discapacidad y situación de cuidador donde esté permitido hacerlo. Un modelo que señala en exceso a mujeres de unos treinta años porque el historial muestra más salidas en torno a la licencia parental está codificando un patrón, no una verdad. El concepto se explica en el sesgo en la IA.
Sea abierto al respecto. Diga a los empleados qué datos se usan y para qué. La puntuación en secreto daña la confianza más rápido que la mayor parte de la rotación.
Manténgase alejado de la vigilancia conductual. Leer mensajes, rastrear la navegación o inferir el estado de ánimo para detectar «retraimiento» es invasivo, propenso a errores y, en el caso del reconocimiento de emociones en la UE, está prohibido. Si una señal exige observar de cerca a las personas, es la señal equivocada.
Cómo implementar la predicción de rotación, paso a paso
- Defina primero la decisión. Escriba qué haría de otra manera si supiera dónde se concentra el riesgo. Si la respuesta es «nada», no lo construya.
- Empiece por la alternativa barata. Observe los datos de salidas, los temas de las entrevistas de salida, las puntuaciones de compromiso y las tasas de salida por gerente y tramo de antigüedad. Muchas organizaciones encuentran los grandes factores sin ningún modelo.
- Audite sus datos. Verifique que tiene registros coherentes de contrataciones, salidas (separando las voluntarias de las involuntarias), historial salarial, cambios de puesto y asignaciones de gerente durante al menos unos años. Excluya del objetivo las salidas involuntarias.
- Fije el alcance a nivel de equipo. Decida que los resultados se agregan, quién puede ver qué y qué acciones están dentro de los límites.
- Elija el modelo más simple que funcione. Una regresión logística o un modelo basado en árboles, con explicaciones, suele bastar. Compárelo con una línea base sencilla como «tramo de antigüedad más posición salarial».
- Pruebe con honestidad. Entrene con datos antiguos y pruebe con el periodo más reciente. Informe exactitud, recall y AUC, no solo precisión, y revise los errores entre grupos.
- Haga el trabajo de privacidad. Documente la base jurídica, realice una evaluación de impacto donde se exija e informe a los empleados.
- Haga un piloto con un circuito de revisión humana. Haga que RR. HH. se siente con los gerentes para preguntar si los factores coinciden con lo que ellos ven. Registre los casos en que el modelo se equivocó.
- Mida la intervención, no el modelo. El objetivo es reducir las salidas que se lamentan. Compare equipos tratados y no tratados, y vea si acciones como las revisiones salariales o los cambios de carga de trabajo movieron los resultados.
- Vuelva a probar según un calendario. Reevalúe al menos una vez al año y tras cualquier cambio organizacional importante.
Para ver cómo encaja esto en todo el recorrido del empleado, consulte la IA a lo largo del ciclo de vida del empleado. Y para saber quién es responsable de qué en una función de recursos humanos que adopta esto, consulte la IA y el modelo operativo de recursos humanos.
Errores comunes
- Comprar por una cifra de precisión de titular. Pida exactitud, recall, los datos usados y cómo se probó.
- Predecir antes de arreglar los datos. Una codificación desordenada de las salidas (renuncia frente a despido frente a jubilación) arruina la variable objetivo.
- Puntuar a individuos cuando bastarían los equipos. Las etiquetas individuales añaden riesgo y poca información.
- Ocultar el modelo. Si los empleados se enteran de una puntuación secreta, el daño supera cualquier beneficio.
- Tratar la puntuación como la causa. El modelo dice dónde mirar. Las personas le dicen por qué.
- Actuar solo sobre las puntuaciones altas. Algunas de sus mejores personas se van en silencio con puntuaciones bajas, y algunas personas señaladas están perfectamente asentadas.
- No volver a probar nunca. Un modelo obsoleto es seguro de sí mismo y está equivocado.
Preguntas frecuentes sobre la predicción de la rotación de empleados con IA
¿Qué es la predicción de rotación de empleados?
Es el uso del aprendizaje automático para estimar qué probabilidad tienen empleados o equipos de irse en un periodo determinado, a partir de datos de recursos humanos como salario, carga de trabajo, antigüedad, ascensos e historial de gerentes. El resultado es una probabilidad o una banda de riesgo que ayuda a RR. HH. a decidir dónde buscar causas corregibles.
¿Qué tan precisos son los modelos de predicción de rotación?
Depende en gran medida de los datos. Un estudio publicado sobre los 8724 empleados de una empresa real de bebidas de Brasil informó una precisión global del 79%, mientras que los resultados con otros conjuntos de datos difieren. Como irse es poco frecuente, la precisión por sí sola engaña, así que pida exactitud, recall y AUC medidos con su propio historial.
¿Qué datos predicen quién renunciará?
El salario y las horas extra son los factores más fuertes en una revisión de 2024 de 52 estudios. El movimiento profesional, los cambios de gerente, el historial de salidas del equipo y las puntuaciones de compromiso también ayudan. Los datos sensibles o invasivos, como los proxies de la edad, el contenido de los mensajes o la actividad de navegación, añaden riesgo con poca ganancia fiable.
¿Es legal predecir qué empleados se irán?
A menudo sí, con condiciones. En la UE, el Artículo 22 del GDPR restringe las decisiones basadas únicamente en el tratamiento automatizado que afecten de manera significativa a las personas, y la AI Act clasifica la IA de empleo como de alto riesgo, con reglas aplicables desde el 2 de diciembre de 2027. Las reglas varían según el país, así que involucre a un asesor jurídico y mantenga a una persona en cualquier decisión sobre un individuo.
¿Deberían los gerentes ver las puntuaciones individuales de riesgo de fuga?
Por defecto, no. Las vistas a nivel de equipo le dan la visión sin etiquetar a nadie, y las puntuaciones individuales invitan a los gerentes a tratar a las personas como si ya se hubieran ido. Si debe usar puntuaciones individuales, restrinja el acceso, documente el propósito y nunca las use para negar aumentos, proyectos o ascensos.
¿Qué debemos hacer cuando el modelo señala a un equipo?
Tómelo como una invitación a investigar. Revise la posición salarial, las horas extra, el historial de ascensos y los cambios de gerente, hable con el equipo y cambie lo que pueda. Luego mida si las salidas bajan, porque el valor está en la intervención, no en la puntuación.

Senior Customer Retention Strategist