Modelado de Probabilidad: Cálculo de Probabilidad de Cierre Basado en Datos
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
El modelado de probabilidad de pipeline utiliza métodos estadísticos para calcular qué tan probable es que cada deal cierre, reemplazando los porcentajes fijos por etapa y las conjeturas de los representantes con predicciones basadas en datos reales de resultados. Los modelos ponderan el tamaño, la antigüedad, la actividad y las señales de stakeholders del deal frente a patrones históricos, de modo que su pipeline ponderado refleje lo que realmente cierra y no lo que los representantes esperan que cierre.
La mayoría de los forecasts de ventas son ficción disfrazada de datos.
Tiene representantes ingresando probabilidades del 75% en deals con un 15% de probabilidad de cierre. Tiene revisiones de pipeline donde la "intuición" se disfraza de perspectiva. Y tiene ejecutivos tomando decisiones de recursos basadas en números que no tienen relación con la realidad.
¿El costo? Trimestres fallidos. Planes de capacidad arruinados. Pagos de compensación de ventas que recompensan la suerte sobre la habilidad. Y una brecha de credibilidad permanente entre lo que ventas dice que sucederá y lo que realmente pasa.
Si se toma en serio la precisión del forecast y la predictibilidad de ingresos, necesita reemplazar la intuición con ciencia de datos. Ahí es donde entra el modelado de probabilidad.
¿Qué es el Modelado de Probabilidad?
El modelado de probabilidad aplica métodos estadísticos para calcular la probabilidad de que una oportunidad específica cierre. En lugar de depender del juicio del representante de ventas o porcentajes fijos de etapa, los modelos de probabilidad analizan múltiples puntos de datos, características del deal, señales de comportamiento, patrones históricos, para generar predicciones fundamentadas empíricamente.
El objetivo no es la predicción perfecta. Eso es imposible. El objetivo es superar consistentemente el juicio humano a escala, proporcionando precisión de forecast que se acumula en mejor planificación, asignación de recursos y decisiones estratégicas.
Por Qué Fallan los Enfoques Tradicionales
La mayoría de las organizaciones comienzan con probabilidad simple basada en etapas vinculada a su diseño de etapas del pipeline:
- Descubrimiento: 10%
- Calificación: 25%
- Propuesta: 50%
- Negociación: 75%
- Cerrado Ganado: 100%
Este enfoque tiene exactamente una ventaja: es fácil de implementar. Pero tiene muchas desventajas.
Ignora factores específicos del deal. Un deal de $10K en Negociación tiene probabilidad de cierre muy diferente a un deal de $1M en la misma etapa. La etapa sola explica quizás el 30-40% de la varianza en resultados de cierre.
Asume progresión lineal. Los deals no se mueven uniformemente a través de las etapas. Algunos saltan de Descubrimiento a Negociación. Otros rebotan entre Propuesta y Calificación por meses. Las probabilidades estáticas de etapa no pueden capturar esta complejidad.
Fomenta la manipulación. Cuando las probabilidades están fijas por etapa, los representantes aprenden a manipular la progresión de etapa para alcanzar objetivos de forecast. Los datos se contaminan por cambios de etapa estratégicos en lugar de progresión real del deal.
No proporciona ciclo de retroalimentación. Porque las probabilidades son fijas, no hay mecanismo para aprender de los resultados y mejorar las predicciones con el tiempo.
El modelado avanzado de probabilidad aborda estas limitaciones.
Entradas y Factores de Probabilidad
Los buenos modelos de probabilidad incorporan múltiples categorías de señales:
1. Etapa del Pipeline
La etapa sigue siendo relevante, captura la progresión a través de un proceso de ventas definido, pero es un factor entre muchos en lugar del único determinante.
Lo que importa es medir las tasas reales de salida de etapa de sus datos históricos, no usar promedios de la industria u objetivos aspiracionales. Si su etapa de "Negociación" históricamente cierra al 42%, esa es su línea base. No 75%.
2. Antigüedad del Deal
El tiempo desde la creación de la oportunidad o entrada a la etapa correlaciona fuertemente con la probabilidad de cierre. Los deals que permanecen en etapas más allá de los tiempos de ciclo típicos muestran tasas de cierre en declive. La gestión efectiva de antigüedad de deals requiere entender estos patrones.
Los buenos modelos rastrean antigüedad absoluta (días desde la creación de la oportunidad), antigüedad de etapa (días en la etapa actual) y velocidad esperada versus real (desviación de las normas históricas).
¿Un deal que ha estado en Propuesta por 90 días cuando su mediana es 14 días? La probabilidad debería reflejar esa realidad.
3. Tamaño del Deal
El valor del deal influye en la probabilidad de cierre de maneras no lineales. Deals muy pequeños pueden tener menor rigor de calificación, llevando a mayores tasas de descalificación. Deals muy grandes enfrentan ciclos más largos, más stakeholders y escrutinio elevado.
La relación varía según su modelo de negocio, valor promedio de contrato y distribución de tamaño de deals. El modelo aprende estos patrones de los resultados históricos.
4. Patrones de Actividad
Frecuencia de reuniones, engagement de email, volumen de llamadas y completación de demos señalan la salud del deal. Pero los conteos de actividad crudos importan menos que los patrones: ¿El engagement está aumentando o disminuyendo? ¿Está llegando a los tomadores de decisiones? ¿Los prospectos están iniciando contacto? ¿Se están completando las acciones de seguimiento? Entender la velocidad del pipeline ayuda a contextualizar estos patrones.
Los modelos que incorporan señales de actividad típicamente mejoran la precisión en 15-25% sobre enfoques solo de etapa.
5. Engagement de Stakeholders
Los deals B2B requieren consenso entre múltiples stakeholders. Los modelos que factorizan la diversidad de roles de contacto, identificación del champion y engagement de tomadores de decisiones consistentemente superan a los que no lo hacen.
Las señales clave incluyen número de contactos registrados, roles representados (comprador económico, evaluador técnico, champion), nivel de engagement ejecutivo y dinámicas de comité versus tomador de decisiones único.
6. Tasas de Cierre Históricas
El factor más predictivo es a menudo la similitud con deals cerrados pasados. Los modelos pueden comparar oportunidades actuales contra cohortes históricas basándose en:
- Coincidencia de industria/vertical
- Segmento de tamaño de empresa
- Tipo de producto/solución
- Competencia encontrada
- Canal de origen
Si los deals de una fuente de leads específica históricamente cierran al 18%, las nuevas oportunidades de esa fuente deberían heredar esa línea base, ajustada por otros factores. Esto conecta directamente con iniciativas de mejora de tasa de cierre.
7. Rendimiento del Representante de Ventas
Las tasas de cierre individuales de los representantes varían significativamente. Un modelo que incorpora el rendimiento histórico a nivel de representante, mientras considera la calidad del territorio y el tamaño de la muestra, produce forecasts más precisos que uno que trata a todos los representantes idénticamente.
Esto no se trata de culpar a los que tienen bajo rendimiento. Se trata de ponderar con precisión cada oportunidad basándose en toda la información disponible, incluyendo quién está manejando el deal.
8. Factores Estacionales y Temporales
Muchos negocios exhiben patrones estacionales:
- Gasto de presupuesto en Q4
- Meses de verano lentos
- Urgencia de fin de trimestre
- Dinámicas de fin de año fiscal
Los modelos pueden incorporar estos efectos temporales, ajustando probabilidades basándose en el timing de la fecha de cierre y patrones históricos de conversión estacional.
Enfoques de Modelado de Probabilidad
Los enfoques de modelado de probabilidad difieren según se apoyen en valores por defecto de etapa, conversión histórica, criterio del representante o señales predictivas.
Las organizaciones típicamente progresan a través de varios niveles de sofisticación de modelado:
Simple: Solo Basado en Etapas
Cómo funciona: Porcentajes fijos asignados a cada etapa del pipeline.
Pros: Fácil de implementar, universalmente entendido, no requiere ciencia de datos.
Contras: Ignora factores específicos del deal, fomenta la manipulación, sin mecanismo de aprendizaje.
Precisión típica: 40-60% de los deals cierran dentro de 10 puntos porcentuales de la probabilidad predicha.
Mejor para: Empresas en etapa temprana con datos históricos limitados (<100 deals cerrados).
Intermedio: Etapa + Ajuste Manual
Cómo funciona: La etapa proporciona probabilidad base. Los representantes ajustan basándose en su juicio de calidad del deal, a menudo informado por criterios de calificación de oportunidades.
Pros: Incorpora conocimiento del representante, flexible para situaciones únicas.
Contras: Altamente subjetivo, propenso a sesgo de optimismo, difícil de auditar o mejorar.
Precisión típica: 45-65% dentro de 10 puntos porcentuales. La mejora sobre solo etapa es marginal porque los sesgos persisten.
Mejor para: Equipos pequeños donde el juicio del representante está bien calibrado y la gerencia puede verificar los ajustes.
Avanzado: Modelos Estadísticos Multi-Factor
Cómo funciona: Regresión logística o técnicas estadísticas similares analizan resultados históricos para ponderar múltiples factores (etapa, antigüedad, tamaño, actividades, etc.) y calcular puntuaciones de probabilidad.
Pros: Basado en datos, incorpora múltiples señales, mejora con el tiempo a medida que se acumulan más resultados, auditable.
Contras: Requiere suficientes datos históricos (500+ oportunidades cerradas), necesita reentrenamiento periódico, menos intuitivo para equipos de ventas.
Precisión típica: 65-80% dentro de 10 puntos porcentuales, con mejora continua.
Mejor para: Empresas en crecimiento y enterprise con higiene de CRM madura y suficientes datos históricos.
IA/ML: Algoritmos Predictivos
Cómo funciona: Algoritmos de machine learning (random forests, gradient boosted trees, redes neuronales) identifican relaciones complejas y no lineales a través de docenas o cientos de características.
Pros: Captura patrones sutiles invisibles para analistas humanos, maneja interacciones de características, proporciona la mayor precisión.
Contras: Requiere grandes conjuntos de datos (2,000+ oportunidades cerradas), la naturaleza de caja negra complica la explicación, demanda experiencia en ML o inversión en plataforma.
Precisión típica: 75-85% dentro de 10 puntos porcentuales en implementación madura.
Mejor para: Organizaciones enterprise con infraestructura de datos robusta, capacidades de ML y deals de alto valor donde las mejoras de precisión justifican la inversión.
Análisis de Datos Históricos
Construir un modelo de probabilidad efectivo requiere minar sus datos históricos de deals para encontrar patrones. Este no es un ejercicio de una sola vez, es una práctica continua.
Requisitos de Datos
Conjunto de datos mínimo viable:
- 500+ oportunidades cerradas (ganadas + perdidas)
- 12+ meses de historial
- Seguimiento limpio de progresión de etapas
- Prácticas consistentes de creación de oportunidades
- Registro básico de actividades
Para modelos avanzados:
- 2,000+ oportunidades cerradas
- 24+ meses de historial
- Registros detallados de actividad (reuniones, emails, llamadas)
- Datos de rol de contacto
- Detalle de producto/servicio
- Inteligencia competitiva
Proceso Analítico
1. Definición de cohortes: Segmente las oportunidades históricas por dimensiones relevantes (bandas de tamaño de deal, verticales, productos, antigüedad del representante, fuente de lead).
2. Cálculo de tasa de cierre: Calcule las tasas de cierre reales para cada cohorte en cada etapa. Esto se convierte en su línea base empírica, reemplazando porcentajes genéricos.
3. Análisis de velocidad: Mida la mediana y distribución de duraciones de etapa y tiempo total de ciclo. Los deals que se desvían significativamente de estas normas justifican ajustes de probabilidad. Las organizaciones enfocadas en reducción del ciclo de ventas pueden usar estos insights para identificar oportunidades de optimización.
4. Correlación de características: Identifique qué factores correlacionan más fuertemente con resultados de cierre ganado. No todas las señales importan igual. Enfoque la complejidad del modelo en factores de alta señal.
5. Entrenamiento del modelo: Use datos históricos para entrenar modelos estadísticos o de ML. Divida los datos en conjuntos de entrenamiento (70%), validación (15%) y prueba (15%) para evitar overfitting.
6. Prueba de precisión: Mida el rendimiento del modelo en datos de prueba retenidos. Las métricas clave incluyen calibración (¿las probabilidades del 60% realmente cierran el 60% del tiempo?) y discriminación (¿puede el modelo separar ganadores de perdedores?).
Modelado Basado en Cohortes
Un enfoque de modelado poderoso agrupa oportunidades similares en cohortes y aplica tasas de conversión específicas de cohorte.
Definiendo Cohortes Significativas
Las cohortes efectivas balancean especificidad (suficientemente estrechas para ser predictivas) con tamaño de muestra (suficientemente grandes para significancia estadística).
Ejemplos:
- Tamaño del deal + etapa: "Oportunidades de $50-100K en Propuesta"
- Industria + producto: "Deals de salud para solución de cumplimiento"
- Fuente + etapa: "Solicitudes de demo inbound en Descubrimiento"
- Segmento de representante + tamaño: "AEs Enterprise con deals de $200K+"
El objetivo es crear grupos donde la varianza interna en tasas de cierre sea baja y la varianza entre grupos sea alta. Técnicas estadísticas como árboles de decisión identifican naturalmente estas divisiones.
Aplicando Probabilidades de Cohorte
Una vez que las cohortes están definidas con tasas de cierre históricas, las nuevas oportunidades se asignan a la cohorte apropiada y heredan esa probabilidad base.
Ejemplo: Un deal de $75K en etapa de Propuesta de una fuente inbound podría coincidir con la cohorte "$50-100K, Propuesta, Inbound" con una tasa de cierre histórica del 47%. Eso se convierte en la probabilidad inicial, potencialmente ajustada por otros factores en tiempo real.
Membresía Dinámica de Cohorte
A medida que los deals progresan, se mueven entre cohortes. Un deal que avanza de Propuesta a Negociación cambia a una nueva cohorte con una probabilidad base diferente. Los cambios de etapa afectan así la probabilidad, pero basándose en datos empíricos en lugar de suposiciones fijas.
Probabilidad Dinámica
Los modelos más sofisticados tratan la probabilidad como un valor que se actualiza continuamente respondiendo a nuevas señales en tiempo real.
Ajustes Basados en Disparadores
Eventos específicos disparan recálculos de probabilidad. La gestión efectiva de progresión de deals asegura que estos eventos se rastreen correctamente:
- Progresión de etapa: Avanzar o retroceder etapas
- Picos o brechas de actividad: Aumento repentino en engagement o silencio
- Cambios de stakeholders: Nuevo champion identificado o salida de contacto clave
- Decaimiento de tiempo: Deal envejeciendo más allá de la velocidad esperada
- Cambios de fecha de cierre: Empujando la fecha de cierre esperada hacia adelante
Cada disparador alimenta el modelo, que recalcula la probabilidad incorporando la nueva información.
Actualización Bayesiana
Un enfoque bayesiano comienza con una probabilidad previa (basada en cohorte o factores iniciales) y la actualiza a medida que se acumula evidencia. Cada nuevo punto de datos, una reunión completada, una propuesta enviada, una semana de inactividad, actualiza la estimación de probabilidad posterior.
Este enfoque maneja elegantemente la incertidumbre e incorpora información asimétricamente: señales positivas fuertes aumentan la probabilidad más que señales débiles, y la evidencia desconfirmante reduce apropiadamente las estimaciones.
Decaimiento de Señal
No todos los puntos de datos tienen el mismo peso con el tiempo. Una demo realizada hace 90 días es menos predictiva que una completada la semana pasada. Los modelos dinámicos pueden degradar la influencia de señales más antiguas mientras enfatizan el engagement reciente.
Esto previene que datos obsoletos inflen o supriman artificialmente las probabilidades en deals donde las circunstancias han cambiado.
Anulaciones de Probabilidad
Incluso el mejor modelo ocasionalmente malinterpretará una situación que el representante entiende mejor. Los mecanismos de anulación proporcionan flexibilidad necesaria mientras mantienen la auditabilidad.
Cuándo las Anulaciones Tienen Sentido
Escenarios legítimos de anulación:
- Circunstancias únicas del deal: Fusión, adquisición o cambio de liderazgo afectando el cronograma
- Información externa: Pérdida competitiva o aprobación inesperada de presupuesto no capturada en el CRM
- Insights de relación: Relación personal con el tomador de decisiones proporcionando confianza que el modelo no puede ver
- Desviaciones del proceso: Deal siguiendo camino no estándar (por ejemplo, fast track liderado por ejecutivo)
Gobernanza de Anulaciones
Las anulaciones sin control anulan el propósito del modelado. La gobernanza efectiva incluye:
Requerir justificación: Los representantes deben documentar por qué están anulando y qué información justifica el cambio.
Limitar magnitud: Topes en el tamaño de la anulación (por ejemplo, ±20 puntos porcentuales) previenen el reemplazo total de las predicciones del modelo.
Rastrear precisión: Monitoree si los deals anulados cierran a las probabilidades anuladas o a las probabilidades del modelo. Si los representantes consistentemente anulan hacia abajo y los deals aún cierran, esa es retroalimentación útil. Si anulan hacia arriba y los deals consistentemente fallan, esa es una oportunidad de coaching de pipeline.
Umbrales de aprobación: Anulaciones grandes o anulaciones en deals de alto valor pueden requerir aprobación del gerente.
Ciclos de retroalimentación: Los resultados de anulación alimentan el entrenamiento del modelo. Si los representantes repetidamente anulan por razones similares y resultan correctos, esa señal debería incorporarse al modelo.
Validación del Modelo
Construir un modelo es fácil. Construir un modelo preciso que mejore con el tiempo requiere validación rigurosa.
Prueba de Calibración
Un modelo bien calibrado asigna probabilidades que coinciden con resultados reales a través de bandas de probabilidad.
Pruebe: Agrupe oportunidades históricas por bandas de probabilidad predicha (0-10%, 10-20%, ..., 90-100%). Calcule las tasas de cierre reales dentro de cada banda. Un modelo calibrado muestra alineación cercana.
Ejemplo:
- Probabilidad predicha 50-60% → 48% real cerrado (bien calibrado)
- Probabilidad predicha 70-80% → 58% real cerrado (sobreconfiado)
La mala calibración indica sesgo sistemático que requiere reentrenamiento del modelo o ingeniería de características.
Análisis de Discriminación
La discriminación mide la capacidad del modelo para separar deals que cierran de los que no.
Métricas clave:
- AUC-ROC: Área Bajo la Curva de Característica Operativa del Receptor. Valores sobre 0.75 indican buena discriminación, sobre 0.85 excelente.
- Precisión-Recall: ¿A qué umbral de probabilidad predicha el modelo identifica correctamente deals cerrables sin excesivos falsos positivos?
Alta discriminación significa que el modelo no solo está bien calibrado en promedio, realmente está ordenando oportunidades por verdadera probabilidad de cierre.
Análisis de Error del Forecast
La prueba definitiva: ¿el modelo mejora la precisión del forecast del pipeline ponderado?
Compare:
- Pipeline ponderado total predicho (suma de valores de oportunidad × probabilidades)
- Ingresos cerrados reales sobre el período de forecast
Calcule el error absoluto medio porcentual (MAPE) y compare contra enfoques de forecasting anteriores. Un buen modelo debería reducir MAPE en 20-40% versus forecasting basado en etapas.
Monitoreo Continuo
El rendimiento del modelo se degrada con el tiempo a medida que:
- Las condiciones del negocio cambian
- El product/market fit evoluciona
- Los procesos de ventas maduran
- La composición del equipo cambia
Implemente revisiones trimestrales del modelo examinando:
- Métricas recientes de calibración y discriminación
- Tendencias de error del forecast
- Deriva de importancia de características (¿los factores que importaban hace seis meses siguen siendo predictivos?)
- Estabilidad de cohortes (¿han cambiado las tasas de cierre históricas?)
Reentrene los modelos cuando el rendimiento se degrade o anualmente como mínimo.
Implementación
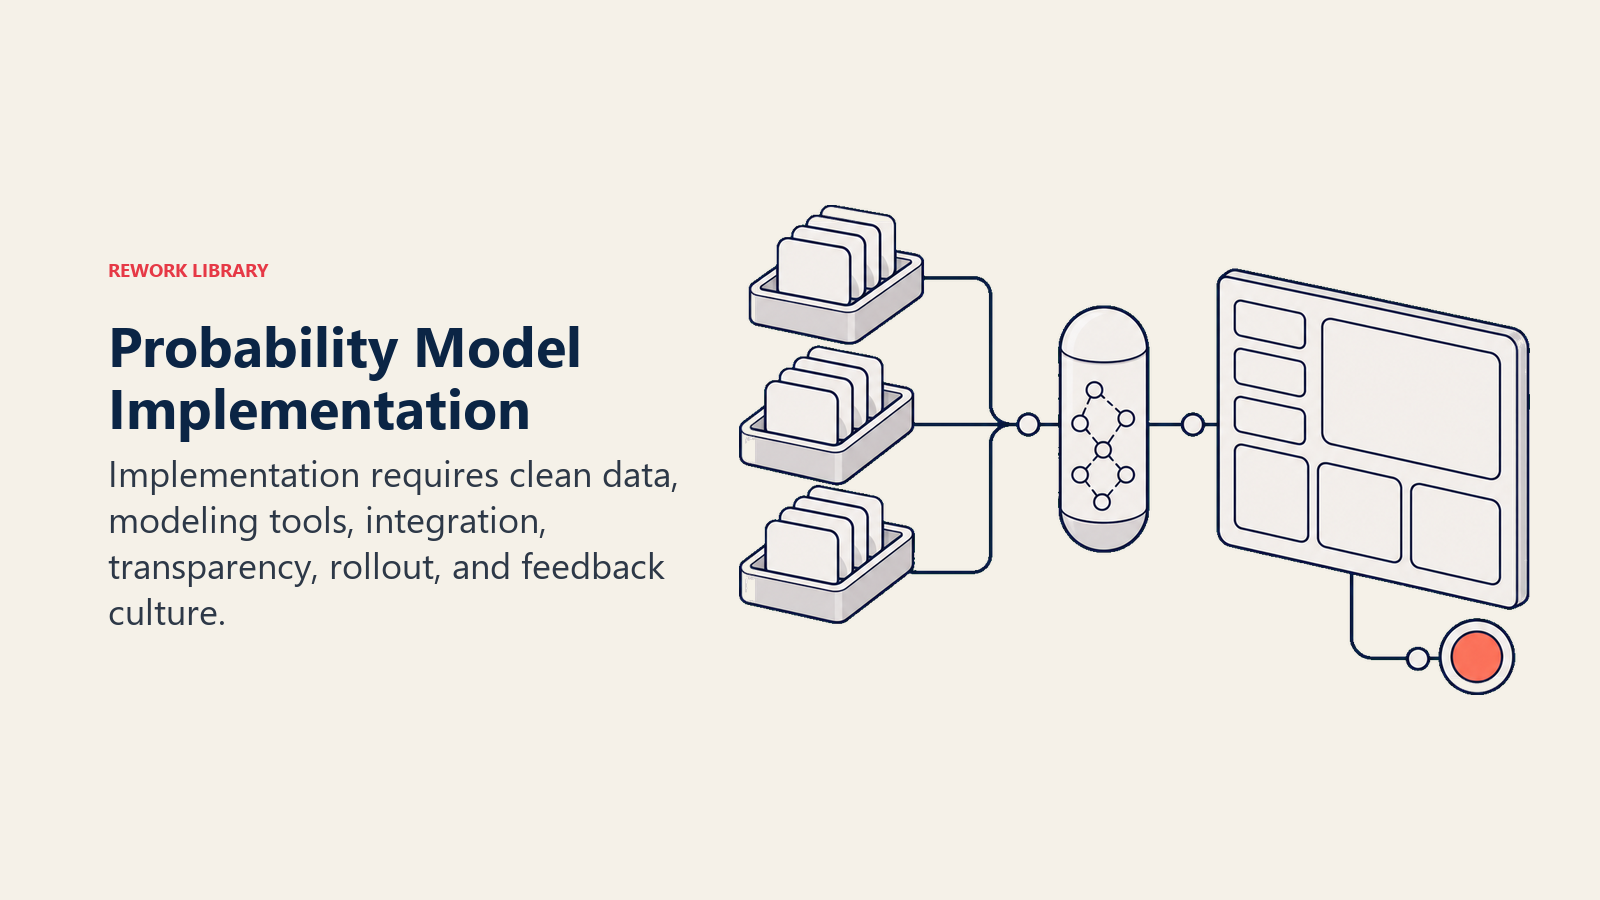
Desplegar exitosamente el modelado de probabilidad requiere abordar tecnología, proceso y gestión del cambio.
Requisitos de Tecnología
Infraestructura de datos: Datos de CRM limpios y centralizados con seguimiento consistente de oportunidades, definiciones de etapa y registro de actividades. Mantener la higiene del pipeline es esencial, basura entra = predicciones basura salen.
Plataforma de modelado: Las opciones van desde:
- Nativas de CRM: Salesforce Einstein, Microsoft Dynamics Insights
- Analítica de ventas especializada: Clari, Gong Forecast, People.ai
- Modelos personalizados: Modelos Python/R desplegados vía API al CRM
La elección depende del volumen de datos, sofisticación de modelado requerida y capacidad interna de ciencia de datos.
Arquitectura de integración: Los modelos deben integrarse con herramientas existentes, CRM, dashboards de forecasting basado en etapas, sistemas de reporting, para proporcionar predicciones donde los equipos ya trabajan.
Gestión del Cambio
El modelado de probabilidad falla más a menudo por problemas de adopción que por problemas técnicos.
Patrocinio ejecutivo: RevOps o liderazgo de ventas debe ser campeón del modelo, explicar el "por qué", y comprometerse a usar los outputs del modelo en la toma de decisiones.
Transparencia: Comparta cómo funciona el modelo, qué factores considera, y por qué supera la intuición. Los sistemas de caja negra generan desconfianza.
Despliegue gradual: Comience con modo de reporte (mostrando predicciones del modelo junto con probabilidades existentes) antes de hacer los outputs del modelo autoritativos. Esto construye confianza e identifica casos extremos.
Entrenamiento: Los equipos de ventas necesitan entender qué comportamientos mejoran la probabilidad del deal (expansión de stakeholders, actividad consistente, mantenimiento de velocidad) versus qué no afecta las predicciones del modelo (pensamiento esperanzador, sandbagging).
Alineación de incentivos: Si los planes de compensación aún recompensan la precisión del forecast basada en probabilidades ingresadas por el representante, los representantes manipularán el sistema. Alinee incentivos con la adopción del modelo.
Cultura de Retroalimentación
Los mejores modelos mejoran continuamente porque las organizaciones tratan los errores de predicción como oportunidades de aprendizaje.
Después de cada trimestre:
- Revise deals que cerraron a pesar de baja probabilidad predicha (¿qué señales perdió el modelo?)
- Revise deals que fallaron a pesar de alta probabilidad predicha (¿qué señales de advertencia se ignoraron?)
- Actualice definiciones de cohorte y conjuntos de características basándose en hallazgos
- Reentrene modelos incorporando los resultados más recientes
Realizar análisis exhaustivo de deals perdidos proporciona insights críticos para el refinamiento del modelo. Este volante, predicción, observación de resultados, análisis, mejora del modelo, se acumula en precisión de forecast creciente con el tiempo.
La Ventaja Competitiva del Modelado de Probabilidad
Las organizaciones que dominan el modelado de probabilidad obtienen ventajas que se acumulan:
Asignación de recursos: Invierta tiempo de coaching, soporte de ingeniería de ventas e involucramiento ejecutivo en oportunidades de alta probabilidad en lugar de distribuir recursos uniformemente.
Gestión de pipeline: Identifique deals en riesgo temprano basándose en decaimiento de probabilidad, permitiendo intervención proactiva en lugar de sorpresas de fin de trimestre.
Planificación de capacidad: El pipeline ponderado preciso permite mejores decisiones de contratación, establecimiento de cuotas y diseño de territorios. Combinado con análisis de cobertura de pipeline, las organizaciones pueden tomar decisiones de asignación de recursos más confiadas.
Claridad estratégica: Cuando los forecasts consistentemente coinciden con los resultados, el liderazgo puede hacer inversiones de crecimiento, decisiones de producto y elecciones de expansión de mercado con confianza en lugar de cubrirse contra la volatilidad del forecast.
Más importante aún, el modelado de probabilidad cambia la conversación de discutir sobre la calidad del deal a diagnosticar por qué ciertos patrones de deal tienen éxito y otros fallan, permitiendo mejora sistemática en lugar de esperanza perpetua.
Conclusión: De Intuición a Ciencia de Datos
Las ventas siempre retendrán elementos de arte, construcción de relaciones, matices de negociación, lectura de dinámicas de sala. Pero el forecasting no debería ser arte. Debería ser ciencia.
El modelado de probabilidad transforma el forecasting de narración a predicción estadística. No porque los modelos sean perfectos, sino porque son consistentemente mejores que el juicio humano, mejoran con el tiempo, y proporcionan auditabilidad que la intuición nunca puede.
La progresión es clara: reemplace las probabilidades fijas de etapa con líneas base empíricas de cohorte, agregue factores específicos del deal (tamaño, antigüedad, actividades), implemente actualización dinámica a medida que evolucionan las señales, agregue IA/ML cuando el volumen de datos lo soporte, y cierre el ciclo con validación rigurosa y mejora continua.
Las organizaciones que hacen este viaje no solo pronostican mejor. Operan mejor, tomando decisiones más inteligentes, haciendo coaching más efectivo, y construyendo motores de ingresos predecibles.
La pregunta no es si adoptar el modelado de probabilidad. Es qué tan rápido puede llegar allí antes de que sus competidores lo hagan.
Aprenda más:
- Pipeline Ponderado: La Base del Forecasting Preciso
- Forecasting Basado en Etapas: Construyendo el Marco para Predicción de Ingresos
- Predictibilidad de Ingresos: El Objetivo Final de la Gestión de Pipeline
- Fundamentos del Forecasting: Conceptos Esenciales para Líderes de Ingresos
- Resumen de Métricas de Pipeline: Mediciones Clave para el Éxito de Ventas
On this page
- ¿Qué es el Modelado de Probabilidad?
- Por Qué Fallan los Enfoques Tradicionales
- Entradas y Factores de Probabilidad
- 1. Etapa del Pipeline
- 2. Antigüedad del Deal
- 3. Tamaño del Deal
- 4. Patrones de Actividad
- 5. Engagement de Stakeholders
- 6. Tasas de Cierre Históricas
- 7. Rendimiento del Representante de Ventas
- 8. Factores Estacionales y Temporales
- Enfoques de Modelado de Probabilidad
- Simple: Solo Basado en Etapas
- Intermedio: Etapa + Ajuste Manual
- Avanzado: Modelos Estadísticos Multi-Factor
- IA/ML: Algoritmos Predictivos
- Análisis de Datos Históricos
- Requisitos de Datos
- Proceso Analítico
- Modelado Basado en Cohortes
- Definiendo Cohortes Significativas
- Aplicando Probabilidades de Cohorte
- Membresía Dinámica de Cohorte
- Probabilidad Dinámica
- Ajustes Basados en Disparadores
- Actualización Bayesiana
- Decaimiento de Señal
- Anulaciones de Probabilidad
- Cuándo las Anulaciones Tienen Sentido
- Gobernanza de Anulaciones
- Validación del Modelo
- Prueba de Calibración
- Análisis de Discriminación
- Análisis de Error del Forecast
- Monitoreo Continuo
- Implementación
- Requisitos de Tecnología
- Gestión del Cambio
- Cultura de Retroalimentación
- La Ventaja Competitiva del Modelado de Probabilidad
- Conclusión: De Intuición a Ciencia de Datos