Modélisation des probabilités : calculer la probabilité de closing à partir des données
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
La modélisation des probabilités du pipeline s'appuie sur des méthodes statistiques pour calculer la probabilité que chaque deal se conclue. Elle remplace les pourcentages fixes par étape et l'intuition des commerciaux par des prédictions fondées sur des résultats réels. Les modèles pondèrent la taille du deal, son ancienneté, l'activité et les signaux des parties prenantes à partir des tendances historiques : votre pipeline pondéré reflète ainsi ce qui se conclut réellement, et non ce que vos commerciaux espèrent conclure.
La plupart des forecasts commerciaux sont de la fiction déguisée en données.
Vos commerciaux saisissent 75 % de probabilité sur des deals qui n'ont que 15 % de chances d'aboutir. Vos revues de pipeline font passer le « feeling » pour de l'analyse. Et vos dirigeants arbitrent leurs ressources à partir de chiffres sans rapport avec la réalité.
Le prix à payer : des trimestres manqués, des plans de capacité faussés, des primes commerciales qui récompensent la chance plutôt que la compétence, et un écart de crédibilité permanent entre ce que les ventes annoncent et ce qui se produit vraiment.
Si vous voulez améliorer sérieusement la précision des prévisions et la prévisibilité du chiffre d'affaires, il faut remplacer l'intuition par la data science. C'est précisément le rôle de la modélisation des probabilités.
Qu'est-ce que la modélisation des probabilités ?
La modélisation des probabilités applique des méthodes statistiques pour calculer la probabilité qu'une opportunité donnée se conclue. Au lieu de s'en remettre au jugement des commerciaux ou à des pourcentages fixes par étape, les modèles analysent plusieurs données (caractéristiques du deal, signaux comportementaux, tendances historiques) pour produire des prédictions empiriques.
L'objectif n'est pas la prédiction parfaite, qui est impossible. Il s'agit de surpasser durablement le jugement humain à grande échelle : la précision du forecast se transforme alors en meilleure planification, en meilleure allocation des ressources et en meilleures décisions stratégiques.
Pourquoi les approches traditionnelles échouent
La plupart des entreprises commencent par une probabilité simple par étape, liée à leur conception des étapes du pipeline :
- Découverte : 10 %
- Qualification : 25 %
- Proposition : 50 %
- Négociation : 75 %
- Gagné : 100 %
Cette approche n'a qu'un seul avantage : elle est facile à mettre en place. Ses inconvénients, eux, sont nombreux.
Elle ignore les facteurs propres à chaque deal. Un deal de 10 K$ en Négociation n'a pas du tout la même probabilité de closing qu'un deal de 1 M$ à la même étape. L'étape seule explique peut-être 30 à 40 % de la variance des résultats.
Elle suppose une progression linéaire. Les deals n'avancent pas de façon uniforme. Certains passent directement de la Découverte à la Négociation. D'autres font des allers-retours entre Proposition et Qualification pendant des mois. Des probabilités statiques par étape ne peuvent pas rendre compte de cette complexité.
Elle encourage les contournements. Quand les probabilités sont fixées par étape, les commerciaux apprennent à manipuler la progression pour atteindre leurs objectifs de forecast. Les données sont alors polluées par des changements d'étape stratégiques plutôt que par l'avancement réel des deals.
Elle n'offre aucune boucle de rétroaction. Les probabilités étant figées, rien ne permet d'apprendre des résultats pour améliorer les prédictions au fil du temps.
La modélisation avancée des probabilités répond à ces limites.
Variables et facteurs de probabilité
Un bon modèle de probabilité intègre plusieurs catégories de signaux :
1. Étape du pipeline
L'étape reste pertinente, puisqu'elle reflète la progression dans un processus de vente défini, mais elle n'est qu'un facteur parmi d'autres, et non le seul déterminant.
Ce qui compte, c'est de mesurer les taux réels de passage à l'étape suivante à partir de vos données historiques, et non d'utiliser des moyennes sectorielles ou des objectifs idéalisés. Si votre étape « Négociation » se conclut historiquement dans 42 % des cas, voilà votre référence. Pas 75 %.
2. Ancienneté du deal
Le temps écoulé depuis la création de l'opportunité ou l'entrée dans l'étape est fortement corrélé à la probabilité de closing. Les deals qui s'éternisent au-delà des durées de cycle habituelles voient leur win rate baisser. Une gestion efficace de l'ancienneté des deals suppose de comprendre ces tendances.
Les bons modèles suivent l'ancienneté absolue (jours depuis la création de l'opportunité), l'ancienneté dans l'étape (jours passés à l'étape en cours) et l'écart entre la vélocité attendue et la vélocité réelle (déviation par rapport aux normes historiques).
Un deal bloqué en Proposition depuis 90 jours alors que votre médiane est de 14 jours ? La probabilité doit refléter cette réalité.
3. Taille du deal
La valeur du deal influe sur la probabilité de closing de façon non linéaire. Les très petits deals sont parfois moins bien qualifiés, d'où des taux de disqualification plus élevés. Les très gros deals impliquent des cycles plus longs, davantage de parties prenantes et un examen plus poussé.
Cette relation varie selon votre modèle économique, votre valeur moyenne de contrat et la répartition de la taille de vos deals. Le modèle apprend ces tendances à partir des résultats historiques.
4. Tendances d'activité
La fréquence des réunions, l'engagement par e-mail, le volume d'appels et les démos effectuées sont autant de signaux de la santé d'un deal. Mais les volumes bruts comptent moins que les tendances : l'engagement augmente-t-il ou diminue-t-il ? Atteignez-vous les décideurs ? Les prospects prennent-ils eux-mêmes contact ? Les actions de suivi sont-elles menées à bien ? Comprendre la vélocité du pipeline aide à replacer ces tendances dans leur contexte.
Les modèles qui intègrent des signaux d'activité améliorent généralement la précision de 15 à 25 % par rapport aux approches fondées sur la seule étape.
5. Engagement des parties prenantes
Les deals B2B exigent un consensus entre plusieurs parties prenantes. Les modèles qui tiennent compte de la diversité des rôles des contacts, de l'identification d'un champion et de l'engagement des décideurs surpassent systématiquement ceux qui l'ignorent.
Les principaux signaux sont le nombre de contacts enregistrés, les rôles représentés (décideur économique, évaluateur technique, champion), le niveau d'engagement des dirigeants, et la dynamique de comité de décision par opposition à celle d'un décideur unique.
6. Win rates historiques
Le facteur le plus prédictif est souvent la ressemblance avec des deals déjà conclus. Les modèles peuvent comparer les opportunités en cours à des cohortes historiques selon :
- La correspondance de secteur ou de vertical
- Le segment de taille d'entreprise
- Le type de produit ou de solution
- La concurrence rencontrée
- Le canal d'origine
Si les deals issus d'une source donnée se concluent historiquement dans 18 % des cas, les nouvelles opportunités de cette source doivent hériter de cette référence, ajustée en fonction des autres facteurs. Cela rejoint directement les démarches d'amélioration du win rate.
7. Performance des commerciaux
Les win rates individuels varient considérablement. Un modèle qui intègre la performance historique de chaque commercial, tout en tenant compte de la qualité du territoire et de la taille de l'échantillon, produit des forecasts plus précis qu'un modèle qui traite tous les commerciaux de la même façon.
Il ne s'agit pas de blâmer ceux qui sont en retrait. Il s'agit de pondérer correctement chaque opportunité en fonction de toutes les informations disponibles, y compris de la personne qui mène le deal.
8. Facteurs saisonniers et temporels
De nombreuses entreprises connaissent des effets de saisonnalité :
- Déblocage des budgets au T4
- Creux des mois d'été
- Urgence de fin de trimestre
- Dynamique de fin d'exercice fiscal
Les modèles peuvent intégrer ces effets temporels et ajuster les probabilités selon la date de closing prévue et les taux de conversion saisonniers historiques.
Approches de modélisation des probabilités
Les approches de modélisation des probabilités se distinguent selon qu'elles reposent sur des valeurs par défaut par étape, sur la conversion historique, sur le jugement des commerciaux ou sur des signaux prédictifs.
Les entreprises progressent généralement à travers plusieurs niveaux de maturité :
Simple : étape uniquement
Fonctionnement : des pourcentages fixes sont attribués à chaque étape du pipeline.
Avantages : facile à mettre en place, compris de tous, aucune data science requise.
Inconvénients : ignore les facteurs propres à chaque deal, encourage les contournements, aucun mécanisme d'apprentissage.
Précision type : 40 à 60 % des deals se concluent à moins de 10 points de pourcentage de la probabilité prédite.
Idéal pour : les entreprises en phase de démarrage, avec peu de données historiques (moins de 100 deals conclus).
Intermédiaire : étape + ajustement manuel
Fonctionnement : l'étape fournit une probabilité de base. Les commerciaux l'ajustent selon leur appréciation de la qualité du deal, souvent guidée par les critères de qualification des opportunités.
Avantages : intègre la connaissance des commerciaux, souple pour les situations particulières.
Inconvénients : très subjectif, sujet au biais d'optimisme, difficile à auditer ou à améliorer.
Précision type : 45 à 65 % à moins de 10 points de pourcentage. Le gain par rapport à l'approche par étape seule est marginal, car les biais persistent.
Idéal pour : les petites équipes où le jugement des commerciaux est bien calibré et où les managers peuvent contrôler les ajustements par sondage.
Avancé : modèles statistiques multifactoriels
Fonctionnement : une régression logistique ou une technique statistique similaire analyse les résultats historiques pour pondérer plusieurs facteurs (étape, ancienneté, taille, activités, etc.) et calculer des scores de probabilité.
Avantages : fondé sur les données, intègre plusieurs signaux, s'améliore à mesure que les résultats s'accumulent, auditable.
Inconvénients : exige suffisamment de données historiques (plus de 500 opportunités conclues), nécessite un réentraînement périodique, moins intuitif pour les équipes commerciales.
Précision type : 65 à 80 % à moins de 10 points de pourcentage, avec une amélioration continue.
Idéal pour : les entreprises en croissance et les grands comptes dotés d'un CRM bien tenu et de suffisamment de données historiques.
IA/ML : algorithmes prédictifs
Fonctionnement : des algorithmes de machine learning (forêts aléatoires, arbres à gradient boosté, réseaux de neurones) identifient des relations complexes et non linéaires entre des dizaines, voire des centaines de variables.
Avantages : détecte des tendances subtiles invisibles pour les analystes humains, gère les interactions entre variables, offre la meilleure précision.
Inconvénients : exige de grands jeux de données (plus de 2 000 opportunités conclues), l'effet « boîte noire » complique les explications, nécessite une expertise ML ou un investissement dans une plateforme.
Précision type : 75 à 85 % à moins de 10 points de pourcentage une fois le dispositif mature.
Idéal pour : les grandes entreprises disposant d'une infrastructure de données solide, de compétences en ML et de deals à forte valeur, pour lesquels le gain de précision justifie l'investissement.
Analyse des données historiques
Construire un modèle de probabilité efficace suppose d'explorer vos données de deals historiques pour en dégager des tendances. Ce n'est pas un exercice ponctuel, mais une pratique continue.
Données nécessaires
Jeu de données minimal viable :
- Plus de 500 opportunités conclues (gagnées et perdues)
- Plus de 12 mois d'historique
- Suivi propre de la progression par étape
- Pratiques cohérentes de création des opportunités
- Journalisation de base des activités
Pour les modèles avancés :
- Plus de 2 000 opportunités conclues
- Plus de 24 mois d'historique
- Journaux d'activité détaillés (réunions, e-mails, appels)
- Données sur les rôles des contacts
- Détail des produits et services
- Veille concurrentielle
Démarche d'analyse
1. Définition des cohortes : segmentez les opportunités historiques selon les dimensions pertinentes (tranches de taille de deal, verticaux, produits, ancienneté des commerciaux, source des leads).
2. Calcul du win rate : calculez les taux de closing réels de chaque cohorte à chaque étape. Ils deviennent votre référence empirique, en remplacement des pourcentages génériques.
3. Analyse de la vélocité : mesurez la médiane et la distribution des durées par étape ainsi que la durée totale du cycle. Les deals qui s'écartent nettement de ces normes justifient un ajustement de la probabilité. Les entreprises qui travaillent à la réduction du cycle de vente peuvent s'appuyer sur ces enseignements pour repérer des pistes d'optimisation.
4. Corrélation des variables : identifiez les facteurs les plus fortement corrélés aux deals gagnés. Tous les signaux n'ont pas le même poids. Concentrez la complexité du modèle sur les facteurs les plus informatifs.
5. Entraînement du modèle : utilisez les données historiques pour entraîner des modèles statistiques ou de ML. Répartissez les données en jeux d'entraînement (70 %), de validation (15 %) et de test (15 %) afin d'éviter le surapprentissage.
6. Test de précision : mesurez les performances du modèle sur des données de test mises de côté. Les principaux indicateurs sont la calibration (les probabilités de 60 % se concluent-elles réellement dans 60 % des cas ?) et la discrimination (le modèle sait-il distinguer les deals gagnés des deals perdus ?).
Modélisation par cohortes
Une approche de modélisation efficace consiste à regrouper les opportunités similaires en cohortes et à appliquer à chacune son propre taux de conversion.
Définir des cohortes pertinentes
Les cohortes efficaces concilient spécificité (assez étroites pour être prédictives) et taille d'échantillon (assez larges pour être statistiquement significatives).
Exemples :
- Taille du deal + étape : « opportunités de 50 à 100 K$ en Proposition »
- Secteur + produit : « deals du secteur santé pour la solution de conformité »
- Source + étape : « demandes de démo entrantes en Découverte »
- Segment de commerciaux + taille : « AEs grands comptes avec des deals de plus de 200 K$ »
L'objectif est de créer des groupes où la variance interne des taux de closing est faible et la variance entre groupes élevée. Des techniques statistiques comme les arbres de décision identifient naturellement ces découpages.
Appliquer les probabilités par cohorte
Une fois les cohortes définies avec leurs taux de closing historiques, chaque nouvelle opportunité est rattachée à la cohorte appropriée et hérite de sa probabilité de référence.
Exemple : un deal de 75 K$ en étape Proposition, issu d'une source entrante, peut correspondre à la cohorte « 50 à 100 K$, Proposition, entrant », dont le taux de closing historique est de 47 %. Cette valeur devient la probabilité de départ, éventuellement ajustée par d'autres facteurs en temps réel.
Appartenance dynamique aux cohortes
À mesure que les deals progressent, ils changent de cohorte. Un deal qui passe de la Proposition à la Négociation rejoint une nouvelle cohorte, avec une probabilité de référence différente. Les changements d'étape influent donc sur la probabilité, mais à partir de données empiriques plutôt que d'hypothèses figées.
Probabilité dynamique
Les modèles les plus élaborés traitent la probabilité comme une valeur mise à jour en continu, qui réagit en temps réel aux nouveaux signaux.
Ajustements déclenchés par des événements
Certains événements déclenchent un nouveau calcul de la probabilité. Une gestion efficace de la progression des deals garantit que ces événements sont bien suivis :
- Progression d'étape : avancée ou retour en arrière
- Pics ou creux d'activité : hausse soudaine de l'engagement ou silence radio
- Changements chez les parties prenantes : nouveau champion identifié ou départ d'un contact clé
- Érosion due au temps : deal qui vieillit au-delà de la vélocité attendue
- Décalages de la date de closing : report de la date de closing prévue
Chaque événement alimente le modèle, qui recalcule la probabilité en intégrant la nouvelle information.
Mise à jour bayésienne
L'approche bayésienne part d'une probabilité a priori (fondée sur la cohorte ou sur les facteurs initiaux) et l'actualise à mesure que les preuves s'accumulent. Chaque nouvelle donnée (une réunion tenue, une proposition envoyée, une semaine d'inactivité) met à jour l'estimation de la probabilité a posteriori.
Cette approche gère avec élégance l'incertitude et traite l'information de façon asymétrique : les signaux positifs forts augmentent davantage la probabilité que les signaux faibles, et les éléments contradictoires la réduisent comme il se doit.
Érosion des signaux
Les données n'ont pas toutes le même poids avec le temps. Une démo réalisée il y a 90 jours est moins prédictive qu'une démo de la semaine dernière. Les modèles dynamiques peuvent atténuer l'influence des signaux anciens et mettre l'accent sur l'engagement récent.
Cela évite que des données périmées gonflent ou fassent artificiellement baisser les probabilités de deals dont le contexte a changé.
Modifications manuelles des probabilités
Même le meilleur modèle interprétera parfois mal une situation que le commercial comprend mieux. Des mécanismes de modification manuelle apportent la souplesse nécessaire tout en préservant l'auditabilité.
Quand une modification manuelle se justifie
Cas légitimes :
- Circonstances particulières du deal : fusion, acquisition ou changement de direction qui affecte le calendrier
- Informations externes : perte face à un concurrent ou approbation de budget inattendue, absentes du CRM
- Connaissance de la relation : relation personnelle avec le décideur, qui donne une confiance que le modèle ne peut pas voir
- Écarts de processus : deal qui suit un parcours non standard (par exemple un circuit accéléré piloté par un dirigeant)
Gouvernance des modifications manuelles
Des modifications non encadrées annulent l'intérêt de la modélisation. Une gouvernance efficace comprend :
Exiger une justification : les commerciaux doivent documenter pourquoi ils modifient la probabilité et quelles informations justifient le changement.
Limiter l'ampleur : des plafonds sur l'écart autorisé (par exemple ±20 points de pourcentage) empêchent de remplacer en bloc les prédictions du modèle.
Suivre la précision : vérifiez si les deals modifiés se concluent à la probabilité modifiée ou à celle du modèle. Si les commerciaux revoient systématiquement à la baisse et que les deals se concluent quand même, c'est un retour utile. S'ils revoient à la hausse et que les deals échouent régulièrement, c'est une occasion de coaching sur le pipeline.
Seuils d'approbation : les modifications importantes, ou celles qui portent sur des deals à forte valeur, peuvent nécessiter l'accord d'un manager.
Boucles de rétroaction : les résultats des modifications manuelles alimentent l'entraînement du modèle. Si des commerciaux modifient à plusieurs reprises pour les mêmes raisons et ont raison, ce signal doit être intégré au modèle.
Validation du modèle
Construire un modèle est facile. Construire un modèle précis qui s'améliore avec le temps exige une validation rigoureuse.
Test de calibration
Un modèle bien calibré attribue des probabilités qui correspondent aux résultats observés dans chaque tranche de probabilité.
Test : regroupez les opportunités historiques par tranches de probabilité prédite (0-10 %, 10-20 %... 90-100 %). Calculez les taux de closing réels de chaque tranche. Un modèle calibré montre un alignement étroit.
Exemple :
- Probabilité prédite de 50 à 60 % → 48 % réellement conclus (bien calibré)
- Probabilité prédite de 70 à 80 % → 58 % réellement conclus (trop confiant)
Une mauvaise calibration révèle un biais systématique qui exige de réentraîner le modèle ou de retravailler les variables.
Analyse de la discrimination
La discrimination mesure la capacité du modèle à distinguer les deals qui se concluent de ceux qui échouent.
Indicateurs clés :
- AUC-ROC : aire sous la courbe ROC (Receiver Operating Characteristic). Au-dessus de 0,75, la discrimination est bonne ; au-dessus de 0,85, elle est excellente.
- Précision-rappel : à partir de quel seuil de probabilité prédite le modèle identifie-t-il correctement les deals qui peuvent aboutir, sans trop de faux positifs ?
Une forte discrimination signifie que le modèle n'est pas seulement bien calibré en moyenne. Il classe réellement les opportunités selon leur probabilité de closing.
Analyse de l'erreur de forecast
Le test ultime : le modèle améliore-t-il la précision du forecast du pipeline pondéré ?
Comparez :
- Le pipeline pondéré total prédit (somme des valeurs des opportunités × probabilités)
- Le chiffre d'affaires réellement conclu sur la période du forecast
Calculez l'erreur absolue moyenne en pourcentage (MAPE) et comparez-la aux approches de forecast précédentes. Un bon modèle doit réduire la MAPE de 20 à 40 % par rapport à un forecast fondé sur l'étape.
Suivi continu
Les performances d'un modèle se dégradent avec le temps, car :
- Le contexte économique change
- L'adéquation produit-marché évolue
- Les processus de vente gagnent en maturité
- La composition de l'équipe se modifie
Mettez en place des revues trimestrielles du modèle, qui examinent :
- Les indicateurs récents de calibration et de discrimination
- L'évolution de l'erreur de forecast
- La dérive de l'importance des variables (les facteurs décisifs il y a six mois sont-ils encore prédictifs ?)
- La stabilité des cohortes (les taux de closing historiques ont-ils bougé ?)
Réentraînez les modèles dès que les performances se dégradent, ou au minimum une fois par an.
Mise en œuvre
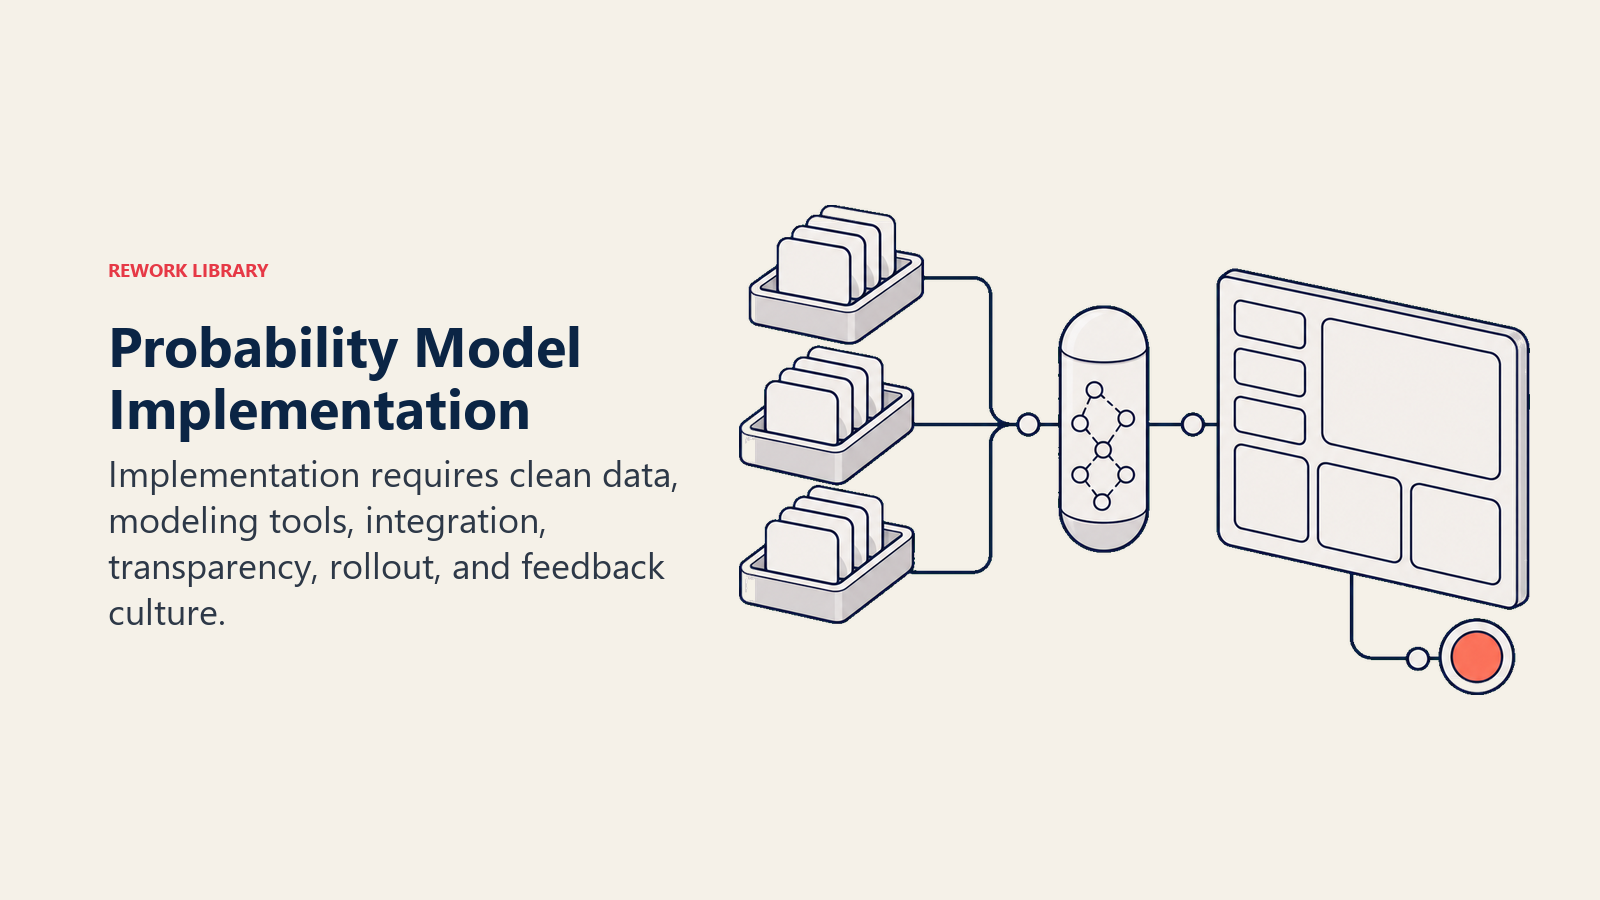
Déployer avec succès la modélisation des probabilités suppose de traiter la technologie, les processus et la conduite du changement.
Exigences technologiques
Infrastructure de données : données CRM propres et centralisées, avec un suivi cohérent des opportunités, des définitions d'étapes et de la journalisation des activités. Maintenir l'hygiène du pipeline est indispensable : des données médiocres en entrée donnent des prédictions médiocres en sortie.
Plateforme de modélisation : les options vont de :
- Solutions natives du CRM : Salesforce Einstein, Microsoft Dynamics Insights
- Analytique commerciale spécialisée : Clari, Gong Forecast, People.ai
- Modèles sur mesure : modèles Python/R déployés dans le CRM via API
Le choix dépend du volume de données, du niveau de technicité requis et des compétences en data science disponibles en interne.
Architecture d'intégration : les modèles doivent s'intégrer aux outils existants (CRM, dashboards de forecast par étape, outils de reporting) pour fournir les prédictions là où les équipes travaillent déjà.
Conduite du changement
La modélisation des probabilités échoue plus souvent pour des problèmes d'adoption que pour des raisons techniques.
Parrainage de la direction : la RevOps ou la direction commerciale doit porter le modèle, expliquer le « pourquoi » et s'engager à utiliser ses résultats dans les décisions.
Transparence : expliquez comment fonctionne le modèle, quels facteurs il prend en compte et pourquoi il fait mieux que l'intuition. Les systèmes en boîte noire engendrent la méfiance.
Déploiement progressif : commencez par un mode reporting (afficher les prédictions du modèle à côté des probabilités existantes) avant de faire des résultats du modèle la référence. Cela instaure la confiance et permet de repérer les cas limites.
Formation : les équipes commerciales doivent comprendre quels comportements améliorent la probabilité d'un deal (élargissement des parties prenantes, activité régulière, maintien de la vélocité) et lesquels n'ont aucun effet sur les prédictions du modèle (pensée magique, sous-estimation volontaire).
Alignement des incitations : si les plans de rémunération récompensent encore la précision du forecast à partir des probabilités saisies par les commerciaux, ceux-ci joueront avec le système. Alignez les incitations sur l'adoption du modèle.
Culture du retour d'expérience
Les meilleurs modèles s'améliorent en continu parce que les entreprises considèrent les erreurs de prédiction comme des occasions d'apprendre.
Après chaque trimestre :
- Passez en revue les deals conclus malgré une faible probabilité prédite (quels signaux le modèle a-t-il manqués ?)
- Passez en revue les deals perdus malgré une forte probabilité prédite (quels signaux d'alerte ont été ignorés ?)
- Mettez à jour les définitions de cohortes et les ensembles de variables en fonction des constats
- Réentraînez les modèles avec les derniers résultats
Une analyse approfondie des deals perdus apporte des enseignements essentiels pour affiner le modèle. Ce cercle vertueux (prédiction, observation des résultats, analyse, amélioration du modèle) fait progresser la précision du forecast de façon cumulative.
L'avantage concurrentiel de la modélisation des probabilités
Les entreprises qui maîtrisent la modélisation des probabilités gagnent des avantages cumulatifs :
Allocation des ressources : concentrez le temps de coaching, l'appui des sales engineers et l'implication des dirigeants sur les opportunités à forte probabilité plutôt que de répartir les efforts uniformément.
Pilotage du pipeline : repérez tôt les deals à risque grâce à l'érosion de la probabilité, pour intervenir de façon proactive plutôt que subir des mauvaises surprises en fin de trimestre.
Planification de la capacité : un pipeline pondéré fiable améliore les décisions d'embauche, de fixation des quotas et de découpage des territoires. Combinées à l'analyse de la couverture du pipeline, ces données permettent d'allouer les ressources avec plus d'assurance.
Clarté stratégique : quand les forecasts correspondent systématiquement aux résultats, la direction peut décider d'investissements de croissance, de choix produit et d'expansion sur de nouveaux marchés avec confiance, sans se couvrir contre la volatilité des prévisions.
Surtout, la modélisation des probabilités déplace la conversation : on ne débat plus de la qualité des deals, on cherche à comprendre pourquoi certains profils de deals réussissent et d'autres échouent. L'amélioration devient systématique au lieu de reposer sur l'espoir.
Conclusion : du feeling à la data science
La vente conservera toujours une part d'art : bâtir la relation, négocier avec finesse, sentir la dynamique d'une salle. Mais le forecast ne devrait pas être un art. Il devrait être une science.
La modélisation des probabilités fait passer le forecast du récit à la prédiction statistique. Non parce que les modèles sont parfaits, mais parce qu'ils sont systématiquement meilleurs que le jugement humain, qu'ils s'améliorent avec le temps et qu'ils offrent une auditabilité que l'intuition n'aura jamais.
La marche à suivre est claire : remplacez les probabilités fixes par étape par des références empiriques par cohorte, ajoutez les facteurs propres à chaque deal (taille, ancienneté, activités), mettez en place une actualisation dynamique à mesure que les signaux évoluent, introduisez l'IA/ML quand le volume de données le permet, et bouclez le tout par une validation rigoureuse et une amélioration continue.
Les entreprises qui font ce chemin ne se contentent pas de mieux prévoir. Elles fonctionnent mieux : leurs décisions sont plus judicieuses, leur coaching plus efficace, et leur machine à revenus plus prévisible.
La question n'est pas de savoir s'il faut adopter la modélisation des probabilités, mais à quelle vitesse vous pouvez y arriver avant vos concurrents.
En savoir plus :
- Pipeline pondéré : la base d'un forecast précis
- Forecast par étape : construire le cadre de la prévision du chiffre d'affaires
- Prévisibilité du chiffre d'affaires : l'objectif ultime de la gestion du pipeline
- Fondamentaux du forecasting : les concepts essentiels pour les responsables des revenus
- Vue d'ensemble des métriques du pipeline : les indicateurs clés de la réussite commerciale
Head of Enterprise Solutions
On this page
- Qu'est-ce que la modélisation des probabilités ?
- Pourquoi les approches traditionnelles échouent
- Variables et facteurs de probabilité
- 1. Étape du pipeline
- 2. Ancienneté du deal
- 3. Taille du deal
- 4. Tendances d'activité
- 5. Engagement des parties prenantes
- 6. Win rates historiques
- 7. Performance des commerciaux
- 8. Facteurs saisonniers et temporels
- Approches de modélisation des probabilités
- Simple : étape uniquement
- Intermédiaire : étape + ajustement manuel
- Avancé : modèles statistiques multifactoriels
- IA/ML : algorithmes prédictifs
- Analyse des données historiques
- Données nécessaires
- Démarche d'analyse
- Modélisation par cohortes
- Définir des cohortes pertinentes
- Appliquer les probabilités par cohorte
- Appartenance dynamique aux cohortes
- Probabilité dynamique
- Ajustements déclenchés par des événements
- Mise à jour bayésienne
- Érosion des signaux
- Modifications manuelles des probabilités
- Quand une modification manuelle se justifie
- Gouvernance des modifications manuelles
- Validation du modèle
- Test de calibration
- Analyse de la discrimination
- Analyse de l'erreur de forecast
- Suivi continu
- Mise en œuvre
- Exigences technologiques
- Conduite du changement
- Culture du retour d'expérience
- L'avantage concurrentiel de la modélisation des probabilités
- Conclusion : du feeling à la data science