Architecture du pipeline : concevoir votre système d'exploitation des revenus
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
Voici la vérité sur les problèmes de pipeline commercial : ils ne viennent presque jamais de votre équipe de vente. Ils viennent de l'architecture.
Vous avez construit votre premier pipeline en 48 heures. Un seul objet opportunité, six étapes, une répartition en round-robin, et c'était réglé. Cela fonctionnait très bien quand vous aviez cinq commerciaux qui vendaient un produit à un segment. Mais comprendre ce qu'est réellement un pipeline commercial et comment il doit fonctionner, ce n'est pas la même chose que d'en concevoir un qui passe à l'échelle.
Puis vous avez ajouté une deuxième gamme de produits avec un autre cycle de vente. Puis vous avez scindé l'équipe en SMB et Enterprise. Puis vous vous êtes développé à l'international. Aujourd'hui, votre pipeline tient grâce à du chatterton, des champs personnalisés et des contournements de plus en plus complexes qui cassent à chaque trimestre.
Cela vous parle ?
Si vous êtes responsable des revenus, CRO ou responsable des Sales Operations, retenez ceci : l'architecture du pipeline n'est pas un projet de configuration ponctuel. C'est le système d'exploitation de vos revenus. Et comme pour tout système d'exploitation, les mauvaises décisions d'architecture s'accumulent en dette technique qui bride la croissance.
Qu'est-ce que l'architecture du pipeline ?
L'architecture du pipeline est la conception structurelle complète de la manière dont vous organisez, suivez et faites avancer les revenus dans votre entreprise. Elle combine les modèles de données, les flux de processus, les structures de permissions et les intégrations système qui définissent vos opérations commerciales.
Voyez-la comme le plan de votre moteur de revenus. Elle couvre les liens entre les opportunités, les comptes, les contacts, les produits et les activités. Les données saisies à chaque étape, et pourquoi. Qui peut voir quoi, modifier quoi et analyser quoi. La façon dont votre pipeline se connecte au marketing, à la finance, au produit et au support. Et la manière dont votre architecture suit l'évolution des gammes de produits, des segments et des zones géographiques.
Le mot clé ici, c'est « architecture ». Il ne s'agit pas de renommer des étapes ou d'ajouter des champs personnalisés. Il s'agit de la structure fondamentale qui détermine si vos Revenue Operations peuvent passer à l'échelle ou si vous bâtissez sur du sable.
Le coût caché de la simplification excessive
La plupart des entreprises démarrent avec le pipeline le plus simple possible : un processus linéaire, de la qualification à la signature. Et c'est logique, la simplicité fonctionne tant que l'on est petit.
Le problème, c'est que la complexité d'une activité ne demande pas la permission avant d'arriver.
Que se passe-t-il en réalité ?
Vos deals Enterprise exigent des revues juridiques et des audits de sécurité que vos deals SMB ne connaissent pas. Vos deals internationaux ont d'autres règles d'approbation et d'autres conditions de paiement. Vos deals d'expansion suivent des critères de qualification complètement différents de ceux du nouveau business. Vos deals de partenariat demandent une coordination avec les canaux que les deals directs n'exigent pas.
Alors vous multipliez les contournements. Des champs personnalisés pour suivre le « type de deal ». Des cases à cocher pour sauter les étapes non pertinentes. Des processus manuels documentés dans Notion parce que votre CRM ne sait pas les gérer. Des rappels par e-mail parce que votre logique d'automatisation ne distingue pas les types de deals.
Le coût grimpe vite.
Les commerciaux passent 30 % de leur temps à saisir des données au lieu de vendre. Les forecasts deviennent peu fiables parce que les différents types de deals avancent à des vitesses différentes. Comprendre la différence entre pipeline et forecast devient crucial lorsque votre architecture ne permet pas des prévisions précises. Les rapports se cassent parce que les données sont incohérentes d'un deal à l'autre. L'onboarding prend 6 semaines parce que votre pipeline « simple » repose sur un savoir tacite. La direction n'obtient pas de réponse aux questions de base sans requêtes SQL sur mesure.
Les entreprises qui passent à l'échelle conçoivent dès le départ une architecture qui absorbe la complexité, ou elles paient le prix d'une refonte plus tard.
Les composantes clés de l'architecture
L'architecture du pipeline définit les étapes, les règles de propriété, les champs de données et la gouvernance nécessaires pour piloter le mouvement des revenus.
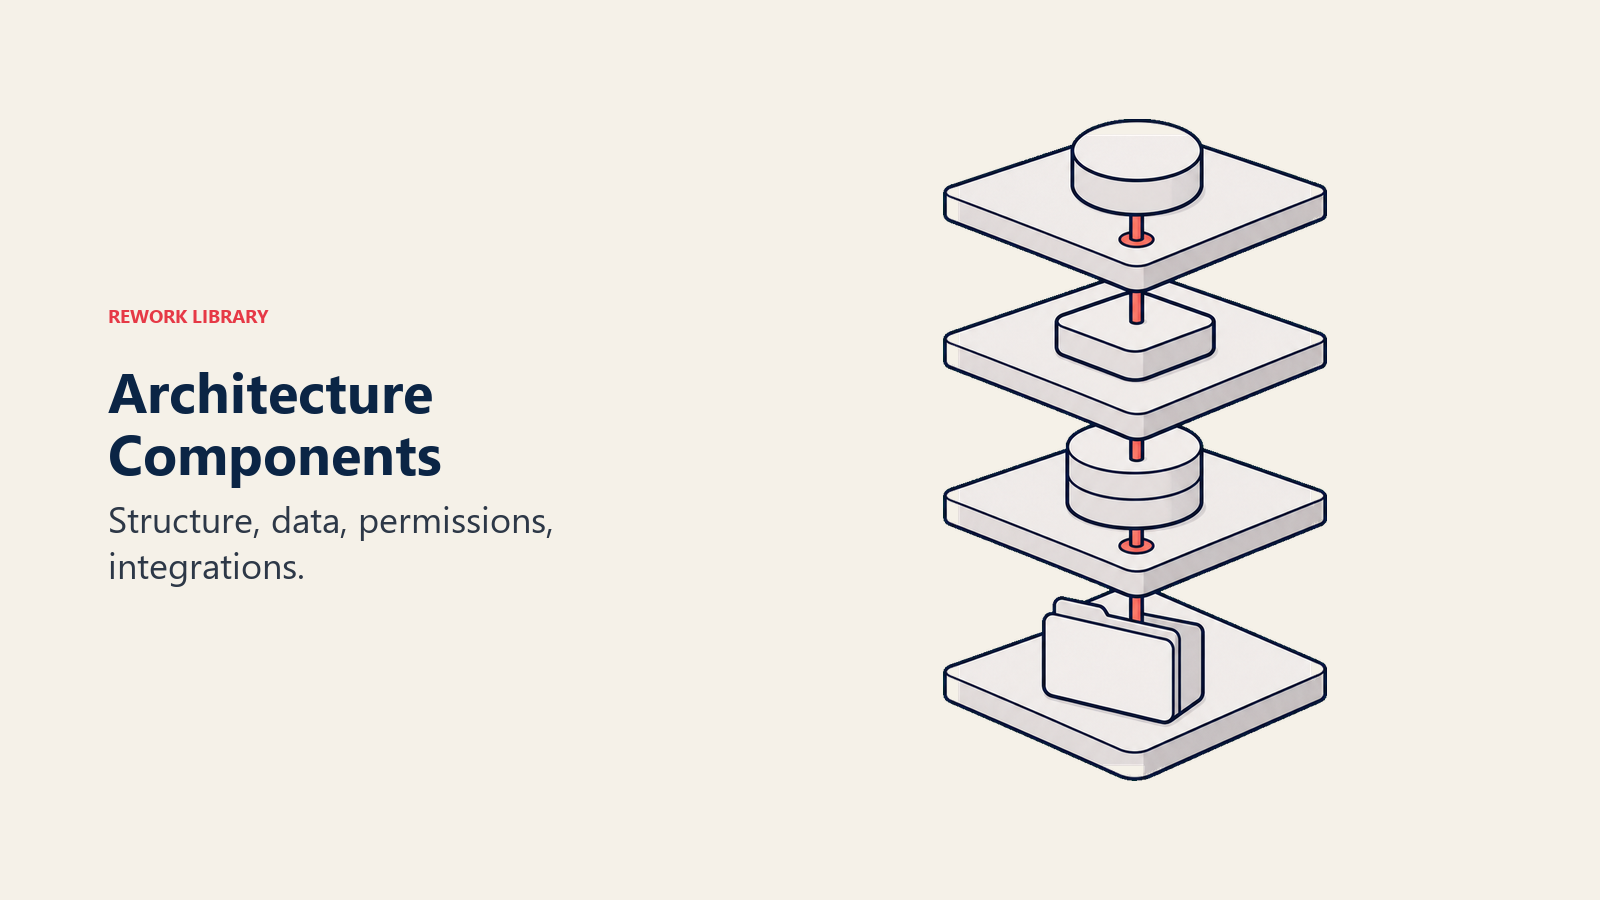
Une bonne architecture de pipeline couvre quatre couches interdépendantes :
1. Structure du pipeline (étapes, points de contrôle, flux)
C'est ce que la plupart des gens appellent « le pipeline » : les étapes que traversent les opportunités, de l'ouverture à la signature.
Points à examiner :
Définition des étapes : que représente concrètement chaque étape ? Quels critères d'entrée ? Quels critères de sortie ? La conception de vos étapes de pipeline détermine à quel point vos commerciaux comprennent la progression d'un deal.
Points de contrôle (stage gates) : quelles qualifications, approbations ou validations doivent avoir lieu avant de passer à la suite ? Définir des critères de stage gate empêche les deals non qualifiés d'avancer.
Variantes de flux : tous les deals suivent-ils le même parcours, ou certains types de deals exigent-ils des flux différents ?
Gestion des exceptions : que se passe-t-il quand un deal saute des étapes ou revient en arrière ?
Exemple de flux unique (SaaS SMB) :
Lead → Qualified → Demo → Proposal → Negotiation → Closed Won/Lost
Exemple de flux multiples (Enterprise avec partenariats) :
Direct: Lead → Qualified → Discovery → Technical Eval → Commercial → Legal → Closed
Partner: Lead → Partner Referral → Joint Validation → Deal Registration → Commercial → Closed
La structure doit refléter la façon dont les deals progressent réellement dans votre entreprise, et non un processus linéaire idéalisé qui n'existe que dans l'imagination de l'administrateur de votre CRM.
2. Modèle de données (objets, champs, relations)
Votre modèle de données définit les informations que vous suivez et la manière dont elles s'articulent.
Les objets centraux de l'architecture des revenus :
Opportunités - L'entité principale du pipeline, qui suit les deals potentiels
- Champs obligatoires : montant, date de clôture, étape, propriétaire
- Champs courants : type de deal, mix produit, concurrence, prochaines étapes
- Champs internes : catégorie de forecast, territoire, source d'origine
Comptes - L'entité au niveau de l'entreprise, qui représente les clients et les prospects
- Champs obligatoires : nom, secteur, taille, zone géographique
- Relation : un compte → plusieurs opportunités (au fil du temps)
- Principe : source unique de vérité pour les données de l'entreprise
Contacts - Décideurs, influenceurs, champions et parties prenantes
- Champs obligatoires : nom, rôle, e-mail
- Relation : plusieurs contacts → une opportunité
- Principe : suivre le comité d'achat, pas un seul contact
Produits - Ce que vous vendez
- Champs obligatoires : référence (SKU), prix, catégorie
- Relation : plusieurs produits → une opportunité
- Principe : permet le forecast par produit et l'analyse de cross-sell
Activités - Appels, e-mails, réunions et démos qui retracent l'engagement
- Champs obligatoires : type, date, propriétaire, opportunité associée
- Relation : plusieurs activités → une opportunité
- Principe : mesure l'engagement commercial et la vélocité
Principes d'architecture des données :
Gardez les champs standard standard. Ne renommez pas « Close Date » en « Date de gain prévue » parce que votre CEO la préfère ainsi. Les champs standard ont des rapports standard, des intégrations standard et un dépannage standard.
Catégorisez clairement les champs personnalisés. Des champs communs que tout le monde utilise (comme « Concurrent »). Des champs généraux propres à un rôle (comme « Exigences techniques » pour l'avant-vente). Des champs internes que seules les opérations voient (comme « Source de routage »).
Rendez les champs critiques obligatoires. Si vous ne pouvez pas faire de forecast sans connaître la taille du deal et la date de clôture, rendez-les obligatoires. Si vos commerciaux se plaignent, c'est votre processus de qualification qui est défaillant, pas votre modèle de données.
Validez les données dès la saisie. Des dates de clôture dans le passé ? Des opportunités supérieures à 10 M$ avec un seul appel de découverte ? Des deals qui passent de la qualification à closed-won d'un seul coup ? Les règles de validation interceptent les mauvaises données avant qu'elles ne polluent votre pipeline.
3. Modèle de permissions (visibilité, propriété, modification)
Qui peut voir quoi, modifier quoi et analyser quoi ? C'est plus important qu'on ne le pense.
Points à examiner pour les permissions :
Le contrôle d'accès par rôle compte. Les commerciaux voient leurs deals (et, si vous le souhaitez, ceux de l'équipe). Les managers commerciaux voient les deals de leur équipe et les rapports consolidés. Les Sales Operations voient tous les deals avec des droits de modification. Les dirigeants voient tous les deals dans des dashboards stratégiques. Les équipes transverses ont un accès ciblé : les sales engineers voient les champs techniques, la finance voit les conditions contractuelles, le juridique voit les signaux de risque.
La visibilité par équipe varie selon votre modèle. Par territoire, les commerciaux voient les deals de leur territoire. Par compte, ils voient les deals de leurs comptes. La plupart des entreprises combinent les deux : les commerciaux Enterprise voient des comptes nommés, tandis que les commerciaux SMB voient des pools de territoires.
La sensibilité des données impose des choix. Qui peut voir les montants des opportunités et les forecasts de revenus ? Les commerciaux doivent-ils voir l'atteinte de quota de leurs pairs ? Les noms des concurrents doivent-ils être largement visibles ?
Les droits de modification encadrent l'hygiène des deals. Les commerciaux peuvent-ils faire reculer un deal, ou seulement le faire avancer ? Peuvent-ils modifier librement les dates de clôture prévues ? Quelle approbation faut-il pour changer la taille d'un deal ?
Un mauvais modèle de permissions crée deux problèmes : soit il est trop ouvert (tout le monde voit tout, la discipline des données s'effondre), soit il est trop fermé (les rapports ne fonctionnent plus parce que les gens n'accèdent pas aux données dont ils ont besoin).
4. Points d'intégration (marketing, finance, opérations)
Votre pipeline n'existe pas en vase clos. Il se connecte à tous les systèmes liés aux revenus de votre entreprise.
Intégrations critiques :
Marketing automation (transmission des leads) :
- Les MQL arrivent dans le CRM sous forme de leads
- La conversion des leads en opportunités est suivie
- L'attribution en boucle fermée relie les revenus aux campagnes
- Données partagées : source du lead, campagne, score comportemental, adéquation démographique
Systèmes financiers (reconnaissance du revenu) :
- Les deals gagnés déclenchent les workflows de facturation
- Les conditions contractuelles remontent à la finance pour la reconnaissance du revenu
- Les upsells et les renouvellements sont suivis par rapport aux clients existants
- Données partagées : montant du deal, produits, conditions de paiement, dates du contrat
Produit et exécution (deal desk, provisioning) :
- Les deals approuvés partent vers le provisioning
- Les exigences de configuration sont saisies dans l'opportunité
- Les calendriers de mise en œuvre sont coordonnés
- Données partagées : références produit, quantités, exigences spécifiques
Systèmes de support (passage de relais après la vente) :
- Le Customer Success reçoit les détails du deal gagné
- L'historique des tickets de support alimente le forecast des renouvellements
- Les opportunités d'expansion sont repérées grâce à l'usage du produit
- Données partagées : santé du compte, données d'usage, tickets de support
Principes d'architecture des intégrations :
Utilisez des API, pas des exports. Les exports CSV manuels créent des décalages de données et des erreurs humaines. Les intégrations par API synchronisent les données quasiment en temps réel.
Définissez des points de passage clairs. À quel moment un lead devient-il une opportunité commerciale ? À quel moment un deal gagné devient-il un client ? Un passage flou crée des trous.
Cartographiez les champs explicitement. Ne supposez pas que « Company Name » dans votre outil marketing correspond à « Account Name » dans votre CRM. Un mapping explicite des champs évite les doublons.
Surveillez les échecs de synchronisation. Les intégrations tombent en panne. Journalisez les erreurs, alertez les responsables et prévoyez des procédures pour les incidents courants.
Pipeline unique ou multiple : la décision
La décision d'architecture la plus lourde de conséquences : un seul pipeline ou plusieurs ?
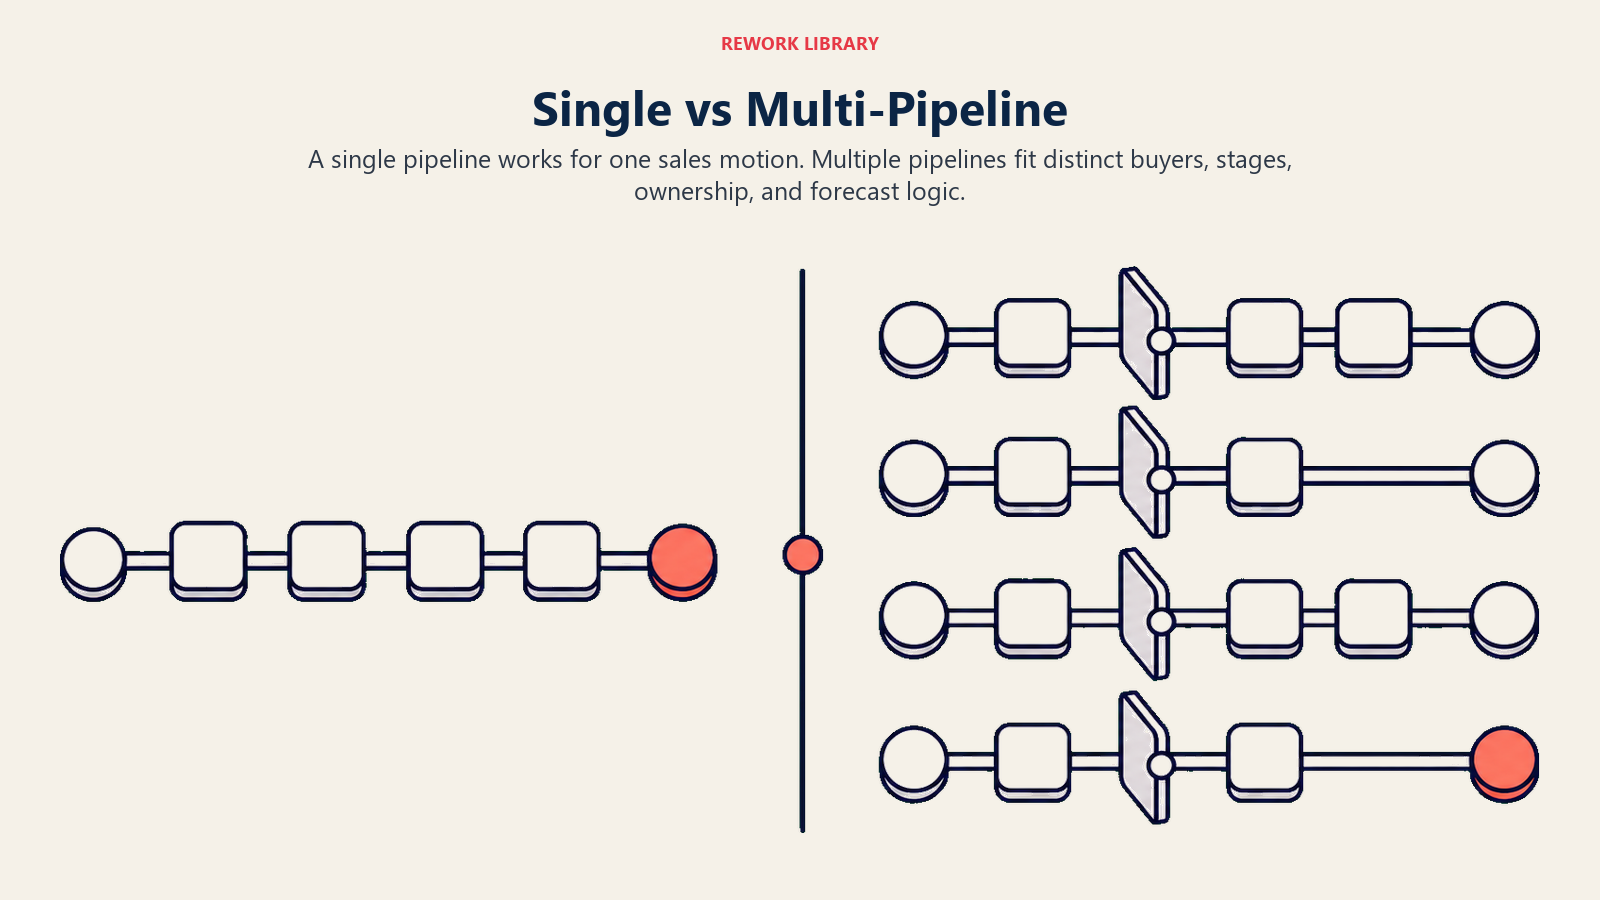
Quand un seul pipeline suffit
Restez sur un pipeline unique si :
- Vous vendez un seul produit (ou une seule gamme) avec une démarche commerciale homogène
- Tous les deals suivent le même processus de qualification, d'évaluation et d'approbation
- La taille des deals reste relativement uniforme (dans un rapport de 1 à 10)
- La durée du cycle de vente est constante d'un segment de clients à l'autre
- Les différences géographiques n'imposent pas de processus distincts
Exemple : une entreprise SaaS SMB
- Un produit, un ACV de 2 K$ à 20 K$
- Tous les deals : démo → essai → signature commerciale
- Pas de développement sur mesure, pas de revue juridique, pas d'achats Enterprise
- Un pipeline unique fonctionne parfaitement.
Quand plusieurs pipelines deviennent nécessaires
Il vous faut plusieurs pipelines quand :
Des produits différents ont des cycles de vente différents :
- Produit A : transactionnel, cycle de 30 jours, essai en libre-service
- Produit B : Enterprise, cycle de 9 mois, mise en œuvre sur mesure, achats
Des segments de clients exigent des processus différents :
- SMB : démo en ligne → contrat via DocuSign → accès immédiat
- Enterprise : appel d'offres → audit de sécurité → négociation juridique → MSA → SOW
Des zones géographiques ont des exigences différentes :
- États-Unis : conditions standard, USD, paiement à 30 jours
- Europe : conformité RGPD, multi-devises, paiement à 60 jours
- APAC : vente pilotée par des partenaires, exigences d'entité locale
Les modèles économiques diffèrent sur le fond :
- Nouveau business : forte intensité de contact, piloté par la découverte
- Expansion : faible intensité de contact, porté par le produit
- Renouvellement : piloté par le Customer Success, fondé sur l'usage
Forcer ces variations dans un seul pipeline crée le chaos : des étapes inutiles pour certains deals, des étapes manquantes pour d'autres, des champs conditionnels partout, des rapports qui exigent des filtres à n'en plus finir. C'est là que la gestion multi-pipeline devient indispensable.
Modèles d'architecture multi-pipeline
Modèle 1 : pipelines par produit
Pipeline 1 (Core Platform): Lead → Demo → Technical → Commercial → Legal → Close
Pipeline 2 (Add-On Modules): Qualified → Validation → Commercial → Close
Pipeline 3 (Professional Services): Scoping → Proposal → SOW → Close
Modèle 2 : pipelines par segment
SMB Pipeline: Inbound → Demo → Trial → Close (30 days)
Mid-Market Pipeline: Outbound → Discovery → Evaluation → Negotiation → Close (90 days)
Enterprise Pipeline: Target → Multi-threading → POC → Procurement → Legal → Close (270 days)
Modèle 3 : pipelines par modèle économique
New Business Pipeline: Prospecting → Qualification → Solution → Proposal → Close
Expansion Pipeline: Opportunity ID → Business Case → Approval → Implementation
Renewal Pipeline: 120-day Alert → Health Check → Commercial Discussion → Renewal Decision
Modèle 4 : approche hybride
- Utilisez plusieurs pipelines pour les processus fondamentalement différents
- Utilisez des types d'enregistrement ou des types de deals au sein des pipelines pour les variantes
- Exemple : séparer les pipelines nouveau business et renouvellement, mais utiliser un champ « segment » pour distinguer SMB, Mid-Market et Enterprise dans le nouveau business
Stratégies de segmentation du pipeline
Au-delà du choix entre pipeline unique et multiple, une bonne architecture suppose une segmentation réfléchie, au sein des pipelines ou entre eux.
Dimensions de segmentation
Vous pouvez segmenter par gamme de produits : matériel, logiciel ou services, plateforme, modules complémentaires ou services professionnels. Chacun a ses propres circuits d'exécution.
Vous pouvez segmenter par segment de clients : SMB (libre-service, peu de contacts, cycle court), mid-market (accompagné, contacts modérés, cycle moyen), Enterprise (forte intensité de contact, cycle long, comités d'achat complexes).
Vous pouvez segmenter par zone géographique : exigences de conformité régionales (RGPD, SOC2, réglementations locales), différences de langue et de devise, modèles partenaires ou directs selon les régions.
Vous pouvez segmenter par démarche commerciale : inbound (issu du marketing, leads plus chauds), outbound (issu de la vente, prospects plus froids), piloté par les partenaires (issu des canaux, co-vente nécessaire).
Vous pouvez segmenter par cycle de vie du client : acquisition de nouveaux logos, cross-sell et upsell auprès des clients existants, renouvellement et fidélisation des contrats arrivant à échéance, reconquête des clients perdus.
Mise en œuvre de la segmentation
Option 1 : objets pipeline distincts
- De vrais objets pipeline différents (la plupart des CRM le permettent)
- Avantages : isolation complète des processus, rapports plus propres, aucun champ inutile
- Inconvénients : vue unifiée plus difficile à obtenir, risque de silos
Option 2 : types d'enregistrement au sein d'un même pipeline
- Même objet, mises en page et processus différents selon le type d'enregistrement
- Avantages : rapports unifiés, transitions plus faciles entre les types
- Inconvénients : la logique conditionnelle peut tout de même devenir brouillonne
Option 3 : segmentation par champs
- Un seul pipeline, avec des champs comme « Type de deal » ou « Segment » pour les distinguer
- Avantages : mise en œuvre la plus simple
- Inconvénients : ne règle ni les étapes ni les champs inutiles, les rapports exigent des filtres
Option 4 : hybride
- Des pipelines distincts pour les processus réellement différents (nouveau business ou renouvellement)
- Des types d'enregistrement ou des champs pour les variantes au sein d'un processus (SMB ou Enterprise)
- Avantages : équilibre entre clarté et simplicité
- Inconvénients : demande une conception soignée en amont
Le bon choix dépend de l'écart réel entre vos processus. Si les deals partagent 80 % du même flux, optez pour la segmentation par champs. S'ils en partagent moins de 50 %, créez des pipelines distincts. Pour des stratégies détaillées, explorez les approches de segmentation du pipeline.
Principes d'architecture des données
Au-delà des objets et des champs eux-mêmes, ces principes guident une architecture de données évolutive :
Principe 1 : le standard avant le personnalisé
Chaque plateforme CRM propose des champs standard pour les opportunités : Amount, Close Date, Stage, Owner, Account Name, etc.
Utilisez-les. Ne créez pas « Revenu attendu » quand « Amount » existe. Ne créez pas « Clôture prévue » quand « Close Date » existe.
Pourquoi ? Les champs standard ont des rapports standard, des intégrations standard et un comportement standard. Les champs personnalisés exigent du sur-mesure partout.
Principe 2 : catégoriser les champs en communs, généraux et internes
Tous les champs ne se valent pas. Catégorisez-les.
Les champs communs sont ceux que tout le monde doit renseigner. Ils sont essentiels pour le forecast, les rapports ou les passages de relais. Exemples : Close Date, Amount, Stage, Next Steps.
Les champs généraux sont propres à un rôle ou à un deal. Importants, mais pas universels. Exemples : concurrents (vente), exigences techniques (avant-vente), complexité de la migration (mise en œuvre).
Les champs internes servent uniquement aux opérations, à l'analyse ou à l'intégration. Ils sont masqués aux commerciaux. Exemples : source du lead, horodatage du routage, statut de synchronisation de l'intégration.
Cette catégorisation guide les mises en page des champs (ce que voient les commerciaux), les règles de validation (ce qui est obligatoire) et l'axe de la formation (ce qui compte le plus).
Principe 3 : les champs obligatoires imposent le processus
Si vous ne pouvez pas établir un forecast précis sans connaître la taille du deal et la date de clôture, rendez-les obligatoires. Si vous ne pouvez pas répartir les deals sans connaître le territoire et le produit, rendez-les obligatoires.
Objection fréquente : « Les commerciaux ne connaissent pas encore le montant à ce stade précoce ! »
Réponse : alors ils ne devraient pas encore créer d'opportunité. Les champs obligatoires imposent la qualification. S'ils ne peuvent pas estimer la taille du deal, ils n'ont pas qualifié l'opportunité. Des processus solides de qualification des opportunités permettent aux commerciaux de savoir quelles données ils doivent réunir.
Cela force une qualification plus précoce et de meilleure qualité, au lieu d'une saisie arbitraire.
Principe 4 : la validation empêche les mauvaises données
Les règles de validation interceptent les données manifestement erronées. Des dates de clôture dans le passé (sauf pour marquer un deal comme perdu). Des opportunités de plus de 1 M$ avec une seule activité enregistrée. Une progression d'étape qui saute des passages obligatoires (comme passer de la qualification à closed-won sans démo). Des montants modifiés de plus de 50 % sans explication.
De mauvaises données rendent les rapports inutiles. Les règles de validation sont votre première ligne de défense. Des pratiques régulières d'hygiène du pipeline rattrapent ce que les règles de validation laissent passer.
Principe 5 : les relations définissent la navigation
La façon dont vos objets sont reliés détermine la navigation des commerciaux et le fonctionnement des rapports.
Relations standard :
- Compte → Opportunités (un-à-plusieurs) : une entreprise, plusieurs deals au fil du temps
- Opportunité → Contacts (plusieurs-à-plusieurs) : un deal, plusieurs parties prenantes
- Opportunité → Produits (un-à-plusieurs) : un deal, plusieurs lignes
- Compte → Activités (un-à-plusieurs) : tous les points de contact remontent au compte
Conséquences sur la navigation :
- Depuis une fiche compte, les commerciaux doivent voir toutes les opportunités (en cours et passées)
- Depuis une opportunité, ils doivent voir tous les contacts impliqués et leur rôle
- Depuis un contact, ils doivent voir toutes les opportunités auxquelles il participe
Conséquences sur les rapports :
- Les rapports d'opportunités peuvent être regroupés par compte
- Les rapports d'activités peuvent être filtrés par étape d'opportunité
- Les rapports de contacts peuvent montrer la participation aux deals
Une mauvaise conception des relations dégrade à la fois l'expérience utilisateur et les rapports.
Une architecture de permissions qui passe à l'échelle
La conception des permissions est souvent traitée en dernier. Elle ne devrait pas l'être.
Contrôle d'accès par rôle (RBAC)
Définissez les rôles explicitement :
Commercial :
- Voit : ses propres deals, et éventuellement ceux de l'équipe
- Modifie : ses propres deals
- Supprime : non
- Rapports : dashboards personnels
Manager commercial :
- Voit : les deals de l'équipe, avec consolidation à l'échelle de la région
- Modifie : ses propres deals et ceux de l'équipe (pour le coaching)
- Supprime : non
- Rapports : performance de l'équipe, santé du pipeline
Sales Operations :
- Voit : tous les deals
- Modifie : tous les deals (pour le nettoyage des données)
- Supprime : oui (doublons, données de test)
- Rapports : accès complet à l'analyse
Dirigeant :
- Voit : tous les deals (agrégés)
- Modifie : non (les dirigeants n'ont pas à modifier les deals dans le CRM)
- Supprime : non
- Rapports : dashboards stratégiques (précision du forecast, win rates, performance par segment)
Transverse :
- Sales Engineers : voient l'étape d'évaluation technique et les champs associés
- Finance : voit les conditions contractuelles et les données des deals gagnés
- Juridique : voit les deals à l'étape juridique et les signaux de risque
- Customer Success : voit les opportunités d'expansion et de renouvellement
Modèles de visibilité
Visibilité par territoire :
- Les commerciaux voient les deals de leur territoire attribué (zone géographique, liste de comptes ou secteur)
- Avantages : propriété claire, évolue avec la croissance de l'équipe
- Inconvénients : exige une attribution précise des territoires
Visibilité par équipe :
- Les commerciaux voient les deals de tous les membres de leur équipe (pod, région ou segment)
- Avantages : encourage la collaboration
- Inconvénients : peut diluer la responsabilité si la propriété n'est pas claire
Visibilité par compte :
- Les commerciaux voient tous les deals de leurs comptes attribués
- Avantages : continuité de la relation (surtout pour les expansions et les renouvellements)
- Inconvénients : fonctionne mal pour les modèles SMB transactionnels
Modèle mixte (le plus courant) :
- Commerciaux Enterprise : par compte (propriété de comptes nommés)
- Commerciaux SMB : par territoire (zone géographique ou leads mutualisés)
Sensibilité des données
Visibilité des revenus :
- Tous les commerciaux doivent-ils voir les montants d'opportunités de chacun ? (transparence entre pairs ou sensibilité concurrentielle)
- Les équipes transverses doivent-elles voir les revenus ? (la finance et le juridique, oui ; le marketing, peut-être pas)
Veille concurrentielle :
- Les noms des concurrents doivent-ils être largement visibles ? (risque de fuites si l'accès est trop large)
- Les motifs de perte doivent-ils être visibles entre équipes ? (oui, pour apprendre, mais en expurgeant les détails sensibles)
Comptes stratégiques :
- Les deals à forte visibilité doivent-ils avoir des restrictions d'accès supplémentaires ? (limiter aux personnes qui ont besoin d'en connaître)
Ce ne sont pas des questions techniques, ce sont des questions de culture d'entreprise. Mais votre architecture doit pouvoir prendre en charge vos réponses.
Exigences d'intégration
Votre pipeline ne fonctionne pas de façon isolée. L'architecture d'intégration détermine si vos systèmes travaillent en harmonie ou se font concurrence.
Intégration de la marketing automation (transmission des leads)
Flux de données :
- Le marketing capte les leads (formulaires, publicités, événements)
- La marketing automation note les leads (comportement et profil démographique)
- Les MQL sont poussés vers le CRM sous forme de leads
- Les commerciaux convertissent les leads en opportunités
- Les deals gagnés sont renvoyés vers la marketing automation (attribution en boucle fermée)
Exigences d'intégration :
- Connexion par API (temps réel ou quasi réel)
- Mapping des champs (source du lead, campagne, score comportemental)
- Prévention des doublons (rapprochement par e-mail)
- Synchronisation des statuts (statut du lead, étape de l'opportunité, clos/gagné)
Point d'architecture : le marketing et la vente doivent s'accorder sur la définition d'un MQL. L'intégration ne corrige pas un manque d'alignement, elle ne fait que synchroniser le chaos plus vite.
Intégration des systèmes financiers (reconnaissance du revenu)
Flux de données :
- Les deals closed-won sont poussés vers la finance et l'ERP
- Les conditions contractuelles (montant, échéancier de paiement, date de début) suivent
- La finance comptabilise le revenu selon les règles comptables
- Les upsells et les renouvellements mettent à jour la valeur vie client
Exigences d'intégration :
- Données contractuelles (montant, produits, durée, conditions de paiement)
- Rapprochement des entités clients (compte CRM = client en finance)
- Suivi des changements (les avenants et les upsells déclenchent des mises à jour)
Point d'architecture : les étapes du pipeline commercial doivent coïncider avec les jalons de reconnaissance du revenu de la finance. « Closed-won » doit signifier « engagé par contrat et facturable », pas « accord verbal ».
Intégration produit et exécution (deal desk, provisioning)
Flux de données :
- Les deals approuvés déclenchent les workflows de provisioning
- Les détails de configuration du produit (références, quantités, options spécifiques) sont transmis à l'exécution
- Les calendriers de mise en œuvre sont coordonnés entre la vente et la livraison
Exigences d'intégration :
- Synchronisation du catalogue produit (produits du CRM = références de provisioning)
- Détails de configuration (champs personnalisés, exigences particulières)
- Workflows d'approbation (approbation financière, approbation juridique, faisabilité technique)
Point d'architecture : la configuration du deal doit être assez détaillée pour que l'exécution puisse agir. Une vague « licence Enterprise » ne suffira pas, l'exécution a besoin de « 50 licences, accès API, support premium ».
Intégration des systèmes de support (passage de relais après la vente)
Flux de données :
- Les deals gagnés sont poussés vers la plateforme de Customer Success
- L'historique des tickets de support enrichit le forecast des renouvellements
- Les données d'usage du produit révèlent des opportunités d'expansion
- Les scores de santé orientent les actions proactives
Exigences d'intégration :
- Création de la fiche client (passage de relais compte et contact)
- Synchronisation des droits produit (ce qui a été acheté et les dates du contrat)
- Alertes de renouvellement (selon les dates de fin de contrat)
Point d'architecture : la vente s'arrête souvent là où le Customer Success commence. Un passage de relais clair = meilleure rétention et davantage d'expansion.
Enjeux de passage à l'échelle
Vos choix d'architecture déterminent si vous passez à l'échelle sans heurts ou si vous atteignez des points de rupture qui exigent une refonte douloureuse.
Performance avec le volume
Seuils de volume :
- 10 000 opportunités : la plupart des CRM le gèrent sans difficulté
- 100 000 opportunités : commencez à optimiser les requêtes et à indexer les champs clés
- Plus de 1 000 000 d'opportunités : il faut une stratégie d'archivage des données et une base de reporting séparée
Architecture pour le passage à l'échelle :
- Indexez les champs les plus interrogés (propriétaire, étape, date de clôture, territoire)
- Archivez les deals clos depuis plus de X ans (conservez-les dans la base de reporting, retirez-les du CRM quotidien)
- Utilisez des agrégats pré-calculés plutôt que des requêtes en direct (par exemple, pré-calculer le pipeline par territoire)
- Partitionnez les données (par exemple, séparez les opportunités actives des opportunités closes)
Erreur courante : optimiser trop tôt. N'architecturez pas pour 1 M d'opportunités si vous en avez 500 aujourd'hui. Mais concevez en gardant à l'esprit la croissance à venir.
Souplesse des processus
Faire grandir les équipes exige de faire évoluer les processus :
- Mois 1 : cinq commerciaux, répartition manuelle des leads via Slack
- Mois 12 : vingt commerciaux, répartition en round-robin par territoire
- Mois 24 : cinquante commerciaux, répartition pondérée selon la performance et la disponibilité
Architecture pour la souplesse :
- Externalisez la logique de routage (un service de routage dédié, pas un workflow codé en dur dans le CRM)
- Privilégiez la configuration à la personnalisation (modifier des paramètres, pas du code)
- Construisez des workflows d'approbation qui s'adaptent à la hiérarchie de l'organisation (sans noms de managers codés en dur)
Erreur courante : coder des hypothèses en dur. « Nous ne vendons qu'aux États-Unis » devient « Nous nous développons en EMEA et tout notre pipeline s'effondre ».
Capacités de reporting
Les besoins de reporting augmentent :
- Phase de lancement : funnel de base (leads, opportunités, deals gagnés)
- Phase de croissance : analyse du taux de conversion par source, performance des commerciaux, analyse des gains et des pertes
- Phase d'échelle : analyse multidimensionnelle (segment par produit par région), analyse par cohortes, forecast prédictif
Architecture pour le reporting :
- Saisie cohérente des données (on ne peut pas analyser des champs non renseignés)
- Catégorisation claire (noms d'étapes, catégories de produits et motifs de perte cohérents)
- Historisation (conservez l'historique des changements d'étape et des montants)
- Base de reporting séparée pour les requêtes complexes (sans ralentir le CRM de production)
Erreur courante : se rendre compte qu'il manque des données qu'on n'a pas collectées. Impossible d'analyser les « jours passés à chaque étape » si l'on n'a pas journalisé les transitions d'étape. Comprendre la vélocité du pipeline exige ces données historiques dès le premier jour.
Potentiel d'automatisation
Possibilités d'automatisation :
- Répartition automatique selon le territoire, le produit, la taille du compte
- Qualification automatique selon des règles de scoring
- Séquences de relance automatiques selon l'étape et l'activité
- Alertes automatiques pour les deals qui s'enlisent, les relances en retard, les forecasts à risque
Architecture pour l'automatisation :
- Des données propres et obligatoires (l'automatisation a besoin d'entrées fiables)
- Des déclencheurs d'événements (changements d'étape, mises à jour de champs, déclencheurs temporels)
- Une conception axée API (l'automatisation vit hors du CRM et l'orchestre via les API)
- Une gestion des erreurs (l'automatisation échoue proprement, journalise les incidents, alerte les responsables)
Erreur courante : automatiser des processus défaillants. L'automatisation accélère les bons processus, et fait aussi échouer plus vite les mauvais.
Les anti-modèles d'architecture
Évitez ces erreurs d'architecture courantes :
Anti-modèle 1 : l'excès de complexité
Vous avez vingt champs personnalisés par opportunité (la plupart inutilisés). Sept flux conditionnels fondés sur des combinaisons de cases à cocher. Des noms d'étapes différents pour chaque segment (mais le même processus sous-jacent). Des pages de documentation pour créer une seule opportunité.
Cela arrive quand on essaie de répondre à tous les cas limites et à toutes les demandes particulières.
La solution : simplifier sans pitié. 80 % des deals doivent entrer dans le processus standard. Traitez les 20 % restants à la main.
Anti-modèle 2 : le manque de structure
Vous n'avez aucun champ obligatoire (la qualité des données est un désastre). Aucune règle de validation (des données aberrantes partout). Aucune définition d'étape (chacun interprète « négociation » à sa façon). Aucune intégration (exports et imports manuels).
Cela vient de la peur d'être « trop rigide » ou de « ralentir la vente ».
La solution : la structure permet la vitesse. Un processus clair, c'est moins de confusion et une exécution plus rapide.
Anti-modèle 3 : le modèle unique pour tous
Vous imposez un pipeline identique à l'Enterprise et au SMB alors que les processus n'ont rien à voir. Les mêmes critères de qualification pour l'inbound et l'outbound alors que les niveaux d'intention diffèrent. Aucune prise en compte des différences de produits alors que les cycles de vente varient.
Cela vient de la confusion entre simplicité et clarté. Ou des limites de la plateforme CRM.
La solution : concevoir pour votre activité réelle. Si les processus diffèrent sur le fond, créez des pipelines distincts.
Anti-modèle 4 : la conception dictée par l'outil
Vous construisez votre pipeline pour coller aux paramètres par défaut du CRM plutôt qu'à votre processus. Vous évitez le multi-pipeline parce que votre CRM le rend difficile. Vous utilisez des champs personnalisés pour contourner les limites de la plateforme.
Cela arrive quand vous laissez votre outil dicter votre processus, au lieu de chercher des outils qui soutiennent votre processus.
La solution : concevez d'abord votre architecture idéale. Cherchez ensuite les outils qui la prennent en charge. Ne concevez pas autour des limites d'un outil.
Anti-modèle 5 : « on le configure et on n'y touche plus »
Votre pipeline n'a pas bougé depuis trois ans alors que votre activité a évolué. Vous avez des champs personnalisés de 2019 dont plus personne ne se rappelle l'utilité. Des contournements empilés sur des contournements parce que « ça a toujours fonctionné comme ça ».
Cela arrive quand on traite l'architecture comme un projet ponctuel au lieu d'une discipline continue.
La solution : revoir l'architecture chaque trimestre. Archiver les champs inutilisés. Simplifier la complexité accumulée. Choisir l'évolution plutôt que l'immobilisme.
Conclusion : l'architecture comme avantage concurrentiel
L'architecture du pipeline n'a rien de glamour. Ce n'est ni une astuce de growth hacking ni une solution miracle. Mais c'est ce qui sépare des Revenue Operations qui passent à l'échelle sans heurts de celles qui s'effondrent sous leur propre complexité.
Les entreprises dotées d'une architecture de pipeline solide intègrent leurs commerciaux en quelques semaines, pas en quelques mois (processus clair, données propres, structure intuitive). Elles font des prévisions précises (saisie cohérente des données, étapes définies, flux fiables) et atteignent une précision du forecast qui permet de décider en confiance. Elles passent à l'échelle sans rupture (architecture souple, intégrations modulaires, prête pour l'automatisation). Elles décident vite (des rapports qui fonctionnent vraiment, des données auxquelles les équipes font confiance).
Les entreprises dotées d'une architecture de pipeline fragile se battent chaque jour avec leur CRM (contournements, nettoyage de données, rapports qui exigent du SQL). Elles perdent en visibilité en grandissant (impossible de voir à travers les segments, les zones géographiques, les produits). Elles passent plus de temps sur les outils qu'à vendre (saisie complexe, processus flou, savoir tacite). Elles refondent leur architecture dans la douleur tous les 18 mois (c'est coûteux, perturbant et démoralisant).
Le meilleur moment pour concevoir une architecture solide, c'était au début. Le deuxième meilleur moment, c'est maintenant, avant que votre prochaine phase de croissance ne révèle les fissures.
Prêt à concevoir une architecture de pipeline qui passe à l'échelle ? Commencez par la conception de vos étapes de pipeline pour définir la structure de vos étapes, puis explorez les stratégies de gestion multi-pipeline pour les Revenue Operations complexes.
En savoir plus
- Vue d'ensemble des métriques du pipeline - Les indicateurs clés à suivre une fois votre architecture en place
- Gestion de la progression des deals - Faire avancer efficacement les opportunités dans votre pipeline
- Revues de pipeline - Les pratiques de gouvernance qui font tenir votre architecture
- Analyse de la couverture du pipeline - Garantir un pipeline suffisant pour vos objectifs de revenus
Head of Enterprise Solutions
On this page
- Qu'est-ce que l'architecture du pipeline ?
- Le coût caché de la simplification excessive
- Les composantes clés de l'architecture
- 1. Structure du pipeline (étapes, points de contrôle, flux)
- 2. Modèle de données (objets, champs, relations)
- 3. Modèle de permissions (visibilité, propriété, modification)
- 4. Points d'intégration (marketing, finance, opérations)
- Pipeline unique ou multiple : la décision
- Quand un seul pipeline suffit
- Quand plusieurs pipelines deviennent nécessaires
- Modèles d'architecture multi-pipeline
- Stratégies de segmentation du pipeline
- Dimensions de segmentation
- Mise en œuvre de la segmentation
- Principes d'architecture des données
- Principe 1 : le standard avant le personnalisé
- Principe 2 : catégoriser les champs en communs, généraux et internes
- Principe 3 : les champs obligatoires imposent le processus
- Principe 4 : la validation empêche les mauvaises données
- Principe 5 : les relations définissent la navigation
- Une architecture de permissions qui passe à l'échelle
- Contrôle d'accès par rôle (RBAC)
- Modèles de visibilité
- Sensibilité des données
- Exigences d'intégration
- Intégration de la marketing automation (transmission des leads)
- Intégration des systèmes financiers (reconnaissance du revenu)
- Intégration produit et exécution (deal desk, provisioning)
- Intégration des systèmes de support (passage de relais après la vente)
- Enjeux de passage à l'échelle
- Performance avec le volume
- Souplesse des processus
- Capacités de reporting
- Potentiel d'automatisation
- Les anti-modèles d'architecture
- Anti-modèle 1 : l'excès de complexité
- Anti-modèle 2 : le manque de structure
- Anti-modèle 3 : le modèle unique pour tous
- Anti-modèle 4 : la conception dictée par l'outil
- Anti-modèle 5 : « on le configure et on n'y touche plus »
- Conclusion : l'architecture comme avantage concurrentiel
- En savoir plus